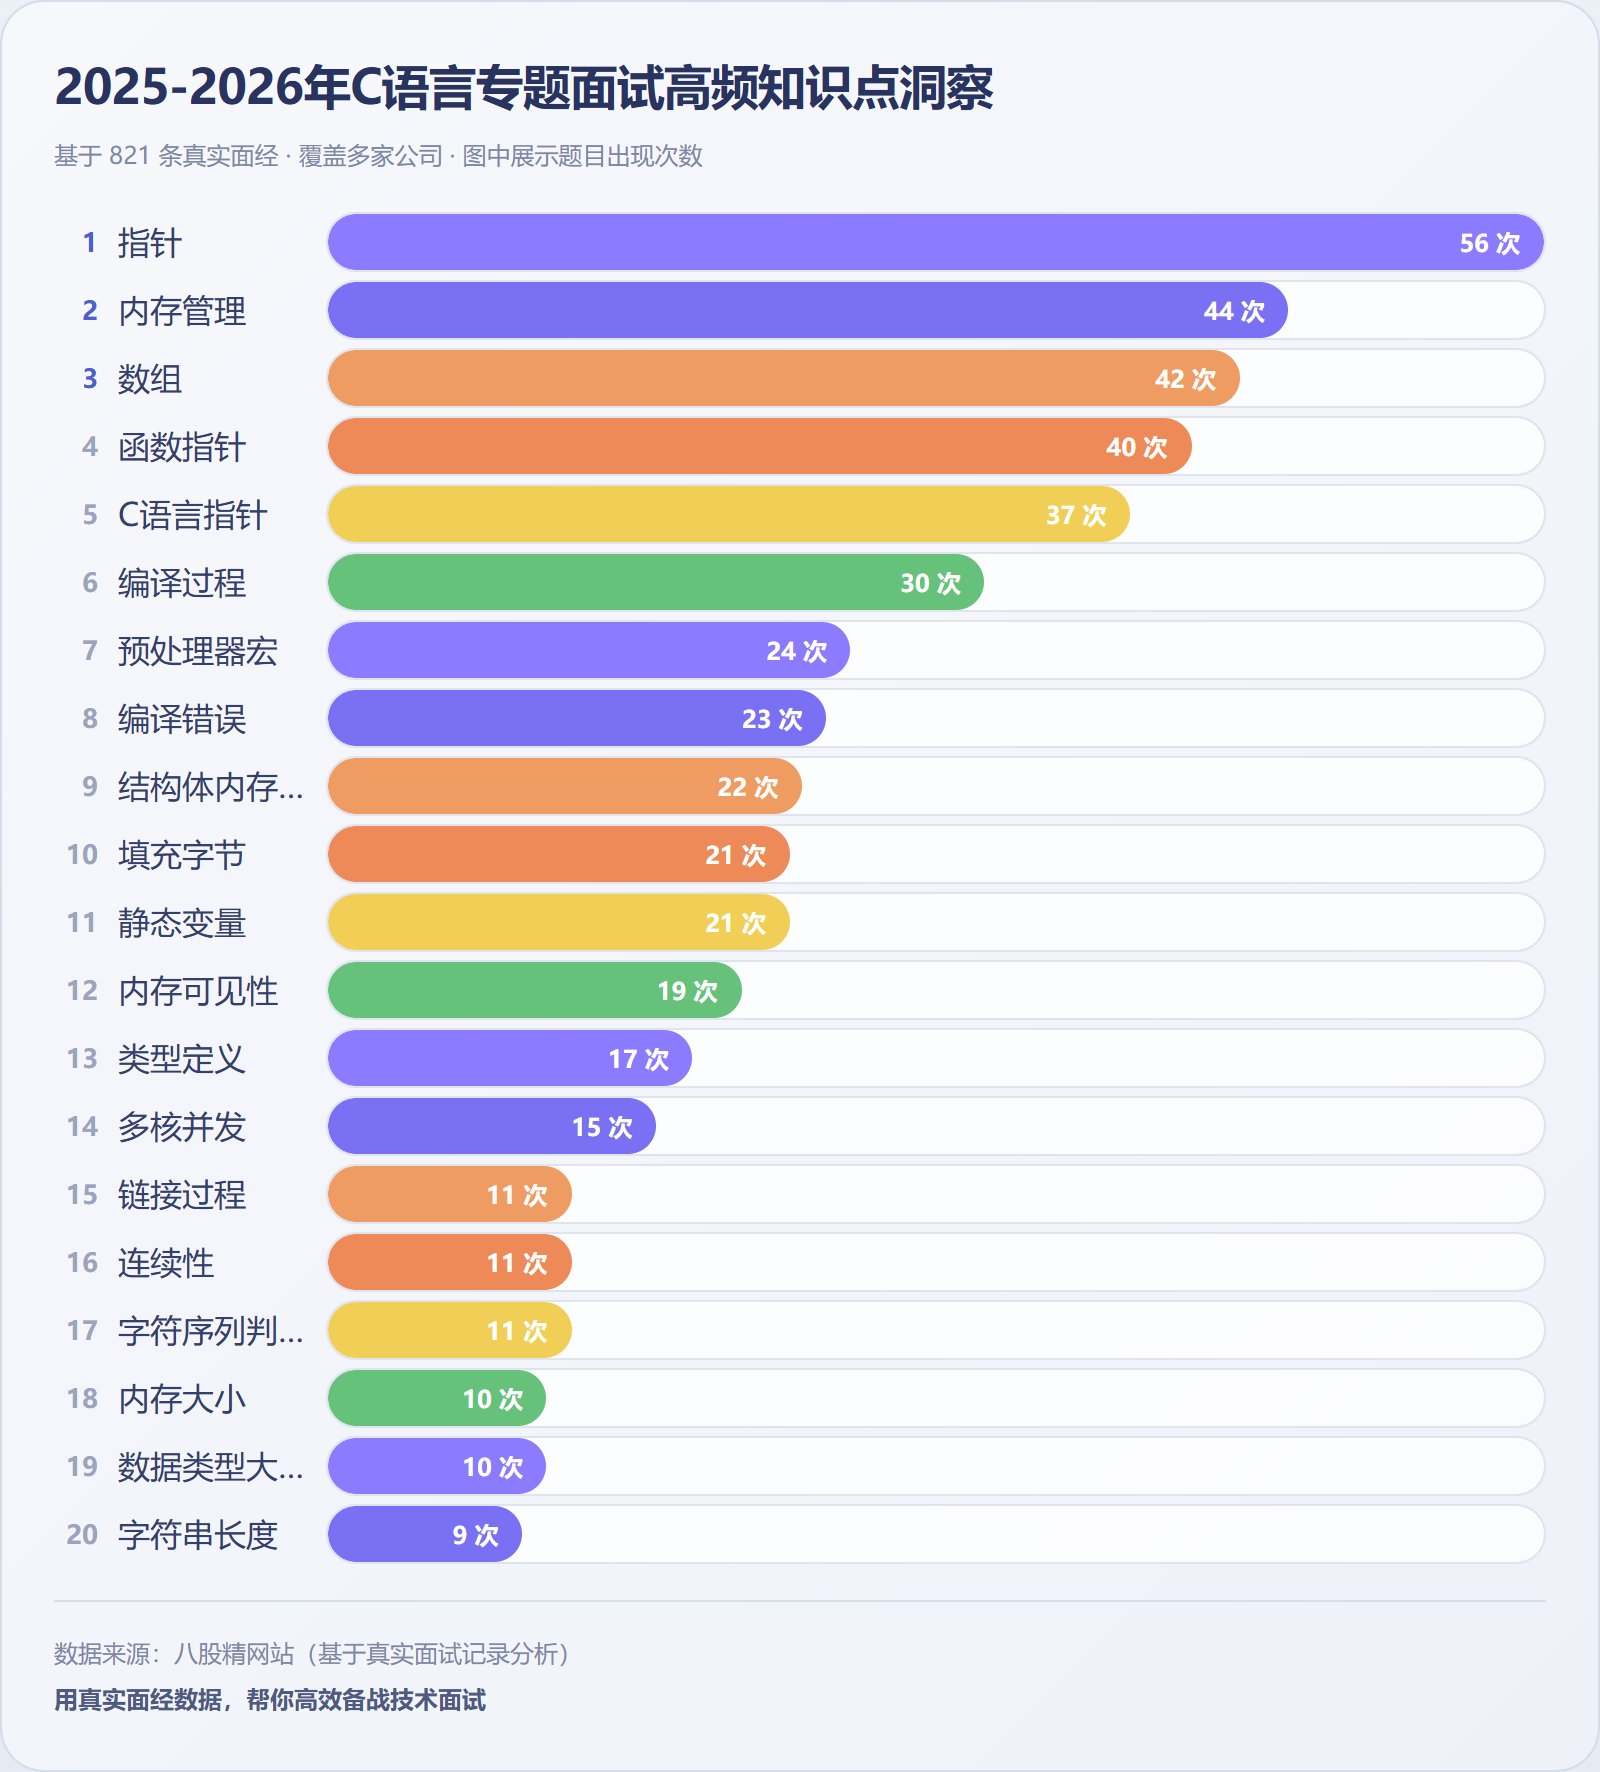
本文基于八股精 C 语言专题约 759 条有效面试记录(统计口径:仅纳入 2025 / 2026 年命中的题目),对 20 个高频知识点按出现次数与真题形态做了聚类解读,并给出分级备考建议,帮助求职者在有限时间内把复习精力花在刀刃上。
写在前面
如果你正在准备 C/C++ 方向的校招或社招面试,大概率会遇到一个经典难题:八股内容浩如烟海,到底哪些是面试官真正爱问的?与其凭感觉复习,不如让数据说话。下面这份洞察,把 20 个知识点重组为 5 大知识模块,每个模块都保留原始出现次数与代表真题,你可以直接把它当成一份"复习优先级地图"来用。
先给一个总体结论:内存管理(15 次)是全专题出现次数最高的知识点,考察频次明显领先;结构体(9 次)、指针(6 次)、位运算(6 次)、内存布局(5 次)构成第二梯队;其余知识点多在 2-4 次区间,属于高频选考或锦上添花项。
模块一:指针体系------C 语言的灵魂考点
核心结论 :指针本身(6 次)+ 函数指针(4 次)+ 类型定义(2 次)+ 数组(3 次),合计出现 15 次,是覆盖最广的模块。面试官很少孤立地问"指针是什么",而是喜欢通过对比题(指针 vs 数组、指针函数 vs 函数指针、const 的不同位置)来考察你是否真正理解指针的语义。
数据与真题:
- 指针(6 次) :高频问法包括------
- 指针和数组的区别,以及指针的指针在实际开发中的应用场景;
const int *p与int *const p的区别(const 修饰指针本身还是修饰所指对象);- 什么是指针的指针,有哪些常见应用场景。
- 函数指针(4 次) :
- 指针函数和函数指针的区别;
- 函数指针与回调机制,如何用回调实现灵活的系统设计;
- 手写一个函数指针:指向"返回
int、含两个int形参"的函数。
- 类型定义(2 次) :解释
typedef void (*my_func)(int)的含义------本质上是函数指针的别名化,常与上一问联动考察。 - 数组(3 次) :
- 数组和链表的区别;
int a[5]与int *p = a的区别(数组名在表达式中退化为指针,但sizeof(a)与sizeof(p)不同)。
避坑/得分点:
- const 与指针的组合 是重灾区,记口诀:"const 在
*左边修饰数据,在*右边修饰指针"。const int *p指向的内容不可改,int *const p指向的地址不可改。 - 问"指针的指针的应用场景"时,不要只答语法,要给出工程场景:在函数内部分配内存并传出 (如
void alloc(char **buf))、二维动态数组、链表节点的修改操作。 - 手写函数指针声明
int (*fp)(int, int);一定要能盲写,这类题答不出来非常减分------它同时检验语法熟练度与 typedef 的理解(typedef int (*fp_t)(int, int);是加分延伸)。 - 回调机制建议结合
qsort的比较函数、事件驱动框架来举例,体现"面向接口编程"的思想,这正是面试官想听到的系统设计视角。
模块二:内存管理------出现次数断层领先的第一考点
核心结论 :内存管理以 15 次的出现次数位居全专题第一,考察频次显著高于相邻排名的知识点,属于"核心必考"级别 。配合内存复制(2 次)与内存大小(2 次),本模块合计 19 次。考察重心非常清晰:malloc/free 的底层机制、与 C++ new 的对比,以及手写 memcpy。
数据与真题:
- 内存管理(15 次) :
new与malloc的区别,并展开说明 malloc 的底层实现过程;- 为什么
malloc申请内存要传大小,而free释放时不需要传大小; - malloc 能申请的最大内存是多少?受哪些因素影响。
- 内存复制(2 次) :实现内存拷贝函数(
memcpy),并说明其优化空间。 - 内存大小(2 次) :
sizeof()与strlen()获取字符串长度的区别;- C 语言基本数据类型及其存储大小,不同平台下的差异。
避坑/得分点:
- "free 为什么不传大小"是极具区分度的问题:因为 malloc 在分配时会在用户内存块前维护元数据头部(记录块大小等信息),free 通过指针回退即可读取。答出"内存管理元数据"这个概念,基本就拿到了高分。
- malloc 底层实现要能讲出关键词:小内存走 brk (堆顶指针移动)、大内存走 mmap 、glibc 的 ptmalloc 分箱管理(bins)与空闲链表复用。不需要背源码,但要能画出大致流程。
malloc最大申请量:受限于虚拟地址空间、物理内存 + swap、ulimit限制、内存碎片等因素,答题时强调"理论上限是地址空间,实际上限受系统配置约束"即可。- 手写
memcpy的优化空间:字长对齐批量拷贝、循环展开、restrict指针消除重叠假设(注意与memmove的区别------重叠场景必须用 memmove)。同时别忽略sizeofvsstrlen这类基础题:sizeof 是编译期运算符算的是占用字节,strlen 是运行期函数算到\0为止。
模块三:结构体与内存布局/对齐------第二大类,重理解、重计算
核心结论 :这是知识点数量最多的模块:结构体(9 次)、内存布局(5 次)、内存对齐(3 次)、结构体内存对齐(3 次)、填充字节(3 次)、结构体内存布局(2 次),合计 25 次,其中结构体单项 9 次仅次于内存管理,同属核心必考。题型上呈现"计算题 + 原理题 + 工程题"三种形态:让你算结构体大小、解释对齐规则、讨论跨平台通信中的布局一致性。
数据与真题:
- 结构体(9 次) :
- 含
int_16 a、int_64 b、float c的结构体占多大内存?说明内存对齐原理; - 如何用 C 的结构体实现类似 C++ 面向对象的效果;
- 位域的作用是什么,编译器如何存储位域。
- 含
- 内存布局(5 次) :
- C 程序运行后内存分布分为哪些段;
- 联合体占用空间由什么决定;
const char* ptr = "abcde";中字符串字面量存储在哪,并说明 Linux 进程内存分布。
- 内存对齐(3 次):malloc 分配 7 字节实际分配了多少?除对齐外还有什么影响因素(呼应模块二的元数据头部)。
- 结构体内存对齐(3 次) :
- int 与 char 成员的结构体如何对齐;
- 对齐规则是什么?
#pragma pack(1)有哪些副作用?CAN 报文解析中如何处理对齐问题; - 同一结构体在不同编译器/平台下为何布局不同?如何保证跨平台通信的数据一致性。
- 填充字节(3 次) :
- 两个成员完全相同的结构体,sizeof 结果为何可能不一样(成员顺序不同);
- int、double、char 按不同顺序定义会产生什么不同效果。
- 结构体内存布局(2 次):结构体的内存布局规则是什么?为什么会有填充字节;如何进行内存对齐,嵌套结构体的对齐规则。
避坑/得分点:
- 对齐计算题必须练熟 :规则是"每个成员的偏移量为其自身对齐值与结构体对齐基准(最大成员对齐值或
#pragma pack指定值)中较小者的整数倍,结构体总大小为最大对齐值的整数倍"。按int_16(2) + int_64(8) + float(4)排列时注意成员顺序对填充的影响,答题时先写排列再逐成员算偏移,过程分比结论更重要。 - 成员顺序优化 是填充字节题的隐含考点:把成员按对齐值从大到小(或从小到大)集中排列可减少填充,这是"绿色编程"的加分点。
"abcde"这类题注意区分:字符串字面量位于只读数据段(.rodata) ,而ptr指针本身在栈上;程序内存分布要能完整说出 text / rodata / data / bss / heap / stack 各段。#pragma pack(1)的副作用:取消填充虽节省空间,但可能导致非对齐访问,在部分架构(如某些 ARM)上引发性能下降甚至总线错误。跨平台通信的一致性方案:统一字节序(htonl/ntohl)、显式指定 pack、序列化协议(如 Protobuf)。能答到这一层的候选人很少,属于明显的差异化得分点。- 用 C 模拟面向对象:结构体 + 函数指针成员(模拟虚表)+ 构造函数风格的 init 函数,这与模块一的回调知识天然衔接,可以合并复习。
模块四:编译链接与预处理------工程化能力的试金石
核心结论 :编译过程(3 次)、编译错误(3 次)、预处理器宏(3 次)、头文件包含保护(4 次),合计 13 次,单项都在 3-4 次的高频选考区间。这个模块的问题普遍带有"排查报错"的工程色彩,说明面试官在考察你是否真正动手写过、编译过、调过错误,而不只是背概念。
数据与真题:
- 编译过程(3 次) :
- C 语言编译成可执行文件的完整过程;"找不到声明""找不到定义"两类报错分别发生在哪个阶段;
- 从编译和链接阶段讲解
extern的作用; - 编译时如何优化?除
-O1/-O2/-O3外,还有哪些操作可以减小二进制体积。
- 编译错误(3 次) :
- 头文件中直接定义全局变量(未用
extern)会导致什么问题,正确做法是什么; - gcc 编译时找不到 .h 头文件可能有哪些原因。
- 头文件中直接定义全局变量(未用
- 预处理器宏(3 次) :
#define与typedef的区别;#define与const的区别,分别在什么时机生效;- 为什么定义宏时需要加括号。
- 头文件包含保护(4 次) :
#ifndef / #define / #endif的作用和原理;- 如何解决头文件重复包含,列举常见方式及各自特点;
- 如何避免 .h 头文件中的定义重复。
避坑/得分点:
- 编译四阶段预处理 → 编译 → 汇编 → 链接 要能对应产物(.i / .s / .o / 可执行文件)。报错归类是常考细节:"找不到声明"是编译阶段 错误,"找不到定义"(undefined reference)是链接阶段错误。
- 头文件里直接定义全局变量,多个 .c 包含后会在链接期产生重复定义 错误;正确做法是"头文件用
extern声明,某一个 .c 文件中定义"。这题与 extern、编译错误两个知识点本质是同一件事,建议串起来记。 - 宏加括号防的是运算符优先级与多次求值 问题,经典反例:
#define SQR(x) x*x遇到SQR(a+b)展开成a+b*a+b;++x类参数还会产生副作用。防重复包含则要能对比 include guard(#ifndef,标准 C,可移植)与#pragma once(编译器扩展,依赖文件路径判断,更简洁但非标准) 两种方案的优劣。 #definevsconst:宏是预处理期 纯文本替换、无类型检查;const 是编译期 带类型的常量,可调试。#definevstypedef:宏是文本别名,typedef 是编译器层面的真正类型别名,在指针类型上差异明显(#define P_INT int*声明多个变量时会踩坑)。- 减小二进制体积属于开放题,可答:
-Os、去除调试符号(strip)、静态库改动态链接、-ffunction-sections + --gc-sections裁剪未用段等,答出两三个即有竞争力。
模块五:语言特性与底层操作------位运算、static 与 volatile
核心结论 :位运算(6 次)、静态变量(3 次)、内存可见性(2 次),合计 11 次。位运算出现 6 次与指针并列第三,且明显偏向嵌入式/驱动场景(寄存器操作),是投嵌入式岗位同学的必考题;static 与 volatile 则是并发与生命周期两大主题的入口。
数据与真题:
- 位运算(6 次) :
- 说明
strcpy与memcpy的区别,并用位运算统计二进制中 1 的个数; - 如何通过位运算实现寄存器某一位的置 1、清 0、翻转;
- 如何分别设置和清除一个整数的第 3 位(从 0 计数,权值 2³=8)。
- 说明
- 静态变量(3 次) :
- static 在嵌入式系统中的实际应用场景;
- 函数内 static 变量与普通局部变量的区别,为什么 static 变量不会随函数结束而销毁;
- 静态变量的生命周期和作用范围。
- 内存可见性(2 次) :
- volatile 能否解决所有并发可见性问题?多核系统与单核中断场景下各有什么局限;
- volatile 的作用,多线程环境下它如何保证变量操作的正确性。
避坑/得分点:
- 位运算三板斧务必写成肌肉记忆:置位
reg |= (1 << n)、清位reg &= ~(1 << n)、翻转reg ^= (1 << n)、读位(reg >> n) & 1。统计 1 的个数要会两种:循环n & 1右移法,以及加分项 Brian Kernighan 法n &= (n - 1)(每次消去最低位的 1)。 - static 的核心答题框架是"生命周期延长(静态存储区,程序全程存活)+ 作用域收窄(仅限本文件/本函数,天然的信息隐藏)"。嵌入式场景可举:模块内私有状态、避免栈上大数组、状态机的状态保持。
- volatile 一题要小心陷阱:volatile 只保证每次读写都访问内存本身(防编译器优化缓存),它不提供原子性,也不是内存屏障。多核下两个核心各自的缓存一致性问题它管不了,单核中断场景下"读-改-写"复合操作仍可能被中断打断。真正解决并发需要锁或原子操作。能把"volatile ≠ 线程安全"讲清楚的候选人,这题就是满分。
strcpyvsmemcpy:strcpy 以\0为界拷贝字符串、不检查长度;memcpy 按指定字节数拷贝任意内存、可配合长度参数更安全,注意重叠时用 memmove。
备考建议:按出现次数梯队分级投入
结合以上数据,给出一套可直接执行的分级复习策略:
- 核心必考(出现 ≥5 次,优先投入约 60% 复习时间) :内存管理(15)、结构体(9)、指针(6)、位运算(6)、内存布局(5)。这五项覆盖了素材中出现次数前五名,其中内存管理 15 次几乎是第二名结构体的 1.7 倍,malloc/free 底层、结构体大小计算、const 与指针、寄存器位操作四件事必须做到"闭眼能写"。
- 高频选考(出现 3-4 次,投入约 30% 时间):函数指针(4)、头文件包含保护(4)、数组(3)、编译过程(3)、编译错误(3)、填充字节(3)、预处理器宏(3)、静态变量(3)、内存对齐(3)、结构体内存对齐(3)。这一梯队题量大但单点浅,建议用"对比表"方式复习:define/typedef/const 一张表、编译四阶段一张图、对齐规则一组计算例题。
- 了解即可(出现 2 次,投入约 10% 时间):结构体内存布局(2)、内存可见性(2)、类型定义(2)、内存大小(2)、内存复制(2)。出现次数低不代表可以裸考------其中 memcpy 手写、sizeof/strlen 区别属于"答不上来直接扣印象分"的基础题;而 volatile 题虽少,但一旦问到就是区分度极高的深水区,建议至少准备一段 30 秒的标准答案。
- 按岗位微调权重 :素材显示位运算真题偏寄存器操作、结构体对齐真题涉及 CAN 报文解析,投嵌入式岗位应把模块三、五的优先级上调;投通用软件岗则保持内存管理与指针体系最高优先级。
- 以真题为纲做输出式复习 :本专题真题高度模板化("请说明 X 和 Y 的区别""请手写 X"),建议对每个知识点自问三件事------能不能 1 分钟讲清概念、能不能举一个工程场景、能不能现场写出来。三项全过,才算真正掌握。
数据来源于八股精(C语言专题)约 759 条真实面试记录,覆盖 2025-2026;结论基于统计,仅供参考。