文章目录
- 前言
- 零、论文基本信息
- 一、问题背景:为什么"每轮都总结"不是一个可持续的记忆方案
-
- [1. Eager Consolidation 的隐性成本](#1. Eager Consolidation 的隐性成本)
- [2. "先不总结"并不等于"直接遗忘"](#2. “先不总结”并不等于“直接遗忘”)
- [3. Recurrence 为什么可以作为巩固信号](#3. Recurrence 为什么可以作为巩固信号)
- [二、相关工作:RecMem 改变的是哪一层问题](#二、相关工作:RecMem 改变的是哪一层问题)
-
- [1. 长上下文与 RAG](#1. 长上下文与 RAG)
- [2. 结构化 Agent Memory](#2. 结构化 Agent Memory)
- [3. 认知科学中的记忆巩固](#3. 认知科学中的记忆巩固)
- 三、方法总览:三层记忆与一条选择性巩固路径
- 四、问题定义与交互单元
- 五、潜意识记忆:低成本地保留全部原始交互
-
- [1. 写入:不调用 LLM](#1. 写入:不调用 LLM)
- [2. 相似度过滤](#2. 相似度过滤)
- [3. 复现触发条件](#3. 复现触发条件)
- [4. 一个三轮交互例子](#4. 一个三轮交互例子)
- 六、情景记忆:把跨时间交互重建成连贯事件
-
- [1. 为什么只保留原始片段还不够](#1. 为什么只保留原始片段还不够)
- [2. 按时间排序后生成事件摘要](#2. 按时间排序后生成事件摘要)
- [3. Merge-first 更新](#3. Merge-first 更新)
- 七、语义精炼:从原始交互中补回摘要丢掉的细节
-
- [1. 情景摘要为何仍不够](#1. 情景摘要为何仍不够)
- [2. 读取已有事实,避免重复与冲突](#2. 读取已有事实,避免重复与冲突)
- 八、查询阶段:三路检索而不是摘要独占
- 九、实验设置
-
- [1. 数据集](#1. 数据集)
- [2. 对比方法](#2. 对比方法)
- [3. 模型与指标](#3. 模型与指标)
- 十、主实验结果
-
- [1. LoCoMo:在记忆系统中最好,但 Full Context 仍有优势](#1. LoCoMo:在记忆系统中最好,但 Full Context 仍有优势)
- [2. LongMemEval-S:历史真正变长后,RecMem 超过 Full Context](#2. LongMemEval-S:历史真正变长后,RecMem 超过 Full Context)
- 十一、消融实验:真正不可替代的是哪一层
-
- [1. No Subconscious:51.88](#1. No Subconscious:51.88)
- [2. No Semantic:70.58](#2. No Semantic:70.58)
- [3. No Episodic:79.94](#3. No Episodic:79.94)
- [4. Direct Extraction:74.22](#4. Direct Extraction:74.22)
- 十二、超参数与效率分析
-
- [1. 相似度阈值与复现次数](#1. 相似度阈值与复现次数)
- [2. 检索预算的边际收益](#2. 检索预算的边际收益)
- [3. F1 与 LLM-as-a-Judge 的差异](#3. F1 与 LLM-as-a-Judge 的差异)
- [十三、横向比较:RecMem 在 Agent Memory 演进中的位置](#十三、横向比较:RecMem 在 Agent Memory 演进中的位置)
-
- [1. 与 A-MEM](#1. 与 A-MEM)
- [2. 与 MAGMA](#2. 与 MAGMA)
- [3. 与 CoM](#3. 与 CoM)
- [4. 与 ReMemR1](#4. 与 ReMemR1)
- [5. 与 Mem²Evolve](#5. 与 Mem²Evolve)
- [十四、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发](#十四、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发)
-
- [1. Coding Agent:不要为每条终端输出都建长期记忆](#1. Coding Agent:不要为每条终端输出都建长期记忆)
- [2. Tool Agent:用复现判断稳定偏好](#2. Tool Agent:用复现判断稳定偏好)
- [3. Multi-Agent:共享记忆也需要写入调度](#3. Multi-Agent:共享记忆也需要写入调度)
- 十五、失败场景与局限性
-
- [1. 罕见但关键的信息不会"反复出现"](#1. 罕见但关键的信息不会“反复出现”)
- [2. 静态阈值依赖数据分布](#2. 静态阈值依赖数据分布)
- [3. 语义相似不等于同一事件](#3. 语义相似不等于同一事件)
- [4. 评价依赖 LLM Judge](#4. 评价依赖 LLM Judge)
- [5. 成本统计不是完整系统成本](#5. 成本统计不是完整系统成本)
- 十六、我的理解与启发
-
- [1. RecMem 真正改变的是 Memory Policy](#1. RecMem 真正改变的是 Memory Policy)
- [2. 复现是一种在线价值估计](#2. 复现是一种在线价值估计)
- [3. 原始证据层是摘要系统的必要保险](#3. 原始证据层是摘要系统的必要保险)
- [4. 下一步不应只是学习一个全局阈值](#4. 下一步不应只是学习一个全局阈值)
- 十七、总结
- 参考资料
前言
长期运行的 Agent 面临一个越来越现实的问题:交互历史越长,记忆系统本身反而可能成为成本最高的模块之一。
此前我们看到的 Agent Memory 工作,大多把注意力放在"记什么"以及"怎样组织记忆"上:
- A-MEM 让记忆笔记彼此建立动态链接,使记忆网络能够随新信息持续演化;
- MAGMA 从多粒度、多图结构角度组织经验,增强跨层级检索与组合推理;
- CoM 强调记忆压缩与组织,希望在有限上下文中保留真正有用的历史;
- ReMemR1 允许 Agent 在写入记忆时回看旧记忆,修复 memorize-while-reading 带来的不可逆信息损失;
- Mem²Evolve 进一步讨论记忆机制如何随任务反馈进行自我演化。
这些工作背后通常共享一个默认前提:新交互到来后,系统应当尽快调用 LLM,将其摘要、抽取、改写或并入某种长期记忆结构。问题在于,真实 Agent 可能一天接收几百乃至几千轮交互。若每一轮都触发一次 LLM 记忆加工,那么即使单次操作不贵,长期累计成本也会十分可观。
RecMem 质疑的正是这个默认前提。作者借鉴认知科学中的记忆巩固现象:人并不会把每一个瞬时刺激都立即加工成长时记忆;通常是持续出现、反复被激活的模式,才更值得进入稳定记忆。
因此,本文的唯一核心增量可以概括为:
RecMem 不再对每轮交互进行 eager consolidation,而是先把原始交互低成本写入"潜意识记忆",只有当某一主题在语义上反复出现并达到阈值时,才调用 LLM 将相关交互巩固为情景记忆和语义记忆。
这个改动看似只是把"立即处理"改成"满足条件再处理",实际上重新定义了记忆系统的写入策略:记忆的重要性不再完全由单轮 LLM 主观判断,而由跨时间的语义复现提供触发信号。
零、论文基本信息
- 论文名称: RecMem: Recurrence-based Memory Consolidation for Efficient and Effective Long-Running LLM Agents
- 发表平台: Findings of the Association for Computational Linguistics: ACL 2026
- 代码仓库: 论文与 ACL Anthology 页面未提供公开代码链接
- 作者: Zijie Dai, Shiyuan Deng, Sheng Guan, Yizhou Tian, Xin Yao, Xiao Yan, James Cheng
一、问题背景:为什么"每轮都总结"不是一个可持续的记忆方案
1. Eager Consolidation 的隐性成本
当前不少 Agent Memory 系统采用即时巩固策略。每当新交互到来,系统就调用 LLM 完成一种或多种操作:
- 抽取事实与偏好;
- 生成事件摘要;
- 判断是否与旧记忆冲突;
- 更新图结构、标签或链接;
- 合并、删除或改写既有记忆。
这类设计在短对话中没有明显问题,但长期运行时,记忆构建成本近似随交互数线性累积。设第 t t t 轮交互触发的巩固成本为 c t c_t ct,总写入成本为:
C e a g e r ( T ) = ∑ t = 1 T c t C_{\mathrm{eager}}(T)=\sum_{t=1}^{T}c_t Ceager(T)=t=1∑Tct
只要每一轮都调用 LLM, T T T 增大后总成本就无法避免地持续增长。更麻烦的是,大量交互可能只是一次性、低价值内容,对它们立即做高成本加工未必有必要。
2. "先不总结"并不等于"直接遗忘"
延迟巩固最直接的风险是:如果某条信息只出现一次,却恰好对未来问题十分重要,系统会不会丢失它?
RecMem 的答案不是删除,而是分层保存:
- 所有原始交互都进入潜意识记忆,不需要 LLM;
- 反复出现的主题再被提升为情景记忆和语义记忆;
- 回答问题时三层记忆都可以被检索。
因此,潜意识记忆既是触发器的数据来源,也是防止一次性信息丢失的原始证据库。这里要特别区分:
未巩固不代表未保存;它只代表尚未花费 LLM Token 将原始交互加工成更高层表示。
3. Recurrence 为什么可以作为巩固信号
单轮交互中的显著性不容易准确判断。例如,用户第一次提到"花生过敏"时,系统未必知道这个事实以后是否重要;当用户之后再次讨论蛋糕、餐厅或配料时,这个主题的持续复现才逐渐显露出长期价值。
RecMem 用两个条件近似衡量这种复现:
- 新交互与历史交互在向量空间中足够相似;
- 相似交互的数量达到复现阈值。
这并不意味着"重复次数等于重要性",而是使用了一个便宜、可在线计算的代理信号,将昂贵的 LLM 巩固集中到更可能具有长期价值的主题上。
二、相关工作:RecMem 改变的是哪一层问题
1. 长上下文与 RAG
Full Context 直接把全部历史放进上下文,信息最完整,但查询成本会随历史长度增长,并最终受模型上下文窗口限制。Naive RAG 则把历史切分并向量化,在查询时只取相似片段,构建便宜,但缺乏跨轮抽象、状态维护与时间组织。
RecMem 保留了 RAG 式原始向量检索的低成本优点,同时只对真正反复出现的主题进行高层加工。因此它不是单纯的 RAG,也不是单纯的摘要系统,而是两者之间的选择性提升机制。
2. 结构化 Agent Memory
Mem0、A-Mem、MemoryOS 等方法用事实、链接、层级或多类存储改善长期记忆。它们主要回答"怎样表示和更新记忆",但写入阶段往往依赖频繁的 LLM 调用。
RecMem 与这些工作的关键差别不在于提出了更复杂的数据结构,而在于追问:
什么时候才值得启动结构化记忆构建?
因此,RecMem 的 recurrence trigger 理论上也能与图记忆、层次记忆等结构结合。它更像一个写入调度原则,而不仅是一种固定的存储格式。
3. 认知科学中的记忆巩固
论文从人类记忆中借用了"瞬时存储---长期巩固"的直觉:输入先以较低成本保留,持续复现的模式逐渐形成更稳定的长期表示。不过,RecMem 并非认知模型的严格实现;它把这种直觉工程化为向量相似度与计数阈值。
三、方法总览:三层记忆与一条选择性巩固路径
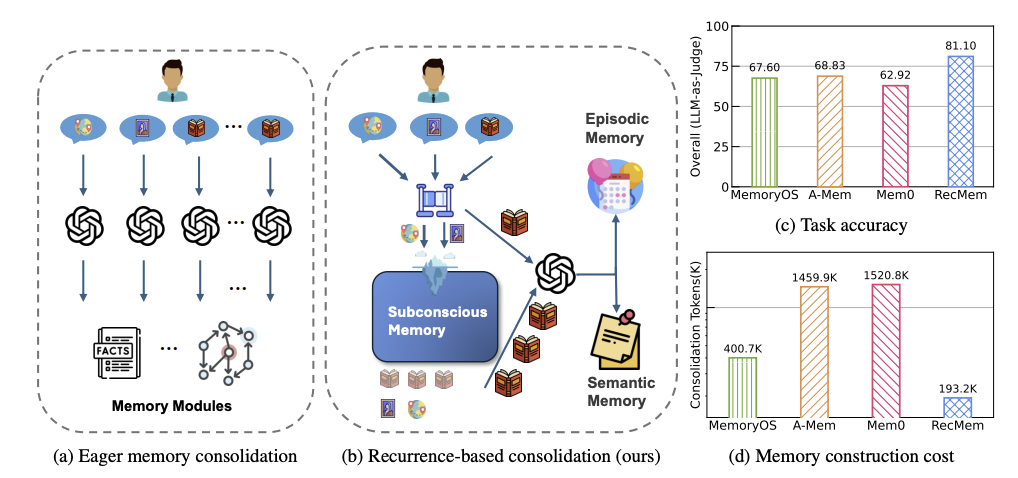
Figure 1:RecMem 与已有记忆系统的总体对比。 传统系统对每个新交互调用 LLM;RecMem 先写入潜意识记忆,只对满足语义复现条件的交互簇生成情景记忆和语义记忆。右侧同时展示 LoCoMo 上的准确率与构建 Token 成本。
Figure 1 直接呈现了论文的核心矛盾。左侧 eager consolidation 的计算路径与交互次数绑定;中间的 RecMem 则在原始交互和 LLM 之间增加了潜意识层与触发条件。右侧结果说明,选择性巩固并没有简单地用质量换成本:在记忆类基线中,RecMem 同时取得更高回答分数和显著更低的构建 Token。
RecMem 包含三层存储:
- 潜意识记忆(Subconscious Memory): 保存原始交互及其向量,是完整证据层;
- 情景记忆(Episodic Memory): 将同一主题下跨时间的交互组织为连贯事件;
- 语义记忆(Semantic Memory): 保存细粒度、原子化且可更新的事实、偏好、约束和实体关系。
整体写入流程是:
Raw Interaction → Subconscious Store → semantic recurrence Episodic Memory + Semantic Memory \text{Raw Interaction} \rightarrow \text{Subconscious Store} \xrightarrow{\text{semantic recurrence}} \text{Episodic Memory}+\text{Semantic Memory} Raw Interaction→Subconscious Storesemantic recurrence Episodic Memory+Semantic Memory
而查询时不是只检索最高层摘要,而是并行从三层取证:
M ( q ) = Retrieve s u b ( q ) ∪ Retrieve e p i ( q ) ∪ Retrieve s e m ( q ) \mathcal{M}(q)=\operatorname{Retrieve}{sub}(q)\cup \operatorname{Retrieve}{epi}(q)\cup \operatorname{Retrieve}_{sem}(q) M(q)=Retrievesub(q)∪Retrieveepi(q)∪Retrievesem(q)
这种设计让"原文细节""跨轮事件"和"原子事实"彼此补充。
四、问题定义与交互单元
给定截至时刻 t t t 的交互历史:
O 1 : t = { o 1 , o 2 , ... , o t } O_{1:t}=\{o_1,o_2,\ldots,o_t\} O1:t={o1,o2,...,ot}
每条交互可写成:
o t = ( s t , x t , τ t ) o_t=(s_t,x_t,\tau_t) ot=(st,xt,τt)
其中, s t s_t st 表示说话者, x t x_t xt 表示文本内容, τ t \tau_t τt 表示时间戳。
在具体实现中,一次用户---助手交换被视为一个 interaction unit:
u i = ( m i u s r , m i a s t , τ i ) u_i=(m_i^{usr},m_i^{ast},\tau_i) ui=(miusr,miast,τi)
这里把用户消息与助手回复绑定在一起很重要。仅保存用户问题可能丢掉 Agent 实际承诺或执行结果;仅保存助手回复又缺少触发它的语境。完整交互单元使后续的主题判断与事实恢复更可靠。
五、潜意识记忆:低成本地保留全部原始交互
1. 写入:不调用 LLM
对每个交互单元 u i u_i ui,RecMem 使用嵌入模型得到向量:
v i = Φ ( u i ) v_i=\Phi(u_i) vi=Φ(ui)
随后保存:
s i = ( v i , u i ) s_i=(v_i,u_i) si=(vi,ui)
这里的关键不是向量数据库本身,而是写入过程完全不需要 LLM 做摘要或事实抽取。即使某条交互最终没有被巩固,它仍以原始文本形式留在潜意识层,并可在未来回答阶段被直接检索。
2. 相似度过滤
新交互写入后,系统先从潜意识记忆取回 Top- k k k 近邻 N i N_i Ni,再用相似度阈值 θ s i m \theta_{sim} θsim 过滤:
R i = { s j ∈ N i ∣ cos ( v i , v j ) ≥ θ s i m } R_i=\{s_j\in N_i\mid \cos(v_i,v_j)\geq \theta_{sim}\} Ri={sj∈Ni∣cos(vi,vj)≥θsim}
R i R_i Ri 表示与当前交互在语义上足够接近的历史单元。两阶段检索的意义是:Top- k k k 限制计算范围,阈值则防止"虽然进入近邻,但实际上并不相似"的内容污染主题簇。
3. 复现触发条件
只有相关单元数达到计数阈值时才触发巩固:
∣ R i ∣ ≥ θ c o u n t |R_i|\geq \theta_{count} ∣Ri∣≥θcount
触发后形成待巩固交互簇:
C i = R i ∪ { s i } C_i=R_i\cup\{s_i\} Ci=Ri∪{si}
若条件不满足,系统到此为止,只保留原始交互。这个简单的门控把 LLM 调用次数从"每轮一次"改成"每次有效主题复现一次"。
4. 一个三轮交互例子
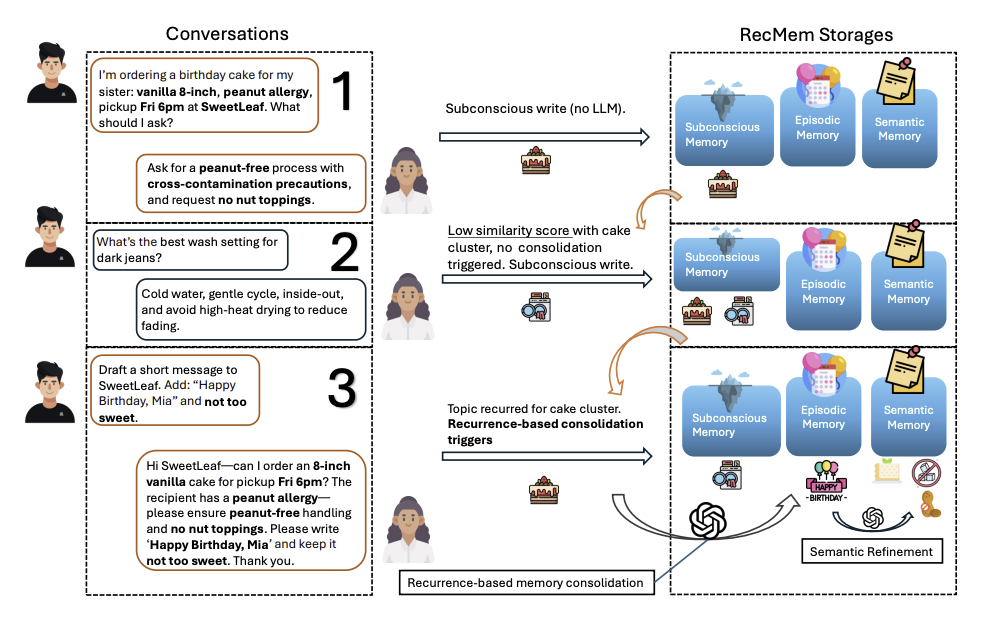
Figure 3:RecMem 的简化记忆摄取过程。 第一轮讨论生日蛋糕并写入潜意识层;第二轮转向牛仔裤清洗,因为与蛋糕主题不相似而不触发巩固;第三轮再次讨论蛋糕,主题复现达到阈值,系统才生成情景记忆并执行语义精炼。
这个例子说明,RecMem 的"复现"不是要求原句重复,而是语义主题持续出现。第一次对话包含香草蛋糕、花生过敏和取货时间;第三轮要求代写蛋糕订单。两轮表述不同,却围绕同一任务演化,因此会进入同一个交互簇。
第二轮关于深色牛仔裤的对话仍然被保存,但不会与蛋糕对话一起摘要。这样既避免无关信息干扰,又没有提前丢弃一次性内容。
六、情景记忆:把跨时间交互重建成连贯事件
1. 为什么只保留原始片段还不够
潜意识层忠实但碎片化。回答"用户为妹妹准备生日蛋糕的整个过程"时,单独返回几条相似片段会迫使回答模型自己重建事件。情景记忆的作用是把同一主题下分散在不同时间的内容组织成带有意图和时间线的叙事。
2. 按时间排序后生成事件摘要
交互簇 C i C_i Ci 中的原始单元会按照时间戳排列:
U i s e q = ( u ( 1 ) , u ( 2 ) , ... , u ( ∣ C i ∣ ) ) U_i^{seq}=(u_{(1)},u_{(2)},\ldots,u_{(|C_i|)}) Uiseq=(u(1),u(2),...,u(∣Ci∣))
然后由 LLM 生成情景记忆:
M i e p i = LLM e p i ( Format ( U i s e q ) ) M_i^{epi}=\operatorname{LLM}_{epi} \left(\operatorname{Format}(U_i^{seq})\right) Miepi=LLMepi(Format(Uiseq))
时间排序并非形式细节。主题相似度只能说明内容相关,不能说明事件先后;如果直接按向量检索次序摘要,模型可能把"计划下单""确认过敏要求""最终下单"混成错误时间线。
3. Merge-first 更新
论文还采用 merge-first 策略:新内容先检索最相近的已有情景记忆 E ∗ E^* E∗。若相似度达到合并阈值,就在原位置更新该事件:
E ∗ ← LLM m e r g e ( E ∗ , u i ) E^*\leftarrow \operatorname{LLM}_{merge}(E^*,u_i) E∗←LLMmerge(E∗,ui)
只有没有合适情景可合并、且潜意识交互簇满足复现条件时,才新建情景记忆。
这样做可以减少同一长期事件被切成多个孤立摘要。例如"计划旅行---预订酒店---改变日期---完成旅行"更适合作为一个持续演化的 episode,而不是四条互不相干的摘要。
七、语义精炼:从原始交互中补回摘要丢掉的细节
1. 情景摘要为何仍不够
LLM 摘要天然是有损压缩。它可能保留"用户为妹妹订生日蛋糕"这一主线,却省略:
- 妹妹名叫 Mia;
- 蛋糕为 8 英寸香草口味;
- 妹妹花生过敏;
- 店铺为 SweetLeaf;
- 取货时间为周五下午 6 点。
这些细节看似次要,却可能恰好是之后问题的答案。因此 RecMem 不直接把情景摘要当作唯一长期记忆,而是让语义精炼器再次查看生成该 episode 的原始交互。
2. 读取已有事实,避免重复与冲突
对新情景记忆 E E E,系统先从语义记忆库取回相关事实:
V = TopK k ( S s e m , Φ ( E ) ) V=\operatorname{TopK}{k} \left(\mathcal{S}{sem},\Phi(E)\right) V=TopKk(Ssem,Φ(E))
随后把情景摘要、原始交互簇和已有事实共同交给精炼器:
M i s e m = LLM r e f i n e ( E , U C , V ) M_i^{sem}=\operatorname{LLM}_{refine}(E,U_C,V) Misem=LLMrefine(E,UC,V)
精炼器承担两项任务:
- Detail Recovery: 回到原始交互,补回情景摘要省略的实体、时间和约束;
- Fact Maintenance: 参考已有语义记忆,避免重复写入,并维护会变化的状态。
这一步与普通"从当前消息直接抽事实"不同。它先用 episode 建立主题与事件框架,再回到 raw interactions 找细节,因此既有全局语境,也有原始证据。
八、查询阶段:三路检索而不是摘要独占
收到问题 q q q 后,RecMem 对问题编码,并分别从潜意识、情景和语义记忆中检索。论文默认检索预算为:
k s u b = 10 , k e p i = 5 , k s e m = 10 k_{sub}=10,\qquad k_{epi}=5,\qquad k_{sem}=10 ksub=10,kepi=5,ksem=10
其中:
- 潜意识记忆提供逐字细节和一次性信息;
- 情景记忆提供跨轮事件结构与时间线;
- 语义记忆提供紧凑、原子化的事实。
论文设定 k s e m = 2 k e p i k_{sem}=2k_{epi} ksem=2kepi,因为一个 episode 往往对应多个细粒度事实。三路结果共同组成回答上下文,再交由 LLM 生成最终答案。
九、实验设置
1. 数据集
LoCoMo
LoCoMo 包含 10 组人工标注的多会话长对话,平均每组约 16K Token,偏向社交和日常场景。问题包括 Multi-Hop、Temporal、Open Domain 和 Single-Hop。
LongMemEval-S
LongMemEval-S 包含 500 个长对话样本,平均约 115K Token,更接近长期任务型 Agent。问题包括 Single-Session User、Single-Session Assistant、Single-Session Preference、Temporal Reasoning、Knowledge Update 与 Multi-Session。
作者采用增量流式协议:对话按发生顺序进入记忆系统,而不是让方法预先看到完整历史。这一点对评估在线写入成本很重要。
2. 对比方法
- Full Context:直接使用完整历史;
- Naive RAG:对原始历史进行向量检索;
- Mem0:抽取并更新原子事实;
- A-Mem:使用可动态链接和演化的记忆笔记;
- MemoryOS:采用分层记忆与混合检索;
- RecMem:本文的复现触发三层记忆。
3. 模型与指标
实验使用 GPT-4o-mini 与 GPT-4.1-mini 作为回答/记忆处理骨干,嵌入模型为 text-embedding-3-small,温度设为 0。主指标由 GPT-4o-mini 充当 LLM-as-a-Judge,结果取三次运行平均值;附录同时报告词面 F1。
成本分为两类:
- Construction Tokens: 每段对话建立和更新记忆所消耗的 Token;
- Query Tokens: 每个问题在回答阶段使用的 Token。
RecMem 的核心优化对象是第一项,而不是宣称把所有查询成本也降到最低。
十、主实验结果
1. LoCoMo:在记忆系统中最好,但 Full Context 仍有优势
GPT-4.1-mini Multi Temp. Open Single Overall Build(K) Query(K) Full Context 82.62 79.13 57.29 90.84 84.18 0 31.52 Naive RAG 58.87 33.96 50.00 61.24 54.42 0 6.28 MemoryOS 66.31 47.66 55.21 77.05 67.60 400.7 5.04 Mem0 58.16 63.86 44.79 66.23 62.92 1520.8 2.11 A-Mem 59.93 72.90 42.71 73.25 68.83 1459.9 5.56 RecMem 78.37 75.39 57.29 86.92 81.10 193.2 2.75 \begin{array}{l|rrrr|r|rr} \text{GPT-4.1-mini} & \text{Multi} & \text{Temp.} & \text{Open} & \text{Single} & \text{Overall} & \text{Build(K)} & \text{Query(K)}\\ \hline \text{Full Context} & 82.62 & 79.13 & 57.29 & 90.84 & 84.18 & 0 & 31.52\\ \text{Naive RAG} & 58.87 & 33.96 & 50.00 & 61.24 & 54.42 & 0 & 6.28\\ \text{MemoryOS} & 66.31 & 47.66 & 55.21 & 77.05 & 67.60 & 400.7 & 5.04\\ \text{Mem0} & 58.16 & 63.86 & 44.79 & 66.23 & 62.92 & 1520.8 & 2.11\\ \text{A-Mem} & 59.93 & 72.90 & 42.71 & 73.25 & 68.83 & 1459.9 & 5.56\\ \textbf{RecMem} & \textbf{78.37} & \textbf{75.39} & \textbf{57.29} & \textbf{86.92} & \textbf{81.10} & \textbf{193.2} & \textbf{2.75} \end{array} GPT-4.1-miniFull ContextNaive RAGMemoryOSMem0A-MemRecMemMulti82.6258.8766.3158.1659.9378.37Temp.79.1333.9647.6663.8672.9075.39Open57.2950.0055.2144.7942.7157.29Single90.8461.2477.0566.2373.2586.92Overall84.1854.4267.6062.9268.8381.10Build(K)00400.71520.81459.9193.2Query(K)31.526.285.042.115.562.75
Table 1:LoCoMo 上 GPT-4.1-mini 的回答质量与 Token 成本。 RecMem 在所有记忆构建方法中取得最高 Overall,同时将构建成本降至 193.2K;Full Context 的 Overall 仍略高,但查询上下文达到 31.52K。
这张表需要分两层理解。
第一,RecMem 并没有超过 Full Context:84.18 对 81.10。LoCoMo 平均只有约 16K Token,完整历史仍可被模型直接读取,因此保留所有上下文具有天然优势。严谨的结论应是"RecMem 是最好的记忆型方法",而不是"RecMem 是全表第一"。
第二,RecMem 的构建成本只有 Mem0 的约 1 / 7.87 1/7.87 1/7.87、A-Mem 的约 1 / 7.56 1/7.56 1/7.56:
1 − 193.2 1520.8 = 87.3 % 1-\frac{193.2}{1520.8}=87.3\% 1−1520.8193.2=87.3%
1 − 193.2 1459.9 = 86.8 % 1-\frac{193.2}{1459.9}=86.8\% 1−1459.9193.2=86.8%
也就是说,它用约七到八分之一的构建 Token,反而取得了明显更高的总体分数。结果支持的不是"摘要越多越好",而是"选择正确的巩固时机比逐轮加工更重要"。
GPT-4o-mini 下趋势相同:RecMem Overall 为 72.47,高于 MemoryOS 的 63.64、A-Mem 的 60.84 和 Mem0 的 58.64;其构建成本为 202.4K,仍显著低于 Mem0 的 1233.5K 与 A-Mem 的 1143.3K。
2. LongMemEval-S:历史真正变长后,RecMem 超过 Full Context
GPT-4.1-mini User Assist. Pref. Temp. Update Multi Overall Build(K) Query(K) Full Context 91.43 100.00 56.67 48.12 75.64 53.38 66.20 0 112.25 Naive RAG 85.71 82.36 83.33 45.86 75.64 63.91 67.00 0 11.93 MemoryOS 94.29 89.29 100.00 54.89 80.77 67.67 74.40 669.22 9.19 Mem0 95.71 50.00 90.00 62.41 74.36 69.92 71.20 1626.54 2.00 A-Mem 95.71 100.00 63.33 52.63 82.05 61.65 71.60 1264.25 15.46 RecMem 95.71 96.43 86.67 68.42 75.64 65.41 76.80 365.49 5.89 \begin{array}{l|rrrrrr|r|rr} \text{GPT-4.1-mini} & \text{User} & \text{Assist.} & \text{Pref.} & \text{Temp.} & \text{Update} & \text{Multi} & \text{Overall} & \text{Build(K)} & \text{Query(K)}\\ \hline \text{Full Context} & 91.43 & 100.00 & 56.67 & 48.12 & 75.64 & 53.38 & 66.20 & 0 & 112.25\\ \text{Naive RAG} & 85.71 & 82.36 & 83.33 & 45.86 & 75.64 & 63.91 & 67.00 & 0 & 11.93\\ \text{MemoryOS} & 94.29 & 89.29 & 100.00 & 54.89 & 80.77 & 67.67 & 74.40 & 669.22 & 9.19\\ \text{Mem0} & 95.71 & 50.00 & 90.00 & 62.41 & 74.36 & 69.92 & 71.20 & 1626.54 & 2.00\\ \text{A-Mem} & 95.71 & 100.00 & 63.33 & 52.63 & 82.05 & 61.65 & 71.60 & 1264.25 & 15.46\\ \textbf{RecMem} & \textbf{95.71} & \textbf{96.43} & \textbf{86.67} & \textbf{68.42} & \textbf{75.64} & \textbf{65.41} & \textbf{76.80} & \textbf{365.49} & \textbf{5.89} \end{array} GPT-4.1-miniFull ContextNaive RAGMemoryOSMem0A-MemRecMemUser91.4385.7194.2995.7195.7195.71Assist.100.0082.3689.2950.00100.0096.43Pref.56.6783.33100.0090.0063.3386.67Temp.48.1245.8654.8962.4152.6368.42Update75.6475.6480.7774.3682.0575.64Multi53.3863.9167.6769.9261.6565.41Overall66.2067.0074.4071.2071.6076.80Build(K)00669.221626.541264.25365.49Query(K)112.2511.939.192.0015.465.89
Table 2:LongMemEval-S 上 GPT-4.1-mini 的回答质量与 Token 成本。 在平均约 115K Token 的长历史中,RecMem 的 Overall 达到 76.80,超过 Full Context、RAG 和全部记忆基线,同时显著降低记忆构建成本。
LongMemEval-S 更能体现长期 Agent 的真实压力。完整上下文的 Query Tokens 达到 112.25K,但 Overall 只有 66.20;RecMem 用 5.89K 查询 Token 达到 76.80。
构建阶段,RecMem 相比 Mem0 节省:
1 − 365.49 1626.54 = 77.5 % 1-\frac{365.49}{1626.54}=77.5\% 1−1626.54365.49=77.5%
相比 A-Mem 节省:
1 − 365.49 1264.25 = 71.1 % 1-\frac{365.49}{1264.25}=71.1\% 1−1264.25365.49=71.1%
RecMem 最稳定的优势出现在 Temporal Reasoning:68.42,高于第二名 Mem0 的 62.41。原因与其结构相吻合:语义相似度把跨时间的同主题提及聚合起来,时间排序再重建事件顺序,语义精炼则补回具体时间事实。
但 RecMem 并非每一列都最好:
- Preference 上 MemoryOS 达到 100.00;
- Assistant 相关问题中 Full Context 与 A-Mem 达到 100.00;
- Knowledge Update 上 A-Mem 为 82.05;
- Multi-Session 上 Mem0 为 69.92。
所以论文证明的是更好的总体质量---成本平衡,而不是对所有问题类型的绝对支配。
十一、消融实验:真正不可替代的是哪一层
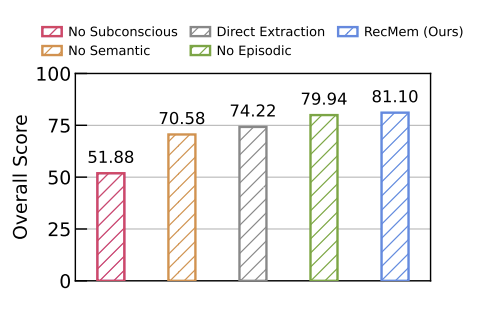
Figure 2:RecMem 在 LoCoMo 上的消融实验。 完整模型得分 81.10;移除潜意识记忆后降至 51.88,移除语义记忆为 70.58,直接抽取为 74.22,移除情景记忆为 79.94。
1. No Subconscious:51.88
从 81.10 暴跌到 51.88,说明潜意识记忆绝不是一个可有可无的缓存。它是唯一完整保存原始交互的层,也是 recurrence 检测和细节恢复的共同基础。
尤其对于只出现一次的事实,既没有足够复现信号形成 episode,也未必进入语义精炼结果;此时只有潜意识检索能够找回它。
2. No Semantic:70.58
去掉语义记忆后下降 10.52 分,说明事件摘要不足以代替原子事实。Episode 擅长回答"发生了什么",却容易压缩人名、日期、数量与约束。语义精炼是 RecMem 抵抗摘要损失的主要模块。
3. No Episodic:79.94
移除情景记忆只下降 1.16 分,表面上似乎 episode 不重要,但不能据此断言可以删除它。一方面,语义事实和原始片段已经覆盖许多问答;另一方面,情景摘要为语义精炼提供了事件级参考,使事实抽取知道哪些交互属于同一主题。
4. Direct Extraction:74.22
Direct Extraction 不先形成 episode,而直接从原始交互抽取事实。它比 No Semantic 好,却明显低于完整模型。这说明"多做一次 LLM 调用"本身不是收益来源;收益来自先建立事件级语境,再以该语境指导细节恢复与事实维护。
十二、超参数与效率分析
1. 相似度阈值与复现次数
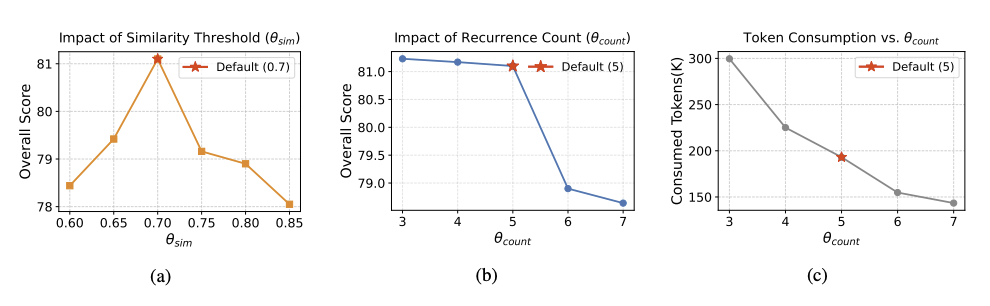
Figure 4:LoCoMo 上巩固阈值的敏感性。 相似度阈值 θ s i m \theta_{sim} θsim 在 0.7 附近达到峰值;提高复现阈值 θ c o u n t \theta_{count} θcount 会平滑降低构建 Token,但从 5 提高到 6 时质量明显下降。
θ s i m \theta_{sim} θsim 太低时,无关交互会被错误合并,生成主题不纯的摘要;太高时,同一主题的不同表述被拆散,复现信号无法积累。LoCoMo 的最佳点约为 0.7。
θ c o u n t \theta_{count} θcount 决定系统有多保守。阈值低会更早、更频繁地巩固,每次处理的交互簇更小,细节压缩较少,但成本更高;阈值高能节省 Token,却可能让真正反复出现的主题迟迟无法被提升,而且最终交互簇过大,摘要难度反而上升。
论文在 LoCoMo 使用 θ s i m = 0.7 , θ c o u n t = 5 \theta_{sim}=0.7,\theta_{count}=5 θsim=0.7,θcount=5,在 LongMemEval-S 使用 θ s i m = 0.6 , θ c o u n t = 4 \theta_{sim}=0.6,\theta_{count}=4 θsim=0.6,θcount=4。这也说明阈值不是跨场景通用常数。
2. 检索预算的边际收益
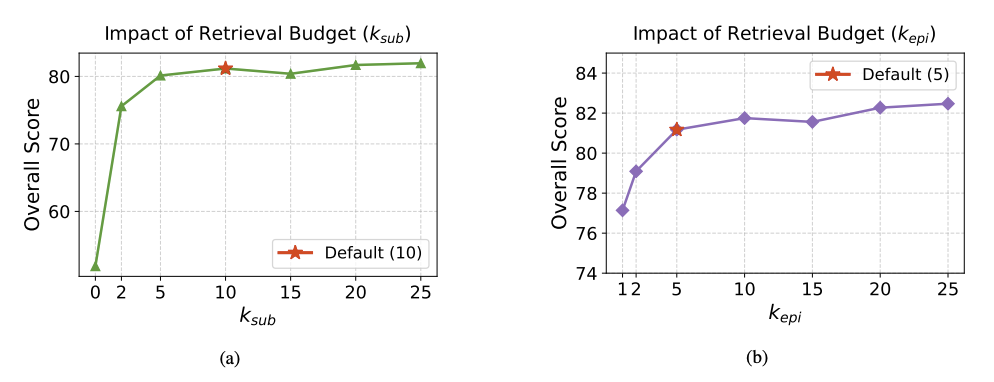
Figure 5:LoCoMo 上检索预算的敏感性。 潜意识和情景记忆预算从极小值增加时得分快速提升,随后进入边际收益递减区间;默认取 k s u b = 10 , k e p i = 5 , k s e m = 10 k_{sub}=10,k_{epi}=5,k_{sem}=10 ksub=10,kepi=5,ksem=10。
当 k s u b = 0 k_{sub}=0 ksub=0 时,系统失去原始证据通道,性能大幅下降;从 0 增到 5 时收益最明显,之后继续扩大预算只带来小幅变化。情景记忆也有类似趋势。
默认值不是追求曲线最高点,而是在质量和查询上下文长度之间取紧凑平衡。这与论文整体思想一致:不是把所有可能信息都送给 LLM,而是让有限计算聚焦于最可能有用的证据。
3. F1 与 LLM-as-a-Judge 的差异
附录中的词面 F1 并不总与主指标一致。例如 GPT-4o-mini 下,MemoryOS 的 F1 为 0.456,高于 RecMem 的 0.385,但 Judge 分数却是 63.6 对 72.47。
这说明长记忆问答中,正确语义与参考答案的逐词重合并不等价。另一方面,它也提醒我们:RecMem 的优势主要由 LLM Judge 指标确认,评价结论仍会受到裁判模型与提示词的影响。
十三、横向比较:RecMem 在 Agent Memory 演进中的位置
1. 与 A-MEM
A-MEM 的核心是让记忆笔记动态建立链接并演化,解决静态、孤立存储的问题。RecMem 则解决"每条交互是否都值得调用 LLM 加工"的问题。
- A-MEM 关注记忆之间怎样组织;
- RecMem 关注何时启动昂贵组织过程。
两者具有组合空间:先用 recurrence trigger 决定哪些主题值得提升,再用 A-MEM 式链接组织已经提升的记忆。
2. 与 MAGMA
MAGMA 用多粒度、多图结构增强记忆表达和检索,适合复杂关系推理;RecMem 的存储结构更简单,但写入成本更低。
如果说 MAGMA 在扩大长期记忆的结构容量,RecMem 则在增加一道"晋升门槛"。未来可以让反复出现的交互簇进入 MAGMA 的图结构,避免每条原始事件都触发昂贵建图。
3. 与 CoM
CoM 更关心如何压缩和组织既有历史,RecMem 更关心哪些历史值得被压缩。RecMem 的潜意识层还提供了一个重要补丁:即使高层压缩遗漏细节,原始交互仍然保留并可查询。
4. 与 ReMemR1
ReMemR1 解决的是记忆写入时缺乏回看能力:Agent 可以 callback 历史记忆,修正边读边记产生的信息损失。RecMem 也回看原始历史,但目的不同:
- ReMemR1 用主动回溯改善每次记忆更新的推理质量;
- RecMem 用复现检测减少不必要的记忆更新次数。
一个自然组合是:RecMem 负责判断"现在是否需要巩固",触发后由 ReMemR1 式策略决定"应该回看哪些旧记忆再写入"。
5. 与 Mem²Evolve
Mem²Evolve 强调记忆策略根据任务反馈不断演化,而 RecMem 的触发条件仍由固定阈值控制。二者结合后,Agent 可以根据后续问答失败、用户纠正或任务收益,学习不同主题的巩固阈值,而不是人工给所有主题设置同一个 θ s i m \theta_{sim} θsim 和 θ c o u n t \theta_{count} θcount。
十四、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
1. Coding Agent:不要为每条终端输出都建长期记忆
Coding Agent 会产生大量中间信息:搜索结果、编译日志、失败栈、临时假设、测试输出。如果逐条摘要,不仅成本高,还会把一次性噪声固化为长期知识。
可以仿照 RecMem:
- 原始日志低成本进入潜意识层;
- 某个错误跨多次构建持续出现时,才生成"故障 episode";
- 从 episode 中抽取稳定事实,如受影响模块、复现条件、最终修复方式;
- 查询时仍保留回看原始日志的入口。
这能把"偶发报错"与"项目级长期故障模式"区分开。
2. Tool Agent:用复现判断稳定偏好
用户一次选择某个航班、酒店或输出格式,不一定代表长期偏好。若系统立即写成"用户总是喜欢......",很容易过度概括。
复现触发提供了更稳妥的偏好形成机制:先保存每次工具选择,只有相似选择跨任务反复出现,才提升为语义偏好;但对于安全限制、过敏信息、预算上限等高风险约束,不能机械等待复现,应设置立即晋升规则。
3. Multi-Agent:共享记忆也需要写入调度
多 Agent 系统中,每个子 Agent 都会产生观察和结论。若所有消息都进入共享记忆并由 LLM 重写,成本与冲突都会放大。
可以把重复出现的跨 Agent 结论视为巩固信号:多个 Agent 独立观察到同一依赖问题、用户约束或环境状态时,再将其提升为共享语义记忆。这里的 recurrence 不只来自时间,也可以来自不同 Agent 的交叉验证。
十五、失败场景与局限性
1. 罕见但关键的信息不会"反复出现"
复现只是重要性的代理信号。一次性安全要求、唯一密码恢复提示、罕见过敏原或不可逆操作约束,可能只出现一次,却极其重要。
潜意识层能保证它们不被物理删除,但如果检索器没有在查询时找到它们,它们就不会获得 episode 与语义事实带来的高层可见性。因此实际系统需要"复现触发 + 显式重要性触发 + 风险规则"混合策略。
2. 静态阈值依赖数据分布
LoCoMo 与 LongMemEval-S 使用不同的阈值,说明主题密度、对话风格和向量模型变化都会影响触发行为。阈值过低会错误聚类,过高则会错过复现。
更合理的方向是让阈值随主题、用户、任务风险以及历史密度自适应,甚至由下游问答反馈学习。
3. 语义相似不等于同一事件
"给妹妹订生日蛋糕"和"公司庆典订蛋糕"在向量空间中可能相近,却属于不同实体和事件;反过来,同一事件中的"改期"与"酒店退款"表面词汇可能差异很大。
只用 cosine similarity 难以稳定处理实体身份、否定、因果关系和状态变化。论文提到的方法可扩展到知识图谱或混合检索,但当前实现仍主要依赖向量语义。
4. 评价依赖 LLM Judge
主结果以 GPT-4o-mini 评分,附录 F1 与 Judge 的排序存在差异。虽然 LLM Judge 更能识别语义等价答案,但也可能受提示词、表达风格和裁判模型偏好影响。
此外,LoCoMo 中各基线沿用其原始回答提示,而 LongMemEval 使用较统一的回答主体。不同提示长度和格式可能影响结果,尤其会影响词面 F1。因此结果足以支持强趋势,但不能把小幅差异解释为绝对能力差距。
5. 成本统计不是完整系统成本
论文重点统计 LLM Token。潜意识层仍需要嵌入计算、向量索引、存储和近邻检索;随着原始交互不断累积,这部分成本也会增长。生产环境还需要考虑索引维护、隐私删除、冷数据归档以及跨租户隔离。
十六、我的理解与启发
1. RecMem 真正改变的是 Memory Policy
本文最值得借鉴的并非"三层记忆"本身,而是把记忆系统拆成两个决策:
- 这条信息是否保存?
- 什么时候值得进行高成本加工?
传统系统经常把两者绑定:不立即抽取,就仿佛没有记住。RecMem 用廉价原始存储把它们解耦,使 Agent 可以"先保留证据,后决定是否理解"。
2. 复现是一种在线价值估计
在看不到未来问题时,系统很难知道当前信息是否重要。复现次数提供了一种无需任务标签的在线价值估计:主题持续回来,说明它更可能与长期目标、稳定偏好或未完成任务相关。
它不完美,但比每轮都让 LLM重新判断重要性更便宜,也比固定时间窗口更符合信息本身的演化。
3. 原始证据层是摘要系统的必要保险
消融中 No Subconscious 从 81.10 降到 51.88,是整篇论文最有说服力的结果之一。它提醒我们,摘要、事实和图结构都不应成为唯一真相来源。
对于长期 Agent,更稳健的架构应该始终保留一条通向原始证据的路径:高层记忆负责提高召回和理解效率,原始记录负责纠错、追溯和恢复被压缩掉的细节。
4. 下一步不应只是学习一个全局阈值
真正有潜力的方向是学习"分类型巩固策略":
- 安全与不可逆约束:首次出现立即巩固;
- 用户偏好:多次复现后巩固;
- 任务状态:发生改变时更新;
- 普通闲聊:高阈值或长期不巩固;
- 已被后续问题命中的原始记忆:提高未来晋升概率。
这会让 recurrence 从一个启发式计数器,演化成带风险、收益和反馈的 memory policy。
十七、总结
RecMem 没有通过更频繁的 LLM 处理来构建更强记忆,而是反过来追问:哪些交互真的值得被加工成长时记忆?
它先把全部原始交互写入潜意识向量库;当新交互找到足够多语义相关的历史单元时,才触发 LLM,将相关内容整理为时间连贯的情景记忆,并通过语义精炼恢复摘要遗漏的原子事实。查询阶段再联合检索原始、情景和语义三层证据。
实验显示,RecMem 在 LoCoMo 上以 193.2K 构建 Token 达到 81.10 分,相比 Mem0 和 A-Mem 节省约 87% 构建 Token;在平均约 115K Token 的 LongMemEval-S 上,它以 76.80 的总体分数超过 Full Context、RAG 与所有记忆基线。消融进一步证明,完整保留原始交互的潜意识层是系统最不可替代的部分。
一句话总结:
RecMem 的核心不是"记得更多",而是"先完整保存,等主题真正反复出现时再认真巩固",从而让长期 Agent 的记忆质量与构建成本同时变得可控。
参考资料
- RecMem: Recurrence-based Memory Consolidation for Efficient and Effective Long-Running LLM Agents,Findings of ACL 2026。
- LoCoMo: Evaluating Very Long-Term Conversational Memory of LLM Agents。
- LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory。
- A-MEM: Agentic Memory for LLM Agents。
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory。
- MemoryOS: An Operating System for AI System Memory。