一、介绍
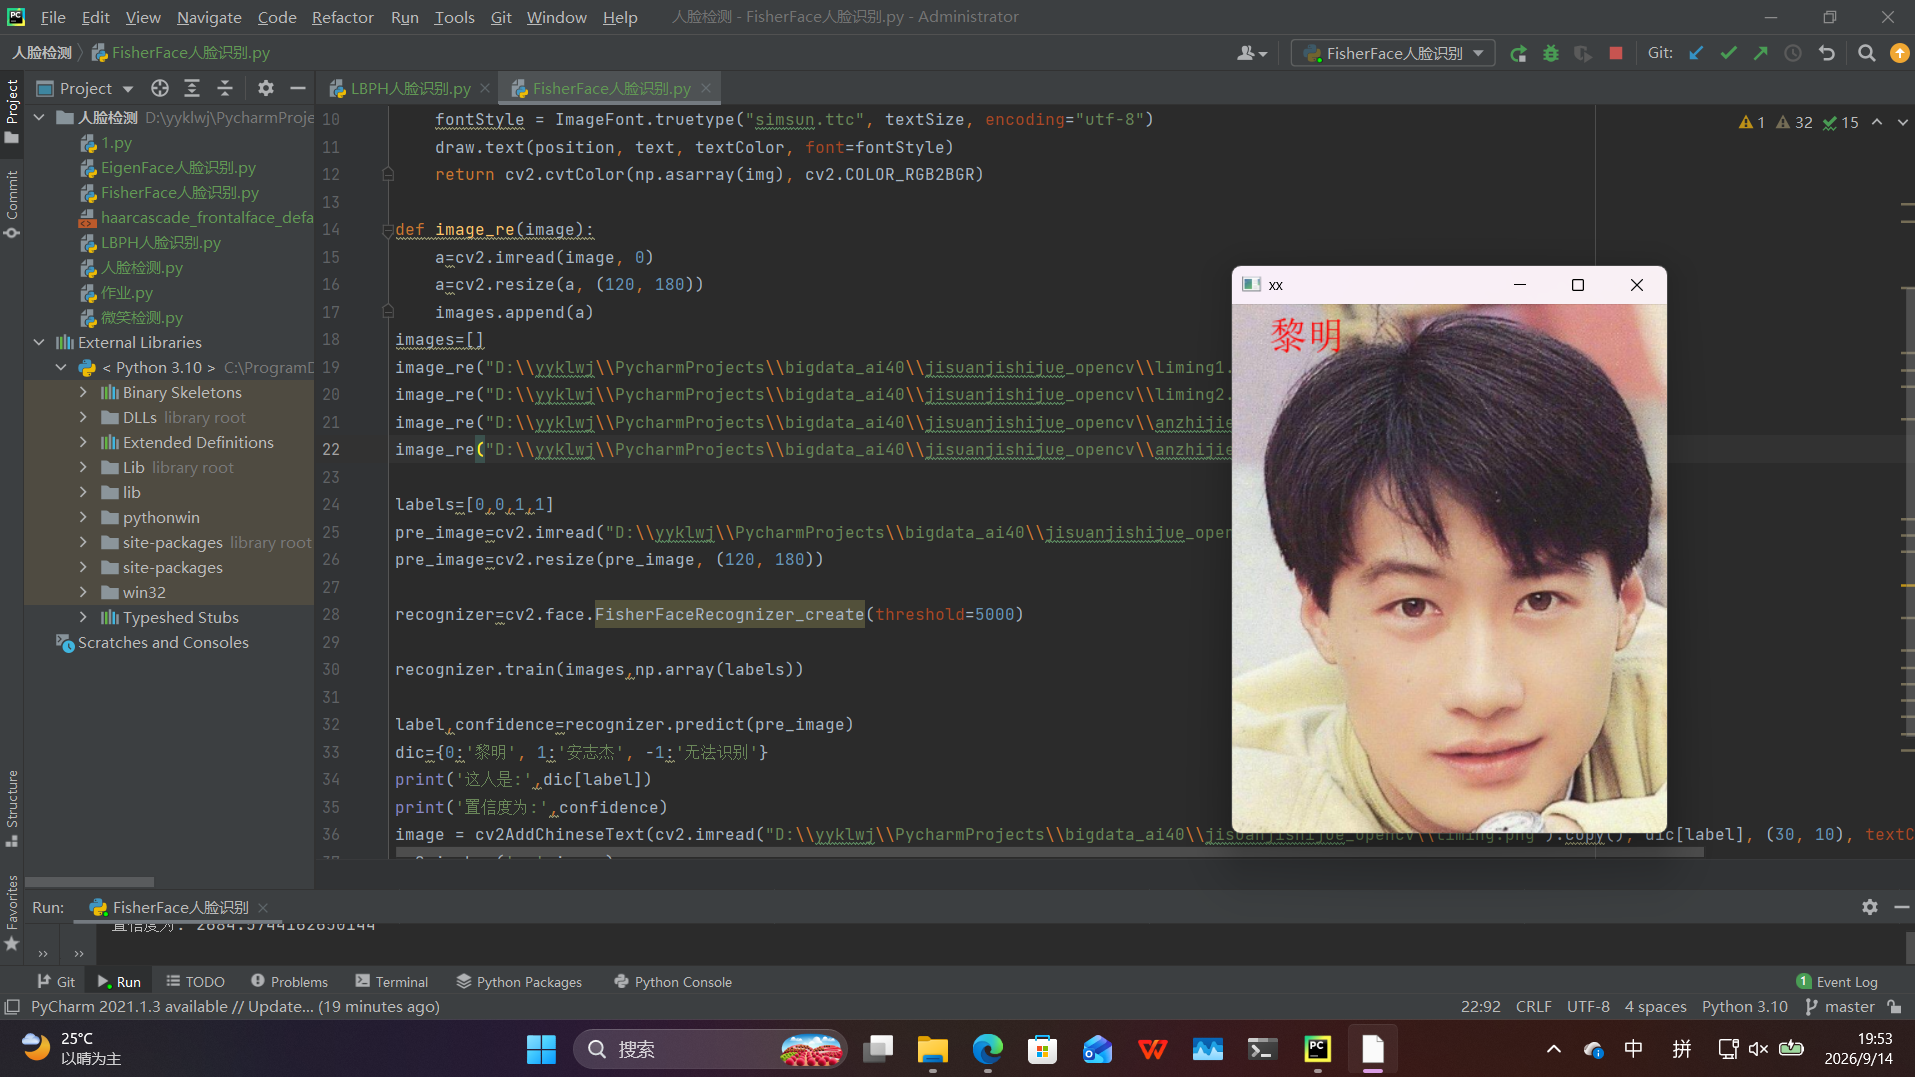
本次实现了一个基于OpenCV的FisherFace人脸识别的小示例,先读取几张已知人脸作为训练集,再读取一张待识别图片,训练FisherFace模型并预测它属于谁,最后把识别结果用中文画在图片上显示。
二、核心代码讲解
2.1导入库
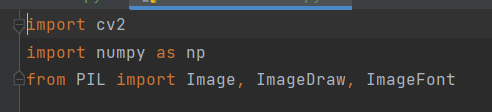
cv2:OpenCV,用于读图、缩放、人脸识别、显示图像。
numpy:用于数值操作,训练标签需要转成np.array。
PIL:Python Imaging Library,这里主要用来在OpenCV图像上绘制中文,因为OpenCV自带的cv2.putText不支持中文。
2.2中文绘制函数
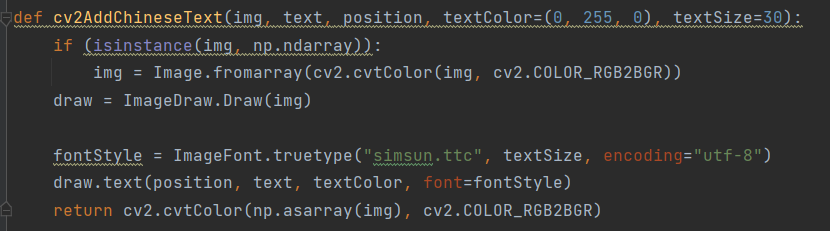
cv2AddChineseText这个函数的作用是:在OpenCV图像上写中文。
img:OpenCV图像。
text:要写的中文。
position:文字左上角坐标,例如(30,10)。
textColor:RGB颜色,默认绿色(0,255,0)。
textSize:字号。
关键点:
1.OpenCV默认颜色顺序是BGR,而PIL默认是RGB。
所以先用cv2.cvtColor(img,cv2.COLOR_RGB2BGR)把OpenCV图像转成PIL能正确显示的颜色。
2.使用**ImageFont.truetype("simsun.ttc", textSize, encoding="utf-8")**加载宋体字体。
3.**draw.text(position, text, textColor, font=fontStyle)**在指定位置画文字。
4.最后再转回OpenCV的BGR格式,方便cv2.imshow显示。
2.3读取并预处理训练图片
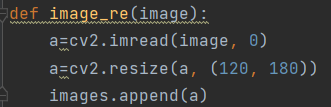
cv2.imread(img,0):以灰度图方式读取图片。
FisherFace训练通常使用灰度图,因为颜色信息对身份识别帮助不大,还会增加计算量。
cv2.resize(a,(120 180)):把图片统一缩放成宽120、高180。所有人脸图片必须尺寸一致,否则无法训练。
images.append(a):把处理后的图片加入全局列表images。
2.4准备训练数据并读取待预测图片
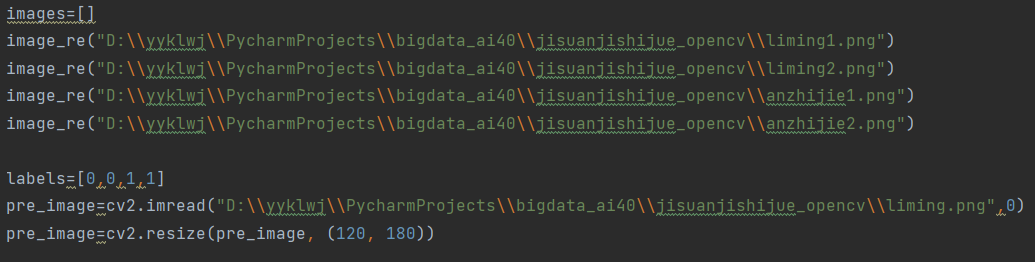
前两张是黎明,标签为0。
后两张是安志杰,标签为1。
读取待识别图片liming.png,同样转灰度并缩放到120*180
模型理想情况下应预测为0,即"黎明"。
2.5创建FisherFace识别器

这行创建一个FisherFace人脸识别模型。
FisherFace的核心思想是:
使用LDA,线性判别分析。
它不只想PCA那样保留最大方差方向,而是利用类别标签,让同类样本尽量聚在一起,不同类样本尽量分开。
因此,FisherFace通常比EigenFace更适合做分类。
OpenCV内部通常会先做PCA降维,再做LDA,避免类内散度矩阵不可逆。
threshold=5000是预测阈值:
predict()会返回一个confidence,可以理解为距离或置信度,越小表示越可信。
如果最小距离大于5000,模型就认为无法识别,返回标签-1。
2.6训练模型和预测
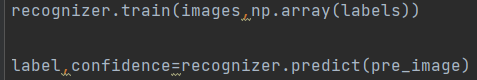
images:训练图片列表,每张都是120*180的灰度图。
labels:对应标签,必须转成np.array。
训练后,模型会学习如何把不同人脸投影到一个更容易区分的空间。
label:预测出的类别标签。
confidence:置信度,越小越好。
2.7结果