深入理解 JVM 内存模型:从堆栈结构到 GC 日志分析实战
写在前面:本文以 JDK 21 为基础,系统讲解 JVM 内存区域划分、对象内存布局、垃圾回收算法演进(CMS → G1 → ZGC),并结合 GC 日志进行调优案例分析。全文以技术原理 + 代码/命令演示的方式展开,帮助读者建立完整的 JVM 知识体系。
目录
- [一、JVM 内存区域全景图](#一、JVM 内存区域全景图)
- 二、对象创建过程与内存布局
- 三、垃圾回收算法对比
- [四、G1 与 ZGC 原理深度剖析](#四、G1 与 ZGC 原理深度剖析)
- [五、实战:用 JFR + GC 日志定位 Full GC 频发问题](#五、实战:用 JFR + GC 日志定位 Full GC 频发问题)
- 六、调优参数推荐与避坑指南
- 七、总结
一、JVM 内存区域全景图
JVM 在运行时会将内存划分为多个区域,每个区域有各自的用途和生命周期。理解这些区域是 GC 调优的基础。
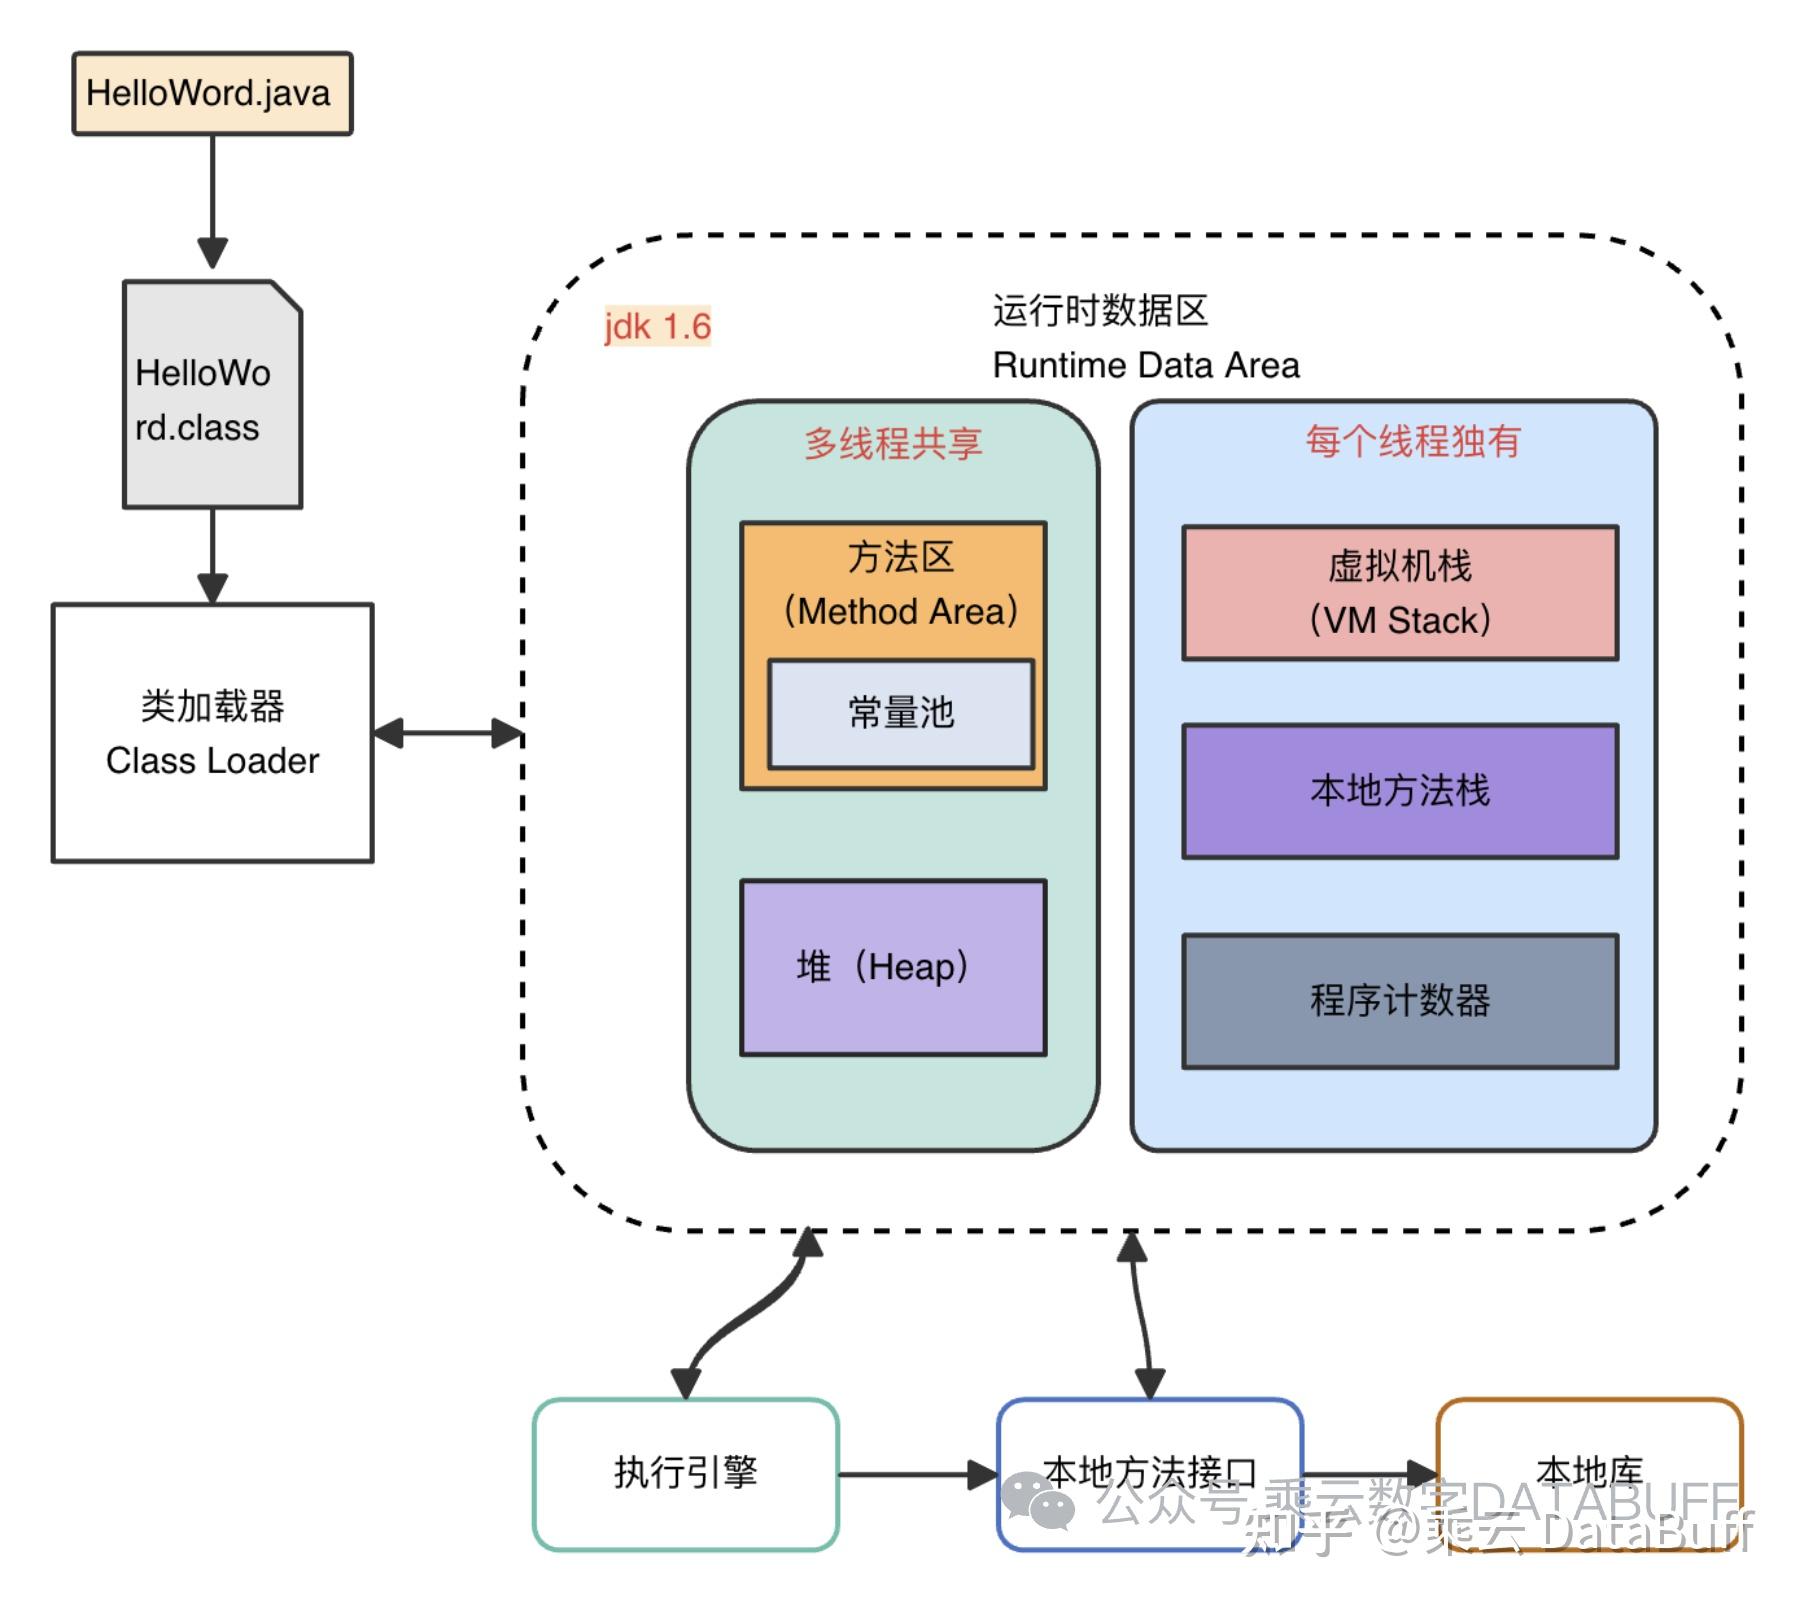
1.1 程序计数器(Program Counter Register)
- 作用:记录当前线程执行的字节码行号
- 特点:线程私有,内存极小,不会 OOM
- 注意:执行 Native 方法时,PC 计数器值为 undefined
1.2 虚拟机栈(VM Stack)
- 作用:每个方法执行时创建一个栈帧,存储局部变量表、操作数栈、动态链接、方法出口
- 特点:线程私有,随方法调用入栈/出栈
- 异常 :栈深度超限 →
StackOverflowError;无法分配新栈帧 →OutOfMemoryError
java
// 经典的栈溢出演示
public class StackOverflowDemo {
    private static int depth = 0;

    public static void main(String[] args) {
        try {
            recursiveCall();
        } catch (StackOverflowError e) {
            System.out.println("栈深度达到: " + depth);
        }
    }

    public static void recursiveCall() {
        depth++;
        recursiveCall();  // 无限递归,最终触发 StackOverflowError
    }
}
在不同栈大小配置下运行,结果不同:
# 默认栈大小(通常512KB~1MB)
栈深度达到: 24578

# -Xss256k
栈深度达到: 9847

# -Xss4m
栈深度达到: 195432
1.3 本地方法栈(Native Method Stack)
与虚拟机栈类似,区别在于服务对象是 Native 方法。HotSpot 将两者合为一谈。
1.4 堆(Heap)
-
作用:存放对象实例和数组,GC 的主战场
-
特点:所有线程共享,在虚拟机启动时创建
-
JDK 21 的堆划分(以 G1 为例):
┌─────────────────────────────────────────┐
│ Heap │
│ ┌─────┐ ┌─────┐ ┌─────┐ ┌─────┐ │
│ │ Eden│ │ Sur │ │ Old │ │ Hum │ ... │
│ │ Re │ │ viv │ │ Re │ │ ong │ │
│ │ gion│ │ or │ │ gion│ │ ours│ │
│ └─────┘ └─────┘ └─────┘ └─────┘ │
│ Region (1~32MB, 统一大小) │
└─────────────────────────────────────────┘
注意:G1 的堆划分与传统分代模型不同。G1 将堆划分为多个等大的 Region,逻辑上标记为 Eden、Survivor、Old、Humongous,但物理上不连续。这一点在第四章会详细展开。
1.5 方法区 / 元空间(Metaspace)
| 对比项 | JDK 7 之前 | JDK 8+ |
|---|---|---|
| 实现方式 | 永久代(PermGen),在堆中 | 元空间(Metaspace),使用本地内存 |
| 默认大小 | 64MB/82MB | 无上限(受限于物理内存) |
| 存储内容 | 类元信息、常量池、静态变量 | 类元信息、类加载器(静态变量移到堆) |
| OOM 类型 | PermGen space |
Metaspace |
为什么废弃永久代?
- 永久代大小固定,难以调优。应用加载大量类时容易 OOM
- 字符串常量池在永久代中,导致
intern()性能问题 - JRockit 和 HotSpot 融合的需要
1.6 直接内存(Direct Memory)
- 作用 :NIO 使用
ByteBuffer.allocateDirect()分配堆外内存,避免数据在内核空间和用户空间之间来回复制 - 特点:不受堆大小限制,但受物理内存限制
- 配置 :
-XX:MaxDirectMemorySize默认与-Xmx相同
java
// NIO 零拷贝示例
ByteBuffer buffer = ByteBuffer.allocateDirect(1024 * 1024);  // 1MB 堆外内存
注意 :直接内存不归 GC 管理(Netty 的
ByteBuf有自己的引用计数管理)。如果分配后不手动释放,可能导致内存泄漏。这也是 Netty 应用最常见的问题之一。
1.7 运行时常量池
JDK 8 之后,运行时常量池位于堆中。除了类文件中的常量池,还包括运行期间动态加入的常量,如 String.intern() 的结果。
java
// String.intern() 演示
// JDK 8+ 中,intern() 会将字符串引用放入堆中的 StringTable
String s1 = new String("hello") + new String("world");  // 创建了多个对象
String s2 = "helloworld";                                 // 常量池中查找
System.out.println(s1.intern() == s2);  // JDK8: true
二、对象创建过程与内存布局
2.1 对象创建的完整流程
当虚拟机遇到 new 字节码指令时,对象创建流程如下:
new 指令
   │
   ▼
① 类加载检查(是否已加载、解析、初始化)
   │
   ▼
② 分配内存(指针碰撞 / 空闲列表)
   │
   ▼
③ 内存空间初始化为零值(不含对象头)
   │
   ▼
④ 设置对象头(Mark Word、类型指针、数组长度)
   │
   ▼
⑤ 执行 <init> 构造方法(赋初始值等)
   │
   ▼
⑥ 引用指向对象地址(栈帧局部变量表)内存分配方式:
| 方式 | 适用场景 | 原理 |
|---|---|---|
| 指针碰撞 | 内存规整(Serial/ParNew) | 移动指针,分配连续空间 |
| 空闲列表 | 内存碎片化(CMS) | 维护空闲块列表,查找合适大小 |
并发安全:
- CAS + 失败重试:分配时用 CAS 原子操作更新指针
- TLAB(Thread Local Allocation Buffer):每个线程预分配一小块内存,在本地缓冲区上分配,避免竞争
bash
# 查看 TLAB 相关参数
java -XX:+PrintFlagsFinal -version | grep TLAB

# 关键参数
# TLAB_REFILL_WASTE_LIMIT  默认值影响浪费率
# TLAB_SIZE  默认大小
2.2 对象内存布局
在 HotSpot 虚拟机中,一个 Java 对象在内存中由三部分组成:
┌─────────────────────────────────┐
│         对象头 (Object Header)  │
│  ┌───────────────────────────┐  │
│  │  Mark Word (64bit)        │  │  ← 锁信息、hashcode、GC分代年龄
│  ├───────────────────────────┤  │
│  │  类型指针 (Klass Pointer) │  │  ← 指向方法区的 Class 元数据
│  └───────────────────────────┘  │
├─────────────────────────────────┤
│         实例数据 (Instance Data) │  ← 各字段值,含填充字段
├─────────────────────────────────┤
│         对齐填充 (Padding)      │  ← 保证对象大小是8的整数倍
└─────────────────────────────────┘
2.3 Mark Word 详解
Mark Word 是对象头的核心,在 64 位系统中占 8 字节。它的内容会随着锁状态的变化而变化:
| 锁状态 | 25bit | 31bit | 1bit | 4bit | 1bit(是否偏向) | 2bit(锁标志) |
|---|---|---|---|---|---|---|
| 无锁 | unused | hashcode(31) | unused | 分代年龄 | 0 | 01 |
| 偏向锁 | Thread ID(54) | Epoch(2) | unused | 分代年龄 | 1 | 01 |
| 轻量级锁 | 指向栈中锁记录的指针 | 00 | ||||
| 重量级锁 | 指向 Monitor 的指针 | 10 | ||||
| GC 标记 | 空 | 11 |
锁升级路径:
无锁 → 偏向锁 → 轻量级锁 → 重量级锁
(不可逆,只能升级不能降级)
注意 :JDK 15 起偏向锁已被废弃(
-XX:+UseBiasedLocking不再生效),因为偏向锁的维护成本在多线程场景下反而降低性能。JDK 21 中所有对象默认以轻量级锁起步。
java
// 查看对象内存布局的工具:JOL (Java Object Layout)
// Maven 依赖:
// org.openjdk.jol:jol-core:0.17

import org.openjdk.jol.info.ClassLayout;

public class ObjectLayoutDemo {
    public static void main(String[] args) {
        Object obj = new Object();
        System.out.println(ClassLayout.parseInstance(obj).toPrintable());
    }
}
输出示例(JDK 21,开启压缩指针):
java.lang.Object object internals:
OFFSET  SIZE   TYPE DESCRIPTION                       VALUE
     0     8        (object header: mark word)        0x0000000000000001 (non-biasable; thin)
     8     4        (object header: class pointer)   0x00010000
    12     4        (alignment/padding gap)
Instance size: 16 bytes
Space losses: 4 bytes internal + 0 bytes external = 4 bytes total
可以看到一个 Object 对象在内存中占 16 字节:8 字节 Mark Word + 4 字节 Klass Pointer(开启压缩指针)+ 4 字节对齐填充。
2.4 指针压缩
64 位 JVM 中,对象引用默认占 8 字节。但大部分应用的堆不会超过 32GB,可以使用指针压缩将引用缩小到 4 字节:
bash
# 开启指针压缩(JDK 8+ 默认开启)
-XX:+UseCompressedOops

# 关闭指针压缩
-XX:-UseCompressedOops| 配置 | 引用大小 | 最大寻址空间 | 适用场景 |
|---|---|---|---|
| 压缩开启 | 4 字节 | 32GB | 大多数应用 |
| 压缩关闭 | 8 字节 | 无限制 | 堆 > 32GB |
注意:当堆超过 32GB 时,指针压缩会自动关闭,此时引用占用从 4 字节变为 8 字节,可能导致实际内存消耗不降反增。所以堆不是越大越好。
三、垃圾回收算法对比
3.1 判断对象是否存活
引用计数法(已废弃):每个对象维护一个引用计数器,+1/-1。缺陷:无法处理循环引用。
可达性分析(HotSpot 采用):从 GC Roots 出发,沿引用链遍历,不可达的对象为垃圾。
GC Roots 包括:
- 虚拟机栈中的局部变量引用
- 方法区中静态变量引用
- 方法区中常量引用
- 本地方法栈中 JNI 引用
- Java 虚拟机内部引用(基本类型 Class、常驻异常对象等)
- 同步锁(synchronized 关键字)持有的对象
3.2 三种基础回收算法
标记-清除(Mark-Sweep)
第一步:标记          第二步:清除
┌──┬──┬──┬──┬──┐     ┌──┬──┬──┬──┬──┐
│ A│ B│ C│ D│ E│     │ A│  │ C│  │ E│
│活│死│活│死│活│     │活│  │活│  │活│
└──┴──┴──┴──┴──┘ └──┴──┴──┴──┴──┘- 优点:实现简单
- 缺点:产生内存碎片,分配大对象时可能触发 Full GC
- 代表收集器:CMS(Concurrent Mark Sweep)
标记-复制(Copying)
第一步:标记存活      第二步:复制到另一半
┌────────┬────────┐  ┌────────┬────────┐
│A B C D │        │  │A B C D │        │
│  From  │   To   │  │   To   │  From  │
│   区   │   区   │  │   区   │  (清空) │
└────────┴────────┘ └────────┴────────┘- 优点:无碎片,分配快(指针碰撞)
- 缺点:可用内存减半,存活率高时复制开销大
- 代表收集器:Serial、ParNew、G1(Region 间复制)
标记-整理(Mark-Compact)
第一步:标记          第二步:整理
┌──┬──┬──┬──┬──┐     ┌──┬──┬──┬──┬──┐
│ A│ B│ C│ D│ E│     │ A│ C│ E│  │  │
│活│死│活│死│活│     │活│活│活│  │  │
└──┴──┴──┴──┴──┘ └──┴──┴──┴──┴──┘- 优点:无碎片,不浪费空间
- 缺点:移动对象需要更新引用,STW 时间长
- 代表收集器:Serial Old、G1(Old Region 回收时)
3.3 分代收集理论
当前主流 GC 都基于分代假说:
- 弱代假说:绝大多数对象朝生夕灭
- 强代假说:熬过越多次 GC 的对象越难以消亡
- 跨代引用假说:跨代引用相对同代引用占极少数
基于此,堆被划分为新生代(Young Gen)和老年代(Old Gen):
| 区域 | 占比 | 回收算法 | 回收频率 |
|---|---|---|---|
| Eden | 8/10 新生代 | 复制 | 高 |
| Survivor | 2/10 新生代 | 复制 | 高 |
| Old | 1/2 ~ 2/3 堆 | 标记-清除/整理 | 低 |
注意:G1 和 ZGC 并不完全遵循传统分代模型。G1 虽然逻辑分代但物理上不连续;ZGC(JDK 21 中的分代 ZGC)采用了全新的分代设计。这些在第四章会详细展开。
四、G1 与 ZGC 原理深度剖析
4.1 G1 收集器
G1(Garbage-First)是 JDK 9 之后的默认 GC,面向大堆、低延迟场景。
4.1.1 Region 模型
G1 将堆划分为多个等大的 Region(1~32MB),每个 Region 可以动态切换角色:
┌───┬───┬───┬───┬───┬───┬───┬───┬───┬───┐
│ E │ E │ S │ O │ H │ E │ O │ S │ O │ - │
├───┼───┼───┼───┼───┼───┼───┼───┼───┼───┤
│ O │ - │ E │ E │ O │ H │ S │ E │ - │ O │
└───┴───┴───┴───┴───┴───┴───┴───┴───┴───┘

E = Eden    S = Survivor    O = Old    H = Humongous    - = Free
Humongous 区域:当一个对象大小超过 Region 的 50% 时,分配在连续的 Humongous Region 中。大对象直接进老年代是 G1 的特点。
4.1.2 GC 流程
┌─────────────┐    ┌──────────────┐    ┌──────────────┐
│  Young GC   │───▶│ Mixed GC     │───▶│  Full GC     │
│ (Evacuation)│    │ (选择性回收)  │    │ (兜底,应避免)│
└─────────────┘    └──────────────┘    └──────────────┘
  Eden + Survivor   回收整个新生代        全堆扫描回收
  复制到 Survivor    + 部分Old Region
  + 部分晋升Old
Young GC(次要回收):
- STW 开始
- 扫描 GC Roots,标记 Eden 和 Survivor 中的存活对象
- 将存活对象复制到新的 Survivor Region(或晋升到 Old Region)
- 清空原 Eden 和 Survivor Region
- STW 结束
Mixed GC(混合回收):
- 初始标记(Initial Mark)--- STW,标记 GC Roots 直接引用
- 并发标记(Concurrent Mark)--- 并发,沿引用链标记
- 最终标记(Remark)--- STW,处理 SATB 缓冲区
- 筛选回收(Cleanup / Evacuation)--- STW,回收价值最高的 Region
关键参数:
bash
# G1 基础配置
-XX:+UseG1GC                          # 使用 G1
-XX:MaxGCPauseMillis=200              # 目标最大停顿时间(默认200ms)
-XX:G1HeapRegionSize=16m             # Region 大小(默认自动计算)
-XX:InitiatingHeapOccupancyPercent=45 # 触发Mixed GC的堆占用阈值(默认45%)
-XX:G1NewSizePercent=5               # 新生代最小占比(默认5%)
-XX:G1MaxNewSizePercent=60           # 新生代最大占比(默认60%)
4.2 ZGC 收集器
ZGC(Z Garbage Collector)是 JDK 11 引入的低延迟收集器,JDK 15 转正,JDK 21 引入分代 ZGC。
4.2.1 核心设计目标
| 指标 | 目标 |
|---|---|
| 停顿时间 | < 10ms(JDK 21 实测多数 < 1ms) |
| 堆大小 | 支持 16TB |
| 吞吐量 | 下降不超过 15% |
| 并发度 | 标记/转移/重定位全部并发 |
4.2.2 核心技术
① 染色指针(Colored Pointers)
ZGC 在 64 位指针中借用了高位来存储 GC 元信息:
64位指针布局(JDK 21 分代ZGC):
┌──────────────────────────────────────────────┐
│ Unused(18) | Finalizable(1) | Remapped(1)   │
│ Marked1(1) | Marked0(1)    | Address(42)    │
└──────────────────────────────────────────────┘
4 个标记位表示对象在不同 GC 阶段的状态,ZGC 通过修改指针的高位来标记对象,而不需要修改对象头。
② 读屏障(Read Barrier)
每次引用读取时,JVM 会自动插入一段代码,检查指针是否需要"重映射":
c
// 伪代码:ZGC 读屏障
Object* p = read_reference_field(obj, offset);
if (is_relocation_bit_set(p)) {
    p = remap(p);        // 重定位到新地址
    write_reference_field(obj, offset, p);  // 更新引用
}
return p;注意:读屏障是 ZGC 性能开销的主要来源,但它是自动的、JVM 级别的,开发者无需手动处理。
③ 内存多重映射
ZGC 使用多重映射技术,让染色指针的多个视图映射到同一物理内存,通过操作系统级别的页表共享实现。
4.2.3 ZGC 回收流程
┌──────────────┐   ┌──────────────┐   ┌──────────────┐   ┌──────────────┐
│  并发标记     │──▶│  并发预处理   │──▶│  并发转移     │──▶│  并发重定位   │
│  (Concurrent  │   │  (Pause Mark │   │  (Pause      │   │  (Concurrent  │
│   Mark Start) │   │   End)       │   │   Relocate   │   │   Relocate   │
│               │   │              │   │    Start)    │   │    End)      │
└──────────────┘   └──────────────┘   └──────────────┘   └──────────────┘
       ↑                                                              │
       └──────────────────────────────────────────────────────────────┘
                              循环
整个流程中只有 4 个极短的 STW 阶段(每次通常 < 1ms),其余全部并发执行。
4.3 G1 vs ZGC 对比
| 维度 | G1 | ZGC |
|---|---|---|
| 停顿时间 | 100~300ms | < 10ms |
| 最大堆 | ~64GB | 16TB |
| 算法 | 分代 + Region 复制 | 并发标记 + 并发转移 + 染色指针 |
| JDK 21 默认 | 否(需手动开启) | 否 |
| 适用场景 | 大堆 + 可接受数百ms停顿 | 超大堆 + 极低延迟要求 |
| 吞吐量 | 高 | 略低(读屏障开销) |
bash
# JDK 21 切换 GC
# G1(默认)
java -XX:+UseG1GC -jar app.jar

# ZGC(分代)
java -XX:+UseZGC -XX:+ZGenerational -jar app.jar选型建议:堆 < 8GB 且对延迟不敏感 → G1;堆 > 8GB 或延迟要求 < 10ms → ZGC。
五、实战:用 JFR + GC 日志定位 Full GC 频发问题
5.1 问题场景描述
假设有一个 Spring Boot 应用出现以下症状:
- 接口响应时间从 50ms 飙升到 3s+
- 监控告警显示每分钟发生 2~3 次 Full GC
- 堆使用率持续在 90% 以上
5.2 第一步:开启 GC 日志
bash
# JDK 21 统一日志格式
java -Xlog:gc*:file=/var/log/gc.log:time,uptime,level,tags:filecount=10,filesize=100m \
     -XX:+UseG1GC \
     -Xms4g -Xmx4g \
     -jar app.jar
5.3 第二步:分析 GC 日志
截取关键日志片段:
[2024-01-15T10:23:01.123+0800] GC(1024) Pause Young (Normal) (G1 Evacuation Pause)
  [Eden: 256M->0B(256M)] [Survivor: 32M->32M(32M)] [Old: 2.8G->2.9G(3.0G)]
  [Metaspace: 128M->128M(256M)]
  0.0452341s ... 4.0G->3.2G(4.0G) 19.5%

[2024-01-15T10:23:15.456+0800] GC(1025) Pause Full (G1 Compaction Pause)
  [Eden: 0B->0B(0B)] [Survivor: 0B->0B(0B)] [Old: 2.9G->2.9G(3.0G)]
  [Metaspace: 128M->128M(256M)]
2.3456789s ... 3.2G->3.1G(4.0G) 77.5%关键信息提取:
| 指标 | Young GC | Full GC |
|---|---|---|
| 持续时间 | 45ms | 2.3s |
| 回收前堆 | 4.0G | 3.2G |
| 回收后堆 | 3.2G | 3.1G |
| 老年代 | 2.8G→2.9G | 2.9G→2.9G |
初步判断:老年代几乎回收不掉内存(2.9G→2.9G),说明存在大量存活对象或内存泄漏。
5.4 第三步:JFR 录制与分析
bash
# 方式一:启动时开启 JFR
java -XX:StartFlightRecording=duration=300s,filename=recording.jfr,settings=profile \
     -jar app.jar

# 方式二:运行时动态录制(通过 jcmd)
jcmd <pid> JFR.start duration=300s filename=recording.jfr settings=profile
使用 JMC(JDK Mission Control)打开 recording.jfr,关注以下几个面板:
① GC 配置面板
查看实际生效的 GC 参数,确认是否符合预期。
② 内存/对象分配面板
查看分配量最大的对象类型:
Top Object Allocation Sites:
1. java.util.HashMap$Node[]     1.2GB (38%)
2. com.example.dto.OrderDTO      0.8GB (25%)
3. java.lang.String              0.4GB (12%)
③ GC 事件面板
查看每次 GC 的回收详情和停顿时间分布。
5.5 第四步:堆转储分析
bash
# 生成堆转储
jcmd <pid> GC.heap_dump /tmp/heapdump.hprof
使用 MAT(Memory Analyzer Tool)打开 heapdump.hprof:
查看 Dominator Tree(支配树):
Object                              | Shallow Heap | Retained Heap | Percentage
──────                               ─────────────  ────────────── ──────────
java.util.HashMap @ 0xa3f2c1        |    48        |    1.8GB     |    56%
└─ java.util.HashMap$Node[]         |    67M       |    1.7GB     |    53%
   └─ HashMap$Node × 8,500,000      |  204M        |    1.6GB     |    50%
      └─ com.example.dto.OrderDTO  |  72B each    |    1.2GB     |    37%
查看 GC Roots 引用链:
发现 HashMap 持有 850 万个 OrderDTO 对象。该 HashMap 被一个静态缓存类引用:
java
// 问题代码定位
public class OrderCacheManager {
    // 缓存从未清理!
    private static final Map<String, OrderDTO> CACHE = new HashMap<>();

    public static void put(String orderId, OrderDTO order) {
        CACHE.put(orderId, order);  // 只进不出
    }

    public static OrderDTO get(String orderId) {
        return CACHE.get(orderId);
    }
    // 缺少 remove() 或过期淘汰逻辑
}
5.6 第五步:修复方案
修复方案一:使用 Caffeine 替代 HashMap
java
public class OrderCacheManager {

    private static final Cache<String, OrderDTO> CACHE = Caffeine.newBuilder()
            .maximumSize(100_000)              // 最大缓存10万条
            .expireAfterWrite(Duration.ofMinutes(30))  // 30分钟过期
            .recordStats()                     // 记录统计信息
            .build();

    public static void put(String orderId, OrderDTO order) {
        CACHE.put(orderId, order);
    }

    public static OrderDTO get(String orderId) {
        return CACHE.getIfPresent(orderId);
    }
}
修复方案二:限制缓存大小 + 定时清理
java
public class OrderCacheManager {

    private static final int MAX_SIZE = 100_000;
    private static final LinkedHashMap<String, OrderDTO> CACHE =
        new LinkedHashMap<>(16, 0.75f, true) {  // LRU
            @Override
            protected boolean removeEldestEntry(Map.Entry<String, OrderDTO> eldest) {
                return size() > MAX_SIZE;
            }
        };

    // 定时清理过期数据
    @Scheduled(fixedDelay = 300_000)  // 5分钟
    public void cleanExpired() {
        CACHE.entrySet().removeIf(e -> e.getValue().isExpired());
    }
}
5.7 修复后效果
| 指标 | 修复前 | 修复后 |
|---|---|---|
| Full GC 频率 | 2~3 次/分钟 | 0 次/小时 |
| 堆使用率 | 90%+ | 45~55% |
| 接口 P99 延迟 | 3000ms | 45ms |
| Young GC 耗时 | 45ms | 22ms |
六、调优参数推荐与避坑指南
6.1 常用 JVM 参数速查表
| 参数 | 说明 | 推荐值 |
|---|---|---|
-Xms / -Xmx |
初始堆/最大堆 | 生产环境设为相同值 |
-Xmn |
新生代大小 | G1 模式下不建议手动设置 |
-XX:MetaspaceSize |
元空间初始大小 | 256M |
-XX:MaxMetaspaceSize |
元空间最大大小 | 512M |
-XX:MaxDirectMemorySize |
直接内存上限 | 与堆大小一致 |
-XX:+UseG1GC |
使用 G1 收集器 | JDK 9+ 默认 |
-XX:MaxGCPauseMillis |
GC 停顿目标 | 200ms |
-XX:+HeapDumpOnOutOfMemoryError |
OOM 时自动 dump | 必须开启 |
-XX:HeapDumpPath |
dump 文件路径 | 指定目录 |
6.2 生产标准启动模板
bash
java \
  -Xms4g -Xmx4g \
  -XX:MetaspaceSize=256m -XX:MaxMetaspaceSize=512m \
  -XX:+UseG1GC \
  -XX:MaxGCPauseMillis=200 \
  -XX:+HeapDumpOnOutOfMemoryError \
  -XX:HeapDumpPath=/data/dumps/heapdump.hprof \
  -XX:ErrorFile=/data/logs/hs_err_pid%p.log \
  -Xlog:gc*:file=/data/logs/gc.log:time,uptime,level,tags:filecount=10,filesize=100m \
  -jar app.jar
6.3 常见误区与避坑指南
坑1:-Xms 和 -Xmx 设置不同值
误区:初始堆设小,运行时按需增长,节省内存。
实际:堆从 2G 增长到 4G 的过程中,可能触发多次 Full GC(因为需要重新分配和整理内存)。生产环境务必设为相同值。
坑2:盲目调大堆
误区:堆越大性能越好。
实际:
- 堆超过 32GB → 指针压缩关闭,引用大小翻倍,实际内存消耗反增
- 堆越大,Full GC 时 STW 时间越长(G1 的 Mixed GC 可以缓解)
- 堆 4~8GB 用 G1,超过 8GB 考虑 ZGC
坑3:手动设置 G1 新生代大小
误区 :用 -Xmn 或 -XX:NewRatio 控制 G1 新生代大小。
实际:G1 的设计目标是动态调整新生代大小来满足停顿目标。手动固定新生代大小会破坏 G1 的自适应策略。
bash
# ❌ 错误:G1 下不要这样做
-XX:NewRatio=2
-Xmn2g

# ✅ 正确:让 G1 自己管理
-XX:+UseG1GC
-XX:MaxGCPauseMillis=200
# 不设置 -Xmn 和 NewRatio
坑4:元空间太小导致 OOM
误区:Metaspace 用默认值就行。
实际:使用动态类加载(如 Spring Boot DevTools、Groovy 脚本、动态代理)时,Metaspace 不断增长。默认值太小可能频繁触发 Full GC。
bash
# 建议显式设置
-XX:MetaspaceSize=256m
-XX:MaxMetaspaceSize=512m
# MetaspaceSize 是初始高水位线,达到后触发Full GC并重新计算
坑5:忽略 GC 日志
误区:应用跑得好好的,不需要开 GC 日志。
实际:出问题时没有 GC 日志就像盲人摸象。GC 日志开销极小(<1%),生产环境必须开启。
bash
# 必须开启
-Xlog:gc*:file=/var/log/gc.log:time,uptime,level,tags:filecount=10,filesize=100m
# + HeapDumpOnOutOfMemoryError
-XX:+HeapDumpOnOutOfMemoryError
坑6:ZGC 不是万能药
误区:ZGC 停顿低,一律用 ZGC。
实际:
- ZGC 的读屏障会带来约 5%~15% 的吞吐量损失
- 小堆(< 4GB)场景下,G1 的停顿已经很短,ZGC 优势不明显
- ZGC 适合堆 > 8GB 且对延迟有极致要求的场景
选型参考:
| 堆大小 | 延迟要求 | 推荐 GC |
|---|---|---|
| < 4GB | 不敏感 | G1 |
| 4~8GB | < 200ms | G1 |
| 8~32GB | < 200ms | G1 / ZGC |
| > 32GB | < 10ms | ZGC |
| 任意大小 | 极致低延迟 | ZGC |
七、总结
本文从 JVM 内存区域划分出发,依次讲解了对象内存布局、垃圾回收算法、G1 与 ZGC 原理,最后通过一个 Full GC 频发的实战案例演示了完整的排查链路。核心要点回顾:
| 知识点 | 关键结论 |
|---|---|
| 内存区域 | 堆(GC 主战场)、元空间(本地内存)、直接内存(NIO) |
| 对象布局 | 对象头(Mark Word + Klass Pointer)+ 实例数据 + 对齐填充 |
| Mark Word | 随锁状态动态变化,JDK 15+ 废弃偏向锁 |
| 指针压缩 | 堆 > 32GB 自动关闭,引用翻倍 |
| G1 | Region 模型,可控停顿,JDK 9+ 默认 |
| ZGC | 染色指针 + 读屏障,停顿 < 10ms,JDK 21 分代 |
| 调优核心 | -Xms=-Xmx、开 GC 日志、开 HeapDump、G1 不要固定新生代 |
JVM 调优没有银弹,理解原理比记住参数更重要。当遇到 GC 问题时,按照"开日志 → 分析 GC 频率和回收效率 → JFR 录制 → 堆转储分析 → 定位代码"的标准链路排查,大多数问题都能找到根因。