前几天,群里有朋友问我:"你们前后端并行开发的时候,接口还没好,前端那几十条测试数据是怎么来的?"
说实话,我之前也被这个问题坑过不少次。
最夸张的一次:一个订单列表页,我手写了 200 条 JSON 数据。写到第 80 条的时候后端说字段名要从 orderNo 改成 order_no,改完又说要加个 refundAt,再改完又说要支持分页。
一份"临时用一下"的假数据,我前后维护了大半天。
那一刻我才意识到:手写 Mock 数据不是慢的问题,是它会持续偷走你的时间。
问题根源:手写 Mock 数据的三宗罪
手写 JSON 看着简单,实际上埋了三类坑。
🕳️ 罪一:假得太干净
手敲的数据永远是 "name": "test1"、"remark": "aaa"、"amount": 100。
结果就是:所有边界情况都测不出来。空字符串会不会崩?null 怎么处理?字段超长 200 字符会不会撑破布局?带 emoji 的商品名会不会乱码?金额为 0 和为负的时候页面长什么样?
这些 Bug 全都安安静静地活到了测试环境,甚至活到了线上。
🕳️ 罪二:结构漂移
后端改了字段,没人会记得去同步那份手写的 mock.json。
于是前端拿着过期的数据结构自测,一路绿灯,联调当天集体翻车。
🕳️ 罪三:不可复现
随手写的随机数据,出 Bug 了想复现------数据已经变了。
"你刚才那个报错还在吗?" "我刷新了一下,没了。"
这种对话,做过前端的都懂。
核心结论:Mock 数据的价值不在"有数据",而在"数据结构可控、内容可复现、边界可覆盖"。
Mock 数据的四个层次
我把常见做法分成四层,越往上越接近工程化。
| 层次 | 做法 | 适用阶段 | 主要问题 |
|---|---|---|---|
| L1 静态手写 | 直接敲 JSON 文件 | 原型、5 条以内 | 假得干净、难维护 |
| L2 模板随机 | faker / Mock.js 批量生成 | 联调、demo | 结构与接口无契约 |
| L3 Schema 驱动 | JSON Schema → 数据 | 正式项目 | 需要先有 Schema |
| L4 场景化 Mock | MSW / Mock Server / 录制回放 | 单测、E2E、长期维护 | 有一定接入成本 |
大多数团队卡在 L1 和 L2 之间,而真正省事的是 L3:契约即数据源。接口 Schema 一改,Mock 数据自动跟着变,结构漂移的问题从根上消失。
方案对比:该用哪个
| 方案 | 类型 | 优势 | 局限 |
|---|---|---|---|
@faker-js/faker |
JS 库 | 数据真实、支持中文、可设种子 | 需要写代码 |
Mock.js |
JS 库 | 模板语法直观、前端拦截请求 | 语法私有、生态偏老 |
json-schema-faker |
JS 库 | Schema 驱动、契约一致 | 依赖已有 Schema |
| MSW | 拦截层 | 单测/浏览器通吃、贴近真实请求 | 有接入成本 |
| 在线生成器 | Web 工具 | 零安装、秒出结果 | 只能造扁平结构 |
| 数据库造数脚本 | SQL/Python | 能造关联数据、贴近真实分布 | 最重 |
没有银弹。临时用 → 在线工具或 faker;正式项目 → Schema 驱动 + MSW。
实战一:@faker-js/faker(推荐日常主力)
Faker 是目前 JS 生态里最活跃的选择(本文用的是 v10.6.0)。v9 之后 API 做过一轮规整,address 改名 location、name 改名 person,中文 locale 也够用。
bash
npm i -D @faker-js/faker
js
import { fakerZH_CN as faker } from '@faker-js/faker';

// 关键:设种子,保证每次生成的数据完全一致,Bug 可复现
faker.seed(20260914);

// 中文 locale 下 phone.number() 给的是固话格式(如 0747-95502468),
// 不是 11 位手机号。要手机号得自己拼号段:
const SEGMENTS = ['133', '150', '176', '186', '199'];
const mobile = () => faker.helpers.arrayElement(SEGMENTS) + faker.string.numeric(8);

const orders = Array.from({ length: 200 }, (_, i) => ({
  id: faker.string.uuid(),
  orderNo: `SO${String(i + 1).padStart(8, '0')}`,
  userName: faker.person.fullName(),
  phone: mobile(),
  // 金额用「分」存整数,别用浮点,0.1 + 0.2 的坑不要踩第二次
  amountCents: faker.number.int({ min: 0, max: 5_000_000 }),
  status: faker.helpers.arrayElement(['pending', 'paid', 'shipped', 'refunded']),
  remark: faker.helpers.arrayElement([null, '', faker.lorem.sentence(), '备注含 emoji 🎉']),
  createdAt: faker.date.recent({ days: 30 }).toISOString(),
}));

console.log(JSON.stringify(orders, null, 2));
⚠️ 上面这段我实际跑过(Faker v10.6.0)。fakerZH_CN.phone.number() 输出的是 0747-95502468、14917446540 这种混合结果,拿去做手机号校验的接口会被直接打回。这是个很容易忽略的细节------大家默认中文 locale 就该出中文手机号,其实不是。
⚠️ 注意 remark 那行------我故意把 null、空串、正常文本、emoji 混在一起。这才是 Mock 数据该有的样子:主动制造脏数据。
常用 Faker 片段速查(v9+,以下均实测可运行)
js
faker.seed(20260914);                              // 固定种子,必须放最前面
faker.person.fullName();                           // 中文姓名
faker.internet.email();                            // 邮箱
faker.location.city();                             // 城市
faker.string.uuid();                               // UUID
faker.number.int({ min: 0, max: 5_000_000 });      // 区间整数
faker.number.float({ min: 0, max: 100, multipleOf: 0.01 }); // 保留两位小数
faker.date.between({ from: '2026-08-01', to: '2026-09-14' });
faker.helpers.arrayElement(['active', 'frozen']);  // 枚举随机
faker.helpers.multiple(() => ({ /* ... */ }), { count: 200 }); // 批量生成
faker.string.numeric(8);                           // 8 位数字串(拼手机号用)
⚠️ fakerZH_CN.phone.number() 不要直接当手机号用,详见下一节。
实战二:Mock.js(模板语法最直观)
如果你的团队已经在用 Mock.js,它的模板语法确实写得快。
js
const Mock = require('mockjs');

const data = Mock.mock({
  'list|50': [{
    'id|+1': 1,
    name: '@cname',
    'age|18-60': 1,
    'level|1': ['VIP1', 'VIP2', 'VIP3'],
    email: '@email',
    'amount|1-10000.2': 1,
    createdAt: '@datetime("yyyy-MM-dd HH:mm:ss")',
    avatar: '@image("80x80", "#4A90E2", "#FFF", "png", "U")',
  }],
});
'list|50' 表示生成 50 条,'id|+1' 表示自增,'level|1' 表示从数组里随机取一个。
⚠️ 这里有个我实测踩到的坑 :@datetime 生成的时间跨度是 1970 年到现在。我跑了 400 次统计,只有 9.5% 的日期落在 2020 年之后------也就是说你造 100 条"最近订单",会有 90 条的时间是 1988 年、2003 年这种。
页面上按时间倒序一排,全是十几年前的订单,一眼就假。而且如果业务逻辑依赖"近 7 天",这些数据直接测不到东西。
正确写法是指定区间:
js
// 用 Mock.Random.date 限定范围,别用 @datetime
const d = Mock.Random.date('2026-08-01', '2026-09-14');   // 2026-08-01
局限也很明显:语法是私有的,Schema 换不过来,而且它默认会拦截 XHR------上线前一定要确认 mock 代码没被打进生产包。
另外 @cname、@email 这类占位符生成的是"格式对但内容假"的值(比如 r.pordsdc@vdemckts.name),域名叫 vdemckts.name,一看就不是真邮箱。做前端展示没问题,但如果你的测试逻辑会真的发信或做域名白名单校验,就会炸。
实战三:json-schema-faker(Schema 驱动,最工程化)
这是我最推荐的正式项目做法。前提是你有接口的 JSON Schema(没有的话,可以让后端从 DTO 生成,或者用工具从样例 JSON 反推)。
⚠️ 先说一个会直接让你卡住的问题:网上的教程大多过时了。
搜到的写法基本都是 const { JSONSchemaFaker } = require('json-schema-faker'),然后 JSONSchemaFaker.generate(schema)。我在 v0.6.3 上实测,两行都跑不通:
require()直接抛ERR_PACKAGE_PATH_NOT_EXPORTED------新版本只发 ESM ,exports字段里只有import,没有require- 没有
JSONSchemaFaker这个命名导出了,改成了一组扁平函数:generate/generateSync/registerFormat/define等
正确写法:
js
// 注意:ESM,且是 generateSync 不是 JSONSchemaFaker.generate
import { generateSync } from 'json-schema-faker';

const schema = {
  type: 'object',
  required: ['orderId', 'amount', 'status'],
  properties: {
    orderId: { type: 'string', format: 'uuid' },
    amount: { type: 'integer', minimum: 0, maximum: 5000000 },
    status: { type: 'string', enum: ['pending', 'paid', 'shipped', 'refunded'] },
    couponId: { type: ['string', 'null'] },
    paidAt: { type: ['string', 'null'], format: 'date-time' },
  },
};

const order = generateSync(schema);
// => {"orderId":"a08ff49b-6f77-4263-8716-c43069c43a8c","amount":964070,
//     "status":"shipped","couponId":null,"paidAt":"2010-05-08T03:43:34Z"}

const orders = Array.from({ length: 200 }, () => generateSync(schema));
如果你的项目还是 CommonJS,只能锁老版本(json-schema-faker@0.5.x)或者改成 ESM。这个坑我踩了小半天,因为报错信息 No "exports" main defined 完全没提示你是模块格式问题。
好处:Schema 是唯一事实来源。后端改字段 → Schema 变 → Mock 自动变,结构漂移彻底消失。同一份 Schema 还能拿去做接口文档和响应校验,一份投入三处收益。
🎯 顺带一提,从上面那段真实输出能看出 Schema 驱动的价值:couponId 自动生成了 null,amount 自动落在 minimum/maximum 区间内,status 自动从 enum 里取值。这些约束条件写在 Schema 里,生成的数据天然就是合法的,不用像手写那样靠人脑记"这个字段可以为空"。
反过来也要注意:paidAt 生成的是 2010-05-08,因为 Schema 里没写时间范围。Schema 只保证"格式合法",不保证"业务合理" ------需要近期时间的话,得自己加 format 扩展或后处理。
实战四:在线生成器(临时用,别当主力)
如果只是要一批扁平结构的数据,贴进 Postman 或者塞进 demo 页面,我一般懒得开编辑器写脚本。
我自己用的是这个纯前端的小工具:Mock 数据生成器。用法很直白------配字段名和类型,填行数,点生成,复制或下载 JSON。支持的类型有 name、email、phone、address、date、uuid、url、ip、number、boolean、custom。
https://leowh.com/tools/mock-data/index.html
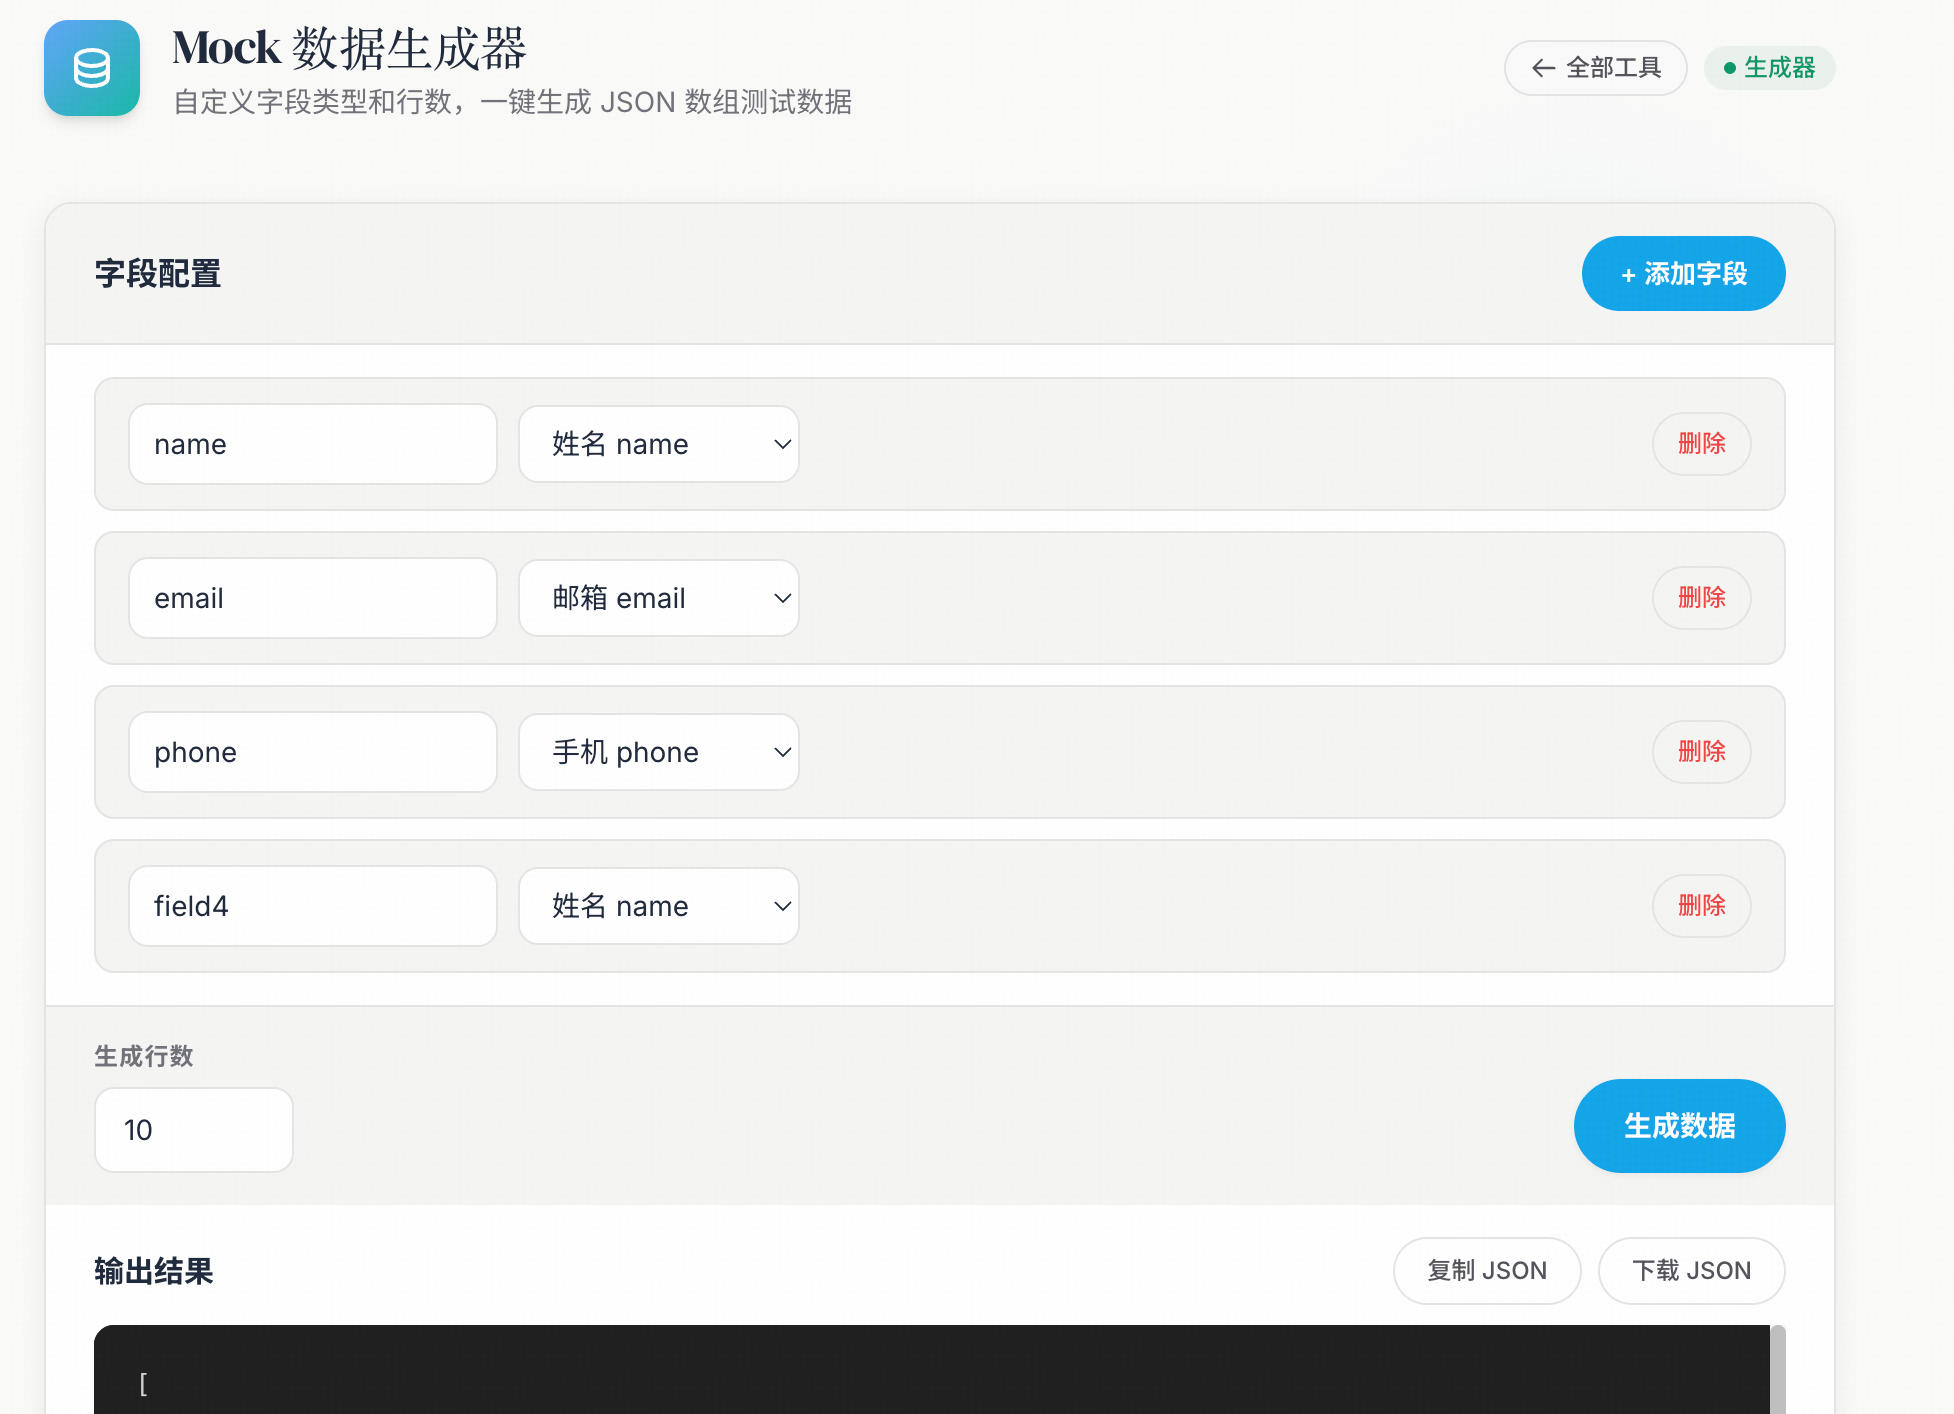
两个细节我觉得设计得挺对:
custom支持值A|值B|值C这种竖线分隔的候选文本,枚举字段直接搞定number可以设最小值和最大值,区间数据不用自己算
它是纯前端实现,配置和数据都在浏览器本地生成,不往服务器发------对内网环境或者字段本身敏感的场景友好一些。
但边界要讲清楚,别拿它当主力:
- 🔴 只能造扁平对象数组,不支持嵌套对象、外键关联、条件依赖(比如
status = refunded时必须有refundAt) - 🔴 每次生成都是随机的,没有种子机制,Bug 不可复现
- 🟡 造完就是一坨静态 JSON,接口字段一改又得重来一遍
所以我的分工是:demo 和联调冒烟用在线工具,正式测试数据和单测夹具回到代码里写(faker / Schema 驱动)。
顺带一提,同一站还有个 JSON 转实体类工具,把生成好的 JSON 贴进去能直接出 Java / C# / Go / TypeScript / Python 的类定义。造数据 → 看结构 → 生成实体,在接口文档还没写全的阶段,这条链路能省点事。
实战五:MSW(让单测吃到真实请求链路)
到了 L4,重点是"拦截"而不是"生成"。MSW(Mock Service Worker)在 Service Worker 层拦请求,单测和浏览器调试用同一套 handler。
bash
npm i -D msw
js
// mocks/handlers.js
import { http, HttpResponse } from 'msw';
import { fakerZH_CN as faker } from '@faker-js/faker';

faker.seed(42);

const makeOrders = (n) =>
  Array.from({ length: n }, () => ({
    id: faker.string.uuid(),
    amountCents: faker.number.int({ min: 0, max: 5_000_000 }),
    status: faker.helpers.arrayElement(['pending', 'paid', 'shipped', 'refunded']),
  }));

export const handlers = [
  http.get('/api/orders', ({ request }) => {
    const url = new URL(request.url);
    const page = Number(url.searchParams.get('page') ?? 1);
    return HttpResponse.json({ page, total: 200, list: makeOrders(20) });
  }),

  // 主动造异常,这才是 Mock 最大的价值
  http.get('/api/orders/:id', () =>
    HttpResponse.json({ code: 500, msg: 'internal error' }, { status: 500 })),
];
🎯 重点:Mock 不只是造正常数据,更是造异常。 500、超时、限流 429、字段缺失、字段类型错误------这些场景在真实环境里很难稳定复现,但在 Mock 层里一行代码的事。
避坑清单
这部分是我踩过的坑,按优先级排。
🔴 必须注意
- 一定要设随机种子。
faker.seed(n)写死,Bug 才能复现。不设种子的随机数据等于没数据。 - 金额别用浮点。 用整数「分」或者 decimal 字符串。
amount: 19.99这种写法迟早出事。 - 主动造脏数据。 每个可空字段都要覆盖
null、undefined、'';字符串字段要覆盖超长(200+ 字符)、emoji、HTML 特殊字符、换行。 - Mock 代码不能进生产包。 Mock.js 会拦 XHR,MSW 的 worker 文件要按环境注入。上线前搜一遍构建产物。
- 时间字段统一格式。 到底是 ISO 8601(
2026-09-14T10:00:00.000Z)、时间戳、还是本地时间字符串?团队内定死一种,Mock 数据必须和后端一致,尤其注意时区。
🟡 建议注意
- 敏感数据合规。 手机号、身份证、银行卡一律用生成的虚构值,绝对不要从生产库导真实数据当 Mock。Faker 生成的手机号是合法号段格式但不对应真实用户,仍然建议只在内网/测试环境流转。
- 别一次造太多。 前端一次渲染 10 万条 JSON,浏览器先卡死给你看。列表页造 50--500 条足够,压测数据另说。
- 关联数据要有外键一致性。
order.userId必须能在users里找到,否则测关联查询全是假阳性。这类需求 faker 也能做,但要自己维护 ID 池。 - 枚举值从后端常量同步。 手写
['pending', 'paid']很容易漏掉后端新增的状态,最好从共享的常量文件或 Schema 的enum读。 - 数据分布要像真的。 全是
status: 'paid'的订单列表,测不出状态筛选逻辑。按真实比例分配(比如 60% paid、20% pending、15% shipped、5% refunded)。
什么情况下用哪种方案?
🔴 直接上 Schema 驱动(json-schema-faker + MSW)
- 项目会长期维护,多人协作
- 已经有或愿意维护接口 JSON Schema
- 需要写单元测试 / E2E 测试
- 接口字段变动频繁
🟡 用 faker / Mock.js 写脚本
- 项目中等规模,没有 Schema
- 需要造有一定业务逻辑的数据(关联、分布、条件依赖)
- 数据需要可复现(配合种子)
🟢 用在线生成器
- 一次性 demo、临时联调、教学示例
- 扁平结构、几百条以内
- 不想装依赖、不想写脚本
常见问题
Q:Mock 数据和后端真实数据不一致怎么办?
A:根源是没有单一事实来源。最好的解法是 Schema 驱动------后端 DTO 生成 Schema,前端从 Schema 生成 Mock,同时用 Schema 做响应校验。退一步的做法是引入契约测试(如 Pact),至少能在 CI 里发现漂移。
Q:为什么我造的数据测不出 Bug,一到测试环境就炸?
A:因为你的数据太干净了。检查三件事:有没有覆盖 null / 空串 / 字段缺失?有没有超长字符串和特殊字符?有没有造过异常响应(500 / 超时 / 429)?
Q:随机种子设多少合适?
A:随便,但要写死并记在代码注释里,比如 faker.seed(20260914)。需要复现某个 Bug 时,把当时用的种子固定下来,写成一个测试用例。
Q:能用生产库的数据脱敏后当 Mock 吗?
A:技术上可以,但成本高且风险大------脱敏不彻底就是数据泄露事故。除非你在做「数据分布真实性」要求极高的场景(比如推荐算法),否则用生成式数据更安全。
Q:Mock.js 和 MSW 能一起用吗?
A:不建议。两者都会拦请求,容易互相干扰导致排查困难。选一个,团队统一。
Q:在线生成器造的数据能直接用于自动化测试吗?
A:不适合。它没有种子机制,每次生成结果不同,测试会变成 flaky test。自动化测试的数据必须由代码生成并固定种子。
总结
Mock 数据这件事,本质是从「手工作坊」升级到「流水线」:
✅ L1 → L2 :别手敲 JSON 了,用 faker / Mock.js 批量生成,效率提升一个数量级
✅ L2 → L3 :引入 JSON Schema,让契约成为唯一事实来源,根治结构漂移
✅ L3 → L4 :用 MSW 统一拦截层,让单测和联调共用一套 Mock,并且开始主动造异常
✅ 贯穿始终:设种子保证可复现、主动造脏数据覆盖边界、金额用整数、Mock 不进生产包
⚠️ 特别提醒: 如果你的 Mock 数据永远只有"正常值",那它测出来的"通过"没有任何意义。
工具选型上,我的习惯是分场景:正式项目走 Schema 驱动 + faker,临时 demo 和联调冒烟用在线生成器图个快。两者不是替代关系。