文章目录
- 一、接口测试
-
- [1.1 UI测试和接口测试到底有什么区别?为什么测了UI还要测接口?](#1.1 UI测试和接口测试到底有什么区别?为什么测了UI还要测接口?)
- 1.2接口测试用例编写
-
- [1.2.1 通过性验证](#1.2.1 通过性验证)
- [1.2.2 参数组合](#1.2.2 参数组合)
- [1.2.3 接口安全](#1.2.3 接口安全)
- [1.2.4 异常验证](#1.2.4 异常验证)
- [1.2.5 结合业务逻辑来设计用例](#1.2.5 结合业务逻辑来设计用例)
- 二、接口自动化测试
-
- 2.1概念
- [2.2 接口自动化流程](#2.2 接口自动化流程)
-
- 2.2.1需求分析
- [2.2.2 挑选自动化接口](#2.2.2 挑选自动化接口)
- [2.2.3 设计自动化测试用例](#2.2.3 设计自动化测试用例)
- 2.2.4搭建自动化测试环境
- [2.2.5 设计自动化执行框架](#2.2.5 设计自动化执行框架)
- [2.2.6 编写代码](#2.2.6 编写代码)
- [2.2.7 执行用例](#2.2.7 执行用例)
- [2.2.8 生成测试报告](#2.2.8 生成测试报告)
- [2.3 第一个简单的接口自动化](#2.3 第一个简单的接口自动化)
- [2.4 requests模块](#2.4 requests模块)
-
- [2.4.1 安装](#2.4.1 安装)
- [2.4.2 介绍](#2.4.2 介绍)
- [2.4.3 常见请求方法](#2.4.3 常见请求方法)
- [2.4.4 添加请求信息](#2.4.4 添加请求信息)
- 2.5自动化框架pytest
-
- [2.5.1 pytest介绍](#2.5.1 pytest介绍)
- [2.5.2 安装](#2.5.2 安装)
- [2.5.3 用例运行规则](#2.5.3 用例运行规则)
- [2.5.4 pytest命令参数](#2.5.4 pytest命令参数)
- [2.5.5 pytest配置文件](#2.5.5 pytest配置文件)
- [2.5.6 前后置](#2.5.6 前后置)
- [2.5.7 断言](#2.5.7 断言)
- [2.5.8 参数化](#2.5.8 参数化)
- [2.5.9 fixture](#2.5.9 fixture)
-
- 2.5.9.1基本使用
- [2.5.9.2 fixture嵌套](#2.5.9.2 fixture嵌套)
- [2.5.9.3 请求多个fixture](#2.5.9.3 请求多个fixture)
- [2.5.9.4 yield fixture](#2.5.9.4 yield fixture)
- [2.5.9.5 带参数的fixture](#2.5.9.5 带参数的fixture)
- [2.6 YAML](#2.6 YAML)
-
- [2.6.1 YAML介绍](#2.6.1 YAML介绍)
- [2.6.2 YAML使用](#2.6.2 YAML使用)
- [2.7 JSON Schema](#2.7 JSON Schema)
-
- [2.7.1 安装JSON Schema](#2.7.1 安装JSON Schema)
- [2.7.2 介绍](#2.7.2 介绍)
-
- [2.7.2.1 数据类型](#2.7.2.1 数据类型)
- [2.7.2.2 最大最小值](#2.7.2.2 最大最小值)
- [2.7.2.3 字符串特殊校验](#2.7.2.3 字符串特殊校验)
- [2.7.2.4 数组约束](#2.7.2.4 数组约束)
- [2.7.2.5 对象约束](#2.7.2.5 对象约束)
- [2.7.2.6 必需属性](#2.7.2.6 必需属性)
- [2.7.2.7 依赖关系](#2.7.2.7 依赖关系)
- [2.8 logging日志模块](#2.8 logging日志模块)
-
- 2.8.1介绍
- [2.8.2 使用](#2.8.2 使用)
- 2.9测试报告allure
-
- 2.9.1介绍
- [2.9.2 安装](#2.9.2 安装)
- [2.9.3 使用](#2.9.3 使用)
一、接口测试
1.1 UI测试和接口测试到底有什么区别?为什么测了UI还要测接口?
很多人会疑惑:页面都点过了,为什么还要单独测接口?其实两者测的是不同层次的东西。UI测试关注的是"用户能不能用"------按钮能不能点、页面跳不跳转、文案对不对;而接口测试是绕过界面,直接对系统接口发请求,验证返回的数据、状态码、业务逻辑是否正确。UI测试只能看到冰山露出水面的部分,接口测试才能看到水下真正庞大的逻辑和数据。很多问题UI根本发现不了:接口返回了脏数据但前端做了容错、并发场景、越权访问、异常参数、边界值等,这些都必须靠接口测试覆盖。而且接口测试更快、更稳、更早、更省------后端接口一完成就能测,不用等前端页面做好;跑几百个用例只要几十秒,不像UI测试几十分钟还容易假失败;失败时能直接定位到是哪个接口、哪个字段出错,责任边界清晰。所以接口测试不是UI测试的重复,而是它的补充和前置。实际项目中通常遵循测试金字塔:大量接口测试打底,少量关键UI测试兜底------接口测试保证"逻辑对、数据对、安全对",UI测试保证"用户真的能用"。
1.2接口测试用例编写
1.2.1 通过性验证
首先肯定要保证这个接口功能是可用的,也就是正常的通过性测试,按照接口文档上的参数,正常传入,是否可以返回正确的结果。
通过性验证
| 用例编号 | 用例标题 | 前置条件 | 测试步骤 | 预期结果 | 实际结果 | 测试结果 |
|---|---|---|---|---|---|---|
| 01 | 接口正常调用测试 | 接口服务正常运行 | 1. 按照接口文档要求,传入所有必填参数 2. 调用接口 3. 检查返回结果 | 返回状态码 200,返回结果符合预期(如操作成功、返回数据完整) |
1.2.2 参数组合
所谓参数组合,就是一个接口有多个参数,不同参数取值会走不同逻辑分支,必须把这些分支都覆盖到。假设下单接口有三个关键参数:orderType(订单类型:1=堂食,2=外送)、tableNo(桌号)、address(收货地址)。业务规则是:orderType=1(堂食)时桌号必传、地址不用传;orderType=2(外送)时地址必传、桌号不用传
| 用例编号 | 用例标题 | 前置条件 | 测试步骤 | 预期结果 | 实际结果 | 测试结果 |
|---|---|---|---|---|---|---|
| 01 | 堂食下单只传桌号 | 接口服务正常运行,8号桌空闲 | 1. 设置 orderType=1 2. 只传桌号 tableNo=8 3. 调用下单接口 | 返回状态码 200,下单成功,订单类型为堂食 | ||
| 02 | 堂食下单同时传桌号和地址 | 接口服务正常运行 | 1. 设置 orderType=1 2. 传桌号 tableNo=8 和地址 address=xx 3. 调用下单接口 | 返回状态码 200,下单成功;或按业务规则返回"堂食不需要地址"的提示 | ||
| 03 | 外送下单只传地址 | 接口服务正常运行 | 1. 设置 orderType=2 2. 只传地址 address=xx 3. 调用下单接口 | 返回状态码 200,下单成功,订单类型为外送 | ||
| 04 | 外送下单不传地址 | 接口服务正常运行 | 1. 设置 orderType=2 2. 不传地址 3. 调用下单接口 | 返回状态码 400,提示"外送订单必须填写地址" |
1.2.3 接口安全
- 绕过验证,比如说购买了一个商品,它的价格是300元,那我在提交订单时候,我把这个商品的价格改成3元,后端有没有做验证,更狠点,我把钱改成-3,是不是我的余额还要增加?
- 绕过身份授权,比如说修改商品信息接口,那必须得是卖家才能修改,那我传一个普通用户,能不能修改成功,我传一个其他的卖家能不能修改成功
- 参数是否加密,比如说我登陆的接口,用户名和密码是不是加密,如果不加密的话,别人拦截到你的请求,就能获取到你的信息了,加密规则是否容易破解。
- 密码安全规则,密码的复杂程度校验
| 用例编号 | 用例标题 | 前置条件 | 测试步骤 | 预期结果 | 实际结果 | 测试结果 |
|---|---|---|---|---|---|---|
| 05 | 绕过价格验证测试 | 接口服务正常运行 | 1. 购买商品 2. 提交订单时,将商品价格改为 3 元 3. 调用接口 | 返回状态码 400 或 403,提示价格验证失败 | ||
| 06 | 绕过身份授权测试 | 接口服务正常运行 | 1. 使用普通用户调用修改商品信息接口 2. 调用接口 | 返回状态码 403,提示无权限操作 | ||
| 07 | 参数加密测试 | 接口服务正常运行 | 1. 检查登录接口的用户名和密码是否加密 2. 拦截请求查看数据 | 用户名和密码已加密,且加密规则难以破解 | ||
| 08 | 密码复杂度校验测试 | 接口服务正常运行 | 1. 注册或修改密码时,输入不符合复杂度要求的密码 2. 调用接口 | 返回状态码 400,提示密码不符合安全规则 |
1.2.4 异常验证
异常验证技术我不按照你接口文档上的要求输入参数,来验证接口对异常情况的校验。比如:必填的参数不填,文档要求输入整数类型,传入字符串类型,长度为10 的,传11。一般就是三种,必传非必传,参数类型,入参长度。
| 用例编号 | 用例标题 | 前置条件 | 测试步骤 | 预期结果 | 实际结果 | 测试结果 |
|---|---|---|---|---|---|---|
| 09 | 必填参数缺失测试 | 接口服务正常运行 | 1. 不传必填参数(如商品id) 2. 调用接口 | 返回状态码400,提示必填参数缺失 | ||
| 10 | 参数类型错误测试 | 接口服务正常运行 | 1. 传入错误类型的参数(如将整数类型传为字符串) 2. 调用接口 | 返回状态码400,提示参数类型错误 | ||
| 11 | 参数长度超限测试 | 接口服务正常运行 | 1. 传入长度超限的参数(如长度限制为10,传入11) 2. 调用接口 | 返回状态码400,提示参数长度超限 |
1.2.5 结合业务逻辑来设计用例
根据业务逻辑来设计的话,就是根据自己系统的业务来设计测试用例,每个公司的业务不一样,就得具体看公司自己的业务了,和功能测试设计测试用例是一样的。
二、接口自动化测试
2.1概念
接口自动化测试是通过对接口进行测试和模拟,以确保软件系统内部的各个组件能够正确的相互通信和交换数据。接口自动化测试可以显著的提高测试效率和准确性。因为接口测试专注于测试系统内部的逻辑和数据传输,而不是像UI测试那样关注用户的操作和交互。同时,接口测试直接针对系统内部的结构和功能,可以更容易的发现和定位问题,减少测试成本和时间。
2.2 接口自动化流程
2.2.1需求分析
- 分析请求:明确接口的URL,请求方法(如:get,post,put,delete等),请求头,请求参数和请求体等信息
- 分析响应:确定接口返回的数据格式,状态码以及可能的错误信息
2.2.2 挑选自动化接口
- 根据项目的时间,人员安排和接口的复杂度,挑选适合自动化测试的接口
- 优先选择核心的业务接口,频繁使用的接口以及容易出错的接口进行自动化测试
功能复杂度 :优先选择功能复杂,逻辑分之多的接口进行自动化测试。例如:设计多种支付方式,多种订单状态转换的订单管理接口。
高风险功能 :选择对业务影响大,风险高的接口进行自动化测试,确保稳定性和可靠性,例如:设计资金操作的支付接口,一旦出现问题可能会导致严重的经济损失,因此需要进行充分的自动化测试。
重复性高:对于需要频繁执行的测试任务,如回归测试中的接口测试,自动化测试可以避免重复的手动测试的繁琐和低效,提高测试效率。
2.2.3 设计自动化测试用例
- 如果在功能测试阶段已经设计了测试用例,可以直接拿来使用
- 根据接口的需求和功能,设计正向的测试用例和反向测试用例,包括边界值测试,参数组合测试等。
2.2.4搭建自动化测试环境
- 选择适合的编程语言和开发环境来实现自动化测试
- 以Python为例,安装必要的依赖库,如requests用于发送HTTP请求,pytest用于测试框架
2.2.5 设计自动化执行框架
- 设计一个框架来执行测试用例,包括报告生成,参数化处理和用例执行逻辑。
2.2.6 编写代码
- 根据设计好的测试用例和框架,编写自动化脚本
2.2.7 执行用例
使用测试框架来执行编写的测试用例
2.2.8 生成测试报告
测试完成后,生成测试报告,可以使用工具来生成易于阅读的报告
2.3 第一个简单的接口自动化
例如:对百度接口发起请求
python
import requests
r = requests.get("https://www.baidu.com")
print(r)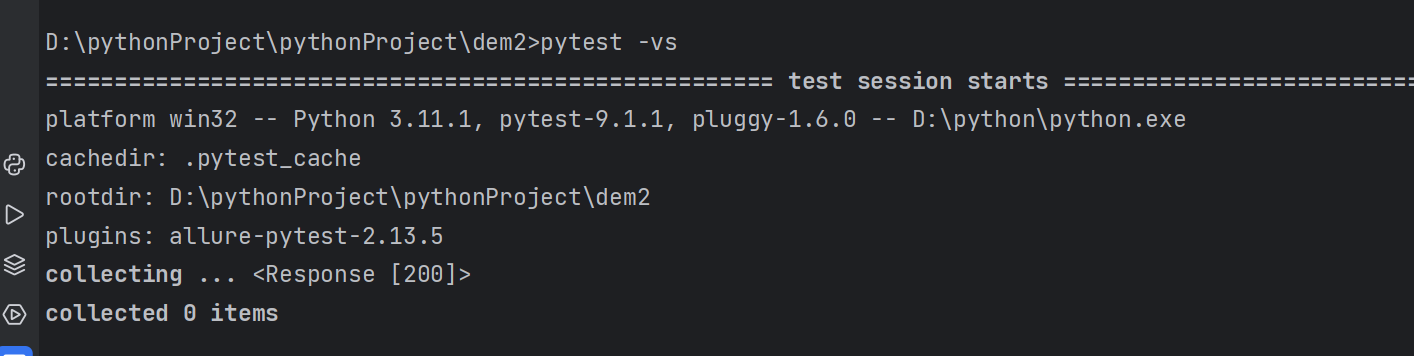
2.4 requests模块
2.4.1 安装
- 命令行通过pip工具进行安装命令
python
#后面可以指定版本号也可以不指定
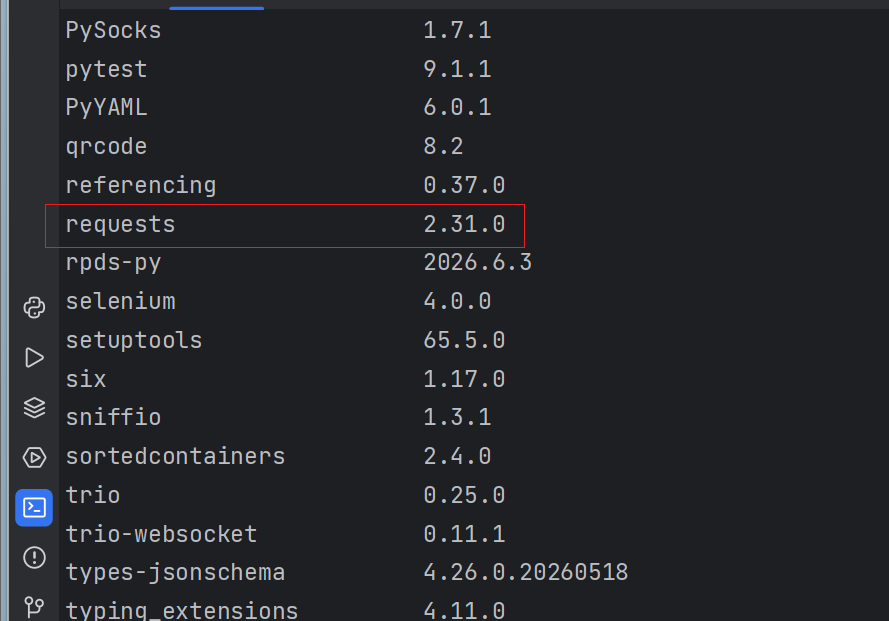
pip install requests==2.31.0
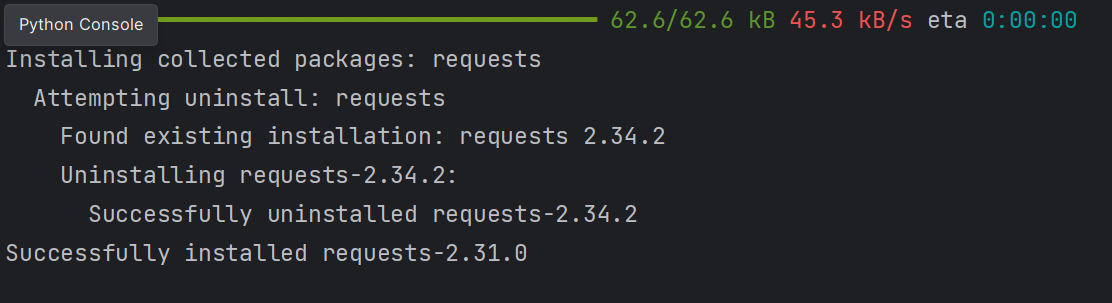
安装成功示例:
- 可以用命令行pip list检查当前项目包是否更新
2.4.2 介绍
requests库是一个非常流行的HTTP客户端,用于发送HTTP请求。requests.get方法用于发送一个HTTP get请求到指定的URL
requests.get方法返回一个Response对象,这个对象包含了服务器返回的所有信息。
比如:
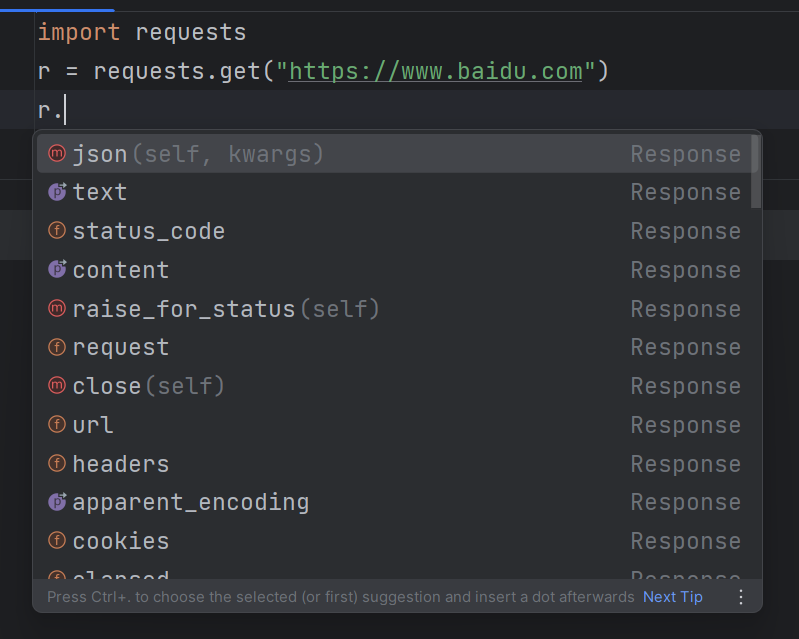
Response对象提供的属性/方法介绍:
| 属性/方法 | 描述 |
|---|---|
r.status_code |
响应状态码 |
r.content |
字节方式的响应体,会自动解码gzip和deflate压缩 |
r.headers |
以字典对象存储服务器响应头,若键不存在则返回None |
r.json() |
Requests中内置的JSON解析方法,将响应体解析为JSON格式 |
r.url |
获取实际请求的URL |
r.encoding |
编码格式,根据响应头部的字符编码确定 |
r.cookies |
获取服务器设置的cookies |
r.raw |
返回原始响应体,不进行任何处理 |
r.text |
字符串方式的响应体,会自动根据响应头部的字符编码进行解码 |
r.raise_for_status() |
失败请求(非200响应)抛出异常 |
2.4.3 常见请求方法
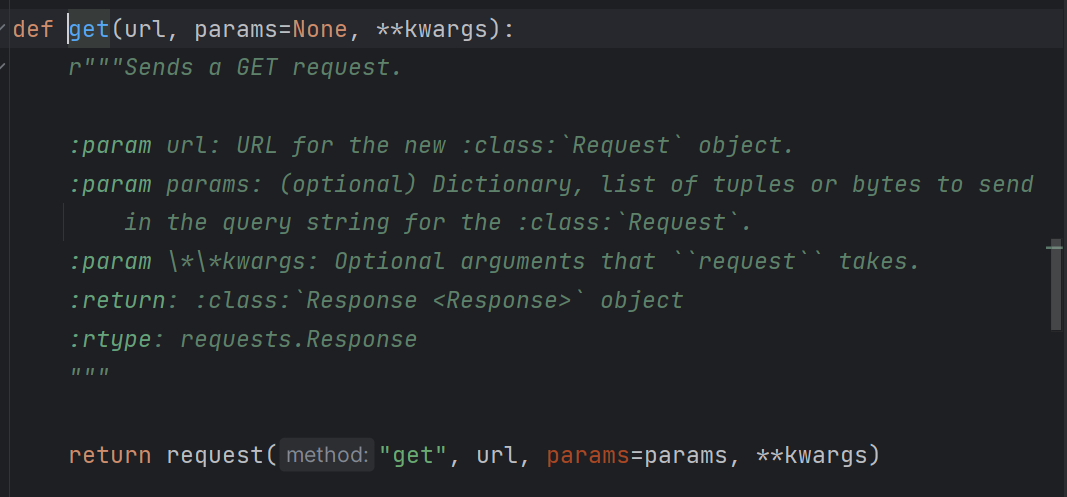
get方法
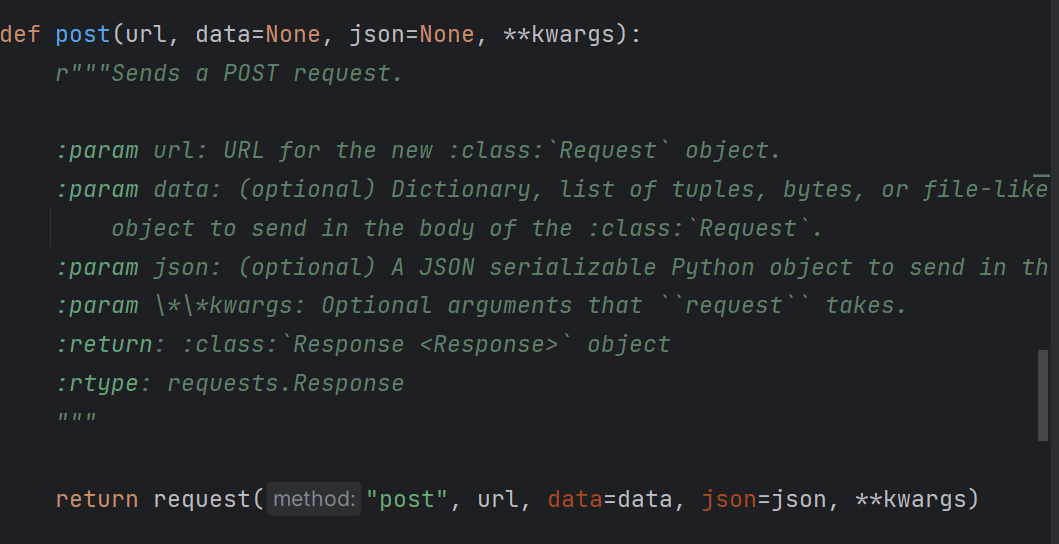
post方法
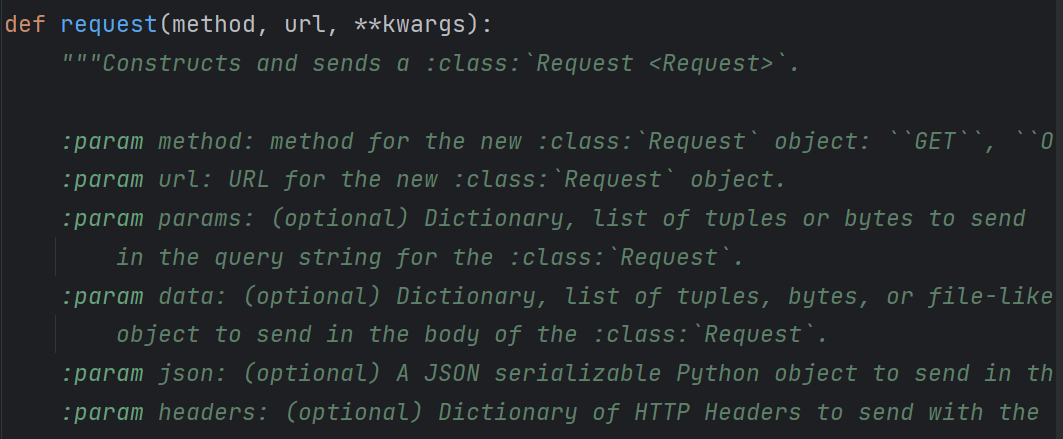
request方法
示例
python
import requests

r_get = requests.get("https://www.baidu.com")
r_post = requests.post("https://www.baidu.com")
r_req1 = requests.request(method="get", url="https://www.baidu.com")
r_req2 = requests.request(method="post", url="https://www.baidu.com")

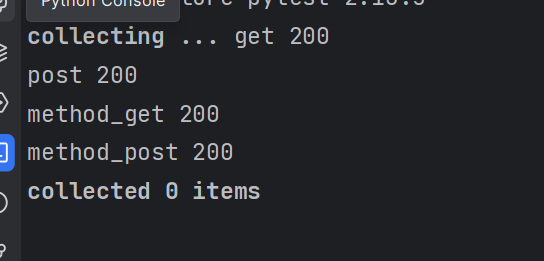
print("get", r_get.status_code)
print("post", r_post.status_code)
print("method_get", r_req1.status_code)
print("method_post", r_req2.status_code)
运行结果:
2.4.4 添加请求信息
get(),post(),底层都是调用request()方法,因此三个方法在发送请求时,传参无太大区别,可传递的参数展示如下:
| 参数 | 说明 |
|---|---|
| url | 请求的接口 |
| headers | 一个字典,包含要发送的HTTP头。 |
| cookies | 一个字典、列表或者 RequestsCookieJar 对象,包含要发送的cookies。 |
| files | 一个字典,包含要上传的文件。 |
| data | 一个字典、列表或者字节串,包含要发送的请求体数据。 |
| json | 一个字典,将被转换为JSON格式并发送。 |
| params | 一个字典、列表或者字节串,将作为查询字符串附加到URL上。 |
| auth | 一个元组,包含用户名和密码,用于HTTP认证。 |
| timeout | 一个浮点数或元组,指定请求的超时时间。 |
| proxies | 一个字典,包含代理服务器的信息。 |
| verify | 一个布尔值或字符串,指定是否验证SSL证书。 |
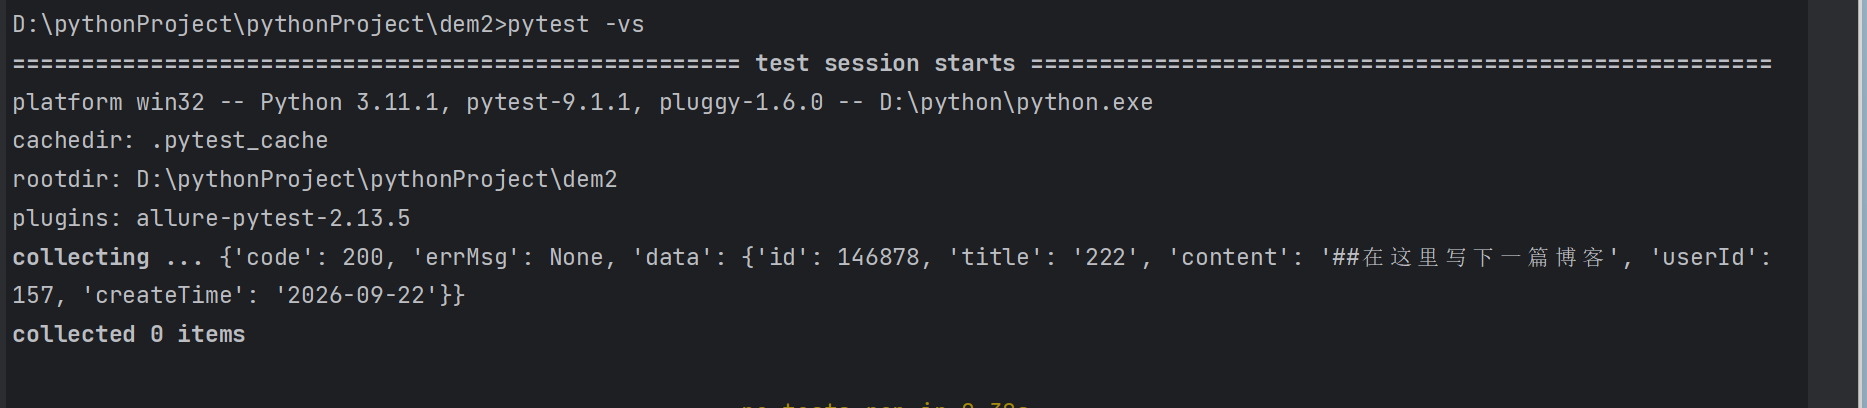
示例1 博客详情接口
python
import requests

url = "http://49.235.61.184:19090/blog/getBlogDetail"

# 定义查询参数
param = {
    "blogId": 146878
}
#定义请求头信息

header = {
    "User_token":"eyJhbGciOiJIUzI1NiJ9.eyJpZCI6MywidXNlck5hbWUiOiJ6aGFuZ3NhbiIsImlhdCI6MTc5MDQ4NTc2OCwiZXhwIjoxNzkxMDkwNTY4fQ.PZhYVu7VqvvjnLtfIPU-s0d6JXgYkw83bXcc1UDShis"
}

r = requests.get(url=url,params=param,headers=header)
print(r.json())
打印结果:
示例2 博客登录接口
python
import requests

url = "http://49.235.61.184:19090/user/login"

data = {
    "userName":"zhangsan",
    "password": "123456"
}

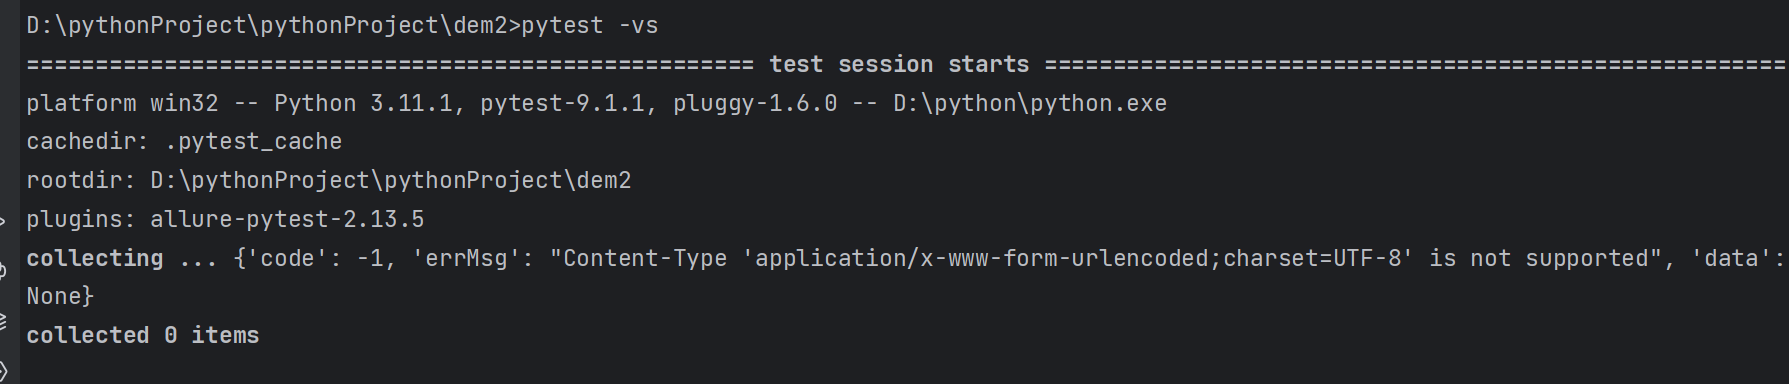
r = requests.post(url=url,data=data)
print(r.json())
运行结果:
2.5自动化框架pytest
主流框架对比:
| 维度 | unittest (Python内置) | pytest | Robot Framework |
|---|---|---|---|
| 安装方式 | 无需安装 (Python标准库) | pip install pytest |
pip install robotframework |
| 语法风格 | 基于类 (需继承 TestCase) | 函数式或面向对象 (无需样板代码) | 关键字驱动 (表格化用例) |
| 断言方法 | self.assertEqual() 等 |
原生 assert 表达式 |
关键字断言 (如 Should Be Equal) |
| 参数化支持 | 需 subTest 或第三方库 |
内置 @pytest.mark.parametrize |
数据驱动 (Test Template) |
| 插件生态 | 少 (依赖扩展库如 HTMLTestRunner) | 丰富 (如 pytest-html、pytest-xdist、allure-pytest) |
一般 (需安装额外库如 RequestsLibrary) |
| 测试报告 | 需插件生成报告 | 支持多格式报告 (HTML、Allure等) | 自带详细日志和报告 |
| 学习曲线 | 中等 (需熟悉xUnit模式) | 低 (语法简洁) | 高 (需掌握关键字和语法) |
| BDD支持 | 不支持 | 支持 (通过 pytest-bdd 插件) |
支持 (通过 robotframework-bdd) |
| 适用场景 | 简单项目或遗留系统维护 | 复杂项目、高扩展性需求 | 团队协作、非技术人员参与 |
2.5.1 pytest介绍
pytest官方文档链接
python
https://docs.pytest.org/en/stable/getting-started.htmlpytest是一个非常流行且高效的Python测试框架,它提供了丰富的功能和灵活的用法,使得编写和运行测试用例变得简单而高效。
2.5.2 安装
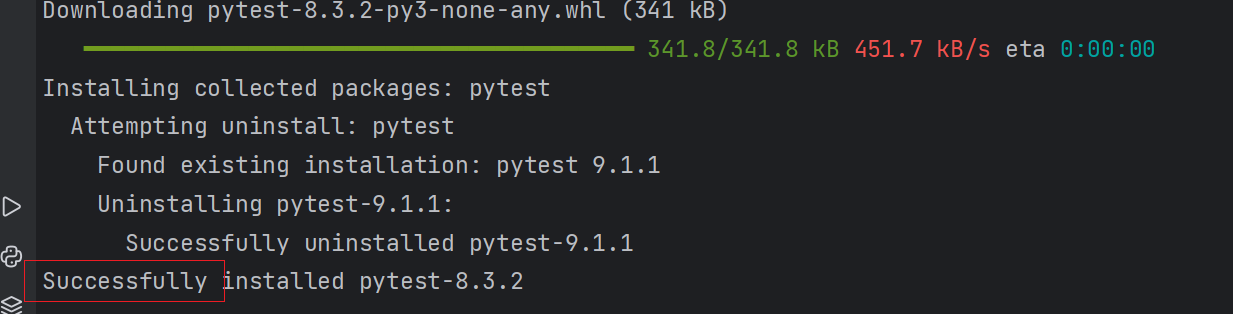
安装pytest8.3.2要求python版本在3.8及以上
pytest
pip install pytest==8.3.2运行结果:
2.5.3 用例运行规则
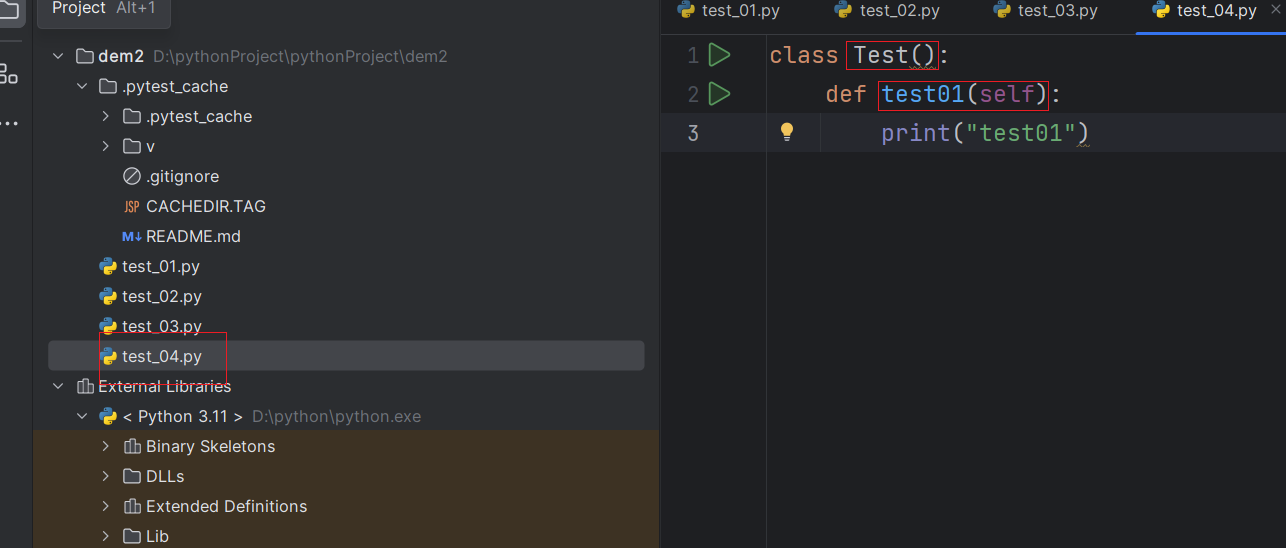
- 1.文件名必须以test_开头或者_test结尾
- 2.测试类必须以Test开头,并且不能有_ _ init_ _方法
- 3.测试方法必须以test开头
示例
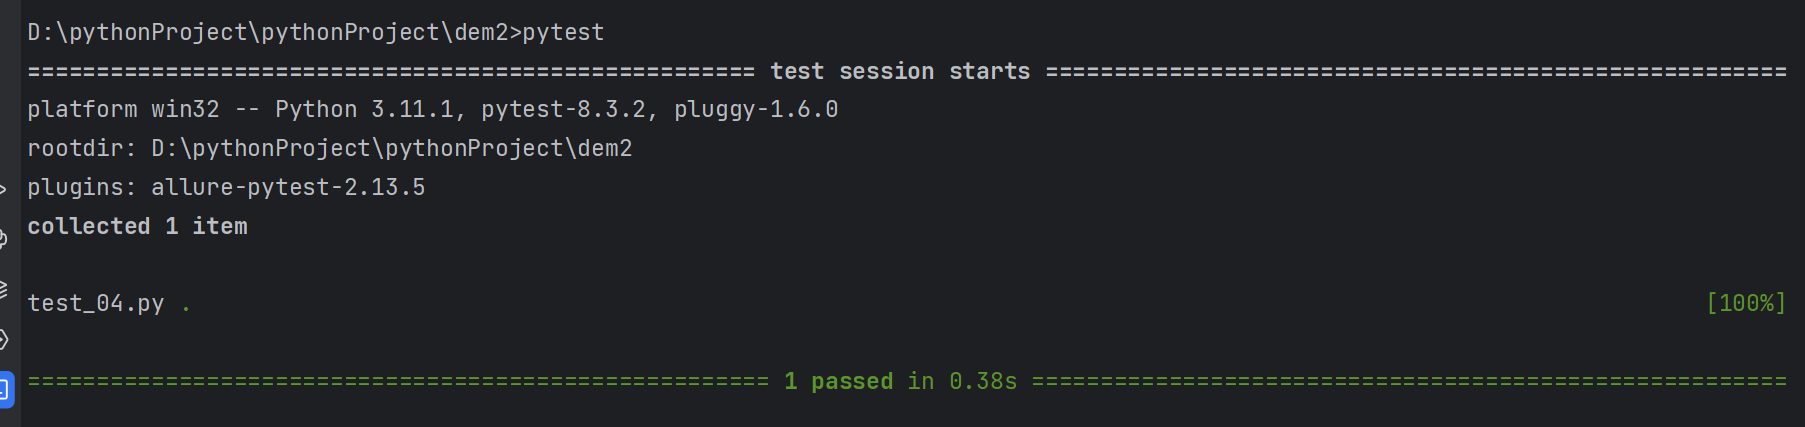
当满足以上要求后,可以通过命令行参数pytest直接运行符合条件的用例:
注意:
Python类中不可以添加_ _ init_ _方法
示例
python
class Test():
    def __init__(self):
        print("init")

    def test01(self):
        print("test01")
运行结果:
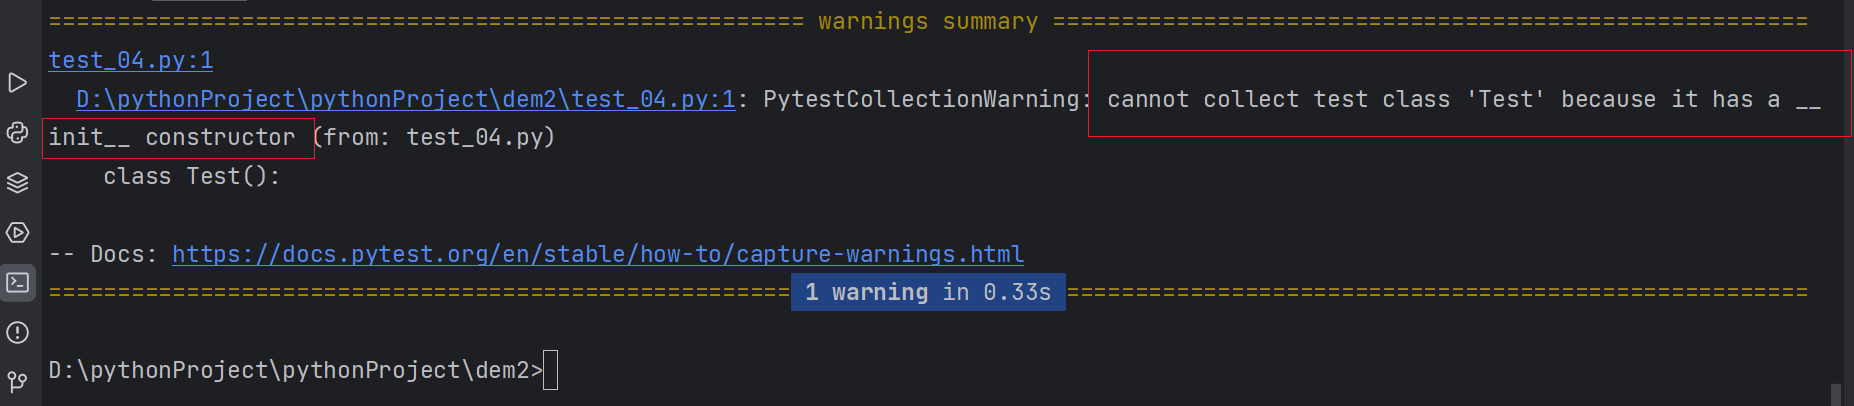
由于 pytest 的测试收集机制,测试类中不可以定义 _ _ init_ _ 方法。pytest 采用自动发现机制来收集测试用例,它会自动实例化测试类,并调用其所有以 test_ 开头的方法作为测试用例。
如果在测试类中定义了 _ _ init_ 方法,那么当 pytest 尝试实例化该类时,可能会因为需要传递额外参数而报错。即使 _ _ init _方法不需要参数,它的执行也可能引入额外的副作用,甚至掩盖或干扰 pytest 自身的测试用例收集与执行机制,从而影响测试结果的准确性。
若测试类中存在初始化操作该采取什么方案?
为了避免使用_ _ init_ _方法,建议在 pytest 中使用其他替代方案,如使用 setup_method() 和 teardown_method() 方法、使用类属性,或者使用 fixture 函数。
2.5.4 pytest命令参数
| 命令 | 描述 | 备注 |
|---|---|---|
pytest |
在当前目录及其子目录中搜索并运行测试。 | |
pytest -v |
增加输出的详细程度。 | |
pytest -s |
显示测试中的 print 语句。 |
|
pytest test_module.py |
运行指定的测试模块。 | |
pytest test_dir/ |
运行指定目录下的所有测试。 | |
pytest -k <keyword> |
只运行测试名包含指定关键字的测试。 | |
pytest -m <marker> |
只运行标记为指定标记的测试。 | |
pytest -q |
减少输出的详细程度。 | |
pytest --html=report.html |
生成 HTML 格式的测试报告。 | 需要安装 pytest-html 插件 |
pytest --cov |
测量测试覆盖率 | 需要安装 pytest-cov 插件 |
下面示例打印的代码
python
class Test():
    def test01(self):
        print("test01")
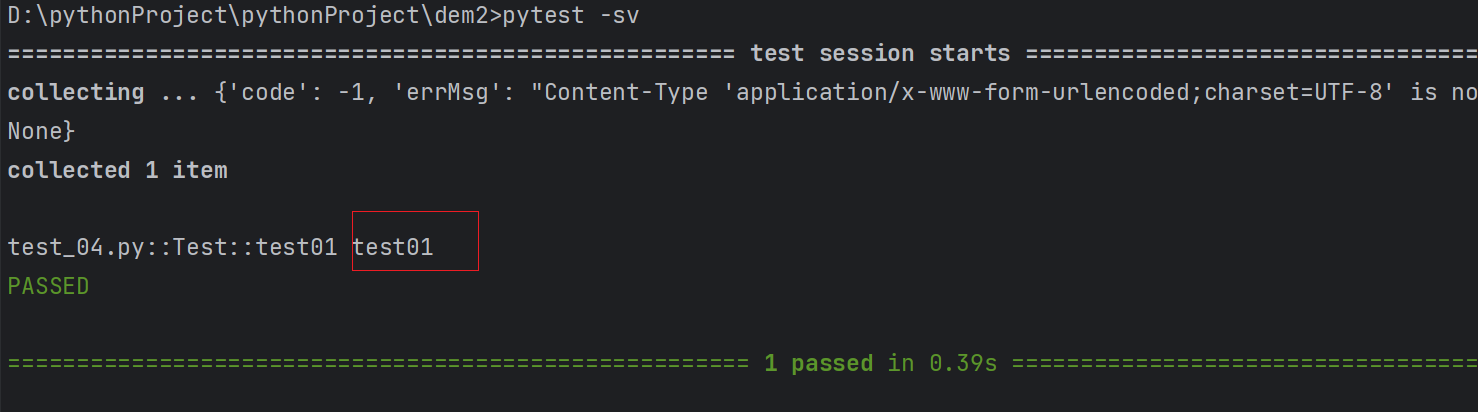
示例1: 详细打印,并输出print内容
python
pytest -s -v 或者 pytest -sv打印结果:
示例2: 指定文件/测试用例
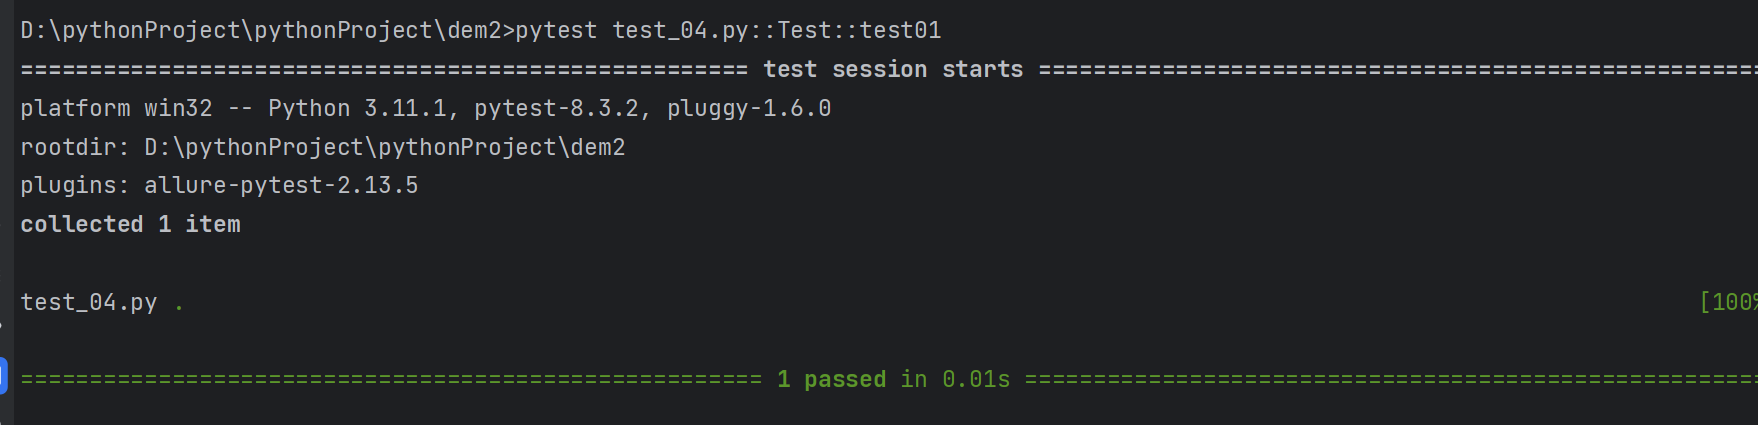
python
# 指定文件:pytest 包名/文件名
例如:pytest cases/test_01.py

# 指定测试用例:pytest 包名/文件名::类名::方法名
pytest cases/test_01.py::Test::test01
打印结果:
那么当我们既要详细输出,又要指定文件时,命令就会变得很长且每次运行都需要手动输入命令,所以我们可以将相关的配置参数统一放到pytest配置文件中,就可以每次不用敲这么长的命令来进行详细输出。
2.5.5 pytest配置文件
在当前项目下创建pytest.ini文件,该文件为pytest的配置文件,以下为常见的配置选项:
| 参数 | 解释 |
|---|---|
addopts |
指定在命令行中默认包含的选项。 |
testpaths |
指定搜索测试的目录。 |
python_files |
指定发现测试模块时使用的文件匹配模式。 |
python_classes |
指定发现测试类时使用的类名前缀或模式。 |
python_functions |
指定发现测试函数和方法时使用的函数名前缀或模式。 |
norecursedirs |
指定在搜索测试时应该避免递归进入的目录模式。 |
markers |
定义测试标记,用于标记测试用例。 |
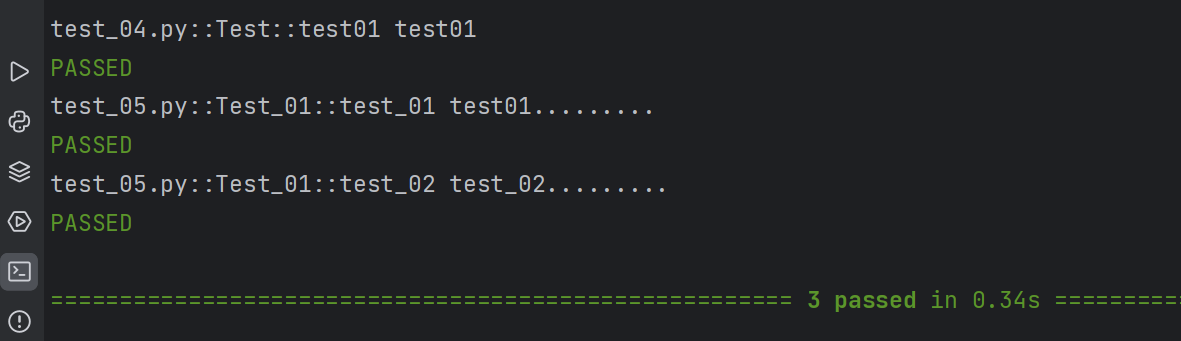
示例详细输出文件名以test_开头且方法
python
class Test:
    def test01(self):
        print("test01")
python
class Test_01:
    def test_01(self):
        print("test01.........")

    def test_02(self):
        print("test_02.........")
配置文件pytest.ini
python
[pytest]
addopts = -vs
python_files = test_*.py
python_classes = Test*
打印结果如下:
2.5.6 前后置
在测试框架中,前后置是指在执行测试用例前和执行测试用例后执行一些额外的操作,这些操作可以用于设置测试环境、准备测试数据,以确保测试的可靠性
pytest框架提供的三种方法做前后置的操作:
- 1.setup_method 和 teardown_method : 这两个方法用于类中的每个测试方法的前置和后置操作。
- 2.setup_class 和 teardown_class : 这两个方法用于整个测试类的前置和后置操作
- 3.fixture:这是pytest推荐的方式来实现测试用例的前置和后置操作。fixture提供了更灵活的控制和更强大的功能。
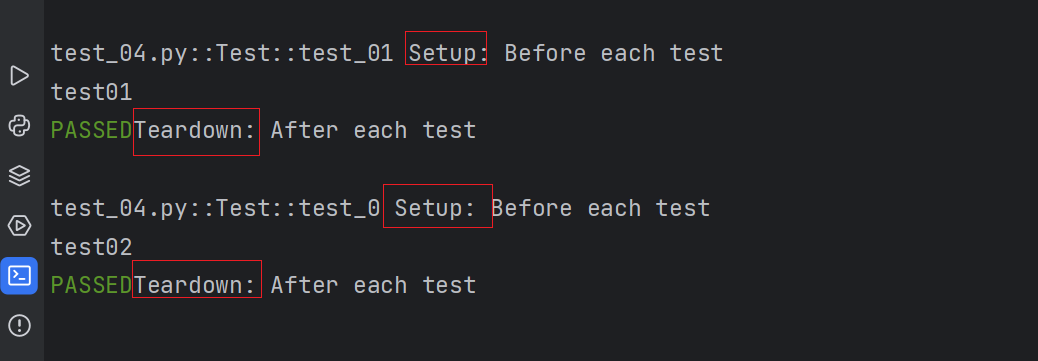
示例1 setup_method 和 teardown_method
python
class Test:
    def setup_method(self):
        print("Setup: Before each test")

    def teardown_method(self):
        print("Teardown: After each test")

    def test_01(self):
        print("test01")

    def test_0(self):
        print("test02")
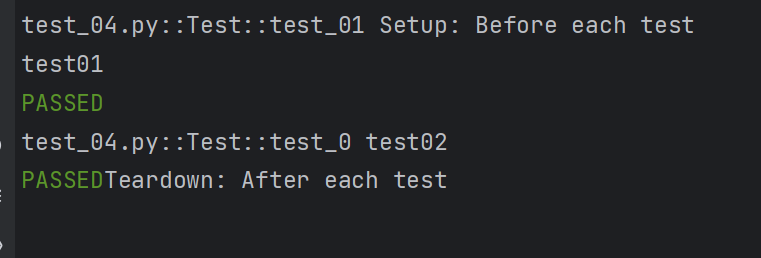
运行结果如下:
示例2:setup_class 和 teardown_class
python
class Test:
    def setup_class(self):
        print("Setup: Before each test")

    def teardown_class(self):
        print("Teardown: After each test")

    def test_01(self):
        print("test01")

    def test_0(self):
        print("test02")
运行结果:
2.5.7 断言
断言assert是一种调式辅助工具,用于检查程序状态是否符合预期。如果断言失败,即条件为假,Python解释器将抛出一个AssertionError异常。断言通常用于检测程序中的逻辑错误。pytest允许你在Python测试中使用标准的Python assert语句来验证预期和值。
基本语法:
python
assert 条件,错误信息- 条件:必须是一个布尔表达式
- 错误信息:当条件为假时,显示的错误信息,可以写也可以不写
免费API学习资源: http://jsonplaceholder.typicode.com/
示例1: 基本数据类型的断言
python
a = 1
b = 2
assert a == b

str = "hello"
assert "hello" == str
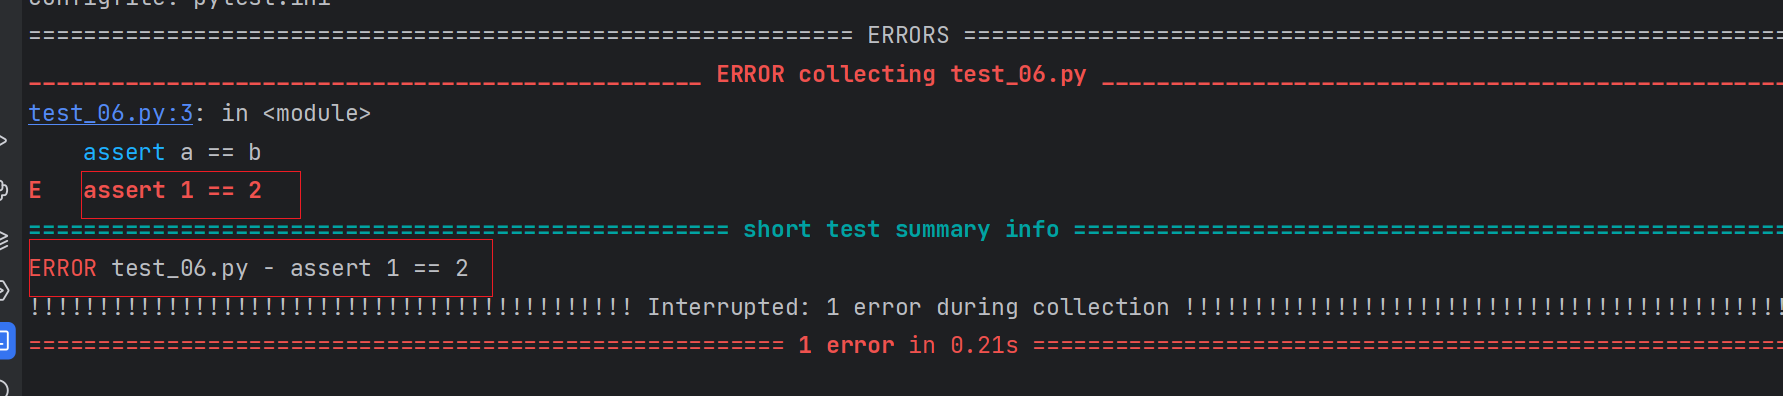
运行结果:可以看到第一个断言失败
示例2: 数据结构断言
python
def test():
   # 断言列表
   expect_list = [1, "hello", True]
   actual_list = [1, "hello", True]
   # 断言元组
   expect_tuple = (1, 'apple', False)
   actual_tuple = (1, 'apple', False)
   # 断言字典
   expect_dict = {'name': 'lisi', 'age': 25}
   actual_dict = {'name': 'lisi', 'age': 25}
   # 断言集合
   expect_set = {1,2,3,'app'}
   actual_set = {1, 2, 3, 'app'}

   # 断言
   assert expect_list == actual_list
   assert expect_tuple == actual_tuple
   assert expect_dict == actual_dict
   assert expect_set == actual_set
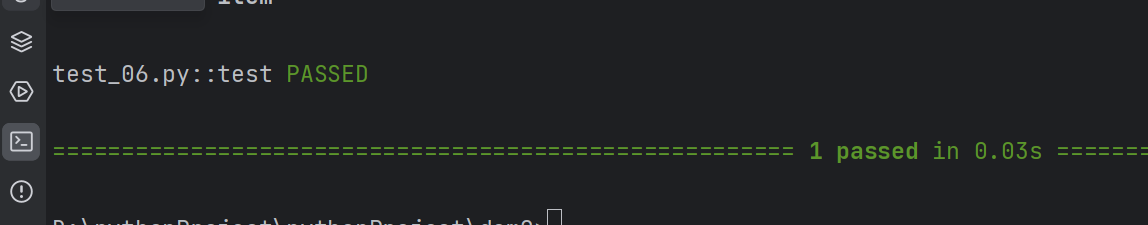
运行结果如下:
示例3: 函数断言
python
def divide(a, b):
    assert b != 0, "除数不能为0"
    return a / b


print(divide(10, 2))

print(divide(10, 0))
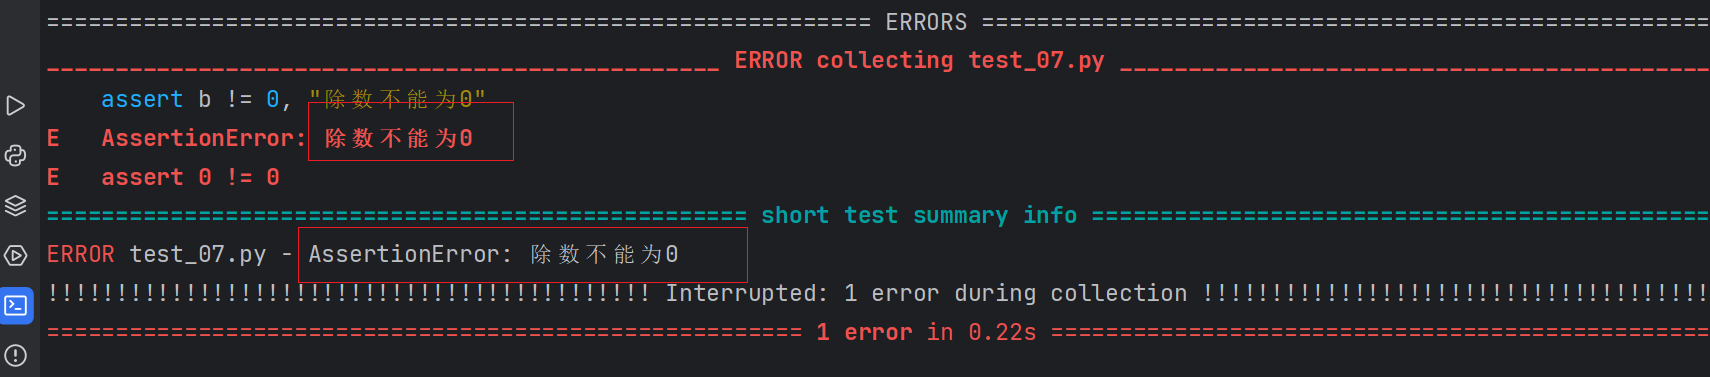
运行结果如下:
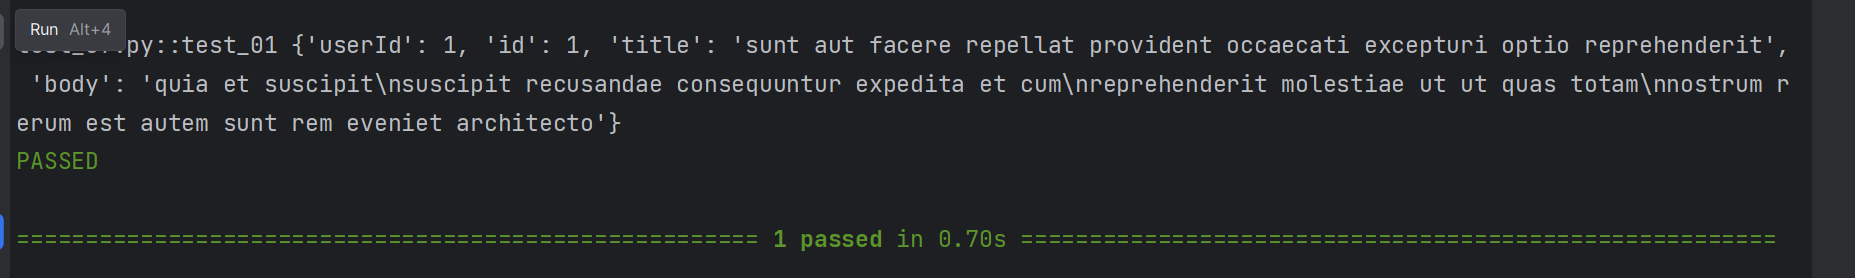
示例4: 接口返回值断言
python
def test_01():
    url = "http://jsonplaceholder.typicode.com/posts/1"
    r = requests.get(url=url)

    expect_data = {
        "userId": 1,
        "id": 1,
        "title": "sunt aut facere repellat provident occaecati excepturi optio reprehenderit",
        "body": "quia et suscipit\nsuscipit recusandae consequuntur expedita et cum\nreprehenderit molestiae ut ut quas totam\nnostrum rerum est autem sunt rem eveniet architecto"
    }
    print(r.json())
    assert r.json()['id'] == 1
    assert r.json() == expect_data
运行结果:
2.5.8 参数化
参数化是自动化设计中的一个重要组成部分,它通过定义设计参数和规则,使得设计过程更加灵活可控。
pytest中内置的pytest.mark.parametrize装饰器允许对测试函数的参数进行参数化。
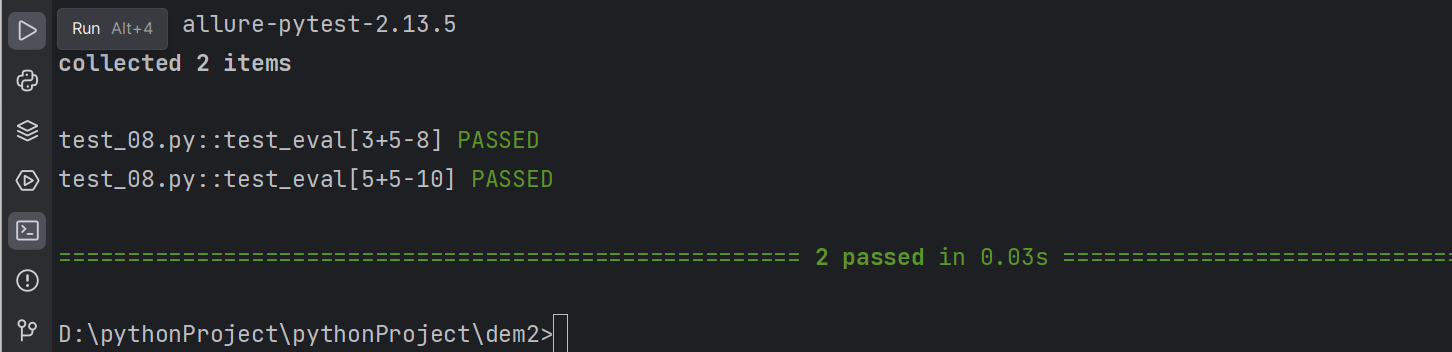
示例1: 在用例上使用参数化
python
#
@pytest.mark.parametrize("test_input,expected", [("3+5", 8), ("5+5",10)])
def test_eval(test_input, expected):
    assert eval(test_input) == expected
(输入1, 预期1), (输入2, 预期2), (输入3, 预期3)
最外层 :告诉 pytest 我要跑几个测试。
里面每个 ( ):告诉 pytest 这一跑,具体传哪些参数。
括号里的元素:必须和函数 def test_xxx(a, b): 里的参数位置一一对应。
打印结果:
示例2: 在类上使用参数化
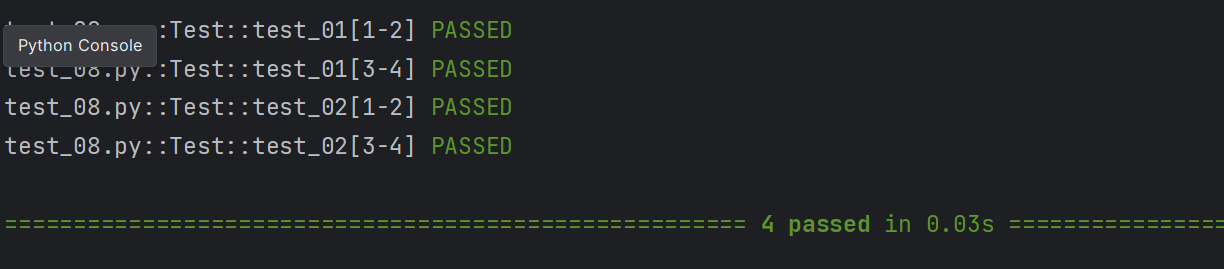
python
@pytest.mark.parametrize("n,expected", [(1, 2), (3, 4)])
class Test:
    def test_01(self, n, expected):
        assert n + 1 == expected

    def test_02(self, n, expected):
        assert (n * 1) + 1 == expected
运行结果如下:
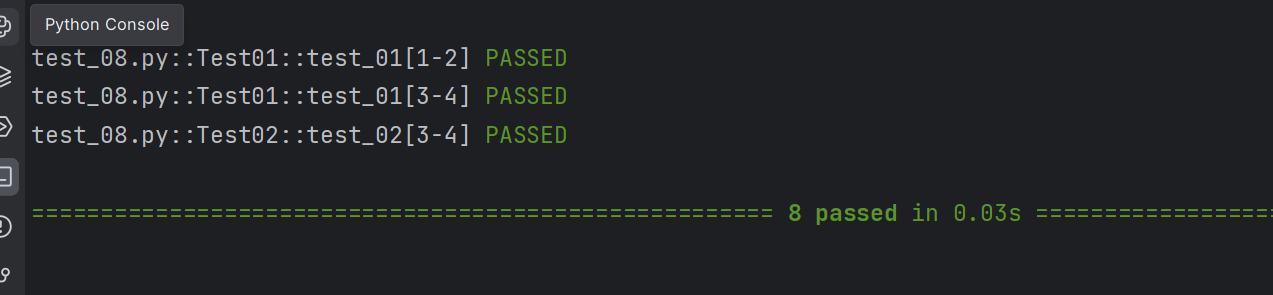
要对模块中的所有测试进行参数化,你可以将pytestmark全局变量赋值
python
import pytest

pytestmark = pytest.mark.parametrize("n,expected", [(1, 2), (3, 4)])


class Test01:
    def test_01(self, n, expected):
        assert n + 1 == expected

    def test_02(self, n, expected):
        assert (n * 1) + 1 == expected


class Test02:
    def test_01(self, n, expected):
        assert n + 1 == expected

    def test_02(self, n, expected):
        assert (n * 1) + 1 == expected
运行结果如下:
除了使用@parametrize添加参数化外,pytest.fixture()允许对fixture函数进行参数化
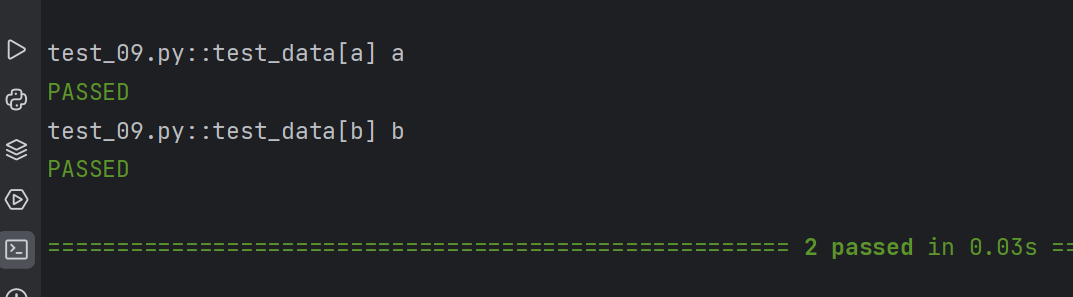
**示例3:**自定义参数化数据源
python
def data_provider():
    return ['a', 'b']


@pytest.mark.parametrize("data", data_provider())
def test_data(data):
    assert data != None
    print(data)
打印结果如下:
2.5.9 fixture
pytest中的fixture是一种强大的机制,用于提供测试函数所需的资源或上下文。它可以用于设置测试环境、准备数据等。以下是fixture的一些核心概念和使用场景
2.5.9.1基本使用
示例1: 使用与不使用fixture标记
不使用fixture方法调用
python
def fixture_01():
    print("第一个方法")


def test_01():
    fixture_01()
    print("第一个测试用例")
使用fixture方法调用
python
@pytest.fixture
def fixture_01():
    print("第一个方法")


def test_01(fixture_01):
    print("第一个测试用例")
未比较fixture方法的调用与fixture标记的方法调用完全不一样,前者需要在方法体中调用,后者可以将函数名作为参数调用
测试脚本中存在很多重复的代码,公用的数据对象时,使用fixture最为合适
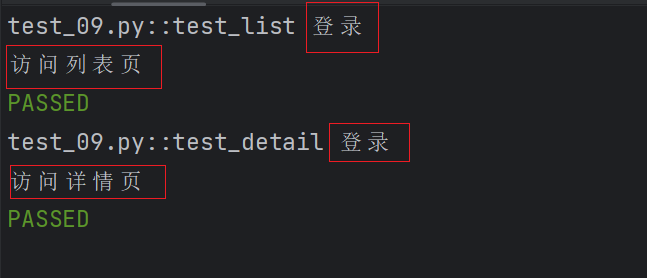
示例2: 访问列表页和详情页之前都需要执行登录操作
python
@pytest.fixture
def login():
    print("登录")


def test_list(login):
    print("访问列表页")


def test_detail(login):
    print("访问详情页")
执行结果如下:
2.5.9.2 fixture嵌套
python
@pytest.fixture
def first():
    return 'a'


@pytest.fixture
def second(first):
    return [first]


def test_01(second):
    second.append('b')

    assert second == ['a', 'b']
测试不必局限于单个的fixture,它们可以依赖于你想要的任意数量的fixture,并且fixture也可以使用其他的fixture。pytest最伟大的优势之一就是极其灵活的fixture系统,它允许我们将测试的复杂需求简化为更简单和有组织的函数,我们只需要每个函数描述它们所依赖的事物。
2.5.9.3 请求多个fixture
python
class Fruit:
    def __init__(self, name):
        self.name = name

    def __eq__(self, other):
        return self.name == other.name

    @pytest.fixture
    def my_fruit(self):
        return Fruit("apple")

    @pytest.fixture
    def fruit_basket(self,my_fruit):
        return [Fruit("banana"),my_fruit]

    def test_my_fruit_in_basket(self,my_fruit,fruit_basket):
        assert my_fruit in fruit_basket
测试和fixture不仅限于一次请求单个fixture,它们可以请求任意多个。
2.5.9.4 yield fixture
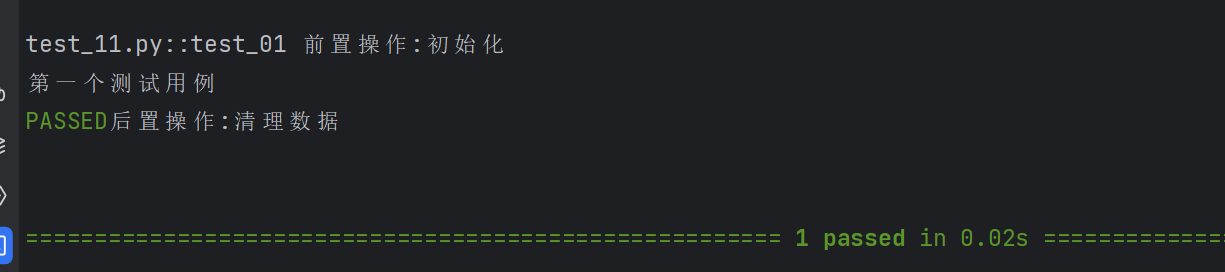
在运行测试时,我们希望确保它们能够自我清理,这样既能避免干扰其他测试,也能避免留下大量测试数据导致系统臃肿。Pytest 中的 fixture 提供了一个非常实用的拆卸系统,它允许我们为每个 fixture 定义具体的清理步骤,而这个功能主要是通过 "Yield" fixture 来实现的。
在 "Yield" fixture 中,我们使用 yield 而不是 return。它与 return 一样,都可以运行一些代码并将准备好的对象返回给请求的 fixture 或者测试函数。唯一的区别在于,return 执行后函数就结束了,而 yield 会将函数暂停在这里,等测试跑完后继续往下走。因此,我们把 yield 之前的代码作为准备阶段,把 yield 之后的代码作为清理阶段。
当 pytest 开始运行时,它会首先确定各个 fixture 的线性依赖顺序,然后正向遍历执行每个 fixture 直到 yield,并把结果层层传递,最后交给测试函数执行。测试完成后,pytest 会逆向遍历 fixture 列表,倒序执行每个 yield 语句之后的清理代码。这就像穿衣服和脱衣服一样,先穿的内衣后穿外套,脱的时候必须先脱外套再脱内衣(后进先出,LIFO)。
总而言之,yield fixture 就像一种租借服务。yield 之前是把资源租借给测试,测试完成后,pytest 会按照相反的顺序,根据 yield 后面写的规则将资源收回并清理干净,从而确保每个测试都能在一个干净的环境中运行。
示例1
python
@pytest.fixture
def open_close():
    print("前置操作:初始化")

    yield

    print("后置操作:清理数据")

def test_01(open_close):
    print("第一个测试用例")
运行结果如下:
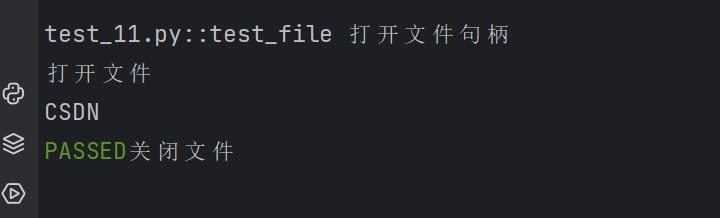
示例2创建文件句柄与关闭文件
python
@pytest.fixture()
def read_file():
    print("打开文件句柄")

    fo = open(file="text.txt", mode='r')

    yield fo

    print("关闭文件")
    fo.close()


@pytest.fixture
def write_file():
    print("打开文件")

    fo = open(file="text.txt", mode='w', encoding="utf-8")

    yield fo


def test_file(read_file, write_file):
    w = write_file
    w.write("CSDN")
    w.close()
    r = read_file
    print(r.read())
运行结果:
2.5.9.5 带参数的fixture
代码块
python
pytest.fixture(scope='', params='', autouse='', ids='', name='')参数详解:
scope参数用于控制fixture的作用范围,决定了fixture的生命周期。可选值有:function(默认):每个测试函数都会调用一次fixture。class:在同一个测试类中共享这个fixture。module:在同一个测试模块中共享这个fixture。(一个文件里)session:整个测试会话中共享这个fixture。
autouse参数默认为False。如果设置为True,则每个测试函数都会自动调用该fixture,无需显式传入params参数用于参数化fixture,支持列表传入。每个参数值都会使fixture执行一次,类似于for循环ids参数与params配合使用,为每个参数化实例指定可读的标识符(给参数取名字)name参数用于为fixture显式设置一个名称。如果使用了name,则在测试函数中需要使用这个名称来引用fixture(给fixture取名字)
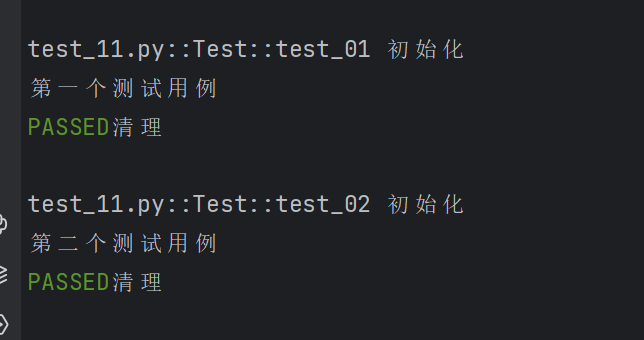
示例1: scope的使用- 1.scope="function"
python
@pytest.fixture(scope="function")
def fixture_01():
    print("初始化")

    yield

    print("清理")


class Test:
    def test_01(self, fixture_01):
        print("第一个测试用例")

    def test_02(self, fixture_01):
        print("第二个测试用例")
运行结果:
- 2.scope="class"
python
@pytest.fixture(scope="class")
def fixture_01():
    print("初始化")

    yield

    print("清理")


class Test:
    def test_01(self, fixture_01):
        print("第一个测试用例")

    def test_02(self, fixture_01):
        print("第二个测试用例")
运行结果:
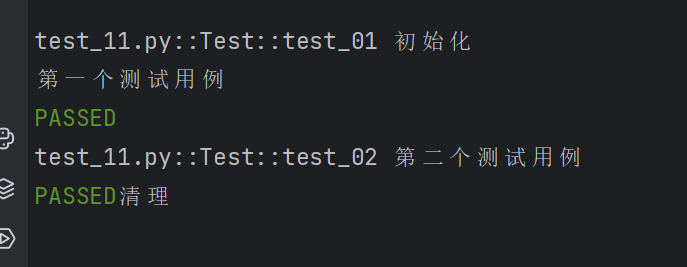
scope默认为function,这里的function可以省略不写,当scope="function"时,每个测试函数都会调用一次fixture。scope="class"时,在同一个测试类中,fixture只会在类中的第一个测试函数开始前执行一次,并在类中的最后一个测试函数结束后执行清理。
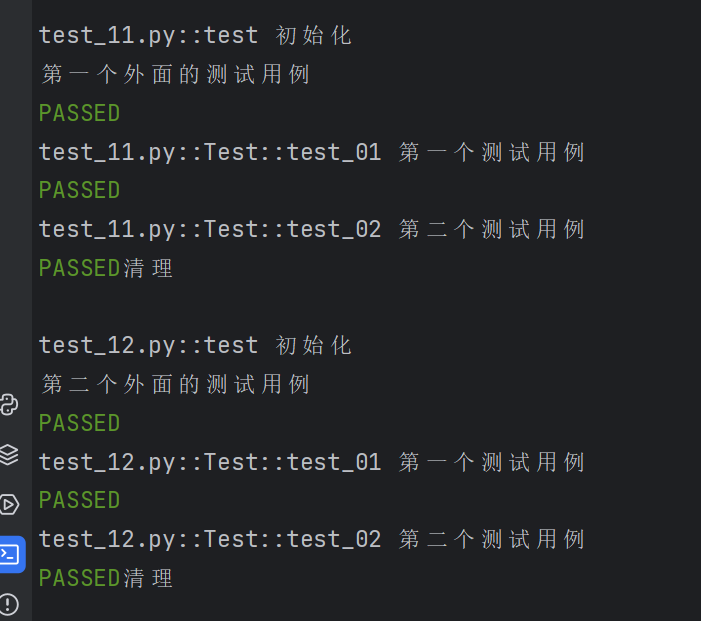
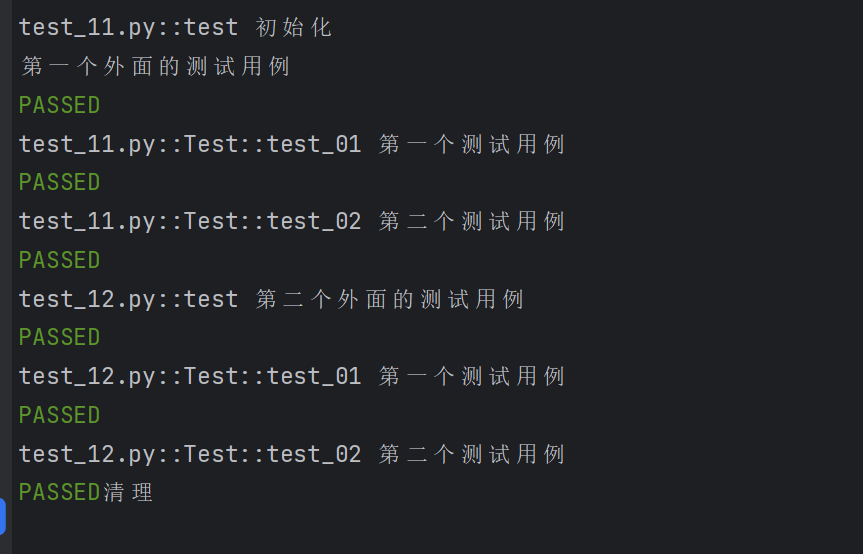
当scope="moudle",scope="session"时,可以用于实现全局的前后置应用,这里需要多个文件配合使用。
conftest.py和@pytest.fixture结合使用实现全局的前后置应用
@pytest.fixture与conftest.py文件结合使用,可以实现在多个测试模块文件中共享前后置操作,这种结合方法使得可以在整个测试项目中定义和维护通用的前后置逻辑,使测试代码更加模块化和可维护。
规则:
- conftest.py是一个单独存放的夹具配置文件,名称是固定的不能修改
- 可以在项目中不同目录下创建多个conftest.py文件,每个conftest.py文件都会对其所在的目录及其子目录下的测试模块生效
- 在不同模块的测试中需要用到conftest.py文件的前后置功能时,不需要做任何的import导入操作
- 作用:可以在不同的.py文件中使用同一个fixture函数
示例2: 全局的前后置应用 - 1.scope="moudle"
conftest配置文件
python
@pytest.fixture(scope="module")
def fixture_01():
    print("初始化")

    yield

    print("清理")
第一个测试文件
python
def test(fixture_01):
    print("外面的测试用例")


class Test:
    def test_01(self, fixture_01):
        print("第一个测试用例")

    def test_02(self, fixture_01):
        print("第二个测试用例")
第二个测试文件
python
def test(fixture_01):
    print("第二个外面的测试用例")


class Test:
    def test_01(self, fixture_01):
        print("第一个测试用例")

    def test_02(self, fixture_01):
        print("第二个测试用例")
运行结果:
- 2.scope="session"
conftest配置文件
python
@pytest.fixture(scope="session")
def fixture_01():
    print("初始化")

    yield

    print("清理")
第一个测试文件
python
def test(fixture_01):
    print("外面的测试用例")


class Test:
    def test_01(self, fixture_01):
        print("第一个测试用例")

    def test_02(self, fixture_01):
        print("第二个测试用例")
第二个测试文件
python
def test(fixture_01):
    print("第二个外面的测试用例")


class Test:
    def test_01(self, fixture_01):
        print("第一个测试用例")

    def test_02(self, fixture_01):
        print("第二个测试用例")
运行结果:
示例3 autouse的使用
python
@pytest.fixture(scope="class", autouse=True)
def fixture_01():
    print("初始化")

    yield

    print("清理")


class Test:
    def test_01(self):
        print("第一个测试用例")

    def test_02(self):
        print("第二个测试用例")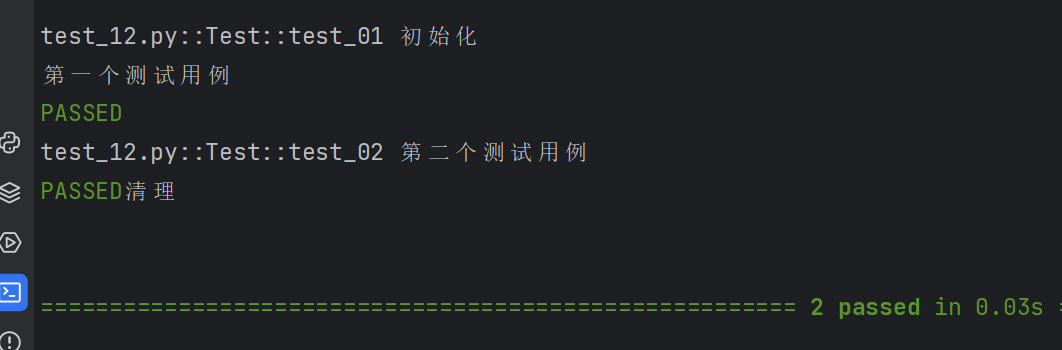
autouse=True,每个测试函数都会自动调用该fixture,无需显式传入
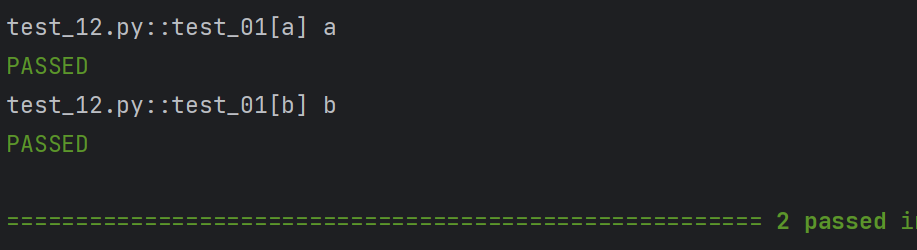
示例4: 通过params实现参数化
python
@pytest.fixture(params=['a', 'b'])
def data_provider(request):
    return request.param


def test_01(data_provider):
    assert data_provider is not None
    print(data_provider)
运行结果:
前面pytest中通过 @pytest.mark.parametrize 实现参数化,通过 fixture 也可以实现参数化,那么到底哪一种更好呢?
如果测试场景主要涉及简单的参数传递,且不需要复杂的资源管理,建议使用parametrize,因为它更简单直接;如果测试需要动态加载外部数据,或者需要管理复杂的测试资源(如数据库连接、文件操作等),建议使用fixture,在某些情况下,也可以结合使用parametrize和fixture,以充分利用两者的优点。总结来说,parametrize 更适合简单场景,而 fixture 更适合需要动态数据和资源管理的复杂场景。
2.6 YAML
yaml官方文档:https://pyyaml.org/wiki/PyYAMLDocumentation
YAML是一种数列话语言,用于以人类可读的形式存储信息。它类似XML和JSON文件,但使用更简洁的语法。
特点:
- 1.YAML 是一种非常简单的基于文本的人类可读的语言,用于在人和计算机之间交换数据。
- 2.YAML 不是一种编程语言。它主要用于存储配置信息。
- 3.YAML 的缩进就像 Python 的缩进一样优雅。
- 4.YAML 还减少了 JSON 和 XML 文件中的大部分"噪音"格式,例如引号、方括号和大括号。
注意:
-
- YAML 是区分大小写。
-
- YAML 不允许使用制表符 Tab 键,(你之所以按下 Tab YAML 仍能使用,是因为编辑器被配置为按下 Tab 键会导致插入适当数量的空格)。
-
- YAML 是遵循严格缩进的。
2.6.1 YAML介绍
YAML文件的后缀名是.yaml或.yml,常用的是.yml
yaml中支持不同的数据类型,但在写法上面稍有区别:
| 类型 | YAML | JSON |
|---|---|---|
| 简单标量值 | key: value |
{ "key": "value" } |
| 整数和浮点数 | int_key: 123 float_key: 123.456 |
{ "int_key": 123, "float_key": 123.456 } |
| 布尔值 | bool_key: true |
{ "bool_key": true } |
| 字符串 | string_key: "This is a string" |
{ "string_key": "This is a string" } |
| 列表 | list_key: - item1 - item2 - item3 |
{ "list_key": ["item1", "item2", "item3"] } |
| 映射 (字典) | map_key: sub_key1: sub_value1 sub_key2: sub_value2 |
{ "map_key": { "sub_key1": "sub_value1", "sub_key2": "sub_value2" } } |
| 嵌套结构 | nested_key: list_key: - item1 - item2 map_key: sub_key1: sub_value1 sub_key2: sub_value2 |
{ "nested_key": { "list_key": ["item1", "item2"], "map_key": { "sub_key1": "sub_value1", "sub_key2": "sub_value2" } } } |
我们也有很多工具可以将json转成yaml格式
2.6.2 YAML使用
yaml通常作为配置文件来使用,可以使用yaml库来读取和写入YAML文件
- 1.安装yaml库
python
pip install PyYAML==6.0.1- 2.创建yaml文件
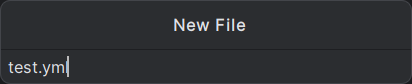
- 3.读取和写入yaml文件
python
def write_yaml(filename, data):
    with open(file=filename, mode='a+', encoding='utf-8') as f:
        yaml.safe_dump(data=data, stream=f)


def read_yaml(filename, key):
    with open(file=filename, mode='r') as f:
        data = yaml.safe_load(f)
        return data[key]


def clear_yaml(filename):
    with open(file=filename, mode='w') as f:
        f.truncate()


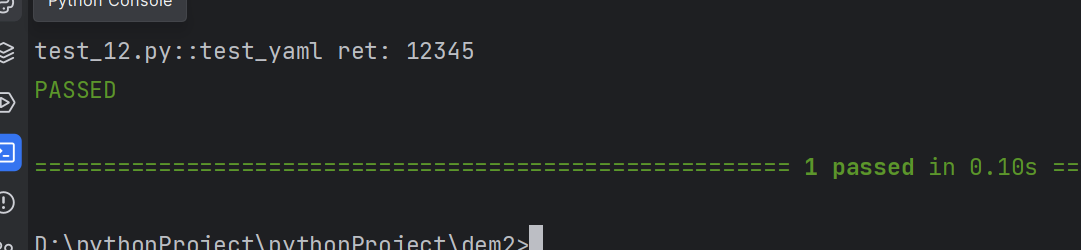
def test_yaml():
    data = {'str': 12345}
    write_yaml("test.yml", data)
    ret = read_yaml("test.yml", 'str')
    print("ret:", ret)
    clear_yaml("test.yml")
运行结果:
2.7 JSON Schema
JSON Schema一个用来定义和校验JSON的web规范,简而言之,JSON Schema是用来校验json是否符合预期。
根据json创建JSON Schema后,你可以使用你选择的语言中的验证器将示例数据与你的模式进行验证。
2.7.1 安装JSON Schema
python
pip install jsonschema==4.23.02.7.2 介绍
json格式
python
{
  "code": "SUCCESS",
  "errMsg": "",
  "data": false
}
jsonschema格式
python
{
  "type": "object",
  "required": [],
  "properties": {
    "code": {
      "type": "string"
    },
    "errMsg": {
      "type": "string"
    },
    "data": {
      "type": "string"
    }
  }
}
通过上面比对可见,JSON_Schema从多个方面对JSON数据进行校验。
如"type","required","properties"等以确保其正确性和一致性。
json转jsonschema工具: https://tooltt.com/json2schema/
工具不是万能的,可能存在错误,需要自动生成的结果进行二次检查
2.7.2.1 数据类型
type 关键字指定了数据类型。
可以验证 JSON 数据中每个属性的数据类型是否符合预期。常用的数据类型包括:
| type | 解释 |
|---|---|
| string | 字符串类型,用于文本数据。 |
| number | 数字类型,用于表示浮点数。 |
| integer | 整数类型,用于表示整数。 |
| boolean | 布尔类型,值为 true 或 false。 |
| object | 对象类型,用于嵌套的 JSON 对象。 |
| array | 数组类型,用于列表或集合。 |
| null | 空值类型。 |
示例:
json
{
  "type": "object",
  "properties": {
    "name": { "type": "string" },
    "age": { "type": "integer" }
  }
}
properties是一个验证关键字。当你定义properties时,你创建了一个对象,其中每个属性代表正在验证的 JSON 数据中的一个键。
2.7.2.2 最大最小值
minimum和maximum:指定数值的最小值和最大值。exclusiveMinimum和exclusiveMaximum:指定数值必须严格大于或小于某个值(不包含等于)。
示例:
json
{
  "type": "object",
  "properties": {
    "age": {
      "type": "integer",
      "minimum": 0,
      "maximum": 120
    }
  }
}
2.7.2.3 字符串特殊校验
pattern:使用正则表达式来验证字符串是否符合特定的模式。
json
{
  "type": "object",
  "properties": {
    "email": {
      "type": "string"
    },
    "username": {
      "type": "string",
      "pattern": "\\S+"
    }
  }
}
上诉
"\\S+"是一个正则表达式,\S代表"非空白字符",+代表"一个或多个"。所以这个pattern的作用是强制username字段不能包含空格、制表符等空白字符 。(注:在 JSON 字符串中,反斜杠
\需要转义,所以写成了\\S+,实际解析出来的正则就是\S+。)
2.7.2.4 数组约束
minItems和maxItems:指定数组的最小和最大长度。uniqueItems:确保数组中的元素是唯一的。items:定义数组中每个元素的类型和约束。
代码块:
json
{
  "type": "object",
  "properties": {
    "tags": {
      "type": "array",
      "items": { "type": "string" },
      "minItems": 1,
      "uniqueItems": True
    }
  }
}
2.7.2.5 对象约束
minProperties和maxProperties:指定对象的最小和最大属性数量。additionalProperties:控制是否允许对象中存在未在properties中定义的额外属性,默认为True。
代码块:
json
{
  "type": "object",
  "properties": {
    "name": { "type": "string" }
  },
  "minProperties": 1,
  "additionalProperties": False
}
2.7.2.6 必需属性
通过 required 关键字,JSON Schema 可以指定哪些属性是必需的。如果 JSON 实例中缺少这些必需属性,验证将失败。
示例:
json
{
  "type": "object",
  "properties": {
    "name": { "type": "string" },
    "email": { "type": "string" }
  },
  "required": ["name", "email"]
}
2.7.2.7 依赖关系
dependentRequired 可以定义属性之间的依赖关系。例如,如果某个属性存在,则必须存在另一个属性。
示例:
json
{
  "type": "object",
  "properties": {
    "creditCard": { "type": "string" },
    "billingAddress": { "type": "string" }
  },
  "dependentRequired": {
    "creditCard": ["billingAddress"]
  }
}
creditCard(信用卡)和billingAddress(账单地址)都是可选属性。但是,一旦数据中包含了creditCard属性,那么billingAddress就必须存在,否则验证就会失败。
2.8 logging日志模块
2.8.1介绍
logging是Python标准库中的一个模块,它提供了灵活的日志记录功能。通过logging,开发者可以方便地将日志信息输出到控制台,文件,网络等多种目标,同时支持不同级别的日志记录,以满足不同场景下的需求。
2.8.2 使用
示例1 全局logging
python
# 日志最低输出级别为INFO
logging.basicConfig(level=logging.INFO)
logging.debug('This is a debug message')
logging.info('This is an info message')
logging.warning('This is a warning message')
logging.error('This is an error message')
logging.critical('This is a critical message')
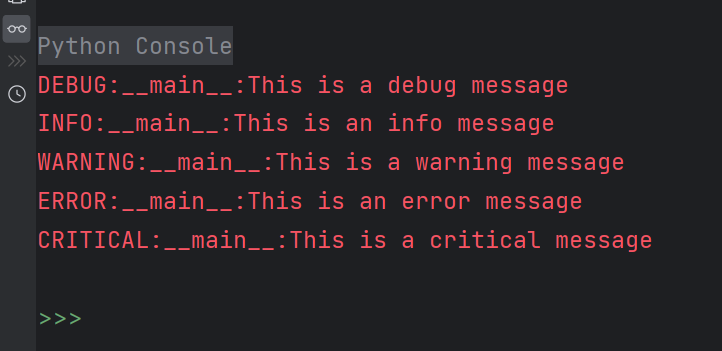
示例2 自定义logger并输出到控制台
python
logging.basicConfig(level=logging.INFO)

# 获取一个日志记录器对象,名称为当前模块的名称
logger = logging.getLogger(__name__)
# 设置日志记录器的级别为DEBUG
#  意味着所有DEBUG以上的日志都会被记录
logger.setLevel(logging.DEBUG)

if __name__ == "__main__":
    logger.debug('This is a debug message')
    logger.info('This is an info message')
    logger.warning('This is a warning message')
    logger.error('This is an error message')
    logger.critical('This is a critical message')
打印结果:
示例3:自定义logger并输出日志文件
python
logging.basicConfig(level=logging.INFO)

logger = logging.getLogger(__name__)

logger.setLevel(level=logging.WARNING)

hander = logging.FileHandler(filename="text.log")
# 将这个处理器添加到日志记录器中
# 这样,日志记录器就会使用这个处理器来处理日志信息
logger.addHandler(hander)
if __name__ =="__main__":
    logger.debug('This is a debug message')
    logger.info('This is an info message')
    logger.warning('This is a warning message')
    logger.error('This is an error message')
    logger.critical('This is a critical message')
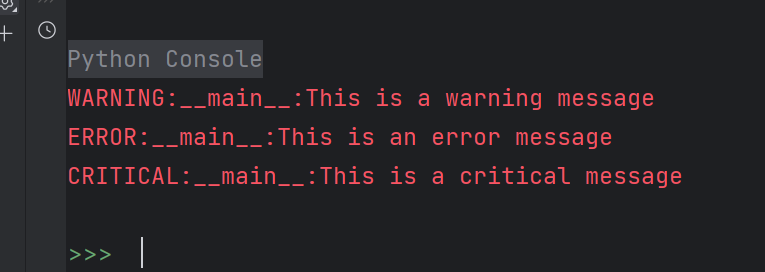
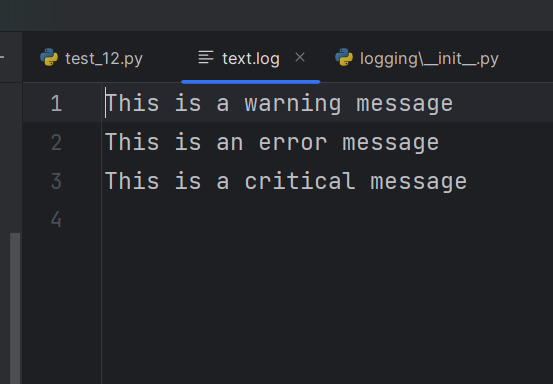
打印结果:
示例4:设置日志格式
python
logging.basicConfig(level=logging.INFO)

logger = logging.getLogger(__name__)

logger.setLevel(level=logging.WARNING)

handler = logging.FileHandler(filename="text.log")
# 创建一个日志格式器对象
formatter = logging.Formatter(
    "%(asctime)s %(levelname)s [%(name)s] [%(filename)s (%(funcName)s:%(lineno)d)] - %(message)s"
)

# 将格式器设置到处理器上
handler.setFormatter(formatter)
# 将这个处理器添加到日志记录器中
# 这样,日志记录器就会使用这个处理器来处理日志信息
logger.addHandler(handler)

if __name__ =="__main__":
    logger.debug('This is a debug message')
    logger.info('This is an info message')
    logger.warning('This is a warning message')
    logger.error('This is an error message')
    logger.critical('This is a critical message')
打印结果:
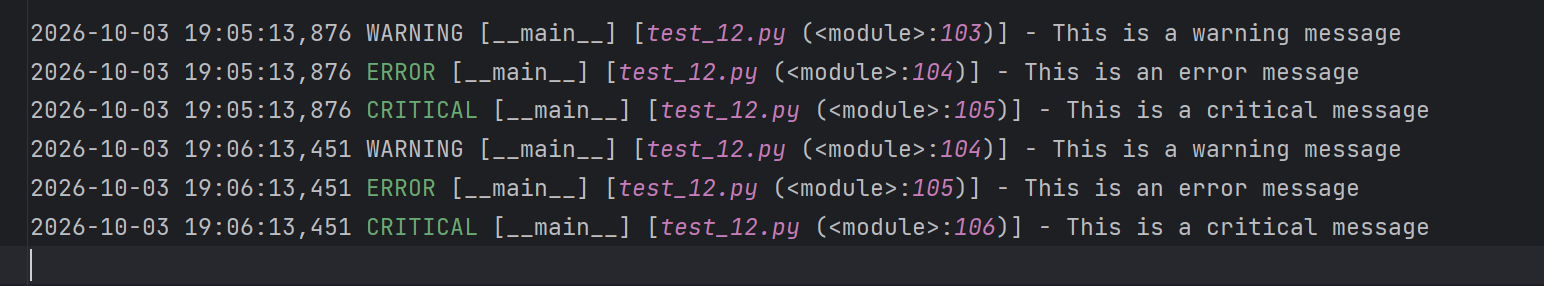
logging.Formatter 是用于定义日志输出格式的类。在构造函数中,传递了一个格式字符串,用于指定日志信息的格式。格式字符串中使用了一些特殊的占位符(以 % 开头),这些占位符会被替换为相应的日志信息内容
| 格式占位符 | 说明 |
|---|---|
%(asctime)s |
日志记录的时间戳,通常显示为日期和时间。 |
%(levelname)s |
日志级别(如 DEBUG、INFO、WARNING、ERROR、CRITICAL)。 |
%(name)s |
日志记录器的名称,通常为模块名称。 |
%(filename)s |
日志记录发生的文件名。 |
%(funcName)s |
日志记录发生的函数名。 |
%(lineno)d |
日志记录发生的行号。 |
%(message)s |
日志消息本身。 |
handler.setFormatter(formatter) 将创建的格式器对象设置到处理器上。这意味着处理器在处理日志信息时,会使用这个格式器来格式化日志信息
通过这种方式,可以控制日志信息的输出格式,使其包含你感兴趣的信息,如时间戳、日志级别、文件名、函数名、行号等。
2.9测试报告allure
官方文档: https://allurereport.org/docs/pytest-configuration
2.9.1介绍
Allure Report由一个框架适配器和allure命令行工具组成,是一个流行的开源工具,用于可视化的测试运行结果。它可以很少甚至零配置的方法添加到测试工具流中。它生成的报告可以在任何地方打开,并且所有人都可以阅读,不需要深厚的技术知识。
2.9.2 安装
- 1.下载allure-pytest包
python
pip install allure-pytest==2.13.5- 2.下载Windows版的Allure报告
下载链接: https://repo.maven.apache.org/maven2/io/qameta/allure/allure-commandline/2.30.0/ - 3.解压
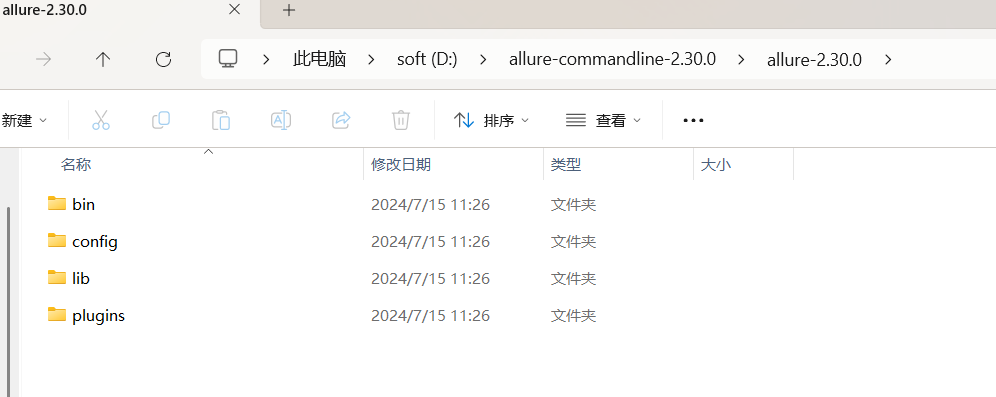
- 4.添加系统环境变量
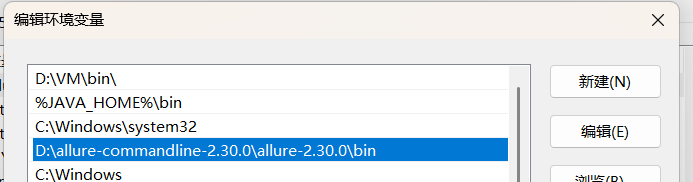
- 5确认结果,打开cmd查看版本,出现对应版本号则安装成功。
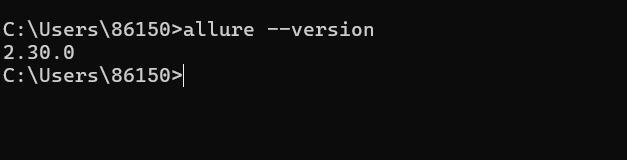
2.9.3 使用
1.运行自动化,并指定测试报告放置路径
python
pytest --alluredir=allure-results
python
def test_01():
    print("第一个测试用例")


def test_02():
    print("第二个测试用例")
运行结果:
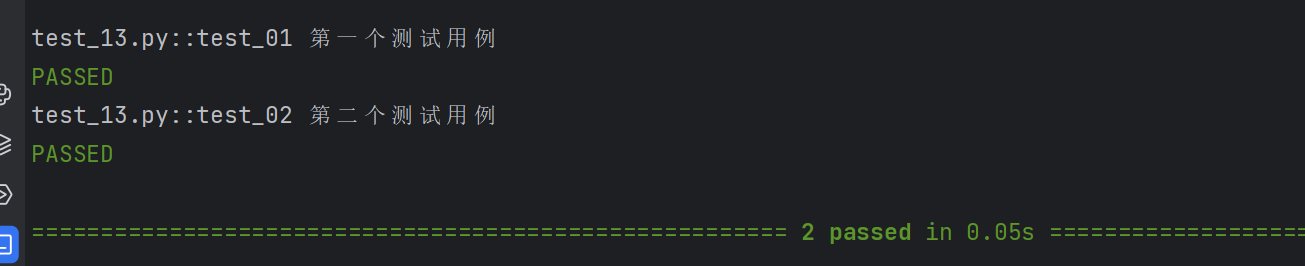
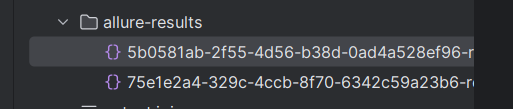
在allure-results文件夹中生成了两个测试报告
2.查看测试报告
方法1:启动一个本地服务器来在浏览器中展示测试报告
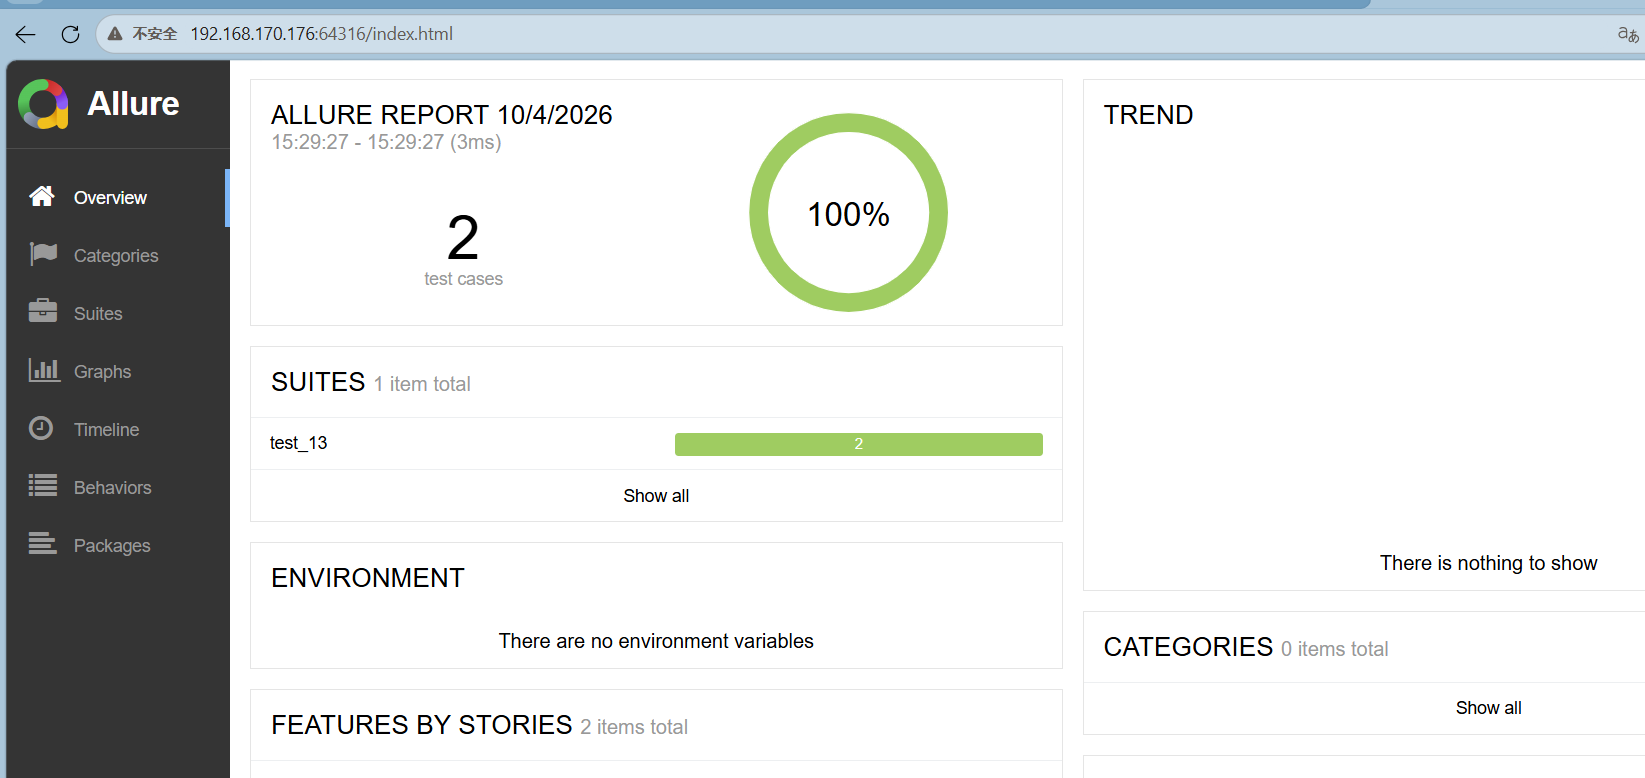
终端执行命令:allure serve [options] <allure-results>,自动在浏览器打开测试报告
--host:指定服务器监听的主机地址,默认为localhost。--port:指定服务器监听的端口号,默认为0(自动选择空闲端口)--clean-alluredir:清除上一次生成的测试报告
示例:
bash
# 不指定端口号和主机地址
allure serve .\allure-results\
bash
# 指定端口号
allure serve --port 8787 .\allure-results\
bash
# 清除上一次生成的测试报告
allure serve .\allure-results\ --clean-alluredir
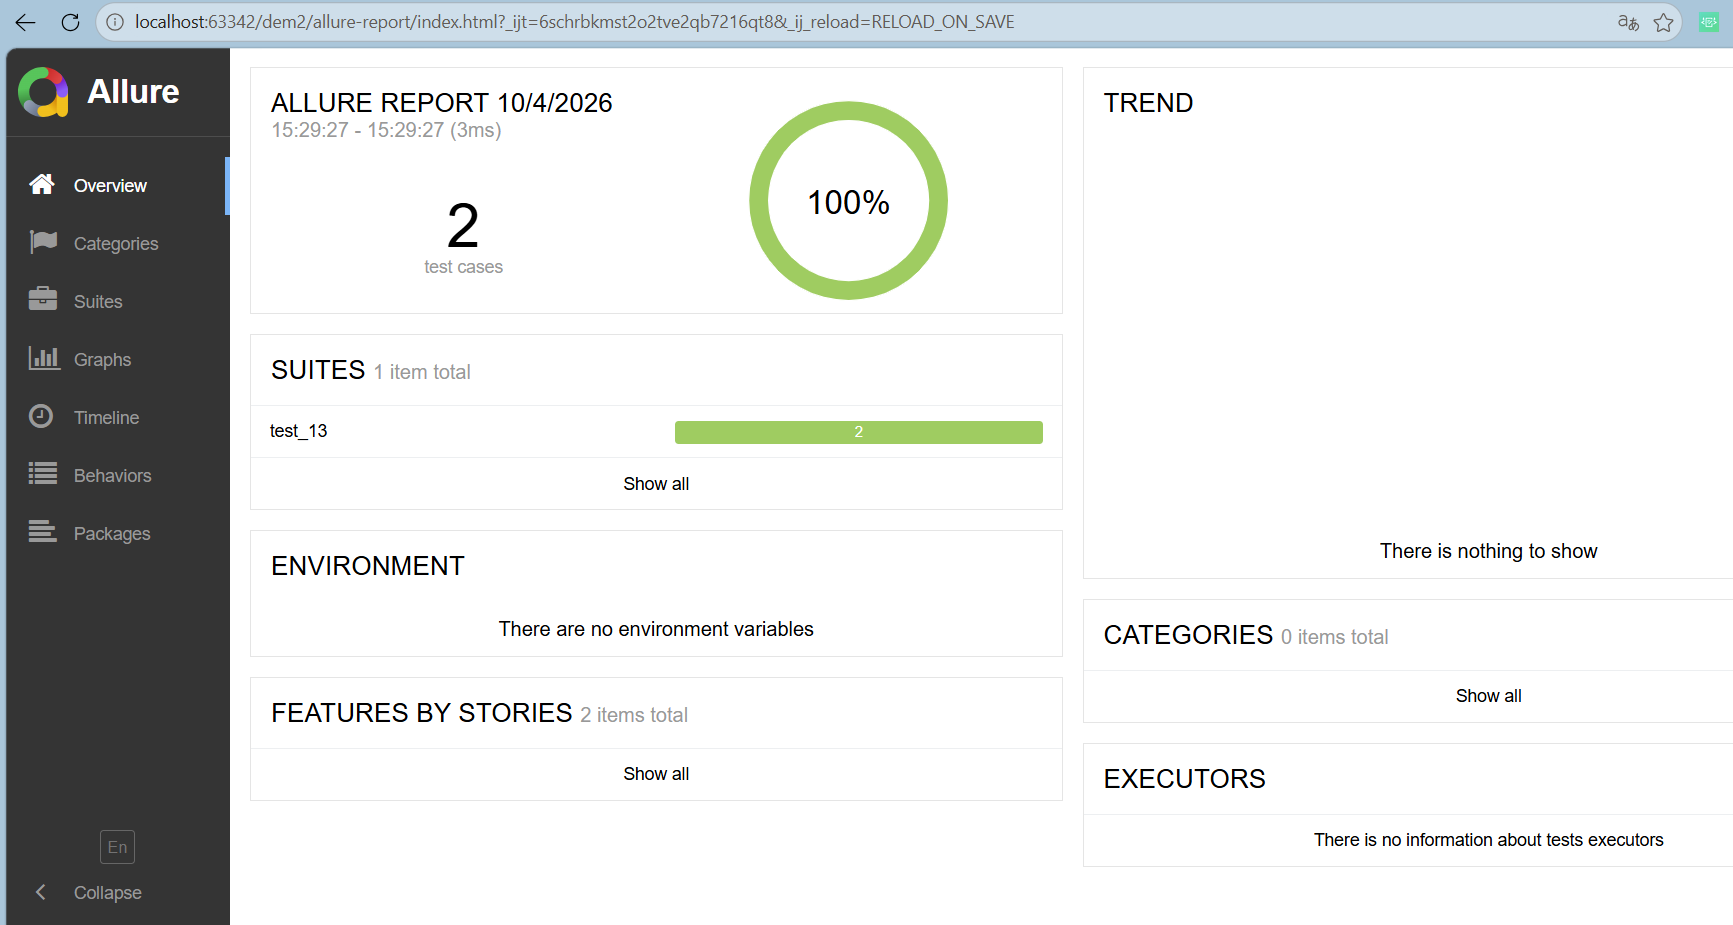
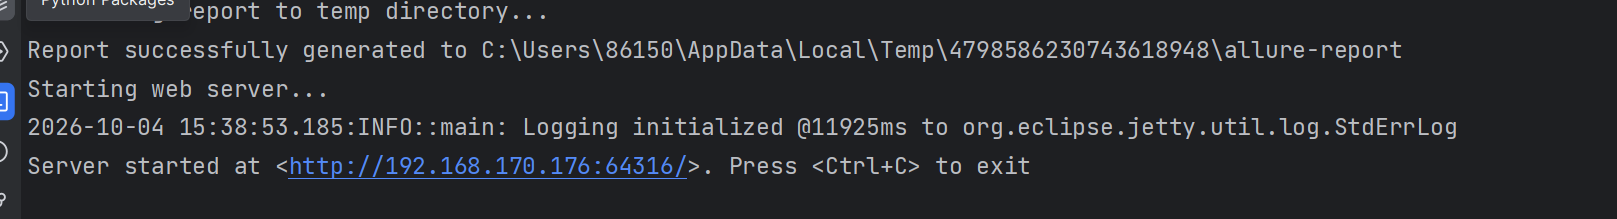
在python中运行结果如下:
方法2:从测试结果生成测试报告
终端执行命令:allure generate [options] <allure-results> -o <reports>
示例:
bash
# 用 Allure 根据已有的测试结果,生成一份静态的 HTML 测试报告,并在生成前清空旧的报告目录。
allure generate .\allure-results\ -o .\allure-report --clean
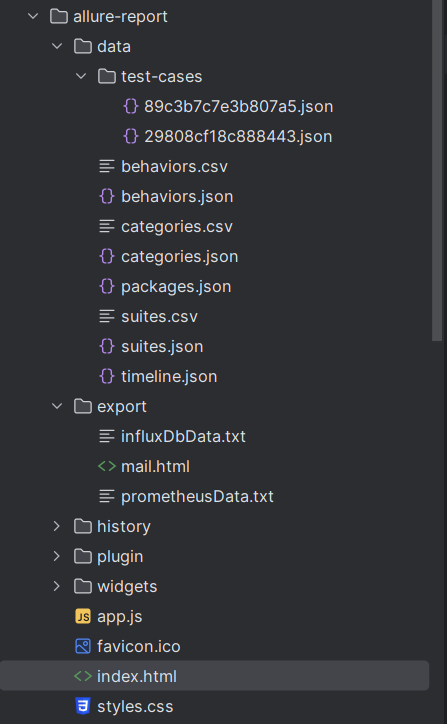
运行结果如下: