一个电商 SaaS 后台的「订单详情」页,回归一直用截图像素比对做。某个版本前端换了一版设计 token------间距调了几像素、圆角从直角改成微圆、字重从 500 提到 600,业务逻辑一行没动。第二天早上,300 张基线图全红。团队对着满屏 diff 排查了一上午,最后确认:不是 bug,是样式重构把像素全改了。
于是有人提议,别用像素比对了,改人工看图。结果没过两个迭代,一次真缺陷就这么溜过去了:订单金额字段在某个边界场景下渲染成了 NaN,肉眼扫过去「页面长得挺正常」,没人多看那一格。像素比对太敏感,一有风吹草动就全红;人工看图又太钝,真正的业务错误反而看不出来。断言这一环,卡在了两个极端中间。
本篇只聊一件事:视觉驱动的 UI 测试里,「断言」到底该怎么做。像素快照比对和语义断言各自擅长什么、又会骗在哪,以及为什么最稳的往往是把两者拼起来的混合策略。不聊选择器自愈,也不聊 UI 就绪判定------那是另外两篇的事,这里只钉「怎么断言」这一环。
一、像素比对的强项与代价
先说结论:像素快照比对(Playwright 的 toHaveScreenshot 是典型代表)擅长抓「视觉不该变却变了」,代价是对任何样式变动零容忍。
它的强项很实在:确定性极高,同一张图必过、差一个像素必挂,不存在模型那种「这次这么判、下次那么判」的漂移;对于「这个按钮的位置被挤歪了」「这块区域莫名多了一条边」这类纯视觉回归,它抓得又快又准。
代价也同样实在。第一是脆弱:样式重构、字体渲染差异、抗锯齿抖动,都能让基线图整片飘红,上面那个 300 张全红就是活例子。第二是维护成本高:每次合理的视觉改动都要重新录制基线,录多了没人敢删也没人敢信。第三,也是最反直觉的一点------它对业务逻辑缺陷其实很钝。金额从 100 变成 NaN,只要那块区域的像素变化没超过阈值、或者刚好被 maxDiffPixelRatio 放行,像素比对是抓不到的。它比的是「像不像」,不是「对不对」。
这里还藏着一个调参两难:maxDiffPixelRatio 这个阈值调松了,真缺陷被放过(金额变了几个像素也算「在容忍范围内」);调紧了,样式重构又全红。你找不到一个「既宽松到容忍合理改版、又严格到抓住业务错误」的完美阈值------因为像素比对压根不区分「这个变化是样式还是语义」,在它眼里所有变化都只是像素差异而已。这正是它抓不住 NaN 的根因,也是为什么单纯调阈值救不了它。
二、语义断言 aiAssert:对样式免疫,但会「骗」
语义断言走的是另一条路。以 Midscene 的 aiAssert 为例,你用自然语言写下业务意图------「页面是否正确显示了订单金额,金额不是 NaN、不是空」------由模型去看页面、理解语义、给出判断。它对样式重构天然免疫:圆角改没改、字重提没提,模型根本不在意,它只关心「金额这个业务事实对不对」。
这套路线现在的能力已经不弱。Midscene 官方站给出的几组数字能说明问题:AndroidWorld 上 Pass@1 达到 93.1%,MobileWorld 是 78.6%(92/117 个任务),AppControlBench 是 96.7%。视觉驱动这条路在标准化基准上已经相当能打。
但语义断言会「骗」,这是必须正视的风险。模型有不确定性,同一句断言,这次判过、下次可能判挂;更麻烦的是它可能给出过于宽松的「看起来对」------页面上明明金额是空的,模型却觉得「整体布局正常」就放行了。断言语句写得越模糊,这种宽松误判的概率越高。所以语义断言不能裸用,尤其在金额、状态这种「错一个字符就是资损」的关键字段上。
三、混合策略:全局语义 + 关键数值区小范围像素
结论先行:最稳的做法不是二选一,而是分工------全局层面用语义断言吃下样式免疫和业务意图,关键数值区用小范围像素比对兜底。下面是完整可运行的示例。
// order-detail.spec.js ------ 订单详情页的混合断言策略
// 依赖安装:npm i -D @playwright/test @midscene/web
// 按官方文档配置 MIDSCENE_MODEL_NAME / OPENAI_API_KEY 等环境变量
const { test, expect } = require('@playwright/test');
const { PlaywrightAgent } = require('@midscene/web/playwright');
const fs = require('fs');

// aiAssert 失败时:把模型解释与截图一起落到报告
asyncfunction assertWithReport(agent, page, assertion, name) {
try {
    await agent.aiAssert(assertion);
  } catch (err) {
    fs.mkdirSync('reports', { recursive: true });
    const shot = `reports/${name}-fail.png`;
    await page.screenshot({ path: shot, fullPage: true });
    // Midscene 默认会在 midscene_run/report 下生成含模型推理过程的 HTML 报告
    console.error(`[aiAssert 失败] ${name}: ${err.message}`);
    console.error(`[失败截图] ${shot}`);
    throw err;
  }
}

test('订单详情:全局语义 + 金额区小范围像素', async ({ page }) => {
// 1. 登录并进入订单详情
await page.goto('https://saas.example.com/login');
await page.fill('#username', process.env.TEST_USER);
await page.fill('#password', process.env.TEST_PASS);
await page.click('button[type="submit"]');
await page.waitForURL('**/dashboard');
await page.goto('https://saas.example.com/orders/20260915001');
await page.waitForSelector('[data-testid="order-detail"]', { state: 'visible' });

const agent = new PlaywrightAgent(page);

// 2. 用 aiQuery 把关键字段抽成结构化数据
const data = await agent.aiQuery(
    '{orderNo: string, amount: string, status: string},' +
    '抽取订单详情页上的订单号、订单金额、订单状态'
  );

// 3. 用 aiAssert 做业务语义断言(对样式重构免疫)
await assertWithReport(agent, page,
    '页面正确显示了订单金额,金额不是 NaN、不是空、不是 undefined', 'amount');
await assertWithReport(agent, page,
    '订单状态是「已支付」「待发货」「已完成」中的一种', 'status');

// 4. 对「金额区域」这一小块做定向快照比对(关键数值用小范围像素兜底)
const amountBox = page.locator('[data-testid="order-amount"]');
await expect(amountBox).toHaveScreenshot('order-amount.png', { maxDiffPixelRatio: 0.01 });

// 5. 断言 aiQuery 抽到的金额能被解析成有限数字(防 NaN 类真缺陷)
const numeric = Number(String(data.amount).replace(/[^\d.]/g, ''));
  expect(Number.isFinite(numeric)).toBe(true);
});
这段代码的核心是「分工」。全局层面用 aiQuery 把订单号、金额、状态抽成结构化数据、用 aiAssert 做业务语义断言------这两步对样式重构免疫,前端把圆角改一改、间距调一调,断言照样过。唯独金额这一块,我们额外用 toHaveScreenshot 做了个小范围定向快照。为什么给金额单独开小灶?因为金额是那种「错一个字符就是资损」的字段,语义断言万一给了个「看起来对」的宽松判断,代价太大;用一小块像素比对兜底,等于给最关键的数值上了双保险。踩过的坑有两个:别把整页快照和语义断言二选一,整页快照会被样式重构全红、纯语义又可能在关键字段上过于宽松,混合才稳;aiAssert 的断言语句要写得具体、可判定,别写「页面正常」这种模糊话,写成「金额不是 NaN、不是空、不是 undefined」,模型才有明确的判定边界。
四、aiAssert 失败时,怎么让报告说人话
像素比对失败,你得到的是一张 diff 图,红一块绿一块,到底哪里不对得自己猜。语义断言有个隐性优势:它失败时能给出模型的解释。
上面代码里的 assertWithReport 包装做了两件事:失败时先 page.screenshot 存一张全页截图,再把错误信息打出来。Midscene 本身默认会在 midscene_run/report 目录下生成一份带模型推理过程的 HTML 报告,配合这张截图,评审时你能直接看到「模型认为哪里不对、它当时看到了什么」,而不是对着一张 diff 图开会猜。这就是为什么在「失败可诊断性」这一维度上,语义断言和混合策略明显占优------它把失败从一个像素差异,变成了一句接近人话的解释。
五、关于那些跑分:Pass@1 和 Pass@3 不是一回事
第二节引了 Midscene 的几组数字,这里必须把口径说清楚,因为它们太容易被误读。除了 Pass@1 的 93.1%,Midscene 在 AndroidWorld 上还有一个 Pass@3 是 97.4%。
Pass@1 是「只给模型一次机会就成功」的比例,Pass@3 是「给三次机会里至少成功一次」的比例------后者天然更高,衡量的是「多试几次能不能成」,跟前者根本不是一套口径,不能拿来直接对比,更不能和别处评测综述里某个长得相近的数字混着读。判断语义断言在你的业务场景里稳不稳,要盯的是 Pass@1 那一档,因为你的 CI 里一条断言通常只跑一次,没有「再来两次」的机会。把这些数字看清楚,是为了不被一个漂亮的高分误导了对稳定性的预期。
六、三条路线对照
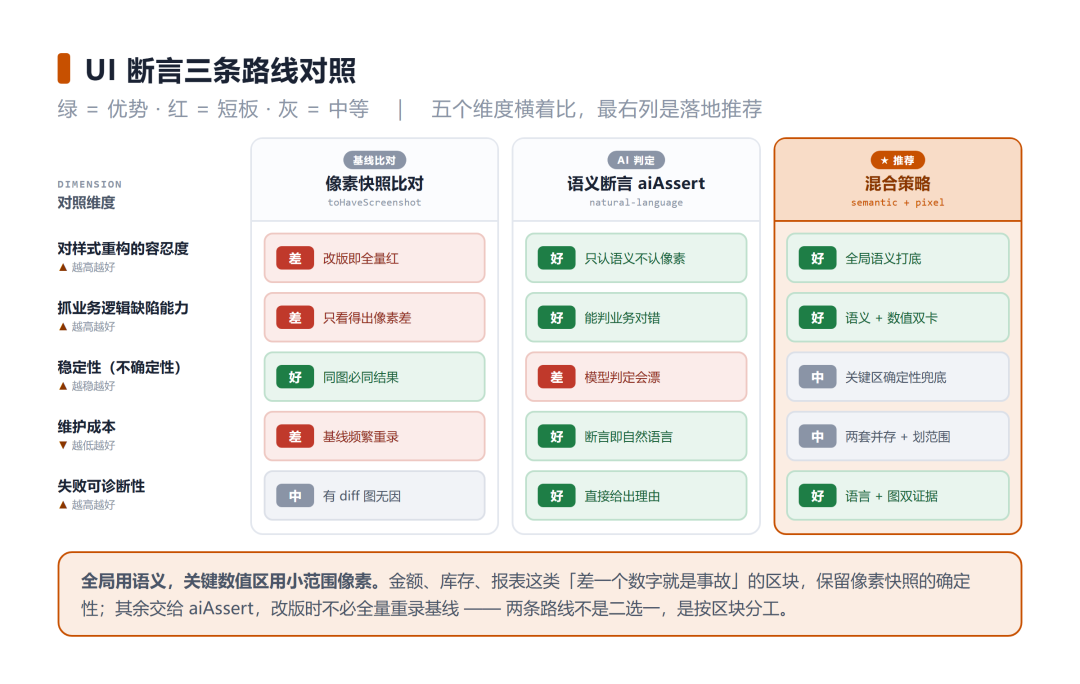
把三种方案放到五个维度上对照,取舍就很清楚了:
| 维度 | 像素快照比对 | 语义断言 aiAssert | 混合策略 |
|---|---|---|---|
| 对样式重构的容忍度 | 零容忍,换个圆角间距就全红 | 高,只看业务语义,样式微调免疫 | 全局免疫,仅关键数值区受控 |
| 抓业务逻辑缺陷能力 | 弱,NaN 也可能「像素一致」地漏过 | 强,用自然语言直接断业务意图 | 强,语义抓逻辑 + 像素兜关键数值 |
| 稳定性(不确定性) | 确定,同图必过同图必挂 | 有模型不确定性,可能给出「看起来对」 | 用像素锚点收敛语义的漂移 |
| 维护成本 | 高,基线图频繁重录 | 低,改断言就是改一句话 | 中,只维护少量关键区快照 |
| 失败可诊断性 | 只给一张 diff 图,得自己猜 | 给模型解释 + 截图,接近人话 | 两者都有,定位更快 |
落地建议就一句:先盘出你系统里「错一个字符就出事」的关键数值区(金额、库存、状态、时间),只给这几处上小范围像素兜底,其余全部交给语义断言。别一上来就整页快照,那是维护噩梦的起点;也别全裸用语义,那是资损风险的起点。
具体怎么落地,可以按这个顺序走。第一步,先用 aiQuery 把关键页面的核心字段抽成结构化数据,这一步几乎零维护成本,改样式完全不影响它。第二步,在这些字段上写 aiAssert 语义断言,断言语句务必具体到可判定,别写「页面正常」这种模糊话。第三步,只挑金额、状态这类资损敏感字段,用 locator 圈出那一小块做定向 toHaveScreenshot,快照范围越小,被样式重构误伤的概率就越低。第四步,把 aiAssert 失败时的模型解释和截图统一落到报告,让每次失败都能说人话。四步走完,你得到的是一套对样式免疫、对业务错误敏感、失败还可诊断的断言体系------这比在像素和语义之间二选一,稳得多。
本篇不讨论选择器自愈,也不讨论 UI 就绪判定------那些是让「找到元素、等到元素」更稳的问题。这里只回答一个更窄的问题:找到之后,断言这一步该交给谁。