大多数构建者仍然把 AI Agent 设计成一条直线先研究、再写作、然后审查、最后发布即使其中一半步骤根本不需要前一步的结果,每一步仍然要等待上一步完成。系统不会分支。不会并行。也不知道如何恢复。它只是不断往同一个上下文窗口里塞内容,直到 Agent 变得缓慢、混乱,或者成本越来越高。现在的问题已经不再是 Prompt。问题在于工作的形状。
这正是 Graph Engineering(图工程)要解决的问题。
Graph Engineering 到底是什么
Graph Engineering 是一种将 Agent 工作流转换成显式执行图的方法。不再把所有决策都隐藏在一个模型循环中,而是把整个系统定义为节点和边。
NODE = 一个边界明确的工作单元EDGE = 两个节点之间真实存在的依赖关系STATE = 在节点之间持续存在的数据ROUTER = 选择下一条边的规则GATE = 决定工作是否可以继续的检查机制一个节点可以是:
-
一个 Agent
-
一次工具调用
-
一个确定性函数
-
一个验证器
-
一个人工审批步骤
一条边说明接下来允许运行什么,以及哪些数据可以跨越这个边界传递。
图决定:
-
哪些循环运行
-
以什么顺序运行
-
使用哪些分支
-
如何汇合
-
如何恢复
一个循环帮助一个 Agent 改进自己的工作。一个图则负责把多个循环协调成一个完整系统。
1. 不要把每一个"然后"都当成依赖关系
大多数 Agent 工作流之所以是线性的,是因为人们就是这样写指令的:做 A,然后做 B,然后做 C。但顺序并不等于依赖关系。如果 B 并不消费 A 的输出,那么 B 就没有理由等待 A。
BADcollect market data -> inspect repository -> check competitor pricing
BETTER                             -> collect market data ---------USER REQUEST     -> inspect repository ----------> SYNTHESIZE                 -> check competitor pricing ----
Graph Engineering 中第一个问题非常简单:下一步是否真的会读取上一步的输出? 如果答案是否定的,就把这条边删掉。仅仅这一项改变,通常就能够把一个缓慢的链式流程,转换成一个快速的并行图。
2. 给每一个节点定义契约
如果你无法精确描述一个节点,那么你也无法对这个节点进行路由、测试或者替换。
每一个真正有用的节点都需要四样东西:
-
一个任务
-
明确的输入
-
结构化输出
-
清晰的失败状态
{ "node": "source_researcher", "input": { "topic": "string", "source_type": "primary" }, "output": { "claim": "string", "source_url": "string", "confidence": "high | medium | low" }, "failure": "no_primary_source_found"}自由文本会迫使下一个节点去猜测刚才到底发生了什么。结构化输出则能够把模型响应转换成图可以信任的数据。这也让节点变得可以替换。只要契约保持不变,你就可以替换:模型、Prompt和工具。而不需要重新构建整个系统。
3. 把边当成数据契约,而不是箭头
一条边不应该表示:"B 在 A 之后执行。"
它应该表示:"A 产生了 B 被允许消费的数据。"
这个区别非常重要,因为大多数工作流中的连接逻辑根本不需要额外调用一次模型。
例如:
-
展平数组
-
去重
-
过滤 null
-
检查状态
-
合并记录
这些都是确定性操作。
const usable = results .filter(Boolean) .flatMap(result => result.items) const unique = [...new Map( usable.map(item => [item.source_url, item])).values()]这里根本不需要 Agent。把模型调用留给需要判断的地方。把代码用于工作流中的连接逻辑。如果一个图中的每一条边都是另一个 Agent,那么这个系统实际上是在为自己的布线支付 Token 成本。
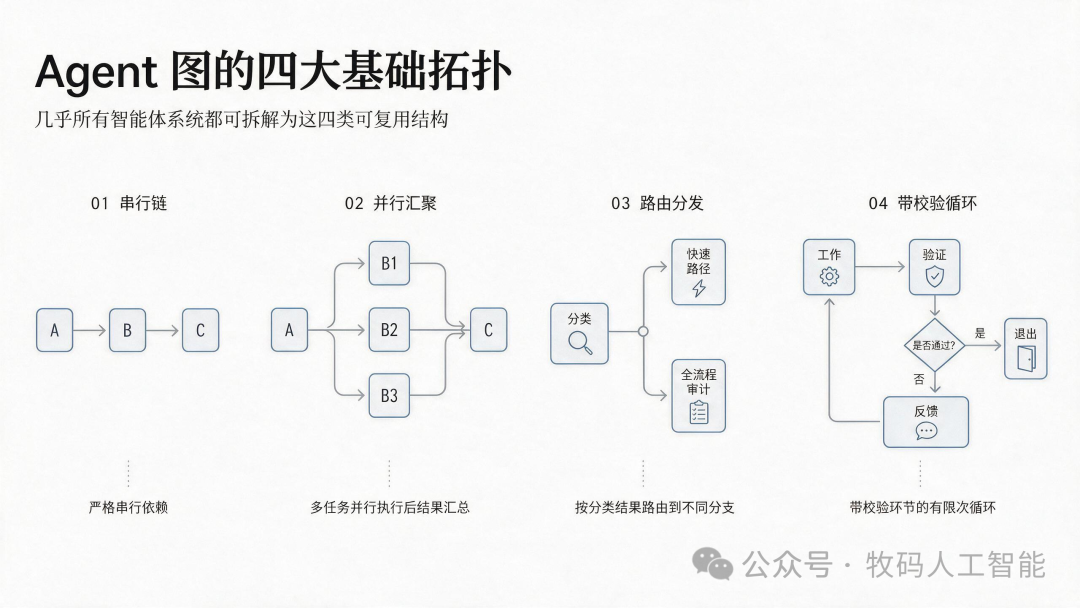
4. 学会几乎所有 Agent Graph 背后的四种形状
你并不需要学习 50 种模式。绝大多数生产环境中的图,都是由四种基本形状组合而成的。
链(Chain)
A -> B -> C当每一步确实都依赖前一步的输出时使用它。它简单、可预测,但通常会比真正需要的速度更慢。
菱形(Diamond)
-> B1 -A -> -> B2 --> C -> B3 -把一个任务拆分成相互独立的分支,让它们同时运行,然后再合并结果。这是以下场景中最常用的结构:
-
研究
-
代码审查
-
尽职调查
-
市场扫描
路由器(Router)
-> QUICK PATHCLASSIFY --- -> FULL AUDIT检查当前状态,只选择任务真正需要的路径。小任务保持低成本。高风险任务进入更深入的图。
受控循环(Controlled Cycle)
WORK -> VERIFY -> PASS -> EXIT | -> FAIL -> FEEDBACK -> WORK只有当证据表明结果仍然不完整时,才进行重复。
每一个循环都必须有:硬性停止条件、预算和收敛规则
5. 将独立工作分散出去,然后有意识地汇合
并行是 Graph 最容易理解的优势,同时也是最容易被滥用的优势。如果有五个相互独立的节点,就让它们同时运行。
const settled = await Promise.allSettled( sources.map(source => researchNode(source))) const findings = settled .filter(result => result.status === "fulfilled") .map(result => result.value)一个分支失败,不应该导致另外四个分支也失败。但是,不要在每一个阶段之后都设置屏障。只有当下一个节点确实需要完整结果集时,等待所有分支汇合才值得。
例如:跨来源去重、对所有候选项进行排序、比较不同方案或判断信息覆盖是否完整
如果每一项都可以继续独立运行,那么就继续让图保持流式执行。并行并不意味着自动变快。真正决定系统在哪里等待的是你的拓扑结构。
6. 让路由过程可检查
模型可以做判断。但是图应该限制这个判断被允许触发什么行为。
const decision = await classifyRisk(change) switch (decision.severity) { case "low": return quickReview(change) case "high": return fullParallelAudit(change) default: return humanReview(change)}分类器是概率性的。允许执行的路由则是确定性的。这样你既能够获得模型的灵活性,又不会让模型拥有对整个系统无限制的控制权。
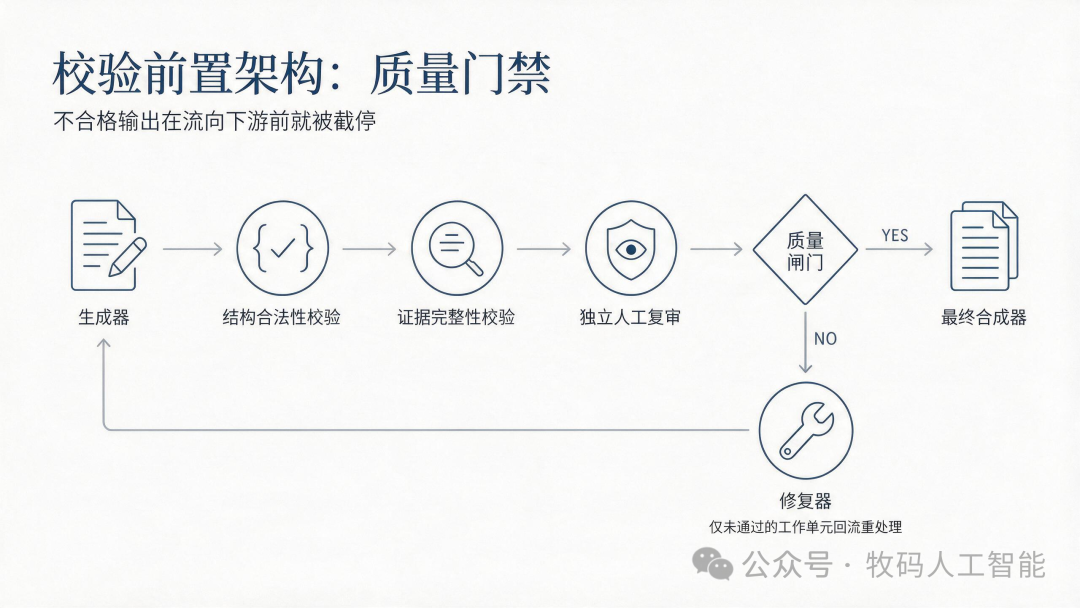
7. 把验证放在边界上
一个图中价值最高的节点,往往是那个什么新内容都不生成的节点。它的任务只是阻止低质量工作继续向下游传播。一个验证器可以检查:
-
每一个声明是否都有来源
-
引用的来源是否真正支持这个声明
-
代码是否通过测试
-
结果是否符合指定 Schema
-
另一个独立路径是否得出了相同结论
GENERATOR -> VERIFIER -> PASS -> SYNTHESIZER | -> FAIL -> REPAIR不要让同一个 Agent 在同一个上下文中:生成内容、批准内容和发布自己的内容
把角色分开。把 Prompt 分开。把失败边界分开。Anthropic 的生产级研究系统,在更大规模上遵循的也是同样的逻辑:一个 Lead Agent 协调多个并行 Subagent,研究结果随后被综合,然后由专门的引用阶段附加证据,最后结果才会发送给用户。
8. State 是大多数架构图都会隐藏的部分
方框和箭头看起来很干净。
直到系统在崩溃之后需要恢复执行。
生产环境中的 Graph 必须拥有持久化 State。
task_idcurrent_nodecompleted_nodesartifactsdecisionsevidencebudgetsretry_countshuman_approvals不要在节点之间传递巨大的对话 Transcript。应该传递 Artifact 的引用。一个研究节点应该把自己的报告保存起来,然后返回:路径、ID和结构化摘要
Reviewer 应该直接读取 Artifact,而不是接收经过三个 Agent 压缩和转述后的内容。这样可以减少上下文信息损失,同时让每一次状态迁移都可以审计。
在任何时刻,Graph 都应该能够回答三个问题:
-
已经发生了什么?
-
系统为什么选择这条路径?
-
从哪里可以安全恢复执行?
如果无法回答这三个问题,那么这个 Graph 仍然只是一个 Demo。
9. 只有在能够收敛时才加入循环
当工作量无法提前确定时,循环非常有用。例如:Bug 发现、深度研究和迭代修复
但是:"重复执行直到结果足够好",并不是一个停止条件。
应该使用可度量的收敛条件。
let dryRounds = 0let iteration = 0const seen = new Set() while (dryRounds < 2 && iteration < 6) { const findings = await discover() const fresh = findings.filter(item => !seen.has(item.key)) fresh.forEach(item => seen.add(item.key)) dryRounds = fresh.length === 0 ? dryRounds + 1 : 0 iteration += 1}注意系统记录了什么。它会根据所有已经见过的结果进行去重,而不仅仅是那些已经通过验证的结果。否则,那些被拒绝的想法会不断重新出现,而 Graph 会永远为重复发现同样的死路支付成本。每一个受控循环都需要:
-
完成条件
-
最大循环次数
-
Token 或成本预算
-
之前尝试的记录
-
当无法收敛时的升级路径
10. 把失败设计成局部事件
在线性链中,一个步骤出错,就可能让整个工作流冻结。在 Graph 中,失败应该被限制在尽可能小的边界内。每一个节点都需要一个策略:
RETRY 临时性的工具或网络失败FALLBACK 首选模型或数据源不可用SKIP 可选分支失败REPAIR 输出没有通过验证ESCALATE 风险或不确定性超过阈值STOP 达到预算、安全或权限边界在昂贵节点之后创建 Checkpoint。让写操作具备幂等性,这样重试就不会产生重复副作用。当并行 Worker 修改文件时,为它们提供隔离的工作空间。记录每一次路由决策,以及产生这个决策时对应的状态。可靠性并不是来自于希望每一个节点都成功。而是来自于:
当某一个节点失败时,你已经提前决定 Graph 应该怎么做。
11. 拓扑结构就是你的成本模型
Graph 并不会自动比单个 Agent 更便宜。如果每一个任务都会生成一整支 Agent 队伍,它甚至可能消耗多得多的 Token。Graph 的形状同时控制:延迟和成本
对于以下任务,可以使用更便宜的模型:有明确边界的信息抽取或分类或格式化
对于以下任务,可以使用能力更强的模型:任务拆解、综合或困难的验证
简单任务走短路径。只有真正值得的任务才进入完整 Graph。
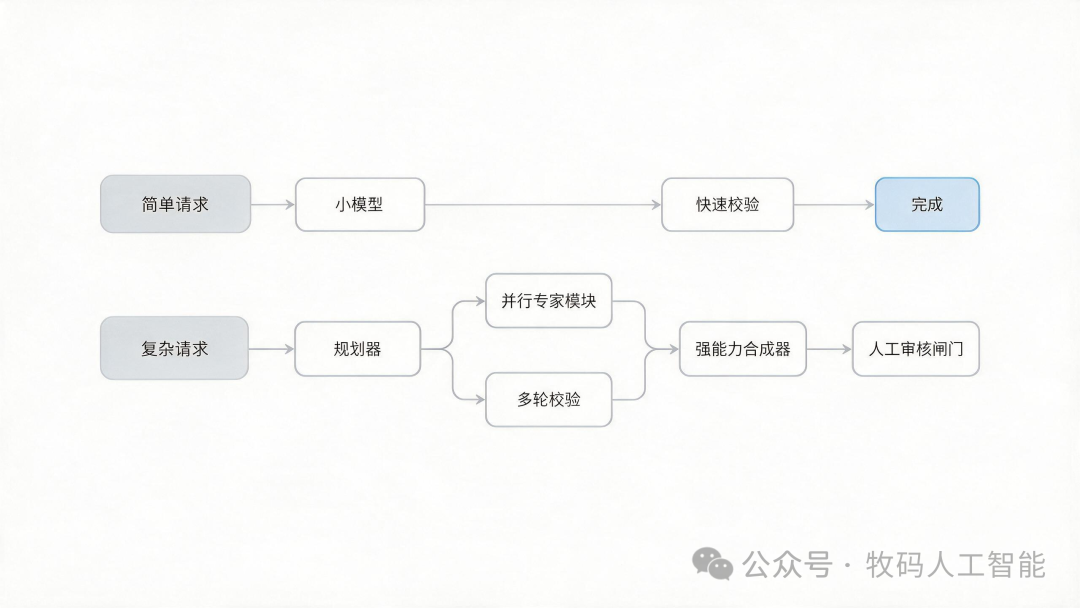
Anthropic 报告称,在广度优先类型的任务中,多 Agent 研究可以显著优于单 Agent。但它也会消耗更多 Token。这就是它的权衡。Graph Engineering 并不是为了最大化 Agent 数量。它真正的目标是只有当以下能力能够创造足够价值时,才为协调付出成本:并行、专业化和独立验证
12. 一个用于研究和发布的生产级 Graph
下面是一个实际可用的 Graph,可以把一个想法转换成一篇带引用的文章。
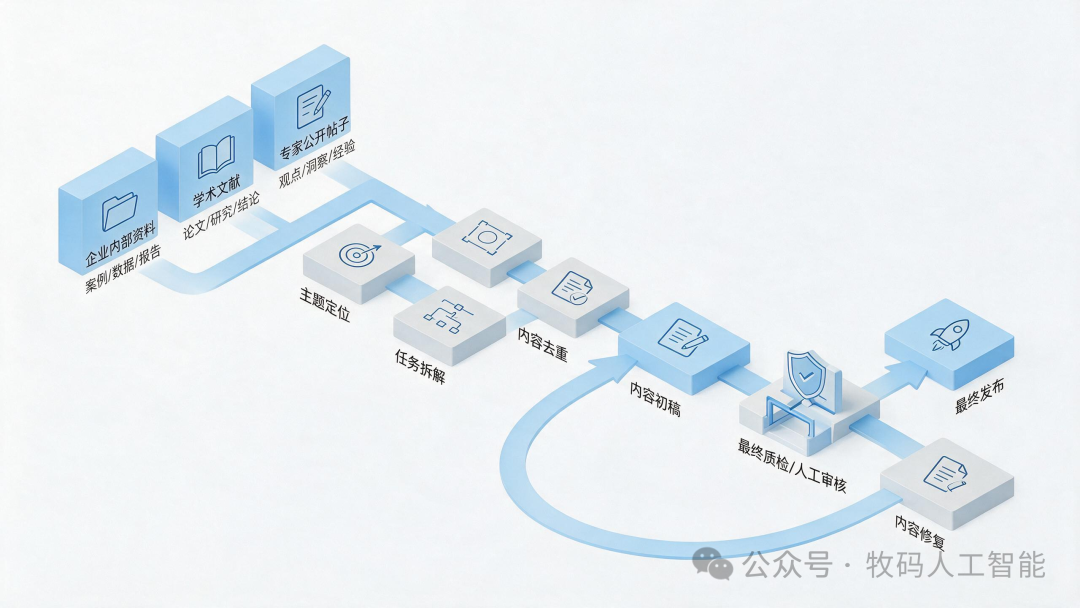
系统的运行方式如下。Scope 节点定义:问题、受众和完成标准Decomposition 节点创建多个相互独立的研究路径。Research 节点使用相互独立的上下文并行运行。确定性代码负责:去重和标准化数据源Draft 节点根据结构化证据进行写作。
Checker 验证:
-
声明
-
引用
-
风格
-
是否缺少章节
检查失败后,只把相关章节送回 Repair 节点。最终 Artifact 在发布之前由人工审批。这并不是一个巨大的 Agent 在假装自己是一支团队。而是一个拥有明确以下内容的系统:
-
所有权
-
State
-
权限
什么情况下 Graph 不是正确答案
不要把每一个 Prompt 都转换成架构图。在以下情况下,继续使用一个 Agent + 一个 Loop:
-
任务很短
-
一个上下文能够容纳所有相关信息
-
不存在独立分支
-
失败成本很低
-
人工可以快速检查最终结果
在以下情况下,再切换到 Graph:
-
工作可以并行执行
-
不同节点需要不同工具或权限
-
输出需要独立验证
-
任务需要在中断之后继续执行
-
多个 Loop 需要共享 State
-
成本和权限必须根据路由控制
从一个 Loop 开始。只有当依赖关系迫使你这样做时,才绘制 Graph。
Graph Engineering 检查清单
发布之前,问自己:
每一条 Edge 是否都承载真实的数据或权限?每一个 Node 是否只有一个边界明确的任务?输入和输出是否结构化?相互独立的节点是否可以并行运行?Join 是否只出现在真正需要完整结果集的地方?重要结果在进入下游之前是否经过验证?失败是否可以重试,并且不会产生重复副作用?Graph 是否可以从 Checkpoint 恢复?每一个 Cycle 是否都有硬性停止条件和预算?人工是否能够中断高风险路径?你是否可以解释为什么选择了每一条路由?Graph 是否比它所解决的问题更简单?如果最后一个问题的答案是否定的:删除节点。
真正的变化
Prompt Engineering 改进的是指令。
Context Engineering 控制模型能够看到什么。
Harness Engineering 构建模型周围的运行环境。
Loop Engineering 让一个工作单元通过反馈不断改进。
Graph Engineering 协调整个任务。
PROMPT -> CONTEXT -> HARNESS -> LOOP -> GRAPHmessage memory machine run coordination 消息 记忆 机器 运行 协调模型只是其中一个节点。真正的产品,是模型周围的整个系统。一个 Prompt Engineer 会要求 Agent 做更多事情。一个架构师则会重新设计 Graph,让整个系统能够更安全地做更多事情。