问题描述
小S是一位国际货船租赁商,他最近接手了一批特殊的货船订单。每艘货船都有一个载货量数值,但奇怪的是,除了某一艘货船之外,其他每种载货量都恰好出现两次。小S需要快速找出那艘载货量独特的货船,以便为它安排特殊的航线。
要求:
- 设计一个算法,在 O(n) 的时间复杂度内找出独特的载货量数值,其中 n 是货船的数量。
- 尽量减少额外空间的使用,以优化资源效率。
测试样例
样例1:
输入:
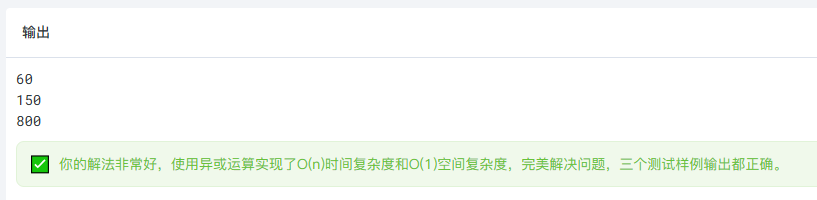
ships = [50, 20, 20, 30, 30, 40, 40, 50, 60]输出:60解释:载货量 60 的货船只出现一次,是独特的;其他载货量(50、20、30、40)都恰好出现两次。
样例2:
输入:
ships = [100, 200, 100, 200, 150]输出:150解释:载货量 150 的货船只出现一次,是独特的;其他载货量(100、200)都恰好出现两次。
样例3:
输入:
ships = [500, 300, 500, 300, 700, 700, 800]输出:800解释:载货量 800 的货船只出现一次,是独特的;其他载货量(500、300、700)都恰好出现两次。
约束条件
- 1 ≤ ships.length ≤ 1001
- 0 ≤ shipsi ≤ 1000
- ships.length 是奇数
- 除了某一艘货船的载货量只出现一次外,其余每种载货量都恰好出现两次
程序代码
#include <stdio.h>
int findUnique(int* ships, int shipsSize) {
int result = 0;
for (int i = 0; i < shipsSize; i++) {
result ^= shipsi;
}
return result;
}
int main() {
int ships1\[\] = {50, 20, 20, 30, 30, 40, 40, 50, 60};
int ships2\[\] = {100, 200, 100, 200, 150};
int ships3\[\] = {500, 300, 500, 300, 700, 700, 800};
printf("%d\n", findUnique(ships1, 9)); // 60
printf("%d\n", findUnique(ships2, 5)); // 150
printf("%d\n", findUnique(ships3, 7)); // 800
return 0;
}
cpp
#include <stdio.h>

int findUnique(int* ships, int shipsSize) {
    int result = 0;
    for (int i = 0; i < shipsSize; i++) {
        result ^= ships[i];
    }
    return result;
}

int main() {
    int ships1[] = {50, 20, 20, 30, 30, 40, 40, 50, 60};
    int ships2[] = {100, 200, 100, 200, 150};
    int ships3[] = {500, 300, 500, 300, 700, 700, 800};

    printf("%d\n", findUnique(ships1, 9));  // 60
    printf("%d\n", findUnique(ships2, 5));  // 150
    printf("%d\n", findUnique(ships3, 7));  // 800

    return 0;
}
运行结果