摘要
当 Agent 只需要调用一个工具时,简单的 AgentExecutor 通常已经够用。但当任务变成长流程后,系统会出现更多状态和分支:需要先检索再分析,某一步失败后要重试,某个高风险动作需要用户确认,任务执行到一半可能暂停,服务重启后还要从上次进度继续。
如果继续使用一个隐式循环来管理这些逻辑,代码会逐渐变得难以理解和维护。LangGraph 提供了一种以状态图为核心的编排方式,将任务拆成节点、边和状态,让 Agent 工作流的执行路径更加明确,也更容易实现条件分支、循环、检查点和人工介入。
本文会从状态机和有向图的基本概念开始,介绍 LangGraph 中的 State、Node、Edge、条件路由、图编译、检查点和中断机制。随后通过一个"企业报告生成助手"的示例,逐步实现数据检索、分析、报告生成、人工确认和发布流程,并讨论如何处理失败重试、任务恢复、权限控制和生产部署。
由于 LangGraph 的 API 会随着版本演进,本文重点放在通用设计思想和工作流边界。实际开发时,应根据项目锁定的 LangGraph 与 LangChain 版本核对具体导入路径和方法签名。
读完本文后,你应该能够:
- 理解为什么复杂 Agent 需要状态图;
- 掌握 LangGraph 的 State、Node 和 Edge;
- 设计顺序节点、条件分支和循环;
- 使用检查点保存任务状态;
- 实现人工确认、暂停和恢复;
- 处理节点失败、重试和替代路径;
- 将 LangChain Agent 作为 LangGraph 节点使用;
- 建立可观测、可恢复和可审计的 Agent 工作流。
一、背景与问题
1. 隐式 Agent 循环会变得复杂
最简单的 Agent 循环通常是:
text
模型
  -> 工具
  -> 模型
  -> 工具
  -> 模型
  -> 最终回答
随着需求增加,流程可能变成:
text
接收任务
  -> 校验参数
  -> 查询数据
  -> 判断数据是否完整
      -> 不完整:补充查询
      -> 完整:开始分析
  -> 生成报告
  -> 判断是否需要审核
      -> 需要:等待用户确认
      -> 不需要:直接发布
  -> 发送通知
  -> 结束
此时系统需要管理:
- 当前执行到哪一步;
- 下一步有哪些候选路径;
- 某个步骤是否已经执行;
- 是否允许重试;
- 是否发生人工中断;
- 用户确认后如何恢复;
- 服务重启后如何继续;
- 已执行的写操作是否可以重复。
如果这些状态全部隐藏在一个 while 循环和大量 if/else 中,代码很快会失去清晰边界。
2. 长任务与短请求的差异
短请求通常具有:
text
请求进入
  -> 模型调用
  -> 工具调用
  -> 返回结果
长任务可能持续数分钟甚至更久:
text
上传文件
  -> 解析文件
  -> 检索资料
  -> 分析数据
  -> 生成人工审核版本
  -> 等待确认
  -> 发布报告
长任务需要支持:
- 保存中间状态;
- 显示执行进度;
- 暂停和恢复;
- 用户主动取消;
- 节点级重试;
- 任务超时;
- 失败补偿;
- 审计和回放。
状态图适合表达这类任务,因为流程中的每个节点和转移关系都可以显式定义。
3. 工作流中的不确定性
传统工作流一般是固定路径:
text
开始
  -> 节点 A
  -> 节点 B
  -> 节点 C
  -> 结束
Agent 工作流可能根据模型和工具结果动态选择路径:
text
开始
  -> 识别目标
  -> 是否需要搜索
      -> 是:搜索
      -> 否:直接分析
  -> 数据是否足够
      -> 否:继续检索
      -> 是:生成报告
LangGraph 的价值在于把固定流程和动态决策组合起来:
text
图结构:
  定义允许的节点和路径

模型:
  在允许范围内选择下一步

状态:
  保存事实、结果和进度

程序:
  控制权限、预算和副作用
4. LangGraph 的定位
LangGraph 更适合承担 Agent 工作流编排层:
text
API 层
  -> 认证、请求和响应

LangGraph
  -> 状态、节点、边和任务生命周期

LangChain
  -> 模型、Prompt、工具和链

业务服务
  -> 事务、权限、状态和领域规则

基础设施
  -> 数据库、缓存、消息和外部系统
它不是数据库、权限系统或消息队列的替代品。复杂工作流仍然需要在应用层设计资源和安全边界。
二、核心概念
1. 状态 State
状态是图中节点之间传递的信息。它可以包含:
- 用户目标;
- 当前计划;
- 已完成步骤;
- 工具结果;
- 报告内容;
- 错误信息;
- 用户确认结果;
- 当前任务状态;
- Token 和费用使用量。
示例:
python
from typing import TypedDict


class ReportState(TypedDict):
    task_id: str
    user_input: str
    current_step: str
    sales_data: dict
    analysis: dict
    report: str
    needs_confirmation: bool
    approved: bool
    error: str | None
状态应该尽量保存任务事实和可恢复信息,而不是保存无法解释的大量模型内部文本。
2. 节点 Node
节点是对状态执行一次处理的函数:
python
def load_data(state: ReportState):
    data = query_sales_data()
    return {
        "sales_data": data,
        "current_step": "analyze",
    }
节点通常应该:
- 接收当前状态;
- 执行一个相对单一的职责;
- 返回状态更新;
- 不随意修改全局状态;
- 对副作用进行幂等处理;
- 记录必要的执行信息。
节点不是越小越好。一个节点应该具有清晰的输入、输出和失败边界。
3. 边 Edge
边定义节点执行完成后下一步去哪里:
python
graph.add_edge(
    "load_data",
    "analyze",
)
固定边表示确定路径:
text
load_data
  -> analyze
  -> generate_report
条件边根据状态选择路径:
python
graph.add_conditional_edges(
    "check_data",
    route_after_check,
    {
        "retry": "load_data",
        "continue": "analyze",
        "fail": "end",
    },
)
4. 条件路由
条件路由函数通常只负责判断下一步:
python
def route_after_check(
    state: ReportState,
) -> str:
    if state["error"]:
        return "fail"

    if not state["sales_data"]:
        return "retry"

    return "continue"
路由判断应该使用状态中的事实,不应该在路由函数中执行复杂副作用。
5. 图 StateGraph
StateGraph 用于定义状态图:
python
from langgraph.graph import (
    END,
    START,
    StateGraph,
)


builder = StateGraph(ReportState)

builder.add_node(
    "load_data",
    load_data,
)
builder.add_node(
    "analyze",
    analyze,
)
builder.add_edge(
    START,
    "load_data",
)
builder.add_edge(
    "load_data",
    "analyze",
)
builder.add_edge(
    "analyze",
    END,
)

graph = builder.compile()
编译后的 graph 可以执行:
python
result = graph.invoke({
    "task_id": "task-001",
    "user_input": "分析本月销售",
})
具体 API 可能随版本变化,但核心流程通常是:
text
定义状态
  -> 注册节点
  -> 注册边
  -> 编译图
  -> 调用图
6. START 和 END
START 表示图的入口,END 表示任务结束:
text
START
  -> 第一个节点
  -> 中间节点
  -> END
可以有多个节点汇聚到 END,也可以通过条件边选择不同结束路径。
7. 检查点 Checkpoint
检查点用于保存图执行过程中的状态:
text
节点 A 完成
  -> 保存状态
节点 B 完成
  -> 保存状态
服务重启
  -> 读取最后一个检查点
  -> 从节点 B 之后继续
检查点通常需要关联 thread_id 或 task_id:
python
config = {
    "configurable": {
        "thread_id": "task-001",
    }
}

result = graph.invoke(
    input_state,
    config=config,
)
内存检查点适合开发测试,生产环境需要持久化存储。
8. 中断 Interrupt
复杂任务可能需要在某个节点暂停:
text
生成报告
  -> 暂停
  -> 等待用户确认
  -> 用户批准
  -> 继续发布
中断机制需要保存:
- 当前节点;
- 当前状态;
- 待确认动作;
- 任务 ID;
- 用户和租户;
- 恢复所需参数;
- 状态版本。
暂停不是异常,而是任务生命周期中的正常状态。
9. 节点返回状态更新
节点可以只返回需要更新的字段:
python
def analyze(
    state: ReportState,
):
    analysis = calculate_changes(
        state["sales_data"]
    )

    return {
        "analysis": analysis,
        "current_step": "generate_report",
    }
相比直接修改传入的 state,返回更新结果更容易追踪状态变化。
10. Reducer 和状态合并
当多个节点并行执行后,需要合并状态更新。例如多个数据源分别返回结果:
text
查询订单
查询退款
查询库存
  -> 合并到 data_sources
可以设计状态字段为列表或字典,并定义明确的合并策略。状态合并必须考虑:
- 键冲突;
- 更新顺序;
- 并发写入;
- 重试覆盖;
- 旧结果污染;
- 数据版本。
11. 子图 Subgraph
复杂工作流可以拆成子图:
text
主图:
  接收任务
  -> 数据分析子图
  -> 报告审核子图
  -> 发布子图
子图可以封装:
- 固定业务流程;
- 独立状态;
- 独立测试;
- 独立重试;
- 子任务权限。
这样可以避免所有逻辑都堆在一张大图中。
三、工作原理
1. 状态图执行流程
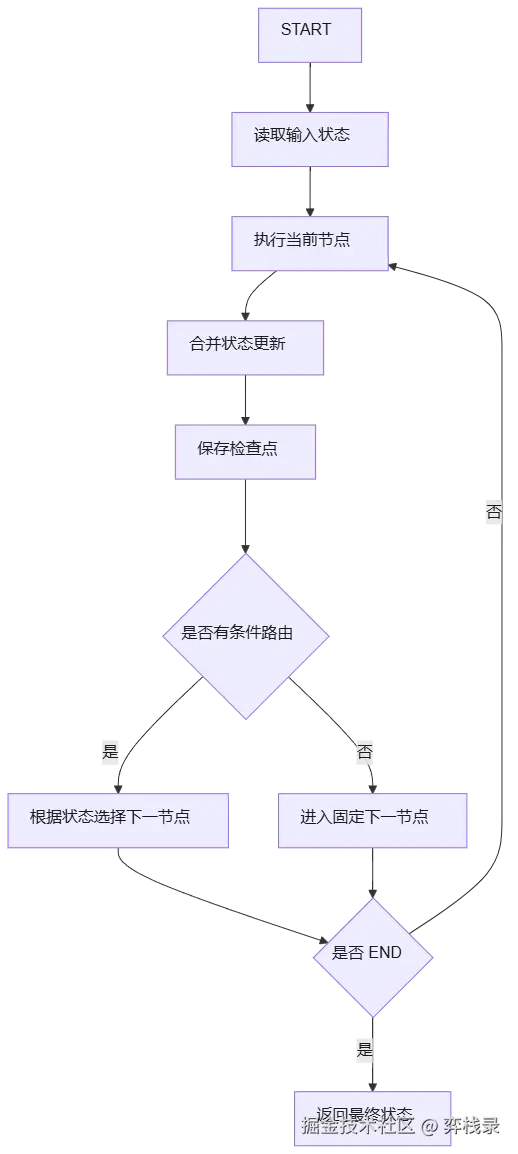
每个节点执行后,图运行时都会根据边决定下一步。
2. 图的编译阶段
编译阶段主要确认图结构:
text
定义状态
  -> 添加节点
  -> 添加边
  -> 检查入口
  -> 检查不可达节点
  -> 检查边和路由
  -> 创建可执行图
编译成功不代表业务一定正确,还需要通过测试验证:
- 状态字段是否完整;
- 条件路由是否覆盖所有分支;
- 是否存在无限循环;
- 节点是否可以重复执行;
- 失败后是否能够恢复;
- 高风险节点是否有确认。
3. 节点执行过程
一次节点执行可以抽象成:
text
读取当前状态
  -> 检查节点前置条件
  -> 检查权限和预算
  -> 执行节点逻辑
  -> 校验结果
  -> 更新状态
  -> 记录节点事件
  -> 保存检查点
节点之间传递的是状态,而不是随意共享全局变量。
4. 条件分支
以报告发布为例:
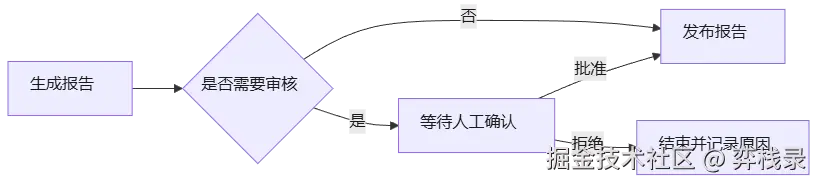
条件判断应基于结构化字段:
python
def route_review(
    state: ReportState,
) -> str:
    if state["approved"]:
        return "publish"

    if state["needs_confirmation"]:
        return "wait"

    return "publish"
5. 循环和重试
图可以表示循环:
text
查询数据
  -> 检查完整性
  -> 不完整
  -> 补充查询
  -> 再次检查
  -> 完整后继续
循环必须有退出条件:
python
def route_data(
    state: ReportState,
) -> str:
    if state["data_attempts"] >= 3:
        return "fail"

    if is_complete(state["sales_data"]):
        return "analyze"

    return "load_more"
如果没有最大次数、超时或预算,图可能无限循环。
6. 并行节点
多个互不依赖的数据查询可以并行:
text
START
  -> 查询订单
  -> 查询退款
  -> 查询库存
  -> 汇总数据
并行执行需要明确汇聚条件:
text
所有查询成功
  -> 汇总

部分查询失败但允许降级
  -> 汇总可用结果

关键查询失败
  -> 任务失败
并行写操作需要特别谨慎,避免多个节点修改同一资源。
7. 图执行中的异常
节点异常可以有几种处理方式:
- 直接终止图;
- 返回错误状态后走失败节点;
- 节点内部有限重试;
- 路由到替代节点;
- 暂停等待人工;
- 保存状态后交给后台恢复。
建议将可预期的业务失败转换为结构化状态,将不可预期的系统异常交给统一错误处理。
8. 检查点恢复
恢复流程:
text
任务请求到达
  -> 根据 thread_id 读取检查点
  -> 判断任务当前状态
  -> 如果已完成,返回历史结果
  -> 如果等待确认,返回待确认信息
  -> 如果运行中断,恢复可执行节点
  -> 继续保存新的检查点
恢复时必须处理"节点已经产生副作用但检查点未保存"的情况。对于写操作,需要通过幂等键或最终状态查询避免重复执行。
9. 人工介入
人工确认节点通常包括:
text
生成待审核结果
  -> 写入任务状态
  -> 返回 approval_required
  -> 用户批准或拒绝
  -> 恢复图
人工确认信息应包含:
- 要执行什么动作;
- 作用于什么资源;
- 影响范围;
- 数据来源;
- 预计副作用;
- 是否可撤销;
- 审核人;
- 过期时间。
不能只保存一个 approved=true,而不保存批准对象和版本。
四、实战示例
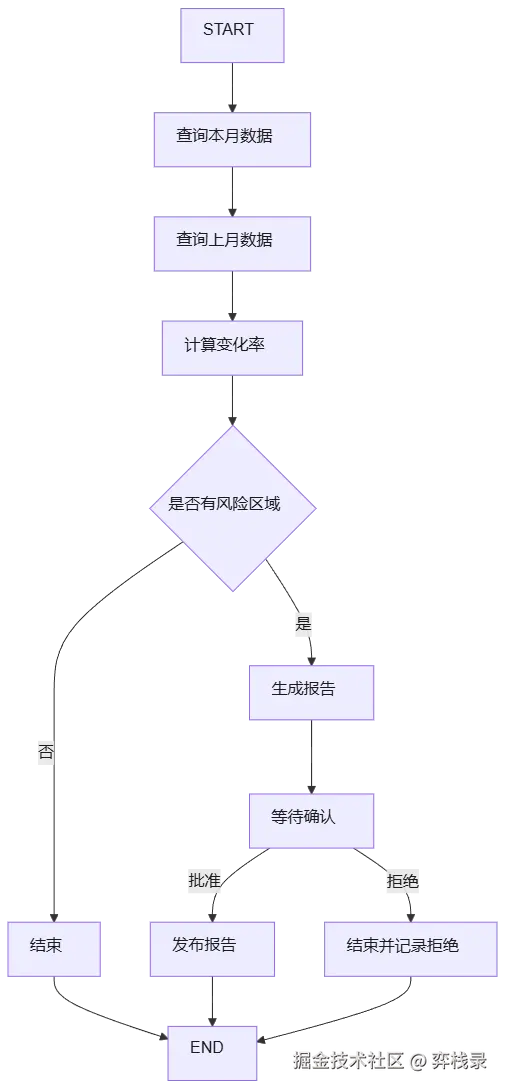
1. 场景设计
构建一个销售报告工作流:
text
用户:
分析 2026 年 8 月销售情况,
如果存在下降超过 10% 的区域,
生成报告并等待我确认后发布。
流程:
- 查询本月销售数据;
- 查询上月销售数据;
- 计算区域变化率;
- 判断是否存在风险区域;
- 生成 Markdown 报告;
- 如果需要审核,暂停等待确认;
- 用户批准后发布报告;
- 返回发布结果。
图结构:
2. 安装依赖
创建虚拟环境:
bash
mkdir langgraph-report-demo
cd langgraph-report-demo
python -m venv .venv
安装:
bash
python -m pip install langgraph langchain-core如果需要接入真实模型,再安装对应的 LangChain 模型集成包:
bash
python -m pip install langchain-openai项目应固定 LangGraph、LangChain Core 和模型集成包版本。
3. 定义状态
python
from typing import TypedDict


class ReportState(TypedDict, total=False):
    task_id: str
    user_id: str
    tenant_id: str
    current_month: str
    previous_month: str
    current_data: dict[str, float]
    previous_data: dict[str, float]
    changes: list[dict]
    risky_regions: list[str]
    report: str
    needs_confirmation: bool
    approval_status: str
    published: bool
    error: str | None
    retry_count: int
total=False 表示字段可以在任务的不同阶段逐步出现。对于生产项目,可以使用 Pydantic 模型或更严格的状态协议。
4. 准备模拟业务数据
python
SALES = {
    "2026-08": {
        "华东": 820000.0,
        "华南": 760000.0,
        "华北": 910000.0,
    },
    "2026-07": {
        "华东": 930000.0,
        "华南": 780000.0,
        "华北": 870000.0,
    },
}


def query_sales(
    month: str,
) -> dict[str, float]:
    data = SALES.get(month)

    if data is None:
        raise ValueError(
            f"没有找到 {month} 的销售数据"
        )

    return data.copy()
真实项目中,查询节点应该调用业务服务或只读查询接口,并将 tenant_id 作为上下文注入。
5. 实现查询节点
python
def load_current_data(
    state: ReportState,
) -> dict:
    data = query_sales(
        state["current_month"]
    )

    return {
        "current_data": data,
        "retry_count": 0,
    }


def load_previous_data(
    state: ReportState,
) -> dict:
    data = query_sales(
        state["previous_month"]
    )

    return {
        "previous_data": data,
    }
节点没有让模型决定月份,也没有从用户输入中直接拼接 SQL。月份应该经过参数解析和格式校验。
6. 实现分析节点
python
def calculate_changes(
    state: ReportState,
) -> dict:
    current = state["current_data"]
    previous = state["previous_data"]

    regions = sorted(
        set(current) | set(previous)
    )
    changes = []

    for region in regions:
        current_value = current.get(
            region,
            0.0,
        )
        previous_value = previous.get(
            region,
            0.0,
        )

        if previous_value == 0:
            rate = None
        else:
            rate = round(
                (
                    current_value
                    - previous_value
                )
                / previous_value
                * 100,
                2,
            )

        changes.append({
            "region": region,
            "current": current_value,
            "previous": previous_value,
            "change_rate": rate,
        })

    risky_regions = [
        item["region"]
        for item in changes
        if item["change_rate"] is not None
        and item["change_rate"] < -10
    ]

    return {
        "changes": changes,
        "risky_regions": risky_regions,
        "needs_confirmation": bool(
            risky_regions
        ),
    }
金额和变化率由程序计算,不交给模型自由推算。
7. 实现报告节点
python
def generate_report(
    state: ReportState,
) -> dict:
    lines = [
        f"# {state['current_month']} 销售分析报告",
        "",
        "## 区域销售变化",
        "",
        "| 区域 | 本月销售 | 上月销售 | 变化率 |",
        "| --- | ---: | ---: | ---: |",
    ]

    for item in state["changes"]:
        rate = item["change_rate"]
        rate_text = (
            "无法计算"
            if rate is None
            else f"{rate:.2f}%"
        )

        lines.append(
            f"| {item['region']} "
            f"| {item['current']:.2f} "
            f"| {item['previous']:.2f} "
            f"| {rate_text} |"
        )

    lines.extend([
        "",
        "## 重点关注",
        "",
        "、".join(state["risky_regions"])
        if state["risky_regions"]
        else "无",
    ])

    return {
        "report": "\n".join(lines),
        "approval_status": "PENDING",
    }
报告内容由程序模板生成,模型可以后续负责语言润色,但核心数值和风险区域必须来自结构化状态。
8. 定义发布节点
发布是有副作用的写操作,应使用幂等键:
python
PUBLISHED_REPORTS: dict[str, str] = {}


def publish_report(
    state: ReportState,
) -> dict:
    task_id = state["task_id"]

    if task_id in PUBLISHED_REPORTS:
        return {
            "published": True,
            "approval_status": "PUBLISHED",
        }

    PUBLISHED_REPORTS[task_id] = state["report"]

    return {
        "published": True,
        "approval_status": "PUBLISHED",
    }
真实发布可能是上传对象存储、创建知识库文档或发送通知。发布接口应使用 task_id 或 request_id 实现幂等。
9. 设计路由函数
python
def route_after_analysis(
    state: ReportState,
) -> str:
    if state.get("error"):
        return "fail"

    if state.get("risky_regions"):
        return "generate_report"

    return "finish"


def route_after_approval(
    state: ReportState,
) -> str:
    status = state.get(
        "approval_status"
    )

    if status == "APPROVED":
        return "publish"

    if status == "REJECTED":
        return "reject"

    return "wait"
路由函数只根据状态返回路径名称,不执行发布、写库或通知。
10. 构建状态图
python
from langgraph.graph import (
    END,
    START,
    StateGraph,
)


builder = StateGraph(ReportState)

builder.add_node(
    "load_current",
    load_current_data,
)
builder.add_node(
    "load_previous",
    load_previous_data,
)
builder.add_node(
    "calculate",
    calculate_changes,
)
builder.add_node(
    "generate_report",
    generate_report,
)
builder.add_node(
    "publish",
    publish_report,
)

builder.add_edge(
    START,
    "load_current",
)
builder.add_edge(
    "load_current",
    "load_previous",
)
builder.add_edge(
    "load_previous",
    "calculate",
)

builder.add_conditional_edges(
    "calculate",
    route_after_analysis,
    {
        "generate_report": "generate_report",
        "finish": END,
        "fail": END,
    },
)

builder.add_edge(
    "generate_report",
    "publish",
)

builder.add_edge(
    "publish",
    END,
)

graph = builder.compile()
这个基础版本还没有人工中断。下一节会把审核节点插入图中。
11. 增加人工审核节点
概念上可以将审核节点表示为:
python
def request_approval(
    state: ReportState,
) -> dict:
    return {
        "approval_status": "WAITING"
    }
路由:
python
builder.add_node(
    "request_approval",
    request_approval,
)

builder.add_edge(
    "generate_report",
    "request_approval",
)

builder.add_conditional_edges(
    "request_approval",
    route_after_approval,
    {
        "publish": "publish",
        "reject": END,
        "wait": END,
    },
)
如果程序在 request_approval 后直接 END,任务状态可以保存为 WAITING。用户确认后,需要使用同一个 thread_id 恢复图,并将 approval_status 更新为 APPROVED。
不同 LangGraph 版本对 interrupt 和 Command 的具体写法可能不同,生产代码应以当前版本 API 为准。核心设计是:
text
图运行到审核节点
  -> 保存检查点
  -> 返回等待确认状态
  -> 用户提交批准
  -> 使用原任务 ID 恢复
  -> 从审核节点之后继续
12. 使用内存检查点
开发阶段可以使用内存检查点:
python
from langgraph.checkpoint.memory import (
    MemorySaver,
)


checkpointer = MemorySaver()
graph = builder.compile(
    checkpointer=checkpointer,
)
调用时传入 thread_id:
python
config = {
    "configurable": {
        "thread_id": "report-task-001",
    }
}

initial_state = {
    "task_id": "report-task-001",
    "user_id": "user-001",
    "tenant_id": "tenant-a",
    "current_month": "2026-08",
    "previous_month": "2026-07",
    "approval_status": "PENDING",
}

result = graph.invoke(
    initial_state,
    config=config,
)
同一个 thread_id 用于定位任务状态。生产系统必须确保 thread_id 不能被其他用户猜测或复用。
13. 查询任务状态
可以根据检查点查询当前状态:
python
snapshot = graph.get_state(config)

print(snapshot.values)
print(snapshot.next)
可能得到:
text
状态:
  approval_status = WAITING
  report = 已生成的 Markdown 报告

下一节点:
  request_approval 或 publish
接口层可以把它转换为:
json
{
  "task_id": "report-task-001",
  "status": "WAITING_CONFIRMATION",
  "next_action": "是否发布销售报告",
  "report_preview": "# 2026-08 销售分析报告"
}
14. 恢复任务
用户批准后,应用程序应先验证:
- 当前用户是否是任务创建者;
- 当前租户是否一致;
- 报告版本是否仍然有效;
- 报告是否已发布;
- 审批是否过期;
- 是否存在重复批准。
确认通过后,再更新状态并恢复:
python
approved_update = {
    "approval_status": "APPROVED",
}

result = graph.invoke(
    approved_update,
    config=config,
)
具体恢复调用方式可能因中断实现和版本不同而变化,但必须使用原来的任务上下文和检查点。
15. 接入 LangChain Agent 节点
LangGraph 节点可以调用 LangChain Agent:
python
def research_node(
    state: ReportState,
) -> dict:
    result = research_executor.invoke({
        "input": state["user_input"],
    })

    return {
        "research_result": result["output"],
    }
图负责:
text
研究
  -> 分析
  -> 审核
  -> 发布
LangChain Agent 负责:
text
研究节点内部:
  模型选择搜索工具
  -> 调用搜索
  -> 汇总结果
这种组合适合把动态工具调用限制在某个节点内部,主图仍然负责任务边界和高风险流程。
五、常见问题与实践建议
1. LangGraph 和 LangChain Agent 有什么区别
可以这样理解:
| 组件 | 主要职责 |
|---|---|
| LangChain | 模型、Prompt、工具、链和 Agent 组件 |
| LangGraph | 状态、节点、边、循环和工作流编排 |
| Agent | 在工具之间动态选择和推进 |
| Workflow | 由程序定义的节点和路径 |
| Checkpoint | 保存任务状态和恢复信息 |
LangChain Agent 可以作为 LangGraph 的一个节点,但二者不是完全互斥的替代品。
2. 什么场景适合使用 LangGraph
适合:
- 多步骤任务;
- 条件分支;
- 循环和重试;
- 人工确认;
- 长时间运行;
- 暂停和恢复;
- 多个 Agent 协作;
- 需要保存任务状态;
- 需要节点级观测。
不一定适合:
- 单次模型问答;
- 一个工具调用;
- 固定的两三步接口;
- 对延迟极端敏感的简单服务;
- 没有状态和恢复需求的短请求。
3. 节点应该拆得多细
节点太大:
- 难以重试;
- 难以定位失败;
- 状态不清晰;
- 运行时间过长。
节点太小:
- 图结构复杂;
- 状态传递成本增加;
- 调试路径变长;
- 节点之间通信开销增加。
建议按业务责任和失败边界拆分:
text
查询本月数据
查询上月数据
计算变化
生成报告
人工审核
发布报告
每个节点都有独立输入、输出和可观测事件。
4. 节点中可以直接修改数据库吗
可以,但必须遵守业务边界:
- 使用服务层;
- 使用事务;
- 使用幂等键;
- 校验用户和租户;
- 记录审计;
- 处理超时和重试;
- 明确失败补偿。
不要因为节点是工作流的一部分,就绕过业务服务直接拼 SQL。
5. 如何防止图无限循环
所有循环都应该配置:
text
最大循环次数
最大任务时长
最大模型调用次数
最大工具调用次数
最大 Token
最大费用
可以把计数写入状态:
python
def increase_attempt(
    state: ReportState,
) -> dict:
    count = state.get(
        "retry_count",
        0,
    ) + 1

    if count > 3:
        return {
            "retry_count": count,
            "error": "超过最大重试次数",
        }

    return {
        "retry_count": count,
    }
路由在进入循环前检查计数。
6. 如何处理节点重试
重试策略要区分:
text
网络超时:
  可以重试

服务限流:
  延迟后重试

参数错误:
  修正参数或终止

权限失败:
  不重试

业务状态冲突:
  查询最新状态后决定

写操作超时:
  先查询幂等状态
不要让图把所有异常都重新执行,否则会造成副作用重复。
7. 检查点应该保存什么
至少保存:
- 任务 ID;
- 用户和租户;
- 当前状态;
- 已完成节点;
- 当前节点;
- 工具调用;
- 工具结果摘要;
- 重试次数;
- 审批状态;
- 计划版本;
- 错误信息;
- 最后更新时间。
不要默认保存:
- API Key;
- 数据库密码;
- 完整敏感字段;
- 不必要的原始文件;
- 未脱敏的用户隐私;
- 过大的模型响应。
8. thread_id 可以直接使用用户输入吗
不建议。thread_id 应由服务端生成,或者使用不可预测的任务 ID:
text
task-uuid
  -> 服务端创建
  -> 与 user_id 和 tenant_id 绑定
  -> 所有恢复请求都校验归属
不能只凭客户端传入 thread_id 就读取任务状态。
9. 多租户状态如何隔离
检查点和任务存储都必须绑定:
text
tenant_id
user_id
task_id
读取任务时同时校验:
text
当前用户
  -> 当前租户
  -> 任务创建者或授权角色
  -> thread_id
如果检查点存储支持自定义 Key,应将租户范围纳入索引和访问控制。
10. 人工确认后如何防止重复发布
审批恢复可能因为网络重试被调用多次。发布节点必须幂等:
python
def publish_report(
    state: ReportState,
) -> dict:
    idempotency_key = (
        state["task_id"]
        + ":"
        + state["report_version"]
    )

    existing = find_publish_record(
        idempotency_key
    )

    if existing:
        return {
            "published": True,
            "publish_id": existing.id,
        }

    record = create_publish_record(
        idempotency_key=idempotency_key,
        content=state["report"],
    )

    return {
        "published": True,
        "publish_id": record.id,
    }
11. 节点失败时是否应该回滚整个图
不一定。图工作流中的节点可能已经产生了不可逆副作用:
text
发送邮件成功
  -> 后续节点失败
此时不能依赖数据库回滚撤回邮件。应该使用:
- 状态记录;
- 补偿动作;
- 后续重试;
- 人工处理;
- 对账。
图的状态回退和业务副作用回滚是两个不同概念。
12. 如何处理用户取消任务
取消时可以:
text
标记任务 CANCEL_REQUESTED
  -> 停止未开始节点
  -> 取消可取消的异步操作
  -> 等待当前节点清理
  -> 标记 CANCELED
已经完成的写操作不能简单回退,必须记录最终状态和补偿结果。
13. 可以在节点中调用同步阻塞代码吗
可以运行,但可能阻塞工作线程或事件循环。需要根据运行方式选择:
- 使用异步客户端;
- 将同步 IO 放入线程池;
- 将 CPU 任务放入进程池;
- 将长任务放入消息队列;
- 为节点设置超时。
节点执行时间过长会影响任务恢复和资源占用。
14. 如何处理模型返回错误路径
模型只能在应用定义的路径中选择:
text
允许:
  search
  analyze
  ask_user
  finish

禁止:
  delete_database
  send_external_email
  execute_shell
路由函数和工具网关必须对模型结果做白名单校验。不能因为模型返回了一个看似合理的节点名称,就动态执行任意函数。
15. 如何观察 LangGraph 执行过程
建议记录:
text
task_id
thread_id
node_name
node_version
start_time
end_time
status
input_summary
output_summary
error_code
retry_count
model_name
token_usage
可以将节点事件转换成统一进度:
json
{
  "task_id": "task-001",
  "node": "generate_report",
  "status": "RUNNING",
  "message": "正在生成报告",
  "timestamp": "2026-09-15T10:00:00+08:00"
}
不要把内部完整 Prompt、敏感工具参数和未经脱敏的状态全部写入公共日志。
16. 如何测试状态图
测试至少包括:
- 正常路径;
- 无风险区域的短路径;
- 有风险区域的审核路径;
- 用户批准;
- 用户拒绝;
- 查询失败;
- 数据不完整循环;
- 超过最大重试;
- 节点超时;
- 检查点恢复;
- 重复恢复;
- 发布幂等;
- 跨租户访问;
- 任务取消。
测试节点函数时,可以使用固定状态;测试整张图时,应使用 Fake 工具和 Fake 模型,避免依赖真实模型随机输出。
17. 如何处理图版本升级
任务可能在旧版本图上暂停,发布新版本后需要恢复。建议保存:
text
graph_version
prompt_version
tool_version
state_schema_version
恢复策略:
- 旧任务继续使用旧图;
- 提供状态迁移;
- 只允许在安全节点切换新图;
- 对不兼容状态拒绝恢复;
- 记录升级和迁移结果。
不能假设新版本节点一定能够读取旧状态。
六、进阶思考
1. 状态图是显式的任务生命周期
LangGraph 的核心价值不是画图,而是把任务状态显式化:
text
任务创建
  -> 运行中
  -> 等待工具
  -> 等待用户
  -> 运行中
  -> 已完成
  -> 已失败
  -> 已取消
这些状态可以服务于:
- 前端进度;
- 任务查询;
- 失败恢复;
- 运营后台;
- 审计;
- 质量评估;
- 资源回收。
2. 将动态 Agent 限制在局部节点
生产工作流可以采用:
text
主图:
  定义总体任务边界和高风险流程

Agent 节点:
  在一个局部范围内选择工具

业务节点:
  执行确定性计算、事务和状态迁移

审核节点:
  处理人工确认
这样模型的自由度被控制在一个局部范围,主流程依然可预测。
3. 节点必须具备幂等语义
节点可能由于:
- 网络超时;
- 检查点保存失败;
- 服务重启;
- 用户重复点击;
- 任务恢复;
- 消息重复;
被执行多次。因此要把节点分成:
纯计算节点
同样输入得到同样输出,天然更容易重试。
只读节点
读取数据,不产生副作用,但实时结果可能变化,需要记录查询时间。
写入节点
创建、修改、发布和发送,需要幂等键、状态检查和审计。
4. 状态和事件分离
状态表示当前快照:
json
{
  "status": "WAITING_CONFIRMATION",
  "current_node": "approval"
}
事件表示状态如何变化:
json
{
  "event": "NODE_COMPLETED",
  "node": "generate_report",
  "at": "2026-09-15T10:00:00+08:00"
}
生产系统可以同时保存状态和事件:
text
当前状态:
  方便快速查询和恢复

事件日志:
  方便审计、回放和问题定位
5. 任务恢复的租约机制
多个 worker 可能同时尝试恢复同一个任务。可以使用租约:
text
worker A 获取 task-001 租约
  -> 执行节点
  -> 定期续租
  -> 保存状态
  -> 释放租约
如果 worker A 崩溃,租约过期后 worker B 才能接管。租约不能替代节点幂等,二者需要同时存在。
6. 节点级超时和总任务截止时间
应该同时设置:
text
模型节点:10 秒
搜索节点:5 秒
数据库节点:2 秒
报告生成:30 秒
总任务:2 分钟
每个节点还需要知道任务剩余时间。总截止时间临近时,应停止新增非关键节点,避免任务永远拖延。
7. 子图与领域边界
可以按领域拆分子图:
text
订单子图:
  查询订单、检查状态、创建售后

知识库子图:
  解析文件、切片、向量化、检索

报告子图:
  查询数据、分析、生成、审核、发布
子图接口应该是结构化的:
text
输入:
  task_id、tenant_id、业务参数

输出:
  status、result、citations、error
避免子图直接共享大量隐式全局状态。
8. 并行图中的数据汇聚
并行节点完成后,汇聚节点需要处理:
text
查询订单成功
查询退款成功
查询库存失败
  -> 是否允许生成部分报告
可以定义数据质量策略:
python
def check_sources(
    state: ReportState,
) -> str:
    if state["orders_status"] == "FAILED":
        return "fail"

    if state["refunds_status"] == "FAILED":
        return "degraded"

    return "continue"
数据缺失必须在状态中显式标记,不能让模型误以为没有返回的数据等于零。
9. 人工审核和权限
人工确认不能只看用户是否点击批准,还要验证:
- 审批人是否拥有审批权限;
- 审批对象是否是当前版本;
- 报告是否没有被替换;
- 任务是否未过期;
- 审批是否重复;
- 审批记录是否完整。
一个审批记录可以包含:
json
{
  "task_id": "task-001",
  "report_version": 2,
  "approver_id": "user-001",
  "decision": "APPROVED",
  "reason": "数据已核对",
  "created_at": "2026-09-15T10:10:00+08:00"
}
10. 状态图与分布式事务
LangGraph 可以编排步骤,但不会自动把多个节点变成一个分布式事务:
text
节点 A 写订单成功
节点 B 扣库存成功
节点 C 发布消息失败
需要使用:
- 本地事务;
- Outbox;
- 状态机;
- 补偿;
- 对账;
- 幂等。
状态图记录流程状态,业务系统保证数据一致性。
11. Agent 工作流的安全边界
建议建立多层安全策略:
text
图结构限制可到达节点
  -> 节点限制可用工具
  -> 工具网关校验权限
  -> 业务服务校验资源归属
  -> 写操作检查幂等和确认
  -> 审计系统记录全过程
模型只能影响决策,不能绕过图结构和业务权限。
12. 观测和回放
如果保存了节点输入摘要、输出摘要、工具调用和状态变化,就可以回放任务:
text
读取初始状态
  -> 重放节点决策
  -> 使用历史工具结果
  -> 对比新版本输出
回放适合:
- 调试;
- 回归测试;
- 模型升级评估;
- 计划质量分析;
- 事故复盘。
回放不能直接重放真实写操作,写操作必须使用模拟环境或只读模式。
13. 成本控制
每个节点可以设置预算:
text
检索节点:最多 3 次搜索
分析节点:最多 2 次模型调用
报告节点:最多 1 次长文本生成
总任务:最多 0.2 元
状态中记录:
json
{
  "usage": {
    "model_calls": 4,
    "tool_calls": 6,
    "input_tokens": 8200,
    "output_tokens": 2100,
    "estimated_cost": 0.08
  }
}
预算检查应在节点执行前完成,超过预算时走降级或人工路径。
14. 图结构和数据流可视化
复杂工作流应该生成图结构或流程文档,让开发、测试和运维能够共同理解:
text
入口
  -> 数据收集
  -> 数据质量判断
  -> 分析
  -> 报告
  -> 审核
  -> 发布
图不是为了让系统看起来复杂,而是为了让允许的路径、状态和风险更加明确。
15. 与传统工作流引擎的关系
LangGraph 适合模型驱动的状态流转和 Agent 编排。传统工作流引擎更擅长:
- 定时任务;
- 审批流程;
- 跨系统业务流程;
- 长期任务调度;
- 可靠消息;
- 事务和补偿;
- 运维管理。
生产系统可以组合:
text
传统工作流:
  负责任务调度和关键业务流程

LangGraph:
  负责 Agent 节点内的动态决策和工具选择
不要为了使用 Agent 而替换已经稳定的确定性工作流。
结论
LangGraph 通过状态、节点、边和检查点,把复杂 Agent 从一个隐式循环转化为显式的状态图。它特别适合需要多步骤执行、条件分支、循环重试、人工确认、暂停恢复和长任务管理的场景。
本文重点介绍了:
- StateGraph;
- State、Node 和 Edge;
- START 与 END;
- 条件路由;
- 循环和并行;
- Checkpoint;
- Interrupt;
- 人工审核;
- LangChain Agent 节点;
- 节点幂等;
- 任务恢复;
- 版本和可观测性。
一个可靠的 LangGraph 工作流通常应遵循:
text
先定义状态
  -> 按业务责任拆分节点
  -> 显式定义允许路径
  -> 为条件分支设置默认和失败路径
  -> 为循环设置次数和时间上限
  -> 为写操作设计幂等
  -> 使用检查点保存任务进度
  -> 在高风险节点增加人工确认
  -> 将权限、事务和审计放在图外的业务层
  -> 使用节点事件和任务状态进行观测
LangGraph 解决的是 Agent 工作流的编排和恢复问题,并不会自动解决数据库一致性、权限、安全、成本和业务补偿。真正的生产级实现,需要让状态图、业务服务、工具网关、消息系统和监控平台共同工作。
下一篇可以继续学习《单智能体到多智能体:角色分工与协作机制》,在状态图和工具编排的基础上,讨论多个 Agent 如何分工、通信、共享状态以及避免协作失控。