从零用 Java 构建 AI Agent 框架:JavaManus 设计与实现深度解析
当大模型从"对话工具"进化为"能调用工具的智能体",Agent 框架的工程实现就成了关键。本文以一个从零构建的 Java Agent 项目 JavaManus 为线索,深入拆解 ReAct 循环、工具调用编排、记忆管理、火山引擎 Ark 适配层的设计思路,并分享开发过程中踩到的几个真实坑------包括一个让超时机制完全失效的隐蔽死锁。
一、为什么要用 Java 做 Agent
提起 AI Agent,大家首先想到的是 Python 生态:LangChain、LlamaIndex、AutoGPT......确实,Python 在 LLM 领域有压倒性的生态优势。但在实际工程落地中,我们常常面临一个现实问题:企业的核心业务系统是 Java 的。
把 Python Agent 嵌入 Java 系统,意味着跨进程调用、序列化开销、运维复杂度翻倍。如果能有一个轻量、可控、能直接复用 Spring 生态的 Java Agent 框架,工程价值是巨大的。
JavaManus 的目标就是:用纯 Java 实现一个可扩展的 ReAct Agent,无缝接入 Spring Boot 应用,支持自定义工具和任意 LLM 提供商。
项目基于 Spring AI 1.1.0 + Spring Boot 3.4,使用火山引擎 Ark(豆包)作为默认 LLM,整体不到 30 个 Java 文件,结构清晰,适合学习和二次开发。
二、架构总览
scss
┌─────────────────────────────────────────────────────────┐
│                    ManusController                       │
│              (SSE 接口,对外暴露 Agent 能力)               │
└───────────────────────┬─────────────────────────────────┘
                        │ ObjectProvider.getObject()
                        ▼
┌─────────────────────────────────────────────────────────┐
│                      ManusAgent                          │
│   (装配工具集: StrReplaceEditor / PythonExecute / ...)    │
└───────────────────────┬─────────────────────────────────┘
                        │ extends
                        ▼
┌─────────────────────────────────────────────────────────┐
│                    ToolCallAgent                         │
│        (工具调用编排: think → act → observe 循环)          │
└───────────────────────┬─────────────────────────────────┘
                        │ extends
                        ▼
┌─────────────────────────────────────────────────────────┐
│            ReActAgent → BaseAgent                        │
│   (状态机 / Memory / 步数控制 / 卡死检测 / 事件分发)       │
└─────────────────────────────────────────────────────────┘
                        │
        ┌───────────────┼───────────────┐
        ▼               ▼               ▼
   ┌─────────┐    ┌───────────┐   ┌──────────────┐
   │ Memory  │    │ ChatModel │   │ ToolCallback │
   │(消息记忆)│    │ (Ark 适配) │   │  (工具集合)   │
   └─────────┘    └───────────┘   └──────────────┘
整个架构遵循"组合优于继承"的原则:
- BaseAgent:纯状态机,不关心 LLM 怎么调、工具怎么执行
- ReActAgent :定义
step() = think() + act()的骨架 - ToolCallAgent:实现工具调用的 think/act 逻辑
- ManusAgent:只负责装配具体工具
这种分层让每一层的职责单一,替换 LLM 或工具集都不需要改 Agent 核心逻辑。
三、核心循环:ReAct 的本质
ReAct(Reasoning + Acting)是 Agent 最经典的模式。它的核心思想是:让模型在"思考"和"行动"之间交替,每一步的行动结果都喂回模型作为下一步思考的依据。
在 JavaManus 中,这个循环被抽象为 BaseAgent.run():
java
public String run(String request) {
    memory.addMessage(new UserMessage(request));
    state = AgentState.RUNNING;
    try {
        while (currentStep < maxSteps && state != AgentState.FINISHED) {
            currentStep++;
            String stepResult = step();   // think + act
            if (isStuck()) {              // 卡死检测
                handleStuckState();
            }
            results.add("Step " + currentStep + ": " + stepResult);
        }
    } finally {
        state = AgentState.IDLE;
        currentStep = 0;
        memory.clear();                   // 防止记忆污染
    }
    return String.join("\n", results);
}
step() 由 ReActAgent 实现,是一个经典的模板方法:
java
public String step() {
    if (!think()) {
        // 思考阶段判定无需行动,直接返回最后内容
        Message last = memory.getLast();
        return last != null ? last.getText() : "Task completed";
    }
    return act();
}
3.1 think():让模型决定下一步
ToolCallAgent.think() 的职责是:把 memory 中的消息 + system prompt + 工具定义发给 LLM,解析返回的文本和工具调用。
java
protected boolean think() {
    List<Message> messages = buildMessages();
    ToolCallingChatOptions options = DefaultToolCallingChatOptions.builder()
            .toolCallbacks(availableTools.getTools().toArray(new ToolCallback[0]))
            .internalToolExecutionEnabled(false)  // 关键:禁用 Spring AI 自动执行
            .build();

    ChatResponse response = chatModel.call(new Prompt(messages, options));
    AssistantMessage msg = response.getResult().getOutput();

    toolCalls = msg.getToolCalls();
    memory.addMessage(msg);
    fireThought(msg.getText());

    // 根据 toolChoice 决定是否需要 act
    return !toolCalls.isEmpty();
}这里有一个关键设计点:internalToolExecutionEnabled(false)。
Spring AI 默认会在 ChatModel.call() 内部自动执行工具调用并递归请求 LLM。但在 Agent 框架中,我们需要手动控制工具执行的时机和方式(比如截断工具输出、触发事件、检测特殊工具),所以必须禁用自动执行,自己编排循环。
3.2 act():执行工具并记录结果
java
protected String act() {
    for (ToolCall tc : toolCalls) {
        Map<String, Object> args = parseArgs(tc.arguments());
        String result = availableTools.execute(tc.name(), args);

        if (maxObserve > 0 && result.length() > maxObserve) {
            result = result.substring(0, maxObserve);  // 截断超长输出
        }

        // 把工具结果作为 ToolResponseMessage 写回 memory
        memory.addMessage(ToolResponseMessage.builder()
                .responses(List.of(new ToolResponse(tc.id(), tc.name(), result)))
                .build());

        if (isSpecialTool(tc.name())) {
            state = AgentState.FINISHED;  // terminate 工具直接结束
        }
    }
    return ...;
}
注意 maxObserve 的设计:工具执行结果可能非常大(比如 cat 了一个几万行的文件),如果全部喂回 LLM,会迅速耗尽 context window。所以必须截断,只保留前 N 个字符。
3.3 消息流转:Memory 的角色
Memory 本质上是一个带上限的消息列表,每次 addMessage 后会检查是否超过 maxMessages,超过就丢弃最早的消息:
java
private void trimIfNeeded() {
    if (messages.size() > maxMessages) {
        messages = new ArrayList<>(
            messages.subList(messages.size() - maxMessages, messages.size())
        );
    }
}
这个"滑动窗口"策略很朴素,但在长任务中能保证 context 不会无限膨胀。更好的做法是用摘要或向量检索做长期记忆,但对于大部分工具调用场景,滑动窗口已经够用。
四、工具系统:让 Agent 能动手
工具是 Agent 与外部世界交互的桥梁。JavaManus 的工具系统设计很简洁。
4.1 BaseTool:统一抽象
java
public abstract class BaseTool implements ToolCallback {
    public abstract String execute(Map<String, Object> args);

    @Override
    public String call(String functionArguments) {
        try {
            Map<String, Object> args = JsonUtils.parse(functionArguments);
            return execute(args);
        } catch (Exception e) {
            return "Error: " + e.getMessage();
        }
    }
}
这里复用了 Spring AI 的 ToolCallback 接口,让所有工具天然能被 Spring AI 的工具调用机制识别。execute 返回纯文本,简化了工具与 LLM 的交互协议。
4.2 ToolCollection:工具路由
java
public class ToolCollection {
    private final Map<String, ToolCallback> tools = new HashMap<>();

    public String execute(String toolName, Map<String, Object> args) {
        BaseTool tool = (BaseTool) tools.get(toolName);
        if (tool == null) throw new ToolError("Unknown tool: " + toolName);
        return tool.execute(args);
    }
}
4.3 两个核心工具
StrReplaceEditor :文件查看/创建/编辑工具,支持 view、create、str_replace、insert、undo_edit 五种命令。这是 Agent 修改代码的主要手段。
PythonExecute :通过 ProcessBuilder 启动独立 Python 进程执行代码,带超时保护。让 Agent 能做数学计算、数据处理等 Python 擅长的事。
五、火山引擎 Ark 适配层
Spring AI 官方没有火山引擎的 starter,所以需要自己实现 ChatModel 和 EmbeddingModel。
5.1 ArkChatModel
核心是把 Spring AI 的 Prompt 转成 Ark SDK 的 ChatCompletionRequest,再把响应转回 Spring AI 的 ChatResponse:
java
public ChatResponse call(Prompt prompt) {
    List<ChatMessage> messages = toArkMessages(prompt);  // Spring AI Message → Ark ChatMessage
    List<ChatTool> tools = extractTools(prompt);          // ToolCallback → Ark ChatTool

    ChatCompletionRequest req = ChatCompletionRequest.builder()
            .model(props.getChatModel())
            .messages(messages)
            .tools(tools)
            .build();

    ChatCompletionResult resp = service.createChatCompletion(req);
    return toChatResponse(resp);  // Ark 响应 → Spring AI ChatResponse
}
消息转换中最复杂的是 tool call 的双向映射:
java
// Spring AI AssistantMessage.ToolCall → Ark ChatToolCall
List<ChatToolCall> toolCalls = assistantMessage.getToolCalls().stream()
    .map(tc -> new ChatToolCall(tc.id(), "function",
        new ChatFunctionCall(tc.name(), tc.arguments())))
    .toList();

// Ark ChatToolCall → Spring AI AssistantMessage.ToolCall
toolCalls = message.getToolCalls().stream()
    .map(tc -> new AssistantMessage.ToolCall(
        tc.getId(), "function",
        tc.getFunction().getName(), tc.getFunction().getArguments()))
    .toList();
这里要注意:Ark 的 ChatFunctionCall 中 arguments 是 JSON 字符串,Spring AI 也是字符串,所以可以直接透传。
5.2 关于 systemPrompt 的设计
Ark 适配层有一个 systemPrompt 配置项,但 Agent 层也有自己的 systemPrompt。这两个的职责是:
- ArkProperties.systemPrompt:全局默认的系统提示词(比如"You are a helpful assistant")
- Agent.systemPrompt:Agent 专属的角色设定和工具使用说明
在 toArkMessages 中,Ark 的 systemPrompt 会被放在消息列表最前面,Agent 的 systemPrompt 通过 SystemMessage 传入。这种分层让不同 Agent 可以共享同一个底层 ChatModel 但有不同的角色设定。
六、工程实践中的几个真实坑
写一个能跑的 Agent 不难,写一个稳健的 Agent 才是考验。下面是开发过程中遇到的几个真实问题,以及修复方案。
6.1 坑一:PythonExecute 的超时机制完全失效
现象:设置了 5 秒超时,但 Python 代码死循环时进程永远不退出。
根因:原代码的执行顺序有问题:
java
// ❌ 错误:readAllBytes 会阻塞直到进程关闭 stdout,
// 也就是进程退出。所以 waitFor 的超时永远等不到。
String output = new String(process.getInputStream().readAllBytes(), UTF_8);
boolean finished = process.waitFor(timeout, TimeUnit.SECONDS);
readAllBytes() 会一直读到 EOF,而 EOF 只有在进程退出后才会出现。如果进程死循环,readAllBytes() 永远不返回,waitFor 根本没机会执行。
修复 :用 CompletableFuture 异步读取输出流,先 waitFor 再拿结果:
java
CompletableFuture<String> outputFuture = CompletableFuture.supplyAsync(() -> {
    try {
        return new String(process.getInputStream().readAllBytes(), UTF_8);
    } catch (IOException e) { return ""; }
});

boolean finished = process.waitFor(timeout, TimeUnit.SECONDS);
if (!finished) {
    process.destroyForcibly();
    String partial = outputFuture.get(2, TimeUnit.SECONDS);
    return partial + "\nExecution timeout after " + timeout + " seconds";
}
String output = outputFuture.get(2, TimeUnit.SECONDS);
这个坑非常隐蔽------代码看起来没问题,单测可能也过(因为测试用的 Python 代码都能快速结束),但在生产环境遇到死循环就直接挂死。
6.2 坑二:文件编辑工具无沙箱限制
问题 :StrReplaceEditor 只校验路径是否为绝对路径,但不限制范围。Agent 可以通过 LLM 工具调用读取或修改系统任意文件,比如 /etc/passwd。
修复 :引入 workspaceRoot,所有操作路径必须在 workspace 内:
java
private void checkWithinWorkspace(Path path) {
    if (workspaceRoot == null) return;
    Path normalized = path.toAbsolutePath().normalize();
    if (!normalized.startsWith(workspaceRoot)) {
        throw new ToolError("Access denied: path " + normalized
                + " is outside the workspace " + workspaceRoot);
    }
}
workspaceRoot 通过 JavaManusProperties 配置,在 ManusAgent 构造时传入 StrReplaceEditor。
6.3 坑三:System.out.println 泄露 prompt
问题 :ArkChatModel.call() 里用 System.out.println 打印完整 prompt 到控制台。prompt 里包含用户输入和工具参数,可能有敏感信息。
修复 :加 @Slf4j,改用 log.debug。日志级别可控,生产环境不会输出。
6.4 坑四:LLM 调用失败后死循环
问题 :think() 中 LLM 抛异常时,向 memory 写入一条错误消息并返回 false,循环继续。但 memory 里多了一条错误消息,下一轮 LLM 可能继续失败,导致直到 maxSteps 才退出,浪费 API 配额。
修复:LLM 失败时直接终止循环:
java
try {
    response = chatModel.call(prompt);
} catch (Exception e) {
    log.error("LLM call failed", e);
    memory.addMessage(new AssistantMessage("Error: " + e.getMessage()));
    state = AgentState.FINISHED;  // 终止,避免死循环
    return false;
}
6.5 坑五:卡死检测逻辑误判
问题 :原 isStuck() 会遍历历史所有 assistant 消息,统计与最后一条消息文本相同的数量。这导致两个误判:
- 工具调用后最后一条消息是
ToolResponseMessage,被跳过,检测时机不对 - 历史中偶发的重复响应会被累计,导致误判
修复 :只统计连续重复的 assistant 消息:
java
protected boolean isStuck() {
    List<Message> msgs = memory.getMessages();
    // 找到最后一条 assistant 消息
    int lastAssistantIdx = -1;
    for (int i = msgs.size() - 1; i >= 0; i--) {
        if (msgs.get(i).getMessageType() == MessageType.ASSISTANT) {
            lastAssistantIdx = i; break;
        }
    }
    if (lastAssistantIdx < 0) return false;

    Message last = msgs.get(lastAssistantIdx);
    if (last.getText() == null || last.getText().isBlank()) return false;

    // 只向前统计连续相同的 assistant 消息
    int duplicateCount = 0;
    for (int i = lastAssistantIdx - 1; i >= 0; i--) {
        Message m = msgs.get(i);
        if (m.getMessageType() != MessageType.ASSISTANT) continue;
        if (last.getText().equals(m.getText())) duplicateCount++;
        else break;
    }
    return duplicateCount >= duplicateThreshold;
}
七、对外接口:SSE 流式输出
Agent 执行可能需要几十秒,同步 HTTP 接口会超时。JavaManus 用 SSE(Server-Sent Events)实时推送思考过程和工具调用结果:
java
@PostMapping(value = "/chat", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public SseEmitter chat(@RequestBody ChatRequest request) {
    SseEmitter emitter = new SseEmitter(props.getSseTimeoutSeconds() * 1000L);
    ManusAgent agent = manusAgentProvider.getObject();

    agent.addListener(new AgentEventListener() {
        public void onThought(String content) {
            send(emitter, "thought", content);
        }
        public void onToolCall(String name, Map<String, Object> args) {
            send(emitter, "tool_call", Map.of("name", name, "args", args));
        }
        public void onToolResult(String name, String result) {
            send(emitter, "tool_result", Map.of("name", name, "result", result));
        }
        public void onComplete(String finalResult) {
            send(emitter, "complete", finalResult);
            emitter.complete();
        }
        public void onError(Throwable e) {
            send(emitter, "error", e.getMessage());
        }
    });

    Thread.ofVirtual().start(() -> agent.run(request.getPrompt()));
    return emitter;
}
几个设计要点:
- 虚拟线程 :Agent 执行在
Thread.ofVirtual()中,不阻塞 Web 容器线程 - 事件类型 :
thought/tool_call/tool_result/complete/error,前端可以做丰富的 UI - prototype 作用域 :
ManusAgent是有状态的,每次请求通过ObjectProvider.getObject()获取新实例
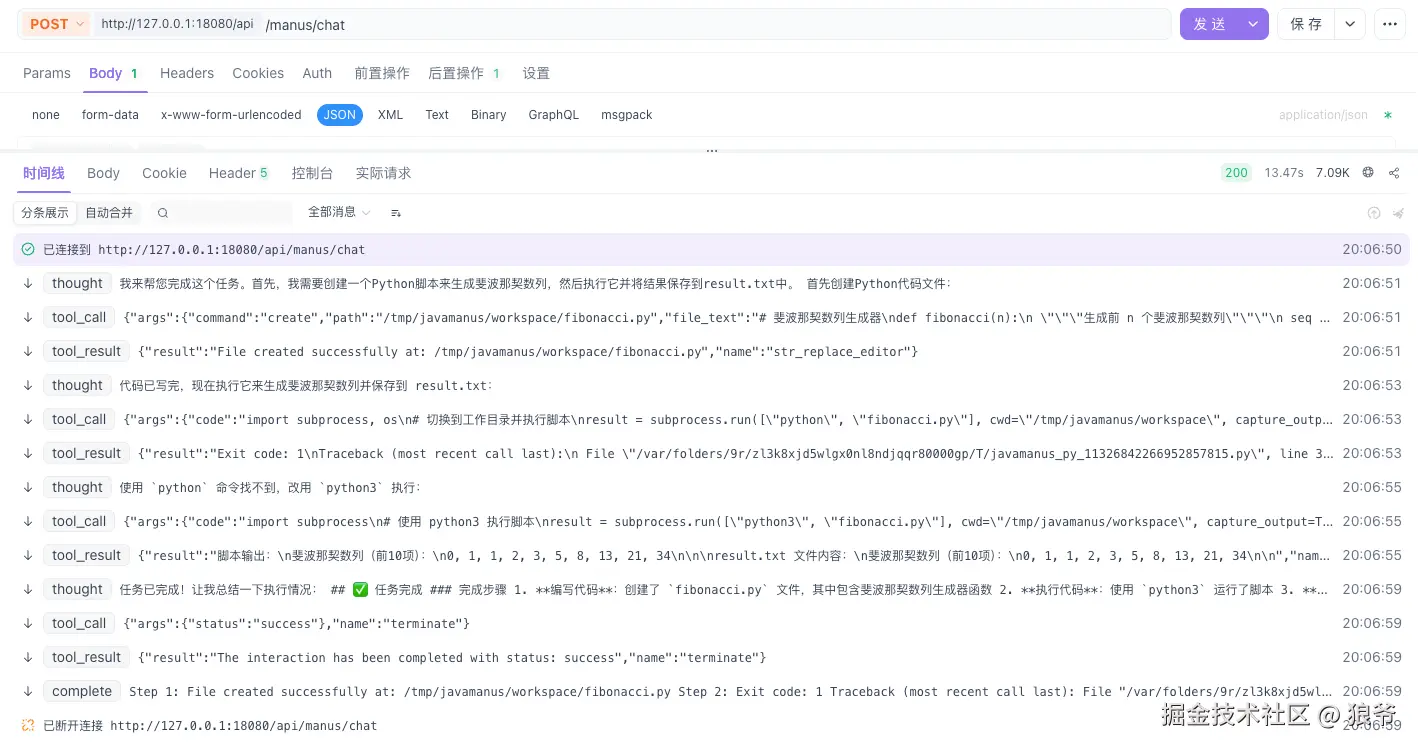
八、实战运行:一个真实的 ReAct 循环
理论说得再多,不如看一次真实运行。下面是 JavaManus 处理用户请求的完整日志,请求是:
用 Python 写一个代码模拟斐波那契数列输出,10 行数列即可,代码写完才执行,结果保存到 result.txt 中
整个过程耗时约 14 秒 ,执行了 4 步。下面逐步拆解。
8.1 Step 1:理解需求,创建代码文件
makefile
20:06:45.831  Executing step 1/20
20:06:50.758  Manus thoughts: 我来帮您完成这个任务。首先,我需要创建一个Python脚本来
                            生成斐波那契数列,然后执行它并将结果保存到result.txt中。
20:06:50.759  Manus selected 1 tools
20:06:50.764  Activating tool: str_replace_editor with args: {command=create,
              path=/tmp/javamanus/workspace/fibonacci.py, file_text=...}
20:06:50.879  Tool str_replace_editor completed. Result: File created successfully
Agent 第一步选择了 str_replace_editor 的 create 命令,在 workspace 目录下创建了 fibonacci.py。注意路径被限制在 /tmp/javamanus/workspace/ 内------这正是沙箱机制在起作用。
8.2 Step 2:执行失败,暴露环境问题
ini
20:06:50.883  Executing step 2/20
20:06:53.290  Manus thoughts: 代码已写完,现在执行它来生成斐波那契数列并保存到 result.txt
20:06:53.303  Activating tool: python_execute with args: {code=import subprocess...
              result = subprocess.run(["python", "fibonacci.py"], ...)}
20:06:53.570  Tool python_execute completed. Result: Exit code: 1
              FileNotFoundError: [Errno 2] No such file or directory: 'python'
Agent 用 python 命令执行脚本,失败了------因为这台机器上只有 python3,没有 python 软链接。工具把完整的 traceback 返回给了 LLM。
这一步的关键在于:Agent 不是直接崩溃,而是把错误信息作为观察结果(observation)喂回 LLM,让它自己决定下一步。
错误信息是如何流转的
很多人对 Agent 的"自动重试"有误解,以为是框架写了个 try-catch + retry。其实不是。JavaManus 的重试完全是 LLM 驱动的自主决策,错误信息的流转路径是这样的:
scss
工具执行失败
    │
    ▼
act() 把错误字符串作为 ToolResponseMessage 写入 memory
    │
    ▼
下一轮 think() 时,memory 中的完整消息历史(含错误 traceback)发给 LLM
    │
    ▼
LLM 读到 FileNotFoundError,自主推理出"应该用 python3"
    │
    ▼
LLM 返回新的工具调用(python3),act() 执行成功
对应到代码,就是 ToolCallAgent.act() 中的这几行:
java
String result;
try {
    result = availableTools.execute(toolName, args);
} catch (Exception e) {
    // 关键:不吞掉异常,把完整错误信息返回给 LLM
    result = "Error: " + e.getMessage();
}

// 把工具结果(无论成功失败)写回 memory,作为下一轮的 observation
memory.addMessage(ToolResponseMessage.builder()
        .responses(List.of(new ToolResponse(tc.id(), tc.name(), result)))
        .build());
这里的设计哲学是:框架只负责传递信息,决策权交给 LLM。 框架不会说"命令不存在,我帮你换 python3 重试",而是把 FileNotFoundError 原样丢给 LLM,让它自己判断该怎么办。这正是 ReAct 模式与传统自动化脚本的本质区别。
8.3 Step 3:自我纠错,改用 python3
css
20:06:53.572  Executing step 3/20
20:06:55.877  Manus thoughts: 使用 `python` 命令找不到,改用 `python3` 执行
20:06:55.879  Activating tool: python_execute with args: {code=...subprocess.run(["python3", ...])}
20:06:55.997  Tool python_execute completed. Result: 脚本输出:
              斐波那契数列(前10项):
              0, 1, 1, 2, 3, 5, 8, 13, 21, 34

              result.txt 文件内容:
              斐波那契数列(前10项):
              0, 1, 1, 2, 3, 5, 8, 13, 21, 34
LLM 读到 FileNotFoundError: 'python' 后,自主判断 应该改用 python3,重新执行脚本。这次成功了,控制台输出了斐波那契数列,result.txt 也正确写入。
这就是 ReAct 的精髓:观察 → 推理 → 行动 的闭环。Agent 不需要人类告诉它 python 不存在,它从错误信息中自己学到了这一点。
这不是代码重试,而是智能重试
值得强调的是,这种"自动重试"和传统意义上的代码重试有本质区别:
| 维度 | 传统代码重试 | Agent 智能重试 |
|---|---|---|
| 触发条件 | 捕获到特定异常类型 | LLM 从错误信息中推理出需要重试 |
| 重试策略 | 固定(换参数/退避/换 endpoint) | 灵活(换命令/换路径/换工具) |
| 信息利用 | 只看异常类型,忽略错误内容 | 完整利用 traceback 文本 |
| 决策主体 | 框架代码 | LLM |
传统重试只能处理"已知的失败模式"(比如网络超时),而 Agent 重试能处理"未知的失败"------因为 LLM 能理解错误文本的语义。日志中 python → python3 的切换,就是 LLM 从 FileNotFoundError: No such file or directory: 'python' 这个自然语言错误中推理出来的。
不过,这种能力也有代价:每次重试都要消耗一次 LLM 调用的 token 和延迟 。日志中 Step 2 → Step 3 之间间隔了 2.3 秒,其中 2 秒是 LLM 推理时间。所以重试不是免费的,这也是为什么框架需要 max-steps 来限制最大循环次数。
8.4 Step 4:总结并终止
makefile
20:06:55.997  Executing step 4/20
20:06:59.032  Manus thoughts: 任务已完成!让我总结一下执行情况:
              # ✅ 任务完成
              ## 完成步骤
              1. 编写代码:创建了 fibonacci.py 文件
              2. 执行代码:使用 python3 运行了脚本
              3. 结果保存:成功将结果写入 result.txt
              ## 生成的斐波那契数列(前10项)
              0, 1, 1, 2, 3, 5, 8, 13, 21, 34
20:06:59.034  Manus selected 1 tools
20:06:59.036  Activating tool: terminate with args: {status=success}
20:06:59.038  Tool terminate completed. Result: The interaction has been completed with status: success
20:06:59.039  Special tool terminate completed the task!
Agent 确认任务完成,调用 terminate 工具,框架将 state 设为 FINISHED,循环结束。
8.5 从日志看设计
这 14 秒的运行日志,验证了前面讲的几个设计点:
| 设计点 | 日志中的体现 |
|---|---|
| ReAct 循环 | 4 次 Executing step,每次都是 think → act → observe |
| 工具编排 | str_replace_editor → python_execute(失败)→ python_execute(成功)→ terminate |
| 智能重试 | Step 2 的 FileNotFoundError 被作为 observation 喂回 LLM,Step 3 自主改用 python3 |
| 沙箱限制 | 所有文件操作都在 /tmp/javamanus/workspace/ 下 |
| 终止机制 | terminate 工具触发 state = FINISHED,循环优雅退出 |
| 步数控制 | max-steps: 20,实际只用了 4 步就完成 |
特别值得注意的是 Step 2 → Step 3 的纠错过程。很多人担心 Agent 遇到错误就会卡死或无限循环,但只要工具返回的错误信息足够清晰,LLM 完全有能力自我修正。这也是为什么我们在 PythonExecute 中保留完整的 traceback 输出,而不是只返回 "Execution failed"。
8.6 两种失败,两种策略
从这个案例引申出一个重要的设计决策:框架必须区分"工具执行失败"和"LLM 调用失败",因为它们的处理方式完全不同。
| 失败类型 | 原因 | 处理策略 | 为什么 |
|---|---|---|---|
| 工具执行失败 | 命令不存在、文件找不到、代码报错等 | 错误信息写回 memory,LLM 自主决策 | LLM 能理解错误语义并纠错(如 python→python3) |
| LLM 调用失败 | 网络超时、API 限流、认证失败等 | 直接终止循环(state = FINISHED) |
再试大概率还是失败,只会浪费配额 |
这正是第六章"坑四"中修复的问题。最初的版本里,LLM 调用失败后只是向 memory 写入一条错误消息然后继续循环,结果就是 LLM 反复看到自己的错误消息、反复失败,直到 max-steps 耗尽。
修复后的逻辑很清晰:
java
// think() 中
try {
    response = chatModel.call(prompt);
} catch (Exception e) {
    // LLM 本身挂了,重试也没用,直接终止
    memory.addMessage(new AssistantMessage("Error: " + e.getMessage()));
    state = AgentState.FINISHED;
    return false;
}
而工具执行失败时,框架不做任何干预,把错误原样交还给 LLM。这种"该放手时放手,该终止时终止"的设计,让 Agent 既保持了纠错的灵活性,又避免了无意义的死循环。
九、配置体系
所有可调参数集中在 JavaManusProperties:
yaml
javamanus:
  workspace-root: /tmp/javamanus/workspace  # 工具操作的沙箱目录
  max-steps: 20                              # 最大执行步数
  max-observe: 10000                         # 工具输出截断长度
  duplicate-threshold: 2                     # 卡死检测阈值
  max-messages: 100                          # 记忆窗口大小
  sse-timeout-seconds: 300                   # SSE 连接超时
这种集中配置的好处是:不需要改代码就能调整 Agent 行为。比如调大 max-steps 让 Agent 处理更复杂的任务,调小 max-observe 节省 token。
十、总结与展望
JavaManus 用不到 30 个 Java 文件实现了一个完整的 ReAct Agent 框架,核心设计可以总结为三点:
- 分层清晰:BaseAgent(状态机)→ ReActAgent(循环骨架)→ ToolCallAgent(工具编排)→ ManusAgent(工具装配),每层职责单一
- 手动编排工具调用:禁用 Spring AI 自动执行,自己控制 think→act→observe 循环,获得最大灵活性
- 工程化思维:沙箱限制、超时保护、卡死检测、记忆窗口、SSE 流式输出,这些"非算法"部分才是 Agent 能否上线的关键
未来可以扩展的方向:
- 长期记忆:用向量数据库替代滑动窗口,支持跨会话记忆
- 多 Agent 协作:让多个 Agent 分工协作(规划者、执行者、审查者)
- 工具动态加载:支持运行时注册新工具,比如通过 MCP 协议
- 失败重试与限流:LLM 调用失败时指数退避重试,429 时自动限流
- 可观测性:集成 Micrometer 记录每步耗时、token 消耗、工具调用统计
Agent 框架的本质是把"大模型的推理能力"和"工程系统的确定性"缝合在一起。缝合得好,Agent 就是可靠的生产力工具;缝合得不好,就是一个不可预测的黑盒。JavaManus 是我在这条路上的一次实践,希望能给你一些启发。
项目地址 :github.com/jasperzxy/J... gitee.com/zhongxianya...
如果你觉得这篇文章有帮助,欢迎点赞、收藏、关注。有问题或建议,评论区见。