大家好,我是数据库小学妹 👋 我踩过的坑,你别再踩。
上个月我被拉进一个选型会。客户要换掉跑了六年的 Oracle 同步链路。会议室里摆着三份方案,报价差了三倍。业务方只问一句:明天早上八点前,报表能不能拿到今天的数。
那一刻我特别想说,选型根本不是比参数表。真正决定成败的,是底下的管子怎么走。说到底,桌上那三份方案,其实是同一类工具。这类工具,到底在干什么?
**数据库实时同步工具,就是把源库变更实时搬到目标库的软件。**搬完还得保证两边对得上。它和定时跑批不是一回事。跑批看的是昨天,实时同步看的是刚刚。这个差别落在风控、库存、看板里,就是能用和不能用。
一、先说清楚:为什么现在必须上实时同步
以前做项目,报表都是每天凌晨两点跑批。到了早上九点,看到的是前一天的数。那时候这没问题,因为业务本身也是隔天对账。现在不行了。风控要发现即阻断,库存要实时扣减。监管那边,随时要能调出当天的流水。夜里跑的那批数据,等到上班早就凉了。
更麻烦的是,企业里的库越来越杂。核心交易在 Oracle,营销系统是 MySQL,老系统还留着 SQL Server,这两年又添了国产库。一份"客户"数据散在五六个库里,字段名都不一样。想打通,靠人写脚本根本撑不住。这也是"数据库实时同步工具"这个词被搜得多的原因。大家不是想了解概念,是想找一条能落地的路。
二、实时同步的地基:增量数据到底怎么抓
不管工具叫什么名字,核心只有一个问题。怎么知道源库变了哪几行?业界做增量,无非三种路子。
第一种,靠时间戳或增量字段 。用 last_update_time 这类字段把新增的捞出来。实现最简单。但源表没这个字段就干不了。删除操作抓不到,高并发下还容易漏。我见过一个项目。源表时间戳精度只到秒,同一秒的两笔变更丢了一笔。
第二种,在源库建触发器。变更写进一张日志表。增删改都能抓到,但要动源库,有额外开销。很多业务方一听要加触发器,直接就不让了。
第三种,解析数据库自己的日志,也就是常说的 CDC。Oracle 读 redo log,MySQL 读 binlog,PostgreSQL 读 WAL。按顺序把变更一条条解出来,再应用到目标端。第三种为什么成了主流?因为它不改源库,还能拿到完整的事务顺序。数据库本来就要靠这些日志做崩溃恢复。日志里记着每次增删改的完整现场。按顺序重放,一致性天然有保障。
日志还有个关键属性:带位点 。MySQL 里是 binlog 文件名加偏移量,Oracle 里是 SCN,PostgreSQL 里是 LSN。工具把"读到哪了"记下来。链路断了重启,就从上次的位置接着读。不重,也不漏。这个能力叫断点续传,生产环境全靠它兜底。我吃过一次亏。某个工具的位点存在内存里,进程一挂就得重跑全量。
全量和增量怎么衔接,也是门学问。严谨的做法是这样。先对源库做一致性快照,同时记下那一刻的日志位点。全量搬完后,从那个位点开始补增量。等两边差距追到零,再切流量。顺序颠倒,中间漏掉的那一段,就是日后对不上账的伏笔。
三、六类数据库实时同步工具,一张表看全
地基打好了,再看工具本身。市面上的工具很多,但按定位归类,其实就六类。我把关键维度拉平,放一张表里。你对着看,差别很清楚。
| 类别 | 代表工具 | 实时性 | 源端覆盖 | 国产库适配 | 运维成本 | 典型场景 |
|---|---|---|---|---|---|---|
| 开源 CDC 组件 | Canal、Debezium | 毫秒~秒级 | Canal 仅 MySQL;Debezium 依赖 Kafka | 弱 | 中高(自建自维护) | 单源 CDC、事件流 |
| 大数据集成平台 | Apache SeaTunnel、DataX | 离线到批量级 | 广 | 一般 | 中(需集群) | 湖仓入湖、离线批 |
| 商业数据复制 | Oracle GoldenGate | 毫秒级 | 偏 Oracle 生态 | 弱 | 中 | 同构高可用、迁移 |
| 云托管同步服务 | 阿里云 DTS、腾讯云 DTS | 秒级 | 云上实例为主 | 视版本而定 | 低 | 上云、同城容灾 |
| 数据集成平台 | TapData、NineData 等 | 秒级 | 较广 | 部分支持 | 低 | 多源汇聚、API 服务 |
| 国产数据库厂商同步工具 | 金仓 Kingbase FlySync 等 | 亚秒级 | 30 余种数据源 | 强 | 低(图形化管控) | 信创迁移、灾备、双活 |
这张表看下来,没有哪一类是通吃的。选型真正的分水岭就两条:你要多快的数据,源端有多复杂。
四、逐类拆解:每类工具适合谁
先说开源 CDC 组件这一类。Canal 解析 MySQL binlog 很成熟,延迟低,但源端只认 MySQL。你要是有一半业务在 Oracle,它直接出局。Debezium 多源支持好一些,可它强依赖 Kafka 和 ZooKeeper。链路一长,故障点就多。我见过小团队为了同步一条链路,额外维护了一整套 Kafka 集群。运维成本比同步本身还高。
大数据集成平台,像 SeaTunnel、DataX,做数据入湖很强,批流一体也喊了几年。可它们的落点是数据湖、数仓。不是把一个业务库的变更搬到另一个业务库。拿它们做核心系统迁移,事务顺序、回滚这些细节不好处理。
商业复制工具里,Oracle GoldenGate 在 Oracle 生态里确实稳。但异构场景下参数调优复杂,对源库资源占用也高。真正要算的是授权成本,还有信创环境下的适配。我碰到的场景是,源端做版本升级时,捕获进程容易挂起。增量就开始积压。
云托管同步服务,阿里云 DTS、腾讯云 DTS 这一类,上手确实快。全量加增量一条龙,控制台点点就配好了。短板也很明确:数据要经过云上。金融和政务场景里,这一条常常直接否掉。这两年云 DTS 也在往 AI 数据准备方向延伸。比如给非结构化数据到向量库铺通道,那是另一条赛道了。
数据集成平台偏服务化,可视化配置做得好。拖拖拽拽就能建管道,还提供 API 化输出。多源汇聚的需求,比如客户中心、用户画像,它接得很顺。但你要的是把生产库原样搬到另一个库。它的数据模型就会多绕一层。
最后是国产数据库厂商的同步工具。信创场景基本绕不开这一类。这几年我碰得最多的就是它。原因很简单。信创项目往往要求国产芯片和操作系统,还要接上已有的 Oracle、SQL Server、MySQL。前几类工具在这里都容易卡壳。我用的比较多的是金仓的异构数据同步软件 Kingbase FlySync(简称 KFS)。
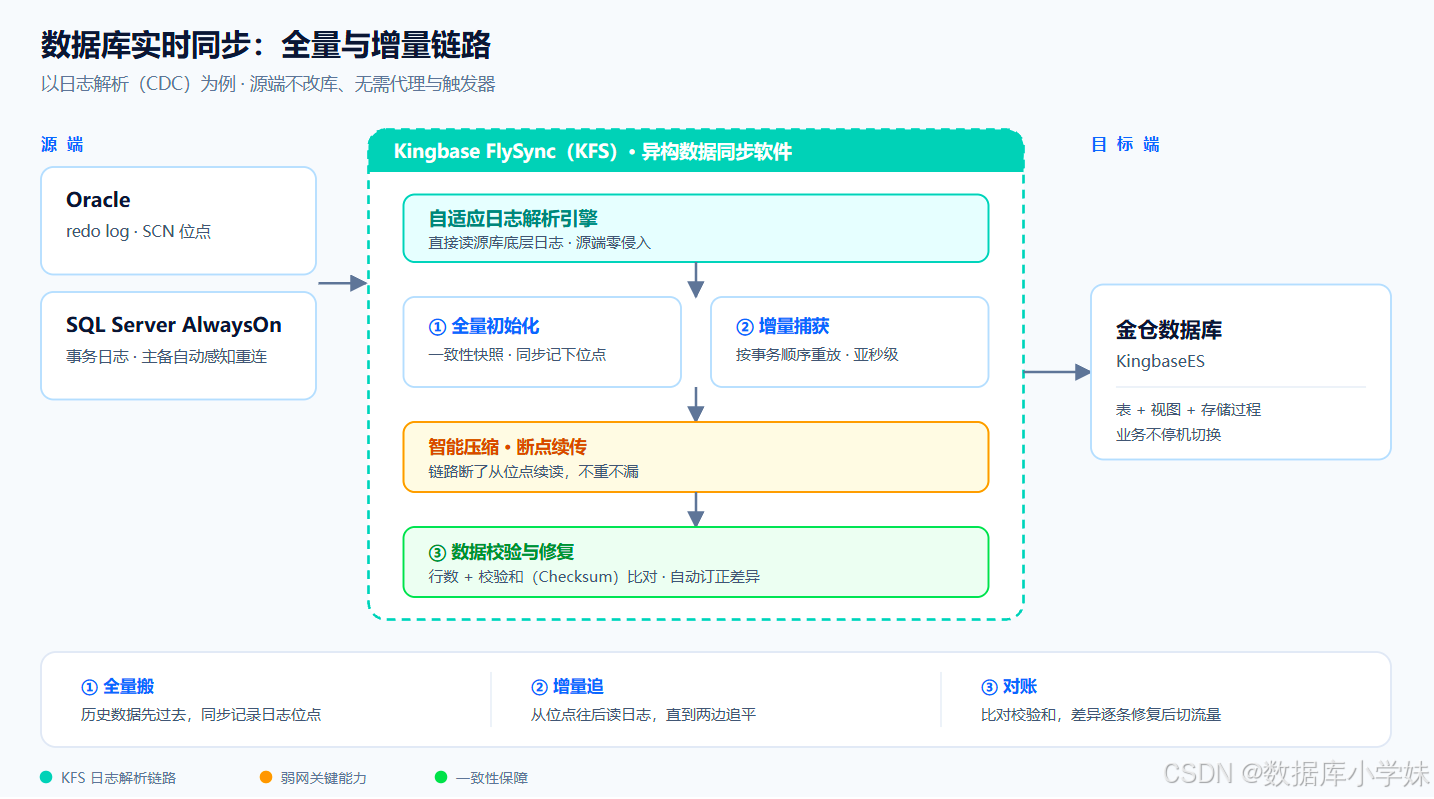
它走的就是日志解析这条路。自适应日志解析引擎直接读源库底层日志。源端不用装代理,也不用加触发器。这点在做 SQL Server AlwaysOn 集群的项目里特别值钱。主备切换时它能自己感知并重连,不用人半夜爬起来重新配。
同步粒度上,它支持按模式、按表、按对象过滤。视图和存储过程这些对象结构也在同步范围内。源端有几十个Schema时,你只挑核心业务同步就行。
五、案例复盘:Oracle 加 SQL Server 迁国产库,链路怎么搭
聊个我做过的真实场景。客户核心交易在 Oracle,还有一套 SQL Server AlwaysOn 集群跑运营系统。目标是把数据集中到金仓数据库(KingbaseES),业务不能停。这套链路我是按三个阶段搭的。
第一阶段,全量搬。 历史数据先过去,同时记下日志位点。KFS 在这块资源占用不高。官方公开的能力是在 1C2G 的最小环境下就能跑到每天 50GB。迁移窗口比预想的短。
第二阶段,增量追。 从那个位点往后读日志,把迁移期间的新变更同步过去。直到两边追平。这一步的延迟官方口径是亚秒级。实测下来报表侧基本无感知。
第三阶段,对账。 这一步最容易被省掉,也最不能省。业务不停机的情况下做数据比对,发现差异就订正。比对不是全表一行行扫,那样数据量上来根本不现实。通常是先比行数,再按主键分片算校验和。最后才对差异数据逐条修。KFS 把校验做进了同步链路,支持自动比对和修复。这一点在双轨并行阶段很关键。新老系统同时跑,谁也不敢保证一次就对。
这套组合有公开案例。西藏"智慧市场监管"项目,停机时间压到了分钟级。数据差异率低于 0.001%。弱网环境下靠压缩和断点续传,把延迟稳在 50ms 以内。另一个是金融核心系统去 OGG 的项目。日均增量到了 TB 级,同城双活、异地灾备演练都跑通了。这些数字来自金仓官网的公开材料,我照搬,不加工。
六、选数据库实时同步工具,先答五个问题
案例看完了,问题也就落回一个:到底选哪个。这句被问得太多了。我的回答永远是先答五个问题。答完,答案自己会浮出来。
- 要实时,还是能接受 T+1? 这一步先砍掉一半选项。要实时就走 CDC,能接受隔天就用跑批,别浪费资源。
- 源端有几种库,包不包括国产库? 先把源端数清楚,再去比对支持的清单。源端有 Oracle,Canal 这类单源工具直接排除。
- 要不要双向或容灾? 单向搬家和双活架构,要求完全不是一个量级。双向还要额外解决冲突和防循环。
- 谁来运维? 图形化管控台和纯脚本日志,对团队的要求差很多。人少就别选自建成本高的方案。
- 有没有信创要求? 要跑在国产芯片和操作系统上,选型范围立刻收窄。这也是国产厂商同步工具的位置所在。
七、数据库实时同步工具避坑清单
选型只是一半。工具定下来之后,真正难的都在落地。这些年我踩过的坑不少,也见过别人栽跟头。挑最要紧的三条,说给你听。
上线前别只压全量,增量链路才是每天都要跑的。全量跑通不代表链路可用。重点是掐断再恢复,看位点能不能接着上次续上。不重,也不漏。我见过有团队全量迁完就庆祝。结果上线第二天,发现增量漏了两小时的数据。
别信"应该没问题",一致性是比出来的。定期拿两端比一比,对不上就早发现早处理。真出事的时候,你手里有没有校验报告,决定了要不要加班通宵。
跨机房、跨地域的网络抖动是常态。这种场景里,压缩和断点续传,得当成必选项。没有断点续传的工具,一次抖动就得重来。这条我做异地灾备项目时,是排在第一位的验收项。
写在最后
数据库实时同步工具没有万能选项。先定实时性,再数源端,再看运维能力和信创要求。四步走完,选择范围自然就小了。回头再看开头那个场景。客户最后选的是国产厂商的同步工具,理由不复杂。源端有 Oracle 和 SQL Server,还要落国产库。前几类工具在信创环境里都容易卡壳。金仓的 KFS 在这类场景里比较对口。日志解析不改源库,全量加增量能并行,还带数据校验。迁移和双轨并行的窗口期,能省不少事。工具终究是工具,但选对了,半夜的电话能少一半。
你们在做数据库实时同步的时候,踩过最深的坑是哪个?评论区聊聊,说不定能帮到正在填坑的同行。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见 👋