一、背景介绍
随着业务不断迭代沉淀,系统日志、流水类表的数据量会快速膨胀,单表到达亿级规模已经成为很多企业会遇到的现实情况。就拿本文的sys_api_log接口日志表举例,整张表已经积累约1.03亿条记录。
如果直接使用默认配置或者传统单线程全量同步方案迁移这类超大表,很容易遇到各类棘手问题:同步耗时久、源库和目标库连接压力陡增,还经常出现查询超时、内存溢出,任务中途失败,需要反复重跑,极大影响数据交付效率。
本篇就以MySQL亿级sys_api_log表同步到Greenplum数仓作为实战场景,讲解如何依靠并发路由+分页读取两个核心配置,既提升海量数据迁移速度,又保障任务运行稳定性,同时也分享实际落地过程中的调优思路,方便大家在自己的项目里参考复用。
二、方案与流程设计
本次同步的核心思路是把海量的数据集做拆分处理,避免一次性加载全部数据造成系统压力。
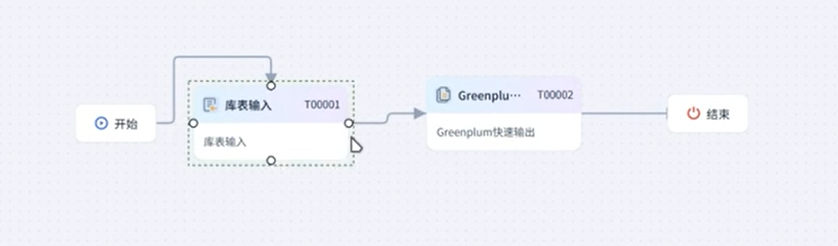
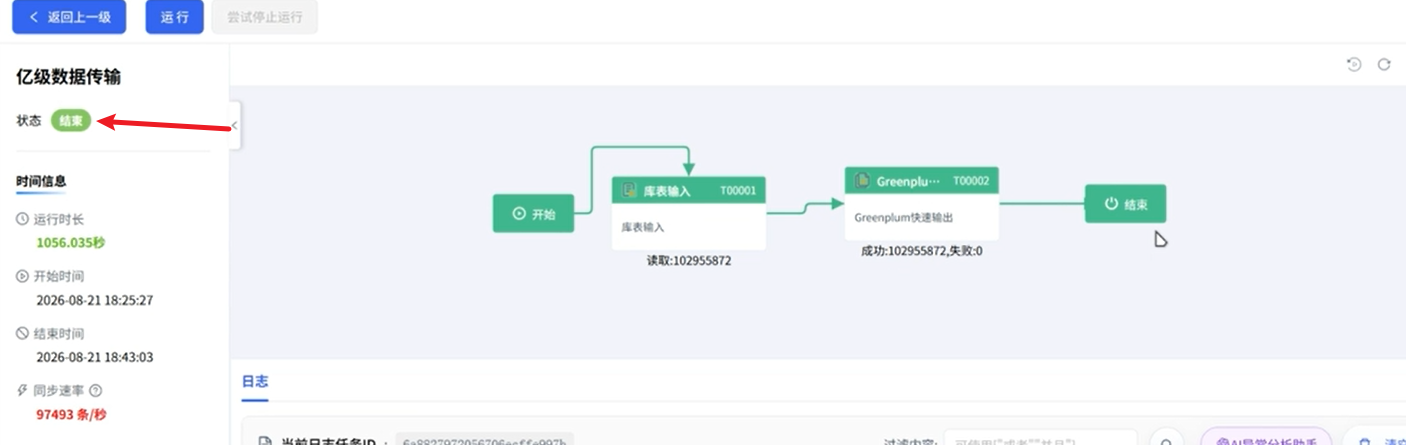
整体数据链路:「库表输入」组件负责从MySQL源库读取数据,数据流转到「路由」组件后开启多线程并发分发,最后交由「Greenplum快速输出」组件完成批量写入目标数据库。 简单来说,就是利用并发拆分提升整体吞吐,搭配分页拉取控制单次数据读取量,二者配合,解决亿级大表同步慢、容易崩溃的痛点。
三、同步前数据核对
正式同步前,先确认源端与目标端的数据规模,作为同步结果校验的基准。
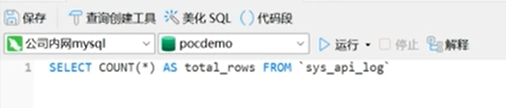
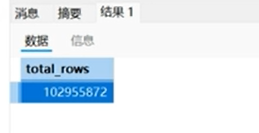
1.源端(MySQL)数据量
查询MySQL数据库sys_api_log表,总记录数为102,955,827条
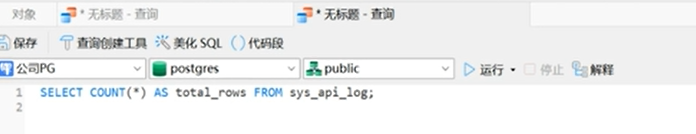
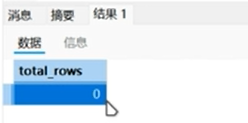
2.目标端(Greenplum)数据量
查询Greenplum数据库sys_api_log表,记录数为0条,确认目标表为空,可进行全量初始化同步
四、集成步骤实战
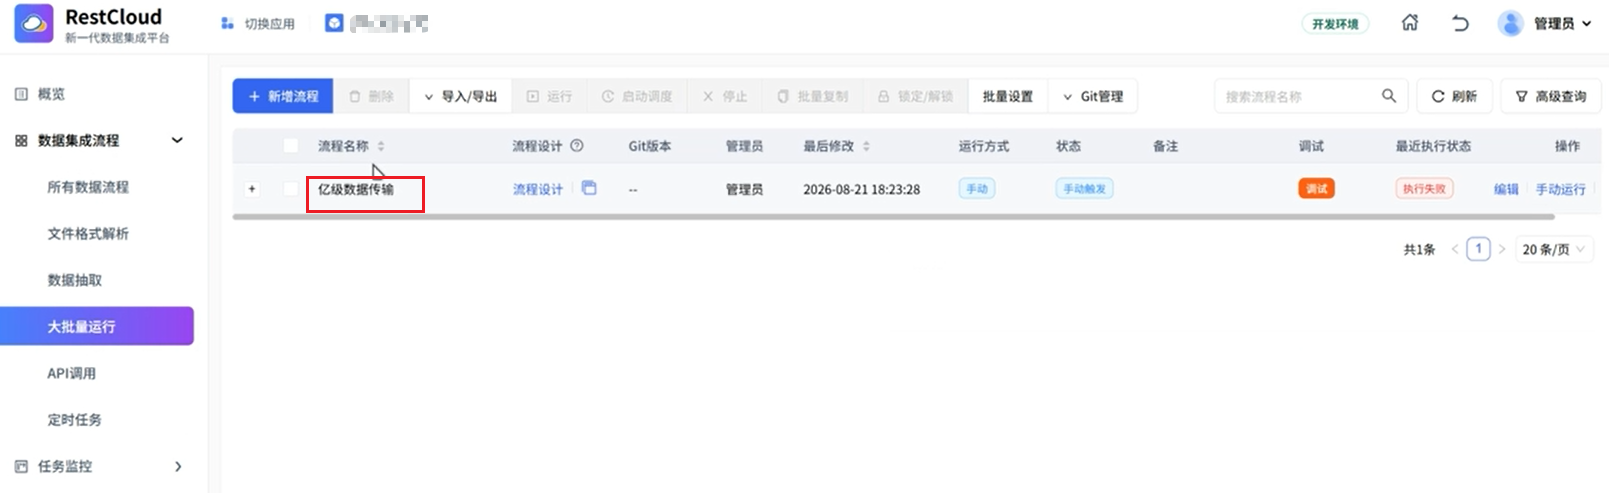
1.创建亿级数据传输流程
在ETLCloud中新建一条数据传输流程,作为本次亿级同步的载体
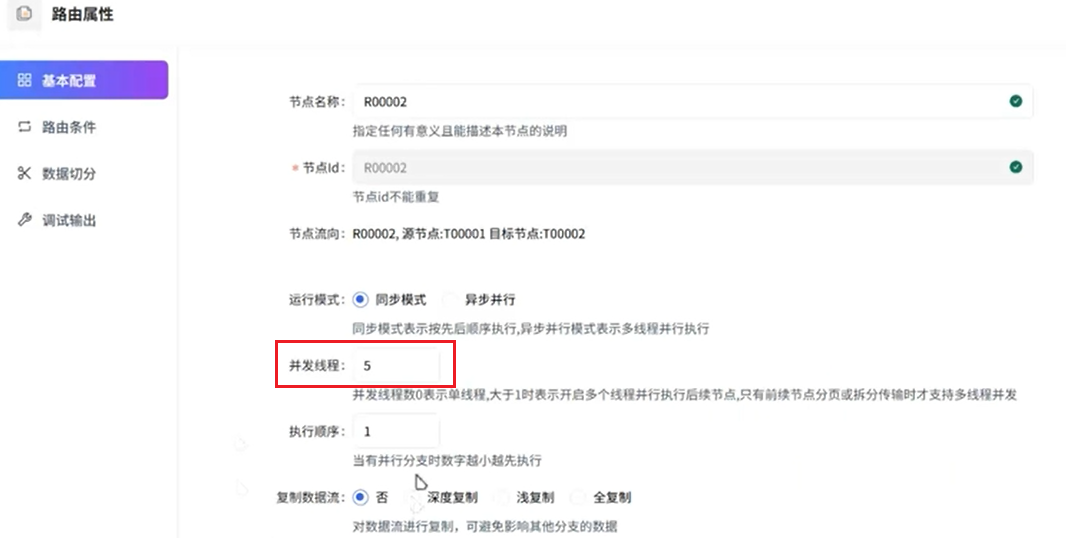
2.配置并发路由
设置R00002路由组件的并发数为5,使5个线程并行进行数据传输,充分压榨源端与目标端的吞吐能力,缩短整体同步时间
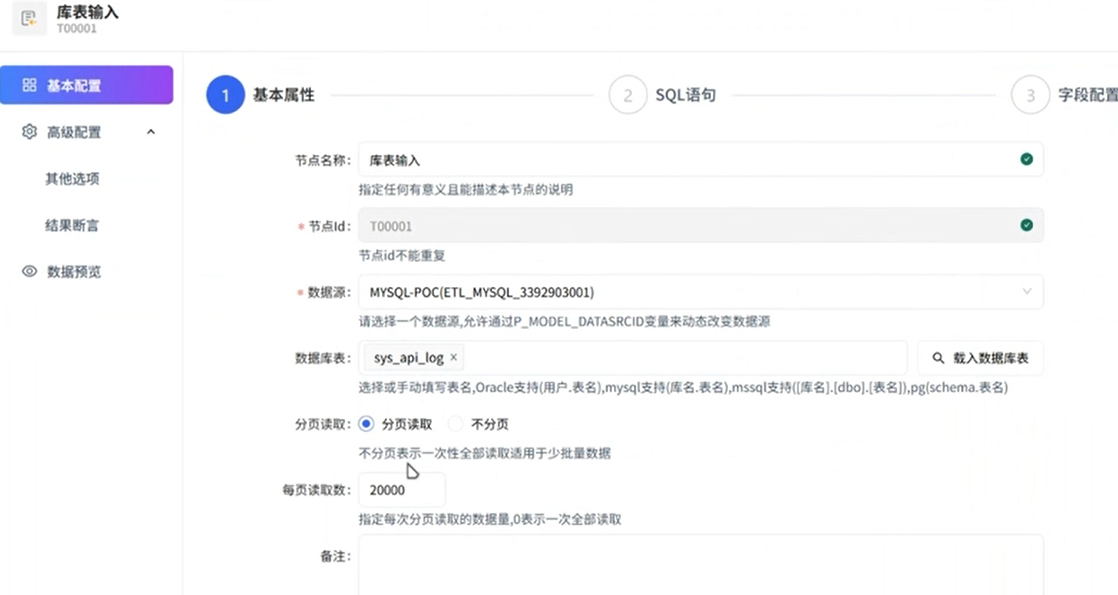
3.配置分页读取
对「库表输入」组件开启分页,每页读取20,000条。分页拉取可避免单次查询返回过大结果集导致的内存溢出与连接超时,是亿级读取稳定性的关键保障
4.运行流程与结果验证
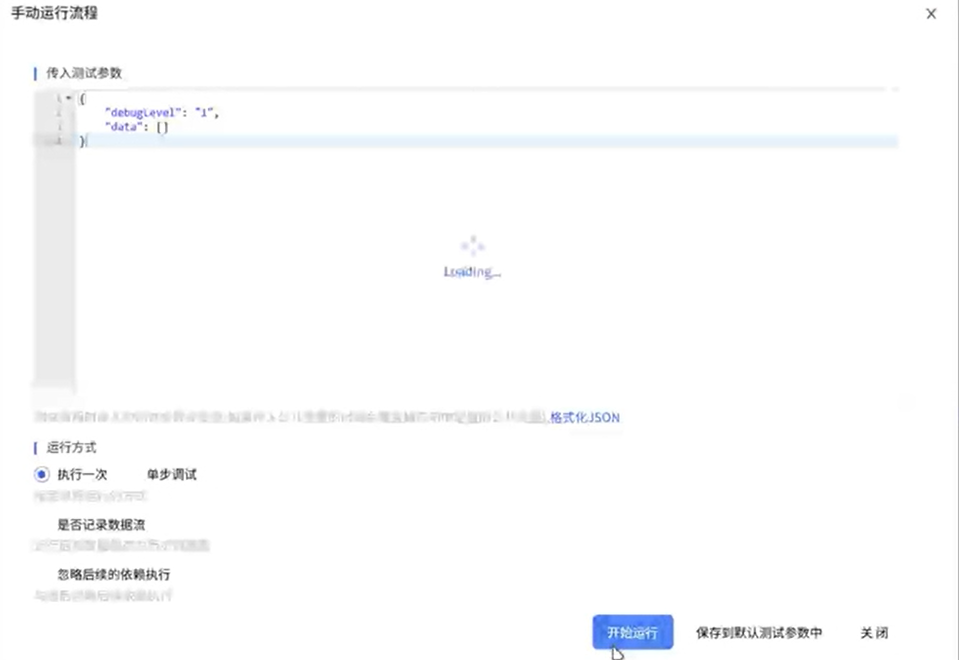
点击「运行流程」启动整条同步链路
流程运行成功后,Greenplum快速输出组件共插入102,955,827条数据,与源端记录数完全一致
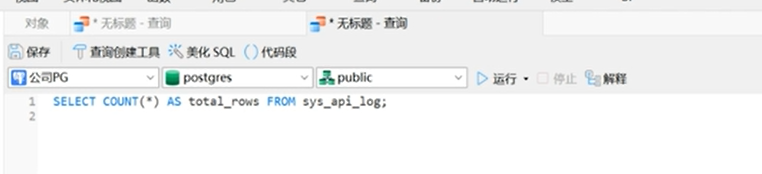
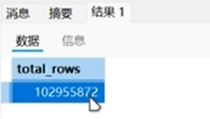
进一步查看目标库数据量,确认数据已成功同步,验证通过
五、关键参数与性能调优
本案例落地的两项核心参数如下,可作为同类亿级同步的调优基线(具体取值需结合源库/目标库承载能力与网络环境调整):
1.并发数=5(R00002路由):通过多线程并行传输提升吞吐量,但并发并非越大越好,需避免打满数据库连接池或CPU。
2.分页大小=20,000条/页(库表输入):平衡单次拉取内存占用与查询往返次数,是亿级读取稳定可控的关键。
六、结论
本次实战以约1.03亿条的MySQL日志大表同步Greenplum为例,完整走完了方案设计、前置数据核对、流程配置、任务执行、参数调优的完整实操流程。 通过并发路由(5线程)+分页读取(2万条/页)的组合策略,102955827条数据完整稳定完成迁移,任务全程没有发生内存溢出、连接超时,源端与目标端数据量完全一致。
在处理海量表同步时,并发拆分和分页读取是两个很重要的调优抓手:调高并发,目的是提升并行处理能力,缩短整体同步时长;分页读取,则用来约束单次处理的数据规模,守住任务稳定性。
依托ETLCloud低代码的特性,以上优化不需要编写大量复杂代码,配置组件参数即可快速落地,这套方案可以作为亿级表初始化全量同步、周期性批量同步的通用参考模板。