导读: Hologres 最初面向 OLAP 分析与在线 Serving,定位为一体化实时数仓引擎。随着多模态需求增加,全文检索与向量检索被纳入能力范围;到了 Agent 时代,它进一步延伸,成为 Agent 与模型所需的数据基础设施。如今的能力可以分为两层:第一层是全模态实时数仓引擎,面向结构化、半结构化与非结构化数据,覆盖 OLAP、KV、向量、全文、图、空间地理等查询与检索;第二层是 Agent 与模型基建,包括长记忆服务与可观测数据底座。
围绕这一定位,Hologres 的 AI 能力沿着三个方向展开:通过 Object Table、Dynamic Table 和 AI Function 处理多模态数据,借助 AI 助手降低数仓开发与运维门槛,再通过长记忆服务支持 Agent 的跨会话记忆。下文将依次展开这三条主线。
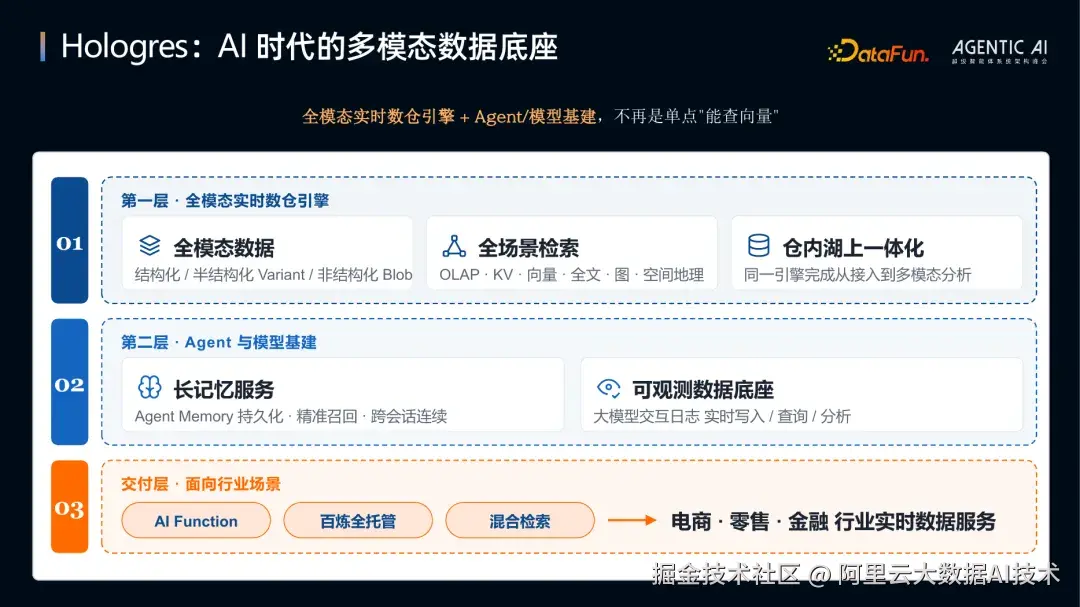
从实时数仓到 AI 数据底座:先把多模态数据放进同一套体系
要做多模态,第一步是支持读取不同模态的数据。Hologres 的做法是打通三类数据源:结构化和半结构化数据可以直接存放在 Hologres 内部,文本、向量、JSON 等面向检索的数据同样原生支持;MaxCompute、Paimon、Iceberg 等湖上或离线数仓中的数据,通过外部访问方式接入;图片、PDF、PPT、视频等存放在 OSS 上的非结构化数据,则通过 Object Table 与文件目录建立映射。原本分散在内部表、数据湖和对象存储中的数据,由此汇入同一条后续处理链路。
数据进来之后,加工和计算主要依托两个组件:AI Function 负责调用模型,完成解析、切片、Embedding、语音转文本、内容生成等 AI 加工;Dynamic Table 负责增量计算和数仓分层。例如 OSS 目录持续新增图片时,Dynamic Table 只处理新增部分,而不必反复执行全量计算。处理结果继续存入 Hologres,通过点查、OLAP、全文、向量和混合检索等方式对外提供服务。
AI Function:把多模态加工、模型调用和混合检索放进一条 SQL 链路
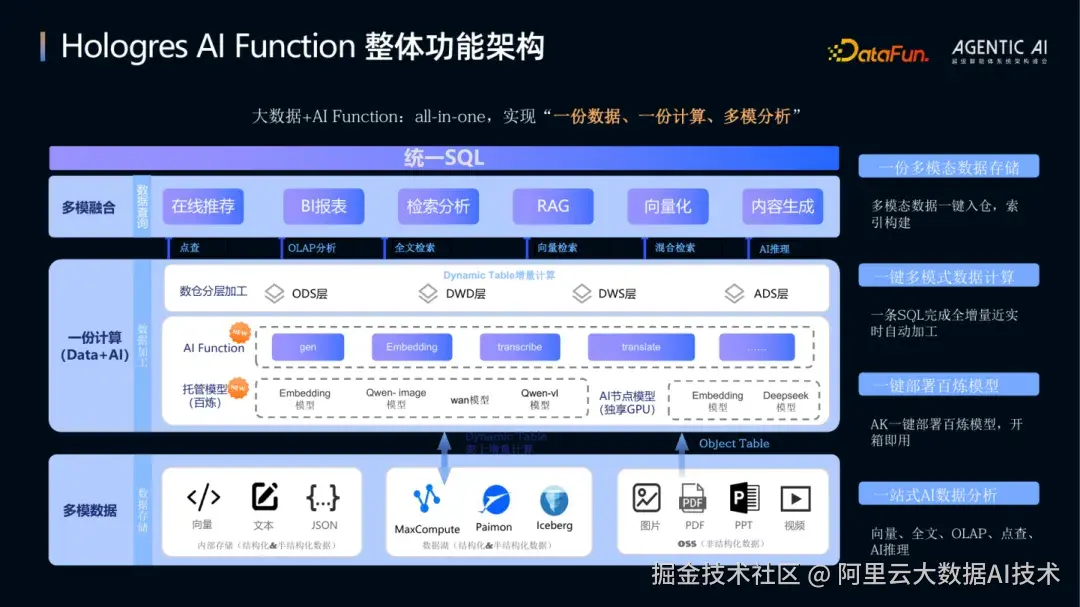
AI Function 的使用路径只有三步:购买 Hologres 模型资源、在控制台部署模型,再通过标准 SQL 调用。原本需要 Python、模型调用和多套数据链路共同完成的工作,如今直接收敛进 SQL 开发体系。使用成本则与场景强相关:文本分类、摘要等轻量场景日均约 10 万到 50 万 Token,语义检索、实时风控约 50 万到 200 万 Token,大规模向量化或复杂生成约 200 万到 1000 万 Token。
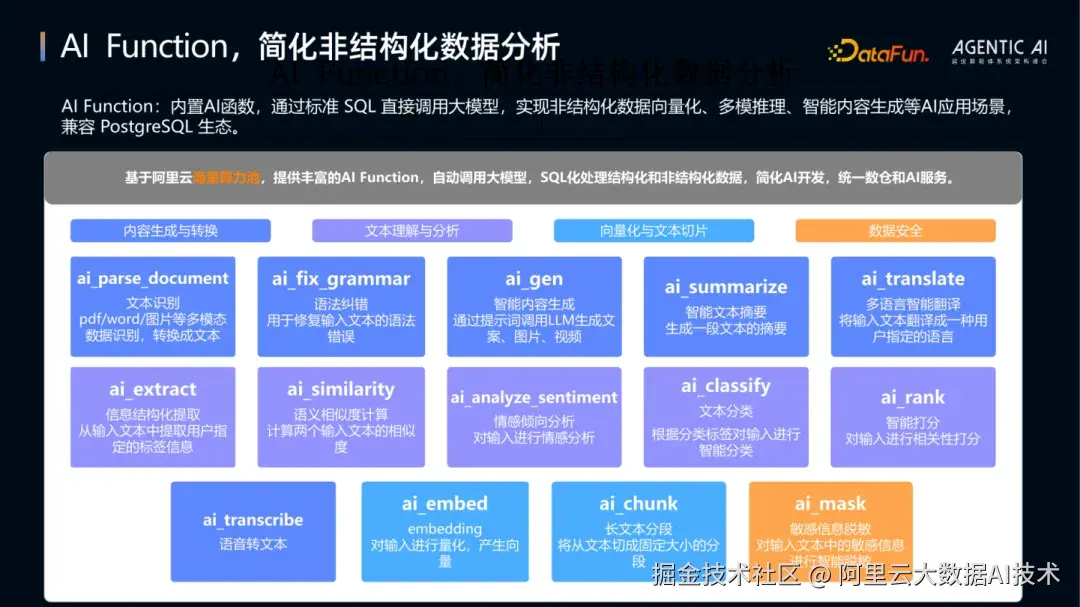
AI Function 将常见 AI 数据处理能力直接封装为 SQL 函数:ai_parse_document、ai_extract、ai_transcribe 负责文档解析、信息提取和语音转写;ai_fix_grammar、ai_similarity、ai_analyze_sentiment、ai_classify、ai_summarize、ai_translate、ai_rank 覆盖文本纠错、相似度、情感分析、分类、摘要、翻译和排序;ai_gen 用于内容生成,ai_embed、ai_chunk、ai_mask 分别完成向量化、文本切片和敏感信息脱敏。
由此,从文件解析、文本处理到 Embedding 和内容生成,都可以直接嵌入 SQL 开发流程,无需额外搭建独立的 AI 数据处理链路。
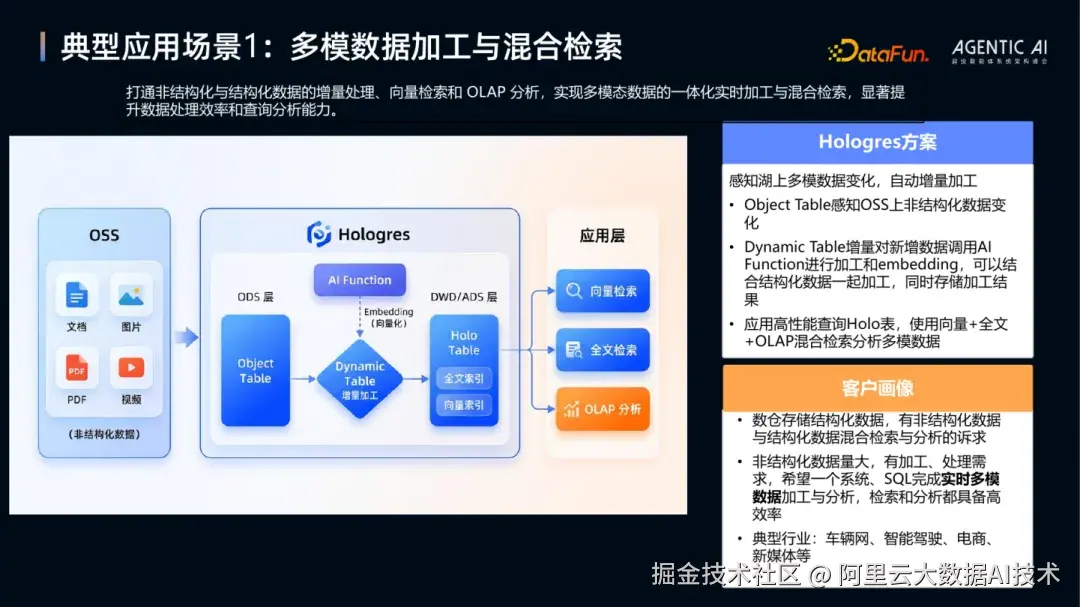
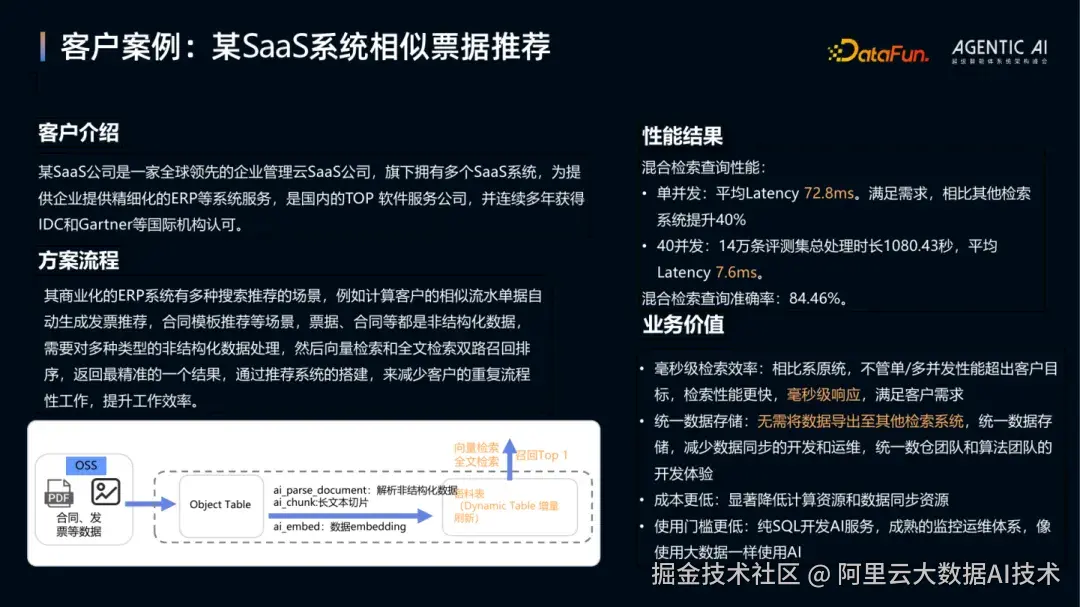
以图片检索为例:图片文件先存放在 OSS,模型部署完成后,通过 SQL 创建 Object Table 和 Dynamic Table,图片路径及转换后的向量被写入表中。下游既支持文搜图------输入"a red car in the rain"即可检索最接近的图片,也支持以图搜图。过去需要多个系统、多条数据链路才能完成的数据加工、索引构建与查询,如今统一在 SQL 体系中维护。 视频演示 >> 在某 SaaS 系统的相似票据推荐场景中,票据、合同等非结构化数据先由 ai_parse_document 解析,再经 ai_chunk 切片、ai_embed 生成向量,最终通过向量检索与全文检索双路召回排序,返回 Top 1。性能方面,混合检索单并发平均 Latency 为 72.8ms,相比其他检索系统提升 40%;40 并发下,14 万条评测集总处理时长 1080.43 秒,平均 Latency 仅 7.6ms,查询准确率达到 84.46%。更重要的是,数据不再需要导出到其他检索系统,省去了数据同步的开发与运维,数仓团队与算法团队得以在同一套数据体系中协作。
再看零售场景。某大型连锁便利店希望对货架、商品、顾客和门店等数据进行多模态检索与分析,其中一个典型需求是货物摆放智能识别:每家门店需要按照规定的货架模板陈列商品,系统通过比对门店货架点检照片与货架模板,识别错放、缺货等异常。
这背后同时涉及货架基础数据、货架模板数据、商品基础数据等结构化信息,以及货架图片、点检照片、模板模拟图、商品图片等非结构化数据。数据接入 Hologres 后,货架模板先完成结构化处理,图片经过存储和向量化,再结合 Qwen3-VL 进行多模态对比校验,最终生成差异数据清单。整个流程可以通过 SQL 完成两类数据的联合检索与分析,差异校验准确率超过 90%。对客户而言,这意味着原有数据平台不再只处理表数据,也开始承担多模态数仓的角色。
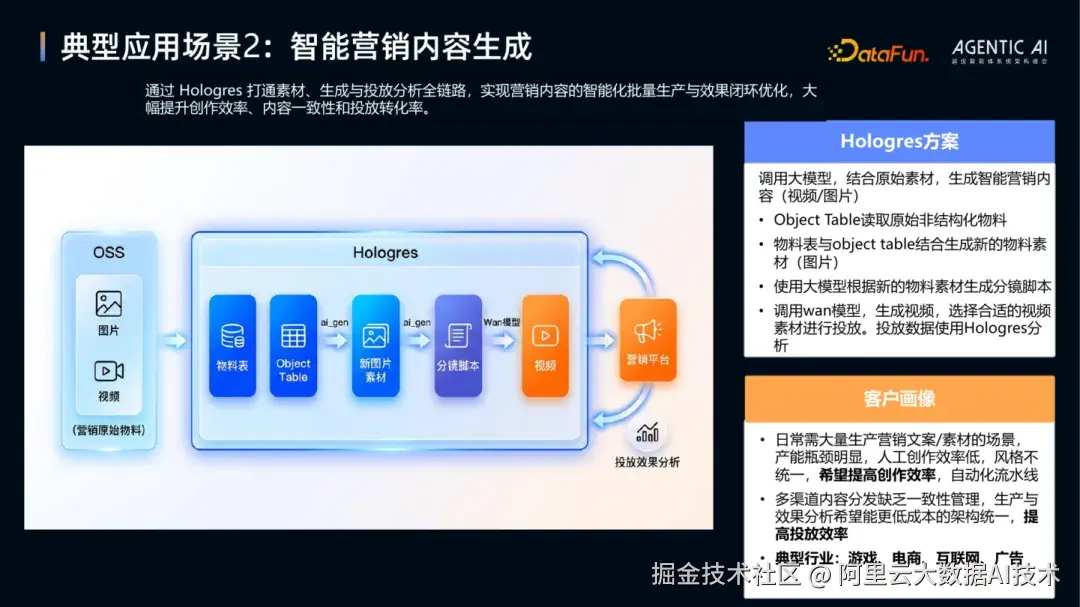
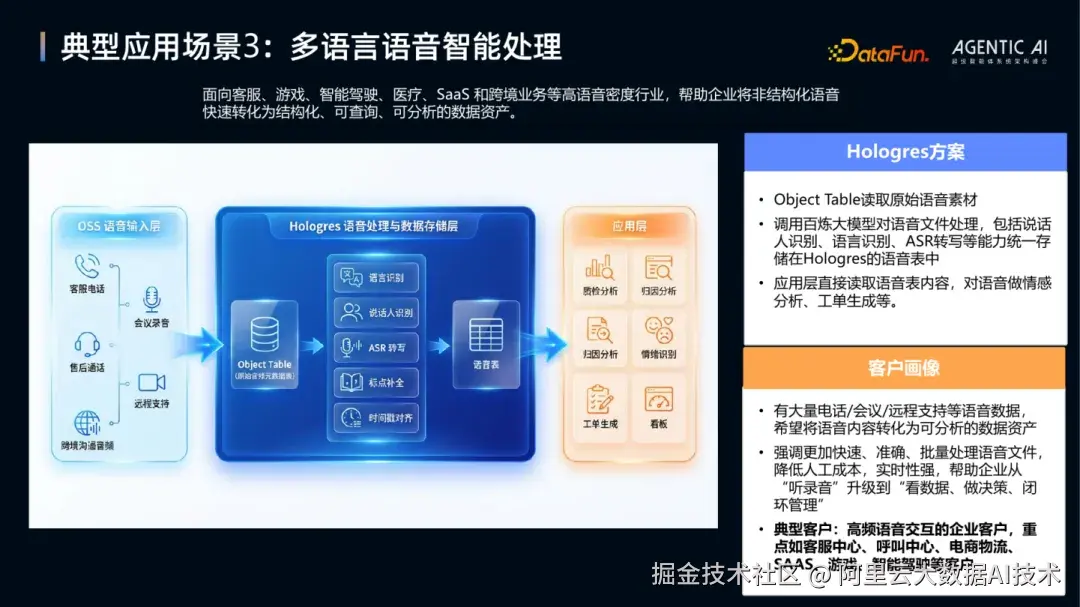
改造后,Object Table 读取原始素材,ai_gen 生成新物料和分镜脚本,再调用视频模型完成生成,人工核对后投放,效果数据回流分析。素材、生成和投放由此被串联起来,角色变体、分镜和视频等资产可实现秒级或分钟级产出,并支持批量生成。
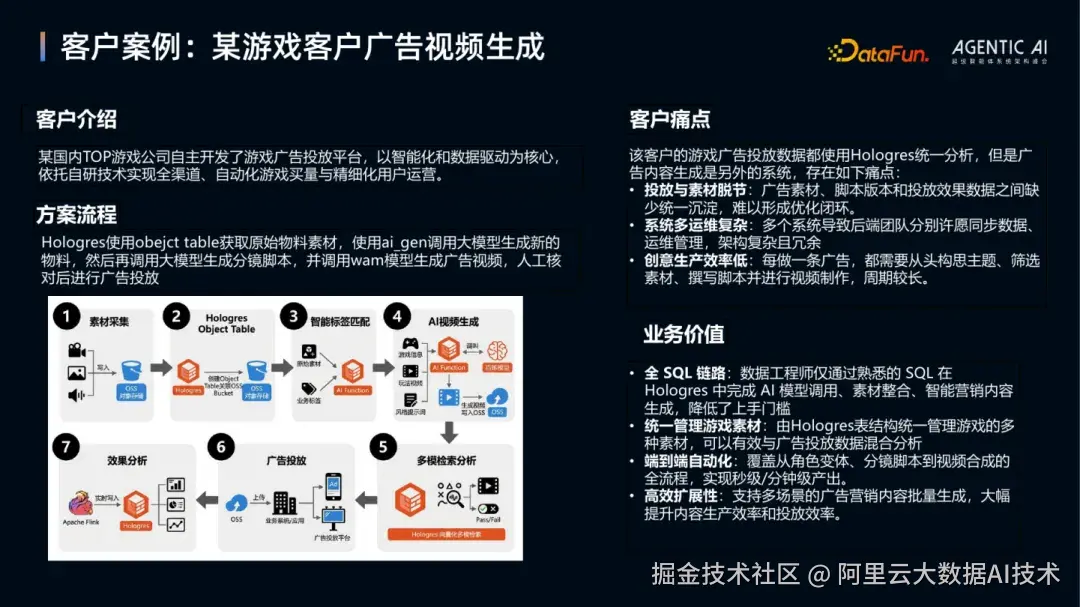
语音场景解决的是非结构化语音数据难以直接分析的问题。客服、游戏、智能驾驶、医疗、SaaS 和跨境业务等行业往往积累了大量电话、会议和远程支持录音,需要进一步转化为可检索的数据。
Hologres 通过 Object Table 读取 OSS 中的原始语音,调用百炼大模型完成说话人识别、语言识别和 ASR 转写,并将结果写入语音表,供应用层继续进行情感分析、工单生成等处理。原本需要人工听取和整理的录音,由此转化为可查询、可分析的数据资产。
AI 助手:把数仓经验封装成可执行 Skills,而不是只做问答
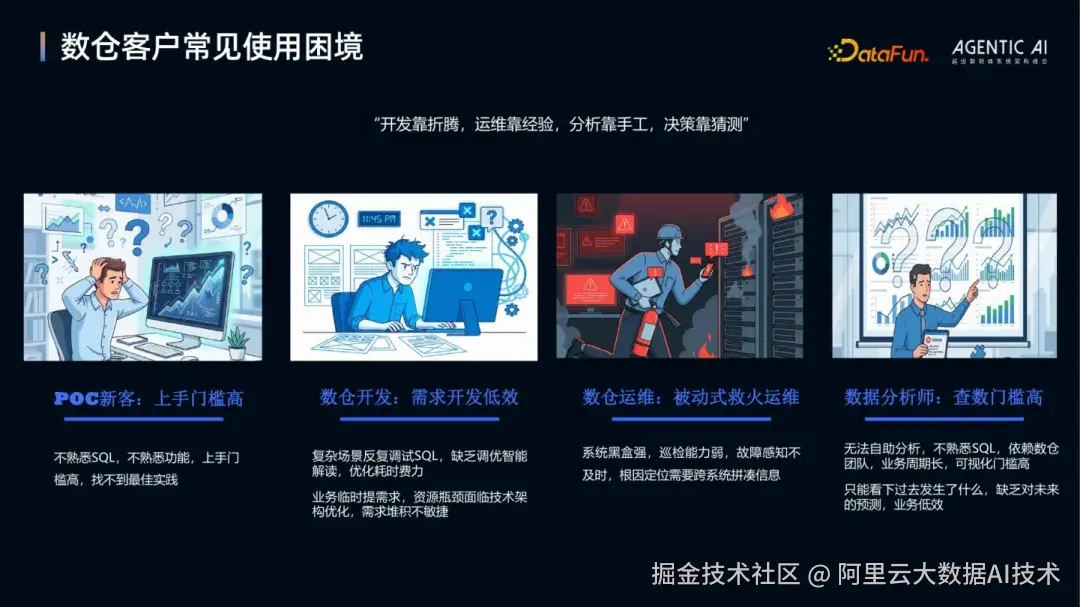
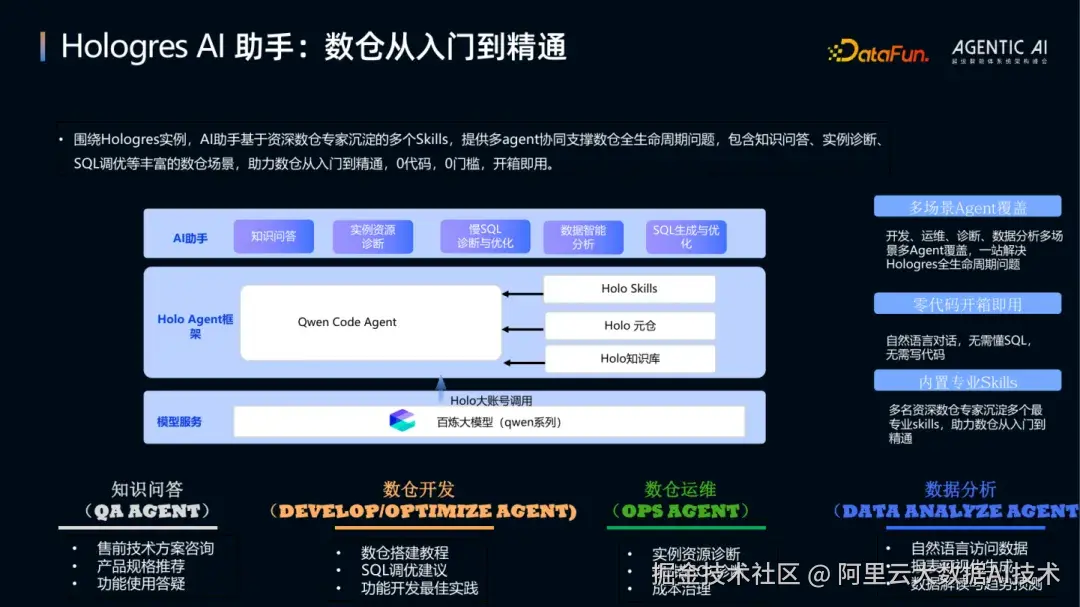
如果说 AI Function 是"Hologres for AI",AI 助手对应的就是"AI for Hologres"------它的目标是降低数仓上手、开发、运维和数据分析的门槛。围绕这些场景,系统提供知识问答、数仓开发、数仓运维等 Agent,并结合 Holo Skills、元仓和知识库完成不同任务。
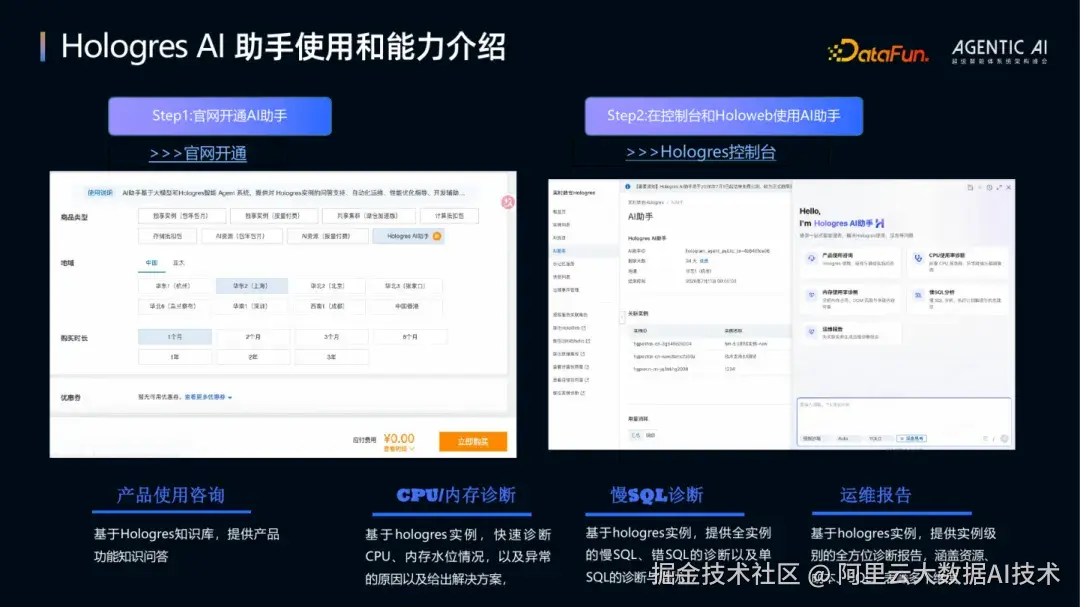
用户开通 AI 助手并关联目标实例后,就可以在控制台或 HoloWeb 中通过自然语言发起任务。以 CPU 诊断为例,只需选择实例和时间范围,模型会按照内置 Skill 逐步执行:采集数据、输出诊断报告,报告涵盖基础信息、实例健康状态判断和可执行建议。慢 Query 诊断遵循同样的思路------先采集所需数据,再结合沉淀的经验与 Skill 输出原因分析和调优方向。
除诊断外,能力还覆盖售前技术方案咨询、产品规格推荐、功能答疑、数仓搭建、SQL 生成与调优、成本治理、自然语言访问数据、报表可视化以及数据解读等任务。关键在于,这些诊断流程和数仓经验被组织成 Agent 可调用的步骤,而不是仅依赖通用问答。
至于能否进一步深入内部组件甚至源码定位问题:借助 AI 让问题排查更轻松是既定目标,但 Hologres 是闭源产品,源码级信息涉及安全问题,相关能力会逐步推进。AI 助手会在安全边界内,持续扩大数仓诊断的自动化范围。
长记忆服务:把 Agent 的交互过程变成可持续召回的数据
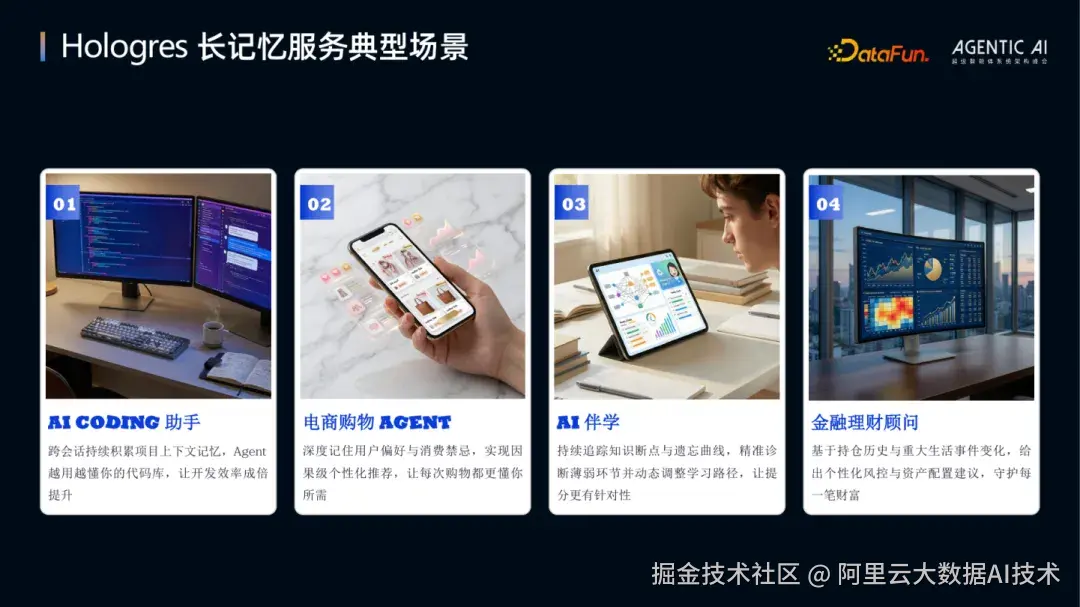
长记忆服务对应的是"Hologres for AI",它要解决两个问题:跨设备、跨会话的信息遗忘,以及企业内部经验难以共享。做法是把人与 Agent 交互中的有效信息抽取出来,持久化到可检索的数据层。典型应用包括电商购物 Agent、AI 伴学、金融理财顾问,以及企业内部的协同办公和 AI Coding。
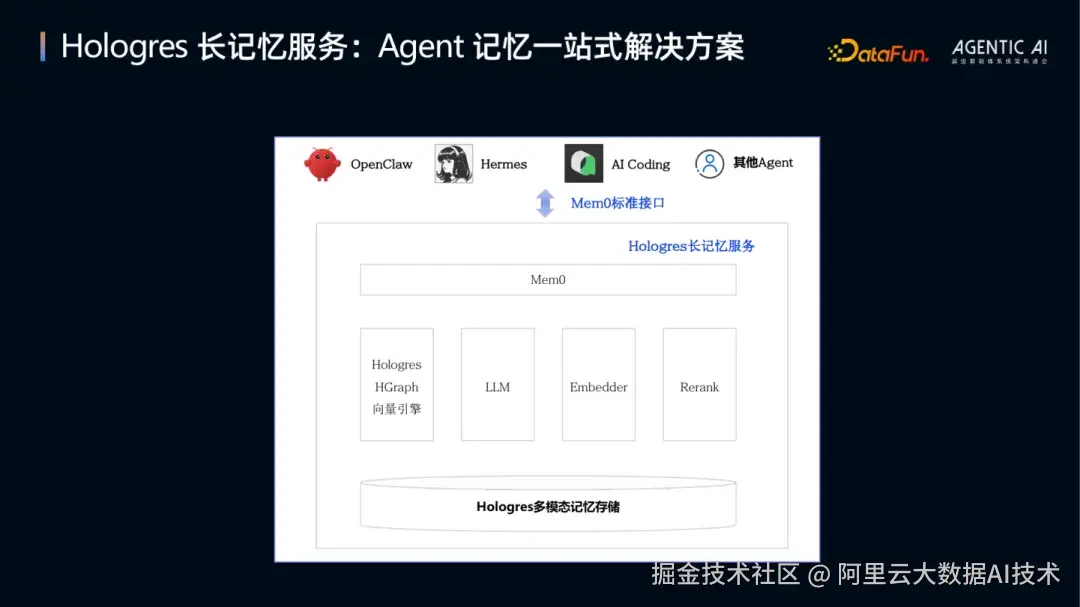
整条链路分为"抽取---存储---召回---注入"四步。人与模型交互产生的上下文,先由语言模型提取记忆要点,再通过 Embedding 模型转成向量;记忆文本与记忆向量一起写入 Hologres 的多模态记忆存储。之后的每次交互,当前问题都会先到记忆库中检索相关内容,再把召回的记忆注入本次模型调用,跨会话的信息由此重新回到当前任务。服务层通过 Mem0 标准接口对外提供能力,OpenClaw、Hermes、AI Coding 等 Agent 均可接入;整套方案还包含 LLM、Embedder、Rerank、Hologres HGraph/向量引擎等组件。
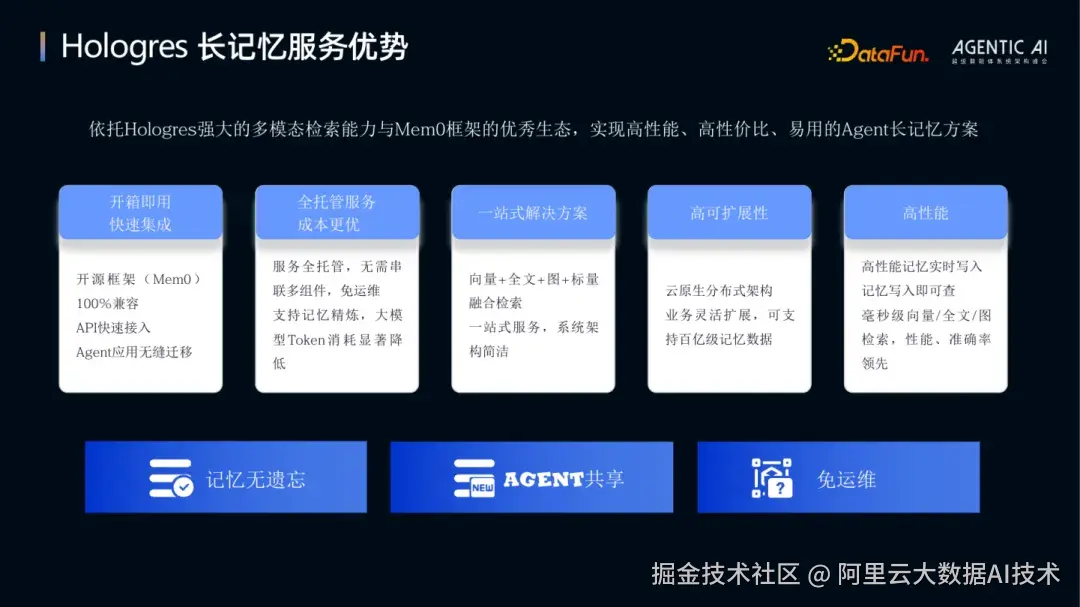
落到产品特性上,长记忆服务主打快速集成、全托管、一站式、高可扩展和高性能:兼容 Mem0 框架,通过 API 即可接入;服务全托管,免去多组件串联的运维负担;支持记忆精炼,以及向量、全文、图、标量融合检索;基于云原生分布式架构,可支撑百亿级记忆数据;记忆实时写入、写入即可查,向量、全文、图检索均为毫秒级。最终指向三个目标:记忆无遗忘、Agent 共享、免运维。
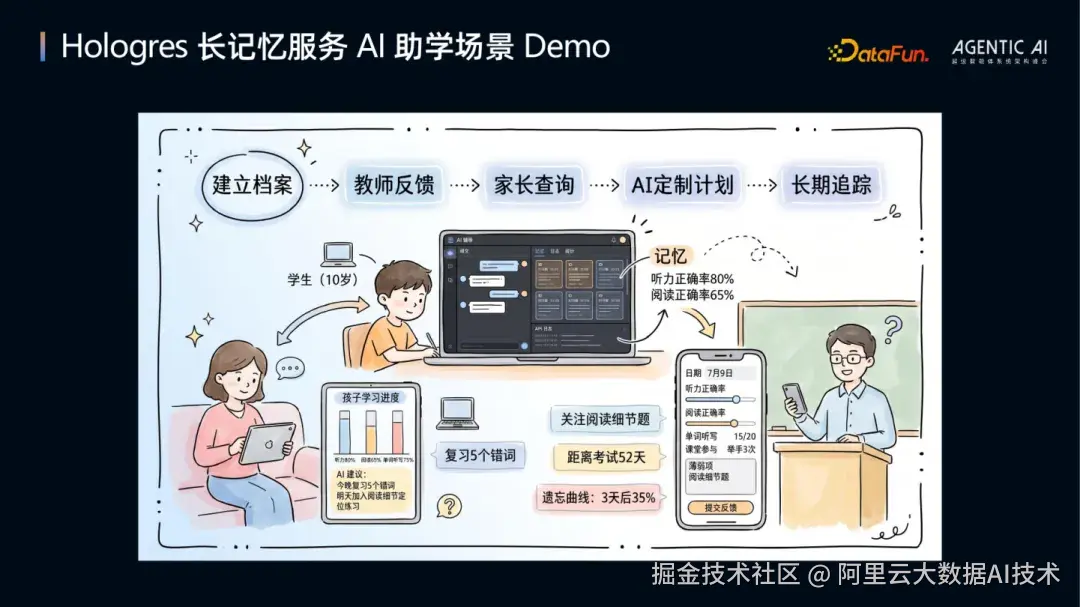
视频演示 >> 以 AI 助学场景为例,老师、学生和家长对应不同的记忆访问需求。家长录入学生的基础信息和学习目标,老师持续写入单词听写、随堂检测、家庭作业等阶段性反馈,这些信息实时沉淀为记忆。当家长再次询问近期学习状态时,模型结合历史记忆总结表现、给出后续行动,并基于同一批记忆制定学习计划。
企业内部的 AI Coding 遵循类似思路。过去,研发过程最终沉淀下来的主要是代码;而在 Agent 写代码的过程中,"为什么这样写、如何一步步写出来"会留在人与 Agent 的交互上下文里。将这部分记忆抽取并持久化后,研发过程本身也成为企业的重要资产。
再往外看,制造业等场景首先要解决的是数据采集与沉淀。以车联网为例:传感器信号、行车视频和图片等数据先被采集存储,之后才能用于模型训练、故障排查等任务。工业场景同理------先判断哪些数据有价值、用什么硬件采集,再把数据持续沉淀下来,AI 增强才有发挥的基础。
从多模态数据加工与检索,到 AI 助手,再到 Agent 长记忆,Hologres 面向 AI 的能力已经从数据处理一路延伸到数据使用和 Agent 运行。能力在延伸,底座没有变------底层始终是统一的数据存储、实时处理与检索,而上层正在承载越来越多面向 Agent 的场景。