Skills:可复用的 "专业能力包"
一、什么是 SKILL?
在深入具体的 SKILL 之前,这里还是啰嗦下 介绍SKILL 的本质。
本质理解
SKILL 不是代码库,不是插件,不是 API------它的本质是一套基于 Prompt 注入的动态上下文增强机制。
简单来说:SKILL = 一个结构化的指令包,告诉 AI "遇到某种场景时,应该怎么做"。
官方的定义是:一个文件夹。里面除了那份 SKILL.md,还可以放脚本、参考资料、数据文件、输出模板,Claude 能自己发现、探索和使用这些东西。
工作流程
当你安装一个 SKILL 后,实际发生的是:
-
启动扫描
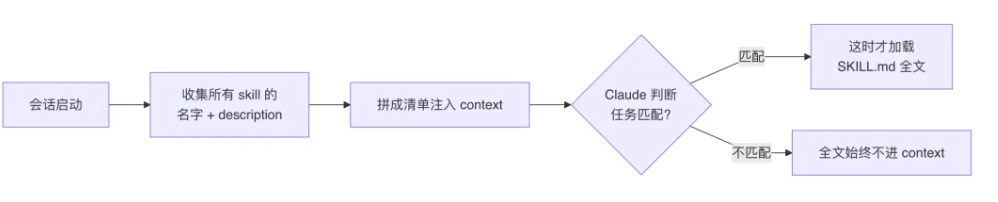
Claude Code 启动时,只读取所有 SKILL 的元数据(名称 + 简短描述),不加载完整内容
-
意图匹配
当你发出请求,Claude 判断是否需要调用某个 SKILL
-
按需注入
只有当 SKILL 被激活时,完整的 SKILL.md(可能是几百行指令)才会被注入到对话上下文
-
工具执行
SKILL 声明的工具权限被预先批准,自动执行
与 Rules 的区别
| 概念 | 职责 | 比喻 |
|---|---|---|
| Rules | 管约束------"不能做什么" | 做人的底线 |
| Skills | 管能力------"怎么做才好" | 做事的方法-2 |
二、SKILL 的文件格式
一个五脏俱全的 skill 长什么样? 典型的目录结构是这样的:
your-skill-name/
├── SKILL.md               # 唯一必需:何时用我 + 操作指引 + 坑点清单
├── references/            # 参考资料,正文放不下的细节放这里
│   ├── api.md             # 部署平台 API 的详细参数和示例
│   └── troubleshooting.md # 部署失败时的排查手册
├── scripts/               # 现成的可执行脚本
│   ├── smoke_test.sh      # 冒烟测试
│   └── rollback.sh        # 一键回滚
└── assets/                # 输出模板
    └── release_note.md    # 发布报告的固定格式
整个文件夹里只有 SKILL.md 是必需的:文件开头一段 frontmatter 写名字和 description,正文写操作指引。references/、scripts/、assets/ 都是可选的,连名字都不是强制的,按你的需要随便加。
一个最简单的 SKILL.md
---
name: your-skill-name
description: 简要描述该 Skill 的功能和触发场景
---
# Skill 名称
## 功能说明
详细的分步操作指导...
## 使用示例
具体应用场景...
## 约束条件
必须遵守的规则....claude/skills/git-commit/SKILL.md:
---
name: git-commit
description: 当用户要创建 git commit 时使用。
---
# Git Commit 规范
你要遵守 Conventional Commits 规范:
格式:`<type>(<scope>): <subject>`
type 必须是:feat/fix/docs/style/refactor/test/chore
工作流程:
1. 跑`git status`看改动
2. 跑`git diff`看具体内容
3. 决定 type 和 scope
4. 写一句不超过 72 字符的 subject
5. 跑`git add`和`git commit`
不要:
- 不要写"update code"这种废话 subject
- 不要在 subject 末尾加句号
它怎么被触发?
Claude 启动时把所有 SKILL.md 的 frontmatter(只取每个 skill 的名字和 description)加进上下文,拼成一张清单注入 context。Claude 平时看到的就只有这张「目录页」。等它判断某个任务匹配上了某个 skill,才会发起调用,这时候 SKILL.md 的全文才被加载进对话。
这套机制有个专门的名字,叫渐进式披露(Progressive Disclosure):平时只给目录,用到了才给正文。
重点:Skill 不是默认加载,是按需加载。所以你可以放几十个 skill 不浪费上下文。
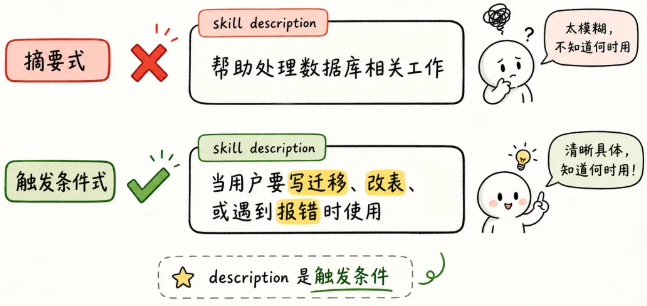
明白了这个机制,「为什么不触发」的答案就浮出来了:Claude 决定用不用你的 skill,唯一的依据就是那一行 description。
这就是官方在博客里专门强调的一条:description 不是写给人看的摘要,是写给模型看的触发条件。「帮助处理数据库相关工作」这种写法就是典型的人类视角摘要;模型视角的写法是「当用户要写数据库迁移、修改表结构、或者遇到 migration 报错时使用」。
官方观察下来,内部效果最好的那批 skill,恰恰都是把文件夹结构和配置项用足了的。只写一份 markdown 的 skill,相当于只用了这个机制十分之一的能力。
skill 是文件夹,不是文件。这是用好它的第一步。
Skill 的关键 frontmatter
---
name:唯一标识(kebab-case,且必须和所在目录同名)
description:触发条件(写给 Claude 看;最重要的字段)
allowed-tools:Read, Grep, Bash# 注意是连字符不是下划线
disable-model-invocation:false# true 表示只能/skill-name显式调用
context: fork   # 关键配置:让Skill在子Agent中运行。独立上下文减少token消耗
agent: Explore  # 指定子Agent的类型
---
字段名陷阱:官方字段名是 allowed-tools(kebab-case),不是 allowed_tools(snake_case)。值可以写成逗号分隔字符串("Read, Edit")或 YAML 列表。name 和 description 是仅有的两个必填字段,其他可省略。
如果只想被 Claude 自动判断时调用、不想暴露成 /xxx 命令,加 disable-model-invocation: true。
带支持文件的 Skill
skill 可以是个文件夹,包含示例、模板:
.claude/skills/api-handler/
├─ SKILL.md
├─ template.ts
└─ examples/
  ├─ good.ts
  └─ bad.ts
SKILL.md 里引用:
模板见 @template.ts,好例子见 @examples/good.tsSkill vs CLAUDE.md
| 维度 | CLAUDE.md | Skill |
| 加载 | 永远在上下文 | 按需加载 |
| 内容 | 通用约定 | 专业操作步骤 |
| 适合 | "全局规则" | "做某类事的标准流程" |
| 大小 | 控制在 200 行 | 可以很大,反正按需加 |
|---|
经验:把通用约定留在 CLAUDE.md,复杂的、有详细步骤的、可能很长的操作搬到 Skills。这是省 token 的核心打法。
在 Subagent 中预加载 Skill
# subagent frontmatter
skills: [git-commit,api-handler]
让该 subagent 启动时直接加载这些 skill,不用临时触发。
内置 Skills
Claude Code 自带一些常用 skill:写文档、做 PR、搜代码库等。/skills 查看。
三、安装 SKILL 的方法
方法一:使用 CLI 工具(推荐)
# 安装 CLI 工具
npm install -g claude-skills-cli
# 安装指定 SKILL 到 Claude Code
claude-skills install <skill-name> --client claude-code
例如:claude-skills install frontend-design --client claude-code
方法二:使用 npx(免安装)
npx claude-skills install <skill-name> --client claude-code方法三:手动 Git Clone
git clone <skill-repo-url>
mkdir -p ~/.claude/skills
cp -r skill-folder/* ~/.claude/skills/
验证安装
# 列出所有已安装的 SKILL
claude-skills list
Skill 的存放位置
Skills 可以放在不同位置,生效范围不一样-1:
| 存储位置 | 路径 | 适用范围 |
|---|---|---|
| 个人 | ~/.claude/skills/ ~/.agents/skills |
当前用户的所有项目 |
| 项目 | .claude/skills/ |
仅当前代码库 |
| 企业 | 企业托管路径 | 整个组织 |
如果同名,优先级是企业 > 个人 > 项目