Agent Memory / 强化学习 MemPO源码学习笔记 --- (2)--- 训练
0x00 概要
现有的基于强化学习的 Memory 管理方法往往缺乏一种有效机制针对 Memory 的更新内容进行引导优化,Memory 的内容难以保证质量。
MemPO(Self-Memory Policy Optimization)使模型对 Memory 进行自管理,并引入了基于有效信息含量的 Memory-level 的优势估计,引导 Memory 保留对解决任务更有效的信息,进而提升记忆有效性。
MemPO的独特切入点:让模型把记忆写在每轮开头(),形式上像"自我对话的草稿纸",既是记忆又是思考链的一部分。这样,变成可训练的策略变量,用RL信号端到端地教会模型"什么值得记、怎么记"。RL 直接端到端优化这一行为,无需额外的记忆模块。
MemPO 的信息如下:
- 论文标题:MemPO: Self-Memory Policy Optimization for Long-Horizon Agents
- 论文地址:arxiv.org/abs/2603.00...
- 代码地址:github.com/TheNewBeeKi...
- 模型和数据集地址:huggingface.co/collections...
0x01 原理
1.1 为什么MemPO必须用RL而不是SFT?
核心原因:没有"正确的记忆摘要"为 SFT 标注数据。而 RL 只需要 (input, target_answer) 就能训练,中间过程靠探索 + 奖励自动学习。这就是 RL 的核心优势。
1.1.1 SFT 的劣势
SFT需要(input,gold_output)对。input是问题,gold_output是标准答案,仅用于评分。
具体对应:
scss
Parquet数据字段:
    prompt/raw_chat        → input(问题)
    target  gold_output    → (标准答案,仅用于评分)
例如:
css
input:"Who directed the film that won Best Picture in 2010?"
target:["Kathryn Bigelow","Bigelow"]                    ← 所有合法别名
但注意:SFT的(input,gold_output)中的"output"不仅仅是最终答案,而是整个多轮轨迹,即SFT需要的gold_output(完整轨迹标注):
xml
<mem>之前的搜索表明...</mem>
<think>我需要先找2010年最佳影片...</think>
<search>2010 Best Picture Oscar winner</search>
<tool_response>The Hurt Locker won...</tool_response>
<mem>2010最佳影片是The Hurt Locker...</mem>
<think>现在需要找导演...</think>
<search>The Hurt Locker director</search>
<tool_response>Directed by Kathryn Bigelow...</tool_response>
<mem>Kathryn Bigelow导演了The Hurt Locker...</mem>
<think>答案是Kathryn Bigelow</think>
<answer>Kathryn Bigelow</answer>
这整个东西都需要人标注一特别是的内容,无法自动生成,即:
xml
<think>内容:没有标准答案,每个人推理方式不同
<search>query:没有标准答案,什么query能搜到什么?取决于RAG系统
<mem>摘要:完全没有标注!
  什么是"好的"记忆摘要?取决于:
   1.未来会遇到什么工具结果
   2.最终问题需要什么信息
   3.模型自身的理解能力
   → 这是一个credit assignment问题,无法预先标注
因此,我们得到 SFT 的问题如下:
-
SFT学的是死板的query模板,不会适应。
-
该写什么? 假设 SFT 标注:"The director is Nolan"。
但如果下一轮要搜索演员信息呢?mem应该保留更多内容
→ 好的mem取决于未来需求,SFT无法预见。
-
无法适应多跳问题(Hotpot QA):第1轮搜什么 → 取决于第2轮需要什么 → 取决于最终答案
→ 典型的延迟奖励 + 多步决策
→ RL的核心场景
1.1.2 RL解决方式
下表给出了三个层面的不可SFT性,以及 RL 如何解决。
| 能力 | SFT困难点 | RL解决方式 |
|---|---|---|
| 记忆摘要 | 没有ground truth,"好"是相对于任务结果的 | mem_reward自动发现什么摘要能帮助答题 |
| 多轮策略 | 第2轮搜什么取决于第1轮结果,组合爆炸 | rollout探索 → 奖励反馈 → 策略优化 |
| 工具使用 | 搜索query的好坏取决于RAG系统的实际返回 | 在线交互 + outcome reward 自动调整 |
1.1.3 MemPO的实际路径
实际上MemPO 先做了SFT:
Stage 1:SFT
→ 学会基本格式(,,
,) → 学会遵循指令和使用工具
Stage 2:RL
→ 学会写"有效的"(而不仅是格式正确的) → 学会更好的搜索策略 → 学会根据上下文调整行为
1.1.4 小结
SFT提供"格式和基本能力",RL优化"策略质量"。
SFT教会模型基本格式(,,
,标签结构)和工具使用能力。
没有 SFT基础,模型连格式都无法遵守,RL的validate_format会导致所有轨迹reward=0,无法学到任何东西。
RL教策略质量。特别是的内容质量 → 这是一个只有通过与环境交互、接收延迟反馈才能优化的能力。
1.2 RL 方案的通俗解释
RL训练让16个侦探同时解同一道题,用他们的成绩互相比较,奖励表现好的走法、惩罚表现差的走法,重复几百轮,侦探自然就学会怎么写好小纸条、怎么高效搜索、怎么最终答对。
把训练想象成"游戏闯关+积分排名" 。
1.2.1 第1步:出题(准备数据)
老师(系统)准备了一堆难题,比如:
- "特朗普的祖父出生地和他的总统任期是多少年?"
- "杨振宁获奖时所在大学的校长是谁?"
这些都是需要多步查资料才能答对的问题。
1.2.2 第2步:让侦探们自由发挥(Rollout)
对于同一道题,同时派出16个侦探(rollout.n=16)去独立解题。每个侦探都会:
xml
1.写小纸条<mem>
2.去搜索 <search>
3.看结果,再写小纸条,再搜索
4.最终给出答案<answer>
16个侦探各自发挥,有的用了3步,有的用了7步,有的答对了,有的答错了。
1.2.3 第3步:打分(Reward)
- 答案正确+格式规范→得1分(或2分,多答案题)
- 答案错误或格式乱→得分
格式规范的要求(validate_format):
- 每轮必须有和
- 必须配对 <tool_response>
- 最终必须有
1.2.4 第4步:算谁表现好(GRPO优势计算)
关键:不是跟标准答案比,而是跟自己的"同伴"比!
- 16个侦探的得分:1,0,1,1,0,1,0,1,1,0,1,0,1
- 平均分=0.625
- 优势分=自己的分 - 平均分
- 答对的侦探:+0.375(高于平均,值得鼓励)
- 答错的侦探:-0.625(低于平均,要惩罚)
这就是GRPO组内相对排名。
1.2.5 第5步:更新大脑(Policy Update)
根据优势分,调整模型参数:
- 答对侦探走过的每一步(包括写的小纸条)→概率提高
- 答错侦探走过的每一步→概率降低
还有一个KL约束(kl_coef=0.001):别改太猛!不然侦探会"走火入魔",忘记之前学过的所有东西。
1.2.6 第6步:反复循环200轮
- 第1轮:侦探基本不会写小纸条,乱写一通,得分很低
- 第20轮:开始学会记关键实体名称
- 第100轮:能精准压缩多步推理结果
- 第200轮:高质量的+准确的搜索策略=高分
1.3 协同优化
我们来看看 P_mem-P_full 和 EM 奖励在数学上如何协同优化?
1.3.1 两个信号的数学定义
EM信号(outcome_adv):
scss
r_i = EM(response_i,ground_truth) E {0,1}

μ = mean({r_1,.,r_16})
σ = std({r_1,...,r_16})

outcome_adv_i = (r_i-μ) / σ
记忆信号(mem_adv):
ini
P_full_it = exp(mean(logp(gt|full_context_t)))         ←   有完整历史的条件概率
P_mem_it = exp(mean(logp(gt| sys+question+<mem>_t)))   ←   仅靠<mem>的条件概率

mem_reward_it = P_mem_it - P_full_it

u_mem = mean(全部轨迹全部轮次的mem_reward)
σ_mem = std(...)

mem_adv_it = (mem_reward_it - μ_mem) / σ_mem
1.3.2 能力分工
两个信号的本质区别如下:
sql
+----------------------------------+-----------------------------------+
| 问题                              | 由谁回答                           |
+----------------------------------+-----------------------------------+
| "这条轨迹整体表现好不好?"           | Global Trajectory Advantage       |
+----------------------------------+-----------------------------------+
| "这轮写的 <mem> 信息够不够用?"      | Informative Memory Advantage      |
+----------------------------------+-----------------------------------+
两个信号优化的"能力分工":
- EM信号负责:"搜什么查询词 如何提取答案 推理结构是否正确" → 作用于全部 response token
- mem信号负责:"把哪些信息写进" "写多少历史细节 "记忆是否足以替代完整上下文" → 仅作用于...
类比:
- EM 是班级总排名奖励(你答对了)
- mem_adv 是每份作业的单独批改(这道题做得好/差)。
两者叠加,既有整体激励,又有精细指导。
1.3.3 token级别的双重优势叠加
两种优势联合作用的哲学:一个轨迹好不好(结果),和这一步的记忆好不好(过程),是两个独立但相关的维度,应当分别给予梯度信号。叠加后的梯度目标如下:
css
∇θ L = ∑_i ∑_t final_adv_{i,t} × ∇θ log π_θ(token_{i,t})

其中:
final_adv_{i,t} = outcome_adv_i+ mem_adv_{i,round(t)} (t ∈ <mem>区间)
final_adv_{i,t} = outcome_adv_i                       (t ∉ <mem>区间)
具体轨迹如下。
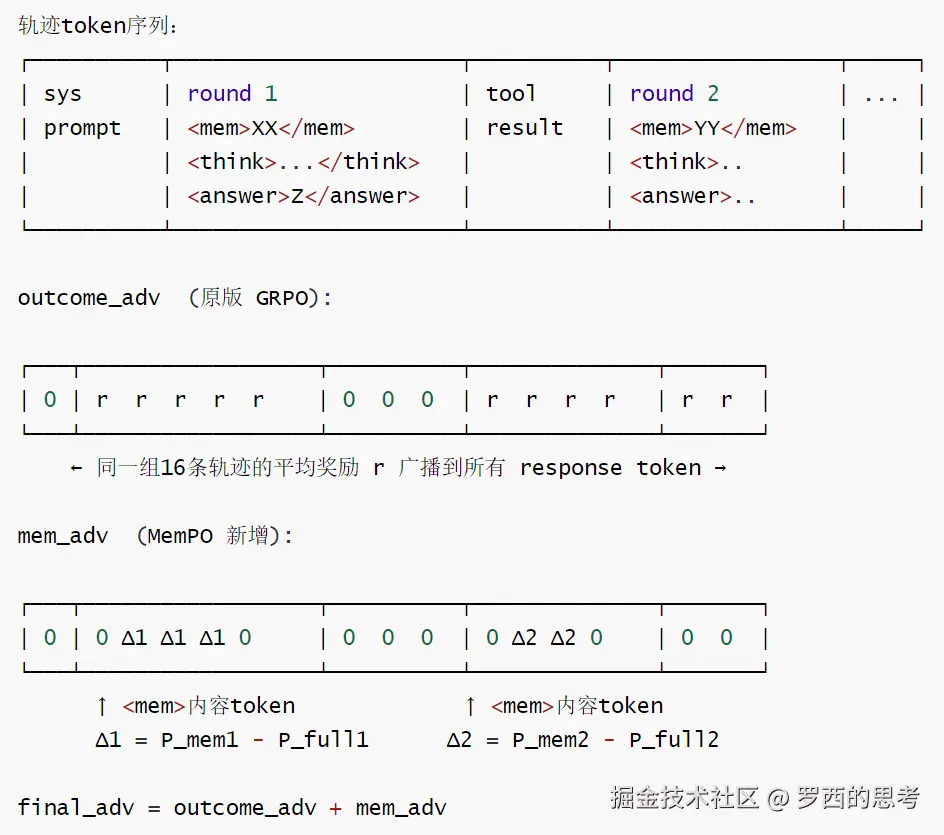
2-具体轨迹
以下图例展示了两种优势如何叠加。
ini
========================================================================
    一条 3 轮轨迹, 最终答对 (score=1):

Token 序列:
[轮次1: <mem> 已知:爱因斯坦生于乌尔姆 </mem> ... <search>市长</search>]
[轮次2: <mem> 市长张三。答案就绪。 </mem> ... 乌尔姆;张三]
------------------------------------------------------------------------

========================================================================
    Global Trajectory Advantage (GRPO 整体):

→ 这道题 16 条轨迹的得分均值 = 0.6
→ 本条轨迹得分 = 1
→ 整体优势 = (1 - 0.6) / std ≈ +0.8

所有 token: [ +0.8 +0.8 ... +0.8 +0.8 ... +0.8 +0.8 ... +0.8 +0.8 ... ]
              ← 均匀分布, 每个 token 获得相同正梯度 →
------------------------------------------------------------------------

========================================================================
    Informative Memory Advantage (记忆专属):

轮次1 <mem>: P_mem=0.12, P_full=0.35 → prob_bias = -0.23 (记忆不完整, 信息不够用)
轮次2 <mem>: P_mem=0.73, P_full=0.68 → prob_bias = +0.05 (记忆信息充分, 还比全文更精炼)

这道题所有轨迹的 prob_bias 均值 = -0.01, std = 0.18
轮次1 记忆优势 = (-0.23 - (-0.01)) / 0.18 ≈ -1.22
轮次2 记忆优势 = (+0.05 - (-0.01)) / 0.18 ≈ +0.33

轮次1 <mem> token: [ -1.22 -1.22 ... -1.22  0   0 ...  0   0 ...  0   0 ...  0   0 ... ]
轮次2 <mem> token: [  0 0 ... 0    +0.33 +0.33...+0.33 0 ...  0   0 ...  0   0 ... ]
                    ←(全0)→        ←第1轮mem范围→       ←------全0------→  ←第2轮mem范围→←------全0------→
------------------------------------------------------------------------

========================================================================
     最终叠加优势 = 整体 + 记忆:

轮次1 <mem>:    +0.8 + (-1.22) = -0.42  ← 虽然轨迹答对,但这段记忆被惩罚
轮次1 其他:      +0.8 + 0       = +0.8
轮次2 <mem>:    +0.8 + 0.33    = +1.13  ← 奖励叠加,强化好记忆
轮次2 其他:      +0.8 + 0       = +0.8
------------------------------------------------------------------------
1.3.4 与模型的 Think与、Action 进行联合优化
MemPO 将Memory 变成了可训练的策略变量,与模型的 Think与Action 进行联合优化。
MemPO中的内容完全由模型自由生成,没有任何规则模板或外部记忆模块约束。模型权重决定了"写什么"、"怎么压缩",因此Memory 确实是策略(policy)输出的一部分,是可训练的。
Memory 与模型的 Think与Action 三者都在同一次 forward pass 中生成,共享同一套参数,梯度联合回传。
更精确的表述
"MemPO将Memory变成了策略的输出变量,与Think、Action在同一次前向传播中联合生成,共享模型参数;在优化阶段,Memory 额外接受一个基于"记忆信息充分性"的专属奖励信号(P_mem - P_full),使其在GRPO框架下受到比推理和行动更强的定向优化压力,从而端到端地学习高质量的信息压缩行为。
完整输出
一个assistant轮次的完整输出:
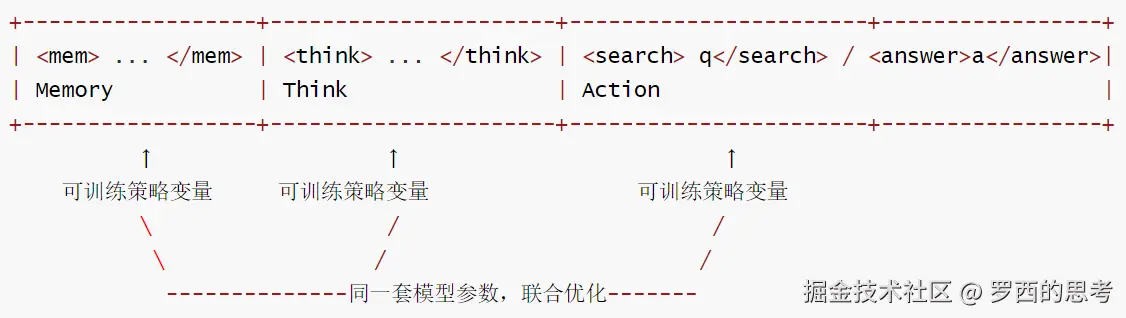
2-完整输出
!三者的梯度信号来源不同
多个梯度
sql
+-----------------+---------------------------------------------------------+
| 部分            | 梯度来源                                                  |
+----------------+----------------------------------------------------------+
| <think>        | 仅来自 GRPO 整体优势(答对/答错)                              |
| / <search> /   |                                                          |
| / <answer>     |                                                          |
+----------------+----------------------------------------------------------+
| <mem>          | GRPO 整体优势 + 记忆专属优势 (双重信号)                       |
+----------------+----------------------------------------------------------+
即
scss
<mem> token 的梯度 = GRPO_advantage + mem_advantage
                     (答对奖励)       (记忆质量奖励: P_mem - P_full)

<think>/<action> token 的梯度 = GRPO_advantage
                               (答对奖励, 没有额外记忆信号)
奖励信号
所以不只是"被联合优化",而是被额外施加了一套专门设计的奖励信号,使其受到比/ 更强的定向优化压力。
另一个细节:第1轮的不参与记忆奖励。这是因为,第1轮的只接受GRPO整体优势,没有记忆专属奖励(因为没有"上一轮完整上下文"作为对比基准)。
ini
# 第1轮特殊处理:
if mem_rewards_idx_tag == 1 and mem_last_round_ids == []:
    mem_rewards_idx_list += [0, 0, ..., 0]    # 全部标记为 0
1.3.5 Outcome路径梯度
Outcome路径本身没有前向传播---它只产出一个标量分数。梯度来自PPO更新阶段。
梯度来源机制
Outcome路径产出:em_check → score ∈ {0,1} → GRPO归一化 → outcome_adv (标量,广播到全序列)
这个 advantage不参与计算图,它是一个 detached 的常数系数。
梯度在PPO更新步骤(有前向传播)中产生:
ini
old_log_prob = actor.compute_log_prob(gen_batch)       ← 旧策略前向 (detached)
ref_log_prob = ref_model.compute_log_prob(gen_batch)   ← 参考模型前向 (detached)

# 多个 mini-batch epoch:
    new_log_prob = actor.compute_log_prob(mini_batch)  ← 当前策略前向 ✔ 有梯度
    ratio = exp(new_log_prob - old_log_prob)           ← importance sampling
    loss = -mean( final_adv × clip(ratio, 1-ε, 1+ε) × response_mask )
                     ↑ 常数系数        ↑ 这里有梯度
    loss.backward()                               ← 梯度流经 ratio → new_log_prob → 模型参数
核心理解
outcome_adv 的角色:不是梯度来源,而是梯度的 "方向和强度"
- 答对 (adv > 0): loss为负 → 反向传播 → 增大这些token的生成概率
- 答错 (adv < 0): loss为正 → 反向传播 → 减小这些token的生成概率
本质是 REINFORCE 算法:
perl
∇J ≈ advantage × ∇log π(action|state)
                    ↑ 这才是模型前向产生的
所以整个流程是:
- Rollout:生成轨迹(前向,但不保留计算图)
- 评分:em_check→标量reward→advantage(纯数值计算,无梯度)
- PPO更新:重新前向计算log_prob→用advantage加权→反向传播更新参数
1.3.6 协同机制的四个场景
场景一:答对 + 写得好
xml
outcome_adv > 0     mem_adv > 0
→ <mem>token获得最大正梯度       ←  双重鼓励
→ 其他token 也获得正梯度(因答对)  ←  双重鼓励
→ "继续这样写<mem>,继续这样思考和搜索"
场景二:答对 + 写得差
含义:即使答对了,这种"答对靠运气(查资料)、记忆写得不好"的路径, 仍然被部分惩罚------明确区分"运气答对"和"靠记忆答对"。
xml
outcome_adv > 0   mem_adv < 0
→ <mem>token:正梯度被部分抵消
→ 其他token:仍有正梯度
→ "答案对了,但<mem>可以更好"
→ 精细信号:哪轮<mem>最差,那轮受到最强惩罚

比如:轨迹A(答对了,但记忆写得稀碎):
  整体优势 = +0.8(答对)
  记忆优势 = -1.2(<mem> 信息不完整)
  <mem> token 最终梯度 = +0.8 - 1.2 = -0.4  ← 净负梯度!
场景三:答错 + 写得好
含义:这条轨迹的记忆写作行为仍受到一定保护, 不会被完全惩罚掉。
xml
outcome_adv < 0    mem_adv > 0
→ <mem>token:负梯度被部分抵消(争议!)
→ 其他token:负梯度(被惩罚)
→ 含义模糊:"虽然答错了,但这段<mem>写得不错"

轨迹B (答错了, 但记忆写得很精炼):
  整体优势 = -0.6 (答错)
  记忆优势 = +0.4 (<mem> 信息完整)
  <mem> token 最终梯度 = -0.6 + 0.4 = -0.2  ← 净负, 但惩罚程度轻于其他 token
场景四:答错+写得差
xml
outcome_adv < 0    mem_adv < 0
→ <mem>token获得最大负梯度   ←  双重惩罚
→ 其他token 也获得负梯度     ←  双重惩罚
→ "这次完全失败,<mem>也糟糕"
0x02 GRPO
MemPO 的训练,本质上是一个 PPO 算法 + 一个复合 advantage:
- GRPO (Group Relative Policy Optimization) 负责计算 outcome_adv
- Memory reward 机制负责计算 mem_adv
- 两者加和后得到final_adv,然后把 final_adv 送入标准 PPO clipped surrogate loss
并没有分别训练两个 objective, 也没有分步交替优化 --- --- --- 就是一个统一的梯度更新。即,outcome_adv 和 mem_adv 两者共同作为 PPO 的 advantage 信号,在同一个 PPO loss 中训练。
ini
final_adv = outcome_adv + mem_adv    ← 叠加后作为 PPO 的 advantage

PPO loss = -mean( final_adv × clip(ratio, 1-ε, 1+ε) × response_mask ) + KL_coef × KL(π || π_ref)
MemPO 的 GRPO 特色如下:
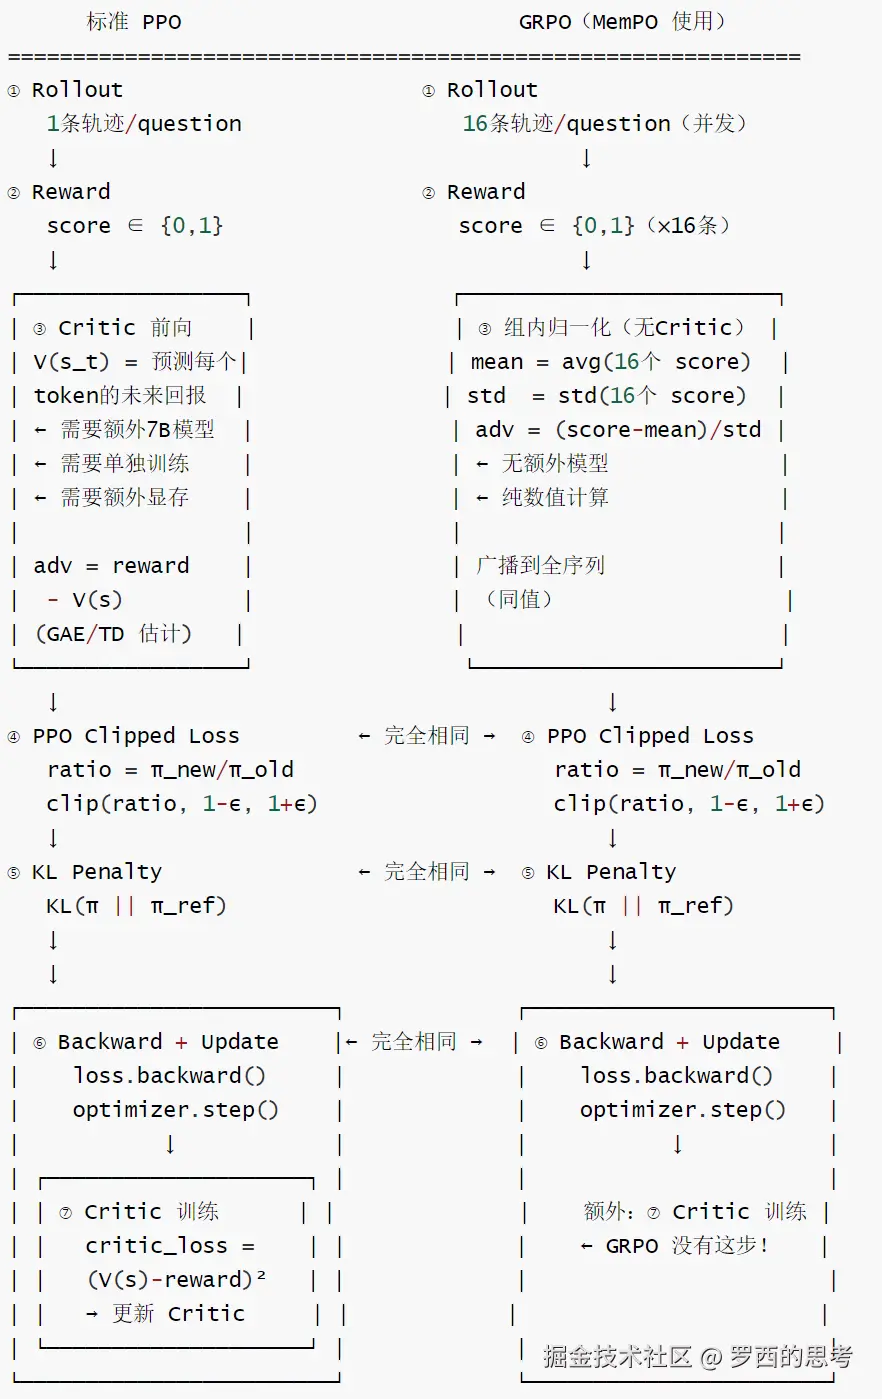
2-MemPO 的 GRPO 特色
0x03 流程
3.1 训练流程精简版
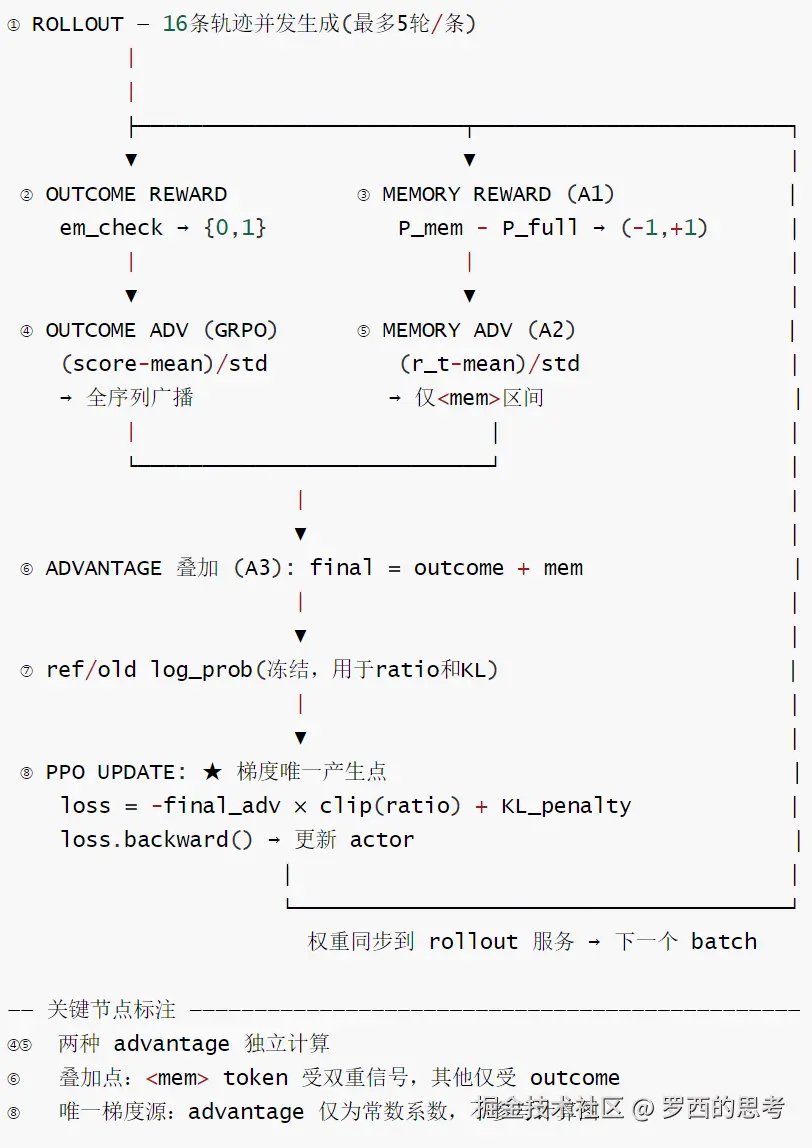
2-训练流程精简版
进一步细化如下:
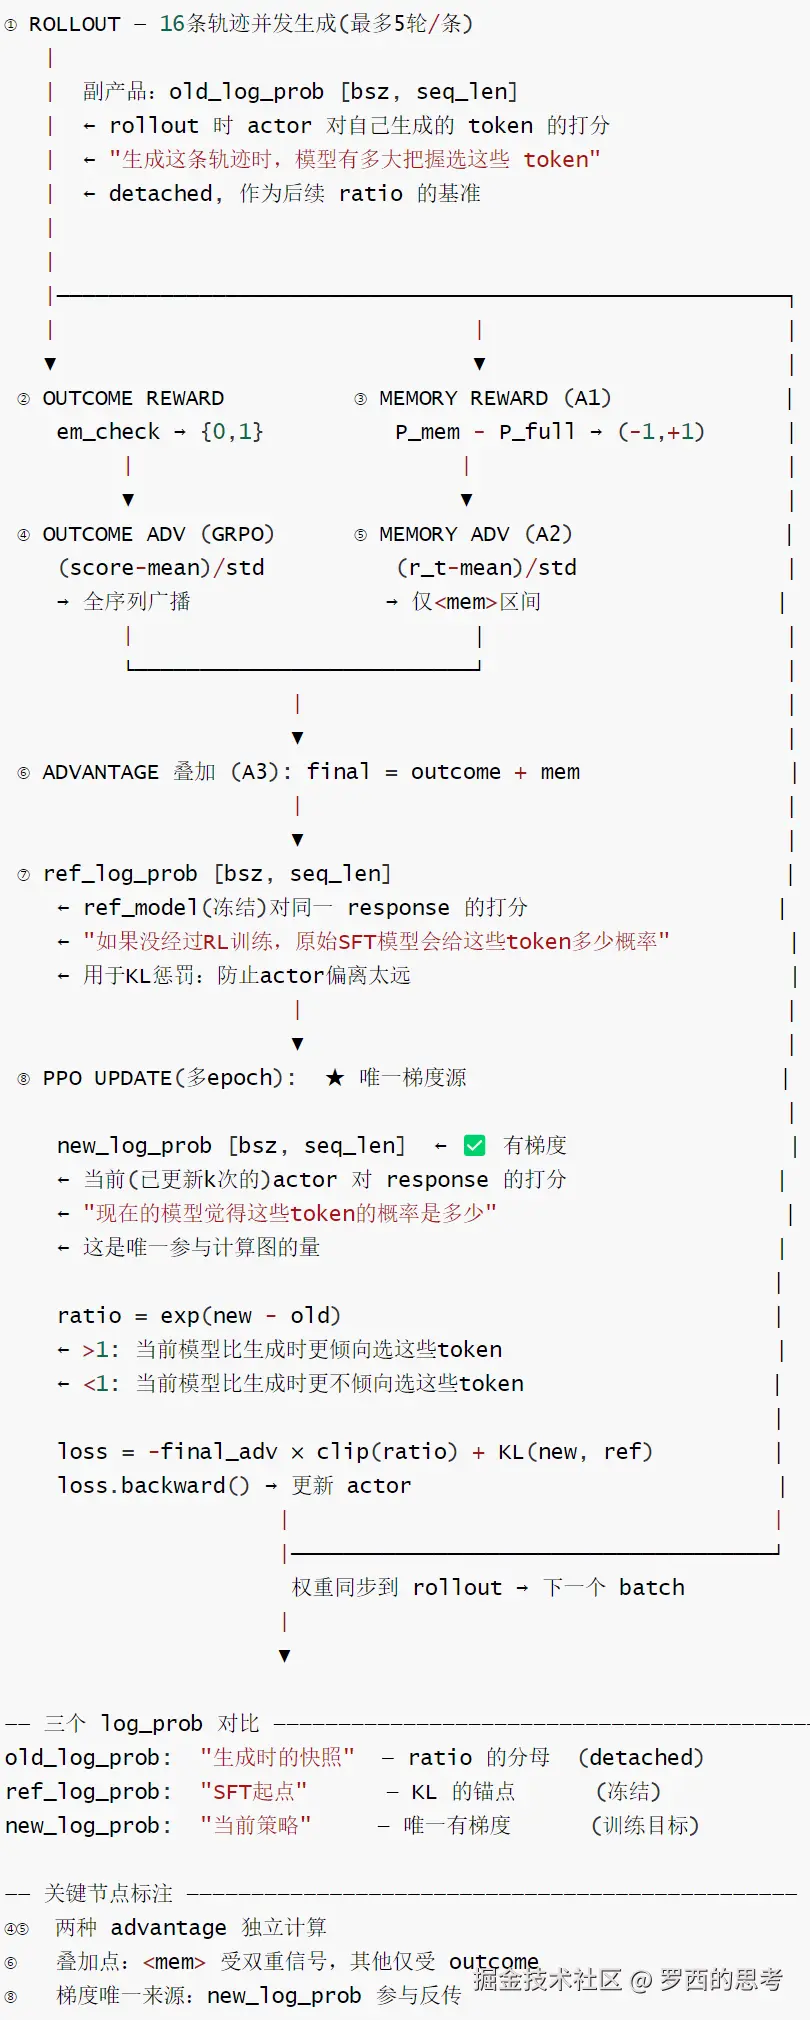
2-训练流程精简版细化
3.2 训练流程图(四阶段)
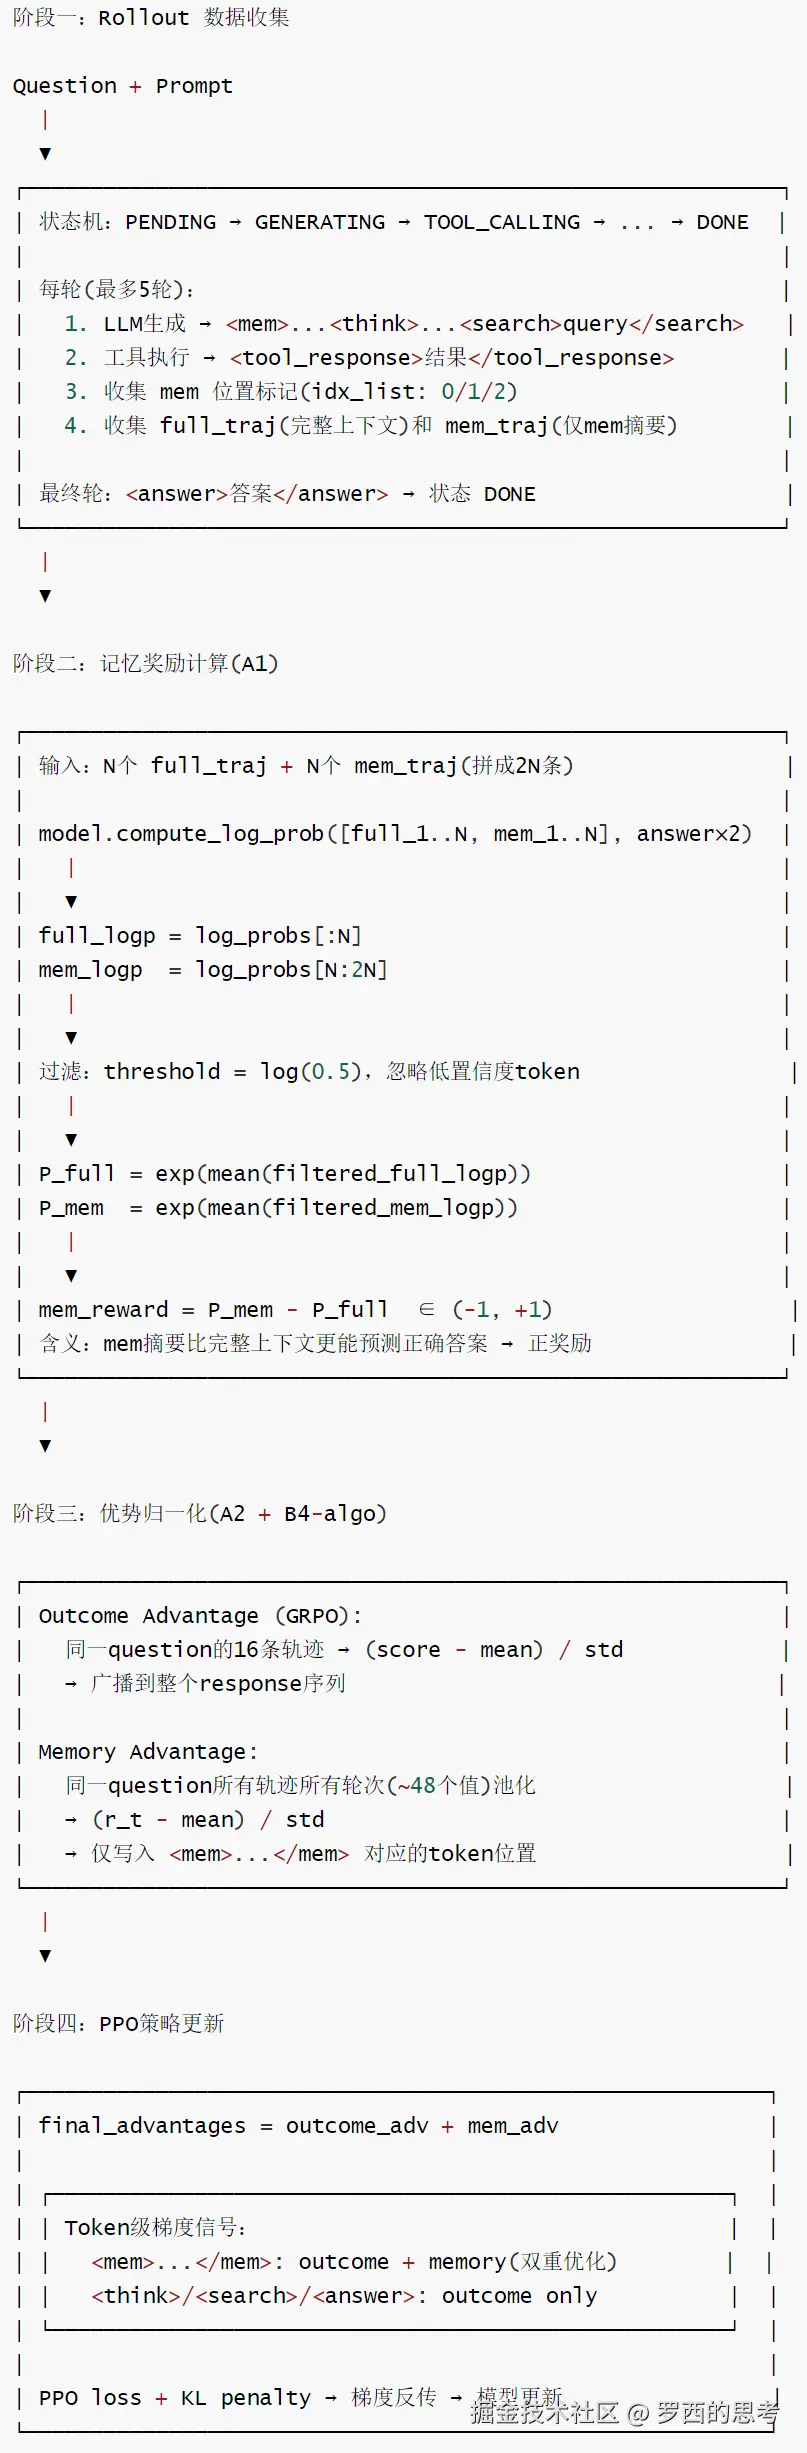
2-训练流程图
3.3 logps
我们来看看几个logps的情况。
对比:
- old_log_prob:
θ_N(rollout时的权重,固定不变,detached) - new_log_prob:
θ_N → θ_N' → θ_N'' → ..(每次 mini-batch 后都不同) - ref_log_prob:
θ_0(训练开始时的SFT权重,永远不变)
关键:old_log_prob在整个 PPO Update 期间保持不变(是rollout 时的快照),而 new_log_prob 随着每次 optimizer.step()更新而改变一这就是PPO 能复用同一批数据做多 epoch 更新的原因(importance sampling 修正分布不匹配)。
ini
Step N 开始
│
├─ ① Rollout(用 actor 当前权重 θ_N 生成 token)
│   → 同时记录 old_log_prob = log π_θN(response_ids)
│   → "生成这些 token 时模型的打分"
│   → 权重 = θ_N
│
├─ ② 计算 advantage(final_adv)
│
├─ ③ PPO Update: epoch 1, mini-batch 1
│   new_log_prob = log π_θN(response_ids)
│   ratio = exp(new - old) ≈ 1(几乎没更新)
│   loss.backward() → optimizer.step() → θ_N 变成 θ_N'
│
├─ ④ PPO Update: epoch 1, mini-batch 2
│   new_log_prob = log π_θN'(response_ids)  ← 权重已变!
│   ratio = exp(new - old) ≠ 1              ← 和 old 有差异了
│   loss.backward() → optimizer.step() → θ_N' 变成 θ_N''
│
├─ ⑤ PPO Update: epoch 2, mini-batch 1
│   new_log_prob = log π_θN''(response_ids) ← 权重继续变
│   ratio 越来越偏离 1
│   → clip 开始起作用,限制更新幅度
│
...
│
└─ PPO Update 结束 → 权重 = θ_{N+1}
   → 同步到 rollout 服务 → 进入 Step N+1
0x04 实现
MemPO中共有三个模型角色:
- Actor-正在训练的策略模型,每个PPOstep更新参数
- Ref Model-冻结的参考模型(初始化自SFT权重),不更新,用于KL惩罚
- Rollout服务一用actor当前权重做推理生成,每步同步actor参数
4.1 训练主循环
训练主循环入口是RayPPOTrainer.fit()。
scss
RayPPOTrainer.fit()
|
+-> AgentLoopManager.generate_sequences()
|   |
|   +-> ToolAgentLoop (状态机循环)
|   |   |
|   |   +-> [每轮] 收集 full_traj / mem_traj
|   |   |       标记 mem token 0/1/2
|   |   +-> [每轮] 构建 ans_mask
|   |
|   +-> AgentLoopWorker._postprocess()
|       |
|       +-> [P_mem/P_full 计算]
|           +-> compute_log_prob (1次前向)
|           +-> mem_reward = P_mem - P_full
|
+-> RewardManagerWorker.reward_wrapper()
|   |
|   +-> NaiveRewardManager.__call__()
|       |
|       +-> compute_score()
|           |
|           +-> validate_format()
|           +-> em_check()
|
+-> compute_advantage()
    |
    +-> compute_grpo_outcome_advantage()
    +-> compute_grpo_memory_advantage()
        +-> 归一化: 同 question 所有轮次池化
        +-> 作用范围: 仅 <mem> token

【评估流程 (独立, 不参与训练)】
AgentMemory.prepare_prompt()
    +-> 每轮只保留最近1轮工具结果
    +-> 强制模型依赖 <mem> 传递历史
4.2 关键点 & 阶段
我们回顾前文,代码具体路径上的关键点如下:
scss
A1   _postprocess(P_mem/P_full段)          MemPO核心:记忆奖励如何计算
A2   compute_grpo_memory_advantage        mem_adv如何归一化、作用于哪些 token
A3   compute_advantage(mem叠加段)          两种优势如何叠加、被注释的条件版本
A4   ToolAgentLoop.__init__(mem收集段)     full/mem_traj 收集时机、ans_mask 构造
A5   AgentMemory.prepare_prompt           "倒逼记忆"机制:每轮只保留1轮工具
B1   NaiveRewardManager.__call_            outcome reward计算和放置位置
B2   compute_score                        三种 target 类型处理、EM check
B3   validate_format                      8条格式规则(隐式prompt工程)
B4   compute_grpo_outcome_advantage       对比 outcome_adv vs mem_adv 的差异
B5   RewardManagerWorker.compute_score     Ray async 奖励计算接口
B6   AgentLoopManager.generate_sequences   rollout 调度+mem_rewards 收集
C1   RayPPOTrainer.fit                     训练主循环(宏观流程)
C2   extract_solution                      答案提取逻辑
C3   ToolParser.register("search")         <search>标签解析
C4   AsearcherSearchTool,execute           RAG检索调用+5次重试
上述关键点其实是按照 outcome advantage 和 mem advantage 的分类来区分的。大致认为:A 路径是 mem advantage,B 路径是 outcome advantage,C 路径是主循环。
我们再按照 PPO 算法的的主要阶段来看看这些关键点属于哪个阶段?
| 标签 | 函数 | 所属阶段 |
|---|---|---|
| C1 | RayPPOTrainer.fit | 训练主循环 |
| B6 | AgentLoopManager.generate_sequences | Rollout |
| A4 | _handle_generating_state | Rollout |
| C3 | ToolParser.parse | Rollout |
| C4 | AsearcherSearchTool.execute | Rollout |
| B5 | RewardManagerWorker.compute_score | Rollout(异步) |
| B1 | NaiveRewardManager.call | Rollout(异步) |
| B2 | compute_score | Rollout(异步) |
| C2 | extract_solution | Rollout(异步) |
| B3 | validate_format | Rollout(异步) |
| B4 | em_check | Rollout(异步) |
| A1 | _postprocess | Rollout 后处理 |
| B4-algo | compute_grpo_outcome_advantage | Advantage 计算 |
| A2 | compute_grpo_memory_advantage | Advantage 计算 |
| A3 | compute_advantage | Advantage 叠加 |
| - | ref_model.compute_log_prob | PPO 更新 |
| - | actor.compute_log_prob (old) | PPO 更新 |
| - | PPO clipped surrogate loss | PPO 更新 |
| A5 | AgentMemory.prepare_prompt | 评估专用 |
4.3 Prompt特点全解析
MemPO的prompt哲学:不用指令工程告诉模型怎么做,而是用奖励信号让模型自己学到最优格式。
训练时:无格式说明,靠RL内化规则(更强泛化)
评估时:有mem-prompt格式说明(显式指导)
arduino
prepare_prompt() ←────────── "约束"------每轮只看最近 1 轮 ─────┐
                                设计目标                  | 相互印证
                                "每轮 <mem> 独立自洽"      |
mem_reward ←────────── "激励"------P_mem ≈ P_full 得正分 ──────┘
4.3.1 训练端Prompt(极简设计)
训练时,模型接收到的prompt 来自 Parquet 数据集的 "messages"字段:{"role":"user","content":"原始问题"},经过apply_chat_template 后:
sql
<|im_start|>system
You are a helpful assistant.   ◄─── 极简系统提示,无任何格式指令
<|im_end|>
<|im_start|>user
什么地方有好吃的?                ◄─── 裸问题,无任何prompt模板
<|im_end|>
<|im_start|>assistant
<mem>                          ◄─── 强制前缀(prepare_1lm_query添加)
特点:无格式说明。训练数据里没有告诉模型"要用//
格式",全靠奖励函数的格式校验(validate_format())来强制。
4.3.2 评估端Prompt(详细格式指令)
xml
PROMPT_TYPES = {

    "mem-prompt": '''You will answer complex questions using iterative reasoning, summarization, and web search. Your task is:

1. Update a concise summary and perform reasoning within <mem>\n...\n</mem>\n<think>\n...\n</think>, respectively.

2. Then choose one of the following actions:
   - If any question remains unanswered, issue a single query for one question inside <search> ... </search>.
   - Provide the final answers within <answer> ... </answer> .If there are multiple queries, ensure all answers are enclosed within <answer> </answer>, seperated with semicolon. The answers must be concise, usually short phrases or words, and avoid any explanations.

Important:
   - Must strictly follow one of these two structures: <mem>\n...\n</mem>\n<think>\n...\n</think>\n<search>\n...\n</search> or <mem>\n...\n</mem>\n<think>\n...\n</think>\n<answer>\n...\n</answer>.
   - Do not search multiple queries or questions simultaneously. Only issue a single query inside <search> ... </search> once. At least one search must be conducted for each question.

User question: {question}
''',
}
特点:评估prompt包含了完整的格式说明、多目标答案格式(;分隔)、以及强制搜索限制。
4.3.3 两端Prompt的对比
| 维度 | 训练端 | 评估端 |
|---|---|---|
| 系统提示 | "You are a helpful assistant." | mem-prompt(含格式指令) |
| 格式说明 | 无 | 有(明确说明 // 用法) |
| 多目标提示 | 无 | 说明答案用 ; 分隔 |
| 强制搜索 | 无明文 | "At least one search must be conducted" |
| 问题呈现 | 裸问题 | User question: {question} 包装 |
| 前缀注入 | (代码强制添加) | (代码强制添加) |
4.3.4 训练 vs 评估的关键 Prompt 漂移
训练时模型学的行为:
- 系统提示极简→格式靠强制前缀和奖励信号
- 没有显式的格式说明
评估时模型面对的:
- 详细的mem-prompt格式说明
- 明确的 "At least one search要求
- 问题被包装在"User question:"之后
潜在影响:
- 训练时无格式说明→模型靠 RL学习格式规则
- 评估时有格式说明→会不会影响模型的行为分布?
实际效果:训练好的模型已经内化了格式规则,评估时的格式说明相当于"冗余提醒",不会干扰太多(但可能导致 in-context learning 效应微调行为)
4.3.5 validate_format()作为隐式 Prompt 工程
由于训练 prompt没有格式说明,格式约束完全通过奖励来传递:
scss
奖励 = 0(格式错误) / 1(格式正确+答案正确)validate_format()要求的规则=模型"应该学到"的prompt规则:
- 每轮必须有...
- 每轮必须有...
- 必须至少有1个
- / 数量 == assistant 轮次数
4.4 Update
PPO Update 期间各量的状态如下:
scss
固定不变 (detached 常数):
    ✅ final_adv      ← 在 update 前就算好了,不会再变
    ✅ old_log_prob   ← rollout 时的快照
    ✅ ref_log_prob   ← 冻结模型的输出
    ✅ response_mask  ← 数据属性
    ✅ response_ids   ← rollout 生成的 token

每次 mini-batch 都变:
    🔄 new_log_prob  ← 随 actor 权重更新而改变
    🔄 ratio         ← 依赖 new_log_prob
    🔄 loss          ← 依赖 ratio
    🔄 actor 权重    ← optimizer.step () 后更新
PPO 的设计特点 ---advantage 不需要重新计算,因为:
- advantage 衡量的是 "这个 token 该鼓励还是抑制", 这个判断在 rollout 结束时就确定了
- ratio 和 clip 机制已经负责 "根据当前策略的偏移量调整更新幅度"
- 如果每次 mini-batch 都重算 advantage, 会引入额外的计算开销和不稳定性
4.5 Token ID
我们来讨论 为何PPO Update用的是rollout产出的原始response_id?
·因为 PPO 优化的目标是"改进生成这些token 的策略",所以需要用实际生成的 token序列来计算log_prob和rat io.
PPO的核心公式:
scss
ratio = exp(new_log_prob(response_ids) - old_log_prob(response_ids))
loss = -adv x clip(ratio)
这里的 response_ids必须是rollout 实际生成的 token:
- old_log_prob:"生成这些token时,旧策略给了多少概率"
- new_log_prob:"现在的策略给这些token多少概率"
- ratio:"现在比以前更倾向/不倾向生成这些token"
如果换成full_traj或mem_traj:
vbnet
→ 那些不是模型实际生成的 action → 无法用importance sampling 纠正 → 违反了 PPO 的理论基础(on-policy → off-policy correction)类比:你考了一张试卷(response_ids = 你的答题过程)
- 老师评分后(advantage = 对/错)
- PPO 做的是:"回看你写的每个字,鼓励好的、抑制坏的" → 必须回看你实际写的答案(response_ids)
- full_traj / mem_traj 是:"你考试前看到的参考资料和笔记" → 这些不是你写的,不能用它们来优化你的"答题策略" → 它们只用于判断"你的笔记(mem)质量好不好"(memory reward)
TransFormer-封面
0xFF 参考
本文使用 markdown.com.cn 排版