成为全栈·Node 后端篇·辅助接口:相邻、相关、目录、统计与搜索
读者看完一篇,最自然的三个念头是:下一篇看什么、这篇和哪篇相关、目录怎么跳。这些功能单个看都不难,可它们不属于核心 CRUD,常被做成"顺手加几个接口"------然后各自为政、口径不一,改一处漏三处。
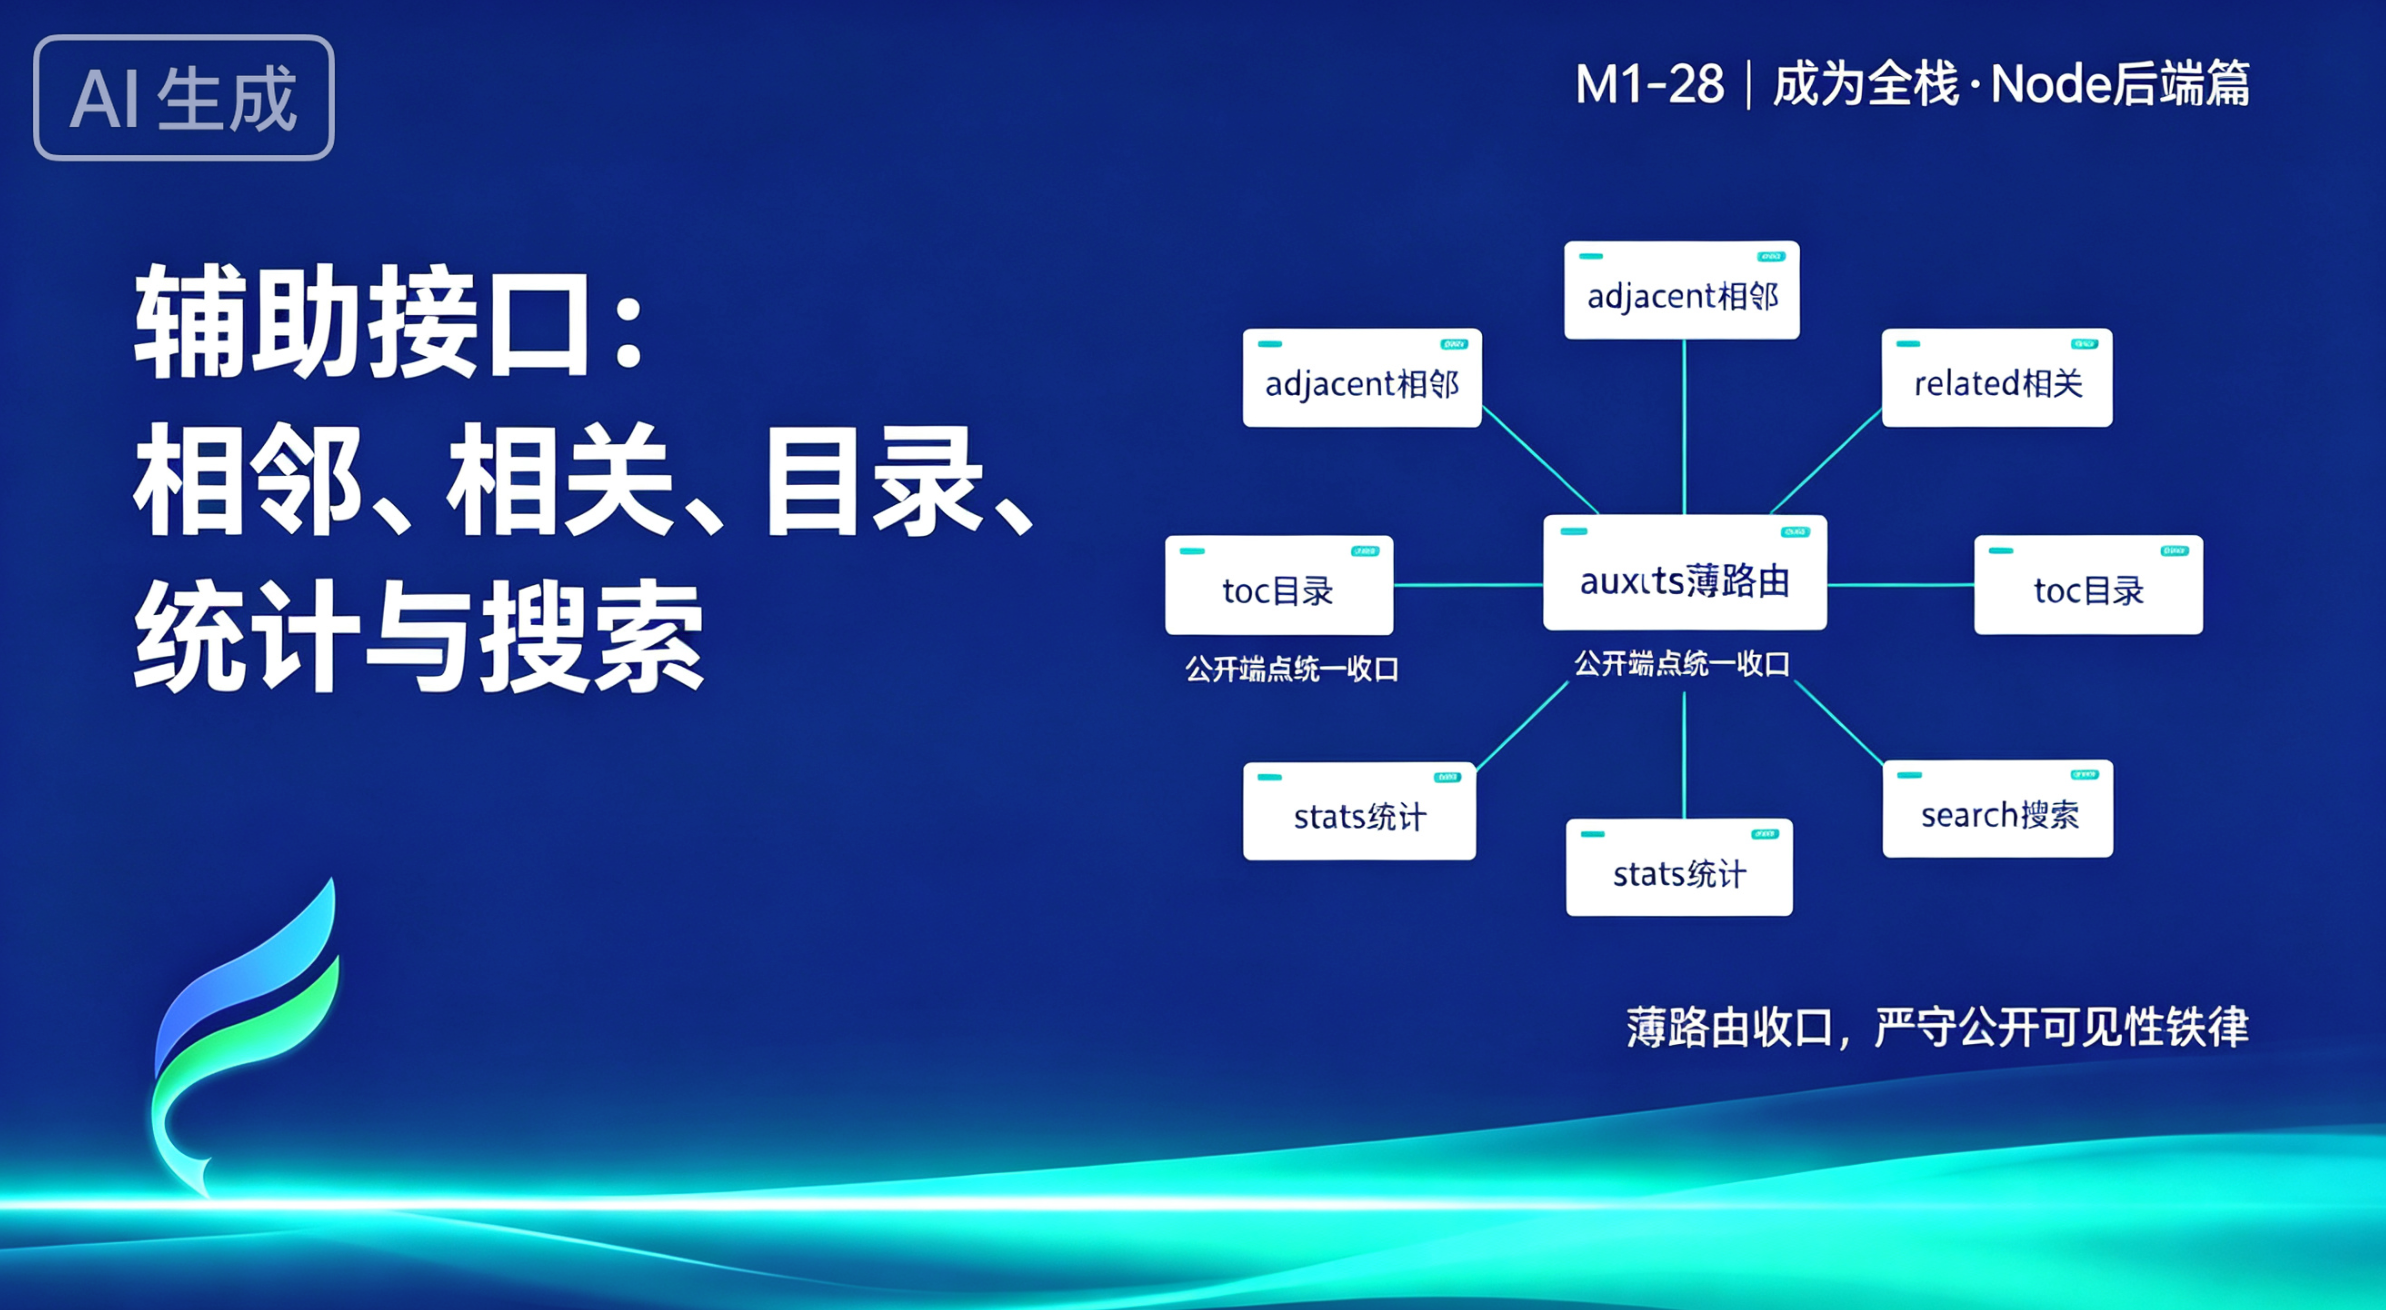
这一篇讲这些辅助接口 怎么落:上一篇 / 下一篇怎么按发布时间定邻域、相关文章怎么用"共享标签 + 同分类"打分、parseToc 这个纯函数为什么是个小艺术品,以及贯穿全站的那条公开可见性铁律。
一、辅助接口有哪些
aux.ts 把一组公开端点收在 /api/v1 下:
| 端点 | 作用 | 真实 service |
|---|---|---|
GET /articles/:id/adjacent |
上一篇 / 下一篇 | getAdjacent |
GET /articles/:id/related |
相关文章 | getRelated |
GET /articles/:id/toc |
文章目录 | parseToc |
GET /stats |
全站统计 | getSiteStats |
GET /search |
搜索(文章 / 会员) | searchArticles / searchMembers |
它们全部 security:[] 公开 (站点统计、搜索本就是给所有人看的),但又严格守着"公开可见性铁律"------adjacent / related / toc 都先调 getPublishedArticle,未发布文章直接 404,不泄露草稿存在。
二、薄路由的两个小细节
aux.ts 开头有个 parseId helper,值得记住:
ts
const parseId = (raw: string): number => {
  const id = Number(raw);
  if (!Number.isInteger(id)) throw new AppError(ErrCode.NOT_FOUND, 404);
  return id;
};
非整数 id(比如 /articles/abc/adjacent)一律 404,而不是 400 或 500。理由是"不是整数 id"和"这个 id 不存在"在语义上等价------都是"你要的资源我给不了",统一走 404 让前端处理逻辑更简单。这是"错误分类要贴合语义"的小修养。
所有辅助端点都遵循同一个骨架:parseId → getPublishedArticle(守未发布铁律)→ 调具体 service → ok(...) 包信封。路由层不碰 DB、不做打分、不解析 Markdown,所有复杂度都在 service / shared 里,和全栈一贯的薄路由纪律一致。
三、上一篇 / 下一篇:基于发布时间的邻域
getAdjacent 的逻辑很直觉------"上一篇"是比当前文章更早发布 的那篇,"下一篇"是更晚发布的那篇:
ts
// src/services/related.ts --- getAdjacent
export const getAdjacent = async (
  article: ArticleRow,
): Promise<{ prev: ArticleStub | null; next: ArticleStub | null }> => {
  const db = getDb();
  const base = and(eq(articles.status, 'published'), isNull(articles.deletedAt));
  if (!article.publishedAt) return { prev: null, next: null };
  const cols = { id: articles.id, title: articles.title, slug: articles.slug } as const;
  const prevRow = (
    await db
      .select(cols)
      .from(articles)
      .where(and(base, lt(articles.publishedAt, article.publishedAt)))
      .orderBy(desc(articles.publishedAt))
      .limit(1)
      .all()
  )[0];
  const nextRow = (
    await db
      .select(cols)
      .from(articles)
      .where(and(base, gt(articles.publishedAt, article.publishedAt)))
      .orderBy(asc(articles.publishedAt))
      .limit(1)
      .all()
  )[0];
  return {
    prev: prevRow ? { id: prevRow.id, title: prevRow.title, slug: prevRow.slug ?? null } : null,
    next: nextRow ? { id: nextRow.id, title: nextRow.title, slug: nextRow.slug ?? null } : null,
  };
};
要点:
- 以
publishedAt为序 ,而不是id------因为文章可能补发、调整顺序,publishedAt才是读者感知到的"前后"语义。 prev取publishedAt小于当前、按降序的第一篇 ;next取大于当前、按升序的第一篇。两个查询对称,各自只取一条。- 没有就返回
null(首篇无prev、末篇无next),前端据此决定显不显示箭头,不会拿到 404 崩掉。
这里 orderBy(desc(articles.publishedAt)) 用全限定列 articles.publishedAt------这正是我们列表接口三件套:分页、筛选、排序讲过的 P-11 排序纪律:当查询只涉及单表时写 publishedAt 也行,但养成"全限定基表列"的习惯,能在任何 JOIN 场景下根除 ambiguous column 错误。辅助接口虽简单,排序纪律照样不打折扣。
四、相关文章:共享标签 + 同分类打分
getRelated 是个"轻量推荐":给当前文章算出最相关的几篇。真实实现不是上协同过滤模型,而是规则打分:
ts
// src/services/related.ts --- getRelated
export const getRelated = async (
  article: ArticleRow,
  limit: number,
): Promise<ArticleRelatedItem[]> => {
  const db = getDb();
  const curTags = new Set(parseTags(article.tags));
  const rows = await db
    .select({
      id: articles.id,
      title: articles.title,
      slug: articles.slug,
      viewCount: articles.viewCount,
      tags: articles.tags,
      categoryId: articles.categoryId,
    })
    .from(articles)
    .where(
      and(
        eq(articles.status, 'published'),
        isNull(articles.deletedAt),
        ne(articles.id, article.id),
      ),
    )
    .all();
  return rows
    .map((r) => {
      const shared = parseTags(r.tags).filter((t) => curTags.has(t)).length;
      const sameCat = article.categoryId != null && r.categoryId === article.categoryId ? 1 : 0;
      return {
        id: r.id,
        title: r.title,
        slug: r.slug ?? null,
        viewCount: r.viewCount,
        score: shared * 2 + sameCat,
      };
    })
    .filter((r) => r.score > 0)
    .sort((a, b) => b.score - a.score || b.viewCount - a.viewCount)
    .slice(0, limit)
    .map(({ id, title, slug, viewCount }) => ({ id, title, slug, viewCount }));
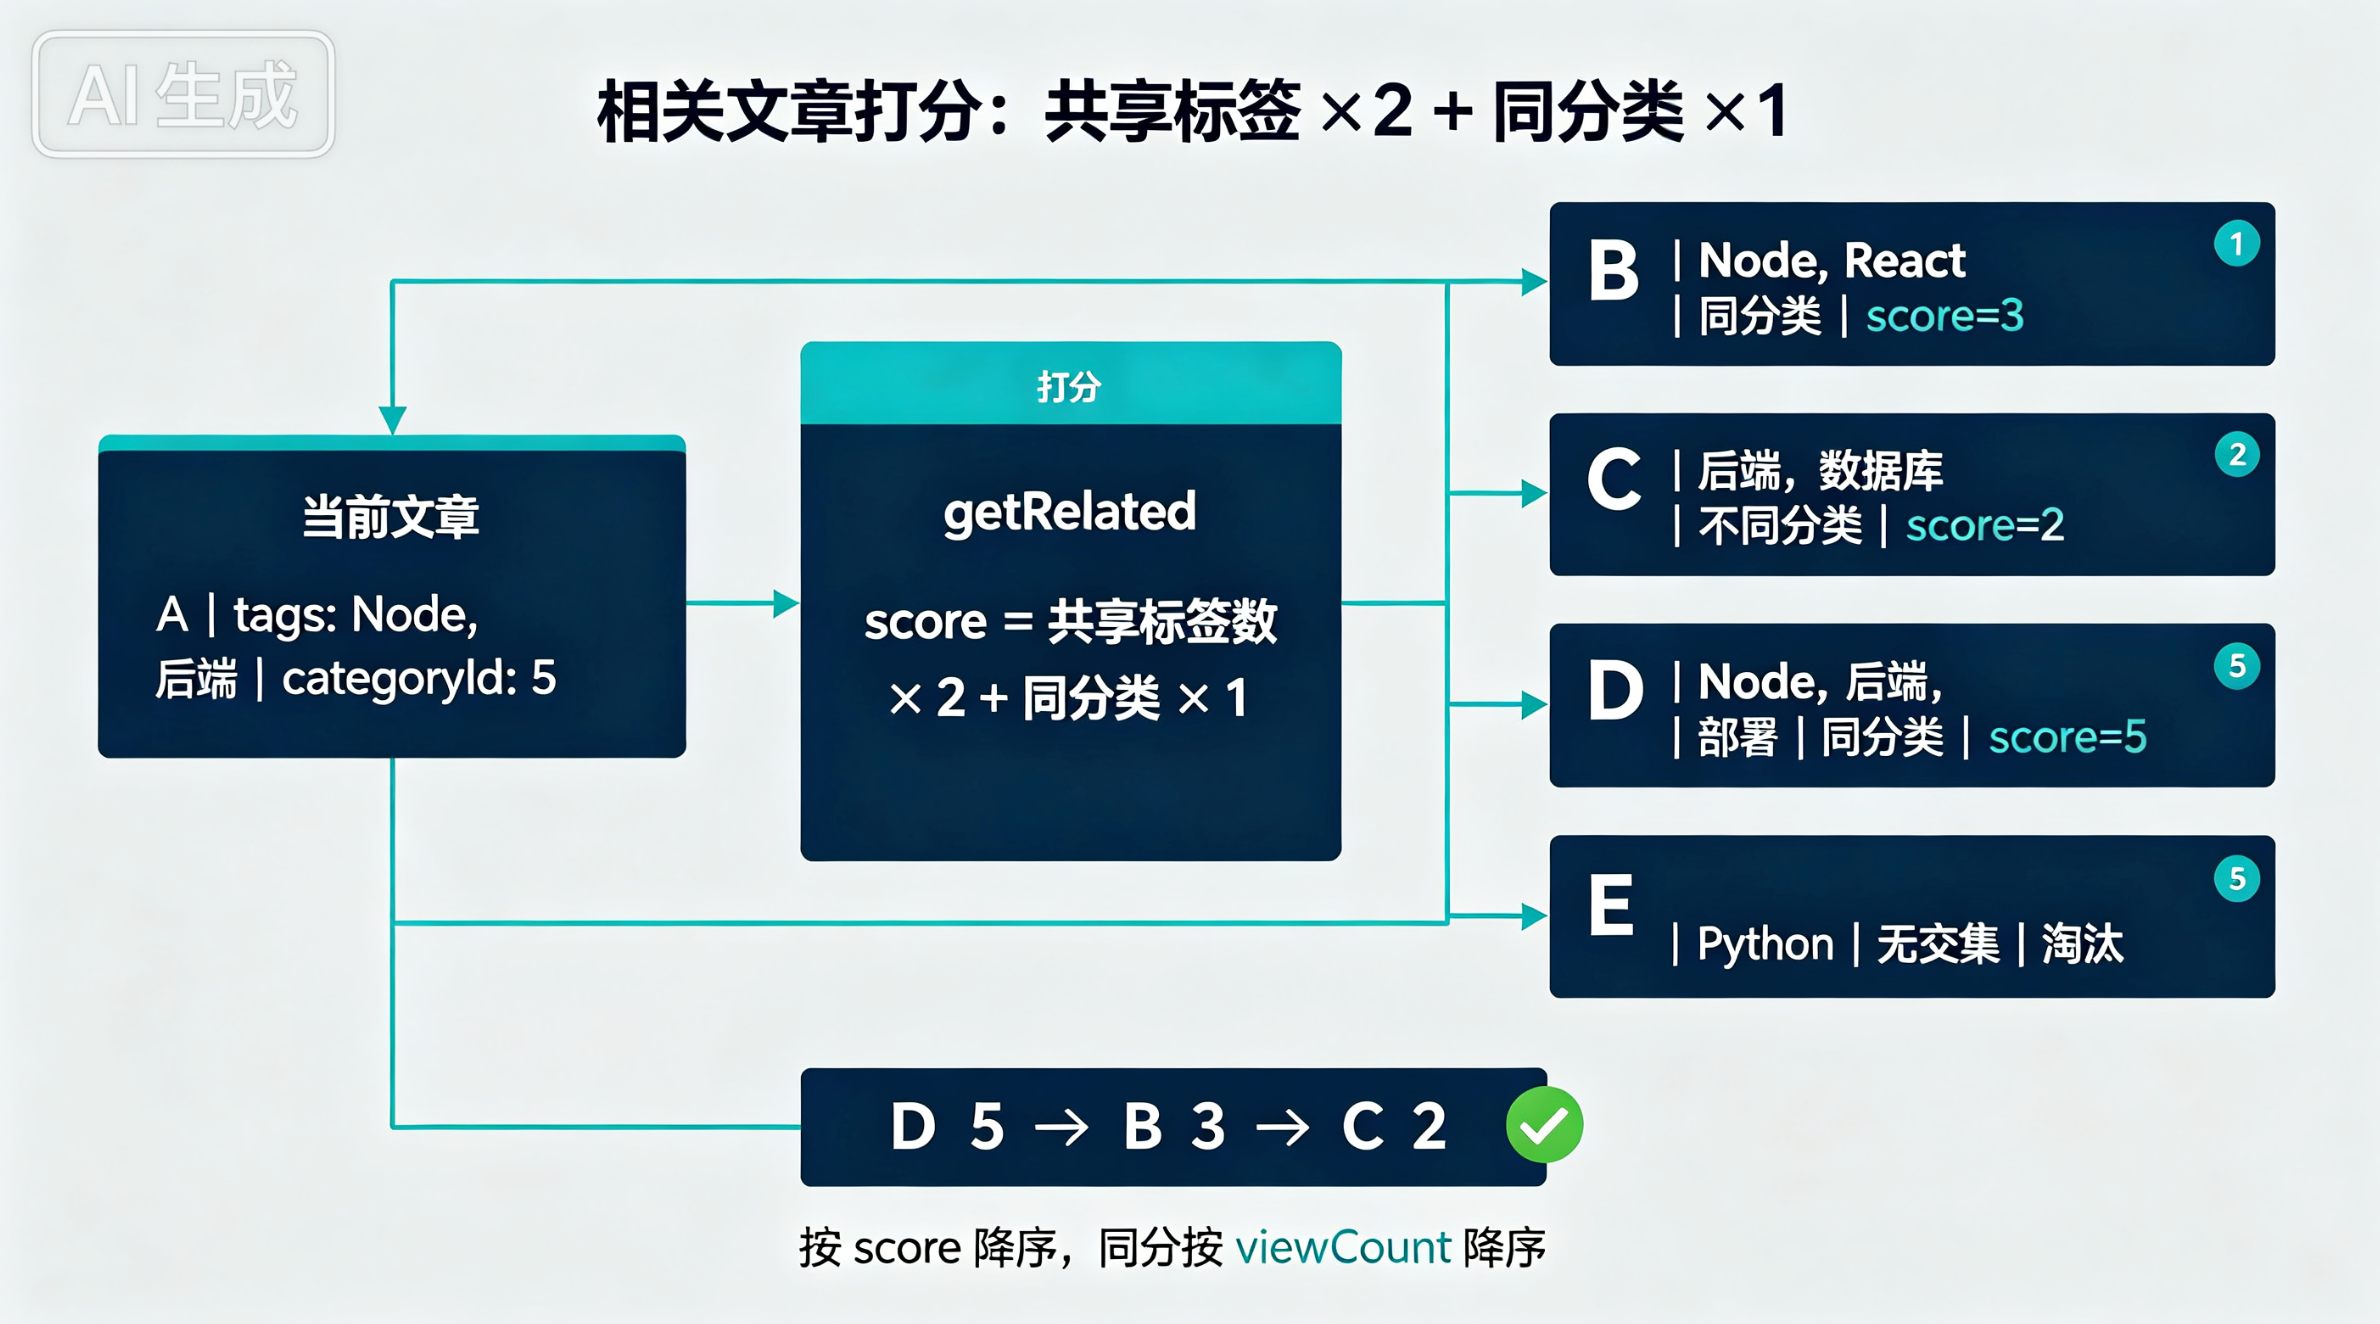
};规则清晰:共享标签每份权重 2,同分类权重 1 ,两者相加得 score;只保留 score > 0 的(和当前文章毫无交集的不推荐);按 score 降序、同分时按 viewCount 降序(热门优先);最后 slice 到 limit(?limit 默认 5、封顶 10,路由层 Math.min(10, Math.max(1, ...)) 钳制)。
这里有个 P-35 相关的设计点:标签打分读的是 articles.tags 这列去规范化的 JSON ,而不是去 JOIN article_tags 关联表。注释明确说"标签取 articles.tags 去规范化 JSON 列(B2 创建文章即填充,与 article_tags 关联表回填状态无关)"。为什么?因为相关文章要算"两篇文章共享多少标签",在内存里 parseTags 一下 JSON 比连表聚合轻得多,而且它不依赖"article_tags 回填任务是否跑完"------即使关联表同步滞后,去规范化列永远是最新的(创建/更新文章时即写)。这是"读路径选最稳数据源"的务实选择,和分类与标签:多对多关系的建模与查询讲的标签精确计数是两条不同的读路径,各有适用场景。
五、P-49:全量内存计算的规模适配
注意 getRelated 是先 SELECT 全部已发布文章,再在 Node 内存里逐篇算分排序 。在几十到几百篇的规模下,这比"用 SQL 做复杂打分"简单且够快。但必须诚实标注(P-49):这不是无限 scalable 的写法。当文章涨到十万级,全量拉回内存会吃内存、拖慢响应。届时的升级方向是:
- 用
article_tags关联表做GROUP BY tag_id的 SQL 聚合,直接算出共享标签数,把打分下推到数据库; - 或上专门的推荐 / 向量检索服务(如之前 M1-19 讲的 Meilisearch / ES),用倒排索引做"相似文章"。
当前规模下,"全量内存打分"是正确且好维护的选择------架构匹配当前规模,别为想象中的海量提前背上重型系统。P-49 要传达的正是这种"清醒的规模意识":知道现在的写法在哪条规模线上会失效,并把它当作一个明确的升级信号,而不是假装它永远最优。
六、目录 parseToc:一个纯函数的小艺术品
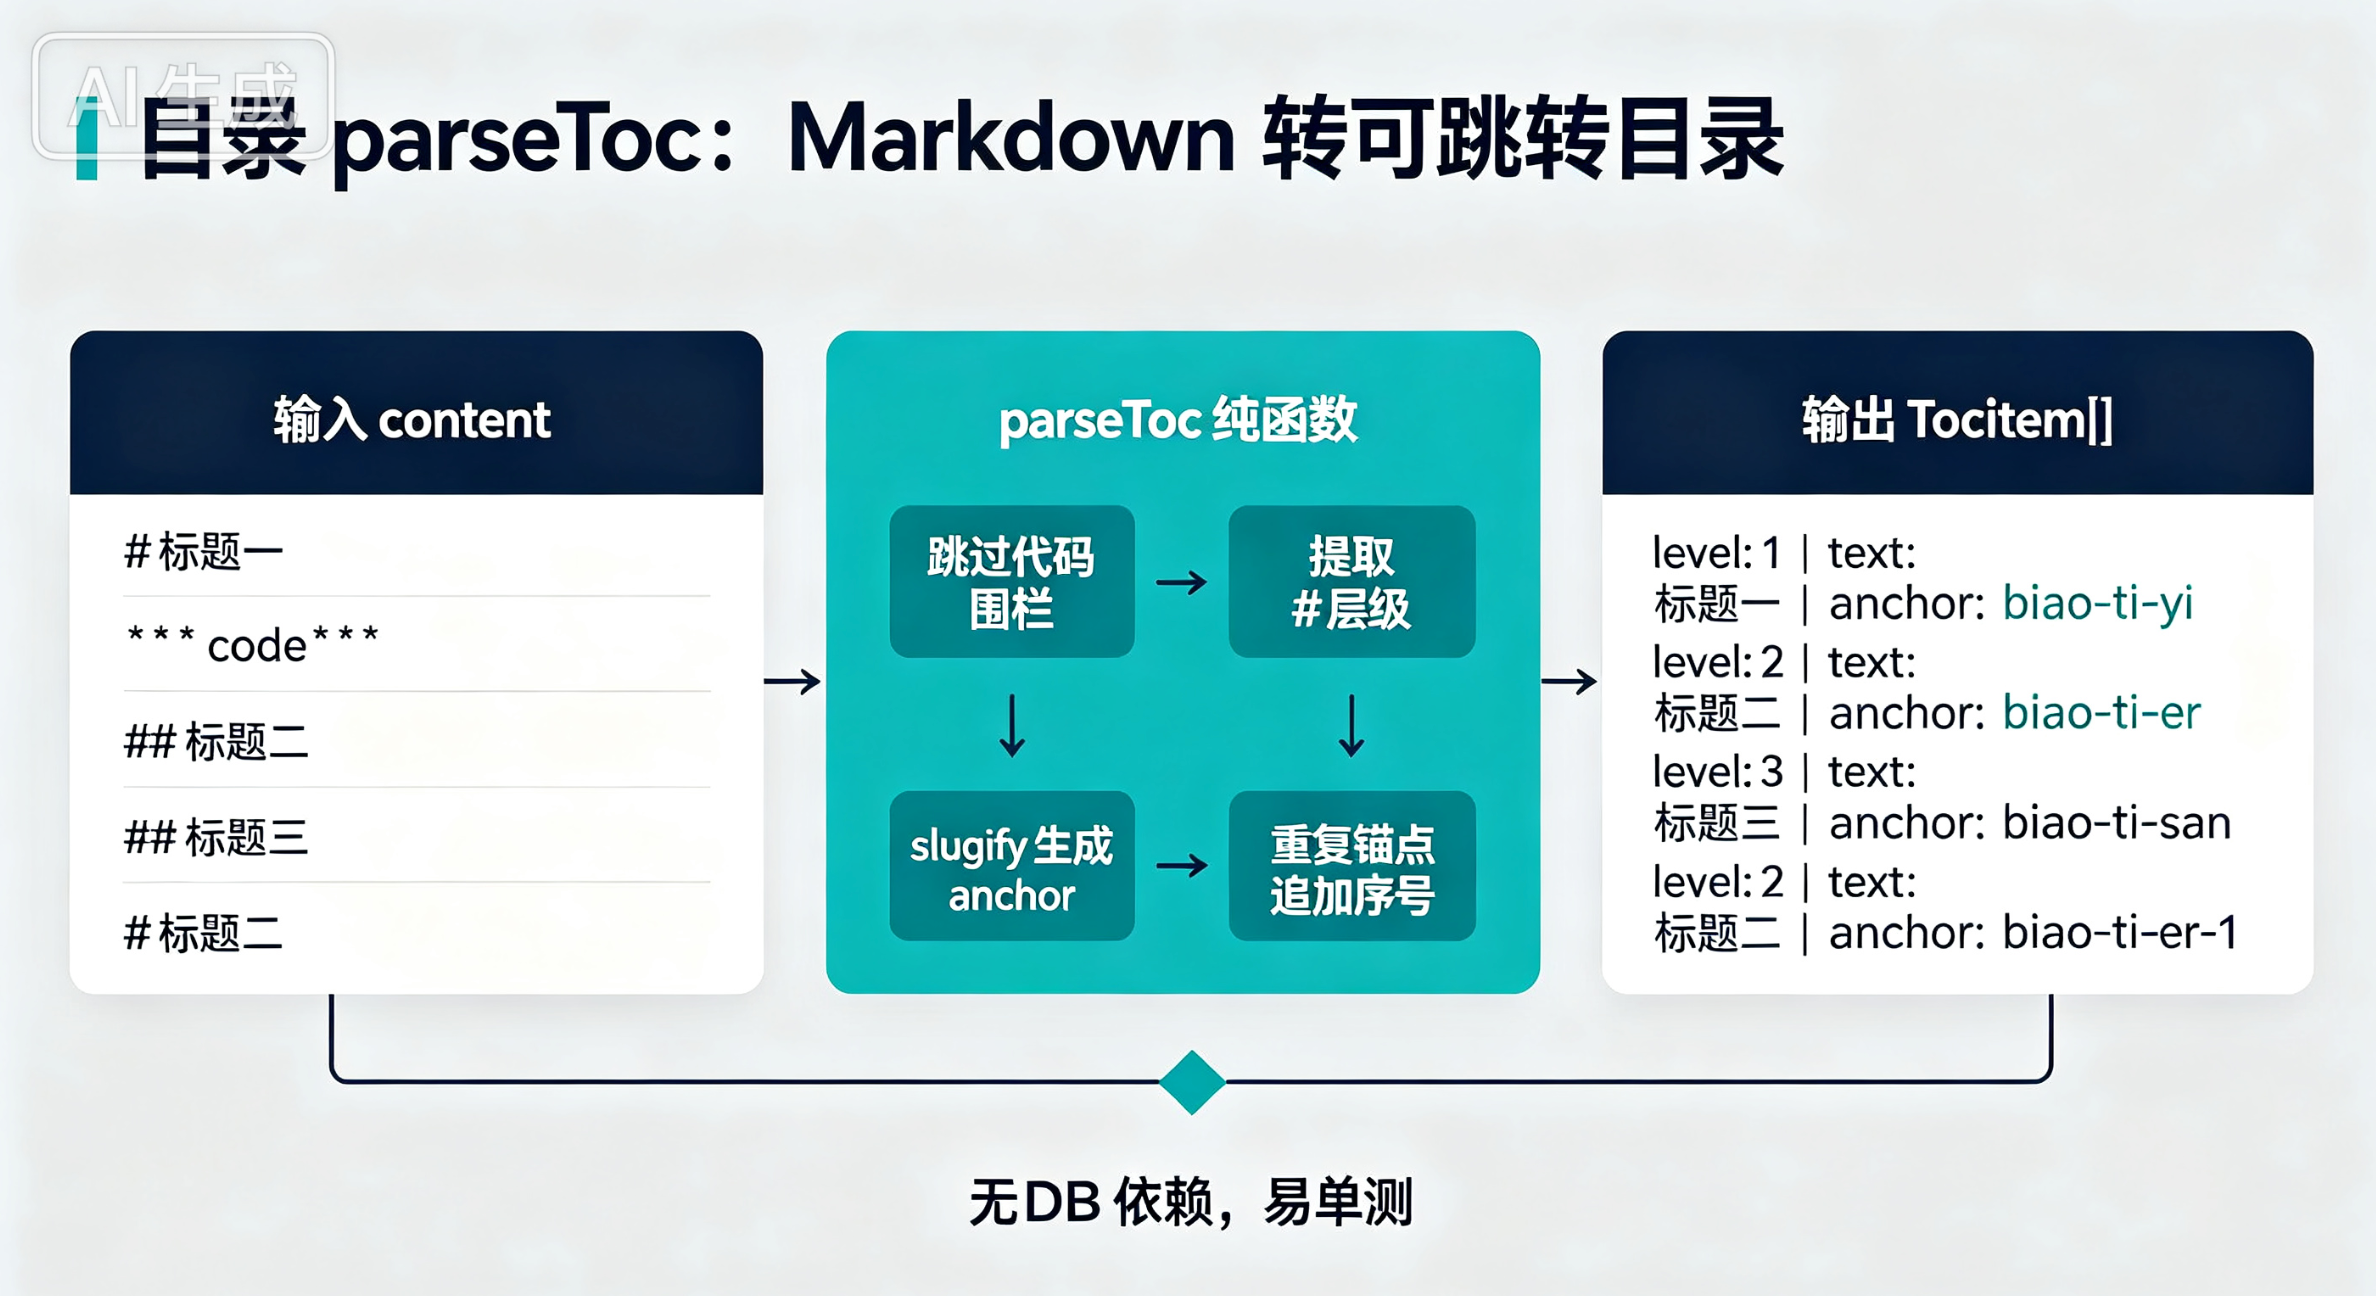
GET /articles/:id/toc 把文章 Markdown 正文解析成目录锚点。parseToc 是个无 DB 依赖的纯函数,非常利于单测:
ts
export const parseToc = (content: string): TocItem[] => {
  const items: TocItem[] = [];
  const seen = new Map<string, number>();
  let inFence = false;
  for (const line of content.split('\n')) {
    if (line.trimStart().startsWith('```')) { inFence = !inFence; continue; } // 跳过代码围栏
    if (inFence) continue;
    const m = /^(#{1,6})\s+(.+?)\s*#*\s*$/.exec(line);
    if (!m) continue;
    const level = m[1]?.length ?? 0;
    const text = m[2]?.trim() ?? '';
    if (!text) continue;
    let anchor = slugify(text) || 'heading';
    const count = seen.get(anchor) ?? 0;
    seen.set(anchor, count + 1);
    if (count > 0) anchor = `${anchor}-${count}`;  // 重复锚点去重
    items.push({ level, text: text.slice(0, 200), anchor });
  }
  return items;
};
几个精巧处:
- 跳过代码围栏 :遇到 ```````````行就翻转
inFence,围栏内的# 注释不会被误判成标题------这是写 Markdown 解析器最容易漏的坑。 slugify锚点 :保留字母 / 数字 / 中文,其余替换成-,截断 100 字符;空则回退'heading'。生成的anchor正好对应前端渲染标题时打的id,点击目录就能跳。- 重复锚点去重 :两处标题文字一样(比如两个"小结"),第二次生成
anchor-1,避免 HTMLid重复导致跳转失效。seenMap 记出现次数,干净利落。
这个纯函数没有任何副作用,测试时丢一段 Markdown 字符串进去、断言输出数组即可,是典型的"把可测试性写在结构上"。
七、/search 端点:回到 LIKE 与 SCAN_LIMIT
GET /search 把搜索收口成一个端点,?q 必填(空则 400)、?type=article|member 默认 article、?sort 仅文章生效:
ts
const q = (c.req.query('q') ?? '').trim();
if (!q) throw new AppError(ErrCode.VALIDATION, 400); // 关键词为空 → 4001
const type = c.req.query('type') === 'member' ? 'member' : 'article';
// ... 委托 searchArticles / searchMembers
搜索的底层(LIKE 起步、SCAN_LIMIT 封顶、中文不分词的硬伤、升级 Meilisearch 的信号)我们在全文搜索:从 LIKE 到全文索引已经专门讲过,这里不再展开。值得补一句的是排序纪律的延续 (P-11):searchArticles 接收的 ?sort 同样走列表接口三件套:分页、筛选、排序里那套"带符号字段 + SORT_COLUMNS 白名单"机制------只允许白名单内的字段、用 - 前缀表示降序,杜绝任意列排序带来的 SQL 注入与歧义列风险。辅助接口虽处在系统边缘,安全与纪律的底线一点没降。
九、相关文章打分的一个演算示例
光看公式抽象,用一组具体数据跑一遍 getRelated 你就全懂了。假设当前文章 A:tags=[Node, 后端]、categoryId=5,候选库里有四篇已发布文章:
| 候选 | tags | 分类 | 共享标签数 | 同分类 | score = 共享×2 + 同分类 |
|---|---|---|---|---|---|
| B | Node, React | 5 | 1(Node) | 是 | 1×2 + 1 = 3 |
| C | 后端, 数据库 | 7 | 1(后端) | 否 | 1×2 + 0 = 2 |
| D | Node, 后端, 部署 | 5 | 2(Node+后端) | 是 | 2×2 + 1 = 5 |
| E | Python | 9 | 0 | 否 | 0×2 + 0 = 0 |
filter(score > 0) 先把 E(毫无交集)淘汰;剩下按 score 降序:D(5) > B(3) > C(2) 。若 ?limit=2,返回 [D, B];若 D 和 B 同分(比如都 3),再比 viewCount,热门的排前面。这套规则解释性强、可调、零外部依赖------运营想"同分类权重再高点",改 sameCat 的系数即可,不用动表结构。正是这种"可解释的轻量推荐",比直接上黑盒模型更适合教学与中小站点。顺带一提,related / toc 都属于"读多写少、计算略重"的端点,生产环境可在路由层加一层短 TTL 缓存(如 60 秒),既扛住热点又不会让推荐"永远滞后"------这是辅助接口上线后最划算的第一道优化。
十、公开铁律贯穿所有辅助接口
把"公开可见性铁律"在辅助接口上的体现汇总成一张表,能看清它是一以贯之的,不是某个端点偶尔守一下:
| 端点 | 未发布 / 软删文章的处理 |
|---|---|
/articles/:id/adjacent |
getPublishedArticle → 404,不泄露草稿存在 |
/articles/:id/related |
同上 → 404 |
/articles/:id/toc |
同上 → 404(目录也不给未发布文章生成) |
/stats |
只 sum 已发布文章,天然不暴露草稿 |
/search |
底层 searchArticles 只查 published(见 M1-19) |
也就是说,任何公开接口对草稿都"集体失明"------要么 404,要么查询结果里根本不包含。这保证了"未发布 = 互联网上不存在"这条铁律,在核心 CRUD 之外、连这些边缘辅助端点也严守。你不会因为在搜索里输入关键词、或在某篇文章的相关推荐里,意外撞见别人还没发出的内容。
十一、小结
辅助接口证明了一件事:再"边缘"的功能,也该长在统一的纪律之上:
- 端点收口 :
aux.ts把 adjacent/related/toc/stats/search 集中管理,全部公开但严守未发布 404。 - 薄路由细节 :
parseId非整数统一 404(语义贴合);路由不碰 DB,复杂度全在 service / shared。 - 相邻 :以
publishedAt为序取前后邻,全限定列排序(P-11 纪律)。 - 相关 :共享标签×2 + 同分类×1 规则打分,内存排序;读去规范化
tagsJSON 而非 JOIN(P-35 读路径选最稳源)。 - P-49 规模意识:全量内存打分在小规模最优,十万级要下推 SQL 或上检索服务。
- 目录 :
parseToc纯函数,跳过代码围栏、slugify 锚点、重复锚点-n去重,易测。 - 搜索 :
?q必填、?type/?sort,排序延续白名单纪律(P-11)。
下一篇({{LINK:M1-29}})我们聊"点赞系统":从"点赞数"这个字段,讲到怎么防止重复点赞、怎么和文章计数保持一致。
如果这篇文章对你有帮助,欢迎订阅我的 CSDN 专栏 「成为全栈」:
🔗 专栏地址:https://blog.csdn.net/fungleo/category_13204651.html
📦 本系列配套代码仓库:https://github.com/fengcms/become-a-full-stack-developer