前端拼 URL 是天天干的事,出问题却很少一眼能看出来:搜索词里的 c++ 到后端变成了 c ,文件名里带个 & 参数就被截断,日志里的中文变成 %25E5%258C,或者干脆一个 URIError: URI malformed 把整个页面打挂。
这些问题基本都出在三个地方:用错了编码函数、+ 和空格的两套规矩、编码次数不对。下面七个坑,每个都配了能直接跑的代码和实际输出(Node 25.8 实测,浏览器里行为一致)。
1. encodeURI 和 encodeURIComponent 不是一回事
先看同一个字符串分别过两个函数:
js
const u = 'https://example.com/search?q=前端 & 后端&tag=c++#top';
console.log(encodeURI(u));
console.log(encodeURIComponent(u));https://example.com/search?q=%E5%89%8D%E7%AB%AF%20&%20%E5%90%8E%E7%AB%AF&tag=c++#top
https%3A%2F%2Fexample.com%2Fsearch%3Fq%3D%E5%89%8D%E7%AB%AF%20%26%20%E5%90%8E%E7%AB%AF%26tag%3Dc%2B%2B%23top区别一句话:encodeURI 认为你给的是一整条 URL ,所以 : / ? & = # + 这些有结构意义的字符它一律不动;encodeURIComponent 认为你给的是 URL 里的一小段值 ,除了字母数字和 - _ . ! ~ * ' ( ),全部编码。
第一行看着像是「编好了」,其实已经错了:前端 & 后端 里那个 & 没被编码,后端会把它解析成 q=前端 和另一个叫 后端 的参数。
2. 给参数值编码,要用 encodeURIComponent
这是最常见的错误写法:
js
const kw = 'c++ & go';
console.log('https://example.com/s?q=' + encodeURI(kw));
console.log('https://example.com/s?q=' + encodeURIComponent(kw));https://example.com/s?q=c++%20&%20go
https://example.com/s?q=c%2B%2B%20%26%20go第一种,后端拿到的 q 是 c (两个加号被当成空格),后面的 go 变成了一个没有值的参数。第二种才是对的。
规则很简单:拼值用 encodeURIComponent,encodeURI 基本只在「手上有一整条带中文的 URL、只想把它变成合法形式」时用,实际项目里我几乎没再用过它。
3. 加号和空格:两套规矩混用
URL 里空格有两种写法:%20 和 +。+ 表示空格这件事只在 application/x-www-form-urlencoded 格式里成立,也就是表单提交和查询字符串的传统写法。encodeURIComponent 和 decodeURIComponent 不认这套规矩,URLSearchParams 认:
js
console.log(new URLSearchParams({ q: 'a b+c' }).toString());
console.log(encodeURIComponent('a b+c'));
console.log(new URLSearchParams('q=a+b%2Bc').get('q'));
console.log(decodeURIComponent('a+b%2Bc'));q=a+b%2Bc
a%20b%2Bc
a b+c
a+b+c最后一行就是坑:一个用表单规则编出来的串,拿 decodeURIComponent 去解,空格变回来的是 +,跟真正的加号再也分不开了。
我自己调试时常用福兮的 URL 编解码工具,它底层就是 encodeURIComponent / decodeURIComponent 这一对,所以正好能演示这个坑------解码框里填 a+b%2Bc%20%E5%8C%97%E4%BA%AC,出来的是 a+b+c 北京:
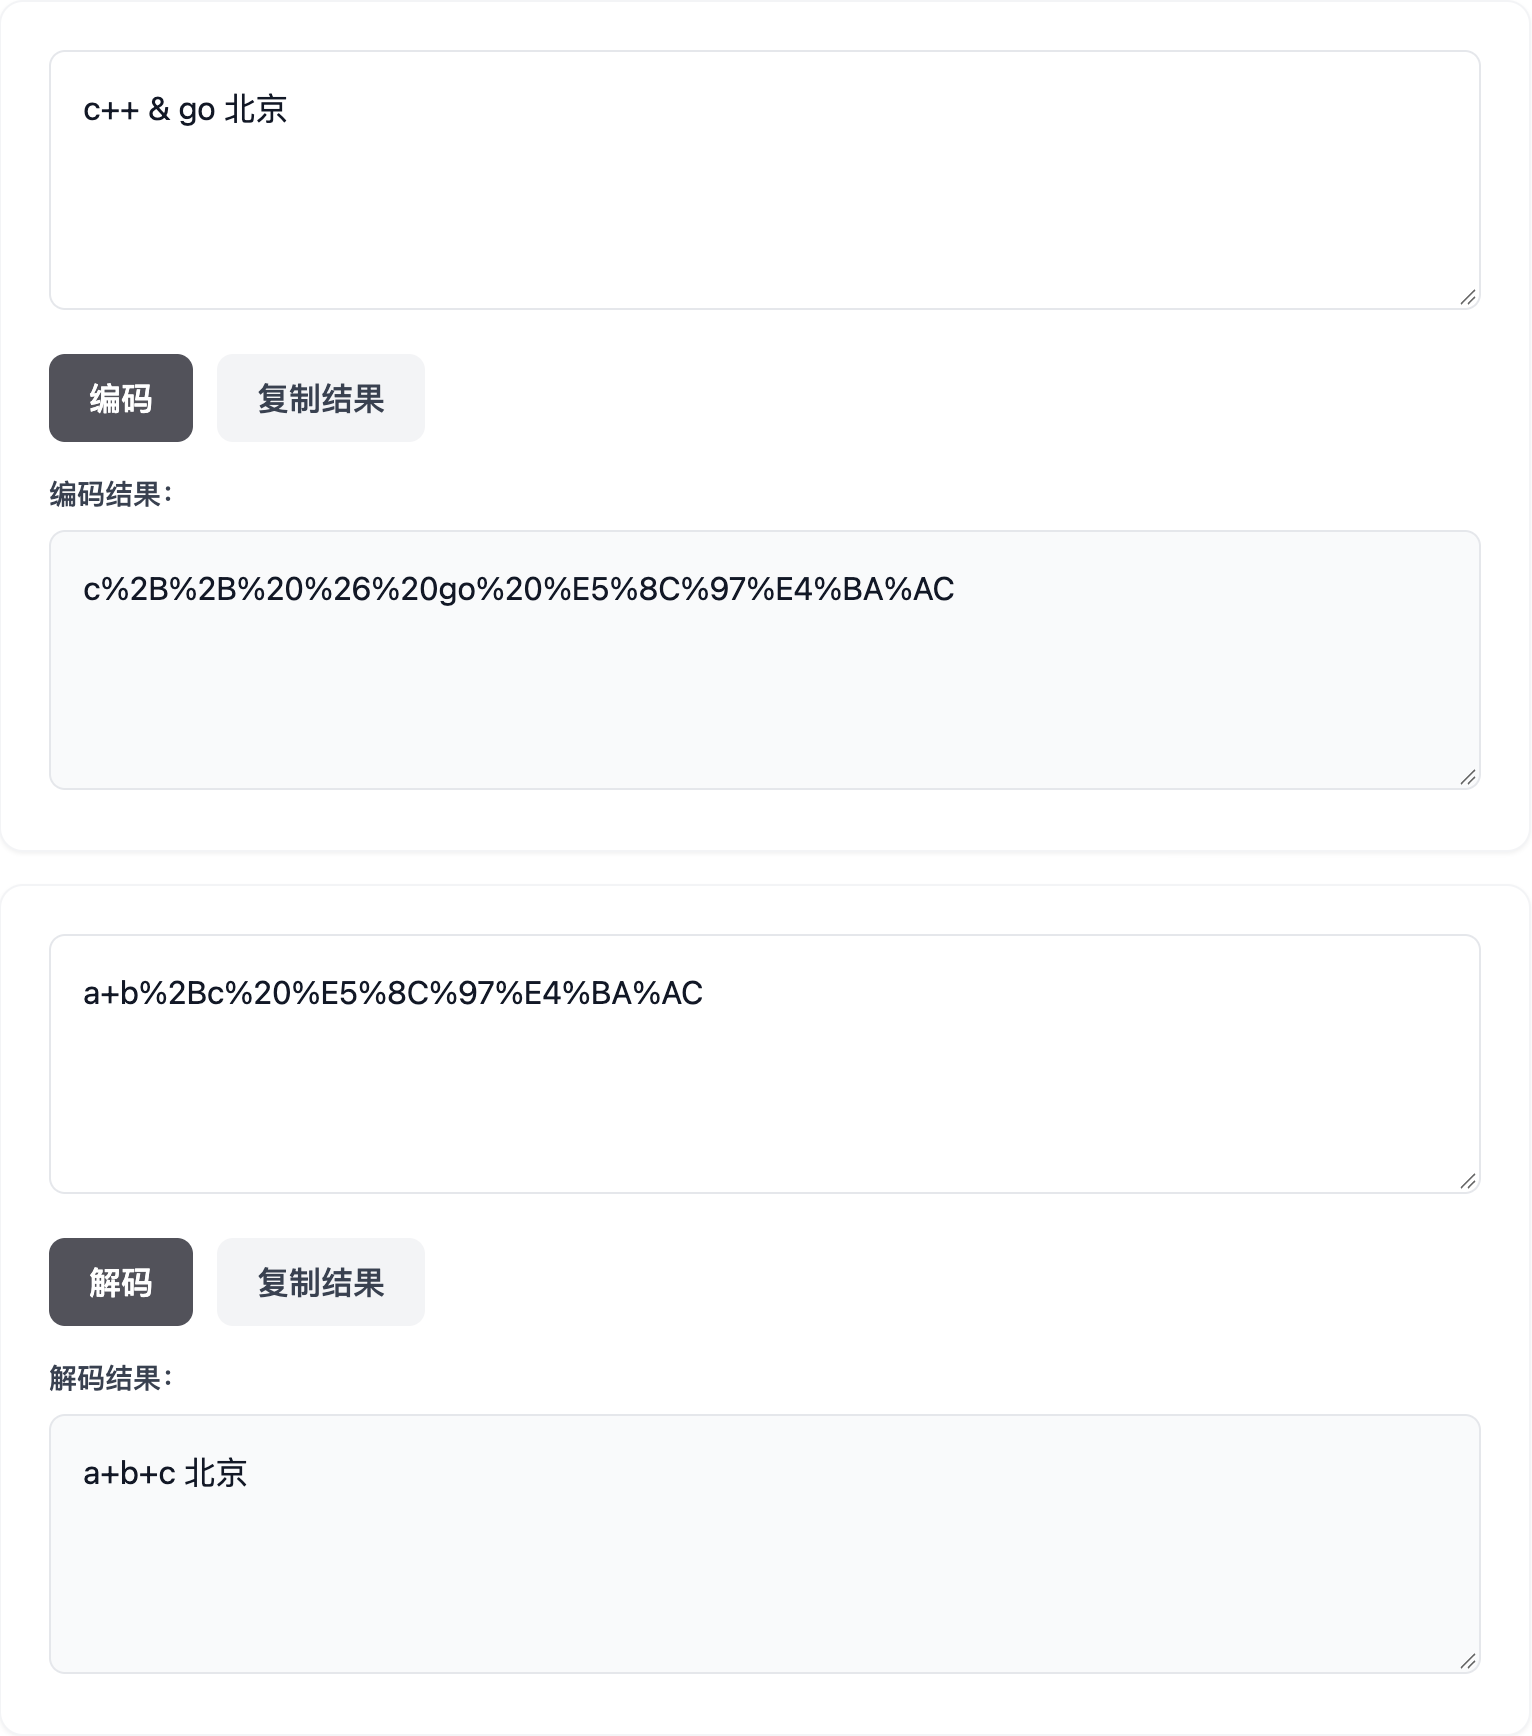
这不算工具的 bug,它严格按标准函数来;但你要清楚手上这个串是哪套规矩编的。如果是从表单或者别人系统的回调里拿到的,先把 + 换成空格再解,或者直接交给 URLSearchParams。
4. 编了两次:%25 是信号
js
const once = encodeURIComponent('北京');
console.log(once, encodeURIComponent(once));
console.log(decodeURIComponent(encodeURIComponent(once)));%E5%8C%97%E4%BA%AC %25E5%258C%2597%25E4%25BA%25AC
%E5%8C%97%E4%BA%AC% 本身编码后是 %25。所以看到 %25 后面跟着两位十六进制,基本就是编了两次。解一次只能回到第一层。
常见的来源:前端编了一次,请求库(axios 的 params、URL 对象的 searchParams)又编了一次。原则是谁拼字符串谁编码,交给库的参数就别自己先编。
5. URIError: URI malformed
decodeURIComponent 遇到不合法的序列会直接抛异常:
js
try { decodeURIComponent('100%'); } catch (e) { console.log(e.name, e.message); }
try { decodeURIComponent('%E4%B8'); } catch (e) { console.log(e.name, e.message); }URIError URI malformed
URIError URI malformed第一个是用户在搜索框里输了「100%」,前端没编码就拼进 URL,回来解的时候炸了;第二个是一个中文字符的 UTF-8 字节被截断了一半。
从地址栏、外部回调、日志里拿到的串,解码一定要包一层:
js
const safeDecode = s => {
  try {
    return decodeURIComponent(s.replace(/\+/g, ' '));
  } catch {
    return s;
  }
};
console.log(safeDecode('100%'), '|', safeDecode('a+b%20c'));100% | a b c注意那个 replace 只适合你确定来源是表单规则的情况,否则会把真正的加号也换掉,按场景取舍。
6. 截断字符串之后再编码,emoji 会把它炸掉
js
const s = '标题😀表情';
const cut = s.slice(0, 3);
console.log(JSON.stringify(cut), cut.length);
try { encodeURIComponent(cut); } catch (e) { console.log(e.name, e.message); }
console.log(encodeURIComponent([...s].slice(0, 3).join('')));"标题\ud83d" 3
URIError URI malformed
%E6%A0%87%E9%A2%98%F0%9F%98%80JS 字符串按 UTF-16 存,一个 emoji 占两个单元。slice(0, 3) 正好切在 emoji 中间,剩下半个代理对,encodeURIComponent 不是解码,它在编码 的时候就抛了。做分享链接、标题截断的时候特别容易遇到:后台截了个标题塞进 URL,带 emoji 的那几条就报错。按字符截用 [...s],或者 Intl.Segmenter。
7. URL 对象改一个参数,别的参数的空格变了
URL 和 URLSearchParams 是现在拼 URL 的推荐方式,但有一个细节:
js
const url = new URL('https://example.com/a b/文件.pdf?x=1 2');
console.log(url.href);
url.searchParams.set('name', '张三&李四');
console.log(url.href);
console.log(url.searchParams.get('name'));https://example.com/a%20b/%E6%96%87%E4%BB%B6.pdf?x=1%202
https://example.com/a%20b/%E6%96%87%E4%BB%B6.pdf?x=1+2&name=%E5%BC%A0%E4%B8%89%26%E6%9D%8E%E5%9B%9B
张三&李四只是 set 了一个 name,原来的 x=1%202 变成了 x=1+2。因为一碰 searchParams,整个查询串就按表单规则重新序列化。对标准后端没区别,但如果对面是签名校验(按原始查询串算 HMAC 的那种),签名就对不上了。遇到要签名的接口,查询串自己按对方文档拼,别让 URL 对象重排。
小结:我现在的习惯
- 拼参数值:
URLSearchParams或encodeURIComponent,不用encodeURI。 - 解外来的串:包
try/catch,先想清楚是不是表单规则(+算不算空格)。 - 看到
%25:查哪里多编了一次。 - 截断字符串:按字符截,别按 UTF-16 单元截。
- 有签名的接口:自己拼查询串,别交给
URL对象。
局限
上面这些都是浏览器和 Node 里 JS 的行为。后端各语言的默认规则不完全一样,比如有的框架解析查询串时会把 + 当空格,有的不会;Java 的 URLEncoder.encode 默认把空格编成 +,和 encodeURIComponent 的 %20 不一样。前后端对不上时,两边各自打一下原始字符串最省事。
在线快速对一下编码结果,可以用 forxi.cn 上的 URL 编解码,它是纯浏览器本地处理的,但记住它解码时不会把 + 当空格。