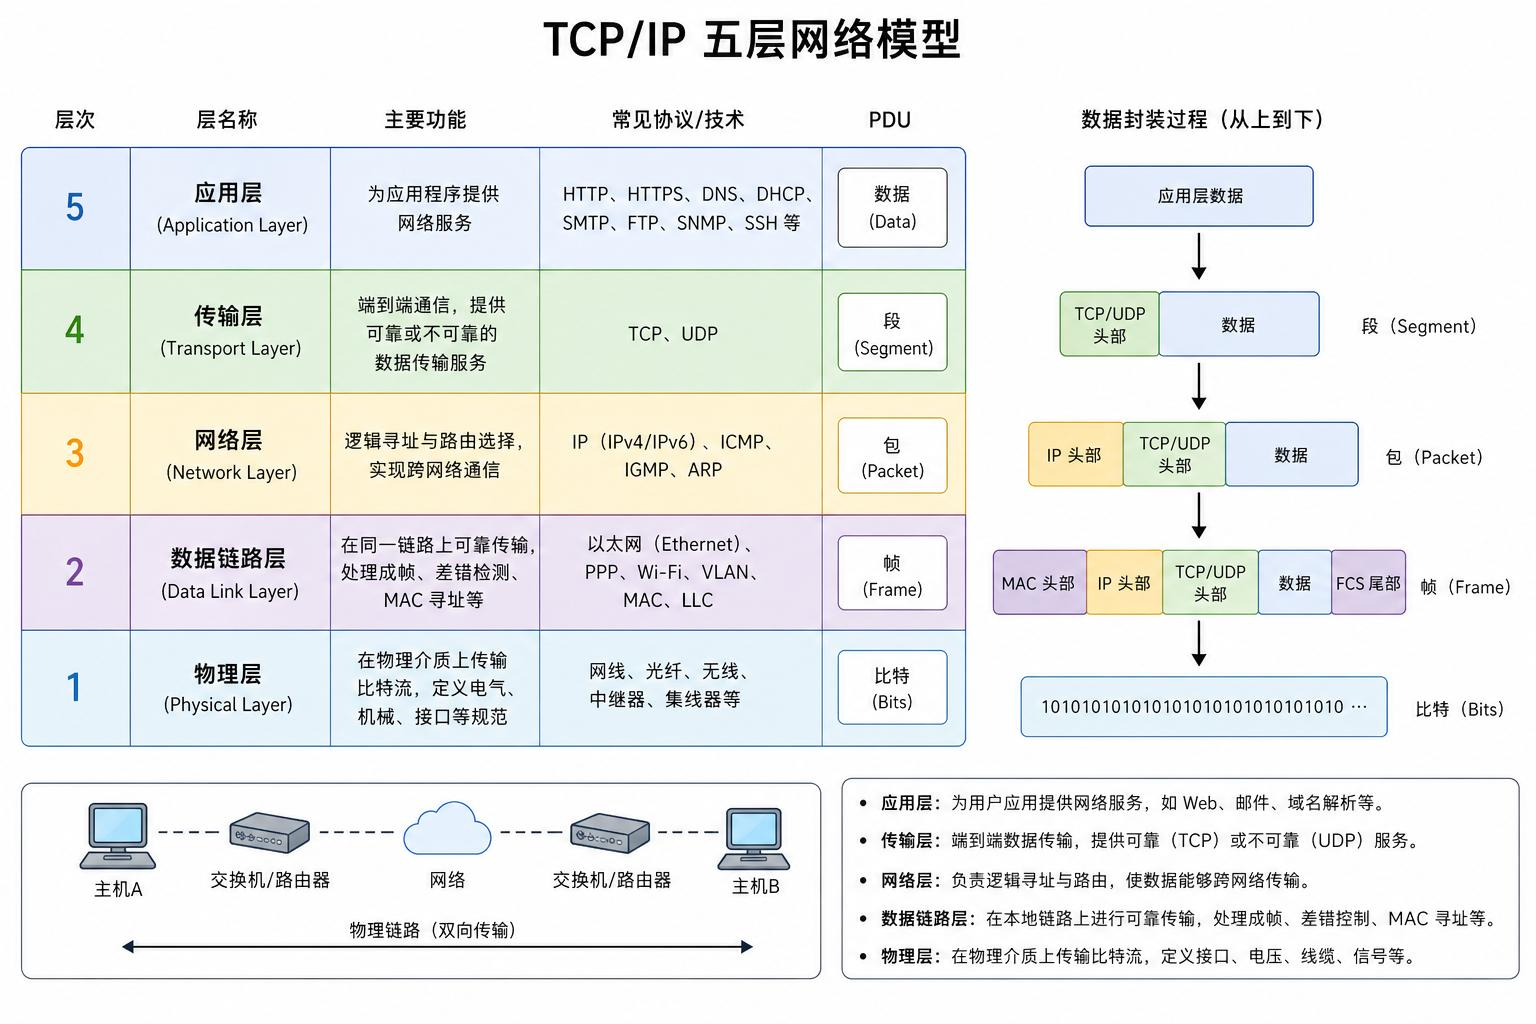
数据传播过程
用户的数据就是通过这5层的结构进行处理,处理成更方便电脑辨认,更具唯一性,方便传输的格式发给别人,别人接收到数据包之后再进行一系列处理就可以得到发送的原始数据。
举个例子:把五层网络结构想成寄快递,你在浏览器里访问一个网站,就像你要从北京寄一个包裹给上海的小明。首先你得准备"要寄的东西",比如你想对服务器发送一条消息"请把网页发给我",这就是应用层的数据,也就是首先需要确定你要通过网络发什么,也就是你要在快递包裹里面寄什么物品;
接着你要写清楚这个包裹具体交给谁,因为一台服务器里可能同时运行网页、邮件、数据库等很多程序,所以网络里会用端口号 Port 来区分具体交给哪个程序,如果把服务器比作一个大楼,端口号就是对应的房间位置,所以需要确认我的快递要寄到哪里去,是寄到办公室?前台?食堂?或者其他的什么地方,这就是传输层,TCP、UDP 也在这一层,可以理解为不同的运输公司,比如 TCP 公司更像"必须确认送到、丢了要补寄"的快递服务,而UDP快递公司不管真到了没有,只负责把数据发过去,由于没有确认的过程,所以UDP公司的发送效率更高。
然后你还得写收货地址,网络里这个地址就是IP 地址 ,它告诉整个网络"最终要送到哪台机器",也就是这栋大楼的位置,比如上海某某区某某路,这是网络层 ,中间经过的一个个路由器 Router就像快递中转站,每到一个中转站都会根据目标 IP 判断下一步往哪里送,他会识别到这是哪里的快递,如果路由器在北京,看到寄到上海的快递就会把信息往南送,如果看到黑龙江的快递就会往北送,有的路由器知道上海在哪里,有的不知道,虽然他们自己不知道,但是每个路由器可以去找其他驿站,总会有一个驿站知道在哪里;
不过光知道最终地址还不够,在当前这个中转站还要决定"下一步具体交给谁",这时候就会用到MAC 地址 ,所以可以简单理解成:IP 管最终去哪,MAC 管当前这一跳交给谁,这属于数据链路层,也就是说,驿站A有自己唯一的名字,驿站B也有自己唯一的名字,当A把包裹给B的时候,就会写上发送人是A,接收人是B,等到B驿站向C发送的时候,又会改成发送人是B,接收人是C;
最后,所有这些信息准备好以后,包裹总得真的动起来,快递靠货车、飞机,网络就靠网线里的电信号、光纤里的光信号或者 Wi-Fi 的无线电波,把数据最终变成一串 0 和 1 传出去,这就是物理层。
网络中的各种名称
五层模型中的各类名词
| 层 | 主要负责什么 | 常见协议 / 设备 | 数据常叫做 |
|---|---|---|---|
| 应用层 Application | 给具体应用提供网络服务 | HTTP、HTTPS、DNS、SMTP | Message / 数据 |
| 传输层 Transport | 负责两个程序之间的数据传输 | TCP、UDP | Segment / Datagram |
| 网络层 Network | 决定数据从哪台机器走到哪台机器 | IP、ICMP、Router | Packet |
| 数据链路层 Data Link | 负责同一个局域网内设备之间通信 | Ethernet、Wi-Fi、MAC、Switch | Frame |
| 物理层 Physical | 真正传输 0 和 1 | 网线、光纤、无线电波 | Bit |
这里面最容易混淆的几个名词,可以重点理解。
协议 Protocol 就是一套通信规则。两台机器要沟通,必须约定怎么说。例如 HTTP 规定浏览器和 Web 服务器怎么交流,TCP 规定怎么可靠传输数据,IP 规定数据包怎么在网络中传递。
可以类比成:
Protocol ≈ 双方都遵守的语言和规则IP 地址
可以理解为网络上的"地址"。类比为现实世界的收货地址"北京某区某街道..."例如:
192.168.1.5
8.8.8.8
IP 最主要出现在网络层。
MAC 地址
是网卡的链路层地址,类比为每个人的身份证号比如:
00:1A:2B:3C:4D:5EMAC 主要用于局域网内部通信,属于数据链路层。
Port 端口号
属于传输层。它解决的不是"哪台电脑",而是:
这台电脑上的哪个程序?
比如一个服务器同时运行 Web 服务和其他服务,只有 IP 是不够的。
所以你可以记一个特别重要的关系:
IP → 找计算机
Port → 找计算机里的程序
MAC → 找当前局域网里的网卡
例如:
142.250.x.x:443前面是 IP,表示服务器;443 是端口,通常表示 HTTPS 服务。
TCP
是一种传输层协议,特点是比较可靠。它会考虑数据有没有丢、顺序对不对、要不要重新发送。所以网页、文件传输之类的场景经常使用 TCP。
你可以先把 TCP 理解成:
"我不仅要发给你,还要尽量确保你正确收到。"UDP
也是传输层协议,但它比 TCP 简单,不负责很多可靠性机制。
可以粗略理解为:
TCP:你收到了吗?
UDP:我发了,你自己看着办。
所以一些对实时性要求高、可以容忍少量丢包的场景可能会使用 UDP。不过实际应用会更复杂,比如 HTTP/3 使用 QUIC,而 QUIC 是建立在 UDP 之上的。
Router 路由器
主要工作在网络层,核心任务是:
根据 IP 地址决定数据包下一步往哪走。
你可以把路由器想象成互联网中的"交通路口"。
易混数据名称
应用层:Data / Message
   ↓
传输层:Segment
   ↓
网络层:Packet
   ↓
数据链路层:Frame
   ↓
物理层:Bit
为什么同一份数据有这么多名字?因为每一层都会在数据上添加自己需要的信息。
比如原本应用层只有:
HelloTCP 会给它加一些 TCP 信息:
[TCP Header][Hello]IP 再加一层:
[IP Header][TCP Header][Hello]Ethernet 再包一层:
[Ethernet Header][IP Header][TCP Header][Hello][Trailer]这个过程就叫:
Encapsulation(封装)。
接收方则反过来一层层拆掉:
Frame
 ↓
Packet
 ↓
Segment
 ↓
Application Data这叫解封装 Decapsulation。
就相当于寄快递需要在包裹上面贴运输单,只不过在网络里每经过一层都要往之前的单子上覆盖的贴一层,在接受的时候也要一层一层撕掉,找到这个包裹真正需要送到的地方。
所以五层模型最核心的思想,其实可以浓缩成这样:
应用层:我要说什么?
        ↓
传输层:我要交给哪个程序?怎么传?
        ↓
网络层:我要送到哪台机器?
        ↓
数据链路层:这一跳具体交给谁?
        ↓
物理层:怎么把 0 和 1 真正发出去?
实际网络处理过程
同一份应用数据,在经过五层的时候到底被怎样处理,以及它在网络中真正发生了什么变化。
应用层
假设你的浏览器已经知道服务器的 IP,现在要向服务器发送一条请求。最开始,在应用层 ,浏览器产生的是一段有具体含义的数据,比如一个 HTTP 请求。对浏览器来说,它关心的是"我要请求哪个页面、带哪些参数、Cookie 是什么"等内容。到了操作系统下面的网络协议栈以后,这些具体含义其实就逐渐不重要了------下面几层基本只把它当作一串字节来处理。如果使用 HTTPS,那么在向下交给传输层之前,这部分数据通常已经经过 TLS 加密,所以 TCP 看到的往往不是可读的 "GET /...",而是一串加密后的字节。也就是说,应用层最终向下一层交出去的,本质上就是一段 bytes。
传输层
接下来数据来到传输层 。假设使用 TCP,TCP 首先要解决一个现实问题:应用给我的数据可能很大,我不一定能一次全部发送。所以 TCP 会把这段连续的数据根据情况拆成适合传输的一段一段。注意,从应用程序的角度,它可能只是写入了一大块数据,但 TCP 会自己决定实际如何分段。然后 TCP 会在每一段数据前面加入自己的控制信息,其中最重要的概念包括源端口、目标端口、序号、确认信息等。这里不用管它们各占几个字节,只需要理解为什么需要它们。端口告诉接收端"这份数据最后应该交给哪个程序";序号告诉接收端"这一段数据在整个数据流中的什么位置";确认等信息用来处理可靠传输。所以到了这一层,原来的数据已经变成类似:
[TCP 控制信息][应用数据的一部分]这个整体我们通常叫 TCP Segment(TCP 段)。
这里有一个很关键的认识:TCP 并没有在乎目标电脑到底在哪里。 TCP 知道目标端口,但它不负责寻找那台机器。比如 TCP 知道"我要交给目标机器的 443 端口",但"目标机器在哪、怎么到那里"不是 TCP 的工作。因此 TCP 把这一整段东西继续交给网络层。
网络层
到了网络层 ,IP 会把刚才整个 TCP Segment 当作自己的"数据"。IP 不去解析里面的 HTTP,也基本不关心 TCP 的具体业务,它只知道:"我现在有这么一块数据,需要把它送到另一台机器。"于是 IP 在前面继续加入自己的信息,最核心的是源 IP 地址和目标 IP 地址,另外还有 TTL、协议类型等控制信息。于是数据进一步变成:
[IP Header][TCP Header][Application Data]现在这个整体通常称为一个 IP Packet(IP 数据包)。
这时候数据已经具备了"跨网络旅行"的能力。比如:
源 IP:你的电脑
目标 IP:服务器
IP 层会查看自己的路由表 ,判断目标 IP 应该往哪里发送。这里非常容易有一个误区:你的电脑通常不会直接把数据"发给服务器"。它只是判断:目标服务器不在我当前这个局域网里,所以我应该先把这个 IP Packet 交给默认网关,也就是家里的路由器,下面都称发送为跳。
然后就出现了一个非常重要的变化:IP 层已经知道最终目标是谁,但它还不知道当前这一跳具体怎么发送。
数据链路层
假设电脑判断下一跳是家里的路由器。那么这一层现在要解决的问题就是:"我怎么把这个 IP Packet 真正在当前局域网里交给路由器?"
这时候需要 MAC 地址。电脑可能已经知道路由器的 MAC;如果不知道,会通过 ARP(IPv4)或者类似机制去确定它。知道之后,数据链路层会把刚才整个 IP Packet 当成自己的数据,再给外面套上一层链路层信息,比如:
[Ethernet Header]
    [IP Header]
        [TCP Header]
            [Application Data]
[校验信息]
Ethernet Header 里面最重要的就是:
源 MAC = 我的网卡
目标 MAC = 路由器的网卡
现在整个东西称为一个 Frame(帧)。
所以你会发现这里有一个特别重要的结构:
Frame
└── IP Packet
    └── TCP Segment
└── Application Data这就是所谓的封装 Encapsulation。不是数据真的变成了四份,而是外面不断套新的控制信息。
物理层
物理层已经完全不理解什么 IP、TCP、HTTP 了。在它眼里,只剩下:
101101001010...网卡会按照 Ethernet、Wi-Fi 等具体技术规定,把这些 bit 编码成真正可以传播的物理信号。如果是网线,可能变成电信号;如果是光纤,变成光信号;如果是 Wi-Fi,则变成无线电信号。
于是:
Application Data
↓
TCP Segment
↓
IP Packet
↓
Ethernet Frame
↓
Bits
↓
Physical Signal
这时候数据终于真正离开你的电脑。
数据从电脑出发的下一步
Ethernet Frame
假设第一站到了你家的路由器 。路由器的网卡首先从物理信号中重新识别出 0 和 1,然后数据链路层重新拼出一个完整的 Ethernet Frame。路由器看到:
目标 MAC = 我所以它知道这个 Frame 是发给自己的。
接着路由器会把 Ethernet Header 去掉:
也就是去掉双方的MAC地址,相当于去掉收件人发件人的信息。
原来:

[Ethernet Header]
[IP Header]
[TCP Header]
[Application Data]

去掉链路层之后:

[IP Header]
[TCP Header]
[Application Data]
这时候有一个非常重要的事实:
Ethernet Frame 到路由器这里基本就结束使命了。
IP Packet
路由器真正关心的是里面的 IP Packet。它查看目标 IP,发现目标 IP 并不是自己,于是查自己的路由表:
目标 IP → 下一跳应该走这个接口IP Packet 在路由器这里会有少量变化。最典型的是 TTL 会减少,因为每经过一个路由器就算一跳。这是为了防止数据因为错误路由永远在网络里循环,也就是说TTL相当于一个计数器,跳一次就减少一个,等减少到0就肯定是有问题的,这个段数据就可以扔了。除此之外,正常转发情况下:
源 IP
目标 IP
TCP Header
Application Data
通常不会因为普通路由转发而改变。然后路由器需要把这个 IP Packet 发送到下一跳。注意,现在旧的 Ethernet Frame 已经没有用了,因为刚才那个 Frame 描述的是:
我的电脑 → 家里的路由器而现在要发送的是:
家里的路由器 → 下一个网络设备所以路由器会重新创建一个新的 Frame:
[新的 Ethernet Header]
    [原来的 IP Packet]
假设下一跳是运营商的设备,那么现在可能变成:
源 MAC = 路由器当前接口的 MAC
目标 MAC = 下一跳设备的 MAC
于是整个旅程会出现这种情况:
第 1 跳:

源 MAC:你的电脑
目标 MAC:家里路由器

源 IP:你的电脑
目标 IP:服务器
到了下一跳:
第 2 跳:

源 MAC:家里路由器
目标 MAC:运营商下一跳设备

源 IP:你的电脑
目标 IP:服务器
再下一跳:
第 3 跳:

源 MAC:当前路由设备
目标 MAC:下一台路由设备

源 IP:你的电脑
目标 IP:服务器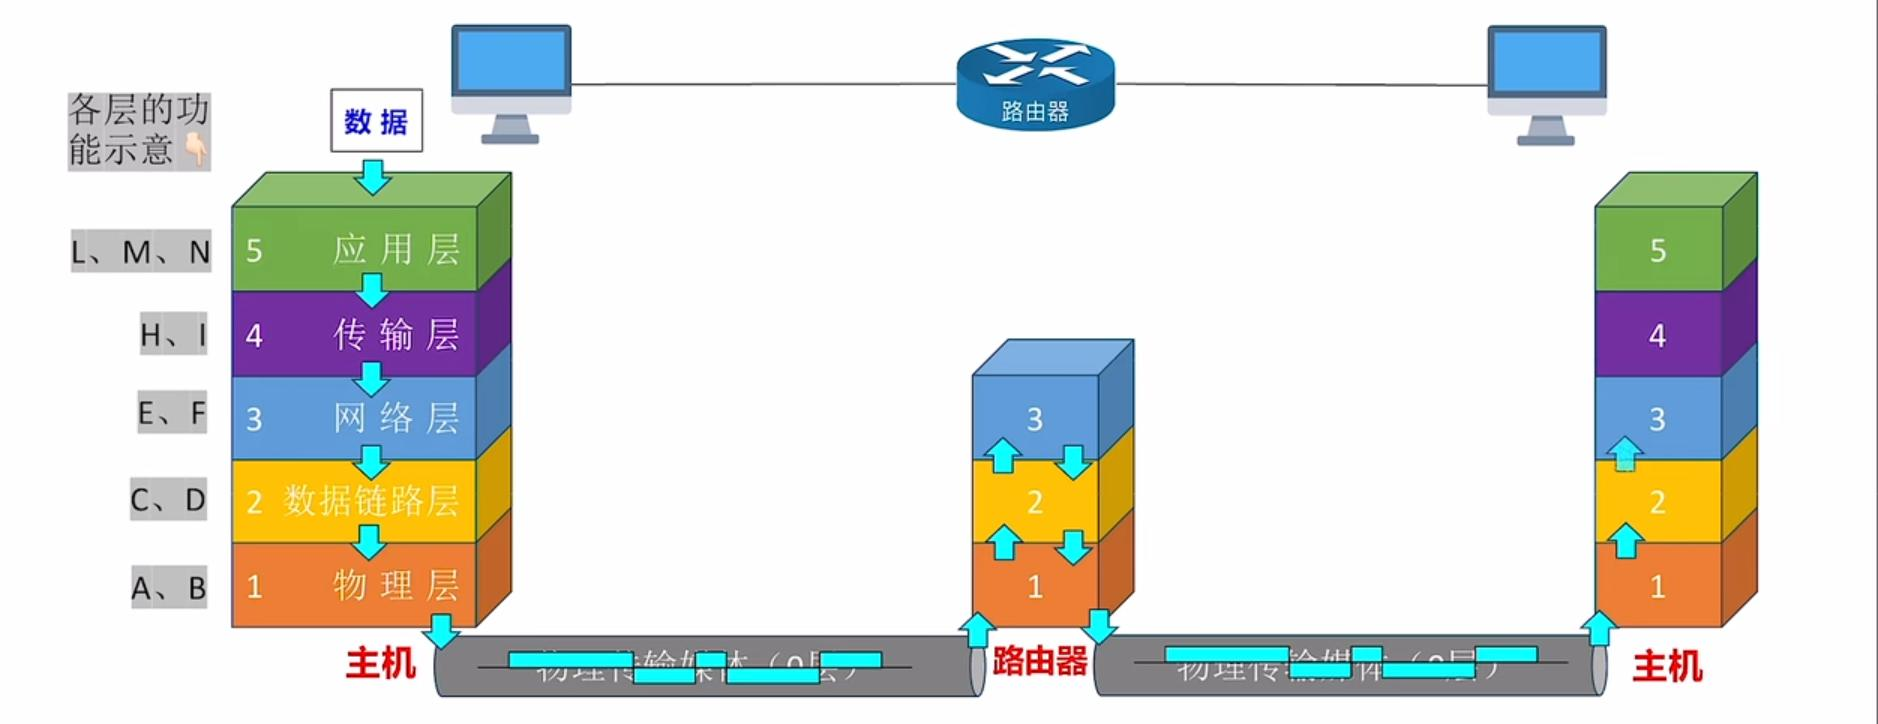
所以有一个极其重要的规律:
MAC 地址通常是一跳一换,而源 IP 和目标 IP 通常贯穿整个端到端传输。
这也就是为什么之前说:
IP:最终要去哪
MAC:这一跳交给谁
更加准确。
数据可能经过十几个甚至几十个路由器。每经过一次路由器,基本都会经历:
收到物理信号
↓
恢复 Frame
↓
去掉这一跳的链路层 Header
↓
拿出 IP Packet
↓
检查目标 IP
↓
查询路由表
↓
决定下一跳
↓
给 IP Packet 套上新的链路层 Header
↓
形成新的 Frame
↓
重新变成物理信号
↓
发送
所以从真正的网络运行角度来看,不应该把数据想成一个完整的"包裹"从头到尾完全不变。更准确的理解是:
IP Packet 在网络里不断前进

而每走一段链路,
都会重新套上适合"这一跳"的 Frame。
可以画成这样:
你的电脑

[MAC A → MAC R1]
    [IP A → IP B]
        [TCP]
            [Data]

          ↓

路由器 R1

[MAC R1 → MAC R2]
    [IP A → IP B]
        [TCP]
            [Data]

          ↓

路由器 R2

[MAC R2 → MAC R3]
    [IP A → IP B]
        [TCP]
            [Data]

          ↓

......

          ↓

目标服务器
这张图其实非常接近真实网络的核心过程。
NAT的概念
当然现实里还存在 NAT。比如你的电脑可能使用:
192.168.1.10这种私有 IP。经过家里的路由器访问互联网时,NAT 可能会把:
源 IP:192.168.1.10改成:
源 IP:你的公网 IP甚至连源端口也一起修改。所以"IP 从头到尾不变"只是正常路由转发的基本模型,NAT 是非常常见的例外。不过这并不影响理解五层模型。
解封装
最终数据抵达服务器以后,过程开始反过来,这叫解封装 Decapsulation。
服务器的物理层首先接收到电信号、光信号或者无线信号:
Signal
↓
Bits
数据链路层把这些 bit 识别成 Frame,并检查:
目标 MAC 是不是我?
Frame 有没有明显传输错误?
如果正确,就去掉链路层的信息,把里面的:
IP Packet交给网络层。
网络层检查:
目标 IP 是不是我?发现确实是自己,就把 IP Header 去掉,然后看里面标记的上层协议,比如:
这是 TCP于是:
TCP Segment被交给 TCP。
TCP 接着检查:
目标端口是多少?
序号是多少?
有没有丢数据?
有没有乱序?
例如发现目标端口:
443那么操作系统就知道这是某个正在监听 443 端口的服务的数据。
而且如果之前的数据被拆成:
Segment 1
Segment 2
Segment 3
Segment 4
即使网络中实际到达的顺序是:
Segment 1
Segment 3
Segment 2
Segment 4
TCP 也可以根据序号重新整理:
1 → 2 → 3 → 4如果发现某一部分没有正常收到,在 TCP 的可靠传输机制下还可能要求重新发送。
最终 TCP 会重新恢复出应用应该看到的那一串数据,把它交给对应的应用程序。
于是服务器应用真正看到的是:
Application Data而不是:
MAC Header
IP Header
TCP Header
...
那些信息都是操作系统协议栈在下面处理的。
所以从服务器应用的视角来看,它可能只是:
read()
↓
得到一串 bytes
然后 HTTPS/TLS 层进行解密,HTTP 再解释这些字节的含义:
原始 bytes
↓
TLS 解密
↓
HTTP Request
↓
"客户端想请求首页"
服务器处理完请求,再生成响应,然后完全重复一次相反方向的过程:
服务器应用生成 Response

↓ Application Layer

HTTP / HTTPS Data

↓ Transport Layer

TCP:
分段
加入端口、序号等

↓ Network Layer

IP:
加入服务器 IP、客户端 IP

↓ Data Link Layer

Frame:
加入当前这一跳的 MAC

↓ Physical Layer

Bits → Signal

↓
↓ 经过很多路由器
↓

客户端
所以如果你想真正理解五层网络,可以把整个过程压缩成这张图:
发送端

Application
    Data
     ↓
Transport
    [TCP][Data]
     ↓
Network
    [IP][TCP][Data]
     ↓
Data Link
    [MAC][IP][TCP][Data]
     ↓
Physical
    010101010...
     ↓
========================
       网络传输
========================
     ↓
路由器:
Frame 拆掉
↓
读取 IP
↓
选择下一跳
↓
重新生成新的 Frame
↓
继续发送
     ↓
========================
     ↓
接收端

Physical
    010101
     ↓
Data Link
    Frame
     ↓ 去掉链路层信息
Network
    IP Packet
     ↓ 去掉 IP Header
Transport
    TCP Segment
     ↓ 排序、重组、找端口
Application
原始应用数据在传输中有三个核心变化:第一,发送端从上到下不断封装,应用数据变成 Segment → Packet → Frame → 信号;第二,中间路由器不会一路保留同一个 Frame,而是每一跳拆掉旧的链路层信息,再重新生成下一跳的 Frame;第三,接收端从下往上一层层解封装,最终 TCP 根据端口和序号等信息,把原来的数据恢复出来交给应用程序。
如果把这三个过程真正理解了,后面的 ARP、路由表、默认网关、NAT、TCP 三次握手就会非常容易串起来。