摘要:本文以一套可运行的 Prometheus + Grafana 监控告警体系为主线,覆盖 Exporter 指标采集、PromQL 查询、告警规则与 Alertmanager 通知落地,最后用 Grafana 出图并给出 docker-compose 一键部署与生产建议,帮助运维与开发搭建自己的可观测性底座。
导语
服务器半夜宕机、磁盘悄悄写满、接口延迟飙升却没人知道------这是很多团队起步时的真实处境。监控告警不是"有了就行",而是要能采集到指标、查得出来、报得出去。
Prometheus 与 Grafana 是当今云原生监控的事实组合:前者负责拉取(pull)时序指标与告警判定,后者负责把数据变成一眼能懂的图。本文不堆概念,全程贴可运行配置。
声明:本文基于个人使用体验,非商业推广。
一、监控告警体系全景:Prometheus 与 Grafana 如何分工
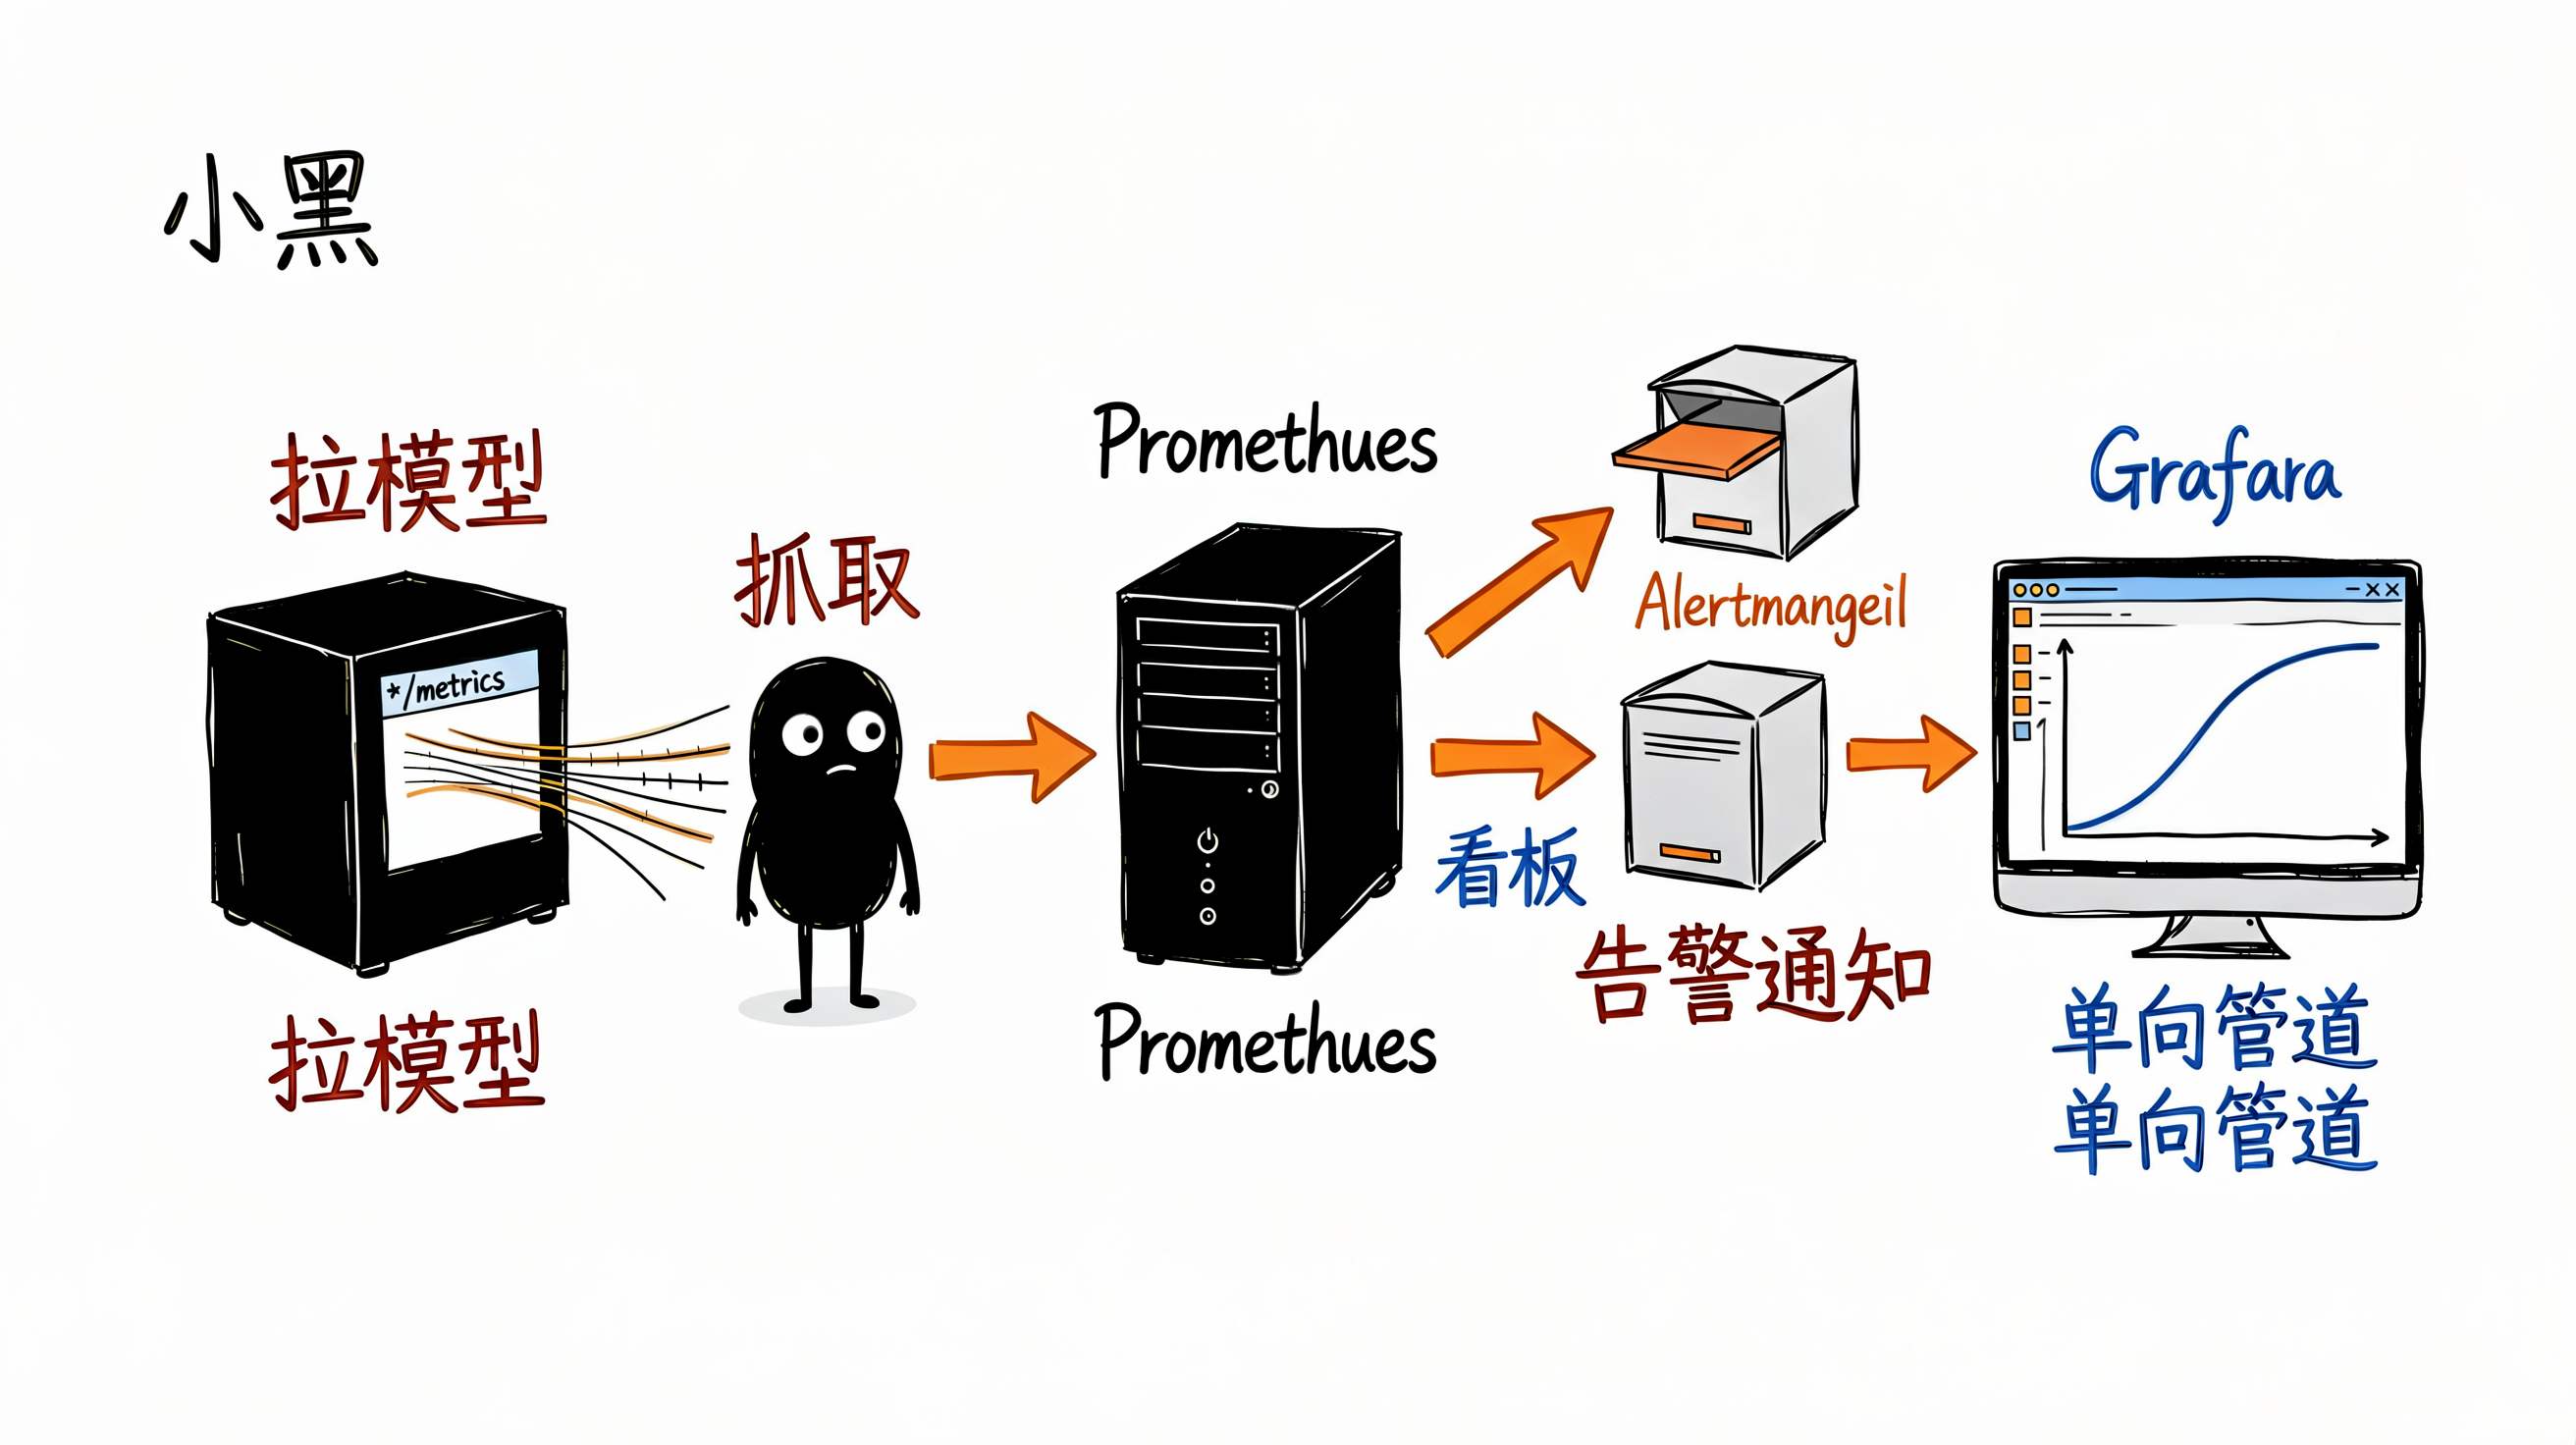
传统监控(如 Nagios)多靠被监控端主动推送(push)或定时探活,指标维度有限、扩展困难。Prometheus 采用拉模型 :服务端按配置周期性地主动抓取(scrape)各目标的 /metrics 接口,天然契合动态变化的容器环境。
一个最小可用体系的组件分工如下:
- Exporter :把系统/中间件的内部状态翻译成可抓取的指标文本,例如
node_exporter暴露主机 CPU、内存、磁盘。 - Prometheus Server:定时抓取、存储时序数据,并用 PromQL 做查询与告警判定。
- Alertmanager:接收触发的告警,负责分组、去重、路由与通知(邮件/Webhook/企业微信等)。
- Grafana:接入数据源,用仪表盘把指标可视化。
整体数据流是一条单向管道:
text
[node_exporter] --/metrics--> [Prometheus scrape]
                                      |
                                      |-- 存储时序库
                                      |-- 评估告警规则 --> [Alertmanager] --> 邮件/Webhook/企业微信
                                      |
                          [Grafana 查询 PromQL] --> 仪表盘
本文主线就是沿这条链路,从采集一路走到告警落地与出图。拉模型还有一个好处:新增节点只需注册到服务发现,Prometheus 会自动发现并抓取,无需在被监控端写死上报地址,这正是它适配 Kubernetes 这类动态环境的原因。
二、Exporter 指标采集:让系统指标可被抓取
Exporter 本质是一个 HTTP 服务 :它按文本格式,在 /metrics 路径暴露形如 metric_name{label="v"} value 的样本。任何能被观测的组件,只要暴露这个接口,就能被纳入监控。
以主机监控为例,下载并启动 node_exporter(默认监听 9100 端口):
bash
# 解压后直接运行,默认监听 :9100
./node_exporter --web.listen-address=:9100

# 另开终端验证指标接口是否就绪
curl -s http://localhost:9100/metrics | head -n 5
# 预期输出包含 HELP/TYPE 与 node_cpu_seconds_total 等指标
只要 curl 能拿到以 # HELP 开头的文本,采集端就准备好了。同时 Prometheus 会为每个目标自动生成 up 指标(值为 1 表示存活、0 表示失联),它正是后面宕机告警的判断依据。接下来告诉 Prometheus 去哪里抓。编辑 prometheus.yml:
yaml
global:
  scrape_interval: 15s        # 全局抓取间隔,默认 1m
  evaluation_interval: 15s    # 规则评估间隔,默认 1m

scrape_configs:
  - job_name: 'node'
    static_configs:
      - targets: ['localhost:9100']
配置生效后,访问 Prometheus 的 localhost:9090 表达式浏览器,输入 up 即可看到各目标存活状态,这是确认采集成功的捷径。默认抓取超时 scrape_timeout 为 10s、指标路径 /metrics,通常无需改动;若目标响应慢可调大,但不能超过 scrape_interval。
当目标数量随业务增长,硬编码 targets 会难以维护。用 file_sd(基于文件的服务发现) 把目标外置成 JSON,Prometheus 会自动热加载:
json
[
  { "targets": ["10.0.0.11:9100"], "labels": { "env": "prod" } },
  { "targets": ["10.0.0.12:9100"], "labels": { "env": "prod" } }
]
yaml
# prometheus.yml 中改用 file_sd
scrape_configs:
  - job_name: 'node'
    file_sd_configs:
      - files: ['targets/node.json']
        refresh_interval: 5m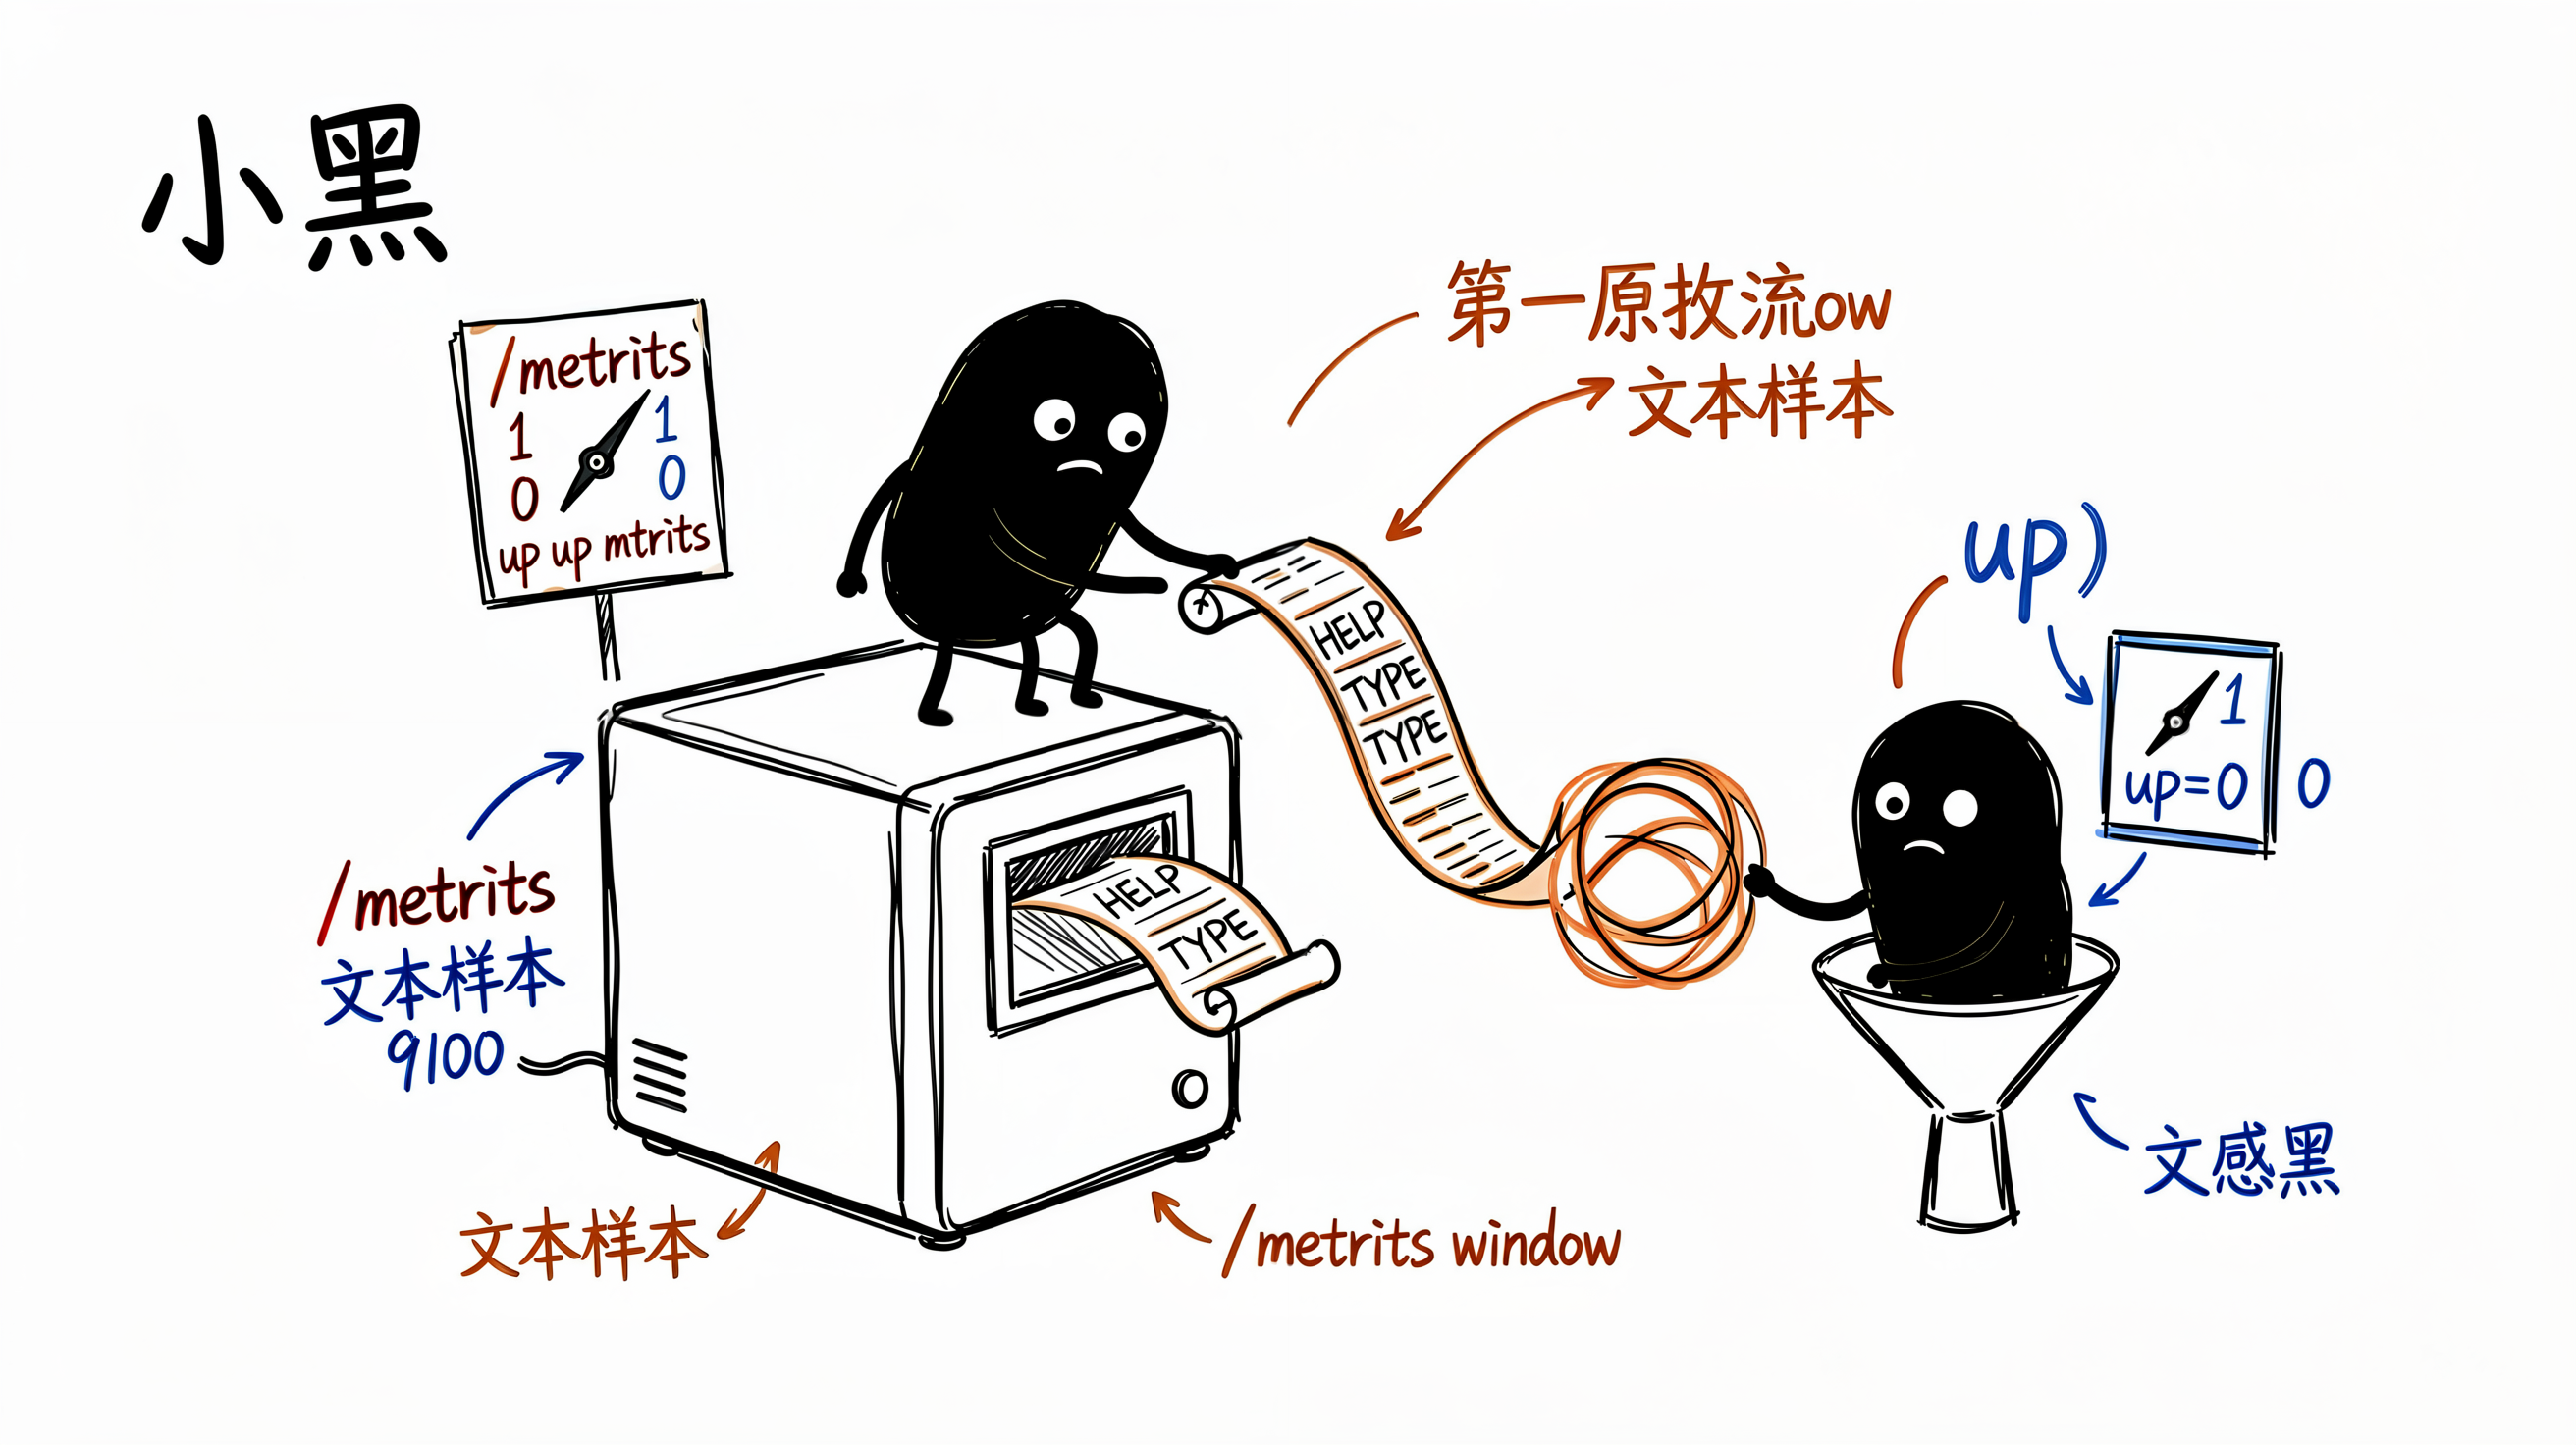
三、PromQL 查询语言:把指标变成洞察
PromQL 是查询语言,理解它的数据类型是写对查询的前提。Prometheus 有四种数据类型:
- Counter(计数器):只增不减的累计值,如请求总数,适合算速率。
- Gauge(仪表):可增可减的瞬时值,如内存使用量。
- Histogram(直方图):对观测值分桶统计,如请求耗时分布。
- Summary(摘要):类似 Histogram,但按分位数直接计算。
标签(label)是 PromQL 的灵魂。匹配运算符有四种:=(等于)、!=(不等于)、=~(正则匹配)、!~(正则不匹配)。下面这组查询是日常排障的高频动作,例如 node_cpu_seconds_total{job="node",mode!="idle"} 只取非空闲 CPU,配合 =~"db.*" 还能按正则圈定一批实例:
promql
# CPU 使用率(排除 idle):rate 取 1m 窗口平均每秒增量
100 - (avg by(instance)(rate(node_cpu_seconds_total{mode="idle"}[1m])) * 100)

# 内存使用率
100 * (1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes)

# 根分区磁盘使用率
100 * (1 - node_filesystem_avail_bytes{mountpoint="/"} / node_filesystem_size_bytes{mountpoint="/"})

# 网卡入向速率(字节/秒)
rate(node_network_receive_bytes_total{device="eth0"}[1m])
rate() 与 irate() 都计算区间增长率:rate 取整个时间窗口的平均,抗锯齿、适合画趋势图;irate 只取窗口内最后两个点,更灵敏、适合看瞬时尖刺。生产出图多用 rate,看抖动多用 irate。聚合函数与标签配合是另一大用法:sum(rate(node_cpu_seconds_total[1m])) 可把多实例指标加总成集群视图,count(up) 能直接数出存活实例数,配合 by (job) 还能按业务分组统计。区间选择器 [1m]、[5m] 的窗口要明显大于抓取间隔,否则 rate 会因样本不足而返回空值,一般取抓取间隔的 4 倍以上为宜。
四、告警规则:用 Alerting Rule 定义阈值
告警规则写在独立的规则文件里,由 prometheus.yml 的 rule_files 引入,并按 evaluation_interval 周期性评估。一个 alert 规则由触发表达式、持续时间 for、标注 annotations、分组标签 labels 组成:
yaml
# rules/alert.yml
groups:
  - name: node-alerts
    rules:
      - alert: InstanceDown
        expr: up == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "实例 {{ $labels.instance }} 宕机"
          description: "{{ $labels.instance }} 已失联超过 1 分钟"

      - alert: CpuOverload
        expr: 100 - (avg by(instance)(rate(node_cpu_seconds_total{mode="idle"}[1m])) * 100) > 85
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "{{ $labels.instance }} CPU 过载"
其中 for 表示表达式持续为真多久才真正触发,能过滤瞬时抖动;annotations 支持 Go 模板,{``{ $labels.instance }} 会替换成实际标签值,让通知更易读。labels 里的 severity 后续正好被 Alertmanager 用来做路由。
当多个面板反复使用同一段复杂 PromQL 时,Recording Rule 把结果物化存储,既能提速又保证各看板口径一致。它本质是预先把查询算成一条新时序,因此大盘几十个面板同时刷新时直接读预计算结果,数据库压力明显下降。
yaml
groups:
  - name: node-recording
    rules:
      - record: job:node_cpu_utilization:ratio
        expr: 1 - avg by(job)(rate(node_cpu_seconds_total{mode="idle"}[5m]))
对应的 prometheus.yml 引入规则文件,并指向 Alertmanager:
yaml
rule_files:
  - 'rules/*.yml'

alerting:
  alertmanagers:
    - static_configs:
        - targets: ['localhost:9093']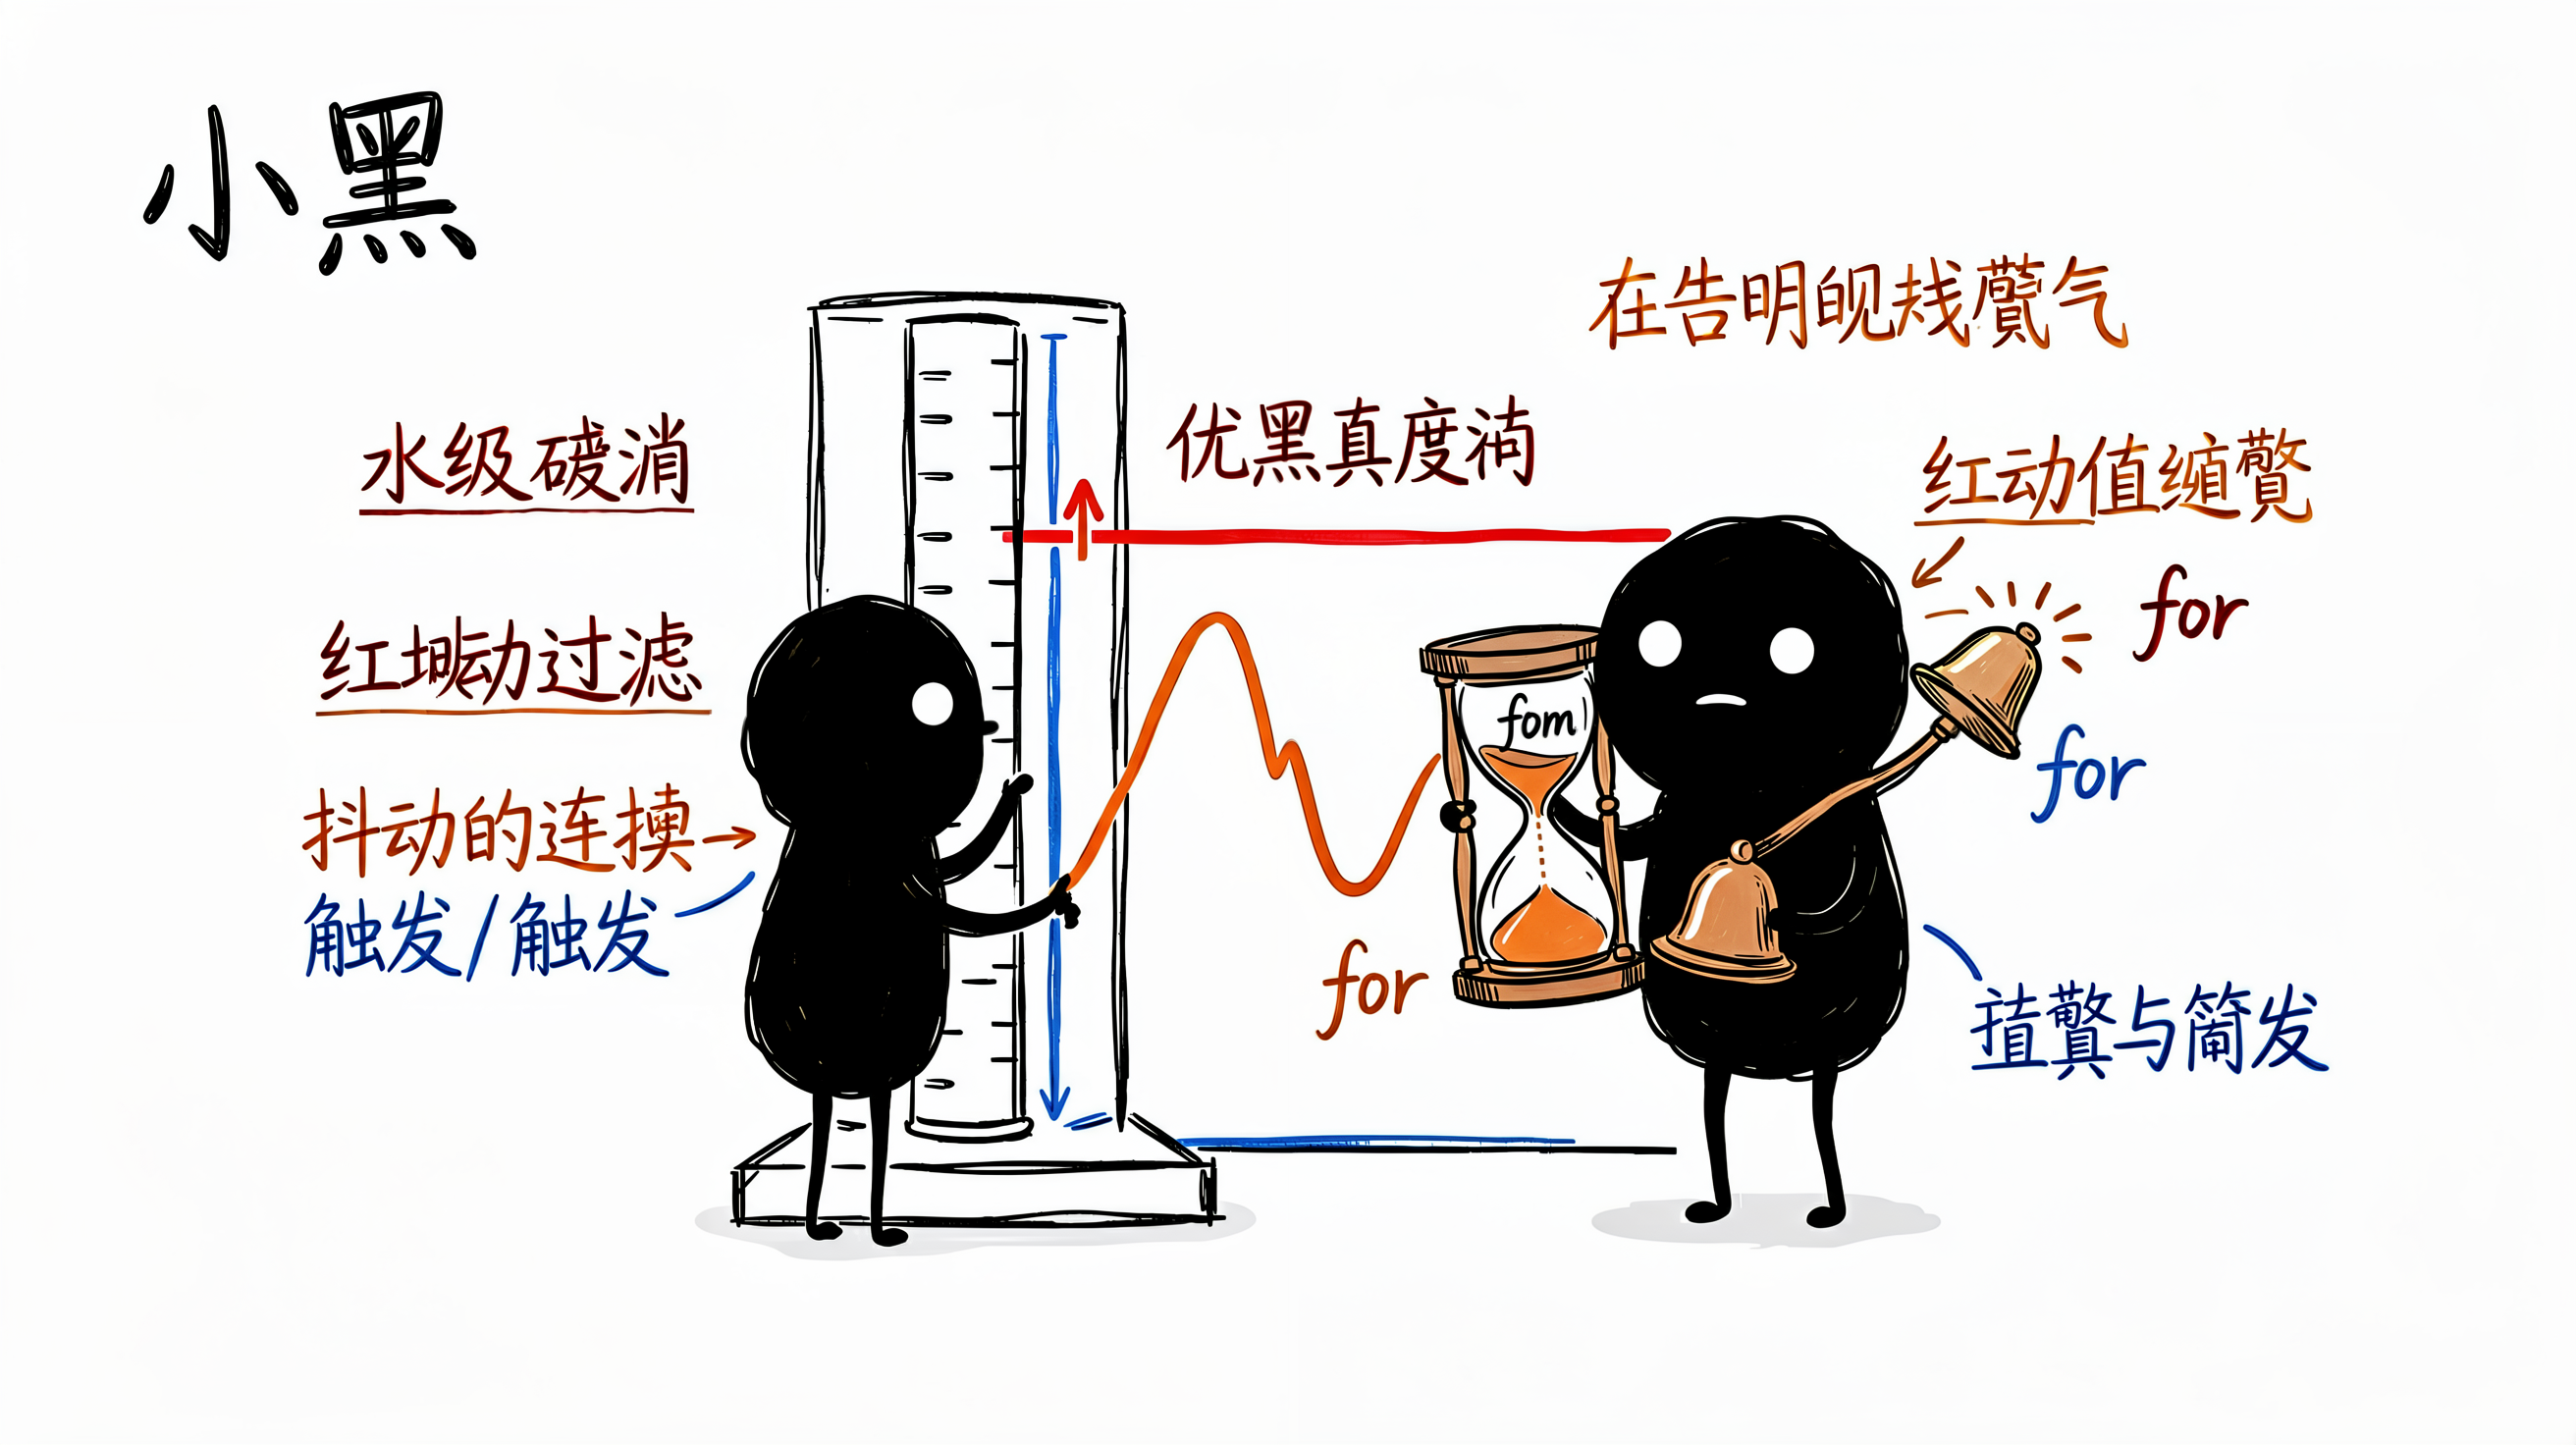
五、Alertmanager 告警落地:路由、分组与通知
Prometheus 只负责"判定告警",真正把告警送到人手里的是 Alertmanager。它在 9093 端口接收告警,再按 route 路由树决定发给谁、怎么分组。
路由树的核心字段:receiver 指定接收者,group_by 按标签聚合,group_wait(默认 30s)是组内第一条通知前的等待,group_interval(默认 5m)是后续通知间隔,repeat_interval(默认 4h)控制重复提醒。理解这组参数很关键:group_wait 让同组告警攒一小会儿一起发,避免告警雪崩;repeat_interval 控制已确认未恢复时多久再催一次,避免刷屏。下面把严重告警发到 Webhook,普通告警发到邮件:
yaml
route:
  receiver: 'webhook'
  group_by: ['alertname', 'instance']
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - matchers: ['severity="critical"']
      receiver: 'webhook'
    - matchers: ['severity="warning"']
      receiver: 'email'

receivers:
  - name: 'webhook'
    webhook_configs:
      - send_resolved: true
        url: 'http://127.0.0.1:8080/alert'
  - name: 'email'
    email_configs:
      - to: 'oncall@example.com'
        from: 'alert@example.com'
smarthost: 'smtp.example.com:25'inhibit_rules(抑制规则)能在"主机宕机"这类大告警触发时,自动抑制它引发的下游小告警,避免告警风暴;临时维护则可去 Alertmanager UI 加 silence(静默)。例如实例整体失联时,屏蔽它上面的次级告警:
yaml
inhibit_rules:
  - source_matchers: ['alertname="InstanceDown"']
    target_matchers: ['severity="warning"']
    equal: ['instance']
验证 Webhook 是否收到,可以手动推一条测试告警,或观察 /alerts 接口。
六、Grafana 可视化:接入 Prometheus 并出图
Grafana 默认在 3000 端口,Prometheus 数据源开箱即用。手动添加时在 Data Sources 填 Prometheus 地址(如 localhost:9090),Scrape interval 建议与抓取间隔对齐。若要可复现部署,用 provisioning 文件声明:
yaml
# provisioning/datasources/prom.yml
apiVersion: 1
datasources:
  - name: Prometheus
    type: prometheus
    access: proxy
    url: http://prometheus:9090
    isDefault: true
面板查询直接写 PromQL,配合模板变量 可一键切换实例。例如用一个 instance 变量驱动 CPU 面板:
promql
# 面板查询,复用 $instance 模板变量
100 - (avg(rate(node_cpu_seconds_total{instance="$instance",mode="idle"}[1m])) * 100)
模板变量在 Dashboard 设置里定义为 label_values(up, instance) 即可。面板类型要按指标性质选:CPU/内存这类趋势用 Time series,瞬时水位用 Gauge,多实例对比用 Bar gauge,选错类型图表会失真。想省事就直接导入社区成熟的 Node Exporter Full 仪表盘(Dashboard ID 1860),一步拉起主机全景图:操作路径是左侧 + 号 → Import → 填入 1860 → 选择 Prometheus 数据源即可。Grafana 也能直接接管告警,但生产上仍建议告警判定留在 Prometheus + Alertmanager,职责更清晰。
七、一键部署与最佳实践(进阶)
把前面各组件用 docker-compose 编排起来,本地一条命令即可拉起整套环境:
yaml
# docker-compose.yml
services:
  prometheus:
    image: prom/prometheus:latest
    ports: ["9090:9090"]
    volumes: ["./prometheus.yml:/etc/prometheus/prometheus.yml", "./rules:/rules"]
  node-exporter:
    image: prom/node-exporter:latest
    ports: ["9100:9100"]
  alertmanager:
    image: prom/alertmanager:latest
    ports: ["9093:9093"]
    volumes: ["./alertmanager.yml:/etc/alertmanager/alertmanager.yml"]
  grafana:
    image: grafana/grafana:latest
    ports: ["3000:3000"]
volumes: ["./provisioning:/etc/grafana/provisioning"]生产环境还有几处要补强:relabel_configs 可在抓取前改写/丢弃目标标签,常用于只保留关心的维度、降低基数;用 远程写(remote_write) 把数据落到长期存储(如 Thanos/Mimir),突破单机 retention 上限;Prometheus 本身做 HA 双副本、用外部 Alertmanager 集群保证通知不丢。容器场景下,Kubernetes 集群里的 cAdvisor 已经内置暴露容器指标,配合 kube-state-metrics 即可监控 Pod 与节点------关于容器弹性与指标驱动的自动扩缩,可进一步参考 Kubernetes HPA 自动扩缩容实战。
常见踩坑:指标名带特殊字符导致 PromQL 报错;for 时间过短触发抖动告警;Alertmanager 与 Prometheus 网络不通而收不到通知;Grafana 时区与本地不一致导致图表时间对不上,需在配置里统一 default_timezone。先 curl 通各 /metrics,再查 UI 的 Targets 与 Alerts 状态,大多能定位。
总结
一套可落地的监控告警体系,核心就四步:Exporter 采集 → PromQL 查询 → 告警规则判定 → Alertmanager 通知,最后用 Grafana 把数据讲清楚。本文给出的配置均经过最小验证,复制到本地即可跑通。把它纳入你的可观测性底座,半夜的告警就不再是盲盒。
落地时也要分清边界:本文方案面向指标监控,日志交给 Loki、链路追踪交给 Tempo,三者共同构成可观测性三支柱;Prometheus 单机 retention 有限,长期存储与多租户需引入 Thanos/Mimir。建议先小范围跑通 node_exporter 加一条告警,再逐步扩展,比一次性铺开更稳。
参考资料
- Prometheus 官方 Node Exporter 指南
- Prometheus 配置文档
- Grafana Prometheus 数据源文档(https://grafana.com/docs/grafana/latest/datasources/prometheus/)
- Alertmanager 配置文档(https://prometheus.io/docs/alerting/latest/configuration/)
© 2026 | 转载请注明出处