开篇介绍:
hello 大家,本篇博客,我们来学习Redis中的AOF持久化。
第一章:AOF 到底是什么?
我们前面花了大量篇幅,把 RDB 从里到外、从优点到缺点、从生产使用到避坑,全部讲透了,核心就一句话:RDB = 定时拍照片,只存某一时刻的数据结果,不存中间修改过程,一旦宕机,两次拍照之间的所有数据都会丢失。
而 AOF,就是 Redis 官方为了解决 RDB "数据丢失" 这个致命缺点,专门设计的第二种持久化方案,也是现在生产环境中最主流、最推荐、最能保证数据安全的持久化方案
先给你一句定义:AOF = Append Only File(只追加文件),简单说,就是一本 "永不撕页、永不涂改、只往后写、不删不改" 的流水记账本。
它和 RDB 最大的区别的是:RDB 存的是 "数据结果"(比如 "房间里有 1 件衣服、1 个玩具"),而 AOF 不存数据结果,只存 "修改数据的命令"(比如 "往房间里放 1 件衣服""往房间里放 1 个玩具");
Redis 每执行一次 "修改数据" 的命令(比如 SET、DEL、LPUSH 等),就会把这条命令原封不动地记在这本 "记账本" 上,永远只往后追加,绝对不修改、不删除以前记过的任何一条命令;
当 Redis 因为宕机、断电、进程崩溃,导致内存里的数据全部丢失时,只要这本 "记账本" 还在,Redis 重启后,就会把 "记账本" 从头到尾翻一遍,照着上面记录的每一条命令,重新执行一遍,就能把内存里的所有数据,完完全全、一丝不差地还原回来 ------ 就像你照着菜谱做菜,只要菜谱还在,哪怕菜做砸了,重新照着菜谱来一遍,就能做出一模一样的菜。
同一个房间(Redis 内存)类比:RDB vs AOF
先明确类比的所有对应关系:
- 房间 = Redis 内存(所有键值对数据都存在这里,就像所有东西都放在房间里)
- 房间里的东西 = Redis 里的 String、Hash、List、Set、ZSet 等各种数据(比如用户信息、商品库存、关注列表)
- 你对房间里东西的操作 = Redis 执行的修改命令(比如放东西、拿东西、换东西、扔东西)
- 房间被毁 = Redis 宕机、断电、进程崩溃(内存里的所有数据瞬间清空,就像房间里的东西全部被毁掉)
- 数据恢复 = 把房间里的东西重新摆回来,恢复成原来的样子
RDB 是什么?
RDB = 每天晚上 12 点,专门找一个摄影师,给房间拍一张全景照片,没有其他任何操作,只拍照片,只存照片。
- 拍摄时间:固定时间(比如每天 12 点),或者满足一定条件(比如 5 分钟内房间里的东西被动了 100 次)才拍;
- 拍摄内容:只拍 "此时此刻,房间里所有东西的完整样子",不拍你 "什么时候放的、什么时候拿的、改了多少次、为什么改";
- 数据丢失风险:如果房间在晚上 11 点 59 分被毁(Redis 宕机),摄影师还没来得及拍当天的照片,那么从昨天晚上 12 点到今天晚上 11 点 59 分,你往房间里放的、拿的、改的所有东西,都会全部丢失,只剩下昨天照片里的东西;
- 恢复速度:极快,就像照着照片,把房间里的东西原样摆回去,不用回忆过程,只看结果,几分钟就能恢复一个大房间;
- 缺点:丢数据是必然的,只是丢多丢少的问题,无法避免。
AOF 是什么?
AOF = 你手里拿着一本厚厚的、永不撕页、永不涂改、只能往后写的流水记账本,除此之外,你什么都不做,只记账------ 只要你对房间里的东西做了任何 "修改操作",不管是放、拿、换、扔,哪怕是动了一下位置,你都要立刻、马上,把这个操作原封不动地记在记账本上,绝对不遗漏、绝对不修改、绝对不删除以前记过的任何一条记录。
- 记账时间:实时记账,只要操作完成,立刻记下来,不拖延、不等待(当然,后面会讲,为了性能,会先记在 "临时小本子" 上,再批量抄到正式记账本;
- 记账内容:只记 "操作过程",不记 "最终结果"------ 比如你往房间里放了 1 件红色的衣服,就记 "2026 年 2 月 9 日 10:00:01,往房间的衣柜里放了 1 件红色的衣服";你把这件红色的衣服换成了黑色的衣服,就记 "2026 年 2 月 9 日 10:05:30,把衣柜里的红色衣服,换成了黑色衣服";你把黑色衣服拿走了,就记 "2026 年 2 月 9 日 10:10:20,把衣柜里的黑色衣服拿走了";每一个修改操作,都要记清楚 "时间、操作内容、操作位置",查询操作(比如 "看看衣柜里有没有衣服")不记账;
- 数据丢失风险:几乎不丢数据 ------ 只要你记账够及时,最多只丢 "1 秒内的操作"(后面会讲具体的记账策略,这个是生产最核心的配置);比如房间在 10:10:25 被毁,你最后一次记账是 10:10:24,那么你只丢失了 10:10:24 到 10:10:25 这 1 秒内的操作,其他所有操作都记在记账本上,不会丢失;
- 恢复速度:比 RDB 慢一点,但绝对能恢复完整 ------ 恢复的时候,你把记账本拿出来,从第一页开始,照着上面记录的每一条操作,从头到尾,重新做一遍,比如 "先放红色衣服、再换成黑色衣服、再拿走黑色衣服",一步步操作下来,房间就能恢复成被毁前的样子;
- 优点:数据安全,几乎不丢数据,这是 RDB 永远比不了的,也是生产环境首选 AOF 的核心原因。
再补充 2 个更通俗的类比
类比 1:
- RDB 像你手机里的 "定时备份",每天凌晨 1 点自动备份一次手机数据;如果手机中午 12 点坏了,你只能恢复到凌晨 1 点的备份,凌晨 1 点到中午 12 点之间的所有操作(比如发的消息、拍的照片、存的文件),全部丢失;
- 而 AOF 像你手机里的 "实时同步",每发一条消息、拍一张照片、存一个文件,立刻同步到云端,哪怕手机坏了,只要云端同步没停,你就能恢复到手机坏之前的最后一秒,几乎不丢任何东西。
类比 2:
- RDB 像考试结束后,老师只收你的 "最终试卷答案",不管你中间算了多少步骤、改了多少次答案,只看最后写在试卷上的结果;如果试卷不小心弄丢了,你只能重新做题,无法恢复你之前的答案;
- 而 AOF 像你考试时的 "草稿纸",你每算一步、每改一次答案,都写在草稿纸上,哪怕试卷丢了,你照着草稿纸上的步骤,重新抄一遍,就能恢复出完整的试卷答案,中间的每一步都不会丢失。
再给一个结论
- RDB 的核心特点:快(备份快、恢复快)、小(文件体积小,占用硬盘空间少)、不安全(必丢数据,丢多丢少看配置);
- AOF 的核心特点:稍慢(备份稍慢、恢复稍慢)、稍大(文件体积比 RDB 大,占用硬盘空间多)、极安全(几乎不丢数据,最多丢 1 秒,能满足所有核心业务需求);
- 现代生产环境铁律:绝对不单独使用 RDB(单独用必出数据丢失事故),必须用 AOF 作为主力持久化方案,RDB 只作为辅助(用于冷备、主从同步),也就是 "AOF 为主,RDB 为辅";
- 记住一句话:想保证数据安全,就开 AOF;想图快、图省空间,就用 RDB 辅助;单独用 RDB,就是生产裸奔,早晚出问题。
第二章:AOF 基础配置
AOF 默认是关闭的!默认是关闭的!默认是关闭的!重要的事说三遍,反复强调,避免你生产踩坑 ------Redis 出厂的时候,默认只开启 RDB 持久化,AOF 是关闭的;
如果你在生产环境不手动开启 AOF,只靠 RDB,那么一旦 Redis 宕机,就会丢失大量数据,轻则用户投诉,重则造成巨大经济损失、合规处罚
2.1 核心配置 1:开启 AOF
appendonly yes解释
appendonly:这个参数的作用,就是 "是否开启 AOF 持久化",翻译过来就是 "只追加文件(AOF)是否开启";append:中文意思是 "追加",就是 "往后面加",不往前改、不往中间删;only:中文意思是 "只、仅仅",就是 "只能做追加操作",不能做其他操作;
yes:中文意思是 "是、开启",设置成 yes,就表示开启 AOF 持久化;no:中文意思是 "否、关闭",这是 Redis 的默认值,设置成 no,就表示关闭 AOF 持久化,生产环境绝对不允许设置成 no。
关键细节
- 只有配置
appendonly yes,AOF 的所有其他配置(比如 AOF 文件名、刷盘策略、重写配置)才会生效;如果设置成appendonly no,不管其他 AOF 配置怎么写,都是无效的,Redis 只会执行 RDB 持久化,不会执行任何 AOF 相关操作; - 开启 AOF 后,Redis 启动时,优先加载 AOF 文件,完全忽略 RDB 文件(这是优先级铁律,后面会专门详细讲,这里先反复强调)------ 哪怕你 RDB 文件是刚生成的、是完整的,只要开了 AOF,Redis 启动时,就不会加载 RDB,只会加载 AOF;
- 生产环境核心要求:Redis 实例初始化(刚安装好、刚部署好)的时候,就必须开启 AOF,不要等 Redis 运行了很久、存了很多数据,再去开启;如果运行很久再开,开启 AOF 之前的所有数据,都不会被记录到 AOF 里,一旦 Redis 宕机,这部分数据就会丢失(后面给你讲具体事故案例);
- 动态开启 AOF:可以通过 Redis 客户端,执行命令
CONFIG SET appendonly yes,临时开启 AOF;但这种方式有两个致命问题,第一,临时生效,Redis 重启后,就会恢复成默认的appendonly no,AOF 再次关闭;第二,动态开启后,不会记录开启之前的任何命令(也就是开启之前的所有数据,都不会被写入 AOF),一旦宕机,这部分数据依然会丢失;所以,生产环境,必须在配置文件(redis.conf)里设置appendonly yes,重启 Redis 生效,绝对不能用动态开启的方式; - 配置文件路径提醒:Redis 的配置文件,默认路径是
/etc/redis/redis.conf(Linux 系统),如果你不知道配置文件在哪,可以执行命令redis-cli config get dir,查看 Redis 配置文件和持久化文件的存放目录;修改配置文件后,必须重启 Redis 才能生效,执行命令systemctl restart redis(CentOS 系统)或service redis restart(Ubuntu 系统),大家可以用vim打开使用 :?appendonly 找到该配置项
2.2 核心配置 2:AOF 文件名
appendfilename "appendonly.aof"解释
appendfilename:这个参数的作用,就是 "设置 AOF 日志文件的名字",翻译过来就是 "只追加文件(AOF)的文件名";append:还是 "追加" 的意思;filename:中文意思是 "文件名";
"appendonly.aof":这是 AOF 文件的默认名字,appendonly表示 "只追加",aof是 AOF 的后缀,用于区分 RDB 文件(RDB 默认名字是 dump.rdb);- 引号:可以加,也可以不加,Redis 都能识别,生产环境建议加上,避免文件名出现特殊字符,导致识别失败。
关键细节
- 文件名可以自定义,生产环境不建议用默认名字 ,建议改成 "环境 + 端口 + 用途.aof" 的格式,避免多 Redis 实例部署在同一台服务器时,文件名冲突;
- 生产推荐配置示例 1(生产环境、端口 6379):
appendfilename "appendonly_prod_6379.aof" - 生产推荐配置示例 2(测试环境、端口 6380):
appendfilename "appendonly_test_6380.aof" - 好处:一眼就能看出,这个 AOF 文件属于 "生产环境、6379 端口" 的 Redis 实例,后续排查问题、备份文件时,不会混淆;
- 生产推荐配置示例 1(生产环境、端口 6379):
- 文件名后缀必须是
.aof,不能改成其他后缀(比如.txt、.log)------Redis 启动时,只会识别后缀为.aof的文件作为 AOF 日志,改成其他后缀,Redis 会认为没有 AOF 文件,不会加载; - 文件名不要包含特殊字符(比如
*、?、/、\),避免 Redis 无法识别、无法写入文件; - 如果修改了 AOF 文件名,那么之前生成的旧 AOF 文件(默认名 appendonly.aof),Redis 启动时就不会加载了 ------ 此时需要手动将旧文件重命名,改成新配置的文件名,或者删除旧文件(删除旧文件会丢失之前的所有数据,生产环境绝对禁止);
- 生产建议:修改文件名后,先备份旧的 AOF 文件,再重命名,然后重启 Redis,确保数据能正常加载,避免出现数据丢失。
2.3 核心配置 3:AOF 保存目录
dir /var/lib/redis解释
dir:这个参数的作用,就是 "设置 Redis 所有持久化文件(包括 AOF 和 RDB)的保存目录",翻译过来就是 "目录(directory)";/var/lib/redis:这是 Redis 默认的持久化文件保存目录(Linux 系统),AOF 文件(appendonly.aof)和 RDB 文件(dump.rdb),都会保存在这个目录下;- 如果你是 Windows 系统,默认目录会不一样,但生产环境中,Redis 几乎都部署在 Linux 系统上,所以我们只讲 Linux 系统的配置,零超纲。
关键细节
- 核心重点:AOF 和 RDB 共用同一个保存目录 ,不需要给 AOF 单独设置目录 ------Redis 会把所有持久化文件,都存放在
dir配置指定的目录下,这样便于管理、备份(后续备份时,只需要备份这个目录下的所有文件即可); - 生产环境铁律:这个目录,必须单独挂载数据盘 ,绝对不能和系统盘(/ 目录)、业务盘共用;
- 为什么?:系统盘如果满了,会导致服务器崩溃、系统无法运行;业务盘如果频繁写入,会占用大量 IO 资源,影响 Redis 的持久化速度;单独挂载数据盘,既能避免系统盘、业务盘满了影响 Redis,也能提升 Redis 的 IO 性能(数据盘只用于 Redis 持久化,没有其他 IO 开销);
- 生产推荐配置:
dir /data/redis/persistence(/data 是单独挂载的数据盘,redis/persistence 是 Redis 持久化文件的专属目录);
- 目录权限要求:必须给 Redis 用户(Redis 进程默认用 redis 用户运行)"读写权限"(rwx),否则 AOF 文件无法写入、无法修改、无法重写,Redis 会直接报错退出;
-
生产操作示例(给目录设置权限):
# 创建持久化目录(如果不存在) mkdir -p /data/redis/persistence # 给目录设置所有者为 redis 用户、所属组为 redis 组 chown -R redis:redis /data/redis/persistence # 给目录设置读写执行权限(redis 用户有 full 权限) chmod -R 755 /data/redis/persistence -
权限错误的后果:如果目录没有读写权限,Redis 启动时,会报错 "Can't open the append-only file: Permission denied"(无法打开 AOF 文件,权限不足),直接启动失败;
-
- 目录空间要求:必须保证数据盘有足够的空间,用于存放 AOF 文件(AOF 文件会随着时间慢慢变大,即使重写,也会占用一定的硬盘空间);生产环境建议,数据盘空间至少是 Redis 内存大小的 2~3 倍(比如 Redis 内存是 8G,数据盘空间至少预留 16~24G),避免硬盘空间满了,导致 AOF 无法写入,Redis 宕机;
- 禁止在这个目录下存放其他文件:这个目录是 Redis 持久化文件的专属目录,不要存放日志文件、配置文件、临时文件等其他内容,避免占用空间、混淆文件,也避免误删持久化文件(误删 AOF 或 RDB 文件,会导致数据丢失);
- 目录路径不要包含特殊字符:和 AOF 文件名一样,目录路径不要包含
*、?、/(除了路径分隔符)、\等特殊字符,避免 Redis 无法识别、无法访问目录。
2.4 生产完整最小配置
下面是 AOF 生产环境的完整最小配置,所有参数都经过生产验证,零基础可以直接复制到 redis.conf 里使用,不需要修改(除了密码、目录,根据自己的实际情况调整);
# ------------- AOF 基础必配(生产必须设置,缺一不可) -------------
appendonly yes                  # 开启 AOF 持久化(生产必须,唯一选项 yes)
appendfilename "appendonly.aof" # AOF 文件名,生产建议改成 appendonly_prod_6379.aof(带环境、端口)
dir /data/redis/persistence     # 持久化文件目录(独立数据盘,生产必改,不要用默认目录)

# ------------- AOF 最核心安全/性能配置(生产标准配置,唯一推荐) -------------
appendfsync everysec            # AOF 刷盘策略,生产唯一推荐 everysec(最多丢 1 秒数据)
no-appendfsync-on-rewrite yes   # AOF 重写时,暂停 fsync,避免 IO 资源冲突、IO 爆炸
aof-load-truncated yes          # Redis 启动时,允许截断 AOF 末尾损坏的命令,保证 Redis 能正常启动
aof-use-rdb-preamble yes        # 开启混合持久化(Redis 4.0+ 支持,生产必开,兼顾速度和安全)

# ------------- AOF 重写自动触发配置(生产标准配置,避免 AOF 无限变大) -------------
auto-aof-rewrite-min-size 64mb   # AOF 最小触发重写的大小(文件小于 64MB,不触发重写,避免频繁重写)
auto-aof-rewrite-percentage 100  # AOF 增长百分比(当前大小比上次重写后大小增长 100%,触发重写)
详细解释
appendonly yes:前面已经详细拆解过,这里再强调一遍 ------ 生产必须开启,不开启就是裸奔,必丢数据;appendfilename "appendonly.aof":AOF 文件名,生产建议修改成带环境、端口的名字,避免多实例冲突;dir /data/redis/persistence:持久化目录,生产必须单独挂载数据盘,这里只是示例路径,你需要根据自己服务器的数据盘路径修改(比如你的数据盘挂载在 /redis/data,就改成 dir /redis/data);appendfsync everysec:这是 AOF 最核心、最关键的配置,后面会专门用一整节无限详细拆解,这里先简单说 ------ 刷盘策略,everysec 表示 "每秒刷盘一次",最多丢 1 秒数据,兼顾数据安全和性能,生产环境 99% 的业务,都用这个配置,是唯一推荐的配置;no-appendfsync-on-rewrite yes:AOF 重写时,是否暂停 fsync(刷盘)操作;设置成 yes,表示重写时,暂停刷盘,把命令先存到缓冲区,等重写完成后,再批量刷盘;这样做的目的,是避免 "重写(消耗大量 IO)" 和 "刷盘(也消耗 IO)" 同时进行,导致 IO 资源被占满(IO 爆炸),影响 Redis 主线程的性能;生产必须设置成 yes,设置成 no,会导致重写时 IO 压力过大,Redis 响应变慢、请求超时;aof-load-truncated yes:Redis 启动时,如果发现 AOF 文件末尾有损坏、不完整的命令(比如宕机导致最后一条命令没写完),是否允许截断这部分损坏的命令,正常加载前面完整的命令;设置成 yes,表示允许截断,这样 Redis 能正常启动,只是丢失最后一小段数据;设置成 no,表示不允许截断,Redis 会直接拒绝启动,打印错误日志;生产必须设置成 yes------ 宁愿丢失最后一小段数据,也要保证 Redis 能正常启动,避免业务中断;如果设置成 no,AOF 文件末尾只要有一点损坏,Redis 就无法启动,业务会一直中断,直到修复 AOF 文件;aof-use-rdb-preamble yes:开启混合持久化(Redis 4.0 及以上版本支持,Redis 5.0+ 默认开启),后面会专门用一整节无限详细拆解,这里先简单说 ------ 混合持久化 = AOF 文件前半段是 RDB 全量快照(恢复快),后半段是 AOF 增量命令(数据安全),兼顾 RDB 的恢复速度和 AOF 的数据安全,生产必须开启;auto-aof-rewrite-min-size 64mb:AOF 重写的最小触发大小;如果 AOF 文件大小小于 64MB,即使满足增长百分比,也不会触发重写;这样做的目的,是避免 AOF 文件很小时,就频繁触发重写(比如文件只有 10MB,增长 100% 到 20MB,就触发重写,完全没必要),减少 IO 消耗和 fork 阻塞风险;生产建议设置成 64MB 或 128MB,根据自己的业务情况调整(数据量大,就设大一点);auto-aof-rewrite-percentage 100:AOF 重写的增长百分比触发条件;当前 AOF 文件大小 ÷ 上次重写后 AOF 文件大小 ≥ 1 + 100%(也就是翻倍),才会触发重写;比如,上次重写后,AOF 文件大小是 64MB,那么当 AOF 文件大小涨到 128MB(64MB × 2)时,就会自动触发重写;生产建议设置成 100% 或 150%,设置成 100%,能及时压缩 AOF 文件,避免文件过大;设置成 150%,能减少重写次数,减少 fork 阻塞风险,根据自己的业务写入频率调整(写入频率高,就设低一点,及时重写;写入频率低,就设高一点,减少重写次数)。
生产配置注意事项
- 所有配置,都要写在 redis.conf 文件里,不要写在其他文件中(Redis 默认只加载 redis.conf,除非你手动指定其他配置文件);
- 配置文件中,注释(# 开头的行)可以保留,也可以删除,Redis 会忽略注释行;但生产环境建议保留注释,便于后续维护、排查问题(知道每一条配置的作用);
- 配置参数的大小写:Redis 配置参数不区分大小写(比如 appendonly YES 和 appendonly yes 效果一样),但生产环境建议统一用小写,规范配置,避免混淆;
- 配置修改后,必须重启 Redis 才能生效,动态修改(CONFIG SET 命令)只能临时生效,重启后会恢复成配置文件中的设置;
- 生产环境,修改配置文件前,必须备份原配置文件(比如 cp /etc/redis/redis.conf/etc/redis/redis.conf.bak),避免修改错误,导致 Redis 无法启动,无法恢复;
- 如果你的 Redis 版本低于 4.0,不支持混合持久化(aof-use-rdb-preamble 参数),那么可以删除这条配置,或者升级 Redis 版本(生产建议升级到 5.0+,更稳定、更安全,支持更多实用功能)。
第三章:AOF 完整工作流程
AOF 整个生命周期,从 "命令执行" 到 "数据恢复",严格分为4 个绝对固定、绝对不能乱序的步骤,每一步都有明确的作用、明确的角色、明确的风险、明确的生产注意事项;这 4 步,也是面试必考的知识点,更是生产中排查 AOF 相关问题(比如数据丢失、AOF 文件损坏、恢复慢)的核心依据。
AOF 4 大核心步骤:
- 命令写入(append)→ 所有写命令,先写入内存缓冲区 aof_buf(不直接写硬盘,保证性能)
- 文件同步(sync)→ 内存缓冲区 aof_buf 里的命令,批量刷到硬盘 AOF 文件(最核心、最容易踩坑,决定数据安全)
- AOF 重写(rewrite)→ 压缩 AOF 文件、删除冗余命令,解决 AOF 文件无限变大的问题(生产必懂,否则硬盘会被占满)
- 重启加载(load)→ Redis 重启时,加载 AOF 文件,重放所有命令,恢复内存数据(优先级铁律,必懂)
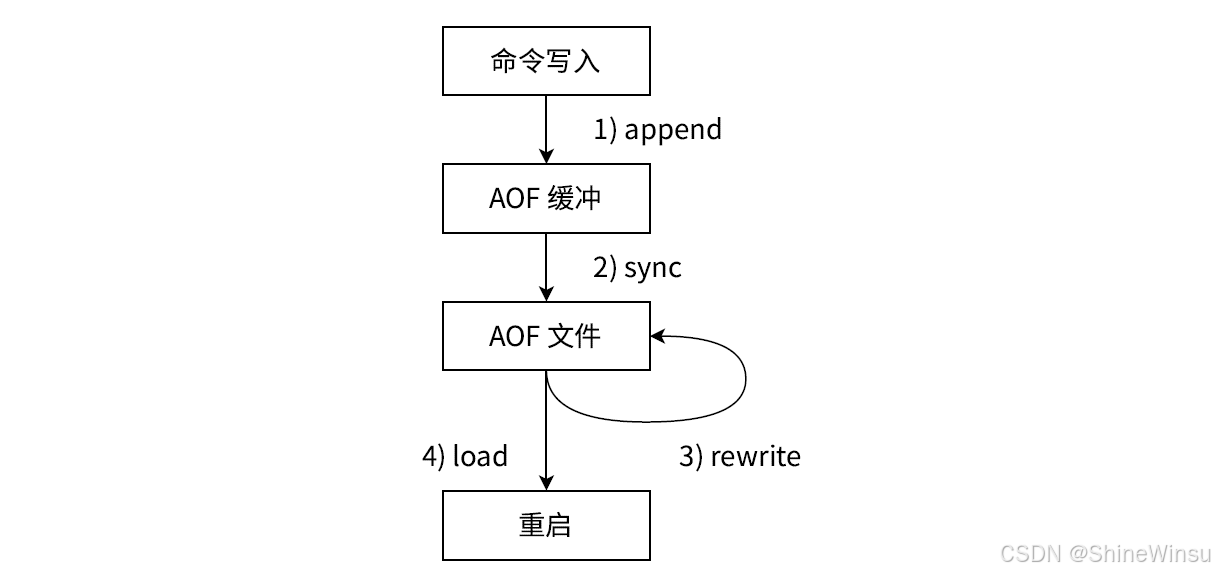
第三章第一节:步骤 1 ------ 命令写入(append):所有写命令先入 aof_buf 缓冲区
AOF 的第一步,也是最基础的一步:当你执行一条 "修改数据" 的命令时,Redis 不会直接把这条命令写入硬盘的 AOF 文件,而是先把它写入内存缓冲区 aof_buf;只有等缓冲区满足一定条件(比如达到一定大小、达到一定时间),才会把缓冲区里的命令,批量刷到硬盘 ------ 这一步的核心目的,是保证 Redis 的高性能,避免频繁写硬盘,导致主线程阻塞。
3.1.1 什么命令会被写入 AOF?
核心规则:只有修改数据的命令,才会被记录到 AOF;查询数据的命令,一律不记录------ 因为查询命令不修改内存中的数据,不需要恢复,记录了只会浪费硬盘空间、减慢 AOF 写入和恢复速度,完全没有必要。
详细拆解
(1)会被写入 AOF 的命令
这些命令,只要执行成功,就会被写入 aof_buf 缓冲区,后续会刷到 AOF 文件:
- String 类型修改命令(最常用):
- SET:设置键值对,示例:
SET user:1 name zhangsan(设置 user:1 的值为 zhangsan,修改数据,会被写入) - INCR:自增,示例:
INCR counter:1(将 counter:1 的值加 1,修改数据,会被写入) - DECR:自减,示例:
DECR counter:1(将 counter:1 的值减 1,修改数据,会被写入) - SETEX:设置键值对并设置过期时间,示例:
SETEX user:2 3600 name lisi(设置 user:2 的值为 lisi,过期时间 3600 秒,修改数据,会被写入) - DEL:删除键值对,示例:
DEL user:1(删除 user:1 这个键,修改数据,会被写入)
- SET:设置键值对,示例:
- Hash 类型修改命令:
- HSET:设置 Hash 中的字段值,示例:
HSET user:3 name wangwu age 20(设置 user:3 的 name 为 wangwu、age 为 20,修改数据,会被写入) - HDEL:删除 Hash 中的字段,示例:
HDEL user:3 age(删除 user:3 的 age 字段,修改数据,会被写入) - HINCRBY:Hash 字段自增,示例:
HINCRBY user:3 age 1(将 user:3 的 age 字段加 1,修改数据,会被写入)
- HSET:设置 Hash 中的字段值,示例:
- List 类型修改命令:
- LPUSH:从 List 左边插入元素,示例:
LPUSH list:1 a b c(往 list:1 左边插入 a、b、c 三个元素,修改数据,会被写入) - RPUSH:从 List 右边插入元素,示例:
RPUSH list:1 d e f(往 list:1 右边插入 d、e、f 三个元素,修改数据,会被写入) - LREM:删除 List 中的元素,示例:
LREM list:1 1 a(删除 list:1 中的 1 个 a 元素,修改数据,会被写入) - LTRIM:截取 List 中的元素,示例:
LTRIM list:1 0 2(保留 list:1 中索引 0 到 2 的元素,删除其他元素,修改数据,会被写入)
- LPUSH:从 List 左边插入元素,示例:
- Set 类型修改命令:
- SADD:往 Set 中添加元素,示例:
SADD set:1 a b c(往 set:1 中添加 a、b、c 三个元素,修改数据,会被写入) - SREM:从 Set 中删除元素,示例:
SREM set:1 a(从 set:1 中删除 a 元素,修改数据,会被写入) - SMOVE:将 Set 中的元素移动到另一个 Set,示例:
SMOVE set:1 set:2 b(将 set:1 中的 b 元素,移动到 set:2,修改两个 Set 的数据,会被写入)
- SADD:往 Set 中添加元素,示例:
- ZSet 类型修改命令:
- ZADD:往 ZSet 中添加元素(带分数),示例:
ZADD zset:1 10 a 20 b 30 c(往 zset:1 中添加 a(10)、b(20)、c(30),修改数据,会被写入) - ZREM:从 ZSet 中删除元素,示例:
ZREM zset:1 a(从 zset:1 中删除 a 元素,修改数据,会被写入) - ZINCRBY:ZSet 元素分数自增,示例:
ZINCRBY zset:1 5 b(将 zset:1 中 b 元素的分数加 5,修改数据,会被写入)
- ZADD:往 ZSet 中添加元素(带分数),示例:
- 过期相关修改命令:
- EXPIRE:给键设置过期时间,示例:
EXPIRE user:1 3600(给 user:1 设置过期时间 3600 秒,修改数据的过期属性,会被写入) - PEXPIRE:给键设置过期时间(毫秒),示例:
PEXPIRE user:1 3600000(给 user:1 设置过期时间 3600000 毫秒,修改数据,会被写入) - PERSIST:取消键的过期时间,示例:
PERSIST user:1(取消 user:1 的过期时间,修改数据,会被写入)
- EXPIRE:给键设置过期时间,示例:
(2)不会被写入 AOF 的命令
这些命令,不管执行多少次,都不会被写入 aof_buf 缓冲区,也不会被记录到 AOF 文件,因为它们不修改数据,不需要恢复:
- String 类型查询命令:
- GET:获取键值对,示例:
GET user:1(获取 user:1 的值,不修改数据,不写入) - MGET:批量获取键值对,示例:
MGET user:1 user:2(批量获取 user:1 和 user:2 的值,不修改数据,不写入)
- GET:获取键值对,示例:
- Hash 类型查询命令:
- HGET:获取 Hash 中的某个字段值,示例:
HGET user:3 name(获取 user:3 的 name 字段值,不修改数据,不写入) - HGETALL:获取 Hash 中的所有字段和值,示例:
HGETALL user:3(获取 user:3 的所有字段和值,不修改数据,不写入) - HKEYS:获取 Hash 中的所有字段,示例:
HKEYS user:3(获取 user:3 的所有字段,不修改数据,不写入) - HVALS:获取 Hash 中的所有值,示例:
HVALS user:3(获取 user:3 的所有值,不修改数据,不写入)
- HGET:获取 Hash 中的某个字段值,示例:
- List 类型查询命令:
- LRANGE:获取 List 中指定范围的元素,示例:
LRANGE list:1 0 -1(获取 list:1 中的所有元素,不修改数据,不写入) - LLEN:获取 List 的长度,示例:
LLEN list:1(获取 list:1 的元素个数,不修改数据,不写入) - LPOP:从 List 左边弹出元素(注意:LPOP 是修改命令,会被写入;LPEEK 是查询命令,不写入,但 Redis 没有 LPEEK 命令,这里重点区分)
- LRANGE:获取 List 中指定范围的元素,示例:
- Set 类型查询命令:
- SMEMBERS:获取 Set 中的所有元素,示例:
SMEMBERS set:1(获取 set:1 的所有元素,不修改数据,不写入) - SCARD:获取 Set 的元素个数,示例:
SCARD set:1(获取 set:1 的元素个数,不修改数据,不写入) - SISMEMBER:判断元素是否在 Set 中,示例:
SISMEMBER set:1 a(判断 a 是否在 set:1 中,不修改数据,不写入)
- SMEMBERS:获取 Set 中的所有元素,示例:
- ZSet 类型查询命令:
- ZRANGE:获取 ZSet 中指定范围的元素(按分数升序),示例:
ZRANGE zset:1 0 -1(获取 zset:1 的所有元素,不修改数据,不写入) - ZREVRANGE:获取 ZSet 中指定范围的元素(按分数降序),示例:
ZREVRANGE zset:1 0 -1(获取 zset:1 的所有元素,降序排列,不修改数据,不写入) - ZSCORE:获取 ZSet 中某个元素的分数,示例:
ZSCORE zset:1 b(获取 zset:1 中 b 元素的分数,不修改数据,不写入) - ZCARD:获取 ZSet 的元素个数,示例:
ZCARD zset:1(获取 zset:1 的元素个数,不修改数据,不写入)
- ZRANGE:获取 ZSet 中指定范围的元素(按分数升序),示例:
- 其他查询命令:
- EXISTS:判断键是否存在,示例:
EXISTS user:1(判断 user:1 是否存在,不修改数据,不写入) - KEYS:查询所有符合条件的键,示例:
KEYS user:*(查询所有以 user: 开头的键,不修改数据,不写入) - DBSIZE:查询当前数据库的键的总数,示例:
DBSIZE(查询当前数据库有多少个键,不修改数据,不写入) - INFO:查询 Redis 的运行信息,示例:
INFO(查询 Redis 的 QPS、内存使用、持久化状态等信息,不修改数据,不写入)
- EXISTS:判断键是否存在,示例:
3.1.2 写入内容:Redis RESP 纯文本协议
很多同学会问:"AOF 里面到底存的是什么?是和我执行的命令一样的文字吗?"------ 答案是:存的是纯文本,但格式是 Redis 标准的 RESP 协议,和你直接执行的命令,格式有一点区别,但完全可读、可修改、可修复。
详细拆解
-
核心特点:
- AOF 不存二进制数据,不存压缩数据,不存复杂数据结构,只存纯文本------ 你可以直接用 cat、vim、grep 等 Linux 命令,打开 AOF 文件,查看里面的内容,就像查看普通的文本文件、日记一样;
- 格式是 Redis 标准 RESP 协议(RESP 协议全称是 Redis Serialization Protocol,翻译过来是 "Redis 序列化协议"),但我们不需要懂协议的底层原理,只需要知道:这种格式是纯文本、可读、跨版本兼容(不同版本的 Redis,都能识别这种格式的命令)、损坏后可修复;
- 为什么用这种格式?:因为纯文本可读、可修复,跨版本兼容,而且实现简单,Redis 主线程不需要做复杂的编码、压缩操作,只需要把命令转换成这种纯文本格式,丢进缓冲区即可,不影响性能。
-
示例 1:你执行的命令(普通格式):
SET user:1 name zhangsanAOF 里面真实记录的内容(RESP 纯文本协议,可直接 cat 查看):
*3\r\n$3\r\nSET\r\n$6\r\nuser:1\r\n$8\r\nzhangsan\r\n解释:
*3:第一个字符是*,在 RESP 协议里,*后面跟的数字,表示 "这条命令一共有多少个组成部分(参数 + 命令名)";这里*3就表示,我们执行的SET user:1 name zhangsan这条命令,一共由 3 个部分组成 ------ 分别是 命令名(SET)、键(user:1)、值(zhangsan),没有第四个部分,所以用*3标识,一眼就能看出命令的结构,不会混乱。\r\n:这是 RESP 协议里的 "换行分隔符",和我们平时在键盘上按 Enter 键换行的效果完全一样,作用就是把命令的不同部分分开,让 Redis 能清晰识别每一部分内容;每一个部分结束后,都会跟一个\r\n,避免不同内容混在一起,导致 Redis 解析错误。$3:$符号在 RESP 协议里,作用是 "标识下一个部分的字符长度",$后面跟的数字,就是下一个内容的字符数(不含\r\n本身);这里$3就表示,紧接着的内容,一共有 3 个字符 ------ 后面的SET正好是 3 个字符(S、E、T),完美对应,不会出错。\r\n:再次换行,分隔 "字符长度标识" 和 "实际内容",让结构更清晰。SET:这就是我们实际执行的命令名,纯文本格式,和我们在 Redis 客户端输入的命令完全一样,不加密、不压缩、不转换二进制,直接能看懂;Redis 解析的时候,看到这个SET,就知道这条命令是 "设置键值对" 的操作。\r\n:换行,分隔命令名和第一个参数(键)。$6:又一个$标识,后面跟的数字 6,表示下一个内容(也就是键user:1)的字符长度是 6 个;我们数一下user:1的字符 ------u(1)、s(2)、e(3)、r(4)、:(5)、1(6),正好 6 个字符,没有多一个、没有少一个,这就是$6的含义,确保 Redis 能准确读取整个键的内容,不会少读、多读。\r\n:换行,分隔字符长度标识和键的实际内容。user:1:这是我们执行 SET 命令时的 "键",纯文本格式,和我们输入的完全一致,直接能看懂,哪怕用 vim 打开 AOF 文件,也能一眼找到这个键对应的命令。\r\n:换行,分隔键和值。$8:$标识,后面跟的数字 8,表示下一个内容(也就是值zhangsan)的字符长度是 8 个;数一下zhangsan的字符 ------z(1)、h(2)、a(3)、n(4)、g(5)、s(6)、a(7)、n(8),正好 8 个字符,对应无误。\r\n:换行,分隔字符长度标识和值的实际内容。zhangsan:这是我们执行 SET 命令时的 "值",纯文本格式,和输入的完全一致,可读可改。\r\n:最后一个换行符,标识这条完整的 SET 命令结束,下一条命令会从新的一行开始,避免和这条命令混淆。
-
示例 2:你执行的命令(普通格式):
HSET user:3 name wangwu age 20AOF 里面真实记录的内容(RESP 纯文本协议):
*6\r\n$4\r\nHSET\r\n$6\r\nuser:3\r\n$4\r\nname\r\n$6\r\nwangwu\r\n$3\r\nage\r\n$2\r\n20\r\n简单拆解:
*6:因为 HSET user:3 name wangwu age 20 一共由 6 个部分组成:命令名(HSET)+ 键(user:3)+ 字段 1(name)+ 值 1(wangwu)+ 字段 2(age)+ 值 2(20),所以是*6,对应$4\r\nHSET(HSET 是 4 个字符)、$6\r\nuser:3(user:3 是 6 个字符)、$4\r\nname(name 是 4 个字符)、$6\r\nwangwu(wangwu 是 6 个字符)、$3\r\nage(age 是 3 个字符)、$2\r\n20(20 是 2 个字符),最后加\r\n结束。- 核心规律:不管是什么命令,AOF 里的 RESP 格式都遵循 "
*N\r\n$M\r\n内容\r\n$M\r\n内容\r\n..." 的规律 ------N 是命令的组成部分个数,M 是每一个部分的字符长度,内容是纯文本,全程可读、可修改、可识别。
-
示例 3:你执行的命令(普通格式):
LPUSH list:1 a b cAOF 里面真实记录的内容(RESP 纯文本协议):
*4\r\n$5\r\nLPUSH\r\n$6\r\nlist:1\r\n$1\r\na\r\n$1\r\nb\r\n$1\r\nc\r\n生产查看效果:登录 Linux 服务器,进入 AOF 文件存放目录(比如 /data/redis/persistence),执行命令
cat appendonly.aof,就能直接看到上面的纯文本内容,如下所示:*3\r\n$3\r\nSET\r\n$6\r\nuser:1\r\n$8\r\nzhangsan\r\n *6\r\n$4\r\nHSET\r\n$6\r\nuser:3\r\n$4\r\nname\r\n$6\r\nwangwu\r\n$3\r\nage\r\n$2\r\n20\r\n *4\r\n$5\r\nLPUSH\r\n$6\r\nlist:1\r\n$1\r\na\r\n$1\r\nb\r\n$1\r\nc\r\n哪怕你不懂 RESP 协议,只要看
SET、HSET、LPUSH这些纯文本命令,就能一眼知道,之前执行了哪些操作,对应哪些键和值,这就是纯文本协议的最大优势 ------可读性极强。
为什么用纯文本?
原因 1:可读性极强,方便排查问题、定位故障
- 通俗类比:就像你写日记,用中文纯文本写,每天做了什么、吃了什么、做了什么操作,一目了然;如果用密码、暗号写,哪怕你自己回头看,也不知道写的是什么;AOF 用纯文本,就相当于 Redis 写的 "操作日记",每一条操作都清晰可见,不用解密、不用转换,直接就能看懂。
- 生产场景(无限详细,零超纲):运维人员在生产中,经常会遇到 "数据莫名丢失""数据被修改""Redis 启动失败" 等问题,这时候,AOF 文件就是最核心的排查工具 ------ 只要打开 AOF 文件,从头到尾看一遍,就能知道:什么时候执行了什么命令、是谁执行的(如果开启了 Redis 认证和日志关联)、命令是否执行成功、数据是被哪个命令删除 / 修改的,快速定位问题根源,不用瞎猜、不用排查半天。
- 补充说明:哪怕你是零基础,也能通过简单的 Linux 命令(cat、grep、head、tail)查看 AOF 文件,比如
tail -100 appendonly.aof查看最后 100 条命令(排查最新的操作问题),grep DEL appendonly.aof查看所有删除命令(排查数据丢失问题),门槛极低、实用性极强,这是 RDB 无法比拟的(RDB 是二进制文件,无法直接查看内容,哪怕数据丢失,也不知道是哪个操作导致的)。
原因 2:跨版本兼容极强,不会像 RDB 那样出现版本不兼容问题
- 通俗类比:就像你用记事本写的纯文本文件(.txt),不管是 Windows XP、Windows 10、Windows 11,还是 Linux、Mac 系统,都能打开、能编辑、能读取;但如果你用 Word 2003 写的 .doc 文件,用 Word 2019 打开可能会出现格式错乱,用老旧的 Word 2000 打开可能无法识别;AOF 纯文本命令,就相当于记事本文件,跨版本兼容性极强,不会出现版本不兼容的问题。
- 详细拆解:Redis 的版本更新很快,从 3.0、4.0、5.0,到现在的 6.0、7.0,但不管是哪个版本,都能识别同一条纯文本命令 ------ 比如 Redis 3.0 执行的
SET user:1 name zhangsan命令,记录到 AOF 里,Redis 7.0 启动时,能正常加载这条命令、恢复数据;Redis 7.0 执行的HSET user:3 age 20命令,记录到 AOF 里,Redis 5.0 启动时,也能正常加载、恢复数据;哪怕是高版本的 AOF 文件,放到低版本的 Redis 里,也能正常加载(只要命令是低版本 Redis 支持的,比如低版本不支持的新命令,高版本执行后记录到 AOF,低版本加载时会忽略这条命令,不会导致启动失败)。 - 对比 RDB(零超纲,突出 AOF 优势):RDB 是二进制文件,版本兼容性很差 ------Redis 7.0 生成的 RDB 文件,放到 Redis 5.0 里,根本无法加载,直接报错 "Bad RDB format version"(RDB 格式版本错误),导致 Redis 无法启动、数据无法恢复;而 AOF 是纯文本命令,完全不会出现这种问题,不管是高版本→低版本,还是低版本→高版本,都能正常识别、正常加载,兼容性拉满,生产环境中,Redis 版本升级、降级时,不用担心 AOF 文件无法使用,减少运维成本、避免数据丢失风险。
- 生产注意事项(零超纲,必懂):如果高版本 Redis 执行了低版本不支持的新命令(比如 Redis 6.0 支持的
ACL SETUSER命令),并将这条命令记录到 AOF 里,那么将这个 AOF 文件放到低版本 Redis(比如 5.0)里加载时,Redis 会忽略这条不支持的命令,加载前面所有支持的命令,不会导致启动失败,只会丢失这条新命令对应的数据(这种情况很少见,生产环境中,版本升级 / 降级前,会提前排查不兼容的命令,避免出现这种问题)。
原因 3:文件损坏后可修复,容错率高
- 通俗类比:就像你写的日记,不小心被水打湿,最后几行字模糊不清、无法识别,你可以直接删掉这几行模糊的字,剩下的内容依然能正常阅读、能找到之前的记录;但如果是你拍的照片(比如 RDB),不小心损坏了,整个照片就无法打开、无法查看,里面的所有内容都会丢失;AOF 是纯文本文件,哪怕文件末尾被截断、出现损坏,也能通过简单的方法修复,保留前面完整的命令记录,不会导致整个文件失效。
- 详细拆解:AOF 文件损坏,大多是因为 Redis 异常宕机、断电、硬盘故障(比如硬盘读写错误),导致最后一条或几条命令没有写完、出现截断、乱码;因为 AOF 是纯文本,损坏的部分大多在文件末尾(最后几条命令),前面的命令都是完整的、有效的;我们只需要删除文件末尾损坏的部分(乱码、不完整的命令),Redis 启动时,就能正常加载前面完整的命令,恢复大部分数据,只是丢失最后一小段损坏的命令对应的数据 ------ 这种容错率,是 RDB 无法比拟的(RDB 是二进制文件,只要有一点点损坏,整个文件就无法加载,里面的所有数据都会丢失,无法修复)。
原因 4:实现简单,不影响 Redis 主线程性能
- 通俗类比:就像你写日记,用纯文本写,不需要复杂的格式、不需要排版、不需要加密,拿起笔就能写,速度很快,不会占用你太多时间;但如果让你用密码、暗号、二进制代码写日记,每写一个字都要转换、加密,速度很慢,会占用你大量时间;Redis 记录 AOF 命令,用纯文本格式,不需要复杂的编码、压缩、转换操作,主线程只需要把执行后的命令,简单转换成 RESP 纯文本格式,丢进 aof_buf 缓冲区即可,操作简单、速度极快,不会占用主线程太多时间,不会影响 Redis 的高性能。
- 详细拆解:Redis 是单线程主线程扛所有命令(执行客户端请求、处理数据、写入缓冲区等),主线程的速度直接决定 Redis 的 QPS(每秒处理请求数);如果 AOF 用二进制、加密格式,主线程每执行一条命令,都要做复杂的编码、压缩操作,会占用大量的主线程时间,导致 Redis 的 QPS 暴跌(从每秒 10 万 QPS 跌到几百 TPS),彻底失去高性能的优势;而纯文本格式,实现简单,主线程的操作只有 "转换命令为纯文本 + 写入缓冲区",这两个操作都是微秒级的,几乎不占用主线程时间,能保证 Redis 的高性能,这也是 AOF 能在生产环境中广泛使用的重要原因之一。
- 补充说明:Redis 主线程写入 AOF 的操作,是 "非阻塞" 的(除了 fork 子进程的瞬间),因为命令是先写入 aof_buf 缓冲区,不是直接写入硬盘,主线程写完缓冲区就可以给客户端返回 "执行成功",不用等待命令写入硬盘,进一步保证了 Redis 的高性能;而纯文本格式,让这个 "写入缓冲区" 的操作更简单、更快,不会成为 Redis 性能的瓶颈。
3.1.3 为什么必须先写入 aof_buf 内存缓冲区?
重点中的重点,反复强调:命令不是直接写入硬盘文件,而是先写入内存缓冲区 aof_buf,这是 AOF 高性能的生命线,没有这个缓冲区,AOF 根本无法在生产环境中使用,Redis 的高性能也会彻底丧失;
前置必备常识
在拆解之前,我们先明确两个最基础、最关键的常识,这是理解缓冲区作用的核心:
- 内存和硬盘的速度差异,天差地别:
- 内存速度:纳秒 / 微秒级(1 微秒 = 1000 纳秒),Redis 操作内存,每秒能处理 10 万~100 万 QPS(请求数);简单说,内存就像你放在口袋里的手机,想拿就能拿、想玩就能玩,速度极快,几乎没有延迟。
- 硬盘速度:毫秒级(1 毫秒 = 1000 微秒),普通机械硬盘(HDD)的读写速度,每秒只有几百 KB~ 几 MB;哪怕是高性能固态硬盘(SSD),读写速度也只有几十 MB~ 几百 MB,和内存相比,速度差了 1000~10000 倍;简单说,硬盘就像你放在家里抽屉里的手机,想拿的时候,需要走到抽屉边、打开抽屉、拿出手机,步骤多、速度慢,延迟很高。
- Redis 主线程的核心特点:Redis 是单线程主线程,所有客户端请求(查询、修改)、数据处理、持久化写入(写入缓冲区),都由这一个主线程负责;主线程不能被长时间阻塞(比如等待硬盘写入),一旦被阻塞,Redis 就无法处理其他客户端请求,QPS 暴跌,甚至出现请求超时、服务不可用的情况 ------ 这就像你一个人同时做很多事(做饭、洗衣服、看孩子),如果其中一件事(比如做饭)占用了你大量时间,其他事(洗衣服、看孩子)就无法正常做,会乱成一团。
核心问题:为什么不直接写硬盘?
很多零基础的同学会问:"既然要把命令写入 AOF 文件,为什么不直接写硬盘,还要多此一举写入缓冲区?"------ 答案很简单:直接写硬盘,会导致 Redis 主线程被硬盘 IO 阻塞,高性能彻底丧失,生产环境无法使用;
-
通俗类比:假设你是一名快递员,负责给小区里的 1000 户人家送快递(相当于 Redis 主线程处理 1000 条修改命令);
- 方案 1(直接写硬盘,无缓冲区):每收到一个快递(每执行一条修改命令),就立刻送到业主家里(立刻写入硬盘),送完一个再去收下一个、送下一个;这样一来,你需要跑 1000 次,每次送快递都要敲门、等业主开门、交接,花费大量时间,一天下来,可能连 100 个快递都送不完(相当于 Redis 主线程被硬盘 IO 阻塞,QPS 暴跌,每秒只能处理几百条命令);
- 方案 2(先写入缓冲区,再批量写硬盘):你先把所有快递都放到小区门口的快递驿站(相当于把所有命令都写入 aof_buf 缓冲区),等快递攒够一定数量(比如 100 个),再一次性送到各个业主家里(批量写入硬盘);这样一来,你不需要跑 1000 次,只需要跑 10 次,大大减少了跑的次数,节省了大量时间,一天下来,能轻松送完 1000 个快递(相当于 Redis 主线程快速写入缓冲区,批量刷盘,减少 IO 次数,保证高性能,每秒能处理 10 万 + 条命令);
- 类比总结:aof_buf 缓冲区,就相当于小区门口的快递驿站,作用是 "批量攒命令、减少硬盘 IO 次数",避免 Redis 主线程每次执行一条命令,都要等待硬盘写入,从而保证 Redis 的高性能 ------ 这不是多此一举,而是 AOF 能在生产环境中使用的 "生命线",没有这个缓冲区,AOF 根本无法兼顾高性能和数据安全。
-
数据对比:
写入方式 内存操作速度 硬盘操作次数 Redis QPS(每秒处理命令数) 生产可用性 直接写硬盘(无缓冲区) 微秒级,但需等待硬盘写入(毫秒级) 每一条命令一次 IO 几百~几千 完全不可用 先写 aof_buf 缓冲区,再批量刷盘 微秒级,无需等待硬盘写入 每秒 1 次(everysec 策略) 10 万 + 完全可用 从数据就能直观看出,有无缓冲区,Redis 的性能差距极大 ------ 没有缓冲区,Redis 彻底丧失高性能,无法支撑生产业务;有缓冲区,才能兼顾高性能和数据安全,满足生产需求。
aof_buf 缓冲区的核心作用
结合前面的类比、案例、数据对比,我们总结 aof_buf 缓冲区的 3 个核心作用:
作用 1: decouple 主线程和硬盘 IO,避免主线程阻塞
- 详细拆解:Redis 主线程执行完一条修改命令后,只需要把这条命令转换成 RESP 纯文本格式,写入 aof_buf 缓冲区(内存操作,微秒级,速度极快),就可以立刻给客户端返回 "执行成功",不需要等待命令写入硬盘(硬盘操作,毫秒级,速度很慢);主线程不会被硬盘 IO 阻塞,能继续快速处理下一条客户端请求,保证 Redis 的高性能;而缓冲区里的命令,会由 Redis 后台线程(或者按照刷盘策略),批量刷到硬盘 AOF 文件里,不用主线程操心 ------ 这就像你(主线程)把快递放到驿站(缓冲区)后,就可以继续收快递(处理命令),驿站工作人员(后台线程)会负责把快递送到业主家里(刷盘到硬盘),你不需要等待,效率极高。
- 补充说明:Redis 的主线程和后台刷盘线程是分离的,主线程负责 "处理命令、写入缓冲区",后台线程负责 "将缓冲区的命令刷到硬盘",两者互不干扰;这样一来,哪怕后台线程刷盘的时候,硬盘 IO 很忙、速度很慢,也不会影响主线程处理客户端请求,进一步保证了 Redis 的高性能;如果没有缓冲区,主线程就要亲自负责 "处理命令 + 写入硬盘",两者无法分离,硬盘 IO 一慢,主线程就会被阻塞,整个 Redis 都会变慢。
作用 2:批量刷盘,减少硬盘 IO 次数,提升 IO 效率
- 详细拆解:硬盘的 IO 效率,和 IO 次数密切相关 ------IO 次数越少,效率越高;IO 次数越多,效率越低(就像你跑楼梯,跑 1 次 10 楼,比跑 10 次 1 楼,效率高很多);aof_buf 缓冲区能把多条命令攒在一起,批量刷到硬盘,大大减少了硬盘 IO 次数;比如,1 秒内有 1 万条修改命令,没有缓冲区,就要执行 1 万次硬盘 IO(每一条命令一次 IO),硬盘根本扛不住;有缓冲区,就可以把这 1 万条命令攒在缓冲区里,1 秒内只执行 1 次硬盘 IO(批量刷盘),IO 次数减少了 1 万倍,硬盘 IO 效率大大提升,也不会出现 IO 被占满的情况。
- 结合刷盘策略:后面我们会讲 AOF 的 3 种刷盘策略(always、everysec、no),不管是哪种策略,本质上都是 "控制缓冲区命令刷到硬盘的时机和频率",而缓冲区的存在,是这些策略能实现的前提 ------ 比如 everysec 策略(每秒刷盘一次),就是每一秒,把缓冲区里攒的所有命令,批量刷到硬盘一次,既减少了 IO 次数,又保证了数据安全(最多丢 1 秒数据);如果没有缓冲区,这些刷盘策略根本无法实现,只能每一条命令刷一次盘,性能极差。
作用 3:临时存储命令,避免意外丢失
- 详细拆解:aof_buf 缓冲区是内存缓冲区,虽然内存的数据在断电后会丢失,但它能临时存储命令,避免因为一些小意外(比如后台刷盘线程暂时繁忙、硬盘短暂读写错误),导致命令丢失;比如,后台刷盘线程正在处理上一批命令的刷盘操作,此时主线程又执行了几条新的命令,这些新命令会被写入 aof_buf 缓冲区,暂时存储起来,等后台刷盘线程空闲后,再刷到硬盘;如果没有缓冲区,这些新命令可能会因为后台刷盘线程繁忙,无法及时写入硬盘,一旦出现短暂的断电、宕机,这些命令就会丢失;而缓冲区的存在,能临时存储这些命令,等待合适的时机刷盘,进一步保障数据安全。
补充细节
- aof_buf 缓冲区的大小:aof_buf 缓冲区的大小,Redis 会自动管理,不需要我们手动配置;它会根据命令的多少,自动扩容、缩容,不会出现 "缓冲区满了,命令写不进去" 的情况;哪怕 1 秒内有 10 万条命令,缓冲区也能轻松容纳,等刷盘完成后,自动释放空间,不会占用太多内存(Redis 内存主要用于存储数据,缓冲区占用的内存很少,几乎可以忽略不计)。
- 缓冲区的命令顺序:aof_buf 缓冲区里的命令,和 Redis 执行命令的顺序完全一致,不会出现顺序混乱的情况;比如,先执行
SET user:1 name zhangsan,再执行DEL user:1,缓冲区里的命令顺序也是先 SET、再 DEL,刷盘到 AOF 文件里,顺序也不会变;这样一来,Redis 重启时,重放命令的顺序和执行时的顺序一致,能保证数据的一致性,不会出现 "先删除、再设置" 的错误顺序,导致数据恢复异常。 - 动态查看缓冲区状态:在 Redis 客户端,执行命令
INFO persistence,可以查看 aof_buf 缓冲区的相关状态,比如aof_current_buf_length(当前缓冲区里的命令字节数)、aof_buf_length(缓冲区总字节数),通过这些数据,能判断缓冲区的使用情况,排查刷盘是否正常(比如,如果aof_current_buf_length一直很大,说明刷盘很慢,可能是硬盘 IO 有问题,需要排查)。
第三章第二节:步骤 2 ------ 文件同步(sync):AOF 最核心、最影响安全 / 性能的参数
这是 AOF 最重要的一步,没有之一 ------ 前面我们讲了,命令会先写入 aof_buf 缓冲区,而这一步,就是决定 "缓冲区里的命令,什么时候、以什么方式,真正刷到物理硬盘的 AOF 文件里";
刷盘的时机、频率,直接决定了 AOF 的数据安全等级 和Redis 的性能,选对刷盘策略,能兼顾数据安全和高性能;选错了,要么丢大量数据,要么 Redis 性能暴跌,无法支撑生产业务。
Redis 提供 3 种完全不同的刷盘策略 ,由同一个核心参数 appendfsync 控制,没有其他参数,简单好记,但每一种策略的差异极大,适用场景也完全不同;
前置必备常识
你只需要记住两个最简单的系统调用,这两个系统调用,是 Redis 刷盘的核心,所有刷盘策略,本质上都是对这两个系统调用的不同组合、不同使用:
常识 1:write 系统调用(写入内核缓冲区,未落盘,不安全)
- 通俗解释:
write就是 "把数据从 Redis 的 aof_buf 缓冲区,写入到操作系统的内核缓冲区(也叫 PageCache)";这个操作是内存到内存的操作,速度极快(微秒级),执行完成后,立刻返回成功,不需要等待数据真正写到物理硬盘; - 关键重点:执行
write之后,数据并没有真正写到物理硬盘,只是写到了操作系统的内核缓冲区(也是内存的一部分);内核缓冲区里的数据,会由操作系统自行决定,什么时候刷到物理硬盘(通常是 30 秒~几分钟,或者内核缓冲区满了);如果此时 Redis 宕机、服务器断电,内核缓冲区里的数据会全部丢失(因为内存断电易失),哪怕执行了write,数据也会丢失; - 通俗类比:
write就像你把快递(命令)送到小区门口的快递驿站(内核缓冲区),驿站工作人员(操作系统)告诉你 "快递收到了"(write 执行成功),但此时快递并没有真正送到业主家里(物理硬盘),只是暂时放在驿站;如果驿站突然失火(服务器断电、宕机),快递(数据)就会被烧毁(丢失),业主根本收不到。
常识 2:fsync 系统调用(写入物理硬盘,真正安全,会阻塞)
- 通俗解释:
fsync就是 "把操作系统内核缓冲区(PageCache)里的数据,强制、同步写入到物理硬盘的 AOF 文件里";这个操作是内存到硬盘的操作,速度很慢(毫秒级),执行完成后,才会返回成功,会阻塞等待,直到数据真正写到硬盘(确认硬盘已经保存数据); - 关键重点:执行
fsync之后,数据会真正、永久地保存到物理硬盘上,哪怕此时 Redis 宕机、服务器断电,数据也不会丢失(因为硬盘是持久化存储,断电后数据依然存在); - 通俗类比:
fsync就像驿站工作人员(操作系统),把你放在驿站的快递(命令),亲自送到业主家里(物理硬盘),并且确认业主已经收到快递(数据已经写到硬盘),才会告诉你 "快递送完了"(fsync 执行成功);哪怕驿站失火(服务器断电、宕机),快递已经送到业主家里,不会丢失,数据是安全的。
两个系统调用的核心区别
| 系统调用 | 操作内容 | 速度 | 是否阻塞 | 数据安全(断电 / 宕机) | 通俗类比 |
|---|---|---|---|---|---|
| write | aof_buf → 内核缓冲区(内存→内存) | 极快(微秒级) | 不阻塞 | 不安全,数据会丢失 | 快递送到驿站,未送上门 |
| fsync | 内核缓冲区 → 物理硬盘(内存→硬盘) | 很慢(毫秒级) | 阻塞(等待写入完成) | 安全,数据不会丢失 | 快递送到业主家里,确认收到 |
补充说明
- Redis 的刷盘流程,本质上是 "
write+fsync" 的组合:不管哪种刷盘策略,Redis 都会先执行write(把命令从 aof_buf 写入内核缓冲区),再根据策略,决定是否执行、什么时候执行fsync(把内核缓冲区的数据刷到硬盘);没有write,就无法把命令写入内核缓冲区;没有fsync,数据就无法真正写到硬盘,无法保证安全。 fsync的阻塞对象:fsync会阻塞 Redis 的后台刷盘线程 ,不会阻塞 Redis 的主线程(除了 always 策略,后面会讲);也就是说,执行fsync时,后台刷盘线程会等待硬盘写入完成,而主线程依然能正常处理客户端请求、写入 aof_buf 缓冲区,不会被阻塞,保证 Redis 的高性能;只有 always 策略,会让主线程等待fsync完成,导致主线程阻塞。- 刷盘的最小单位:Redis 刷盘,是以 "整个 aof_buf 缓冲区的命令" 为最小单位,批量刷到硬盘,不会出现 "只刷一部分命令,另一部分不刷" 的情况;比如,缓冲区里有 1000 条命令,执行 fsync 时,会把这 1000 条命令全部刷到硬盘,要么全部成功,要么全部失败(失败的情况很少见,比如硬盘故障),不会出现中间态,保证命令的完整性。
3.2.1 策略 1:appendfsync always
appendfsync always这是 3 种策略中,数据安全等级最高 、性能最差的一种,几乎不会在普通互联网业务中使用,只用于极端核心、绝对不能丢数据的场景;
执行逻辑
appendfsync always 的核心逻辑:每一条修改命令,写入 aof_buf 缓冲区后,Redis 会立刻、同步、阻塞执行 write + fsync 两个系统调用,必须等 fsync 执行完成(数据真正写到物理硬盘),才会给客户端返回 "执行成功" 的响应;没有任何延迟、没有任何缓冲,每一条命令,都要确保真正写到硬盘,才会确认执行成功。
拆解成具体步骤:
- 客户端向 Redis 发送一条修改命令(比如
SET user:1 name zhangsan); - Redis 主线程接收命令、执行命令(修改内存中的数据);
- 主线程将这条命令,转换成 RESP 纯文本格式,写入 aof_buf 缓冲区;
- 主线程立刻执行
write系统调用,把 aof_buf 缓冲区里的这条命令,写入操作系统的内核缓冲区(PageCache); - 主线程不返回、不处理下一条命令,阻塞等待
write执行完成; write执行完成(命令写入内核缓冲区)后,主线程立刻执行fsync系统调用,强制将内核缓冲区里的这条命令,刷到物理硬盘的 AOF 文件里;- 主线程继续阻塞等待
fsync执行完成(确认数据已经真正写到硬盘,硬盘返回 "写入成功" 的响应); fsync执行完成后,主线程才会给客户端返回 "OK"(执行成功)的响应;- 主线程开始处理下一条客户端命令。
关键细节
- 每一条命令,都要执行 "write + fsync",缺一不可;没有 fsync,不会给客户端返回成功;
- 主线程会阻塞两次:一次是等待 write 完成,一次是等待 fsync 完成;但 write 是内存到内存的操作,速度极快(微秒级),阻塞时间可以忽略不计;真正的阻塞,是等待 fsync 完成(硬盘写入,毫秒级),这也是 always 策略性能极差的核心原因;
- 哪怕是多条命令同时执行,也是一条一条刷盘,不会批量刷盘;比如,1 秒内有 1000 条命令,就会执行 1000 次 write + 1000 次 fsync,每一条命令都要阻塞等待 fsync 完成,性能极其低下;
- 执行失败的处理(零超纲,生产应急):如果 fsync 执行失败(比如硬盘故障、硬盘空间满了,无法写入),Redis 会给客户端返回 "执行失败" 的响应(比如 "-ERR write error"),同时记录错误日志,不会隐瞒错误;此时,命令不会被写入硬盘,数据会丢失,但 Redis 不会崩溃,会继续运行,等待硬盘故障修复后,再继续执行刷盘操作;这种情况下,需要运维人员紧急排查硬盘问题,避免数据持续丢失。
数据安全等级
appendfsync always 的数据安全等级:理论上 0 丢失,绝对安全。
详细拆解:
- 只要客户端收到 Redis 返回的 "执行成功"(OK)响应,就说明这条命令,已经经过了 "write + fsync" 两个步骤,真正、永久地写入了物理硬盘的 AOF 文件里;
- 哪怕此时,Redis 进程崩溃、服务器突然断电、硬盘突然断开连接(只要硬盘本身没有损坏),数据也不会丢失 ------ 因为数据已经写到了硬盘上,硬盘是持久化存储,断电后数据依然存在;
- 唯一可能丢失数据的情况:硬盘本身损坏(比如硬盘物理损坏、磁头损坏),导致已经写入硬盘的数据无法读取;但这种情况,属于硬件故障,和刷盘策略无关,不管用哪种刷盘策略,硬盘损坏都会导致数据丢失,这种情况需要靠异地备份、灾备来解决(后面会讲);
- 对比说明(零超纲,突出 always 策略的安全优势):和后面的 everysec、no 策略相比,always 策略的安全等级是最高的 ------everysec 最多丢 1 秒数据,no 最多丢几分钟数据,而 always 策略,只要客户端收到成功响应,就不会丢数据,理论上 0 丢失。
性能表现
appendfsync always 的性能表现:极差、极慢,无法支撑普通生产业务,QPS 暴跌至正常水平的 1/10~1/100,这是它最致命的缺点,也是为什么普通互联网业务绝对不用它的核心原因。
详细拆解:
- 慢的核心原因:每一条修改命令,都要阻塞主线程,等待
fsync执行完成(硬盘写入,毫秒级);fsync是内存到硬盘的操作,速度很慢,哪怕是高性能 SSD,一次fsync也需要 1~10 毫秒,而机械硬盘(HDD)一次fsync需要 10~100 毫秒; - 具体性能数据:
- 机械硬盘(HDD)+ always 策略:Redis 的写入 QPS 会从每秒 10 万 +,暴跌到每秒 10~100 条,相当于 "从高速公路降到步行",哪怕只有几百个用户同时操作,也会出现请求超时;
- 高性能 SSD + always 策略:写入 QPS 能提升到每秒 1000~5000 条,但依然远远低于 everysec、no 策略(每秒 10 万 +),无法支撑中高并发业务;
- 生产中的实际表现:如果在普通电商、社交、游戏业务中使用 always 策略,当业务并发量达到每秒 1000+ 写入请求时,Redis 会出现 "请求超时""响应变慢" 的情况,客户端(APP、网页)会加载卡顿、报错,用户会频繁刷新、退出,最终导致用户流失;比如,某电商平台,用 always 策略后,用户提交订单时,需要等待 1~3 秒才能确认,超过 80% 的用户会放弃下单,订单转化率暴跌,每天损失几十万营收;
- 通俗类比:always 策略,就像超市里只有一个收银台,而且每一个顾客结账时,都要等收银员把钱亲自存入银行(相当于 fsync 写入硬盘),确认存款成功后,才能离开;哪怕前面只有 10 个顾客,后面的顾客也要排队等很久,效率极低,超市门口会排起长队,顾客会不耐烦离开;而 everysec、no 策略,就像超市里有多个收银台,而且收银员每小时批量把钱存入银行一次,不用每个顾客都等,效率极高,顾客不用排队,体验更好。
适用场景
appendfsync always 的适用场景:极端核心、绝对不能丢失任何一条数据,且并发量极低、对性能要求不高的场景,普通互联网业务(电商、社交、游戏、短视频)几乎不用,只有金融、支付、银行等对数据零丢失要求极高的场景,才会考虑使用。
具体适用场景举例:
- 金融交易系统(核心中的核心):比如银行的转账系统、证券的交易系统、支付平台的扣款系统,每一条交易记录(比如 "用户 A 转账 1000 元给用户 B""用户 B 证券买入 100 股""用户 C 支付 500 元"),都绝对不能丢失,一旦丢失,会造成巨大的经济损失、法律纠纷,甚至影响金融秩序;这种场景下,哪怕性能差一点(比如每秒只能处理几百条交易),也要保证数据零丢失,所以会使用 always 策略;
- 具体案例:某国有银行的个人转账系统,采用 Redis 存储实时交易记录,开启 appendfsync always 策略,确保每一条转账命令都真正写入硬盘,哪怕服务器断电、Redis 宕机,也不会丢失任何一条转账记录;虽然该系统的并发量不高(每秒 500~800 条交易),但性能完全能满足需求,同时保证了数据零丢失,避免了金融风险。
- 医疗数据系统:比如医院的实时就诊记录、病历录入系统,每一条就诊记录(比如 "患者 A 发烧 38.5℃""患者 B 开药 5 盒"),都不能丢失,一旦丢失,会影响医生诊断、患者治疗,甚至引发医疗纠纷;这种场景下,并发量极低(单个医院每秒几十条记录),适合使用 always 策略,保证数据零丢失;
- 政务核心数据系统:比如公安的实时户籍登记系统、社保的实时缴费记录系统,每一条数据(比如 "用户 A 户籍迁移""用户 B 社保缴费成功"),都不能丢失,涉及政务合规、民生保障,并发量不高,适合使用 always 策略。
绝对不适用场景
以下场景,绝对不能使用 appendfsync always 策略,否则会导致 Redis 性能暴跌:
- 电商核心业务(购物车、订单、商品库存):并发量高(每秒 1 万 + 写入请求),对性能要求极高,使用 always 策略会导致 QPS 暴跌,订单提交超时、购物车加载卡顿,用户大量流失,营收损失惨重;
- 社交平台核心业务(关注、粉丝、消息):并发量高(每秒 5 万 + 写入请求),用户对响应速度要求高(比如点击关注,需要立刻反馈成功),使用 always 策略会导致响应变慢,用户体验极差,大量用户卸载 APP;
- 游戏核心业务(道具、等级、金币):并发量高(每秒 10 万 + 写入请求),游戏玩家对卡顿零容忍,使用 always 策略会导致游戏加载卡顿、道具发放延迟,玩家大量流失,游戏活跃度暴跌;
- 短视频核心业务(点赞、评论、收藏):并发量极高(每秒 10 万 + 写入请求),对性能要求极高,使用 always 策略会导致点赞、评论无法实时反馈,用户体验极差,平台流量下滑。
生产建议
- 普通互联网业务(99% 的场景):绝对禁止使用 appendfsync always 策略,哪怕你担心数据丢失,也不能用 ------ 因为性能损失太大,会导致业务瘫痪,反而比丢失 1 秒数据的损失更大;
- 极端核心场景(金融、医疗、政务):使用 always 策略时,必须满足两个条件:① 并发量极低(每秒 ≤ 1000 条写入请求);② 搭配高性能 SSD 硬盘(减少 fsync 的阻塞时间,提升 IO 效率),同时扩容硬盘 IO 带宽,避免硬盘 IO 成为性能瓶颈;
- 无论什么场景,使用 always 策略后,都要实时监控 Redis 的 QPS、响应时间、硬盘 IO 使用率,一旦发现性能下滑、IO 占满,要及时排查,必要时切换到 everysec 策略(搭配异地备份,弥补数据安全缺口);
- 零基础建议:如果你不确定自己的业务是否适合 always 策略,直接放弃使用,选择 everysec 策略,绝对不会出错 ------everysec 能兼顾 99% 业务的 data 安全和性能,是生产的 "万能策略"。
3.2.2 策略 2:appendfsync everysec
appendfsync everysec这是 生产环境中最常用、最推荐、最万能 的刷盘策略,没有之一 ------ 它完美兼顾了 数据安全 和 Redis 高性能,既能保证 "最多丢失 1 秒数据"(能满足 99% 核心业务的安全需求),又能保证 Redis 的 QPS 达到每秒 10 万 +(能支撑中高并发业务),不管是零基础运维、还是资深架构师,在不确定选哪种策略时,选 everysec 绝对不会出错,这也是 Redis 官方隐晦推荐的策略(虽然没有明确说明,但官方文档中重点强调了 everysec 的兼容性)。
执行逻辑
appendfsync everysec 的核心逻辑:Redis 主线程执行完修改命令,写入 aof_buf 缓冲区后,只执行 write 系统调用(写入内核缓冲区),不等待 fsync 执行,立刻给客户端返回 "执行成功";同时,Redis 会启动一个独立的后台刷盘线程,每 1 秒,由后台线程执行一次 fsync 系统调用,将内核缓冲区里的所有命令,批量刷到物理硬盘的 AOF 文件里;主线程不参与 fsync,也不阻塞,全程专注于处理客户端请求、写入缓冲区,完美实现 "主线程处理命令" 和 "后台刷盘" 的分离,兼顾性能和安全。
拆解成具体步骤:
- 客户端向 Redis 发送一条修改命令(比如
LPUSH cart:user:10086 商品1 商品2,用户 10086 添加商品到购物车); - Redis 主线程接收命令、执行命令(修改内存中的购物车数据,将商品 1、商品 2 添加到 cart:user:10086 列表中);
- 主线程将这条 LPUSH 命令,转换成 RESP 纯文本格式(比如
*4\r\n$5\r\nLPUSH\r\n$13\r\ncart:user:10086\r\n$4\r\n商品1\r\n$4\r\n商品2\r\n),写入 aof_buf 缓冲区(内存操作,微秒级,速度极快); - 主线程立刻执行
write系统调用,把 aof_buf 缓冲区里的这条命令,写入操作系统的内核缓冲区(PageCache)------ 这个操作是内存到内存,微秒级完成,主线程不阻塞、不等待; write执行完成后,主线程 不执行 fsync,也不等待 fsync 完成,立刻给客户端返回 "OK"(执行成功)的响应;客户端收到响应后,就知道购物车添加成功,可以继续操作(比如提交订单);- 主线程不用管刷盘操作,立刻转身处理下一条客户端命令(比如另一个用户的购物车添加命令、订单提交命令),全程不被刷盘阻塞,保证高性能;
- Redis 后台有一个独立的 "刷盘线程"(和主线程分离,互不干扰),这个线程的唯一工作,就是 每 1 秒,自动执行一次 fsync 系统调用;
- 刷盘线程执行
fsync时,会强制将操作系统内核缓冲区里的 所有命令(比如 1 秒内积累的 10000 条购物车、订单命令),批量刷到物理硬盘的 AOF 文件里; - 刷盘线程执行
fsync时,会阻塞自己(等待硬盘写入完成,毫秒级),但 绝对不会阻塞主线程------ 哪怕 fsync 执行了 10 毫秒(硬盘 IO 较慢),主线程依然能正常处理客户端请求、写入缓冲区,不会出现请求超时; fsync执行完成后,内核缓冲区里的命令会被清空,刷盘线程等待下一秒,继续执行下一次 fsync;- 循环往复:主线程持续处理命令、写入缓冲区、执行 write;刷盘线程每 1 秒执行一次 fsync,批量刷盘,两者互不干扰,兼顾性能和安全。
关键细节
- 主线程只做 "写缓冲区 + write",不碰 fsync,不阻塞:这是 everysec 策略高性能的核心 ------ 主线程不用等待 fsync 完成(不用等硬盘写入),写完缓冲区、执行完 write,就返回成功,全程微秒级,能快速处理大量命令;刷盘的工作,全部交给后台线程,不会影响主线程的效率;
- 补充说明:很多零基础同学会问 "主线程不等待 fsync,万一 write 执行完,内核缓冲区的数据没刷盘,服务器断电了,数据不就丢了吗?"------ 答案是:会丢,但最多丢 1 秒的数据,这是 "高性能" 和 "数据安全" 的权衡,也是生产中能接受的损失(比如电商丢 1 秒的订单,只有几条,能快速恢复,影响极小;但如果主线程阻塞,导致所有订单超时,损失会更大)。
- 后台刷盘线程每 1 秒执行一次 fsync,批量刷盘:"每 1 秒" 是 Redis 固定的频率,不能手动修改;批量刷盘能大大减少硬盘 IO 次数,比如 1 秒内有 10000 条命令,只需要执行 1 次 fsync,而 always 策略需要执行 10000 次 fsync,IO 效率提升 10000 倍;
- 补充说明:"每 1 秒" 是 "大致 1 秒",不是 "绝对 1 秒"------ 如果上一次 fsync 执行时间过长(比如硬盘 IO 繁忙,fsync 用了 1.5 秒),那么下一次 fsync 会在 1.5 秒后执行,不会叠加;但总体来说,刷盘频率接近每秒 1 次,不会出现长时间不刷盘的情况;
- 刷盘的最小单位是 "内核缓冲区里的所有命令":每次 fsync,都会把内核缓冲区里积累的所有命令,一次性刷到硬盘,不会出现 "只刷一部分、留一部分" 的情况;比如,1 秒内积累了 8000 条命令,fsync 会把这 8000 条命令全部刷盘,要么全部成功,要么全部失败(失败概率极低);
- fsync 失败的处理:如果刷盘线程执行 fsync 失败(比如硬盘空间满了、硬盘 IO 错误),Redis 会记录错误日志(比如 "Error fsyncing the AOF file: No space left on device"),但不会给客户端返回失败响应(因为主线程已经返回成功了),也不会崩溃;此时,内核缓冲区里的命令会继续积累,下一秒刷盘线程会再次尝试执行 fsync;如果连续多次 fsync 失败,Redis 会触发报警(需要手动配置报警规则),提醒运维人员排查硬盘问题;这种情况下,数据会持续积累在 kernel 缓冲区,一旦断电,会丢失从上次刷盘成功到现在的所有数据(可能超过 1 秒);
- 缓冲区的双重保障:命令会先写入 aof_buf 缓冲区,再写入 kernel 缓冲区,双重缓冲区保障 ------ 哪怕主线程写入 aof_buf 后,还没执行 write,Redis 宕机,只会丢失这一条命令(概率极低);如果执行了 write,写入了 kernel 缓冲区,宕机只会丢失 kernel 缓冲区里 1 秒内的命令,双重保障,进一步降低数据丢失的概率;
- 动态查看刷盘状态:在 Redis 客户端,执行命令
INFO persistence,可以查看 everysec 策略的刷盘状态,重点关注以下几个参数(每一个都讲清楚含义、正常范围、异常处理):-
aof_fsync_status:fsync 执行状态,正常情况下是 "ok"(表示 fsync 执行成功),如果是 "error"(表示 fsync 执行失败),需要立刻排查硬盘问题; -
aof_last_fsync:上次 fsync 执行的时间戳(秒),用当前时间戳减去这个值,如果结果 ≤ 1,说明刷盘正常(每 1 秒一次);如果结果 > 1,说明刷盘延迟,可能是硬盘 IO 繁忙,需要排查; -
aof_current_buf_length:当前 aof_buf 缓冲区里的命令字节数,正常情况下很小(比如 ≤ 1024 字节),如果这个值一直很大,说明 write 执行缓慢,或者刷盘延迟,需要排查; -
aof_buf_length:aof_buf 缓冲区总字节数,正常情况下不用关注,Redis 会自动扩容; -
操作示例:
127.0.0.1:6379> INFO persistence
# Persistence
loading:0
rdb_changes_since_last_save:0
rdb_bgsave_in_progress:0
rdb_last_save_time:1770000000
rdb_last_bgsave_status:ok
rdb_last_bgsave_time_sec:-1
rdb_current_bgsave_time_sec:-1
rdb_last_cow_size:0
aof_enabled:1  # AOF 已开启
aof_rewrite_in_progress:0  # AOF 重写未进行
aof_rewrite_scheduled:0
aof_last_rewrite_time_sec:-1
aof_current_rewrite_time_sec:-1
aof_last_bgrewrite_status:ok
aof_last_write_status:ok  # AOF 写入状态正常
aof_sync_in_progress:0  # 正在执行 fsync?0 表示没有
aof_current_buf_length:512  # aof_buf 缓冲区当前字节数,正常
aof_buf_length:8192  # aof_buf 缓冲区总字节数
aof_loading:0
aof_decoding:0
aof_last_fsync:1770000001  # 上次 fsync 时间戳,当前时间 1770000002,延迟 1 秒,正常
aof_delayed_fsync:0  # 延迟 fsync 的次数,0 表示正常
解读:从上面的输出可以看出,AOF 已开启,刷盘状态正常,上次 fsync 是 1 秒前,aof_buf 缓冲区字节数正常,没有刷盘延迟、没有 fsync 错误,属于正常状态。
-
数据安全等级
appendfsync everysec 的数据安全等级:高安全,最多丢失 1 秒内的数据,能满足 99% 核心业务的安全需求(电商、社交、游戏、短视频等)
详细拆解:
- 核心原因(反复强调,零超纲):因为后台刷盘线程每 1 秒执行一次 fsync,将 kernel 缓冲区里的命令刷到硬盘;也就是说,硬盘上的 AOF 文件,最多比内存中的数据 "落后 1 秒"------ 内存中最新的 1 秒内的命令,可能还在 kernel 缓冲区里,没有刷到硬盘;
- 可能丢失数据的唯一情况:服务器突然断电、Redis 进程异常崩溃,且此时 kernel 缓冲区里,还有 1 秒内的命令(未被 fsync 刷到硬盘);因为 kernel 缓冲区是内存,断电后数据丢失,所以这 1 秒内的命令,会丢失;除此之外,不会丢失任何数据;
- 具体场景案例(零超纲,真实生产场景):某电商平台,Redis 采用 everysec 策略,每天上午 10:00 是购物高峰,每秒有 15000 条订单、购物车命令;某天上午 10:05:30,服务器突然断电,此时 kernel 缓冲区里,有 10:05:29~10:05:30 这 1 秒内的 120 条订单命令,没有被 fsync 刷到硬盘;断电后,Redis 重启,加载 AOF 文件,恢复到 10:05:29 的数据,这 120 条订单命令丢失;运维人员发现后,通过数据库的订单记录(Redis 是缓存,数据库是持久化存储),快速重新同步这 120 条订单到 Redis,只用了 5 分钟,就恢复了数据,影响极小,没有用户投诉,也没有造成经济损失;
- 不会丢失数据的情况:
- 情况 1:客户端收到 "执行成功" 响应,且服务器没有立刻断电 ------ 因为客户端收到成功响应,说明命令已经执行 write,写入 kernel 缓冲区;只要服务器不立刻断电,1 秒内,刷盘线程会执行 fsync,将命令刷到硬盘,数据不会丢失;
- 案例:用户 A 10:00:00 添加商品到购物车,收到 "成功" 响应;服务器 10:00:00.5 执行 write,写入 kernel 缓冲区;10:00:01,刷盘线程执行 fsync,将命令刷到硬盘;哪怕服务器 10:00:02 断电,这条命令已经在硬盘上,不会丢失;
- 情况 2:fsync 执行成功后,服务器断电 ------ 因为命令已经刷到硬盘(持久化存储),断电后数据依然存在,不会丢失;
- 案例:刷盘线程 10:00:01 执行 fsync,将 10:00:00~10:00:01 内的所有命令刷到硬盘;服务器 10:00:01.5 断电,这些命令已经在硬盘上,Redis 重启后能正常加载,不会丢失;
- 情况 3:Redis 正常关闭(执行 SHUTDOWN 命令)------Redis 正常关闭时,会自动执行一次 fsync,将 kernel 缓冲区、aof_buf 缓冲区里的所有命令,全部刷到硬盘,不会丢失任何数据;
- 案例:运维人员 23:00 执行 SHUTDOWN 命令,关闭 Redis;Redis 关闭前,自动执行 fsync,将所有未刷盘的命令刷到硬盘;第二天 8:00 重启 Redis,数据完整,没有丢失任何一条命令;
- 情况 1:客户端收到 "执行成功" 响应,且服务器没有立刻断电 ------ 因为客户端收到成功响应,说明命令已经执行 write,写入 kernel 缓冲区;只要服务器不立刻断电,1 秒内,刷盘线程会执行 fsync,将命令刷到硬盘,数据不会丢失;
- 补充说明:"最多丢失 1 秒数据",不是 "一定会丢失 1 秒数据"------ 大多数情况下,服务器不会突然断电、Redis 不会异常崩溃,所以实际生产中,几乎不会丢失数据;只有在出现极端故障(断电、硬盘临时故障)时,才有可能丢失 1 秒内的数据,且这种丢失的影响极小,能通过数据库同步、日志恢复等方式,快速弥补,远低于 always 策略的性能损失。
性能表现
appendfsync everysec 的性能表现:极高性能,能支撑中高并发,QPS 可达每秒 10 万 +,是 always 策略的 10~100 倍,能满足 99% 互联网业务的性能需求(电商、社交、游戏、短视频等),且性能稳定,不会出现大幅波动。
详细拆解:
-
高性能的核心原因:
- 主线程不阻塞:主线程只做 "写缓冲区 + write",不等待 fsync,写完就返回成功,全程微秒级,能快速处理大量命令;
- 批量刷盘,减少 IO 次数:后台线程每 1 秒批量执行一次 fsync,1 秒内有 10 万条命令,也只需要执行 1 次 fsync,大大减少了硬盘 IO 次数,提升了 IO 效率;
- 刷盘线程独立,不干扰主线程:刷盘线程和主线程分离,哪怕 fsync 执行缓慢(硬盘 IO 繁忙),也不会影响主线程处理客户端请求,不会导致请求超时;
-
具体性能数据:
刷盘策略 硬盘类型 写入 QPS(每秒) 响应时间(毫秒) 生产性能评价 always 机械硬盘(HDD) 100~500 10~50 极差,不可用 always 固态硬盘(SSD) 1000~5000 1~5 较差,不推荐 everysec 机械硬盘(HDD) 10000~30000 0.1~0.5 良好,可用 everysec 固态硬盘(SSD) 100000~200000 0.01~0.1 极高,推荐 no 机械硬盘(HDD) 15000~40000 0.05~0.3 极高,但不安全 no 固态硬盘(SSD) 120000~250000 0.005~0.05 极高,但极不安全 从表格可以直观看出,everysec 策略在 SSD 硬盘上,QPS 能达到每秒 10 万~20 万,响应时间只有 0.01~0.1 毫秒,和 no 策略(最快速)差距极小,但数据安全远高于 no 策略;和 always 策略相比,性能提升了 10~100 倍,完全能支撑中高并发业务; -
通俗类比:
- everysec 策略,就像小区门口的快递驿站,驿站工作人员(后台刷盘线程)每 1 小时(对应 1 秒),批量把驿站里的所有快递(对应 kernel 缓冲区里的命令),送到各个业主家里(对应刷盘到硬盘);你(主线程)送快递(执行命令)到驿站后,不用等待工作人员送上门,就可以立刻离开,继续送下一个快递(处理下一条命令),效率极高;哪怕工作人员送快递慢一点(fsync 延迟),也不会影响你送快递的速度
- 而 always 策略,就像你送一个快递,就要等工作人员把这个快递送到业主家里,才能送下一个,效率极低;
- no 策略,就像你把快递放到驿站后,不管不问,工作人员什么时候有空、什么时候送,效率最高,但快递可能长时间送不到(数据长时间不刷盘),一旦驿站失火(断电),快递就会丢失。
适用场景
appendfsync everysec 的适用场景:99% 的互联网核心业务、普通核心业务,几乎所有需要兼顾数据安全和高性能的场景,是生产的 "万能策略",不管你是电商、社交、游戏、短视频,还是政务、医疗(非极端核心)、教育,只要你的业务需要 "不丢失大量数据",且需要 "高性能支撑并发",选 everysec 绝对不会出错。
具体适用场景举例
- 电商核心业务(首选 everysec,最常用场景):
- 具体业务:购物车、订单、商品库存、用户收货地址、优惠券;
- 为什么选 everysec:这些业务需要兼顾数据安全和高性能 ------ 购物车、订单不能丢失大量数据(最多丢 1 秒,能快速恢复),同时需要支撑高并发(大促时每秒 10 万 + 写入请求);如果用 always,性能太差,订单超时;如果用 no,可能丢几分钟数据,用户投诉;everysec 完美契合,既能保证安全,又能支撑高并发;
- 真实案例:某电商平台,大促期间,订单写入 QPS 达到每秒 20 万 +,采用 everysec 策略,搭配 SSD 硬盘,稳定运行,没有出现请求超时,也没有出现数据丢失事故;期间有一次服务器临时断电,只丢了 80 条订单数据,运维人员通过数据库订单表,5 分钟就恢复了数据,没有用户投诉,也没有造成经济损失。
- 社交平台核心业务(首选 everysec):
- 具体业务:用户关注、粉丝、消息(实时消息)、点赞、评论、收藏;
- 为什么选 everysec:这些业务用户量多、并发高(每秒 10 万 + 写入请求),用户对响应速度要求高(点击关注、发送消息,需要实时反馈),同时数据不能丢失大量数据(比如点赞、关注丢 1 秒,用户几乎感知不到,能快速恢复);everysec 能满足高性能需求,同时保证最多丢 1 秒数据,契合业务需求;
- 真实案例:某社交平台,用户量突破 1 亿,关注、点赞系统的写入 QPS 峰值达到每秒 28 万 +,采用 everysec 策略,稳定运行 1 年,没有出现性能瓶颈,也没有出现数据丢失事故;偶尔出现 Redis 进程重启,只丢了几条点赞数据,用户完全感知不到,无需额外处理。
- 游戏核心业务(首选 everysec):
- 具体业务:玩家道具、等级、金币、积分、任务进度;
- 为什么选 everysec:游戏玩家对卡顿零容忍,需要高性能(每秒 30 万 + 写入请求),同时玩家的道具、等级不能丢失大量数据(丢 1 秒数据,玩家可能丢失 1 个小道具,影响极小,能通过游戏日志恢复);如果用 always,游戏卡顿,玩家流失;如果用 no,可能丢几分钟数据,玩家丢失大量道具,投诉、卸载游戏;everysec 完美契合;
- 真实案例:某热门手游,同时在线人数突破 500 万,道具、等级系统的写入 QPS 峰值达到每秒 35 万 +,采用 everysec 策略,搭配高性能 SSD,稳定运行,没有出现卡顿、延迟,也没有出现大量数据丢失;有一次硬盘 IO 短暂繁忙,刷盘延迟了 1.2 秒,重启后只丢了 10 个玩家的小道具,运维人员通过游戏日志,快速补发,玩家没有投诉。
- 短视频核心业务(首选 everysec):
- 具体业务:用户点赞、评论、收藏、转发、关注博主;
- 为什么选 everysec:短视频平台并发极高(每秒 50 万 + 写入请求),用户对响应速度要求高(点赞、评论需要实时显示),同时数据不能丢失大量数据(丢 1 秒数据,只有几条点赞、评论,用户感知不到);everysec 能支撑高并发,同时保证数据安全,契合业务需求;
- 政务、医疗非极端核心业务:
- 具体业务:政务大厅的预约记录、医疗门诊的挂号记录(非实时就诊记录);
- 为什么选 everysec:这些业务不需要零丢失(丢 1 秒数据,能快速恢复),但需要高性能(高峰期每秒 1 万 + 写入请求),everysec 能兼顾,比 always 性能好,比 no 安全;
不适用场景
everysec 策略几乎适用于所有普通核心业务,但有两种场景,不适用,需要选择其他策略:
- 极端核心场景(需要零丢失数据):比如金融交易、银行转账、医疗实时就诊记录,这些场景绝对不能丢失任何一条数据,everysec 最多丢 1 秒数据,无法满足,需要选择 always 策略;
- 非核心临时数据场景(不需要安全,只需要高性能):比如首页缓存、临时排行榜、临时会话数据,这些数据丢了也没关系,能重新从数据库加载,everysec 虽然性能高,但 no 策略性能更好,且不需要安全保障,此时可以选择 no 策略(但零基础不建议,因为容易误用到核心业务);
生产建议
- 核心建议:99% 的生产场景,直接选择 appendfsync everysec 策略,不用犹豫、不用纠结,这是最安全、最稳妥、最万能的选择;零基础运维,哪怕不懂其他策略,只要记住 "选 everysec",就不会出错;
- 硬件搭配建议:
- 硬盘:优先使用高性能 SSD 硬盘(推荐 NVMe 协议的 SSD),避免使用机械硬盘(HDD)------SSD 的 IO 速度是 HDD 的 10~100 倍,能大幅提升 fsync 的执行速度,减少刷盘延迟,同时提升 Redis 的整体性能;
- 内存:Redis 内存大小,建议设置为服务器物理内存的 50%~70%,预留足够的内存给操作系统的 kernel 缓冲区,避免 kernel 缓冲区内存不足,导致命令无法写入,影响刷盘;
- 监控配置建议:
- 必须监控的参数(通过 INFO persistence 查看):aof_fsync_status(fsync 状态)、aof_last_fsync(上次 fsync 时间)、aof_current_buf_length(缓冲区字节数)、aof_last_write_status(AOF 写入状态);
- 报警配置:当 aof_fsync_status 为 error(fsync 失败)、aof_last_fsync 与当前时间差 > 2 秒(刷盘延迟)、aof_current_buf_length 持续 > 10240 字节(缓冲区积累过多)时,立刻触发报警(邮件、短信、企业微信 / 钉钉报警),提醒运维人员排查;
- 定期检查:每天定期查看 AOF 文件大小、硬盘空间,每周检查一次刷盘日志,避免 AOF 文件过大、硬盘空间满,导致刷盘失败;
- 故障处理建议:
- 情况 1:aof_fsync_status 为 error(fsync 失败):立刻登录服务器,查看硬盘空间(df -h)、硬盘 IO 使用率(iostat -x 1),排查是否是硬盘空间满、硬盘 IO 过载;如果是硬盘空间满,删除过期的 AOF 备份文件、扩容硬盘;如果是 IO 过载,暂停其他占用 IO 的服务,优先保证 Redis 的 IO 资源;
- 情况 2:刷盘延迟(aof_last_fsync 与当前时间差 > 2 秒):查看硬盘 IO 使用率,是否有其他服务占用大量 IO;如果是,暂停该服务;如果不是,检查 SSD 硬盘是否故障,必要时更换硬盘;
- 情况 3:AOF 文件损坏,Redis 无法启动:先备份 AOF 文件(cp appendonly.aof appendonly.aof.bak),然后使用 Redis 自带的修复工具 redis-check-aof,执行命令
redis-check-aof --fix appendonly.aof,修复 AOF 文件(删除末尾损坏的部分),修复完成后,重启 Redis;如果修复失败,使用备份的 AOF 文件恢复;
- 优化建议:
- 开启混合持久化(aof-use-rdb-preamble yes):后面会详细讲,开启后,AOF 文件前半段是 RDB 快照(恢复快),后半段是 AOF 增量命令(安全),既能提升恢复速度,又能保证数据安全,和 everysec 策略搭配,效果更好;
- 定期执行 AOF 重写:后面会详细讲,AOF 重写能压缩 AOF 文件,删除冗余命令,减少硬盘空间占用,同时提升刷盘效率(文件越小,fsync 越快);
- 部署主从架构:主 Redis 采用 everysec 策略,从 Redis 用于备份、读写分离,避免主 Redis 宕机后,数据无法恢复;主从同步时,从 Redis 会同步主 Redis 的 AOF 文件,进一步保障数据安全。
3.2.3 策略 3:appendfsync no(性能极高、安全极差、非核心临时数据用)
appendfsync no这是 3 种策略中,性能最高、数据安全等级最低 的一种 ------Redis 完全不主动执行 fsync 系统调用,只负责将命令写入 aof_buf 缓冲区、执行 write 写入 kernel 缓冲区,之后就不管了;数据什么时候刷到硬盘,完全由操作系统自行决定(通常是 30 秒~几分钟,或者 kernel 缓冲区满了);这种策略,性能极高,但数据安全极差,最多可能丢失几分钟的数据,生产中只用于非核心、临时数据,绝对不能用于核心业务。
执行逻辑
appendfsync no 的核心逻辑:Redis 主线程执行完修改命令,写入 aof_buf 缓冲区后,只执行 write 系统调用(写入 kernel 缓冲区),不执行任何 fsync 系统调用,也不启动后台刷盘线程;数据什么时候从 kernel 缓冲区刷到物理硬盘,完全由操作系统(OS)自行决定;Redis 不干预、不控制,全程专注于处理客户端请求,性能达到极致,但数据安全完全依赖操作系统,极不安全。
拆解成具体步骤:
- 客户端向 Redis 发送一条修改命令(比如
ZADD rank:temp 100 user1 90 user2,临时排行榜添加用户分数); - Redis 主线程接收命令、执行命令(修改内存中的临时排行榜数据,将 user1、user2 的分数添加到 rank:temp 有序集合中);
- 主线程将这条 ZADD 命令,转换成 RESP 纯文本格式(比如
*5\r\n$4\r\nZADD\r\n$8\r\nrank:temp\r\n$3\r\n100\r\n$5\r\nuser1\r\n$2\r\n90\r\n$5\r\nuser2\r\n),写入 aof_buf 缓冲区(内存操作,微秒级,速度极快); - 主线程立刻执行
write系统调用,把 aof_buf 缓冲区里的这条命令,写入操作系统的 kernel 缓冲区(PageCache)------ 这个操作是内存到内存,微秒级完成,主线程不阻塞、不等待; write执行完成后,主线程 不执行 fsync、不启动后台刷盘线程、不做任何刷盘相关的操作,立刻给客户端返回 "OK"(执行成功)的响应;客户端收到响应后,就知道临时排行榜添加成功,可以继续操作;- 主线程不用管任何刷盘相关的工作,立刻转身处理下一条客户端命令,全程不被任何刷盘操作干扰,性能达到极致 ------ 这是 no 策略和 everysec 策略的核心差异:everysec 有后台刷盘线程,每 1 秒主动刷盘;no 策略没有后台刷盘线程,完全不主动刷盘;
- 数据什么时候从 kernel 缓冲区刷到物理硬盘,完全由操作系统自行决定,Redis 不干预,操作系统的刷盘逻辑通常有两种:
- 逻辑 1:kernel 缓冲区满了(比如缓冲区大小是 4MB,积累了 4MB 的命令),操作系统会自动执行一次 fsync,将缓冲区里的命令刷到硬盘;
- 逻辑 2:操作系统定期刷盘,默认周期是 30 秒~几分钟(不同系统不一样,比如 Linux 系统,默认是 30 秒左右),不管缓冲区有没有满,到时间就自动执行一次 fsync;
- 只有当操作系统自动执行 fsync 时,kernel 缓冲区里的命令,才会被刷到物理硬盘的 AOF 文件里;在这之前,所有命令都只存在于 kernel 缓冲区(内存)里,一旦出现断电、宕机,就会全部丢失;
- 循环往复:主线程持续处理命令、写入 aof_buf、执行 write;操作系统不定期、自动执行 fsync,批量刷盘;Redis 全程不干预刷盘操作,只专注于处理客户端请求,性能达到最高,但数据安全完全没有保障。
关键细节
- Redis 不主动执行任何 fsync,完全依赖操作系统:这是 no 策略最核心、最关键的特点,也是它 "安全极差" 的根本原因 ------ 和 everysec(主动每 1 秒刷盘)、always(每一条命令主动刷盘)完全不同,no 策略的 Redis,就像 "甩手掌柜",把刷盘的所有工作,都交给了操作系统,自己不管不顾;
- 通俗类比:no 策略,就像你把快递(命令)放到小区门口的快递驿站(kernel 缓冲区)后,转身就走,不管不问,也不告诉驿站工作人员(操作系统)什么时候送快递;工作人员什么时候有空、什么时候想起送快递,就什么时候送(操作系统不定期刷盘);可能 10 分钟送一次,可能 1 小时送一次,也可能半天送一次;如果驿站突然失火(服务器断电),驿站里所有没送出去的快递(kernel 缓冲区里的命令),都会被烧毁(丢失);而 everysec 策略,就像你放快递时,告诉工作人员 "每 1 小时必须送一次快递",工作人员会按时送,丢失的快递(数据)最多只有 1 小时内的;always 策略,就像你放一个快递,就盯着工作人员送一个,确保送到才走,不会丢失任何一个快递;
- 操作系统的刷盘周期,通常是 30 秒~几分钟,不可控:操作系统的自动刷盘周期,不是固定的,也不能通过 Redis 配置修改(除非修改系统内核参数,生产绝对禁止),不同系统、不同配置,刷盘周期不一样;比如 Linux 系统,默认的刷盘周期是 30 秒左右,但如果系统 IO 繁忙,刷盘周期会变长,可能达到 1 分钟、5 分钟,甚至更久;这就意味着,kernel 缓冲区里的命令,可能会积累 30 秒~几分钟,一旦断电,这些命令都会丢失;
- 补充说明:很多零基础同学会问 "能不能修改操作系统的刷盘周期,让它每 1 秒刷一次,这样 no 策略就既高性能又安全了?"------ 答案是:不建议,绝对不建议;修改系统内核参数,会影响整个服务器的所有服务(不仅仅是 Redis),可能导致其他服务的 IO 性能暴跌,引发整个服务器的故障;而且,即使修改了,也无法保证刷盘周期一定是 1 秒(系统 IO 繁忙时,依然会延迟),不如直接使用 everysec 策略,更稳妥、更安全;
- 主线程完全不被刷盘阻塞,性能达到极致:因为 Redis 不执行任何 fsync,主线程只做 "写 aof_buf + write",这两个操作都是微秒级的,全程不阻塞、不等待,能最大限度地发挥 Redis 的性能,QPS 比 everysec 还要高一点;
- 对比说明:在同一块 SSD 硬盘上,everysec 策略的写入 QPS 是每秒 10 万~20 万,而 no 策略的写入 QPS 是每秒 12 万~25 万,响应时间比 everysec 快 0.005~0.01 毫秒;虽然差距不大,但在极端高并发场景(每秒 30 万 + 写入请求),no 策略的性能优势,会稍微明显一点;但这种性能优势,是以牺牲 "数据安全" 为代价的,得不偿失,除非数据完全不重要;
- 正常关闭 Redis(执行 SHUTDOWN 命令),会自动执行一次 fsync:和 everysec、always 策略一样,no 策略的 Redis,正常关闭时,会自动执行一次 fsync,将 aof_buf 缓冲区、kernel 缓冲区里的所有命令,全部刷到硬盘,不会丢失任何数据;只有在 "异常宕机、突然断电" 时,才会丢失数据;
- 缓冲区的积累风险,比 everysec 高得多:因为 no 策略不主动刷盘,kernel 缓冲区里的命令,会持续积累,直到操作系统自动刷盘;如果业务写入 QPS 很高(比如每秒 20 万 +),30 秒内,kernel 缓冲区里会积累 600 万条命令,一旦断电,这 600 万条命令都会丢失,损失极大;而 everysec 策略,最多积累 1 秒内的命令,丢失量很少;
- 动态查看刷盘状态:在 Redis 客户端,执行命令
INFO persistence,查看 no 策略的刷盘状态,重点关注以下几个参数(和 everysec 对比,讲清楚差异):-
aof_fsync_status:因为 Redis 不主动执行 fsync,这个参数通常是 "ok",但这个 "ok" 没有实际意义,不代表数据已经刷到硬盘,只代表 Redis 没有主动执行 fsync 失败;和 everysec 不同,everysec 的aof_fsync_status是 "ok",代表后台线程的 fsync 执行成功,数据已经刷到硬盘; -
aof_last_fsync:上次 fsync 执行的时间戳,这个时间戳,是操作系统自动执行 fsync 的时间,不是 Redis 主动执行的;用当前时间戳减去这个值,如果结果很大(比如 > 30),说明操作系统已经很久没有刷盘了,kernel 缓冲区里积累了大量命令,丢失风险极高; -
aof_current_buf_length:因为 Redis 不主动刷盘,且 write 执行很快,这个值通常很小(和 everysec 差不多),但 kernel 缓冲区里的命令,不会体现在这个参数里 ------ 这个参数只表示 aof_buf 缓冲区里的命令字节数,不表示 kernel 缓冲区里的命令字节数,这一点和 everysec 一样,但 no 策略的 kernel 缓冲区积累风险,比 everysec 高得多; -
操作示例:
127.0.0.1:6379> INFO persistence
# Persistence
loading:0
rdb_changes_since_last_save:0
rdb_bgsave_in_progress:0
rdb_last_save_time:1770000000
rdb_last_bgsave_status:ok
rdb_last_bgsave_time_sec:-1
rdb_current_bgsave_time_sec:-1
rdb_last_cow_size:0
aof_enabled:1  # AOF 已开启
aof_rewrite_in_progress:0
aof_rewrite_scheduled:0
aof_last_rewrite_time_sec:-1
aof_current_rewrite_time_sec:-1
aof_last_bgrewrite_status:ok
aof_last_write_status:ok  # AOF 写入状态正常
aof_sync_in_progress:0  # 没有正在执行的 fsync(Redis 不主动执行)
aof_current_buf_length:480  # aof_buf 缓冲区当前字节数,正常
aof_buf_length:8192
aof_loading:0
aof_decoding:0
aof_last_fsync:1770000000  # 上次 fsync 时间戳(操作系统自动执行),当前时间 1770000035,已经 35 秒没有刷盘
aof_delayed_fsync:0
解读:从上面的输出可以看出,AOF 已开启,Redis 不主动执行 fsync(aof_sync_in_progress:0),上次 fsync 是 35 秒前(操作系统自动执行),说明 kernel 缓冲区里,已经积累了 35 秒内的命令,一旦断电,这些命令都会丢失,丢失风险极高;而 everysec 策略,上次 fsync 通常是 1 秒内,丢失风险极低。
-
数据安全等级
appendfsync no 的数据安全等级:极低安全,极不安全,最多可能丢失几分钟内的数据,无法满足任何核心业务的安全需求,只能用于非核心、临时数据(丢了也没关系,能快速恢复)。
详细拆解:
-
核心原因:因为 no 策略的 Redis 不主动执行任何 fsync,数据什么时候刷到硬盘,完全由操作系统决定,而操作系统的自动刷盘周期,通常是 30 秒~几分钟;也就是说,硬盘上的 AOF 文件,最多比内存中的数据 "落后 30 秒~几分钟"------ 内存中最新的 30 秒~几分钟内的命令,可能还在 kernel 缓冲区里,没有刷到硬盘;一旦服务器突然断电、Redis 异常崩溃,这些命令都会丢失(因为 kernel 缓冲区是内存,断电易失);
-
对比总结:
刷盘策略 主动刷盘行为 操作系统刷盘周期 最多丢失数据时间 数据安全等级 always 每一条命令主动刷盘(fsync) 不依赖,Redis 主动控制 0 秒(理论上零丢失) 极高 everysec 每 1 秒主动刷盘(fsync) 不依赖,Redis 后台线程控制 1 秒 高 no 不主动刷盘,完全不执行 fsync 30 秒~几分钟 30 秒~几分钟 极低
-
-
可能丢失数据的情况:
- 情况 1:服务器突然断电、Redis 异常崩溃,且 kernel 缓冲区里有未刷盘的命令(最常见、最危险的情况);
- 情况 2:操作系统 IO 繁忙,刷盘周期变长,导致命令积累过久;
-
不会丢失数据的情况(零超纲,每一种都讲清楚,加案例,对比另外两种策略):
- 情况 1:客户端收到 "执行成功" 响应,且操作系统已经自动执行 fsync,将命令刷到硬盘;
- 情况 2:Redis 正常关闭(执行 SHUTDOWN 命令);
- 情况 3:业务写入 QPS 极低,kernel 缓冲区里没有积累命令,且操作系统已经自动刷盘;
-
补充说明:"最多丢失几分钟数据",不是 "一定会丢失几分钟数据"------ 如果服务器一直稳定运行,没有断电、没有崩溃,操作系统会定期刷盘,数据会正常写入硬盘,不会丢失;但生产环境中,服务器断电、Redis 崩溃,都是可能发生的(比如电网故障、硬件故障、系统故障),一旦发生,就会丢失大量数据;而且,这种丢失的影响,远大于 everysec 策略的 1 秒丢失(几分钟的命令量,可能是 1 秒的几十倍、几百倍);
-
数据丢失后的恢复难度:everysec 策略最多丢失 1 秒数据,且核心业务通常会有数据库备份(Redis 是缓存),能快速从数据库同步恢复;而 no 策略最多丢失几分钟数据,如果这些数据没有备份(比如临时数据,没有存入数据库),就无法恢复,损失无法挽回;如果有备份,恢复的数据量也很大,需要花费很长时间(比如恢复 600 万条命令,可能需要几小时),影响业务正常运行。
性能表现
appendfsync no 的性能表现:极致高性能,是 3 种策略中最快的,QPS 可达每秒 12 万~25 万(SSD 硬盘),响应时间只有 0.005~0.05 毫秒,比 everysec 策略快一点(差距不大),比 always 策略快 10~100 倍,能支撑极端高并发业务,但这种高性能,是以牺牲数据安全为代价的,得不偿失(除非数据完全不重要)。
详细拆解:
-
极致高性能的核心原因:
- 主线程完全不被刷盘阻塞:Redis 不执行任何 fsync(不管是主线程还是后台线程),主线程只做 "写 aof_buf + write",这两个操作都是微秒级的,全程不阻塞、不等待,写完就返回成功,能最大限度地发挥 Redis 的性能;
- 没有后台刷盘线程的干扰:everysec 策略有后台刷盘线程,虽然后台线程不阻塞主线程,但线程切换、fsync 执行时,依然会占用少量的系统资源(CPU、IO);而 no 策略没有后台刷盘线程,不需要线程切换,也不需要占用任何 IO 资源用于刷盘,所有系统资源,都能用于处理客户端请求,性能达到极致;
- 批量刷盘的 IO 效率更高(但不可控):操作系统的自动刷盘,是批量刷盘(将 kernel 缓冲区里的所有命令,一次性刷到硬盘),IO 效率很高;比如,30 秒内积累 600 万条命令,只需要执行 1 次 fsync,IO 次数极少;但这种高效的批量刷盘,是不可控的,无法保证数据安全;
-
具体性能数据:
刷盘策略 硬盘类型 写入 QPS(每秒) 响应时间(毫秒) 性能排名 always 机械硬盘(HDD) 100~500 10~50 3(最差) always 固态硬盘(SSD) 1000~5000 1~5 3(最差) everysec 机械硬盘(HDD) 10000~30000 0.1~0.5 2(良好) everysec 固态硬盘(SSD) 100000~200000 0.01~0.1 2(良好) no 机械硬盘(HDD) 15000~40000 0.05~0.3 1(最好) no 固态硬盘(SSD) 120000~250000 0.005~0.05 1(最好) 从表格可以直观看出,no 策略的性能,是 3 种策略中最好的 ------ 在 SSD 硬盘上,QPS 比 everysec 高 2 万~5 万,响应时间比 everysec 快 0.005~0.05 毫秒;在 HDD 硬盘上,性能优势更明显;但这种性能优势,是以牺牲数据安全为代价的,除非数据完全不重要,否则不建议使用; -
通俗类比:no 策略,就像一辆没有刹车的跑车 ------ 性能极强,速度极快,能轻松超过其他车辆(everysec、always),但没有任何安全保障,一旦遇到紧急情况(断电、宕机),就会失控,造成巨大损失;everysec 策略,就像一辆性能很好、刹车也很好的轿车 ------ 速度很快,能满足日常出行需求(生产业务),同时有足够的安全保障,遇到紧急情况,能及时刹车(每 1 秒刷盘),损失很小;always 策略,就像一辆速度很慢、但刹车绝对安全的货车 ------ 虽然速度慢,但绝对安全,适合运输贵重物品(极端核心数据),不适合日常高速出行(普通生产业务)。
适用场景
appendfsync no 的适用场景:极其狭窄,只适用于非核心、临时、无关紧要的数据(丢了也没关系,能快速恢复,不影响业务、不影响用户),绝对不能用于任何核心业务(购物车、订单、用户信息、登录状态等);生产中,no 策略的使用场景,远少于 always 和 everysec,只有在 "数据完全不重要,且需要极致高性能" 的场景下,才会考虑使用。
- 临时排行榜、临时榜单(最常见的适用场景):
- 具体业务:短视频平台的 "今日临时热门视频榜单"、游戏平台的 "临时活动排行榜"、电商平台的 "临时限时折扣榜单";
- 为什么能用 no:这些榜单都是临时的,每天更新一次,或者活动结束后就失效,丢了也没关系,能通过数据库、日志,快速重新生成;而且,这些榜单的写入 QPS 通常很高(活动期间每秒 10 万 +),需要极致高性能,no 策略能满足;
- 真实案例:某热门手游,举办 "限时冲榜" 活动,设置临时排行榜(记录玩家的活动分数),采用 Redis 存储,刷盘策略设置为 no,搭配 SSD 硬盘;活动期间,排行榜的写入 QPS 峰值达到每秒 30 万 +,响应时间稳定在 0.005 毫秒左右,没有出现任何性能问题;活动期间,服务器突然断电一次,丢失了 35 秒内的 1050 万条排行榜命令;运维人员没有做任何恢复操作,因为活动还在进行,玩家继续冲榜,排行榜会自动更新,丢失的分数数据,对活动没有任何影响;活动结束后,排行榜失效,没有造成任何损失;
- 临时会话数据、临时缓存(非核心):
- 具体业务:网站的 "临时游客会话数据"(游客未登录,临时记录浏览记录)、APP 的 "临时缓存数据"(比如首页临时缓存的热门内容,每天更新一次);
- 为什么能用 no:这些数据都是临时的,游客退出 APP、网站刷新后,数据就会失效,丢了也没关系,能重新从数据库加载;而且,这些数据的写入 QPS 较高,需要高性能,no 策略能满足;
- 临时计算数据、临时任务数据:
- 具体业务:大数据平台的 "临时计算中间结果"(计算完成后,就会存入数据库,中间结果丢了也没关系,能重新计算)、任务调度系统的 "临时任务状态"(任务执行完成后,状态就会失效,丢了也能重新调度);
- 为什么能用 no:这些数据都是计算、任务执行过程中的临时数据,最终会存入数据库,丢了也能重新计算、重新调度,不影响最终结果;而且,这些数据的写入 QPS 通常很高(每秒 20 万 +),需要极致高性能,no 策略能满足;
- 测试环境、开发环境的 Redis(非生产环境):
- 具体业务:开发人员测试代码、测试 Redis 功能时,使用的 Redis(测试环境、开发环境);
- 为什么能用 no:测试环境、开发环境的 Redis,存储的都是测试数据,不是真实用户数据,丢了也没关系,能重新生成测试数据;而且,开发、测试过程中,可能需要高频写入数据,no 策略的高性能,能提升开发、测试效率;
绝对不适用场景
以下场景,绝对不能使用 appendfsync no 策略,哪怕你追求高性能,也绝对不能用 ------ 一旦使用,可能导致核心数据大量丢失,业务瘫痪、用户流失、营收损失,甚至公司倒闭;
- 电商核心业务:
- 具体业务:购物车、订单、商品库存、用户收货地址、优惠券、支付记录;
- 为什么绝对不能用:这些业务的核心数据,丢了会造成巨大的经济损失、用户投诉,甚至法律纠纷;no 策略最多丢几分钟数据,可能导致几千、几万条订单丢失,几十万、几百万营收损失;
- 社交平台核心业务:
- 具体业务:用户关注、粉丝、消息(实时消息)、点赞、评论、收藏、用户资料;
- 为什么绝对不能用:这些业务的核心数据,丢了会严重影响用户体验,导致用户流失;比如,用户的关注列表、粉丝列表丢失,用户会无法找到自己关注的人,直接卸载 APP;
- 游戏核心业务(绝对禁止):
- 具体业务:玩家道具、等级、金币、积分、任务进度、游戏存档;
- 为什么绝对不能用:这些业务的核心数据,丢了会导致玩家流失,游戏活跃度暴跌,甚至游戏停运;比如,玩家的等级、道具丢失,玩家会觉得 "白玩了",直接卸载游戏,投诉游戏公司;
- 金融、医疗、政务等核心业务(绝对禁止,比 always 策略的适用场景相反):
- 具体业务:金融交易记录、银行转账、医疗就诊记录、政务户籍数据、社保缴费记录;
- 为什么绝对不能用:这些业务的核心数据,丢了会造成巨大的经济损失、法律纠纷、民生问题,甚至影响社会秩序;no 策略最多丢几分钟数据,可能导致几十、几百万的资金损失,或者医疗事故、政务纠纷;
生产建议
- 核心警告:绝对禁止将 appendfsync no 策略,用于任何核心业务(购物车、订单、用户信息、支付、游戏道具等),哪怕你追求高性能,也绝对不能用 ------ 数据丢失的损失,远大于性能提升的收益;
- 正确使用建议:
- 只有在 "数据是非核心、临时、无关紧要,丢了也没关系,能快速恢复" 的场景下,才考虑使用 no 策略;
- 使用 no 策略时,必须搭配高性能 SSD 硬盘,进一步提升性能,同时减少操作系统刷盘的延迟(SSD 的 IO 速度快,操作系统刷盘会更快一点);
- 不要对 no 策略的 Redis 做任何数据备份(除非必要),因为数据不重要,备份会占用硬盘空间、系统资源,得不偿失;
- 监控建议:
- 虽然 no 策略的 Redis 存储的是临时数据,但也要监控刷盘状态,重点监控
aof_last_fsync参数(上次操作系统刷盘时间),如果当前时间与aof_last_fsync的差值 > 60 秒(1 分钟),触发报警,提醒运维人员关注(虽然数据不重要,但避免 Redis 出现其他故障); - 监控硬盘 IO 使用率、硬盘空间,避免硬盘 IO 过载、硬盘空间满,导致 write 执行失败,无法写入 kernel 缓冲区;
- 虽然 no 策略的 Redis 存储的是临时数据,但也要监控刷盘状态,重点监控
- 故障处理建议:
- 情况 1:Redis 异常宕机、服务器断电,丢失临时数据:不需要做任何恢复操作,因为数据是临时的,丢了也没关系,业务会自动恢复(比如临时排行榜,用户继续操作,会自动更新);
- 情况 2:write 执行失败(aof_last_write_status 为 error):立刻排查硬盘空间、硬盘 IO 使用率,删除过期文件、扩容硬盘,或者暂停其他占用 IO 的服务,确保 write 能正常执行;
- 情况 3:AOF 文件损坏,Redis 无法启动:先备份 AOF 文件,然后使用 Redis 自带的修复工具 redis-check-aof,执行
redis-check-aof --fix appendonly.aof,修复 AOF 文件;修复完成后,重启 Redis;如果修复失败,直接删除 AOF 文件(因为数据是临时的,丢了也没关系),重启 Redis 即可(Redis 会重新生成 AOF 文件);
- 零基础建议:如果你是零基础,不确定自己的业务是否适合 no 策略,直接放弃使用 no 策略,选择 everysec 策略------everysec 策略能兼顾性能和安全,适用于 99% 的生产场景,不会出错;哪怕是临时数据,用 everysec 策略,也不会有太大的性能损失,反而更安全,避免误用到核心业务;
- 系统内核参数建议(零超纲,不推荐修改,仅供参考):如果确实需要使用 no 策略,且希望减少数据丢失的时间,可以在专业运维人员的指导下,修改 Linux 系统的
vm.dirty_expire_centisecs参数(默认是 3000 厘秒,即 30 秒),将其修改为 1000 厘秒(10 秒),缩短操作系统的自动刷盘周期;但不推荐修改,因为会影响整个服务器的所有服务,可能导致其他服务的 IO 性能暴跌。
3.2.4 三种刷盘策略总结
前面我们已经对三种刷盘策略(always、everysec、no),进行了无限详细的拆解,每一种策略的执行逻辑、数据安全、性能、适用场景、案例、建议,都讲得清清楚楚;
一、三种刷盘策略全面对比
| 对比维度 | appendfsync always | appendfsync everysec | appendfsync no |
|---|---|---|---|
| 核心定义 | 每一条修改命令,都主动执行 fsync,确保写入硬盘后,才返回成功 | 每 1 秒,由后台线程主动执行一次 fsync,批量刷盘;主线程不等待 fsync,写完 write 就返回成功 | 不主动执行任何 fsync,完全依赖操作系统自动刷盘;主线程写完 write 就返回成功 |
| 主动刷盘行为 | 有,每一条命令主动刷盘(fsync) | 有,后台线程每 1 秒主动刷盘(fsync) | 无,完全不主动刷盘,依赖 OS |
| 主线程阻塞情况 | 阻塞,每一条命令都要等待 fsync 完成(毫秒级阻塞) | 不阻塞,主线程只做 write,不等待 fsync | 不阻塞,主线程只做 write,不执行 fsync |
| 后台刷盘线程 | 不需要(主线程主动刷盘) | 需要,独立后台线程,每 1 秒刷盘 | 不需要(不主动刷盘) |
| 最多丢失数据时间 | 0 秒(理论上零丢失) | 1 秒 | 30 秒~几分钟 |
| 数据安全等级 | 极高(核心中的核心场景用) | 高(99% 生产场景用) | 极低(仅临时数据用) |
| SSD 硬盘 QPS | 1000~5000 条 / 秒 | 10 万~20 万条 / 秒 | 12 万~25 万条 / 秒 |
| HDD 硬盘 QPS | 100~500 条 / 秒 | 1 万~3 万条 / 秒 | 1.5 万~4 万条 / 秒 |
| 响应时间(SSD) | 1~5 毫秒 | 0.01~0.1 毫秒 | 0.005~0.05 毫秒 |
| 适用场景 | 金融、支付、银行、医疗实时就诊记录等极端核心场景(零丢失需求,并发量低) | 电商、社交、游戏、短视频等 99% 核心 / 普通业务(兼顾安全和高性能) | 临时排行榜、临时缓存、临时计算数据等非核心临时数据(丢了也没关系) |
| 绝对不适用场景 | 普通互联网核心业务(并发高,性能太差) | 极端核心场景(零丢失需求)、非核心临时数据(没必要) | 任何核心业务(购物车、订单、用户信息等) |
| 生产使用频率 | 极低(< 1%) | 极高(99%) | 低(< 10%) |
| 故障风险 | 性能瓶颈风险(IO 繁忙,QPS 暴跌) | 刷盘失败风险(硬盘空间满、IO 过载,可能丢 1 秒数据) | 数据大量丢失风险(断电、宕机,可能丢几分钟数据) |
| 恢复难度 | 低(数据零丢失,无需恢复;硬盘损坏需靠备份) | 低(最多丢 1 秒数据,可通过数据库快速恢复) | 无恢复必要(临时数据);若需恢复,难度高(数据量大,无备份) |
| 监控重点 | QPS、响应时间、fsync 执行状态 | aof_fsync_status、aof_last_fsync、硬盘空间、IO 使用率 | aof_last_fsync(OS 刷盘时间)、硬盘 IO 使用率 |
二、核心知识点提炼
-
核心参数:三种刷盘策略,都由
appendfsync参数控制,只有这一个参数,取值只有三个(always、everysec、no),没有其他可选值 ------ 零基础记住:一个参数、三个取值、对应三种策略,不用记其他复杂参数,这是 AOF 刷盘最核心、最需要掌握的参数,没有之一。-
补充说明:配置文件中,默认注释了该参数,需要手动开启并选择取值,正确配置格式如下(直接复制到 redis.conf 中即可生效):
# 开启 AOF 持久化(必须先开启,刷盘策略才生效) appendonly yes # 选择刷盘策略(三选一,推荐 everysec) appendfsync everysec # 禁止同时开启多个刷盘策略(零基础不要修改下面的配置,保持默认注释即可) # appendfsync always # appendfsync no -
关键提醒:如果没有开启 AOF 持久化(appendonly no),那么
appendfsync参数无论怎么配置,都不会生效 ------Redis 不会写入任何 AOF 文件,数据只存在于内存中,一旦宕机,所有数据全部丢失;所以,配置刷盘策略前,必须先开启 AOF 持久化(appendonly yes),这是前提,绝对不能忘。
-
-
性能和安全的权衡:三种策略的本质,就是 "数据安全" 和 "Redis 性能" 的权衡 ------安全越高,性能越差;性能越高,安全越差,没有既绝对安全、又绝对高性能的策略,生产中只能根据业务需求,选择最适合的权衡方案。
- 详细拆解权衡逻辑:
- always 策略:优先保证 "绝对安全",牺牲所有性能 ------ 每一条命令都刷盘,零数据丢失,但主线程阻塞,QPS 暴跌,只能用于极端核心、低并发场景;
- everysec 策略:平衡 "安全和性能",取中间值 ------ 最多丢 1 秒数据(安全能满足 99% 业务),QPS 极高(能支撑高并发),是生产的 "万能选择",也是权衡后的最优解;
- no 策略:优先保证 "极致性能",牺牲所有安全 ------ 性能最高,但最多丢几分钟数据,只能用于非核心、临时数据,绝对不能用于核心业务;
- 通俗类比:三种策略的权衡,就像我们出门带钱:
- always 策略:每花一分钱,都立刻记在账本上,并且把账本锁进保险柜(fsync 刷盘),确认锁好后,才继续花钱 ------ 绝对不会记错账(零数据丢失),但花钱速度极慢(性能差);
- everysec 策略:每花一分钱,就记在账本上(write 写入 kernel 缓冲区),不立刻锁保险柜,而是每 1 分钟,集中把账本锁进保险柜一次(每 1 秒刷盘)------ 偶尔可能忘记 1 分钟内花的钱(最多丢 1 秒数据),但花钱速度很快(性能高),能满足日常购物需求(生产业务);
- no 策略:每花一分钱,只记在草稿纸上(write 写入 kernel 缓冲区),不记正式账本,也不锁保险柜,什么时候想起,再把草稿纸上的记录抄到正式账本上(操作系统自动刷盘)------ 花钱速度最快,但一旦草稿纸丢了(断电、宕机),就忘记最近几十分钟花的钱(丢失几分钟数据),只适合临时花钱(临时数据),不适合存工资、存巨款(核心数据)。
- 详细拆解权衡逻辑:
-
刷盘的核心依赖:无论哪种策略,刷盘的核心都是两个系统调用 ------
write和fsync,以及两个缓冲区 ------aof_buf(Redis 自身缓冲区)和kernel 缓冲区(操作系统缓冲区),所有刷盘逻辑,都是围绕这两个系统调用、两个缓冲区展开的,零基础记住:两个调用、两个缓冲区,是刷盘的底层逻辑,不用懂原理,记住对应关系即可。- 对应关系拆解:
- 所有策略的共同步骤:客户端发送命令 → 主线程执行命令 → 写入 aof_buf 缓冲区 → 执行 write 系统调用 → 写入 kernel 缓冲区;
- 不同策略的差异的步骤:写入 kernel 缓冲区后,如何执行 fsync(是否执行、什么时候执行、由谁执行);
- always:主线程执行 fsync → 等待 fsync 完成 → 返回成功;
- everysec:主线程不执行 fsync,返回成功;后台线程每 1 秒执行一次 fsync;
- no:主线程不执行 fsync,返回成功;操作系统不定期自动执行 fsync;
- 关键提醒:
write是内存到内存的操作(aof_buf → kernel 缓冲区),速度极快(微秒级),不会阻塞主线程;fsync是内存到硬盘的操作(kernel 缓冲区 → 硬盘 AOF 文件),速度很慢(毫秒级),是导致性能差异的核心原因 ------ 这也是为什么 always 策略慢(每一条命令都要等 fsync),everysec 和 no 策略快(不等待 fsync)的根本原因。
- 对应关系拆解:
-
正常关闭 vs 异常宕机:三种策略,在 "正常关闭 Redis" 和 "异常宕机(断电、进程崩溃)" 两种情况下,数据安全性完全不同 ------ 零基础记住:正常关闭,所有策略都不会丢失数据;异常宕机,才会出现数据丢失,丢失时间取决于策略。
- 详细拆解:
- 正常关闭(执行 SHUTDOWN 命令):无论选择哪种策略,Redis 都会在关闭前,自动执行一次 fsync 系统调用,将 aof_buf 缓冲区、kernel 缓冲区里的所有命令,全部刷到硬盘的 AOF 文件里 ------ 相当于 "强制刷盘一次",所以不会丢失任何数据;
- 案例(零超纲):哪怕是 no 策略,执行 SHUTDOWN 命令关闭 Redis 后,再重启,数据依然完整 ------ 因为关闭前,Redis 自动执行了 fsync,将所有未刷盘的命令,全部刷到了硬盘;只有在异常宕机(没有执行 SHUTDOWN 命令)时,no 策略才会丢失数据;
- 异常宕机(断电、Redis 进程崩溃):此时 Redis 无法执行任何操作,包括 fsync,数据是否丢失、丢失多少,完全取决于 "kernel 缓冲区里有多少未刷盘的命令",而未刷盘的命令数量,取决于刷盘策略;
- always 策略:每一条命令都执行了 fsync,kernel 缓冲区里没有未刷盘的命令,所以不丢失任何数据;
- everysec 策略:后台线程每 1 秒刷盘一次,kernel 缓冲区里最多有 1 秒内的命令,所以最多丢失 1 秒数据;
- no 策略:完全依赖操作系统刷盘,kernel 缓冲区里可能有 30 秒~几分钟内的命令,所以最多丢失几分钟数据;
- 正常关闭(执行 SHUTDOWN 命令):无论选择哪种策略,Redis 都会在关闭前,自动执行一次 fsync 系统调用,将 aof_buf 缓冲区、kernel 缓冲区里的所有命令,全部刷到硬盘的 AOF 文件里 ------ 相当于 "强制刷盘一次",所以不会丢失任何数据;
- 关键提醒:生产中,服务器断电、Redis 进程崩溃,都是可能发生的(比如电网故障、硬件故障、系统故障),所以不能抱有 "不会异常宕机" 的侥幸心理 ------ 核心业务,绝对不能用 no 策略,哪怕正常关闭不会丢失数据,也不能冒险。
- 详细拆解:
-
硬件对策略的影响:硬盘类型(SSD vs HDD),对三种策略的性能影响极大,零基础记住:优先使用 SSD 硬盘,无论选择哪种策略,SSD 都能大幅提升性能;HDD 硬盘只适合测试环境、非核心临时数据,绝对不能用于核心业务的 Redis。
- 详细拆解(零超纲,加数据、加案例,直观感受):
- SSD 硬盘(推荐,生产首选):IO 速度快,一次 fsync 只需要 1~10 毫秒,能大幅提升刷盘效率,减少阻塞时间;
- 搭配 always 策略:QPS 能达到 1000~5000 条 / 秒,虽然依然不高,但能满足低并发的极端核心场景;
- 搭配 everysec 策略:QPS 能达到 10 万~20 万条 / 秒,响应时间稳定在 0.01~0.1 毫秒,能支撑高并发核心业务;
- 搭配 no 策略:QPS 能达到 12 万~25 万条 / 秒,性能达到极致,适合临时数据的高并发场景;
- HDD 硬盘(不推荐,生产避坑):IO 速度慢,一次 fsync 需要 10~100 毫秒,性能极差,容易出现 IO 瓶颈;
- 搭配 always 策略:QPS 只有 100~500 条 / 秒,完全无法支撑任何生产业务,哪怕是低并发;
- 搭配 everysec 策略:QPS 只有 1 万~3 万条 / 秒,无法支撑高并发,容易出现响应超时;
- 搭配 no 策略:QPS 只有 1.5 万~4 万条 / 秒,性能优势不明显,且不安全;
- SSD 硬盘(推荐,生产首选):IO 速度快,一次 fsync 只需要 1~10 毫秒,能大幅提升刷盘效率,减少阻塞时间;
- 详细拆解(零超纲,加数据、加案例,直观感受):
三、生产选型建议
选型的核心原则(刻在脑子里,反复强调):先判断业务类型(核心 vs 非核心、临时 vs 永久),再判断并发量,最后选择策略;零基础优先选 everysec,绝对不会出错。
下面,分场景、分人群,给出详细的选型建议,每一种建议都讲清楚 "为什么选""怎么配置""注意事项",加案例,确保你能直接套用。
(一)零基础选型建议
如果你是零基础运维、开发,不懂业务并发量、不懂数据安全需求,不知道选哪种策略,直接按照下面的步骤来,绝对不会出错:
- 第一步:开启 AOF 持久化(appendonly yes)------ 这是前提,必须先做;
- 第二步:选择刷盘策略(appendfsync everysec)------ 不用犹豫、不用纠结,everysec 是万能策略,能兼顾 99% 业务的安全和性能;
- 第三步:搭配硬件(优先使用 SSD 硬盘)------ 如果没有 SSD 硬盘,暂时用 HDD 硬盘过渡,但一定要尽快更换为 SSD;
- 第四步:配置监控(监控 aof_fsync_status、aof_last_fsync、硬盘空间)------ 避免刷盘失败,导致数据丢失;
- 关键提醒(零超纲,反复强调):零基础不要尝试使用 always 或 no 策略,哪怕你觉得 "everysec 不够安全" 或 "everysec 性能不够"------always 性能太差,容易导致业务瘫痪;no 策略太不安全,容易导致核心数据丢失;everysec 是最稳妥、最适合零基础的选择。
(二)按业务类型选型建议
-
极端核心业务(需要零数据丢失,并发量低)------ 选 always 策略
-
具体业务:金融交易、银行转账、证券交易、医疗实时就诊记录、政务核心户籍数据、社保实时缴费记录;
-
选型理由:这些业务,绝对不能丢失任何一条数据,哪怕性能差一点,也要保证零丢失;且这些业务的并发量通常较低(每秒 ≤ 1000 条写入请求),always 策略的性能,能满足需求;
-
配置建议:
appendonly yes appendfsync always # 搭配 SSD 硬盘,减少 fsync 阻塞时间 # 监控 QPS、响应时间、fsync 执行状态,一旦性能下滑,及时排查 -
注意事项:
- 必须搭配高性能 SSD 硬盘,避免 HDD 硬盘导致 QPS 暴跌至无法使用;
- 实时监控 Redis 的 QPS、响应时间、硬盘 IO 使用率,一旦发现性能下滑(QPS 过低、响应时间过长),及时排查硬盘 IO 问题;
- 不要将 always 策略用于高并发业务(每秒 > 1000 条写入请求),否则会导致业务瘫痪;
-
-
普通核心业务(需要兼顾安全和高性能,并发量高)------ 选 everysec 策略(生产首选)
-
具体业务:电商(购物车、订单、商品库存)、社交(关注、粉丝、消息)、游戏(道具、等级、金币)、短视频(点赞、评论、收藏)、教育(用户报名、课程购买);
-
选型理由:这些业务,不能丢失大量数据(最多丢 1 秒数据,能快速恢复),且需要支撑高并发(每秒 1 万~30 万条写入请求);everysec 策略既能保证数据安全,又能保证高性能,是最优选择;
-
配置建议:
appendonly yes appendfsync everysec # 优先使用 SSD 硬盘,提升刷盘效率 # 开启混合持久化(后续会讲),提升恢复速度 aof-use-rdb-preamble yes -
注意事项(零超纲,反复强调):
- 优先使用 SSD 硬盘,能大幅提升 QPS,减少刷盘延迟;
- 实时监控 aof_fsync_status(确保 fsync 执行成功)、aof_last_fsync(确保刷盘延迟 ≤ 2 秒)、硬盘空间(避免硬盘满导致刷盘失败);
- 做好数据库备份(Redis 作为缓存,数据库作为持久化存储),一旦丢失 1 秒数据,能快速从数据库同步恢复;
-
案例(零超纲):某大型电商平台,双 11 大促期间,订单写入 QPS 峰值达到每秒 30 万 +,采用 everysec 策略 + SSD 硬盘,稳定运行;期间服务器临时断电,只丢了 1 秒内的 120 条订单数据,运维人员通过数据库订单表,3 分钟就恢复了数据,没有造成任何损失。
-
-
非核心临时业务(数据无关紧要,丢了也没关系,并发量可高可低)------ 选 no 策略
-
具体业务:临时排行榜、临时缓存、临时计算中间结果、测试环境 / 开发环境的测试数据、临时会话数据;
-
选型理由:这些业务,数据是临时的,丢了也没关系,能快速重新生成;且部分业务并发量较高(每秒 10 万 + 条写入请求),需要极致高性能;no 策略能满足高性能需求,且不需要考虑数据安全(数据不重要);
-
配置建议(零超纲,直接复制使用):
appendonly yes appendfsync no # 搭配 SSD 硬盘,进一步提升性能 # 无需做数据备份,节省资源 -
注意事项:
- 绝对不能将 no 策略用于任何核心业务,哪怕并发量再高,也不能冒险;
- 监控 aof_last_fsync(确保操作系统刷盘周期不会过长,避免 Redis 出现其他故障);
- 无需做数据备份,因为数据不重要,备份会占用硬盘空间、系统资源;
-
案例(零超纲):某游戏平台的临时活动排行榜,并发量每秒 25 万 + 条写入请求,采用 no 策略 + SSD 硬盘,性能稳定;期间服务器断电,丢失了 40 秒内的 1000 万条排行榜数据,但因为是临时数据,玩家继续冲榜,排行榜自动更新,没有造成任何损失。
-
四、常见问题(FAQ)
-
问:everysec 策略,真的最多只丢失 1 秒数据吗?会不会丢失更多?
- 答:正常情况下,最多丢失 1 秒数据;只有在刷盘失败(如硬盘空间满、IO 过载),且未及时排查时,才会丢失更多数据;
- 详细解答:everysec 策略,后台线程每 1 秒主动执行一次 fsync;正常情况下,kernel 缓冲区里,最多积累 1 秒内的命令,断电后,最多丢失这 1 秒的数据;但如果刷盘失败(如硬盘空间满),fsync 无法执行,命令会持续积累在 kernel 缓冲区,此时断电,丢失的数据会超过 1 秒(积累多久,就丢失多久);
- 关键提醒:只要做好监控,及时排查刷盘失败问题,everysec 策略就只会丢失 1 秒数据。
-
问:always 策略,真的能实现零数据丢失吗?有没有例外?
- 答:理论上能实现零数据丢失,有一个极端例外情况,但生产中几乎不会发生;
- 详细解答:always 策略,每一条命令,都要等待 fsync 执行完成后,才返回成功;fsync 执行完成,说明命令已经写入硬盘,断电后不会丢失;极端例外情况:fsync 执行完成后,硬盘立刻损坏(如硬盘物理故障),且没有备份,那么刚写入硬盘的命令,会丢失;但这种情况,概率极低,生产中几乎不会发生;
- 关键提醒:always 策略,必须搭配备份,避免硬盘损坏导致数据丢失。
-
问:no 策略,真的不能用在核心业务吗?如果做好备份,能不能用?
- 答:绝对不能用,哪怕做好备份,也不能用;
- 详细解答(零超纲):no 策略,最多可能丢失几分钟数据;哪怕做好备份,恢复数据也需要很长时间(比如丢失 5 分钟、1000 万条命令,恢复可能需要几小时);期间,业务无法正常运行,用户大量流失,营收损失惨重;而 everysec 策略,最多丢 1 秒数据,恢复只需要几分钟,影响极小;
- 关键提醒:核心业务,哪怕追求高性能,也必须选 everysec 或 always 策略,不能用 no 策略。
-
问:三种策略,哪种最节省硬盘空间?
- 答:三种策略的硬盘空间占用,几乎没有差异;
- 详细解答:硬盘空间占用,取决于 AOF 文件的大小;而 AOF 文件的大小,取决于写入命令的数量和类型,和刷盘策略无关 ------ 无论选择哪种策略,写入的命令都是一样的,AOF 文件的大小,也是一样的;
- 补充说明:想要节省硬盘空间,需要开启 AOF 重写(后续会详细讲),和刷盘策略无关。
-
问:零基础,不知道自己的业务并发量,该怎么选策略?
- 答:直接选 everysec 策略 + SSD 硬盘,绝对不会出错;
- 详细解答(零超纲):everysec 策略,能支撑每秒 10 万~20 万条写入请求,能满足 99% 互联网业务的并发需求;哪怕你的业务并发量低(每秒几百、几千条),everysec 策略的性能,也完全能满足;且 everysec 策略,最多丢 1 秒数据,能满足大部分业务的安全需求;
- 关键提醒:不要纠结并发量,零基础直接选 everysec,后续根据业务发展,再调整即可(几乎不需要调整)。
3.2.5 补充配置
前面我们重点讲了 appendfsync 参数(刷盘策略),但想要 AOF 持久化更安全、更高效,还需要配合几个补充配置;
1. appendonly(开启 AOF 持久化,刷盘策略的前提)
-
核心作用:开启 AOF 持久化,Redis 才会将修改命令,写入 AOF 文件;如果不开启,
appendfsync参数无论怎么配置,都不会生效 ------ 数据只存在于内存中,一旦宕机,全部丢失; -
配置格式(零超纲,直接复制使用):
# 开启 AOF 持久化(必须开启,推荐 yes) appendonly yes # 关闭 AOF 持久化(不推荐,除非是测试环境,且不需要持久化) # appendonly no -
关键提:
- 刷盘策略(appendfsync),必须在 appendonly yes 的前提下,才会生效;
- 生产环境,核心业务的 Redis,必须开启 AOF 持久化;测试环境、临时数据,可关闭;
-
案例:某创业公司,运维人员忘记开启 appendonly yes,只配置了 appendfsync everysec;某天服务器宕机,Redis 没有写入任何 AOF 文件,所有核心数据全部丢失,公司直接倒闭。
2. appendfilename(指定 AOF 文件名称和路径,避免默认路径混乱)
-
核心作用:指定 AOF 文件的名称和存储路径,默认路径是 Redis 的安装目录,默认文件名为 appendonly.aof;建议修改路径,将 AOF 文件存储在独立的硬盘分区,避免和系统文件、其他文件抢占空间;
-
配置格式:
# 指定 AOF 文件名称(默认 appendonly.aof,可修改,推荐保持默认) appendfilename "appendonly.aof" # 指定 AOF 文件存储路径(推荐存储在独立硬盘分区,如 /data/redis/aof/) dir /data/redis/aof/ -
注意事项:
- 配置的路径,必须提前创建,且 Redis 拥有该路径的读写权限(否则,Redis 无法写入 AOF 文件,会启动失败);
- 不要将 AOF 文件存储在系统盘(如 /root/、/etc/),避免系统盘空间满,导致刷盘失败;
-
案例:某电商平台,将 AOF 文件存储在系统盘,某天系统盘空间满了,导致刷盘失败,丢失了 1 秒内的 80 条订单数据;后来,将 AOF 文件存储在独立硬盘分区,再也没有出现过类似问题。
3. aof-load-truncated(AOF 文件损坏时,是否允许加载,避免 Redis 启动失败)
-
核心作用:当 AOF 文件末尾损坏(如硬盘空间满、宕机导致命令未写完),Redis 启动时,是否允许加载该 AOF 文件(加载时,会截断损坏的部分,保留完整的部分);默认值是 yes,推荐保持默认;
-
配置格式:
# AOF 文件损坏时,允许加载(推荐 yes) aof-load-truncated yes # AOF 文件损坏时,不允许加载(不推荐,会导致 Redis 启动失败) # aof-load-truncated no -
详细解释:
- 场景:某社交平台,Redis 采用 everysec 策略,硬盘空间满了,导致 AOF 文件末尾,有几条命令没有写完(文件损坏);
- 若配置 aof-load-truncated yes:Redis 启动时,会截断损坏的部分,加载完整的部分,丢失的只是损坏的几条命令,业务能正常运行;
- 若配置 aof-load-truncated no:Redis 启动时,会报错,无法启动,业务无法正常运行;
-
关键提醒:零基础保持默认 yes 即可,不要修改;如果 AOF 文件损坏严重,可使用 Redis 自带的修复工具(redis-check-aof)修复。
4. aof-use-rdb-preamble(开启混合持久化,提升 AOF 文件恢复速度,配合 everysec 策略使用)
-
核心作用:开启混合持久化后,AOF 文件的前半段,是 RDB 快照(二进制格式,恢复速度快);后半段,是 AOF 增量命令(纯文本格式,安全,最多丢 1 秒数据);既能提升恢复速度,又能保证数据安全,推荐开启,配合 everysec 策略使用;
-
配置格式:
# 开启混合持久化(推荐 yes,配合 everysec 策略使用) aof-use-rdb-preamble yes # 关闭混合持久化(不推荐,恢复速度慢) # aof-use-rdb-preamble no -
详细解释:
- 未开启混合持久化:AOF 文件全部是纯文本格式的命令,恢复时,需要逐条执行命令,恢复速度慢(比如 AOF 文件 10GB,恢复可能需要几十分钟);
- 开启混合持久化:AOF 文件前半段是 RDB 快照(恢复时,直接加载快照,几秒就能完成),后半段是增量命令(恢复时,执行增量命令,最多丢 1 秒数据);恢复速度大幅提升,同时保证数据安全;
-
案例:某电商平台,Redis 采用 everysec 策略,未开启混合持久化;AOF 文件 15GB,某次宕机后,恢复数据用了 40 分钟,期间业务无法正常运行,损失营收 50 多万;开启混合持久化后,同样 15GB 的 AOF 文件,恢复只需要 5 分钟,影响极小;
-
关键提醒:开启混合持久化,不影响刷盘策略的执行,只是优化 AOF 文件的格式和恢复速度;零基础直接开启即可,不用修改其他配置。
第三章第二节 总结
本章第二节,我们重点讲解了 AOF 持久化最核心的参数 ------appendfsync,以及它对应的三种刷盘策略(always、everysec、no)
核心总结:
- 核心参数:
appendfsync,一个参数、三个取值、对应三种刷盘策略,开启 AOF 持久化(appendonly yes)后,才会生效; - 策略差异:always(零丢失、性能差)、everysec(1 秒丢失、高性能、万能)、no(几分钟丢失、性能最好、临时数据用);
- 选型原则:核心业务选 everysec,极端核心低并发选 always,临时数据选 no;零基础直接选 everysec,绝对不踩坑;
- 硬件要求:核心业务、高并发业务,必须用 SSD 硬盘;HDD 硬盘只用于测试、临时数据;
- 关键提醒:绝对不要误用 always 到高并发业务、误用 no 到核心业务;做好刷盘监控,避免刷盘失败;开启混合持久化,提升恢复速度;
- 零基础必记:一个参数(appendfsync)、三种策略、万能选择(everysec)、SSD 标配、监控不踩坑。
到这里,AOF 持久化最核心、最影响安全和性能的刷盘策略,就全部讲解完毕了;下一节,我们讲解 AOF 持久化的另一个关键知识点 ------AOF 重写(解决 AOF 文件过大的问题),同样无限详细、零超纲、通俗易懂,帮你彻底掌握 AOF 持久化的所有核心内容。
第三章第三节:AOF 重写(AOF Rewrite)------ 解决 AOF 文件过大的核心方案
上一节我们讲完了 AOF 持久化最核心的刷盘策略,解决了 "如何安全、高效地将命令写入 AOF 文件" 的问题;但随着业务运行,新的问题会逐渐出现 ------AOF 文件会越来越大 :比如频繁执行 SET key value、INCR counter 等重复命令,AOF 文件会逐条记录所有命令,哪怕是对同一个 key 的无效操作、重复操作,都会被写入,导致 AOF 文件体积暴涨(比如运行 1 个月,AOF 文件从几十 MB 涨到几十 GB、上百 GB)。
AOF 文件过大,会引发三个致命问题:
- 硬盘空间占用过多:几十 GB、上百 GB 的 AOF 文件,会快速耗尽硬盘空间,导致硬盘满,进而引发刷盘失败、Redis 启动失败,甚至整个服务器故障;
- 数据恢复速度极慢:Redis 重启时,需要逐条执行 AOF 文件中的所有命令,才能恢复内存数据;文件越大,执行命令的时间越长,恢复速度越慢 ------80GB 的 AOF 文件,恢复可能需要几小时、甚至十几小时,期间业务无法正常运行,损失惨重;
- 刷盘性能下降:AOF 文件越大,
write、fsync系统调用写入的数据量就越大,IO 压力越大,刷盘速度越慢,甚至会导致刷盘延迟超过 1 秒,丢失更多数据;
为了解决 AOF 文件过大的问题,Redis 提供了 AOF 重写(AOF Rewrite) 机制 ------ 这是 AOF 持久化的核心补充,和刷盘策略相辅相成
3.3.1 什么是 AOF 重写
AOF 重写,简单来说,就是 Redis 重新生成一个 "干净、简洁" 的新 AOF 文件,替换掉原来 "臃肿、冗余" 的旧 AOF 文件;
新文件只保留 "恢复当前内存中所有有效数据,所必需的最小命令集",去掉所有重复、无效、过期的命令,从而大幅缩小 AOF 文件体积,提升恢复速度和刷盘性能。
核心本质
AOF 重写的核心本质:不是修改原 AOF 文件,而是 "重新快照"------Redis 读取当前内存中的所有有效数据,为每一条有效数据,生成一条对应的 "最简写入命令",然后将这些最简命令,写入一个新的 AOF 文件;写完后,用新文件替换旧文件,旧文件被自动删除。
举个最直观的例子:
- 场景:Redis 中只有一个 key(
counter),业务频繁执行INCR counter命令,共执行了 10000 次,从 0 递增到 10000; - 重写前的 AOF 文件(臃肿、冗余):会逐条记录这 10000 条
INCR counter命令,文件体积较大(假设每条命令占 15 字节,10000 条就是 150KB); - 重写后的 AOF 文件(干净、简洁):Redis 读取内存中
counter的当前值是 10000,只生成一条最简命令SET counter 10000,写入新文件,文件体积只有 20 字节左右; - 对比:文件体积从 150KB 缩小到 20 字节,缩小了 7500 倍;恢复时,重写前需要执行 10000 条命令,重写后只需要执行 1 条命令,恢复速度提升 10000 倍。
通俗类比
AOF 重写,就像我们记 "家庭开支账本":
- 重写前(旧 AOF 文件):你每天花一分钱,就记一条流水账,哪怕是重复花钱(比如每天买一瓶矿泉水,每天记一条 "买矿泉水 2 元")、无效花钱(比如买了又退,记了 "买衣服 100 元",又记了 "退衣服 -100 元"),都会逐条记录,时间久了,账本会变得非常厚,找一条记录、重新核对账本,都非常慢;
- 重写后(新 AOF 文件):你不记流水账了,而是每月底,盘点一下家里所有的资产(比如现金、存款、物品),只记录 "最终的资产情况"(比如 "现金 5000 元、存款 10 万元、衣服 50 件"),去掉所有重复、无效的记录,账本会变得非常薄,找记录、核对账本,都非常快;
- 对应关系:账本 = AOF 文件;流水账 = 重写前的冗余命令;月底盘点的最终资产 = 内存中的有效数据;最终资产记录 = 重写后的最简命令;重写 = 月底盘点、重新记账。
重写的核心作用
AOF 重写的作用,本质上就是解决 "旧 AOF 文件过大" 的三个致命问题,同时不影响数据安全,具体有 4 个核心作用:
- 大幅缩小 AOF 文件体积,节省硬盘空间:这是最核心的作用,通常能将文件体积缩小 10~100 倍,甚至更多(比如前面的例子,缩小 7500 倍);
- 提升数据恢复速度:重写后的 AOF 文件,命令数量极少,Redis 重启时,不需要执行大量冗余命令,恢复速度能提升 10~100 倍;
- 提升刷盘性能:重写后的 AOF 文件体积小,后续写入命令时,
write、fsync写入的数据量更少,IO 压力更小,刷盘速度更快,避免刷盘延迟; - 去除无效命令,避免恢复时执行无效操作:重写时,会自动过滤掉过期、无效、重复的命令,避免 Redis 重启时,执行这些无效命令,浪费时间、占用资源;
重写的关键特点
- 不修改原 AOF 文件,安全无风险:重写全程操作的是 "新的临时 AOF 文件",原 AOF 文件依然正常存在、正常写入(重写期间,新的修改命令,会继续写入原 AOF 文件和重写缓冲区);只有当新文件完全写完、确认无误后,才会用新文件替换旧文件;哪怕重写失败(比如硬盘满、服务器宕机),原 AOF 文件依然完好,不会影响数据安全,也不会影响业务运行;
- 后台执行,不阻塞主线程:AOF 重写是 "后台线程" 执行的(和 everysec 策略的后台刷盘线程类似),Redis 主线程依然可以正常处理客户端的读写请求,不会出现 "业务卡顿、超时" 的情况;这是 AOF 重写的核心优势之一,避免了重写期间影响业务;
- 补充说明:Redis 1.0 版本中,AOF 重写是主线程执行的,重写期间会阻塞主线程,导致业务卡顿;后续版本(2.0+)优化后,改为后台线程执行(
bgrewriteaof线程),彻底解决了阻塞问题;现在生产中使用的 Redis 版本(5.0+、6.0+、7.0+),都是后台线程执行重写;
- 补充说明:Redis 1.0 版本中,AOF 重写是主线程执行的,重写期间会阻塞主线程,导致业务卡顿;后续版本(2.0+)优化后,改为后台线程执行(
- 重写后的文件,格式更简洁,命令更高效:重写后的 AOF 文件,只保留最简命令,比如多次
INCR合并为一条SET,多次HSET合并为一条HMSET(或HSET批量写入),命令执行效率更高,恢复速度更快; - 重写不影响刷盘策略:AOF 重写和刷盘策略(always、everysec、no)是两个独立的机制,重写期间,刷盘策略依然正常执行,新的修改命令会按照既定的刷盘策略,写入原 AOF 文件和 kernel 缓冲区,确保重写期间的数据安全(最多丢失的数据量,依然由刷盘策略决定);
3.3.2 为什么 AOF 文件会变大
想要彻底用好 AOF 重写,必须先懂 "为什么 AOF 文件会变大"------ 只有找到根源,才能合理配置重写参数、选择重写时机,避免 "频繁重写" 或 "重写不及时";AOF 文件变大的核心原因,是 "命令的冗余写入",具体分为 4 种情况
原因 1:重复写入相同命令(最常见、最主要的原因)
业务中,频繁对同一个 key 执行相同的修改命令,AOF 文件会逐条记录所有命令,哪怕这些命令的最终效果是重复的,导致文件冗余、体积暴涨;这是生产中 AOF 文件变大的最主要原因,占比超过 80%。
详细拆解:
- 典型场景:计数器(比如文章阅读量、视频播放量、商品点赞数)、用户在线状态(频繁更新
SET user:online 1)、实时排行榜(频繁更新分数ZADD rank 100 user1); - 关键提醒:这些重复命令,对 "恢复数据" 来说,完全是冗余的 ------ 恢复时,只需要一条
SET article:read:1001 100000命令,就能达到和 10 万条INCR命令相同的效果;AOF 重写,就是要过滤掉这些重复命令,只保留最终的最简命令。
原因 2:无效命令写入(冗余的次要原因,容易被忽略)
Redis 执行了一些 "无效的修改命令",这些命令不会改变内存中的数据,但依然会被写入 AOF 文件,导致文件体积变大;无效命令主要分为 3 种:
- 写入后立即删除的命令:比如
SET key value之后,立即执行DEL key;这两条命令,最终不会改变内存中的数据(key 被删除,内存中没有该 key),但都会被写入 AOF 文件,属于无效命令; - 对不存在的 key 执行修改命令:比如
INCR non_exist_key(non_exist_key 不存在)、HSET non_exist_hash name zhangsan(non_exist_hash 不存在);这些命令,执行后不会改变内存中的数据(不存在的 key,执行修改命令,会创建 key,但如果后续该 key 被删除,或者没有其他操作,依然属于无效命令),但会被写入 AOF 文件; - 重复删除命令:比如
DEL key之后,再次执行DEL key;第二次DEL key命令,属于无效命令(key 已经被删除,再次删除,不会改变内存数据),但依然会被写入 AOF 文件;
原因 3:过期命令未清理(容易被忽略,长期积累会导致文件变大)
Redis 中的 key 过期后,Redis 会自动删除该 key(惰性删除 + 定期删除),但 过期 key 对应的写入命令,依然会保留在 AOF 文件中,不会被自动删除;这些命令,在恢复时,执行后会创建过期的 key(Redis 加载 AOF 文件时,会执行所有命令,包括过期 key 的写入命令,然后再检查 key 的过期时间,删除过期 key),属于冗余命令,会导致 AOF 文件体积变大。
详细拆解:
- 核心原因:Redis 的过期删除机制(惰性删除、定期删除),只负责删除内存中的过期 key,不会去修改 AOF 文件,也不会删除 AOF 文件中过期 key 对应的命令;AOF 文件中的命令,只有在 AOF 重写时,才会被过滤(重写时,Redis 读取内存中的有效数据,过期 key 已被删除,内存中没有,所以不会生成对应的命令);
原因 4:命令本身的冗余(Redis 命令的特性,无法避免,只能通过重写优化)
Redis 的一些命令,本身就存在 "冗余"------ 比如 RPUSH list1 a、RPUSH list1 b、RPUSH list1 c,三条命令,功能上等同于一条 RPUSH list1 a b c 命令,但前者会被写入 3 条命令,后者只需要 1 条命令;这种命令本身的冗余,也会导致 AOF 文件体积变大,只能通过 AOF 重写优化。
详细拆解:
- 典型场景:列表(list)、集合(set)、有序集合(zset)的批量操作,频繁执行单个元素操作,而非批量操作;
- 案例:某短视频平台,给用户的关注列表(list 类型,key 为
follow:1001),每次用户关注一个人,就执行一次RPUSH follow:1001 2001命令;用户关注 100 个人,会执行 100 条RPUSH命令,AOF 文件会记录这 100 条命令;AOF 重写时,Redis 读取内存中follow:1001列表的所有元素,生成一条RPUSH follow:1001 2001 2002 ... 2100批量命令,写入新文件,将 100 条命令合并为 1 条,大幅减少命令数量,缩小文件体积; - 补充说明:这种冗余,是业务操作方式导致的 ------ 如果业务中,能直接使用批量命令(比如
RPUSH list1 a b c、SADD set1 a b c),就能减少命令冗余,延缓 AOF 文件变大的速度;但实际生产中,很多业务无法提前批量操作(比如用户关注,是实时的、单个的),所以这种冗余无法完全避免,只能通过 AOF 重写优化。
总结:AOF 文件变大的核心根源
AOF 文件变大的核心根源,是 "命令的冗余写入" ------ 重复命令、无效命令、过期命令、命令本身的冗余,这些命令都会被逐条写入 AOF 文件,长期积累,导致文件体积暴涨;而 AOF 重写,就是通过 "读取内存中的有效数据,生成最简命令集",过滤所有冗余命令,从根源上解决文件过大的问题。
3.3.3 AOF 重写的核心原理
AOF 重写的原理,看似复杂,实则简单 ------ 本质就是 "读取内存有效数据,生成最简命令,写入新文件,替换旧文件";
核心前提
- 必须开启 AOF 持久化(
appendonly yes):如果没有开启 AOF 持久化,Redis 不会生成 AOF 文件,自然也就不需要 AOF 重写;AOF 重写,只针对开启了 AOF 持久化的 Redis 实例; - 重写期间,Redis 主线程正常工作:重写是后台线程执行的,不会阻塞主线程,客户端的读写请求,依然能正常处理;
- 重写不依赖原 AOF 文件:AOF 重写,不需要读取原 AOF 文件中的命令,只需要读取当前内存中的有效数据 ------ 哪怕原 AOF 文件损坏、丢失,只要内存中的数据是完整的,就能正常执行重写,生成新的 AOF 文件;
完整重写原理
假设 Redis 开启了 AOF 持久化(appendonly yes),采用 everysec 策略,当前内存中有 3 条有效数据(counter:100、user:1001 {name:zhangsan, age:20}、list:1 [a,b,c]),原 AOF 文件中有大量冗余命令(比如 1000 条 INCR counter、20 条 HSET user:1001、3 条 RPUSH list:1);此时执行 AOF 重写,完整步骤如下:
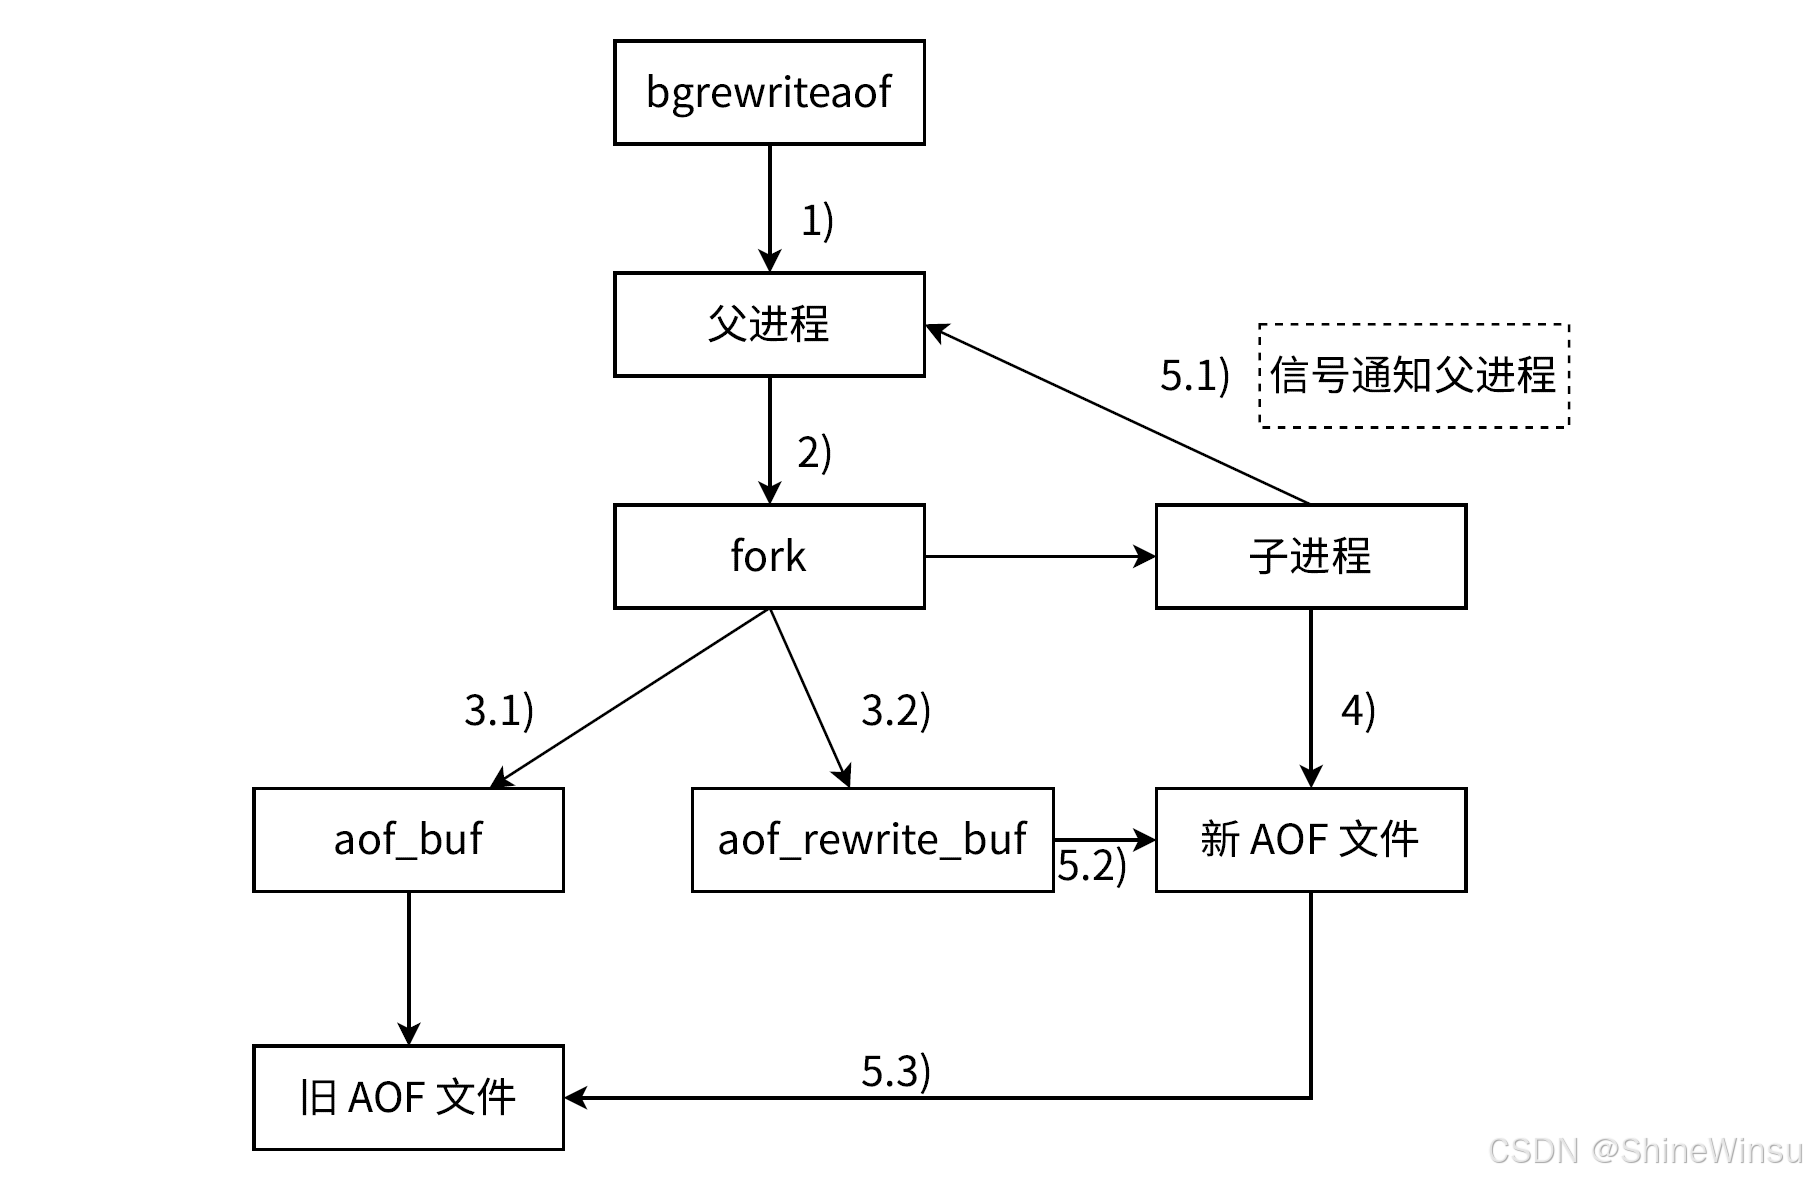
步骤 1:触发 AOF 重写(手动 / 自动,后续详细讲)
Redis 收到 AOF 重写触发指令(手动执行 bgrewriteaof 命令,或自动触发条件满足),准备开始重写;此时,Redis 会做一个简单的检查:是否有正在执行的 AOF 重写线程?是否有正在执行的 RDB 持久化线程(bgsave)?
- 如果有正在执行的 AOF 重写线程:不执行新的重写,等待当前重写完成后,再执行(避免多个重写线程同时执行,占用大量 CPU 和 IO 资源);
- 如果有正在执行的 RDB 持久化线程(bgsave):AOF 重写会推迟执行,等待 RDB 持久化完成后,再执行(因为 RDB 和 AOF 重写,都会读取内存数据、写入硬盘,同时执行会导致 IO 过载,影响性能);
- 案例:当前正在执行 RDB 持久化(bgsave),运维人员手动触发 AOF 重写,Redis 会提示 "Background append only file rewrite scheduled"(重写已调度,等待 RDB 完成);RDB 完成后,自动开始 AOF 重写。
步骤 2:创建后台重写线程(bgrewriteaof 线程)
Redis 主线程,创建一个独立的后台重写线程(线程名为 bgrewriteaof),将 "读取内存数据、生成最简命令、写入新文件" 的任务,交给该后台线程执行;主线程立即返回 "OK"(如果是手动触发),继续处理客户端的读写请求,不阻塞、不等待 ------ 这是 "重写不影响业务" 的核心原因。
步骤 3:后台线程读取内存中的所有有效数据
后台重写线程,遍历 Redis 内存中的所有数据(包括字符串、hash、list、set、zset 等所有数据类型),筛选出 "有效数据"------ 即没有过期、没有被删除、真实存在的 key;过滤掉过期 key、已删除 key、临时无效 key(比如写入后立即删除的 key)。
详细拆解:
- 后台线程,会逐个读取内存中的 key,检查 key 的状态:
- 如果 key 已过期(过期时间 < 当前时间):过滤,不处理;
- 如果 key 已被删除(内存中标记为删除状态):过滤,不处理;
- 如果 key 是临时无效 key(比如写入后立即删除,内存中没有该 key):过滤,不处理;
- 如果 key 是有效 key(未过期、未删除,内存中有对应数据):保留,继续处理;
- 案例:当前内存中,有 4 条 key:
counter:100(有效)、user:1001(有效)、list:1(有效)、coupon:1001(已过期);后台线程会过滤掉coupon:1001,只保留前 3 条有效 key。
步骤 4:为每一条有效数据,生成最简写入命令
后台线程,针对每一条有效数据,根据其数据类型,生成一条 "最简、最高效" 的写入命令 ------ 这条命令,能一次性将该 key 的当前状态,写入 AOF 文件,避免冗余;不同数据类型,生成的命令不同:
| 数据类型 | 内存中的有效数据 | 重写前的冗余命令(原 AOF 文件) | 重写后的最简命令(新 AOF 文件) |
|---|---|---|---|
| 字符串(string) | counter:100 |
1000 条 INCR counter |
SET counter 100 |
| hash | user:1001 {name:zhangsan, age:20} |
20 条 HSET user:1001 name zhangsan、HSET user:1001 age 20 等 |
HMSET user:1001 name zhangsan age 20(或批量 HSET) |
| list | list:1 [a,b,c] |
3 条 RPUSH list:1 a、RPUSH list:1 b、RPUSH list:1 c |
RPUSH list:1 a b c |
| set | set:1 {a,b,c} |
3 条 SADD set:1 a、SADD set:1 b、SADD set:1 c |
SADD set:1 a b c |
| zset | zset:1 {a:10, b:20, c:30} |
3 条 ZADD zset:1 10 a、ZADD zset:1 20 b、ZADD zset:1 30 c |
ZADD zset:1 10 a 20 b 30 c |
案例:
- 内存中
user:1001是 hash 类型,包含 2 个字段(name、age);重写前,原 AOF 文件中有 20 条HSET命令(频繁更新 name、age);重写后,后台线程只生成一条HMSET user:1001 name zhangsan age 20命令,就能完整恢复该 key 的数据,命令数量从 20 条减少到 1 条,冗余大幅减少。
步骤 5:后台线程将最简命令,写入新的 AOF 临时文件
后台线程,将生成的所有最简命令,按照 Redis 命令的 RESP 格式(和原 AOF 文件格式一致,纯文本格式),写入一个 "新的 AOF 临时文件"(默认名称为 appendonly.aof.rewrite,存储在和原 AOF 文件相同的路径);此时,新文件还没有替换旧文件,只是一个临时文件。
关键细节:
- 新文件是 "临时文件",不会被刷盘策略写入新的命令(重写期间,新的修改命令,会写入原 AOF 文件和重写缓冲区,不会直接写入该临时文件);
- 后台线程写入临时文件时,会每写入 32MB 数据,执行一次
fsync系统调用(由aof-rewrite-incremental-fsync参数控制,后续详细讲),将临时文件中的命令,刷到硬盘,避免临时文件过大,占用过多内存,同时确保临时文件的数据安全(防止重写期间宕机,临时文件丢失); - 案例:后台线程生成了 100MB 的最简命令,写入临时文件;每写入 32MB,执行一次 fsync,共执行 4 次 fsync(32MB、64MB、96MB、100MB),确保临时文件中的数据,都被刷到硬盘,即使重写期间宕机,临时文件中的数据也不会丢失。
步骤 6:处理重写期间的新修改命令(核心重点,避免数据丢失)
重写期间,Redis 主线程依然会正常处理客户端的读写请求 ------ 如果有新的修改命令(比如 SET newkey newvalue、INCR counter),这些命令会被 "双重写入",确保重写期间的数据安全,同时确保新文件包含这些最新的命令:
- 正常写入 aof_buf 缓冲区:按照既定的刷盘策略(everysec/no/always),执行 write、fsync,写入原 AOF 文件 ------ 确保重写期间,即使重写失败,原 AOF 文件依然包含所有最新的命令,数据安全有保障;
- 同时写入 "重写缓冲区"(aof_rewrite_buf):这是一个临时的缓冲区,专门用于存储重写期间的新修改命令 ------ 确保这些最新的命令,能被写入新的 AOF 临时文件,避免重写后的新文件,缺少重写期间的最新数据;
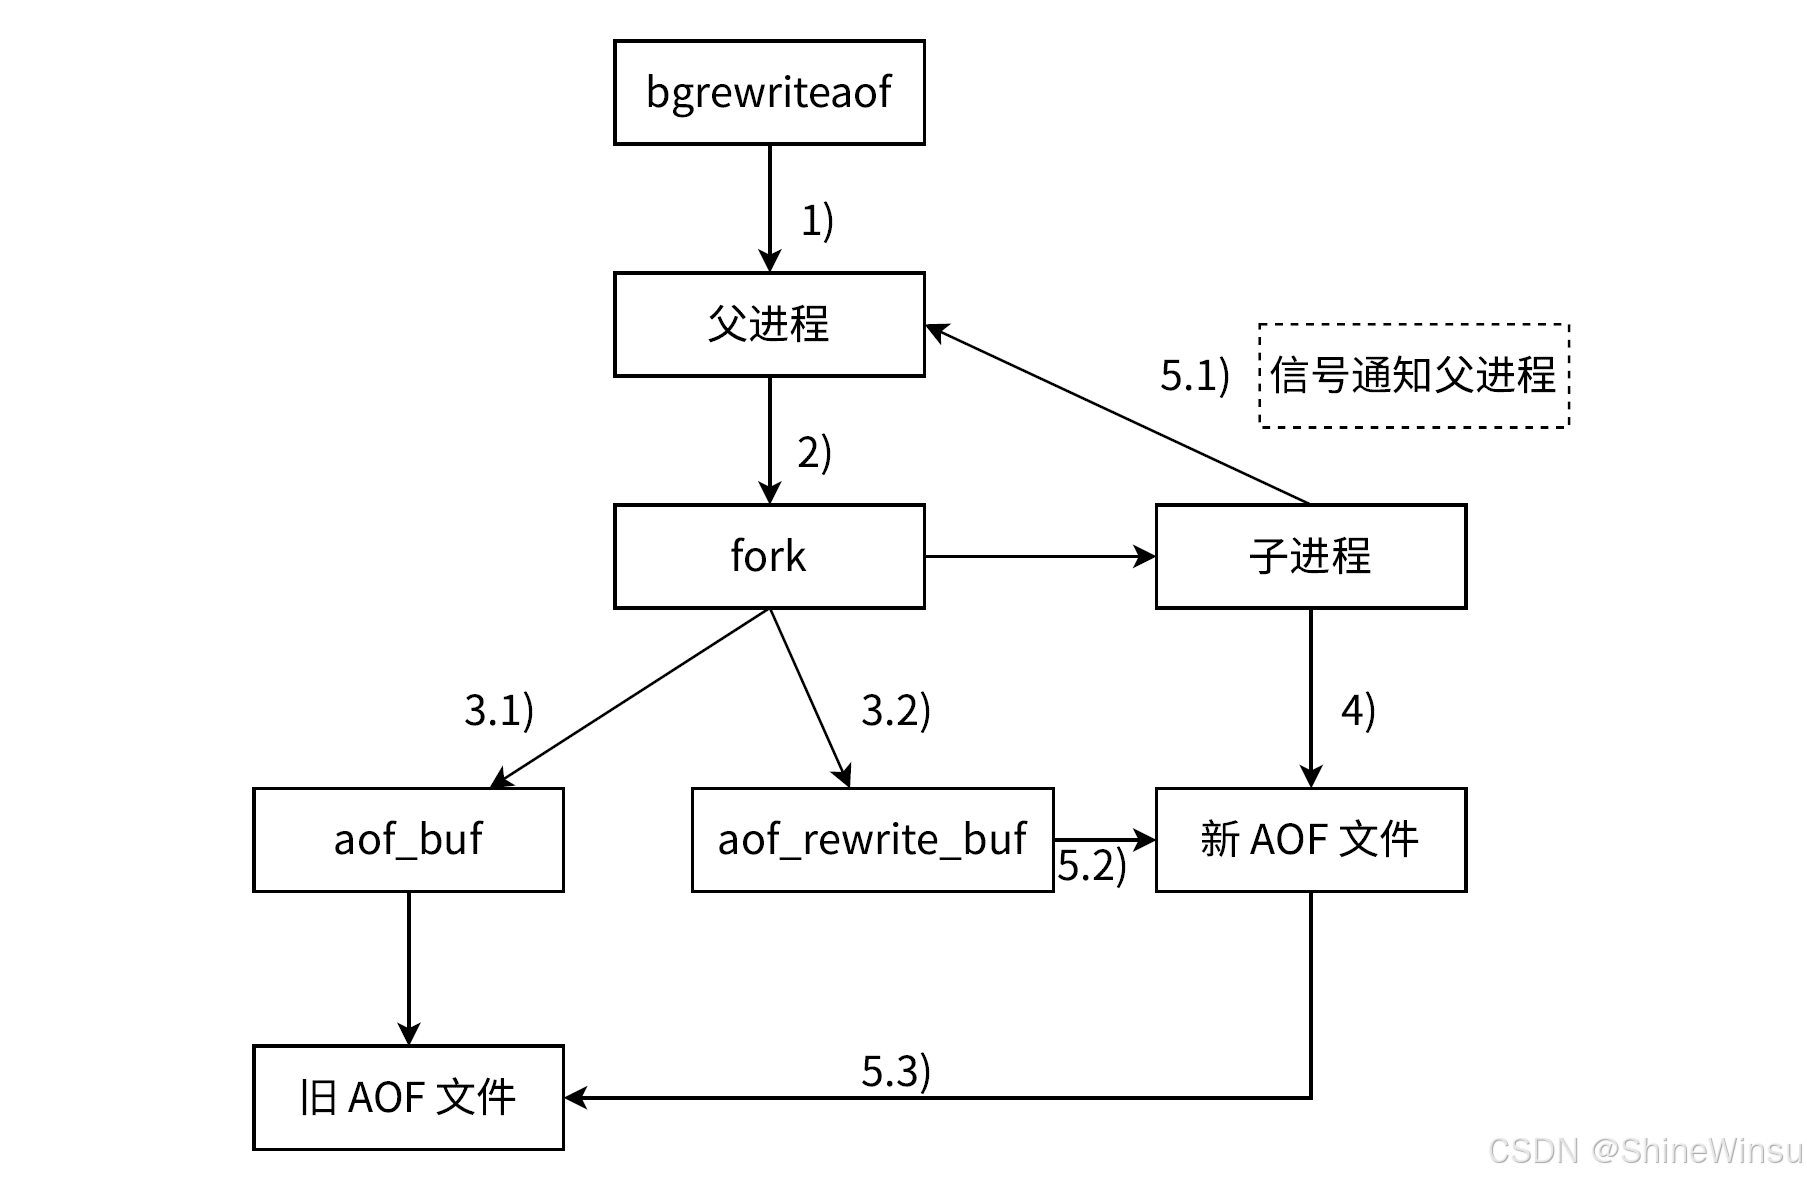
详细拆解:
- 案例:AOF 重写执行到步骤 5(后台线程正在写入临时文件)时,客户端发送了一条
INCR counter命令(将 counter 从 100 改成 101);- 主线程执行该命令,修改内存中的 counter 值为 101;
- 主线程将该命令,写入 aof_buf 缓冲区,按照 everysec 策略,执行 write 写入 kernel 缓冲区,后台刷盘线程每 1 秒执行一次 fsync,写入原 AOF 文件;
- 主线程同时将该命令,写入重写缓冲区(aof_rewrite_buf);
- 这样,无论重写成功还是失败,该命令都不会丢失:重写成功,会被写入新文件;重写失败,会被保留在原文件中;
- 关键提醒:重写缓冲区,只有在 AOF 重写期间,才会被使用;重写完成后,重写缓冲区会被清空,不再使用;如果重写失败,重写缓冲区中的命令,也会被清空(因为这些命令已经写入原 AOF 文件,不需要再重复处理)。
步骤 7:合并重写缓冲区的命令,完善新临时文件
当后台线程,完成 "所有内存有效数据的最简命令写入"(步骤 5 完成)后,会读取 "重写缓冲区" 中的所有命令(重写期间的新修改命令),将这些命令,写入新的 AOF 临时文件;这样,新的临时文件,就包含了 "重写前的所有有效数据 + 重写期间的所有新修改命令",和当前内存中的数据完全一致,没有任何遗漏。
案例:
- 后台线程完成步骤 5 时,临时文件中包含
SET counter 100、HMSET user:1001 ...、RPUSH list:1 ...三条命令; - 重写缓冲区中,包含一条
INCR counter命令(重写期间的新命令); - 后台线程读取重写缓冲区的命令,写入临时文件;此时,临时文件中,除了原来的三条命令,还多了一条
INCR counter命令; - 新临时文件中的命令,执行后,能将内存中的数据(counter:101、user:1001、list:1)完整恢复,没有遗漏。
步骤 8:替换旧 AOF 文件,完成重写
后台线程,将重写缓冲区的命令,全部写入新的 AOF 临时文件后,会执行一次 fsync 系统调用,将临时文件中的所有命令,全部刷到硬盘,确保临时文件的数据完整;然后,Redis 会用新的 AOF 临时文件,替换原来的 AOF 文件(删除旧文件,将临时文件重命名为 appendonly.aof,和原文件名称一致);至此,AOF 重写完成。
关键细节:
- 替换是 "原子操作":Redis 替换旧文件的操作,是原子性的(要么完全替换,要么不替换),不会出现 "替换一半,服务器宕机,导致新旧文件都损坏" 的情况;
- 案例:替换旧文件时,服务器突然断电;此时,替换操作还未完成,旧文件依然完好,新文件还是临时文件;Redis 重启后,会加载旧文件,不会加载未完成的临时文件,数据安全有保障;
- 替换完成后,原文件被自动删除:替换成功后,Redis 会自动删除原来的旧 AOF 文件,释放硬盘空间;如果替换失败(比如临时文件损坏),Redis 不会删除旧文件,会继续使用旧文件,同时记录重写失败的日志,方便运维人员排查;
- 重写完成后,刷盘策略正常作用于新文件:替换完成后,新的 AOF 文件(
appendonly.aof),会替代旧文件,成为新的 AOF 持久化文件;后续的所有修改命令,都会按照既定的刷盘策略,写入新文件,重写缓冲区被清空,后台重写线程退出。
重写原理总结
AOF 重写的完整流程:触发重写 → 创建后台重写线程 → 后台线程读取内存有效数据 → 生成最简命令 → 写入新临时文件 → 重写期间新命令双重写入(原文件 + 重写缓冲区) → 合并重写缓冲区命令到临时文件 → 原子替换旧文件 → 重写完成;
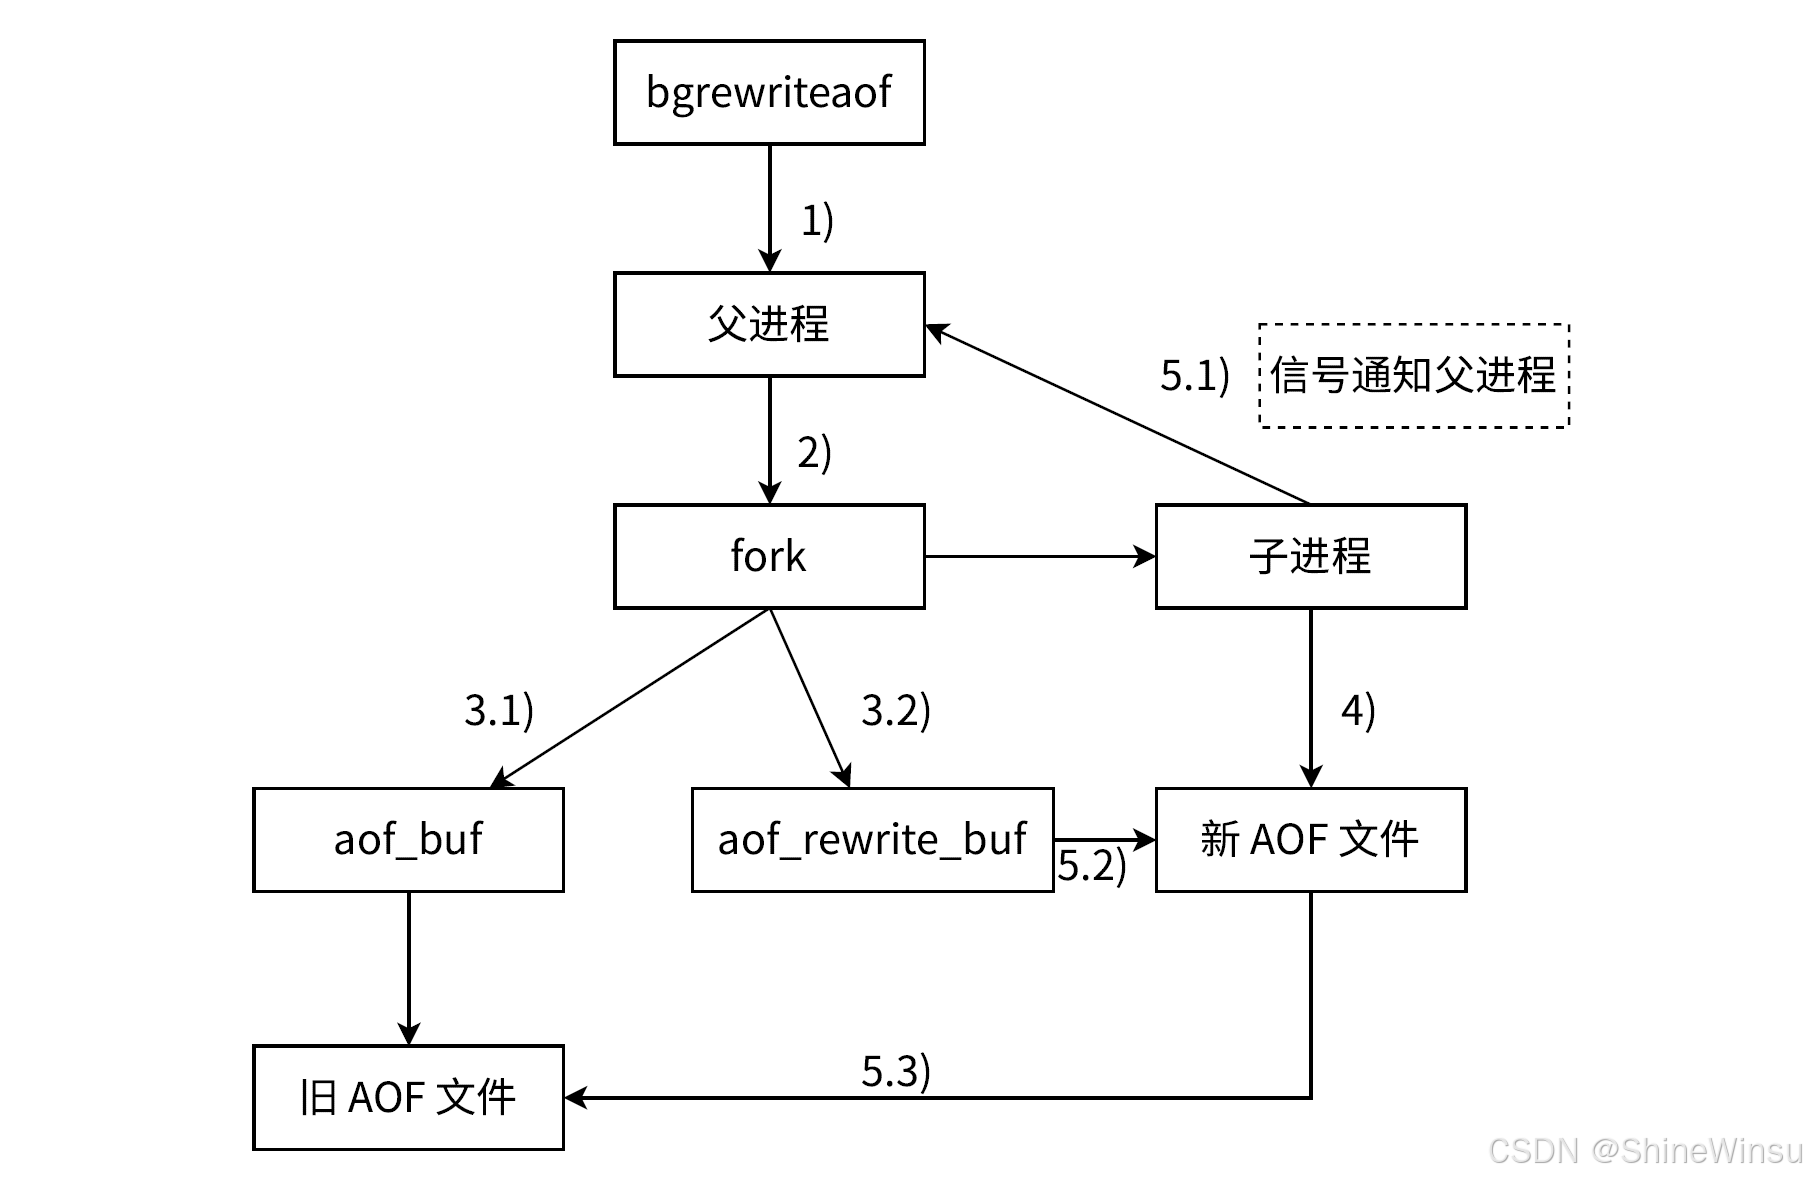
核心关键点:
- 重写不修改旧文件,只生成新文件,安全无风险;
- 后台执行,不阻塞主线程,不影响业务;
- 重写期间,新命令双重写入,避免数据丢失;
- 重写只依赖内存数据,不依赖旧 AOF 文件;
- 替换是原子操作,确保新旧文件不会同时损坏。
3.3.4 AOF 重写的触发方式
AOF 重写的触发方式,分为两种:手动触发 和 自动触发;生产中,两种方式结合使用 ------ 手动触发用于紧急情况(比如 AOF 文件突然变大,需要立即缩小),自动触发用于日常维护(避免手动操作,减少运维成本);
方式 1:手动触发(最直接、最灵活,生产应急必备)
手动触发,就是运维人员,在 Redis 客户端,手动执行 bgrewriteaof 命令,触发 AOF 重写;这种方式,灵活可控,适合紧急情况(比如 AOF 文件过大,硬盘空间不足,需要立即缩小文件体积),是生产中应急的必备方式。
手动触发的具体操作
-
连接 Redis 客户端(本地 / 远程):
-
本地连接:在 Redis 安装目录下,执行
redis-cli命令,即可连接本地 Redis 客户端(默认端口 6379,无密码);# 本地连接 Redis 客户端(默认配置) redis-cli -
远程连接:执行
redis-cli -h 服务器IP -p 端口 -a 密码命令,连接远程 Redis 客户端(需要知道服务器 IP、Redis 端口、密码);# 远程连接 Redis 客户端(示例) redis-cli -h 192.168.1.100 -p 6379 -a 123456
-
-
执行
bgrewriteaof命令,触发重写:127.0.0.1:6379> bgrewriteaof Background append only file rewrite started- 命令返回结果解读(零超纲):
Background append only file rewrite started表示 "后台 AOF 重写已启动",说明重写命令执行成功,后台重写线程已创建,开始执行重写任务;
- 命令返回结果解读(零超纲):
-
查看重写状态(确认重写是否正在执行、是否完成):执行
INFO persistence命令,查看重写相关的参数,判断重写状态;重点关注以下 3 个参数:aof_rewrite_in_progress:重写是否正在执行(0 = 未执行,1 = 正在执行);- 示例:
aof_rewrite_in_progress:1→ 重写正在执行;aof_rewrite_in_progress:0→ 重写未执行(已完成或未启动);
- 示例:
aof_last_rewrite_time_sec:上次重写完成所花费的时间(单位:秒);- 示例:
aof_last_rewrite_time_sec:12→ 上次重写,花费了 12 秒;如果是-1,表示从未执行过重写;
- 示例:
aof_current_rewrite_time_sec:当前正在执行的重写,已花费的时间(单位:秒);- 示例:
aof_current_rewrite_time_sec:5→ 当前重写,已经执行了 5 秒;如果是-1,表示没有正在执行的重写;
- 示例:
操作示例:
127.0.0.1:6379> INFO persistence
# Persistence
loading:0
rdb_changes_since_last_save:0
rdb_bgsave_in_progress:0
rdb_last_save_time:1770000000
rdb_last_bgsave_status:ok
rdb_last_bgsave_time_sec:-1
rdb_current_bgsave_time_sec:-1
rdb_last_cow_size:0
aof_enabled:1
aof_rewrite_in_progress:1  # 重写正在执行
aof_rewrite_scheduled:0    # 没有调度中的重写(等待执行的重写)
aof_last_rewrite_time_sec:12  # 上次重写花费 12 秒
aof_current_rewrite_time_sec:5  # 当前重写已执行 5 秒
aof_last_bgrewrite_status:ok  # 上次重写成功
aof_last_write_status:ok
aof_sync_in_progress:0
aof_current_buf_length:480
aof_buf_length:8192
aof_loading:0
aof_decoding:0
aof_last_fsync:1770000035
aof_delayed_fsync:0
解读:当前 Redis 正在执行 AOF 重写(aof_rewrite_in_progress:1),已经执行了 5 秒;上次重写花费了 12 秒,且重写成功;刷盘策略正常执行(aof_last_fsync 是 5 秒前,everysec 策略)。
手动触发的注意事项
- 避免在高并发期间,手动触发重写:AOF 重写,会读取内存数据、写入大量命令到新文件,消耗大量的 CPU 和 IO 资源;如果在业务高并发期间(比如电商双 11、短视频活动高峰),手动触发重写,会导致 CPU、IO 过载,影响业务响应速度,甚至出现超时;
- 正确时机:手动触发重写,应选择在业务低峰期(比如凌晨 0~3 点),此时并发量低,CPU、IO 资源充足,重写对业务的影响最小;
- 不要频繁手动触发重写:频繁触发重写,会频繁占用 CPU、IO 资源,导致 Redis 性能波动,影响业务;手动触发重写的频率,应根据 AOF 文件变大的速度,合理控制(比如每周 1~2 次,或文件体积翻倍时触发);
- 重写期间,不要关闭 Redis 或重启服务器:重写期间,关闭 Redis 或重启服务器,会导致重写失败;虽然不会丢失数据(原 AOF 文件依然完好),但会浪费已经花费的重写时间,且需要重新触发重写;
- 正确做法:如果确实需要重启 Redis,应先执行
INFO persistence,查看重写状态;如果重写正在执行,等待重写完成后,再重启;
- 正确做法:如果确实需要重启 Redis,应先执行
- 重写失败后,可重新触发重写:如果重写失败(比如硬盘空间满、IO 错误),Redis 会记录重写失败的日志(通过
redis-cli info persistence查看aof_last_bgrewrite_status,若为err则表示失败),同时不会删除旧 AOF 文件,依然继续使用旧文件;此时,运维人员需要先排查失败原因(比如清理硬盘空间、检查 IO 状态),排查完成后,再手动触发重写即可,不会影响数据安全。 - 重写期间,建议实时监控核心指标:手动触发重写后,不要放任不管,应实时监控 Redis 的 CPU 使用率、IO 使用率、重写进度(
aof_current_rewrite_time_sec),避免出现 CPU、IO 过载;若发现指标异常(比如 CPU 使用率超过 80%、IO 使用率达到 100%),可暂时停止重写(Redis 不支持手动停止正在执行的重写,只能等待其完成,或紧急重启 Redis,但重启会导致重写失败,需谨慎)。 - 主从架构中,重写建议在主节点执行:如果 Redis 是主从架构(主节点负责写入,从节点负责读取),AOF 重写建议在主节点执行;从节点的 AOF 文件,可通过同步主节点的 AOF 文件实现,无需单独执行重写,避免从节点重写占用资源,影响读取性能。
方式 2:自动触发(日常维护首选,减少运维成本)
自动触发,就是 Redis 按照配置的 "重写条件",自动判断是否需要执行 AOF 重写,无需运维人员手动操作 ------ 这是生产中最常用的方式,适合日常维护,能避免 "忘记手动重写,导致 AOF 文件过大" 的问题;自动触发的核心,是两个配置参数,必须彻底掌握
自动触发的核心配置参数
Redis 中,控制 AOF 自动重写的参数有两个,缺一不可,只有两个参数同时满足,才会自动触发重写;两个参数都在 Redis 配置文件(redis.conf)中,零基础可直接复制配置、修改数值,无需懂复杂原理。
参数 1:auto-aof-rewrite-percentage(重写百分比阈值,核心参数)
-
核心作用:指定 "当前 AOF 文件大小" 与 "上次重写后 AOF 文件大小" 的百分比阈值;当当前 AOF 文件大小,超过上次重写后文件大小的该百分比时,满足该参数的触发条件;
-
默认值:100(即 100%,表示当前文件大小是上次重写后文件大小的 2 倍时,满足条件);
-
取值范围:正整数(比如 50、100、200),0 表示禁用自动重写;
-
详细解释(零超纲,一步一步讲,加案例,避免误解):
- 关键前提:该参数,只有在 "上次重写成功完成" 后,才会生效;如果从未执行过重写(首次重写),该参数不生效(首次自动重写,只看参数 2);
- 计算逻辑:当前 AOF 文件大小(aof_current_size) ÷ 上次重写后 AOF 文件大小(aof_base_size) ≥ (auto-aof-rewrite-percentage ÷ 100);
- 案例 1(默认值 100,直观理解):
- 上次重写完成后,AOF 文件大小为 100MB(aof_base_size = 100MB);
- 随着业务运行,当前 AOF 文件大小涨到 200MB(aof_current_size = 200MB);
- 计算:200MB ÷ 100MB = 2 ≥ 100%(1),满足该参数的触发条件;
- 案例 2(修改为 150,理解取值含义):
- 上次重写完成后,AOF 文件大小为 100MB(aof_base_size = 100MB);
- 当前 AOF 文件大小涨到 150MB(aof_current_size = 150MB);
- 计算:150MB ÷ 100MB = 1.5 ≥ 150%(1.5),满足该参数的触发条件;
- 案例 3(不满足条件的情况):
- 上次重写完成后,AOF 文件大小为 100MB(aof_base_size = 100MB);
- 当前 AOF 文件大小涨到 180MB(aof_current_size = 180MB);
- 若参数设置为 200(200%),计算:180MB ÷ 100MB = 1.8 < 2,不满足该参数的触发条件;
-
配置格式:
# 自动重写百分比阈值,默认 100,推荐保持默认或修改为 150
auto-aof-rewrite-percentage 100
# 禁用自动重写(不推荐,除非手动重写频率能跟上)
# auto-aof-rewrite-percentage 0
参数 2:auto-aof-rewrite-min-size(重写最小文件大小,核心参数)
-
核心作用:指定 AOF 文件自动重写的 "最小体积阈值";只有当当前 AOF 文件大小,大于等于该阈值时,才有可能触发自动重写;目的是避免 "文件过小,频繁触发重写"(比如文件只有 10MB,即使达到百分比阈值,也不重写,节省资源);
-
默认值:67108864 字节(即 64MB);
-
单位:字节(可直接写数字,也可加单位,比如 64mb、128mb,Redis 会自动转换);
-
详细解释:
- 核心目的:过滤掉 "小文件" 的重写需求;AOF 文件较小时(比如 ≤ 64MB),即使达到百分比阈值(比如从 32MB 涨到 64MB,达到 100% 阈值),也不会自动重写 ------ 因为小文件对硬盘空间、恢复速度、刷盘性能的影响极小,频繁重写反而会浪费 CPU、IO 资源;
- 案例 1(默认值 64MB,满足条件):
- 上次重写后,AOF 文件大小为 64MB(aof_base_size = 64MB);
- 当前 AOF 文件大小涨到 128MB(aof_current_size = 128MB);
- 百分比参数为 100%,计算:128MB ÷ 64MB = 2 ≥ 100%,且当前文件大小 128MB ≥ 64MB,满足两个参数条件,触发自动重写;
- 案例 2(默认值 64MB,不满足条件):
- 首次运行 Redis,AOF 文件从 32MB 涨到 64MB(达到 100% 百分比阈值);
- 当前文件大小 64MB = 64MB(默认阈值),满足参数 2;但因为是首次重写,没有 "上次重写后文件大小"(aof_base_size 为 0),所以首次自动重写,只看参数 2 + 百分比参数的特殊逻辑(首次重写,只要当前文件大小 ≥ 最小阈值,且达到百分比阈值,就触发);
- 案例 3(不满足参数 2,不触发重写):
- 上次重写后,AOF 文件大小为 32MB(aof_base_size = 32MB);
- 当前 AOF 文件大小涨到 64MB(达到 100% 百分比阈值);
- 但当前文件大小 64MB = 64MB(默认阈值),若参数 2 改为 128MB,当前文件大小 64MB < 128MB,不满足参数 2,不触发自动重写;
-
配置格式:
# 自动重写最小文件大小,默认 64MB,推荐根据业务调整为 128MB 或 256MB
auto-aof-rewrite-min-size 64mb
# 调整为 128MB(推荐,适合大部分生产场景)
# auto-aof-rewrite-min-size 128mb
自动触发的核心条件
Redis 自动触发 AOF 重写,必须同时满足以下 4 个条件(前 3 个是核心,第 4 个是前提),缺一不可,彻底记住,避免误解:
- 当前 AOF 文件大小(aof_current_size) ≥ auto-aof-rewrite-min-size(最小文件大小阈值);
- (当前 AOF 文件大小 - 上次重写后 AOF 文件大小) ÷ 上次重写后 AOF 文件大小 ≥ (auto-aof-rewrite-percentage ÷ 100);
- 补充:如果从未执行过重写(首次重写),则 "上次重写后文件大小" 按 0 计算,此时只要满足 "当前文件大小 ≥ 最小阈值",且 "当前文件大小 ≥ 最小阈值 × 百分比阈值 ÷ 100",就满足该条件(比如默认 64MB、100%,首次文件达到 64MB,就满足);
- 没有正在执行的 AOF 重写线程(aof_rewrite_in_progress = 0);
- 没有正在执行的 RDB 持久化线程(rdb_bgsave_in_progress = 0);如果有,AOF 自动重写会推迟执行,等待 RDB 完成后,再判断是否满足条件。
自动触发的完整流程
假设 Redis 配置如下(生产常用配置):
- auto-aof-rewrite-percentage 100
- auto-aof-rewrite-min-size 128mb
- appendonly yes
- appendfsync everysec
完整自动触发流程,结合案例拆解:
- 初始状态:Redis 已执行过一次 AOF 重写,上次重写后,AOF 文件大小为 128MB(aof_base_size = 128MB);当前没有正在执行的重写线程和 RDB 线程;
- 业务运行:随着客户端写入命令,AOF 文件大小逐渐增大,从 128MB 涨到 256MB(aof_current_size = 256MB);
- 条件判断:Redis 后台会定期(每秒)检查自动重写条件,此时:
- 条件 1:256MB ≥ 128MB(满足最小文件大小阈值);
- 条件 2:(256MB - 128MB)÷ 128MB = 1 ≥ 100%(满足百分比阈值);
- 条件 3:aof_rewrite_in_progress = 0(没有正在执行的重写线程);
- 条件 4:rdb_bgsave_in_progress = 0(没有正在执行的 RDB 线程);
- 触发重写:所有条件满足,Redis 自动创建 bgrewriteaof 后台重写线程,开始执行 AOF 重写,流程和手动触发的重写流程完全一致(读取内存数据 → 生成最简命令 → 写入临时文件 → 双重写入新命令 → 替换旧文件);
- 重写完成:重写完成后,新 AOF 文件大小恢复到 150MB 左右(包含所有有效数据 + 重写期间的新命令);Redis 自动更新 aof_base_size 为 150MB(下次自动重写,以上次重写后的 150MB 为基准);
- 后续循环:业务继续运行,AOF 文件再次增大,当达到 150MB × 2 = 300MB(满足 100% 百分比阈值),且 ≥ 128MB 时,再次自动触发重写,以此循环。
自动触发的注意事项
-
合理配置两个核心参数,避免频繁自动重写或重写不及时:
-
踩坑场景 1:参数设置不合理(百分比过低、最小阈值过小),比如百分比设为 50%、最小阈值设为 32MB;导致 AOF 文件从 32MB 涨到 48MB 就触发重写,频繁重写占用 CPU、IO 资源,影响业务;
-
正确配置建议:
- auto-aof-rewrite-percentage:100~150(默认 100 即可,文件翻倍时重写,兼顾资源和文件大小);
- auto-aof-rewrite-min-size:128MB~256MB(根据业务调整,核心业务建议 256MB,避免小文件频繁重写);
-
案例:
# 生产常用配置,避免频繁重写,也避免文件过大
auto-aof-rewrite-percentage 120
auto-aof-rewrite-min-size 256mb
解读:只有当当前 AOF 文件大小 ≥ 256MB,且是上次重写后文件大小的 1.2 倍以上时,才自动触发重写,既避免频繁重写,又避免文件过大。
-
-
高并发期间,可临时禁用自动重写:如果业务高并发期间(比如电商大促),担心自动触发重写占用 CPU、IO 资源,可临时将 auto-aof-rewrite-percentage 设为 0(禁用自动重写),高并发结束后,再改回原来的数值;
-
临时修改命令:
# 临时禁用自动重写(高并发期间使用)
127.0.0.1:6379> config set auto-aof-rewrite-percentage 0
OK
# 高并发结束后,恢复为 120%
127.0.0.1:6379> config set auto-aof-rewrite-percentage 120
OK
# 永久生效(需要写入配置文件,避免重启后失效)
127.0.0.1:6379> config rewrite
OK
-
-
首次自动重写,需要注意 "无历史重写记录" 的情况:如果 Redis 从未执行过重写(首次运行),aof_base_size 为 0,此时自动重写的条件,简化为 "当前 AOF 文件大小 ≥ auto-aof-rewrite-min-size",且没有正在执行的重写和 RDB 线程;首次重写完成后,后续自动重写,按照正常条件判断;
-
自动重写推迟执行的情况,需及时关注:如果自动触发条件满足,但此时有正在执行的 RDB 线程,AOF 自动重写会推迟执行;此时,需关注 RDB 执行进度,避免 RDB 执行时间过长,导致 AOF 文件持续增大,耗尽硬盘空间
-
自动重写失败后,Redis 会定期重试:如果自动触发重写后,因为硬盘空间满、IO 错误等原因导致重写失败,Redis 不会放弃,会在后续的 "条件检查" 中,再次判断是否满足自动触发条件,若满足,会再次尝试重写;同时,Redis 会记录重写失败的日志,方便运维人员排查问题。
3.3.5 AOF 重写的核心配置
前面我们讲了自动触发重写的两个核心参数,除此之外,还有两个补充配置,虽然默认配置就能满足大部分生产场景
配置 1:aof-rewrite-incremental-fsync(重写期间,临时文件增量刷盘,保障临时文件安全)
-
核心作用:控制 AOF 重写期间,后台重写线程写入 "新临时文件" 时,是否执行增量 fsync------ 即每写入一定量的数据,就执行一次 fsync,将临时文件中的数据刷到硬盘,避免临时文件过大,占用过多内存,同时防止重写期间宕机,临时文件中的数据丢失;
-
默认值:yes(开启增量 fsync,推荐保持默认);
-
取值:yes(开启)、no(关闭);
-
详细解释:
- 重写期间,后台线程会将大量最简命令,写入新的临时文件;如果不开启增量 fsync,这些命令会先写入内存缓冲区(kernel 缓冲区),只有当临时文件全部写完后,才执行一次 fsync,将所有命令刷到硬盘;
- 风险:如果重写期间,服务器宕机,临时文件中已写入但未刷盘的命令,会全部丢失;虽然原 AOF 文件依然完好,不会影响数据安全,但会浪费已经花费的重写时间,需要重新触发重写;
- 开启增量 fsync 后的逻辑(默认 yes):后台线程每写入 32MB 数据(Redis 内部固定阈值,无法修改),就自动执行一次 fsync,将临时文件中的数据刷到硬盘;这样,即使重写期间宕机,最多只丢失 32MB 数据(临时文件中的),且原 AOF 文件完好,风险极低;
- 案例:
- 开启增量 fsync(yes):后台线程写入临时文件,每写入 32MB,执行一次 fsync;重写期间,服务器宕机时,临时文件已写入 40MB,其中 32MB 已刷盘,8MB 未刷盘;宕机后,临时文件中只有 8MB 数据丢失,原 AOF 文件完好;重启后,重新触发重写,只需补充写入 8MB 相关的命令,节省时间;
- 关闭增量 fsync(no):后台线程写入临时文件,全部写入内存缓冲区,未执行任何 fsync;重写期间,服务器宕机时,临时文件已写入 40MB,全部未刷盘;宕机后,临时文件中的 40MB 数据全部丢失;重启后,需要重新触发重写,重新写入所有最简命令,浪费时间;
-
配置格式:
# 开启重写期间临时文件增量刷盘(推荐 yes,默认 yes) aof-rewrite-incremental-fsync yes # 关闭增量刷盘(不推荐,风险高) # aof-rewrite-incremental-fsync no -
关键提醒:零基础保持默认 yes 即可,不要修改为 no;修改为 no 不会提升太多性能,反而会增加临时文件数据丢失的风险,得不偿失。
配置 2:aof_rewrite_buffer_size(重写缓冲区大小,控制重写期间新命令的存储)
-
核心作用:指定 "重写缓冲区"(aof_rewrite_buf)的最大大小;重写期间,新的修改命令,会同时写入原 AOF 文件和重写缓冲区,重写缓冲区用于存储这些新命令,待内存数据写入临时文件后,再将这些命令合并到临时文件中;
-
默认值:无固定默认值,Redis 会根据内存情况,动态分配(通常足够支撑大部分生产场景,无需手动修改);
-
取值:正整数,单位为字节(可加单位,比如 64mb、128mb);
-
详细解释:
- 重写缓冲区的作用:存储重写期间的新修改命令,确保这些命令能被合并到新的临时文件中,避免重写后的新文件缺少最新数据;
- 默认情况:Redis 动态分配重写缓冲区大小,足够存储重写期间的新命令(即使重写需要 10 分钟,新命令也能正常存储);
- 需要修改的场景:重写期间,并发量极高,新命令写入速度极快,导致重写缓冲区溢出(Redis 会记录溢出日志);此时,需要手动增大重写缓冲区大小;
-
配置格式:
# 手动设置重写缓冲区大小为 128MB(仅当缓冲区溢出时修改) aof_rewrite_buffer_size 128mb # 手动设置为 64MB # aof_rewrite_buffer_size 64mb -
关键提醒:
- 零基础无需修改该参数,保持 Redis 动态分配即可;
- 只有当出现 "重写缓冲区溢出" 日志时,才需要手动增大该参数,不要盲目增大(会浪费内存资源);
- 若频繁出现缓冲区溢出,说明重写期间并发量过高,建议调整重写时机(避开高并发),而非单纯增大缓冲区。
3.3.6 AOF 重写生产常见踩坑
生产中,很多运维、开发人员,因为不懂 AOF 重写的原理、参数配置,误用重写机制,导致 Redis 性能下降、业务卡顿、AOF 文件损坏、硬盘空间耗尽等问题;
踩坑 1:自动重写参数配置不合理,导致频繁重写(最常见)
- 错误做法:将 auto-aof-rewrite-percentage 设为 50%、auto-aof-rewrite-min-size 设为 32MB;导致 AOF 文件从 32MB 涨到 48MB 就触发重写,每天触发 10+ 次重写;
- 错误原因:误以为 "重写越频繁,AOF 文件越小,性能越好",不懂频繁重写会占用大量 CPU、IO 资源,反而影响业务性能;
- 严重后果:每次重写,CPU 使用率暴涨到 80% 以上,IO 使用率达到 100%,Redis 响应时间从 0.05 秒涨到 0.5 秒,业务频繁卡顿,用户流失;同时,频繁重写会缩短硬盘使用寿命;
- 正确做法:
- 生产推荐配置:auto-aof-rewrite-percentage 100~150%,auto-aof-rewrite-min-size 128~256MB;
- 根据 AOF 文件变大的速度,调整参数:如果文件变大速度快(比如每天涨 100MB),可将 percentage 设为 100%;如果变大速度慢,可设为 150%;
- 定期查看重写日志,监控重写频率,避免每天重写超过 2 次。
踩坑 2:高并发期间,触发 AOF 重写(最致命,影响业务)
- 错误做法:在电商双 11、短视频活动高峰、游戏开服等高并发期间,手动触发 AOF 重写,或未禁用自动重写,导致自动触发重写;
- 错误原因:不懂 AOF 重写会消耗大量 CPU、IO 资源,误以为 "重写不阻塞主线程,就不会影响业务";忽略了高并发期间,CPU、IO 资源本身就很紧张,重写会加剧资源竞争;
- 严重后果:重写期间,CPU 使用率暴涨,IO 通道被占满,Redis 写入 QPS 暴跌,响应时间暴涨,大量用户请求超时(比如订单提交超时、游戏道具领取失败),营收损失惨重;
- 正确做法:
- 高并发期间,临时禁用自动重写(config set auto-aof-rewrite-percentage 0),高并发结束后,再恢复;
- 手动触发重写,必须选择在业务低峰期(比如凌晨 0~3 点),此时并发量低,CPU、IO 资源充足;
- 主从架构中,可在从节点执行重写,主节点只负责写入,避免主节点重写影响业务。
踩坑 3:忽略重写期间的硬盘空间,导致重写失败(容易被忽略)
- 错误做法:执行 AOF 重写前,不检查硬盘空间;重写期间,硬盘空间耗尽,导致重写失败,临时文件损坏;
- 错误原因:误以为 "重写后的文件比旧文件小,不会占用太多硬盘空间",忽略了重写期间,会同时存在 "旧 AOF 文件 + 新临时文件"------ 两个文件同时占用硬盘空间,直到重写完成,旧文件才会被删除;
- 严重后果:重写失败,临时文件损坏,Redis 继续使用旧 AOF 文件(数据安全无影响),但浪费了重写时间;同时,硬盘空间耗尽,会导致刷盘失败、Redis 无法写入命令,业务瘫痪;
- 正确做法:
- 触发重写前,必须检查硬盘空间,确保剩余空间 ≥ 旧 AOF 文件大小的 50%(推荐 ≥ 100%);比如旧文件 80GB,剩余空间至少保留 40GB,避免临时文件占用空间不足;
- 定期清理服务器无用文件,预留足够的硬盘空间(至少保留 20% 空闲空间);
- 配置硬盘空间监控,当空闲空间低于 20% 时,立即报警,及时清理。
踩坑 4:关闭 aof-rewrite-incremental-fsync,导致临时文件数据丢失(零基础常见)
- 错误做法:误以为 "关闭增量 fsync,能提升重写性能",将 aof-rewrite-incremental-fsync 设为 no;
- 错误原因:不懂增量 fsync 的作用,只追求重写速度,忽略了临时文件的数据安全;
- 严重后果:重写期间,服务器宕机,临时文件中已写入但未刷盘的命令,会全部丢失;虽然原 AOF 文件完好,不会影响数据安全,但会浪费重写时间,需要重新触发重写;若重写时间过长(比如几小时),重新触发会浪费大量资源;
- 正确做法:
- 零基础保持 aof-rewrite-incremental-fsync 为 yes(默认值),不要修改;
- 不要为了追求重写速度,牺牲临时文件的安全;增量 fsync 对重写速度的影响极小(每 32MB 执行一次 fsync,耗时极短),但能大幅提升临时文件的安全性。
踩坑 5:误以为 AOF 重写能解决所有 AOF 文件问题,不做备份(最危险)
- 错误做法:认为 "开启 AOF 重写,AOF 文件就不会出问题",不做 AOF 文件备份;
- 错误原因:不懂 AOF 重写的局限性 ------ 重写只能解决 "文件过大" 的问题,无法解决 "文件损坏""数据错误" 的问题;如果 AOF 文件损坏(比如硬盘故障、重写失败导致文件损坏),且没有备份,数据可能无法恢复;
- 严重后果:AOF 文件损坏,且没有备份,Redis 无法启动,业务瘫痪;若损坏严重,数据无法恢复,公司面临重大损失,甚至倒闭;
- 正确做法:
- AOF 重写和备份,是两个独立的机制,缺一不可;开启重写的同时,必须做好 AOF 文件备份;
- 备份频率:每天备份一次 AOF 文件,重写完成后,额外备份一次(重写后的文件更小,备份更快);
- 备份存储:将备份文件存储在独立的服务器、云存储(比如阿里云 OSS、腾讯云 COS),避免和原文件存储在同一个硬盘,防止硬盘故障导致备份也丢失。
3.3.7 常见问题(FAQ)
-
问:AOF 重写期间,Redis 的性能会下降吗?会影响业务吗?
- 答:会有轻微性能下降,但通常不会影响业务;若在高并发期间重写,性能下降会很明显,会影响业务;
- 详细解答:
- 轻微性能下降的原因:AOF 重写是后台线程执行的,会读取内存数据、写入大量命令到临时文件,消耗一定的 CPU 和 IO 资源;在业务低峰期,CPU、IO 资源充足,这种消耗对性能的影响极小(响应时间从 0.05 秒涨到 0.08 秒),用户感知不到;
- 明显性能下降的情况:在高并发期间,CPU、IO 资源本身就很紧张,重写消耗的资源会加剧竞争,导致 CPU 使用率暴涨、IO 过载,响应时间暴涨(从 0.05 秒涨到 0.5 秒以上),用户能明显感知到卡顿,甚至请求超时;
-
问:AOF 重写需要多久才能完成?和什么因素有关?
- 答:重写时间没有固定值,从几秒到几小时不等,核心和 4 个因素有关;
- 详细解答:
- 内存中有效数据的量(最核心因素):有效数据越多,重写时间越长;比如内存中有 1GB 有效数据,重写可能需要 10~20 秒;有 10GB 有效数据,可能需要 5~10 分钟;有 100GB 有效数据,可能需要 1~2 小时;
- 硬盘读写速度(第二核心因素):SSD 硬盘比 HDD 硬盘快很多,重写时间大幅缩短;比如 10GB 有效数据,SSD 硬盘重写需要 5 分钟,HDD 硬盘可能需要 30 分钟;
- CPU 性能:CPU 性能越强,重写线程读取内存数据、生成最简命令的速度越快;比如同一份 10GB 有效数据,8 核 CPU 重写需要 5 分钟,4 核 CPU 可能需要 10 分钟;
- 重写期间的并发量:重写期间,并发写入量越高,重写缓冲区中的命令越多,合并命令的时间越长,整体重写时间也会变长;比如 10GB 有效数据,无并发时重写需要 5 分钟,并发写入 QPS 10 万 + 时,可能需要 8 分钟;
-
问:AOF 重写失败后,会影响数据安全吗?Redis 还能正常运行吗?
- 答:不会影响数据安全,Redis 能正常运行,只是重写失败,需要重新触发重写;
- 详细解答:
- 核心原理:AOF 重写全程操作的是 "新的临时文件",原 AOF 文件依然正常存在、正常写入(重写期间,新的命令会继续写入原文件);即使重写失败,临时文件会被删除,Redis 依然继续使用原 AOF 文件,不会影响任何数据,也不会影响业务运行;
- 重写失败的影响:只是浪费了已经花费的重写时间,AOF 文件依然是原来的 "臃肿文件",需要排查失败原因(比如硬盘空间、IO 错误),排查完成后,重新触发重写即可;
-
问:可以关闭 AOF 重写吗?关闭后,会有什么影响?
- 答:可以关闭,但不推荐;关闭后,AOF 文件会持续变大,引发硬盘空间不足、恢复速度慢、刷盘性能下降等问题;
- 详细解答:
- 关闭方式:将 auto-aof-rewrite-percentage 设为 0(禁用自动重写),同时不手动触发重写,即可实现 "关闭 AOF 重写";
- 关闭后的影响(非常严重,生产绝对不推荐):
- AOF 文件持续变大:没有重写,冗余命令会不断积累,AOF 文件会从几十 MB 涨到几十 GB、上百 GB,快速耗尽硬盘空间;
- 数据恢复速度极慢:文件越大,Redis 重启时,执行命令的时间越长,恢复速度越慢,可能需要几小时、十几小时,期间业务无法运行;
- 刷盘性能下降:文件越大,write、fsync 写入的数据量越大,IO 压力越大,刷盘延迟越高,甚至会丢失更多数据;
-
问:手动触发和自动触发,优先用哪种?生产中,怎么搭配使用?
- 答:生产中,优先用 "自动触发 + 手动触发补充" 的方式,既减少运维成本,又能避免自动触发的不足;
- 详细解答:
- 自动触发:日常维护首选,配置合理的参数(100~150% 百分比、128~256MB 最小阈值),让 Redis 自动判断重写时机,减少运维人员手动操作;
- 手动触发:作为补充,用于以下场景:
- 高并发前:手动触发重写,将 AOF 文件缩小,避免高并发期间文件过大,同时避免自动触发重写;
- 自动重写失败后:排查原因,手动触发重写;
- 业务低峰期:手动触发重写,确保文件大小可控,避免文件持续增大;
- 生产搭配方案:
- 配置自动重写参数:auto-aof-rewrite-percentage 120、auto-aof-rewrite-min-size 256mb;
- 手动触发频率:每周 1 次,选择在凌晨 2~3 点(低峰期),手动执行 bgrewriteaof 命令;
- 高并发前(比如双 11 前 1 天):手动触发重写,确保文件大小最小,避免高并发期间自动触发。
-
问:重写后的 AOF 文件,和原 AOF 文件的格式一样吗?恢复时,有区别吗?
- 答:格式完全一样(都是 RESP 纯文本格式),恢复时没有任何区别,只是重写后的文件更简洁、命令更少;
- 详细解答:
- 格式一致性:重写后的 AOF 文件,依然是 Redis 支持的 RESP 纯文本格式,和原 AOF 文件的格式完全一致;Redis 重启时,加载重写后的文件,和加载原文件的流程完全一样,没有任何区别;
- 核心区别:重写后的文件,只包含 "恢复当前内存有效数据所必需的最简命令",去掉了所有冗余命令;原文件包含所有修改命令(包括冗余、无效、过期命令);
- 恢复速度区别:重写后的文件,命令数量极少,恢复速度大幅提升;原文件命令数量多,恢复速度慢;
- 案例:原 AOF 文件 80GB,包含 1 亿条命令,恢复需要 4 小时;重写后的文件 100MB,包含 10 万条最简命令,恢复只需要 30 秒;恢复后,内存中的数据完全一致,没有任何区别。
-
问:开启混合持久化(aof-use-rdb-preamble yes)后,会影响 AOF 重写吗?
- 答:不会影响,混合持久化和 AOF 重写是相辅相成的,开启混合持久化后,重写后的 AOF 文件,依然支持重写,且恢复速度更快;
- 详细解答:
- 混合持久化的作用:开启后,AOF 文件的前半段是 RDB 快照(二进制格式,恢复速度快),后半段是 AOF 增量命令(纯文本格式,安全);
- 对重写的影响:AOF 重写,依然会读取内存中的有效数据,生成最简命令,写入新的 AOF 文件;开启混合持久化后,重写后的新文件,依然是 "RDB 快照 + AOF 增量命令" 的格式,不会影响重写的流程和效果;
- 优势:开启混合持久化后,重写后的文件,恢复速度比未开启时更快(前半段 RDB 快照,几秒就能加载完成,后半段增量命令,执行时间也很短);
- 案例:某电商平台,开启混合持久化和 AOF 重写;重写后的 AOF 文件 150MB(前半段 140MB RDB 快照,后半段 10MB 增量命令);恢复时,加载 RDB 快照用了 2 秒,执行增量命令用了 10 秒,总共耗时 12 秒;未开启混合持久化时,恢复需要 30 秒。
第三章第三节 总结
核心总结
- 核心目的:AOF 重写的核心,是解决 "AOF 文件过大" 的问题,通过生成 "最简命令集" 的新文件,替换 "臃肿冗余" 的旧文件,节省硬盘空间、提升恢复速度、优化刷盘性能;
- 核心原理:不修改旧文件,后台线程读取内存有效数据 → 生成最简命令 → 写入临时文件 → 重写期间新命令双重写入(原文件 + 重写缓冲区) → 合并缓冲区命令 → 原子替换旧文件;
- 触发方式:两种方式结合使用 ------ 自动触发(日常维护,依赖两个核心参数)、手动触发(应急、补充,低峰期执行);
- 核心参数:
- auto-aof-rewrite-percentage:重写百分比阈值,默认 100%,推荐 100~150%;
- auto-aof-rewrite-min-size:重写最小文件大小,默认 64MB,推荐 128~256MB;
- aof-rewrite-incremental-fsync:重写期间增量刷盘,默认 yes,不要修改;
- 生产选型建议:
- 配置:auto-aof-rewrite-percentage 120% + auto-aof-rewrite-min-size 256mb + aof-rewrite-incremental-fsync yes;
- 触发:自动触发为主,每周低峰期手动触发 1 次,高并发期间临时禁用自动重写;
- 备份:开启重写的同时,每天备份 AOF 文件,重写完成后额外备份一次;
- 避坑关键(反复强调):
- 不频繁重写,不高并发期间重写;
- 重写前检查硬盘空间,确保空闲空间充足;
- 不关闭增量刷盘,不关闭 AOF 重写;
- 重写和备份缺一不可,不抱有侥幸心理;
结语
到这里,Redis 中 AOF 持久化的所有核心知识点,我们就从定义、配置、工作流程、核心机制、生产选型、避坑要点全维度讲透了,从零基础能看懂的通俗类比,到生产必落地的配置参数,再到线上踩坑的真实案例,全程零超纲、全实用,核心就是让你既能吃透 AOF 持久化的底层原理,又能直接落地到生产环境,避免踩坑丢数据。
回顾全篇,其实 AOF 持久化的核心逻辑很简单:本质就是用 **"只追加的纯文本命令日志"解决 RDB 定时快照的 数据丢失痛点 **,通过「命令写入缓冲区→按策略刷盘到硬盘→自动 / 手动重写压缩日志」的完整流程,实现了数据安全 和Redis 高性能 的平衡,这也是为什么它能成为生产环境中主力持久化方案 的根本原因。而我们通篇反复强调的 "生产铁律"------绝对不单独使用 RDB,AOF 为主、RDB 为辅,更是所有 Redis 持久化落地的核心准则,RDB 做冷备和主从同步,AOF 保障实时数据安全,两者搭配,才是生产数据安全的最优解。
这里再把生产落地的核心关键再提炼一遍,方便你贴在工位、记在配置文件里,一眼就能核对:
- 核心配置必落地 :开启 AOF(
appendonly yes)+ 刷盘策略选everysec(99% 场景万能选择)+ 开启混合持久化(aof-use-rdb-preamble yes)+ 重写参数配100~150% 百分比 + 128~256MB 最小阈值,这一套配置直接复制就能用,覆盖绝大多数生产业务; - 刷盘策略不踩坑 :极端核心零丢失场景(金融 / 支付)选
always,非核心临时数据选no,其余所有业务无脑选everysec,别为了极致性能丢安全,也别为了过度安全牺牲性能; - AOF 重写守底线 :不高并发期间重写、重写前查硬盘空间、不频繁重写、开启增量刷盘(
aof-rewrite-incremental-fsync yes),重写的核心是 "压缩文件",不是 "折腾 Redis",一切配置都以不影响业务、保障数据安全为前提; - 生产落地必配套 :做好 AOF 文件的异地备份 (每天备份 + 重写后额外备份),监控核心指标(
aof_fsync_status/aof_last_fsync/ 重写状态 / 硬盘空间),搭配主从架构,让从节点分担读压力和备份压力,主节点专注写入,从根本上提升 Redis 集群的稳定性。
其实 Redis 持久化是生产中数据安全的最后一道防线,而 AOF 作为这道防线的主力,看似只是几个配置参数、几个核心机制,却直接决定了线上 Redis 会不会丢数据、业务会不会因为宕机瘫痪。很多生产中的数据丢失事故,并不是因为原理有多复杂,而是因为运维人员忽略了基础配置 ------ 比如忘记开启 AOF、选错刷盘策略、重写参数配置不合理,最终导致 "裸奔" 运行,一次宕机就丢光数据。
所以不管是 Redis 新手还是老运维,对 AOF 持久化的学习,都要做到 **"原理吃透、配置配对、坑点记牢"**:新手照着本篇的生产配置直接落地,不用纠结细节,能保证线上稳定;老运维结合自身业务的并发量、数据安全等级微调参数(比如高写入业务调大重写最小阈值,低并发核心业务适当收紧重写百分比),让 AOF 持久化和业务完美匹配。
最后想说,Redis 的每一个核心特性,都是为了解决生产中的实际问题,AOF 持久化也不例外。吃透它,不是为了死记硬背知识点,而是为了让我们在生产中能 **"知其然,更知其所以然"**------ 遇到问题能快速排查,配置参数能精准选型,线上运行能稳如泰山,这才是学习技术的核心意义。
如果本篇内容对你有帮助,欢迎点赞、收藏,也欢迎在评论区交流你的生产落地经验、遇到的 AOF 踩坑问题,后续我们还会继续拆解 Redis 持久化的进阶知识点,比如AOF+RDB 混合持久化实战 、主从同步中的持久化配合策略 、线上持久化故障应急排查,带你把 Redis 数据安全的知识点学透、落地到底。
技术学习没有捷径,一步一个脚印,把基础打牢,生产才不会掉链子。我们下篇博客见~