基于概率消耗流的分布式集群拦截决策:从拦截概率先验到注水投影求解的完整实现
本文环境:Python 3.10 + NumPy 1.24 + SciPy 1.10 + scikit-learn 1.2,Ubuntu 22.04 验证通过,Windows 11 同样可运行。全文只讨论工程实现:防御无人机集群在只能看到局部态势、通信半径受限的条件下,如何协同分配拦截目标,并且避免"一窝蜂扑向同一个目标"。
一、问题背景:集群拦截为什么不能只按"谁近谁上"
在机场、电力设施、体育场馆、灾害应急空域这类民用场景里,非法入侵的低空小型无人机是真实存在的威胁。当来的是单机时,问题很简单:派一架防御机去拦就行。但当来的是十几架甚至几十架编队推进的集群,问题性质就变了------防御方手中的拦截资源是有限的、一次性的,每一架防御机只要完成一次物理拦截就随之消耗,不可能"拦完再拦"。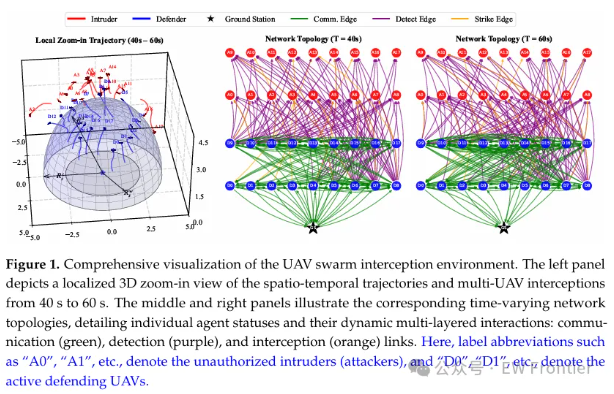
大多数入门实现会直接采用两类方法:
第一类是集中式分配。由一个中心节点掌握全局态势,统一求解一个分配矩阵再下发给各防御机。这类方法在仿真里效果往往不错,但它有两个致命前提:中心节点必须能实时掌握全局,且下行链路必须可靠。一旦通信被干扰或者中心节点本身被打击,整个防御体系当场失效。
第二类是局部贪心与拍卖式分配。局部贪心就是每架防御机选离自己最近的敌机;拍卖式的代表是 CBAA(Consensus-Based Auction Algorithm),每架防御机对目标"出价",价高者得,通过邻居之间的共识迭代消解冲突。这类方法通信开销小、鲁棒性好,但它们的代价函数几乎只有一个维度------距离。
只用距离做决策,会在工程上踩到四个坑:
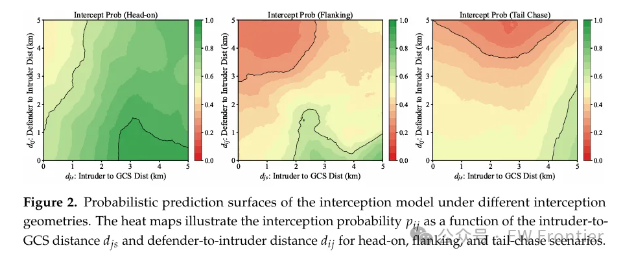
- 距离近不等于拦得住。 防御机与入侵机的相对距离只是几何关系的一部分,真正决定能否拦截的是交战几何:迎头拦截、侧向拦截、追尾拦截的成功率可以相差数倍。
- 入侵机的威胁程度随时间变化。 同样一架入侵机,距离保护中心 8 公里和距离 2 公里,威胁等级完全不同。把资源平均分配在"还早得很"的目标上,是典型的资源错配。
- 重复分配存在边际收益递减。 三架防御机同时扑向同一架入侵机,联合拦截概率并不是单机概率的简单相加,而是很快饱和。多出来的防御机等于被浪费。
- 拦截完成后资源会减少。 防御机拦截成功后自身消耗,原本分配给它的后续任务需要有人接盘,这个"转移代价"如果不进入决策,就会出现局部真空。
本文要拆解的这套框架,正是围绕这四个坑来设计的:用拦截概率先验 解决"拦不拦得住",用概率消耗流 解决"重复分配饱和与资源转移",用分布式市场共识 解决"只有局部态势怎么达成一致"。
二、整体框架:四层结构
整套实现可以切成四层,从上到下依次是:
决策层(2 Hz 低频)   分布式市场共识:目标分配与待命仲裁
        ↓
概率层(在线查表)     拦截概率先验查询 + 概率消耗流 + 二次转移代价
        ↓
规划层(中频)         从位置序列中选择最优机动动作
        ↓
控制层(10 Hz 高频)   双闭环轨迹跟踪,输出加速度与角速率指令
对应的调度逻辑是:每架防御机自身以 2 Hz 的频率做一次目标决策,以 10 Hz 的频率更新控制量,仿真步长 0.1 秒。三层的频率依次递增,是因为决策依赖态势融合的结果,规划依赖决策的输出,而控制必须足够快才能压住姿态误差。
这里先给一个结论性的设计取舍:决策层不追求全局最优,而追求局部可执行且不冲突 。因为分布式节点永远拿不到完整全局信息,任何"假装自己知道全局"的最优解在真实链路上都会退化。真正有价值的性质是单调性和一致性------局部信息越多,决策不劣化;邻居动作变化时,自己的选择不会剧烈震荡。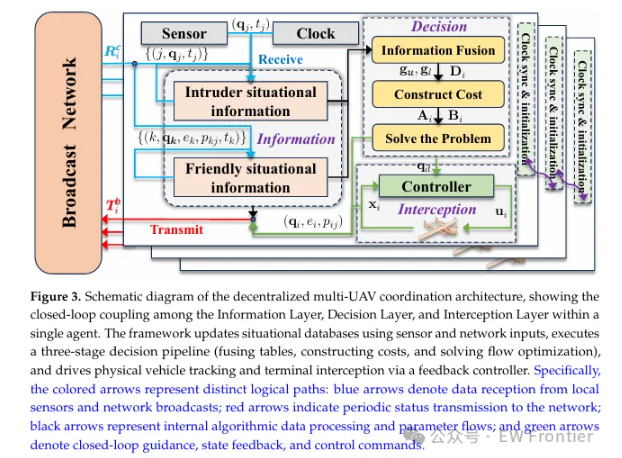
三、气动感知的固定翼模型与双闭环跟踪
要谈拦截概率,先得有一个可信的底层运动模型。项目采用六维状态、三维控制的固定翼质点模型:
状态量 x = [x, y, z, v, θ, ψ]
控制量 u = [a, θ̇, ψ̇]
其中 x, y, z 是 ENU 惯性系下的位置,v 是空速,θ 是航迹角(俯仰相关),ψ 是航向角。状态方程为:
ẋ = v·cosθ·cosψ
ẏ = v·cosθ·sinψ
ż = v·sinθ
v̇ = a − g·sinθ − ρ·v²
θ̇ = u₂
ψ̇ = u₃
注意 v̇ 这一项:它不是简单的 a,而是叠加了重力分量 −g·sinθ 和气动阻力 −ρ·v²。很多初学者写控制器时只用 a 输入,结果飞机爬升时掉速、俯冲时超速,本质就是漏掉了这两个前馈项。
控制输入必须做物理饱和,这是仿真能不能收敛的关键:
python
u[0] = np.clip(u[0], 0, self.a_max)          # 加速度上限 20 m/s²
u[1] = np.clip(u[1], -np.pi/4, np.pi/4)      # 俯仰角速率限幅
u[2] = np.clip(u[2], -np.pi/3, np.pi/3)      # 偏航角速率限幅
轨迹跟踪采用级联的双闭环结构。外环处理位置误差,把误差映射成一个速度修正量,再与期望速度合成:
python
# 外环:位置误差 -> 速度矢量修正
pos_error = pos_d - pos
error_vel = np.array([
    self.pid_x.update(pos_error[0], dt),
    self.pid_y.update(pos_error[1], dt),
    self.pid_z.update(pos_error[2], dt),
])
# 修正量限幅:不超过期望速度的 2.5 倍,防止大幅超调
max_norm = np.linalg.norm(vel_d) * 2.5
if np.linalg.norm(error_vel) > max_norm:
    error_vel = error_vel / np.linalg.norm(error_vel) * max_norm
vel_d = vel_d + error_vel
从修正后的速度矢量里反解出三个期望参考值------空速、航迹角、航向角:
python
v_d     = np.clip(np.linalg.norm(vel_d), 10, 90)                     # 空速限幅
theta_d = np.clip(np.arctan2(vel_d[2], np.linalg.norm(vel_d[0:2])),
                  -np.radians(45), np.radians(45))                   # 航迹角限幅
psi_d   = np.arctan2(vel_d[1], vel_d[0])                             # 航向角
内环分别跟踪这三个量,其中纵向通道做了反馈线性化补偿,把重力项和阻力项前馈回来:
python
error_v     = v_d - v
error_theta = np.unwrap([theta, theta_d])[1] - theta   # 角度解缠绕,防止跨 ±π 跳变
error_psi   = np.unwrap([psi, psi_d])[1] - psi

a_cmd         = self.pid_v.update(error_v, dt) + self.uav.g * np.sin(theta) + self.uav.rho * v**2
theta_dot_cmd = self.pid_theta.update(error_theta, dt)
psi_dot_cmd   = self.pid_psi.update(error_psi, dt)
这段代码里有三个容易被忽略但很关键的细节:角度误差必须用 np.unwrap 解缠绕,否则从 +179° 转到 −179° 时控制器会以为误差接近 360°;空速参考要做 [10, 90] 的硬限幅,否则外环在远距离时会要求一个物理上不可能的速度;修正速度限幅到 2.5 倍,是为了避免大误差下控制器输出饱和引起的持续振荡。
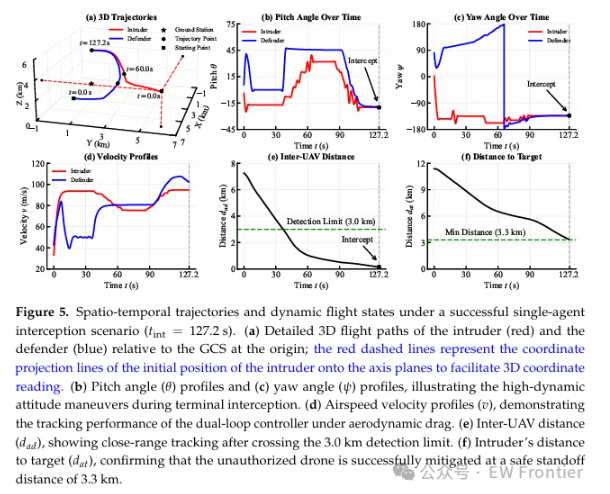
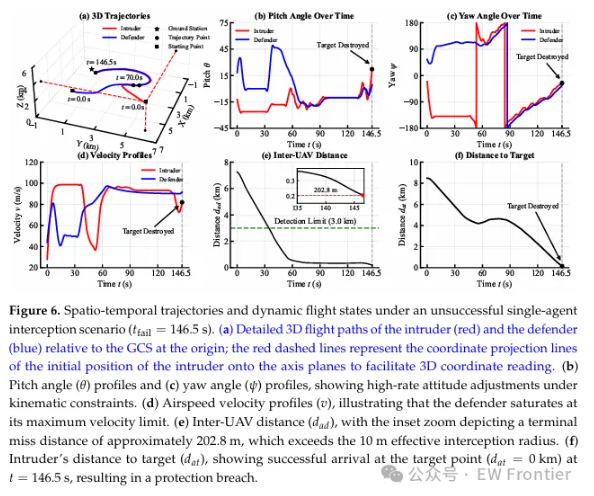
这一层的工程意义在于:拦截概率不是拍脑袋给的常数,而是这套闭环系统真实跑出来的结果 。后面训练概率模型时,样本就来自这套模型的仿真轨迹。
四、拦截概率先验:从单对单仿真到三维查找表
有了可信的运动模型,第一个核心问题就是:给定防御机 i 和入侵机 j 的当前几何关系,拦截成功的概率是多少?
如果直接在线计算,每架防御机每个决策周期都要跑一次闭环仿真,计算量完全不可接受。工程上的标准做法是离线学习、在线查表。
4.1 三个几何特征
描述一对拦截关系,特征不需要多,但要抓住物理本质。项目采用三个量:
d_js     入侵机到保护中心(地面站)的距离
d_ij     防御机到入侵机的距离
τ_ij 以入侵机为顶点,防御机-保护中心张开的夹角这三个量的物理含义很清晰:d_js 描述威胁的紧迫程度,越近越危险;d_ij 描述防御机能否及时赶到;τ_ij 描述交战的几何关系------τ 接近 0 意味着防御机正处在入侵机飞向保护中心的航路上,属于迎头拦截,成功率最高;τ 接近 π 意味着防御机在入侵机的尾部方向,属于追尾拦截,成功率最低。
4.2 数据采集:强制 1v1 的闭环仿真
为了保证样本"干净",采集阶段需要强制一对一配对:编号为 i 的防御机只拦截编号为 i 的入侵机,其余干扰全部屏蔽。采集流程是:
python
class Forced1v1DecisionMaker(BaseDecisionMaker):
    """强制 defender_i 只锁定 attacker_i,用于采集单对单数据"""
    def decide(self, t, my_state, friends, enemies, standby_pos):
        if not enemies:
            return None
        for e in enemies:
            e_idx = int(re.search(r'(\d+)', e.agent_id).group(1))
            if e_idx == self.my_idx:      # 只拦截和自己编号一致的敌机
                return e.agent_id
        return None
每架防御机、入侵机的位置随机化,运行若干轮 360 秒的仿真,然后按固定步长重采样轨迹点,逐点计算三个特征,并把该次交战的最终结局作为标签:
python
for step_idx in range(0, len(times), 10):     # 每 1 秒采一个点,降低冗余与末端偏倚
    if not a_log['alive'] or not d_log['alive']:
        continue
    if d_log['target_id'] != att_id:           # 尚未进入拦截逻辑的样本丢弃
        continue
    vec_e_to_me, vec_e_to_gs = my_pos - e_pos, gs_pos - e_pos
    d_me, d_gs = np.linalg.norm(vec_e_to_me), np.linalg.norm(vec_e_to_gs)
    cos_theta  = np.clip(np.dot(vec_e_to_me, vec_e_to_gs) / (d_me * d_gs), -1.0, 1.0)
    angle_rad  = np.arccos(cos_theta)
samples.append([d_gs, d_me, angle_rad, outcome])这里有两个采样细节值得说:一是按固定步长重采样 ,因为原始轨迹点在高频仿真下极其密集,且末端数据天然稀疏,不重采样会让模型被中间段样本淹没;二是必须过滤未进入拦截逻辑的样本,否则会出现"防御机还在巡航、什么都没发生"的假阴性样本,把标签污染掉。
4.3 为什么选 KNN 而不是神经网络
标签是 0/1 的"是否拦截成功",这本质上是一个概率回归问题。选 KNN 回归的理由很实际:在足够密集的样本点云上,KNN 等价于"查询点附近 k 个状态里成功拦截的比例",这恰好就是条件概率的局部频率估计,物理含义一目了然,不需要调一堆超参,也不会有神经网络的过拟合和不可解释问题。
python
k_neighbors = len(X) // 50          # 邻居数与样本量挂钩
knn_model = make_pipeline(
    StandardScaler(),
    KNeighborsRegressor(n_neighbors=k_neighbors, weights='uniform')
)
knn_model.fit(X, y)                 # X = [d_js, d_ij, angle], y = outcome
StandardScaler 是必须的:三个特征的量纲差了两个数量级(距离是千米级、角度是弧度级),不做标准化的话,距离维度会完全主导欧氏距离,角度特征形同虚设。
4.4 离线编译成查找表
KNN 在线推理要遍历样本算距离,样本量大时单次查询是毫秒级,而防御机的决策周期是 0.5 秒、还要遍历 30 个目标,累计开销不可接受。所以要把模型离线编译成规则网格:
python
d_js_grid  = np.linspace(0, 10000, 50)     # 入侵机到保护中心距离 50 格
d_ij_grid  = np.linspace(0, 10000, 50)     # 防御机到入侵机距离 50 格
angle_grid = np.linspace(0, np.pi, 20)     # 交战夹角 20 格

D_JS, D_IJ, ANGLE = np.meshgrid(d_js_grid, d_ij_grid, angle_grid, indexing='ij')
points = np.c_[D_JS.ravel(), D_IJ.ravel(), ANGLE.ravel()]
probs  = knn_model.predict(points).reshape(50, 50, 20)      # 一次性离线推理 5 万个网格点
运行时用三线性插值查询,单次开销降到微秒级:
python
class InterceptProbEstimator:
    def __init__(self, table_path):
        with open(table_path, "rb") as f:
            d_js_grid, d_ij_grid, angle_grid, probs = pickle.load(f)
        self.interpolator = RegularGridInterpolator(
            (d_js_grid, d_ij_grid, angle_grid), probs,
            bounds_error=False, fill_value=None      # 允许边缘外推
        )

    def predict(self, d_js, d_ij, angle_rad):
        angle_rad = abs(angle_rad)
        if angle_rad > np.pi:
            angle_rad = 2 * np.pi - angle_rad
        return float(self.interpolator((d_js, d_ij, angle_rad)))
最后一行做了夹角折叠,把 0, 2π 的夹角归一化到 0, π,因为几何上夹角的正负没有意义。这一层做完之后,每架防御机都能在微秒级拿到自己对任意可见目标的拦截概率 p_ij。
五、概率消耗流:解决"扎堆"与"资源转移"
拿到 p_ij 只是第一步。真正困难的是:当多架防御机同时看上一个目标时,怎么判断"该不该去"?
5.1 联合拦截概率与边际递减
多机协同拦截同一个目标 j 时,只要有一架成功就算整体成功,因此联合概率是:
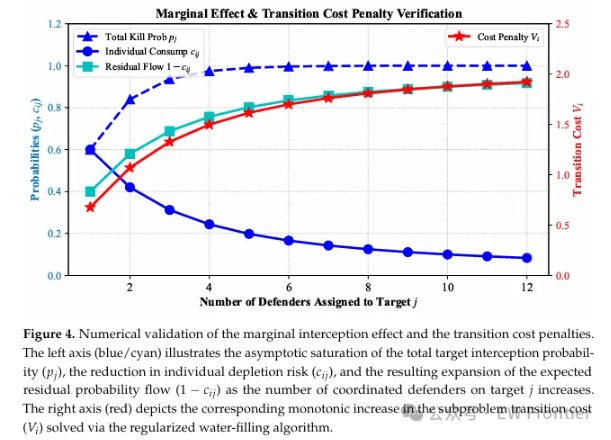
p_j = 1 − Π_i (1 − p_ij)^(m_ij)m_ij 表示防御机 i 是否被分配到目标 j。这个式子天然编码了边际收益递减:当第一架防御机的概率是 0.6 时,联合概率是 0.6;第二架带来 0.84;第三架 0.936;第四架 0.974。第四架防御机相比第三架只多贡献了不到 4 个百分点,但它的消耗是实打实的。
5.2 期望消耗与剩余流
既然多机分配,就要回答"哪架防御机实际承担了多少拦截任务"。项目采用按概率占比分摊的方式:
c_ij = (p_ij / Σ p_i'j) · p_jc_ij 就是防御机 i 在目标 j 上的期望消耗。它是拦截成功的期望"份额"。对应的剩余概率流 是 1 − c_ij:如果防御机 i 在目标 j 上只消耗了 0.6,那它还剩下 0.4 的概率流可以供给后续目标。
这个建模的巧妙之处在于,它把"一次性消耗的物理拦截资源"用一个连续的概率流来近似,使得后续的优化问题可以用凸优化的工具来解------而不是写成一个组合爆炸的整数分配问题。
5.3 二次转移流子问题
剩余流要分配到哪些后续目标?这构成了一个子问题:给定剩余流总量和到各候选目标的转移代价向量 C_i,求解最优分配 N_i:
min   <C_i, N_i> + (γ/2)·‖N_i‖²
s.t.  Σ_k n_ijk = 1 − c_ij
      0 ≤ n_ijk ≤ 1
目标函数第一项是线性转移代价,第二项是二次正则项 (γ/2)‖N‖²,γ 越大越倾向于把流"摊平"、避免集中。
这个问题的求解不需要通用二次规划求解器。由 KKT 条件可得,最优解的解析结构是:
N_i(λ) = clip( (λ − C_i) / γ, 0, 1 )也就是说,给定一个"水位" λ,每个分量的解就是 (λ − C_i)/γ 再截断到 0, 1。于是整个求解退化成一维搜索:二分 λ,使 Σ N_i(λ) 恰好等于剩余流。这就是经典的注水法(water-filling):
python
def solve_subproblem_V_i(residual_flow, C_i, gamma):
    """min <C_i,N> + (gamma/2)||N||^2  s.t. sum(N)=residual_flow, 0<=N<=1"""
    num_targets = len(C_i)
    residual_flow = np.clip(residual_flow, 0.0, num_targets)     # 容错:浮点截断误差

    if residual_flow == 0.0:
        return 0.0, np.zeros(num_targets)
    if residual_flow == num_targets:
        N_opt = np.ones(num_targets)
        return np.dot(C_i, N_opt) + (gamma / 2.0) * np.sum(N_opt ** 2), N_opt

    # KKT: C_i + gamma*N_i - lambda = 0  =>  N_i = clip((lambda - C_i)/gamma, 0, 1)
    lambda_low  = np.min(C_i)                 # 水位下限:流量刚好为 0
    lambda_high = np.max(C_i) + gamma         # 水位上限:流量刚好取满
    for _ in range(60):
        lambda_mid = (lambda_low + lambda_high) / 2.0
        N_mid = np.clip((lambda_mid - C_i) / gamma, 0.0, 1.0)
        if np.sum(N_mid) < residual_flow:
            lambda_low = lambda_mid
        else:
            lambda_high = lambda_mid

    lambda_opt = (lambda_low + lambda_high) / 2.0
    N_opt = np.clip((lambda_opt - C_i) / gamma, 0.0, 1.0)
    obj_val = np.dot(C_i, N_opt) + (gamma / 2.0) * np.sum(N_opt ** 2)
    return obj_val, N_opt
60 次二分对双精度浮点来说已经收敛到机器精度极限,而整个求解只是 60 次向量化的 clip 和求和,实测在毫秒以下。用通用 SLSQP 求解器当然也能得到同样结果,但单次调用就要几十毫秒,放进 2 Hz × 30 目标的决策循环里直接不可用------这是"根据问题结构手写解析解"比"调用通用求解器"更快也更稳的典型案例 。
5.4 边际效应的量化验证
这套建模是否真的实现了"抑制扎堆",可以用一个最小实验验证:固定单机拦截概率 h = 0.6,逐步增加分配到同一目标的防御机数量,观察联合概率、单机期望消耗、剩余流和转移代价的变化。
无人机数量 | 联合概率 p_j | 期望消耗 c_ij | 剩余流 1−c_ij | 转移代价 V_i
    1      |    0.6000    |    0.6000     |    0.4000     |    低
    2      |    0.8400    |    0.4200     |    0.5800     |    上升
    3      |    0.9360    |    0.3120     |    0.6880     |    继续上升
    4      |    0.9744    |    0.2436     |    0.7564     |    显著上升
... | 趋近 1 | 持续下降 | 持续上升 | 持续上升这张表就是整套机制的自证:随着扎堆的防御机数量增加,联合概率迅速饱和,单机期望消耗持续下降,剩余流不断上升,而转移代价随之上扬。转移代价放在决策代价函数里,就形成了一个自动的负反馈------越多人抢同一个目标,边际代价越高,后来者会自动转向其他目标。
六、分布式市场共识:只有局部态势时如何达成一致
前面几节都是"单机视角"的计算,最后一层要解决的问题是:没有任何一架防御机知道全局,如何让整个集群的分配不冲突?
6.1 带时间戳的局部态势表
每架防御机维护一张局部态势表,表项记录的是"我认为友机 f 正在打哪个目标、对那个目标的拦截概率是多少、它的通信/侦察半径多大、这条信息是什么时候的":
python
@dataclass
class Fsa:
    target: Optional[int]   # 友机当前锁定的目标编号,None 表示待命
    pj:     Optional[float] # 友机对该目标的拦截概率
    commr:  float           # 友机的通信半径
    deter:  float           # 友机的侦察半径
    ts:     float           # 信息时间戳
通信时只广播自己的态势表增量,接收方按时间戳合并,旧信息一律丢弃:
python
def receive(self, data):
    for fid, fsa in data['friends_sa'].items():
        existing = self.friends_sa.get(fid)
        if existing is None or fsa.ts > existing.ts:    # 时间戳新者胜,天然抗乱序
            self.friends_sa[fid] = fsa
这种"时间戳取胜"的合并规则有三个好处:不需要全局时钟同步、不需要可靠传输、天然抵抗消息乱序和重复。对分布式集群来说,这是成本最低的一致性机制。
6.2 信息融合:把邻居的概率累加起来
拿到邻居的态势后,先做两件事。第一件是把所有邻居对目标 j 的拦截概率累加,得到"已经在打 j 的友军概率总和":
python
g_p[fsa.target] += fsa.pj                                  # 概率线性累加
g_l[fsa.target] += np.log(1 - fsa.pj + 1e-9)               # 对数域累加,用于联合概率
这里用了一个小技巧:联合失败概率是各机失败概率的乘积,在数值上容易下溢,所以放到对数域做累加,需要时再取指数。第二件事是收集所有友军对目标 j 的代价,用于计算"准入门槛"。
6.3 准入门槛:用虚拟席位自动确定第 K 名
这是整套方法里设计感最强的一处。集群不应该让所有防御机挤向同一个高价值目标,所以需要给每个目标设一个拥塞门槛:只有当自己的代价明显低于门槛时,才允许"挤进去"。
门槛怎么定?直觉上应该是"当前争夺这个目标的所有友军中,第 K 名的代价"------因为前 K 名以内是合理负载,超出 K 名就应该被劝退。但分布式节点不知道全局排名。实现上用了一个很朴素的处理:把已经收集到的真实代价和 K 个虚拟的高代价席位(9999.0) 混在一起排序,取第 K 个作为门槛:
python
K = max(1, int(len(friends) / len(enemies) + 0.5))    # 自适应火力分配比例,四舍五入

for j in range(self.NUM_SLOTS + 1):
    all_bids = sorted(target_costs_pool[j] + [9999.0] * K)   # 混入 K 个虚拟高价席位
    L_i[j] = all_bids[K - 1]                                  # 排序后第 K 名即门槛
这样做的效果是:当某个目标的争夺者不足 K 个时,门槛会自动落到虚拟席位的高价上,等于"不设限";一旦争夺者超过 K 个,门槛就落在真实的第 K 名代价上,后来者只要代价高于它就会被劝退。用 K 个虚拟席位替代了全局排序,把一个需要全局信息的判断,简化成了一次局部排序。
6.4 评估代价函数:三项加权
最后,每架防御机对每个可见目标(外加一个"待命"选项)计算评估代价:
python
# 直接代价:到目标的距离
term1 = W_i[j]

# 拥塞代价:只有当自己代价高于门槛时才生效(ReLU 形式)
term2 = self.parm["lambda_lf"] * (W_i[j] - L_i[j] + abs(W_i[j] - L_i[j]))

# 转移代价:剩余流分配的最优值 + 二次正则
term3 = np.dot(C_i[j, :], n_row) + (self.parm["gamma"] / 2.0) * np.sum(n_row ** 2)

eval_cost = term1 + term2 + term3三项分别对应三种控制意图:term1 让防御机就近拦截,减少飞行时间 term2 抑制过度集中(x + |x| 是 ReLU 的写法,x > 0 时取 2x,否则为 0,即只有"超出门槛"才受罚);term3 把"拦完之后剩余资源去哪"的代价提前算进当前决策。求最小代价的目标,若最小的是"待命"选项,则返回轨道驻留位置。
6.5 决策主循环
把上面的环节串起来,单机的决策伪代码是:
输入: 自身状态、局部友军态势表、局部敌军列表、待命位置
1. 自适应比例 K ← max(1, round(友军数 / 敌军数))
2. 遍历友军态势表:
     g_p[j] += pj                       # 概率累加
     g_l[j] += log(1 - pj)              # 对数域累加
     pool[j].append(代价)                # 收集代价
3. 计算门槛 L_i[j] ← 混入 K 个虚拟席位后的第 K 名代价
4. 对每个可见目标 j:
     P_i[j]      ← 查找表查询拦截概率(含夹角折叠与截断到 [0.01, 0.99])
     W_i[j]      ← λ_a1 × 0.001 × d_ij
     C_i[j, :]   ← λ_b1 × 0.001 × 目标间距离
     s_val       ← 自身概率占比 × 联合成功概率
     n_row       ← 注水投影(1 − s_val, C_i[j,:], γ)
     eval_cost   ← term1 + term2 + term3
5. 取评估代价最小的目标;若为"待命"则返回 None
6. 更新本机态势表项(目标编号、拦截概率、时间戳),供邻居合并注意最后一步会把自己的选择写进态势表并广播出去。下一轮决策时,邻居的态势表里就有了这条信息,g_p、g_l 和门槛都会随之更新。整个集群就是通过这种**"各自决策 → 广播结果 → 邻居合并 → 重新决策"**的迭代,在没有任何中心节点的情况下逐步收敛到互不冲突的分配。
七、参数说明与调参思路
决策器暴露的主要参数有五个,含义和调参方向如下:
| 参数 | 含义 | 调大 | 调小 |
|---|---|---|---|
lambda_a1 |
直接距离代价权重 | 更保守,优先就近拦截 | 更激进,愿意远程奔袭 |
lambda_b1 |
目标间转移代价权重 | 更重视拦截后的资源接续 | 更关注当前一击 |
lambda_lf |
拥塞惩罚权重 | 强烈抑制扎堆 | 弱化成近似纯贪心 |
gamma |
二次正则系数 | 剩余流更摊平,分散转移 | 转移更集中于低代价目标 |
by_b |
待命基准代价 | 更倾向驻留待命、保存实力 | 更倾向主动出击 |
调参经验上,lambda_lf 是影响最大的一个:它直接决定"允许多少架防御机打同一个目标"。调得太小,集群会像纯贪心一样扎堆;调得太大,会出现大量防御机宁可待命也不出击、导致漏防。实践中建议先固定 lambda_a1 和 by_b,再用贝叶斯式搜索扫 lambda_lf 和 gamma。
参数还可以通过环境变量注入,方便批量实验:
python
if "DDFO_OPT_PARAMS" in os.environ:
    opt_params = json.loads(os.environ["DDFO_OPT_PARAMS"])
    self.parm.update(opt_params)
八、踩坑记录
坑一:拦截半径和仿真时长必须与结论对齐。 论文实验配置与示例脚本的默认值并不完全一致,例如拦截判定半径、仿真时长(250 秒 vs 100 秒)、默认决策算法(DFMC vs CBAA)都可能有差异。拿着示例脚本跑出来的数字去核对论文表格,几乎一定对不上。结论只能和产生它的那套配置绑定,跨配置比较是没有意义的。
坑二:随机种子不固定。 场景初始化、决策时刻的抖动、目标点采样都用了随机数。不固定种子的话,同一套算法两次运行的拦截数可能差出一架以上,看起来像"算法不稳定",其实只是采样噪声。任何对比实验都应该报均值和标准差,而不是单次结果。
坑三:概率模型的外推风险。 查找表在 fill_value=None 下允许外推,这意味着超出训练数据覆盖范围的查询点会得到一个由边缘值延伸出来的概率。如果目标距离远超训练时的采样范围,这个概率并不可信。工程上应该在查询前做范围检查,超界时退化为一个保守常数。
坑四:独立成功假设。 联合概率公式隐含了"各防御机的拦截事件相互独立"。这在仿真里成立,但在真实场景中,多机共同机动、共享的感知误差、气动耦合都会引入相关性,实际联合概率会低于公式给出的值。这套框架给出的是乐观上界,不是精确预测。
坑五:模型文件的安全性。 概率模型和查找表都是序列化对象,加载时可能执行任意代码。生产环境应该换成安全的、经过校验的数据格式,至少要做哈希校验并限定来源。
坑六:角度处理。 夹角在几何上是对称的,但原始计算会落在 0, 2π。如果不在查询前折叠到 0, π,同一个几何关系会因为正负号不同查到两个不同的概率值,表现为"决策结果来回抖"。
九、结果对比
在同等仿真配置下,三类分配策略的表现大致如下(数据为多次运行的均值与标准差):
| 方法 | 平均拦截入侵机数量 | 平均每智能体每决策周期耗时 |
|---|---|---|
| 分布式拍卖(CBAA) | 9.762 ± 1.137 | 4.109 ± 0.134 ms |
| 改进拍卖(MTCBAA) | 10.254 ± 1.208 | 4.514 ± 0.109 ms |
| 概率流共识(本文框架) | 10.698 ± 1.190 | 4.967 ± 0.173 ms |
几点解读:
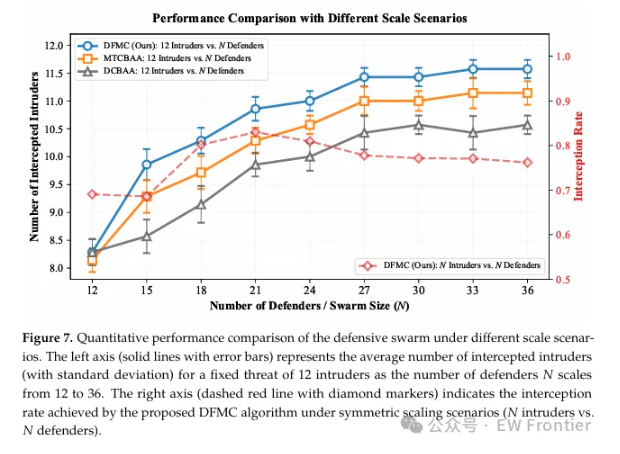
- 拦截数量上,概率流框架相对基础拍卖提升约 9.6%,相对改进拍卖提升约 4.3%。提升幅度不是数量级的,这符合预期------分配策略只能优化"资源怎么用",不能突破物理拦截能力的上限。
- 单次决策耗时从 4.1 ms 上升到 5.0 ms,增加了约 21%。这是"多算一点概率和转移代价"换来的代价,相对于 500 ms 的决策周期,占比不到 1%,完全可以接受。
- 规模同步增大时,概率流框架的拦截率保持相对稳定,而纯距离方法会随着集群规模上升而明显退化。原因在于后者缺乏抑制扎堆的机制,规模越大、重复分配的浪费越严重。
十、局限与适用边界
这套实现有明确的适用边界,写在这里是为了避免误用:
- 适用对象是低空、低至中等速度的旋翼或轻型固定翼无人机,不适用于高速巡航导弹、弹道目标等超出该类无人机动力学能力的目标。
- 运动模型和控制器都是简化模型,不能替代真实飞控、避障与通信协议栈。
- 概率先验依赖训练数据的覆盖范围,超出分布的外推结论需要谨慎解释。
- 通信与态势融合是软件层面的抽象,不等价于真实无线链路(没有考虑丢包、时延抖动、多径)。
- 没有硬件在环、实机飞行或真实传感器验证。
- 仿真步频 10 Hz、决策频率 2 Hz 是论文设定,实际系统若降低频率,需重新评估收敛性。
责任使用声明: 本文涉及的方法仅用于民用关键基础设施保护研究、未授权无人机入侵的仿真分析,以及多无人机协同、分布式优化与控制算法研究。未经充分安全验证,不应将任何结论直接用于真实世界的自动拦截系统。使用者应遵守适用的法律法规与空域管理要求。
十一、小结
这篇文章完整走了一遍"从几何特征到分布式决策"的实现链路,核心可以归纳成四句话:
- 用闭环仿真的数据 训练拦截概率先验,再用查找表 + 插值把在线开销压到微秒级------这是"离线学习、在线查表"的标准范式。
- 用联合概率 + 期望消耗 + 剩余流把一次性消耗的物理拦截建模成连续概率流,让"扎堆饱和"这个定性问题变成可以量化的代价项。
- 用KKT 解析结构 + 二分注水把带约束的二次子问题从"调用通用求解器"变成"60 次向量化操作"------识别问题结构比选求解器更重要。
- 用带时间戳的态势表 + 虚拟席位门槛在没有中心节点、没有全局信息的前提下达成分配一致。
真正值得迁移的经验不是这几个公式,而是这套设计思路:先把物理过程建模成可微、可优化的形式,再用问题结构去换计算效率,最后用局部信息 + 时间戳换取分布式一致性。
参考文献
1 面向集群对集群拦截的分布式协同主动区域防御概率流框架相关研究(2026 年)。
2 Choi H L, Brunet L, How J P. Consensus-based decentralized auctions for robust task allocation. IEEE Transactions on Robotics, 2009.
3 Boyd S, Vandenberghe L. Convex Optimization. Cambridge University Press, 2004.(注水法与该二次子问题的 KKT 结构)
4 Altman E. Constrained Markov Decision Processes. Chapman and Hall/CRC, 1999.(约束优化与流平衡建模)