(1)大语言模型:符号空间中的统计自洽
在计算语言学中,语言模型被严格定义为"对词序列概率分布进行建模的计算模型"(Jurafsky & Martin, 2023),即给定一个符号序列的前缀,预测下一个符号的条件概率。
以GPT-4、Claude、Llama 等为代表的大语言模型,利用Transformer 架构,将这一传统定义推向了极致。Transformer 的核心是自注意力机制,允许序列中的每一个位置直接关注上下文的所有其他位置,从而捕获长距离的语义依赖。在训练过程中,文本经过分词器被切分为Token 序列,每个Token 被映射为高维向量空间中的嵌入向量,并叠加位置编码以保留序列顺序信息。随后,多层Transformer 块对这些向量表示进行迭代变换,最终在输出层产生下一个Token 的概率分布。
当前主流的大语言模型大多采用Decoder-only 架构,以自回归方式逐Token 生成文本。这一架构的重要前提是,语言可以被线性化为离散符号的序列,语义在向量空间中被几何关系所近似。然而,语义向量空间的维度是有限的,通常为数百至数千维,其承载的语义结构完全由训练语料的统计分布所决定。
当模型生成文本时,它在做的本质上是在已有语料的概率分布中进行采样和组合。这是一种统计自洽,由人类主观感受对其正确性进行判断,比如流畅度、连贯性、逻辑性等。因此,即使在几乎没有物理世界标注数据的情况下,大语言模型也能通过海量互联网文本语料达到人类语言组织水平。
(2)视觉生成模型:像素空间中的视觉逼真
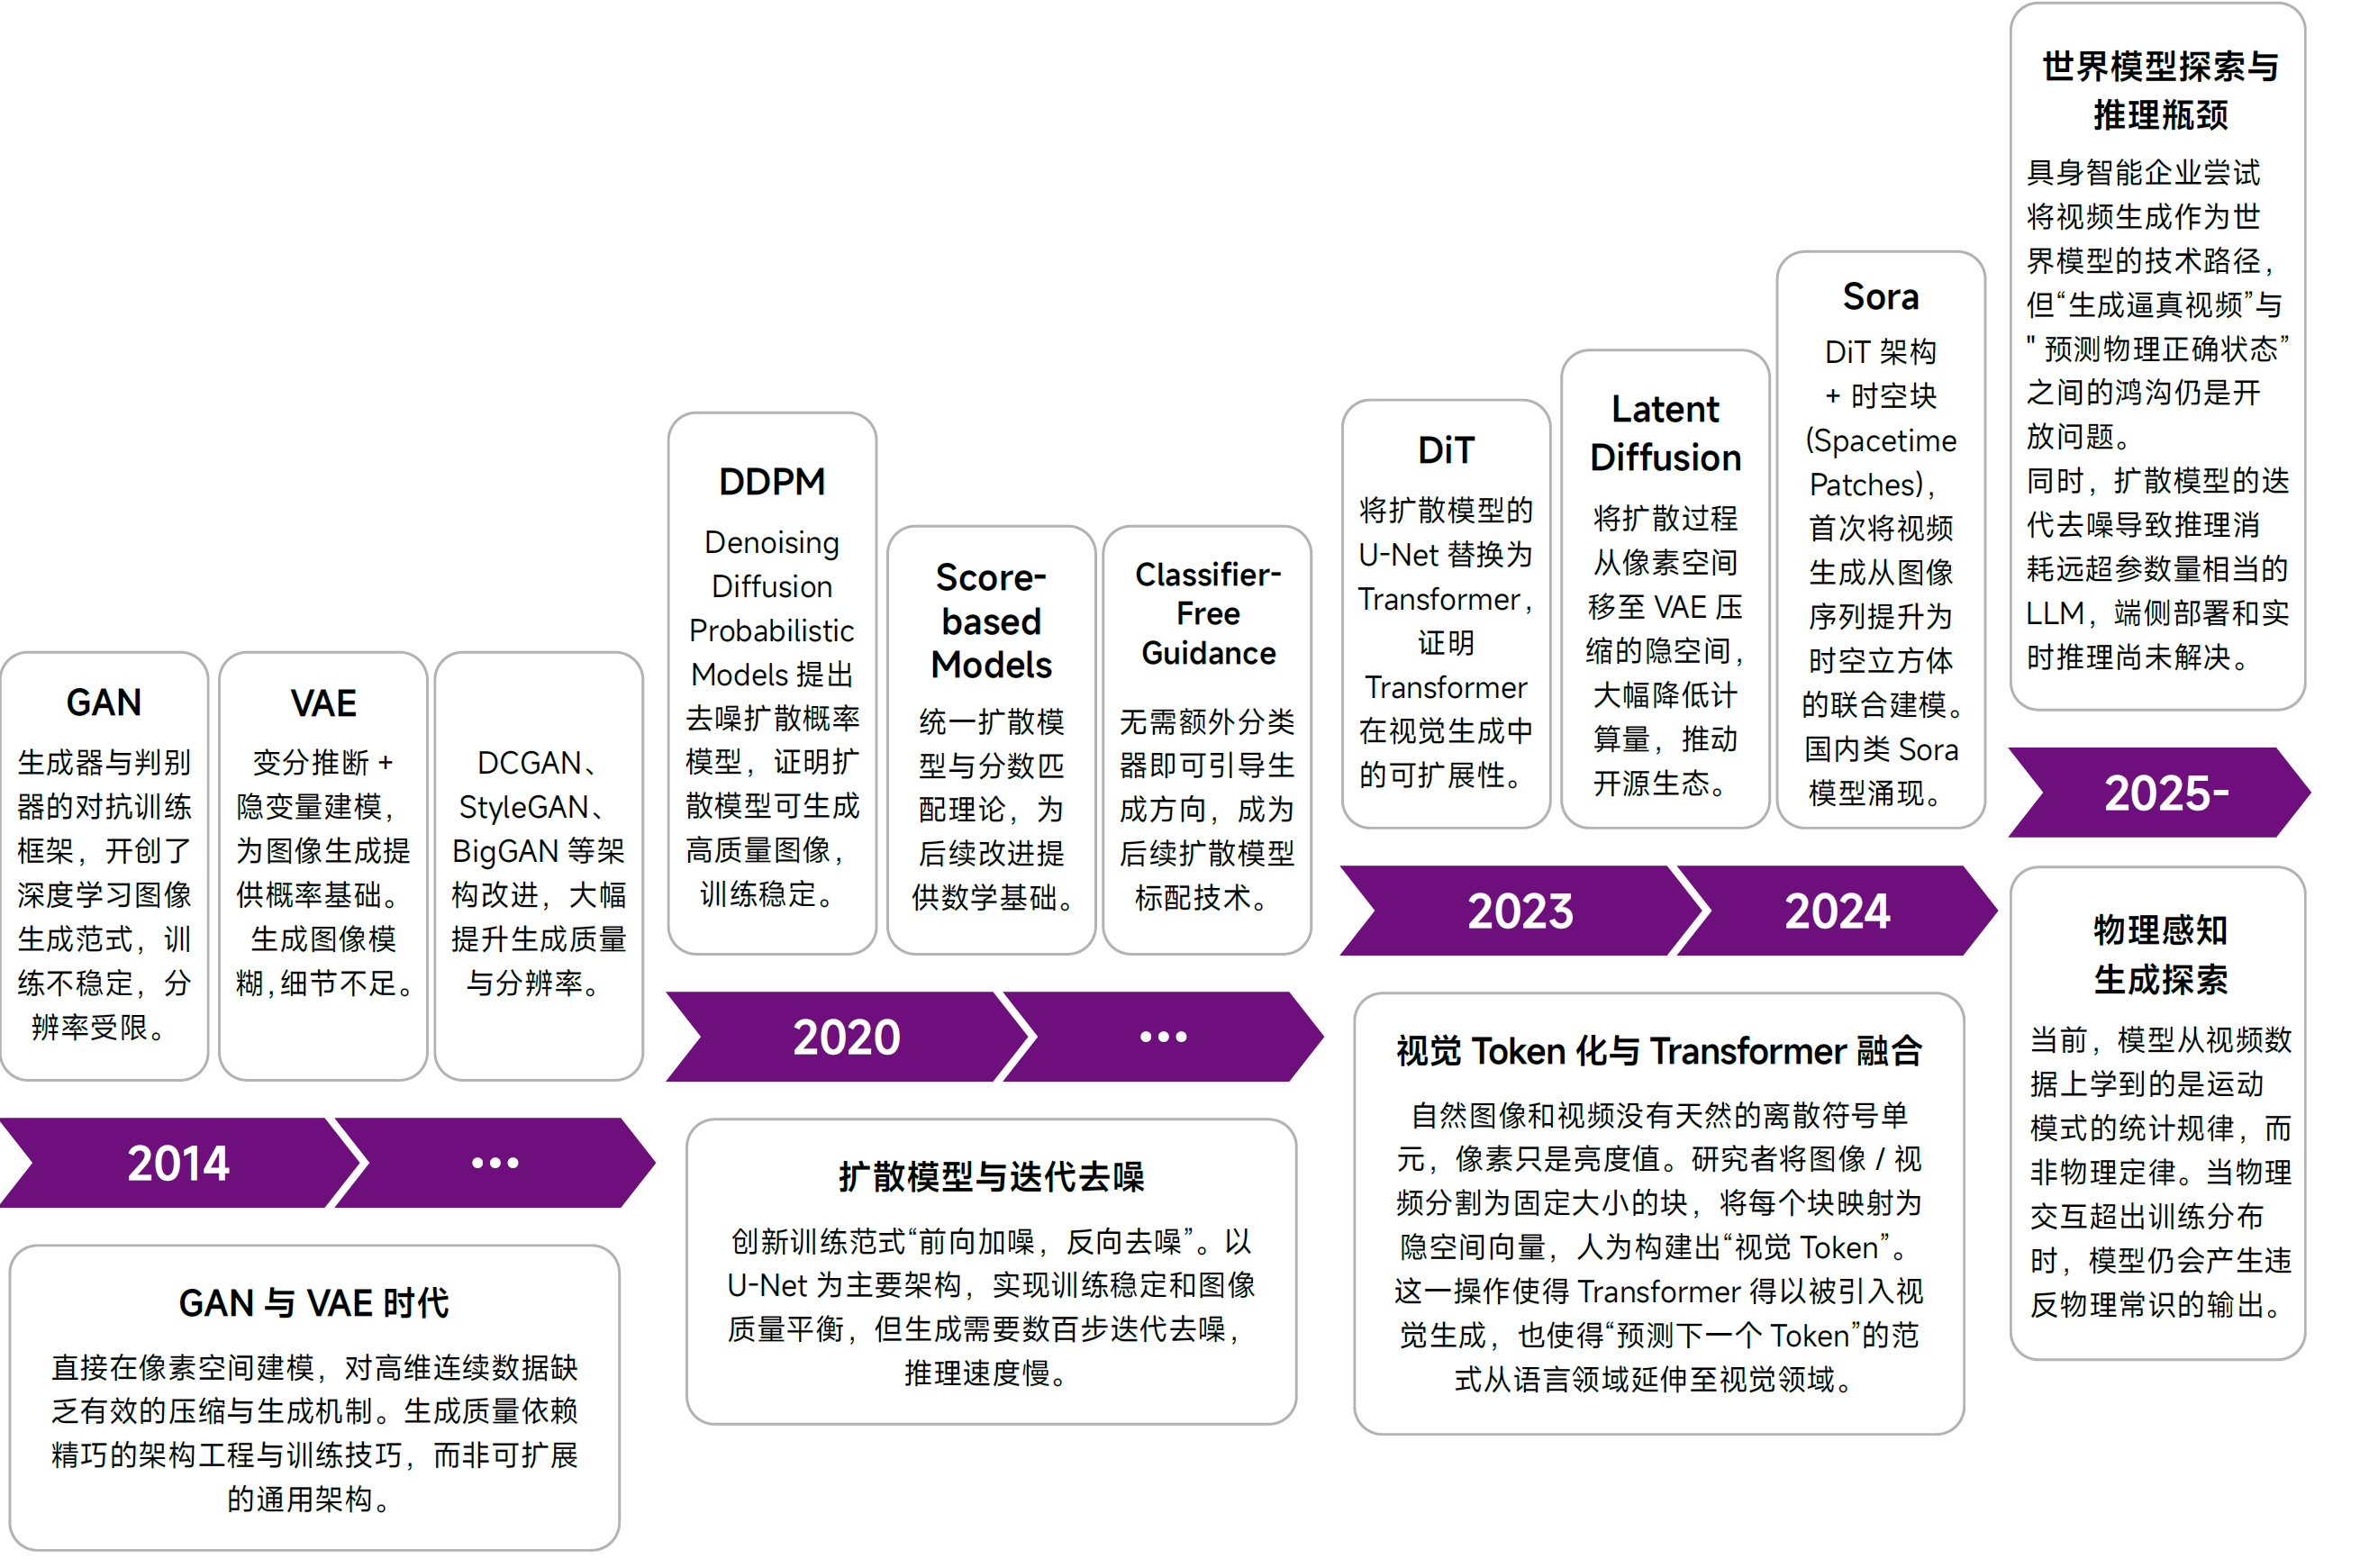
视觉生成模型在技术范式上与语言模型一脉相承,但其发展路径更为曲折。从早期的生成对抗网络(GAN,Goodfellow et al.,2014) 和变分自编码器(VAE,Kingma & Welling,2014), 到后来的扩散模型(Diffusion Model),再到与Transformer 架构实现深度融合的DiT 架构,视觉生成逐渐实现了视觉生成从二维单帧走向时空联合建模的质变。
自然图像和视频没有离散的符号单元,"视觉Token 化"过程,是视觉生成模型从像素空间进入特征空间的关键一步。2024 年,Sora 开创性地将视频数据压缩为低维隐空间表征,再分割为时空块(Spacetime Patches),使用Transformer 在这些视觉Token 上执行去噪任务。为了将Transformer 引入视觉生成,研究者将图像划分为固定大小的块,将每个块映射为高维隐空间中的向量,从而人为构建出一个"视觉词表"。在这个隐空间中,模型遵循着与语言模型极为相似的自监督逻辑,给定被噪声破坏的视觉Token 序列,预测原始干净的Token。