本文是「Java + Python 全栈学习」系列第 12 篇。索引是数据库面试的绝对高地,但绝大多数人八股背了一堆(回表、最左前缀、覆盖索引......),却从没把这些概念挂到同一个结构上。这篇就用 B+ 树这一个数据结构,把所有索引"玄学"一次性串成因果链。
一、先建立直觉:为什么数据库不用别的结构
索引的本质就一句话:用额外的存储空间 + 写入时的维护成本,换取读取时的查找加速。关键问题是:选什么数据结构?
逐个排除,推理自然浮现:
| 候选结构 | 查找效率 | 致命缺陷 |
|---|---|---|
| 有序数组 | O(log n) 二分 | 插入要整体挪动,写入密集的数据库直接出局 |
| 哈希表 | O(1) 完美 | 只支持等值查询 ,范围查询(WHERE age > 18)、排序全废 |
| 二叉搜索树 | O(log n) | 树高由数据量决定:100 万行的树高约 20 层 = 一次查询 20 次磁盘 IO |
| B+ 树 | O(log n) 但树极矮 | ------ 胜出 |
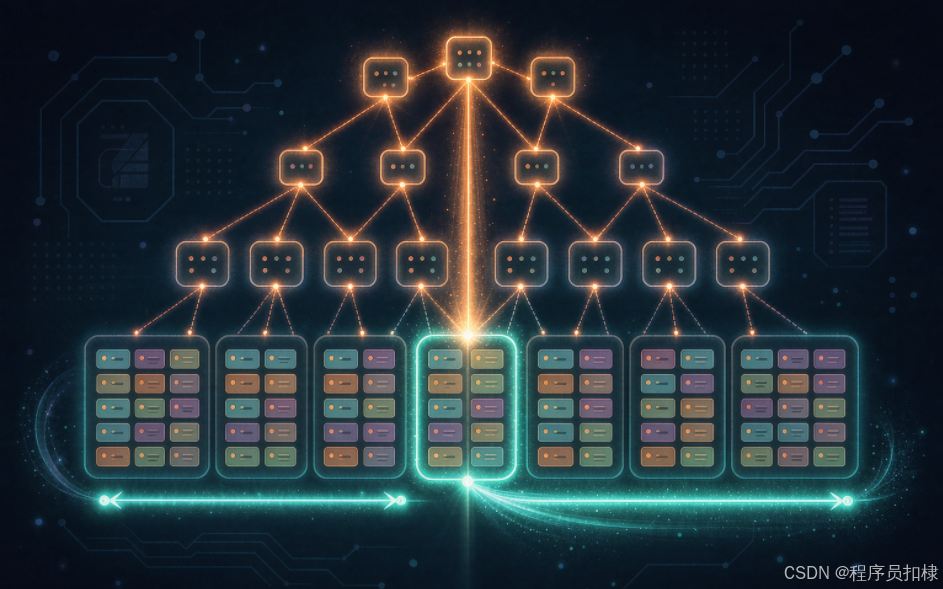
B+ 树胜出的核心是为磁盘而生 的矮胖结构:每个节点是一个"页"(MySQL 默认 16KB),一次磁盘 IO 读回一大坨数据。10 亿行的表,B+ 树高度通常只有 3~4 层------一次主键查询最多 3~4 次磁盘 IO。树高每降一层,等于全体查询少一次磁盘往返,这就是 B+ 树设计的一切动机。
再记住 B+ 树的两个关键细节,后面所有推理都靠它们:
- 非叶子节点只存"路标"(键),不存数据------路标占空间小,一页能塞几百上千个,扇出极大,树因此矮;
- 数据全在叶子层,且叶子节点之间有双向链表相连------这根链表是范围查询的胜负手。
二、聚簇索引 vs 二级索引:MySQL 表的"双系统"
InnoDB 表本身就是一棵按主键组织的 B+ 树(聚簇索引 )------"表即索引,索引即表",数据行就挂在主键树的叶子上。
那二级索引(你自己建的普通索引)呢?它是另一棵独立的 B+ 树,但叶子上不存整行数据,只存"索引列 + 主键值":
聚簇索引(主键树)            二级索引 name 上的树
30:[完整行数据]               '张三' → 主键 30
  /      \                    '李四' → 主键 17
20:[行]   40:[行]             (叶子间双向链表)
于是查询 SELECT * FROM user WHERE name = '张三' 的完整旅程:
在 name 索引树查到 '张三' → 主键 30
  → 拿着 30 回聚簇索引树再查一遍 → 找到完整行
↑ 这个"再查一遍"就是大名鼎鼎的"回表"回表是额外的一次树查找。优化器极不喜欢它,于是有了下面的连锁概念。
三、四大高频概念:一条因果链串起来
3.1 覆盖索引:让回表彻底消失
sql
SELECT id, name FROM user WHERE name = '张三';要查的字段(id, name)在 name 索引树的叶子上全都有 (别忘了二级索引叶子天然带主键)------根本不需要回表,直接返回。这就是覆盖索引 ,执行计划的 Extra 列会骄傲地显示 Using index。
工程启示:高频查询可以专门设计"窄索引"喂饱它 。比如订单列表只显示"订单号+金额",建 (order_no, amount) 联合索引即可全程覆盖。这也是"不建议 SELECT *"的第一层理由:选的列越多,覆盖索引越难成立,回表越频繁。
3.2 最左前缀原则:联合索引的"字典排序"
联合索引 (a, b, c) 的本质:先按 a 排序,a 相同再按 b 排序,b 相同再按 c 排序------和字典里先按第一个字母排是同一个逻辑。由此可以直接推导出哪些查询能用上它:
sql
-- 能用(前缀连续)
WHERE a = 1                       ✅ 定位到 a=1 的连续区段
WHERE a = 1 AND b = 2             ✅ 在 a=1 内部继续按 b 收窄
WHERE a = 1 AND b = 2 AND c = 3   ✅
WHERE a = 1 AND c = 3             ⚠️ 只用到 a(c 在 b 缺席时是"乱序"的,无法二分)

-- 不能用(前缀断了)
WHERE b = 2                       ❌ 整棵树对 b 整体无序------这就是标题问题的答案
WHERE b = 2 AND c = 3 ❌ 同理想象一本按"姓氏笔画排、同姓再按名字排"的电话簿:你知道名"伟"但不知道姓,只能一页页翻------因为"伟"们散落在整本簿子的各个姓氏分节里。联合索引对跳过前导列的查询失效,原理一模一样。
范围查询是隐形杀手:
sql
WHERE a = 1 AND b > 5 AND c = 3
-- a 能精确定位,b 能走范围,但 c 用不上了!
-- (b > 5 的区段内,c 是乱序的)由此得出建索引的经典准则:等值条件的列放前面,范围条件的列放最后。
3.3 索引下推(ICP):5.6 之后的小优化
sql
WHERE a = 1 AND c = 3 -- 索引 (a,b,c)没有 ICP:引擎定位 a=1 区段 → 逐条回表 → Server 层再过滤 c=3(回表 100 次可能只剩 3 条有效)。
有 ICP:引擎在索引层先过滤 c=3 再回表 (回表 3 次)。Extra 显示 Using index condition。它不改变"用不到 c 排序"的本质,但大幅减少回表次数------理解它只需要记住一句话:能在索引层提前过滤的,绝不拖到回表之后。
3.4 为什么推荐自增主键:插入的"顺序之美"
聚簇索引的叶子按主键物理有序。对比两种主键:
- 自增主键 :每次插入永远是最大值,追加到最右叶子,页写满了开新页,旧页安详稳定;
- 随机主键 (UUID/雪花不当时):每次插入落在树的随机位置,引发页分裂------目标页满了,申请新页并搬迁一半数据,还留下碎片。写放大、缓存命中率同时恶化。
另一个理由呼应 3.1:所有二级索引的叶子都存主键值,主键越窄(bigint 8 字节 vs UUID 36 字符),所有索引都跟着瘦身。
手机业务里的反例 :订单号这种"业务含义主键"看似直观,一旦未来要换号(业务合并、系统迁移)就是灾难。业务键做唯一索引、代理键(自增/雪花)做主键,是更稳妥的分层。
四、事务与隔离级别:MVCC 的两分钟版
索引之外,另一块面试高地是事务。ACID 中最反直觉的是隔离性并不非黑即白:
| 隔离级别 | 脏读 | 不可重复读 | 幻读 | 实现代价 |
|---|---|---|---|---|
| READ UNCOMMITTED | 会 | 会 | 会 | 几乎无 |
| READ COMMITTED | 不 | 会 | 会 | 行级 |
| REPEATABLE READ(InnoDB 默认) | 不 | 不 | 基本不会 | 行级+间隙锁 |
| SERIALIZABLE | 不 | 不 | 不 | 排队执行,性能崩 |
InnoDB 默认 RR 且用 **MVCC(多版本并发控制)**实现读不加锁:每行隐藏两个版本列,读时按"事务快照"决定看哪个版本------读旧版本、写新版本,读写互不阻塞。这是"并发性能"与"数据一致"之间的精妙平衡,也是 1.5-05 分布式事务篇的思想前菜(数据库内部先打了个样:强一致是可以通过版本协调"绕"开的)。
五、动手:用 EXPLAIN 给 SQL 做"CT"
一切索引知识最终落到一个工具------EXPLAIN。建表插数据后跑:
sql
EXPLAIN SELECT * FROM t_order WHERE user_id = 42;

-- 盯住三个关键列:
-- type   :ref(走了普通索引,好)/ range(范围扫,可接受)
--          index(扫整棵索引树,差)/ ALL(全表扫,红灯)
-- key    :实际用到的索引(为 NULL 就是全表扫)
-- rows   :预估扫描行数(数量级比精确值更重要)
-- Extra  :Using index(覆盖索引,好)
--          Using filesort(排序没吃到索引,待优化)
--          Using temporary(用了临时表,多发生在 group by/distinct)
实操路线 :找一条你项目里的慢 SQL(或随便 SELECT SLEEP(2) 造一条),EXPLAIN 一下,按"type 差 → 补索引;filesort → 排序列进联合索引;回表多 → 考虑覆盖索引"的决策树优化。走完这一轮,本篇知识才算落袋。
六、常见误区清单
- "索引越多越好"------每个索引都是一棵要维护的 B+ 树,写入时全部同步更新;索引还会挤占 Buffer Pool。经验值:单表 5 个以内为宜,且尽量复用联合索引;
- "WHERE 里函数包住索引列没关系" ------
WHERE DATE(create_time) = '2026-09-07'让索引失效(树按原始值排序,函数加工后无序)。改写成范围条件:create_time >= '2026-09-07' AND create_time < '2026-09-08'; - "SELECT * 无所谓"------破坏覆盖索引、拉宽网络传输、还给 binlog/临时表加压;
- "分页深了加 LIMIT 就行" ------
LIMIT 1000000, 10要扫过前 100 万行再丢弃。经典解法是游标分页 (WHERE id > 上次最大id LIMIT 10)。
七、小结
| 问题 | 答案 |
|---|---|
| 为什么是 B+ 树? | 矮胖+大扇出+叶子链表:磁盘 IO 次数与范围查询双优 |
| 聚簇 vs 二级? | 表即主键树;二级索引叶子存"索引列+主键",查完要回表 |
| 最左前缀的本质? | 联合索引 = 多列字典序;前缀断了,后续列在剩余区段内无序 |
| 覆盖索引? | 查的列全在索引树上,回表消失(Extra: Using index) |
| 自增主键的理? | 追加写入不页分裂 + 主键窄使所有二级索引瘦身 |
| EXPLAIN 三件套? | type 定优劣、rows 定代价、Extra 定隐藏动作 |
下一篇继续数据库主题的下半场:数据库设计与 SQL 优化实战------范式什么时候该违反?慢 SQL 定位的完整武器库是什么?什么情况才真的需要分库分表?
本篇思考题: 拿你项目里最复杂的一条 SQL 跑一下 EXPLAIN,type 和 Extra 各是什么?按本篇的决策树,它有优化空间吗?(评论区贴执行计划,我来帮你读。)
上篇回顾: Java全栈实战 \| 1.3-02 JDBC 本质:MyBatis 框架诞生前,Java 程序员每天在重复什么苦役
------ 完 ------