AiBrainBox-UGV 的目标跟踪从“传统视觉跟踪”升级为“语义目标跟踪”

AiBrainBox-UGV 的目标跟踪从"传统视觉跟踪"升级为"语义目标跟踪"
关键边界:

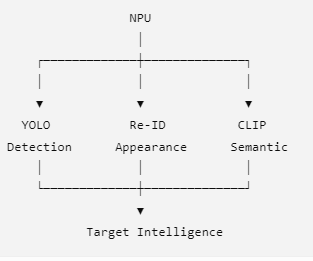
不要让 CLIP 直接承担实时跟踪,而应该让 CLIP 成为 Tracking Engine 的"语义认知层",与检测、Re-ID、运动模型、LiDAR/UWB共同参与目标关联。

通用 Human Target Tracking Engine 的方向

CLIP最擅长的是:

图像 ↔ 文本语义空间对齐

而不是:

每帧进行复杂的空间推理、轨迹预测。
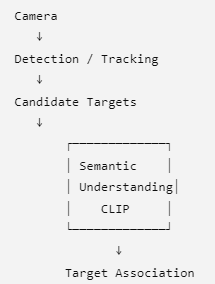
CLIP是"认知辅助",不是"运动跟踪核心"。
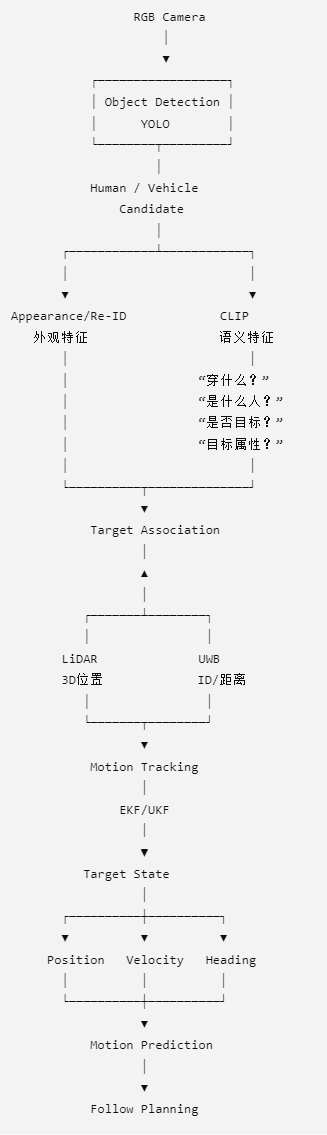
这个架构比单纯的:

YOLO + DeepSORT + EKF

明显更有AiBrainBox的特色。

Referring Target Tracking

也就是:

基于自然语言/属性描述的目标跟踪。
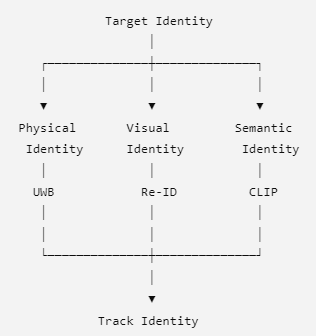
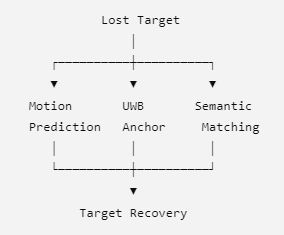
CLIP对"遮挡恢复"尤其有价值-多模态目标重识别
CLIP还有一个更大的价值:从"人"扩展到"物"
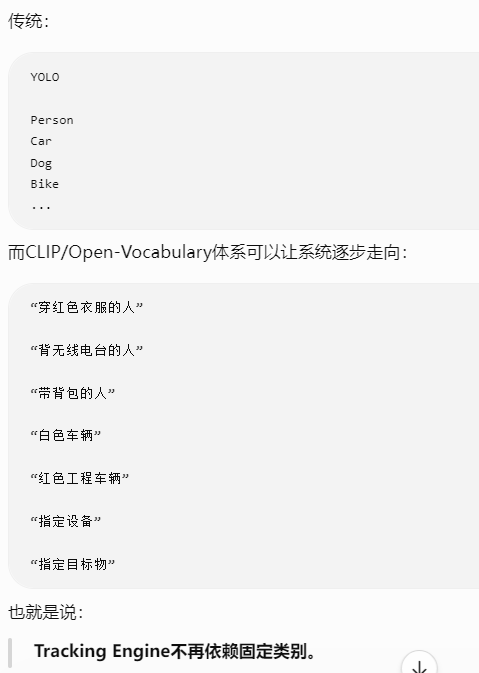
因为:

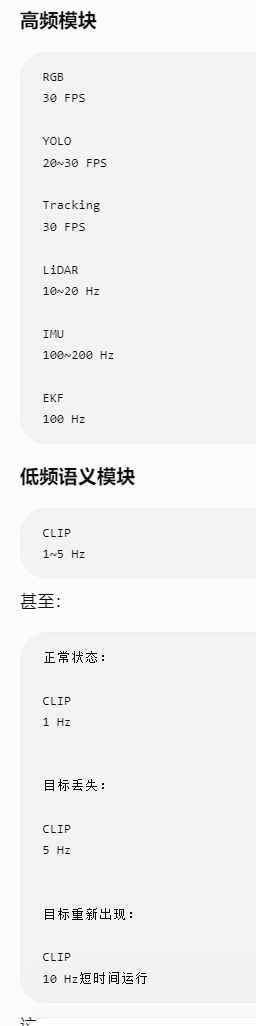
跟踪需要高频,语义不需要高频。

CLIP的输出可以缓存成:

复制代码
复制代码
Semantic Memory

而不是每帧重新推理。

AiBrainBox的NPU扩展卡

从:

AI Compute

升级成:

Target Intelligence Compute

"视觉语义层"-Semantic Vision Engine
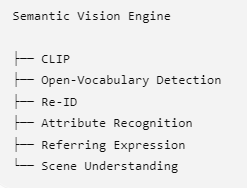
AiBrainBox-UGV的视觉跟踪变成"五层"
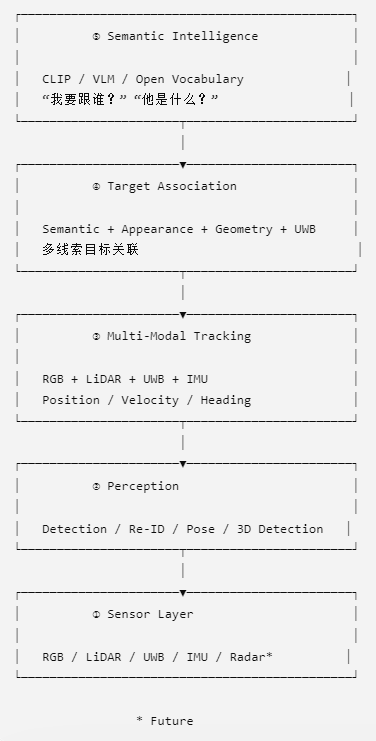
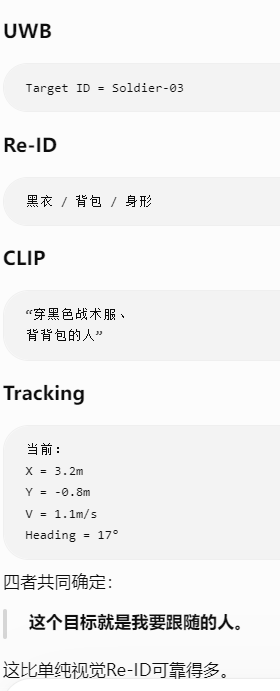
Semantic + Appearance + Geometry + Motion + Identity

五维目标模型。

Semantic Multi-Modal Target Tracking Engine

即:

语义 + 视觉 + LiDAR + UWB + IMU +(未来Radar)

共同构建一个"目标数字身份"。
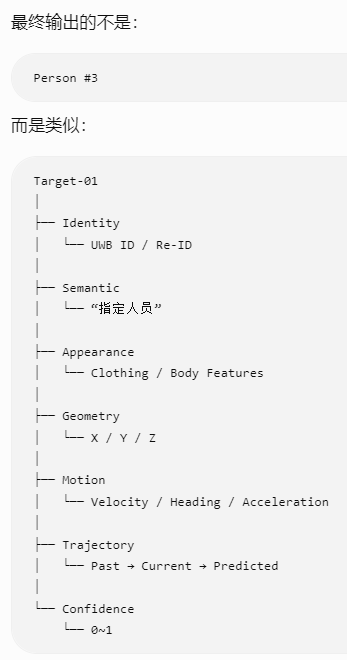
Ontology / Mission Intelligence 思路:机器人不再只是"看到一个人",而是建立一个可持续更新的 Target Entity-AiBrain OS 中可复用的 Target Intelligence 能力

相关推荐
Csvn10 小时前
同一个问题问 100 遍,钱就扣 100 次?精确缓存让它只扣一次(C02)
人工智能·aigc·agent
罗西的思考11 小时前
【轻量化复刻大模型 / KIMI K3】Multi-Token Prediction(MTP / EAGLE-3)(2)
人工智能·算法·机器学习
罗西的思考11 小时前
【轻量化复刻大模型 / KIMI K3】Multi-Token Prediction(MTP / EAGLE-3)(1)
人工智能·算法·机器学习
汤姆宝库12 小时前
BPE分词器的完整实现:字节对合并与词表构建
开发语言·人工智能·c#
岁月宁静12 小时前
从零拆解 AI 语音模拟面试系统
人工智能·python·agent
武子康12 小时前
H3-World 接入 Game Agent:谁来判断门真的打开了?
人工智能·算法·机器学习
可乐ea13 小时前
MCP 和 CLI 差 42 倍:一次 GitHub 任务的上下文成本实测
人工智能·github·工具调用·ai智能体·openrouter·mcp协议·上下文优化
kyriewen13 小时前
编辑弹窗点了取消,列表里的数据怎么还是变了?
前端·javascript·人工智能
Karl_fang13 小时前
🥳 再也不用拿起手机抄验证码!我做了一个 Android → Mac 的「验证码接力」工具
前端·macos·ai编程
泯泷14 小时前
Multica 真正打动我的,不是更多 Agent,而是一种新的团队协作方式
人工智能·llm·agent