ArgMaxRL:扩展 MaxRL 算法到连续性奖励
链接:https://www.doubleai.com/research/argmaxrl-generalizing-maxrl-to-continuous-rewards
一、为什么使用连续性奖励、使用 best@k 对象
1.1 二元奖励的局限:MaxRL 只能处理"对/错"
MaxRL 建立在二元正确性判定 之上:奖励 r∈{0,1}r\in\{0,1\}r∈{0,1},目标是优化 pass@k,即"采样 k 次至少有一次正确"的概率。
但许多重要任务的奖励是分级的、连续的,二元 pass@k 无法区分:
- CUDA内核优化:十个版本都正确,但加速比从 1.2×1.2\times1.2× 到 8.5×8.5\times8.5× 不等。pass@k 只知道"有正确的",不知道"哪个最快"。
- 部分给分数学:答案部分正确,得分 0.3、0.6、0.9,不是非 0 即 1。
- 代码生成:通过测试的比例,可能是 50%、80%、100%。
- 奖励模型打分:连续标量,反映质量高低。
- 按相关性排序的检索结果:排序分数。
- 多目标设置:正确性、效率、可读性等多个维度。
1.2 从 pass@k 到 best@k
- 对于连续奖励,真正关心的是:采样 k 次,其中最好样本的平均奖励是多少。
- 采样k次得到y1,y2,⋯ ,yk∼πθ(⋅∣x)y_1,y_2,\cdots,y_k \sim \pi_\theta(·|x)y1,y2,⋯,yk∼πθ(⋅∣x)是独立同分布,分别得到奖励r1,r2,⋯ ,rkr_1,r_2,\cdots,r_kr1,r2,⋯,rk。定义:Mk:=max1≤i≤kriM_k := \max_{1\le i\le k} r_iMk:=max1≤i≤kri表示k个样本中最大的奖励 。MkM_kMk是一个随机变量,每次采样k个样本,得到的奖励集合不同,最大值也会不同。
- 定义:best@k(x):=EMk\text{best@}k(x):=\mathbb{E}M_kbest@k(x):=EMk表示在给定输入x和当前策略模型下,反复进行"采样k次,取其中最好值"的操作,得到的平均最好奖励。
- best@k(x)正是推理时扩展(test-time scaling)的目标:k次采样中最好样本的期望质量。
- 在二元奖励下,奖励只能是0,1:Mk∈{0,1}M_k\in\{0,1\}Mk∈{0,1},所以EMk=P(Mk=1)=P(采样k次,至少有1次成功)=pass@k(x)\mathbb{E}M_k=P(M_k=1)=P(\text{采样k次,至少有1次成功})=\text{pass@}k(x)EMk=P(Mk=1)=P(采样k次,至少有1次成功)=pass@k(x)
所以 best@k 是 pass@k 的严格推广:"至少一个成功"变成"最好样本的奖励"。
对于复杂问题,模型的采样回答会有一定的不确定,单次采样可能会犯错,但多次采样至少有一个正确答案的概率会上升。所以模型会在训练完成后,推理时1.采样k次,2.用验证器或者奖励模型打分,3.选最好的或者投票。用推理时的计算量,换更高的准确率或者更好的质量,这也叫推理时扩展(test-time scaling)。
1.3 best@k 能保持多样性
- 以 k=2 为例:max(r1,r2)=r1+r22+∣r1−r2∣2max(r_1,r_2)=\frac{r_1+r_2}{2}+\frac{|r_1-r_2|}{2}max(r1,r2)=2r1+r2+2∣r1−r2∣
best@2=Emax(r1,r2)=12Er1+r2+12E∣r1−r2∣=best@1+12E∣r1−r2∣\text{best@}2=Emax(r_1,r_2)=\frac{1}{2}\mathbb{E}r_1+r_2+\frac{1}{2}\mathbb{E}|r_1-r_2| =\text{best@}1+\frac{1}{2}\mathbb{E}|r_1-r_2|best@2=Emax(r1,r2)=21Er1+r2+21E∣r1−r2∣=best@1+21E∣r1−r2∣
第一项是两个采样的平均质量,r1,r2r_1,r_2r1,r2独立同分布,也就是单样本质量,第二项奖励奖励值的差异。奖励差异越大,第二项越大。
三、ArgMaxRL 算法
3.1 问题设定
- 奖励为非负连续值 ri≥0r_i\ge 0ri≥0。
- Mk=max1≤i≤kriM_k=\max_{1\le i\le k} r_iMk=max1≤i≤kri。
- best@k(x)=EMk\text{best@}k(x)=\mathbb{E}M_kbest@k(x)=EMk。
在二元奖励下 best@k=pass@k\text{best@}k=\text{pass@}kbest@k=pass@k:
MaxRL问题设定
- 输入 x∼ρx\sim\rhox∼ρ,正确答案 y∗(x)y^*(x)y∗(x)。
- 潜变量 z∼mθ(z∣x)z\sim m_\theta(z|x)z∼mθ(z∣x),解码 y=f(z)y=f(z)y=f(z)。
- 二元奖励:r(x,z)=I{f(z)=y∗(x)}r(x,z)=\mathbb{I}\{f(z)=y^*(x)\}r(x,z)=I{f(z)=y∗(x)}。
- 通过率:pθpass(x)=P(f(z)=y∗(x))p_\theta^{\text{pass}}(x)=P(f(z)=y^*(x))pθpass(x)=P(f(z)=y∗(x))。
- pass@k:pass@k(x)=1−(1−p)k\text{pass@}k(x)=1-(1-p)^kpass@k(x)=1−(1−p)k。
3.2 目标函数
ArgMaxRL :
JArgMaxRL(N)(x):=∑k=1N1kbest@k(x)=∑k=1N1kEMkJ^{(N)}{\text{ArgMaxRL}}(x):=\sum{k=1}^{N}\frac{1}{k}\text{best@}k(x)=\sum_{k=1}^{N}\frac{1}{k}\mathbb{E}M_kJArgMaxRL(N)(x):=k=1∑Nk1best@k(x)=k=1∑Nk1EMk
∇θJArgMaxRL(N)(x)=∑k=1N1k∇θbest@k(x)\nabla_\theta J^{(N)}{\text{ArgMaxRL}}(x)=\sum{k=1}^{N}\frac{1}{k}\nabla_\theta \text{best@}k(x)∇θJArgMaxRL(N)(x)=k=1∑Nk1∇θbest@k(x)
二元下与 MaxRL 目标完全一致。
MaxRL:
JMaxRL(T)(x):=−∑k=1T(1−p)kk=−∑k=1Tfail@k(x)k=∑k=1Tpass@k(x)−1kJ^{(T)}{\text{MaxRL}}(x) := -\sum{k=1}^{T}\frac{(1-p)^k}{k}= - \sum_{k=1}^T \frac{fail@k(x)}{k}=\sum_{k=1}^T \frac{pass@k(x)-1}{k}JMaxRL(T)(x):=−k=1∑Tk(1−p)k=−k=1∑Tkfail@k(x)=k=1∑Tkpass@k(x)−1
∇θJMaxRL(T)(x)=∑k=1T1k ∇θpass@k(x)\nabla_{\theta} J^{(T)}{\text{MaxRL}}(x) = \sum{k=1}^{T}\frac{1}{k}\,\nabla_{\theta}\text{pass}@k(x)∇θJMaxRL(T)(x)=k=1∑Tk1∇θpass@k(x)
3.3 数学分解:尾和公式 + 阈值积分
- 核心思路是将连续奖励分解为一系列二元问题,在每个二元问题上应用最大强化学习(MaxRL),再进行整合。
- 对于非负随机变量𝑋,有尾和公式tail sum formula:
EX=∫0∞P(X>τ) dτ\mathbb{E}X=\int_0^\infty P(X>\tau)\,d\tauEX=∫0∞P(X>τ)dτ
应用到best@k(x)=EMk\text{best@}k(x)=\mathbb{E}M_kbest@k(x)=EMk:
best@k(x)=EMk=∫0∞P(Mk>τ) dτ\text{best@}k(x)=\mathbb{E}M_k=\int_0^\infty P(M_k>\tau)\,d\taubest@k(x)=EMk=∫0∞P(Mk>τ)dτ- 此处的τ≥0是阈值,MkM_kMk是k个采样中的最大值,对于每个阈值τ,{Mk>τ}\{M_k > \tau\}{Mk>τ},表示k个采样中至少有一个奖励大于τ。
- 基于此,定义二元奖励biτ=I{ri>τ}b_i^\tau=\mathbb{I}\{r_i>\tau\}biτ=I{ri>τ}(采样的奖励ri>τr_i>τri>τ则biτb_i^\taubiτ为1),则:
P(Mk>τ)=P(∑i=1kbiτ≥1)=1−P(∑i=1kbiτ=0)=1−∏i=1kP(biτ=0)=1−failτ@k(x)=passτ@k(x)\begin{aligned} P(M_k >\tau)&=P(\sum_{i=1}^k b_i^\tau \geq 1)\\ &=1-P(\sum_{i=1}^k b_i^\tau =0)\\ &=1-\prod_{i=1}^k P(b_i^\tau =0)\\ &=1-\text{fail}\tau @k(x)\\ &=\text{pass}\tau @k(x) \end{aligned}P(Mk>τ)=P(i=1∑kbiτ≥1)=1−P(i=1∑kbiτ=0)=1−i=1∏kP(biτ=0)=1−failτ@k(x)=passτ@k(x) - 即将采样最大值Mk>τM_k>τMk>τ的概率拆解成:对于设定的阈值τ,1-每次采样都<τ的概率
- 因此:best@k(x)=∫0∞P(X>τ) dτ=∫0∞passτ@k(x) dτ\text{best@}k(x)=\int_0^\infty P(X>\tau)\,d\tau=\int_0^\infty \text{pass}_\tau @k(x)\,d\taubest@k(x)=∫0∞P(X>τ)dτ=∫0∞passτ@k(x)dτ
- 即连续奖励best@k,可以写成所有阈值τ上二元pass@k的积分
- 再结合上面的梯度
∇θJArgMaxRL(N)(x)=∑k=1N1k∇θbest@k(x)∇θJArgMaxRL(N)(x)=∫0∞∑k=1N1k∇θpassτ@k(x) dτ=∫0∞∑k=1N1k∇θpassτ@k(x)⏟每个阈值τ的MaxRL梯度 dτ \begin{aligned} \nabla_\theta J^{(N)}{\text{ArgMaxRL}}(x)&=\sum{k=1}^{N}\frac{1}{k}\nabla_\theta \text{best@}k(x)\\ \nabla_\theta J^{(N)}{\text{ArgMaxRL}}(x)&=\int_0^\infty \sum{k=1}^N \frac{1}{k}\nabla_\theta \text{pass}\tau @k(x)\,d\tau\\ &=\int_0^\infty \underbrace{\sum{k=1}^N \frac{1}{k}\nabla_\theta \text{pass}\tau @k(x)}{每个阈值τ的MaxRL梯度}\,d\tau\\ \end{aligned} ∇θJArgMaxRL(N)(x)∇θJArgMaxRL(N)(x)=k=1∑Nk1∇θbest@k(x)=∫0∞k=1∑Nk1∇θpassτ@k(x)dτ=∫0∞每个阈值τ的MaxRL梯度 k=1∑Nk1∇θpassτ@k(x)dτ
- survival function幸存函数:(对于一个非负随机变量X)SX(τ)=P(X>τ)S_X(\tau)=P(X>\tau)SX(τ)=P(X>τ)
意思是随机变量X超过阈值τ的概率,如果X表示寿命,S(τ)就是活过时间τ的概率。这里X是最大奖励,S(τ)就是奖励超过某个阈值的概率。- 尾和公式tail sum formula:
EX=∑P(X≥x)=∑xP(X=x)=∫P(X≥x)dx=∫xd(F(x)) \begin{aligned} EX&=\sum P(X \geq x)&=\sum x P(X=x)\\ &=\int P(X \geq x)dx&=\int x d(F(x))\\ \end{aligned} EX=∑P(X≥x)=∫P(X≥x)dx=∑xP(X=x)=∫xd(F(x))
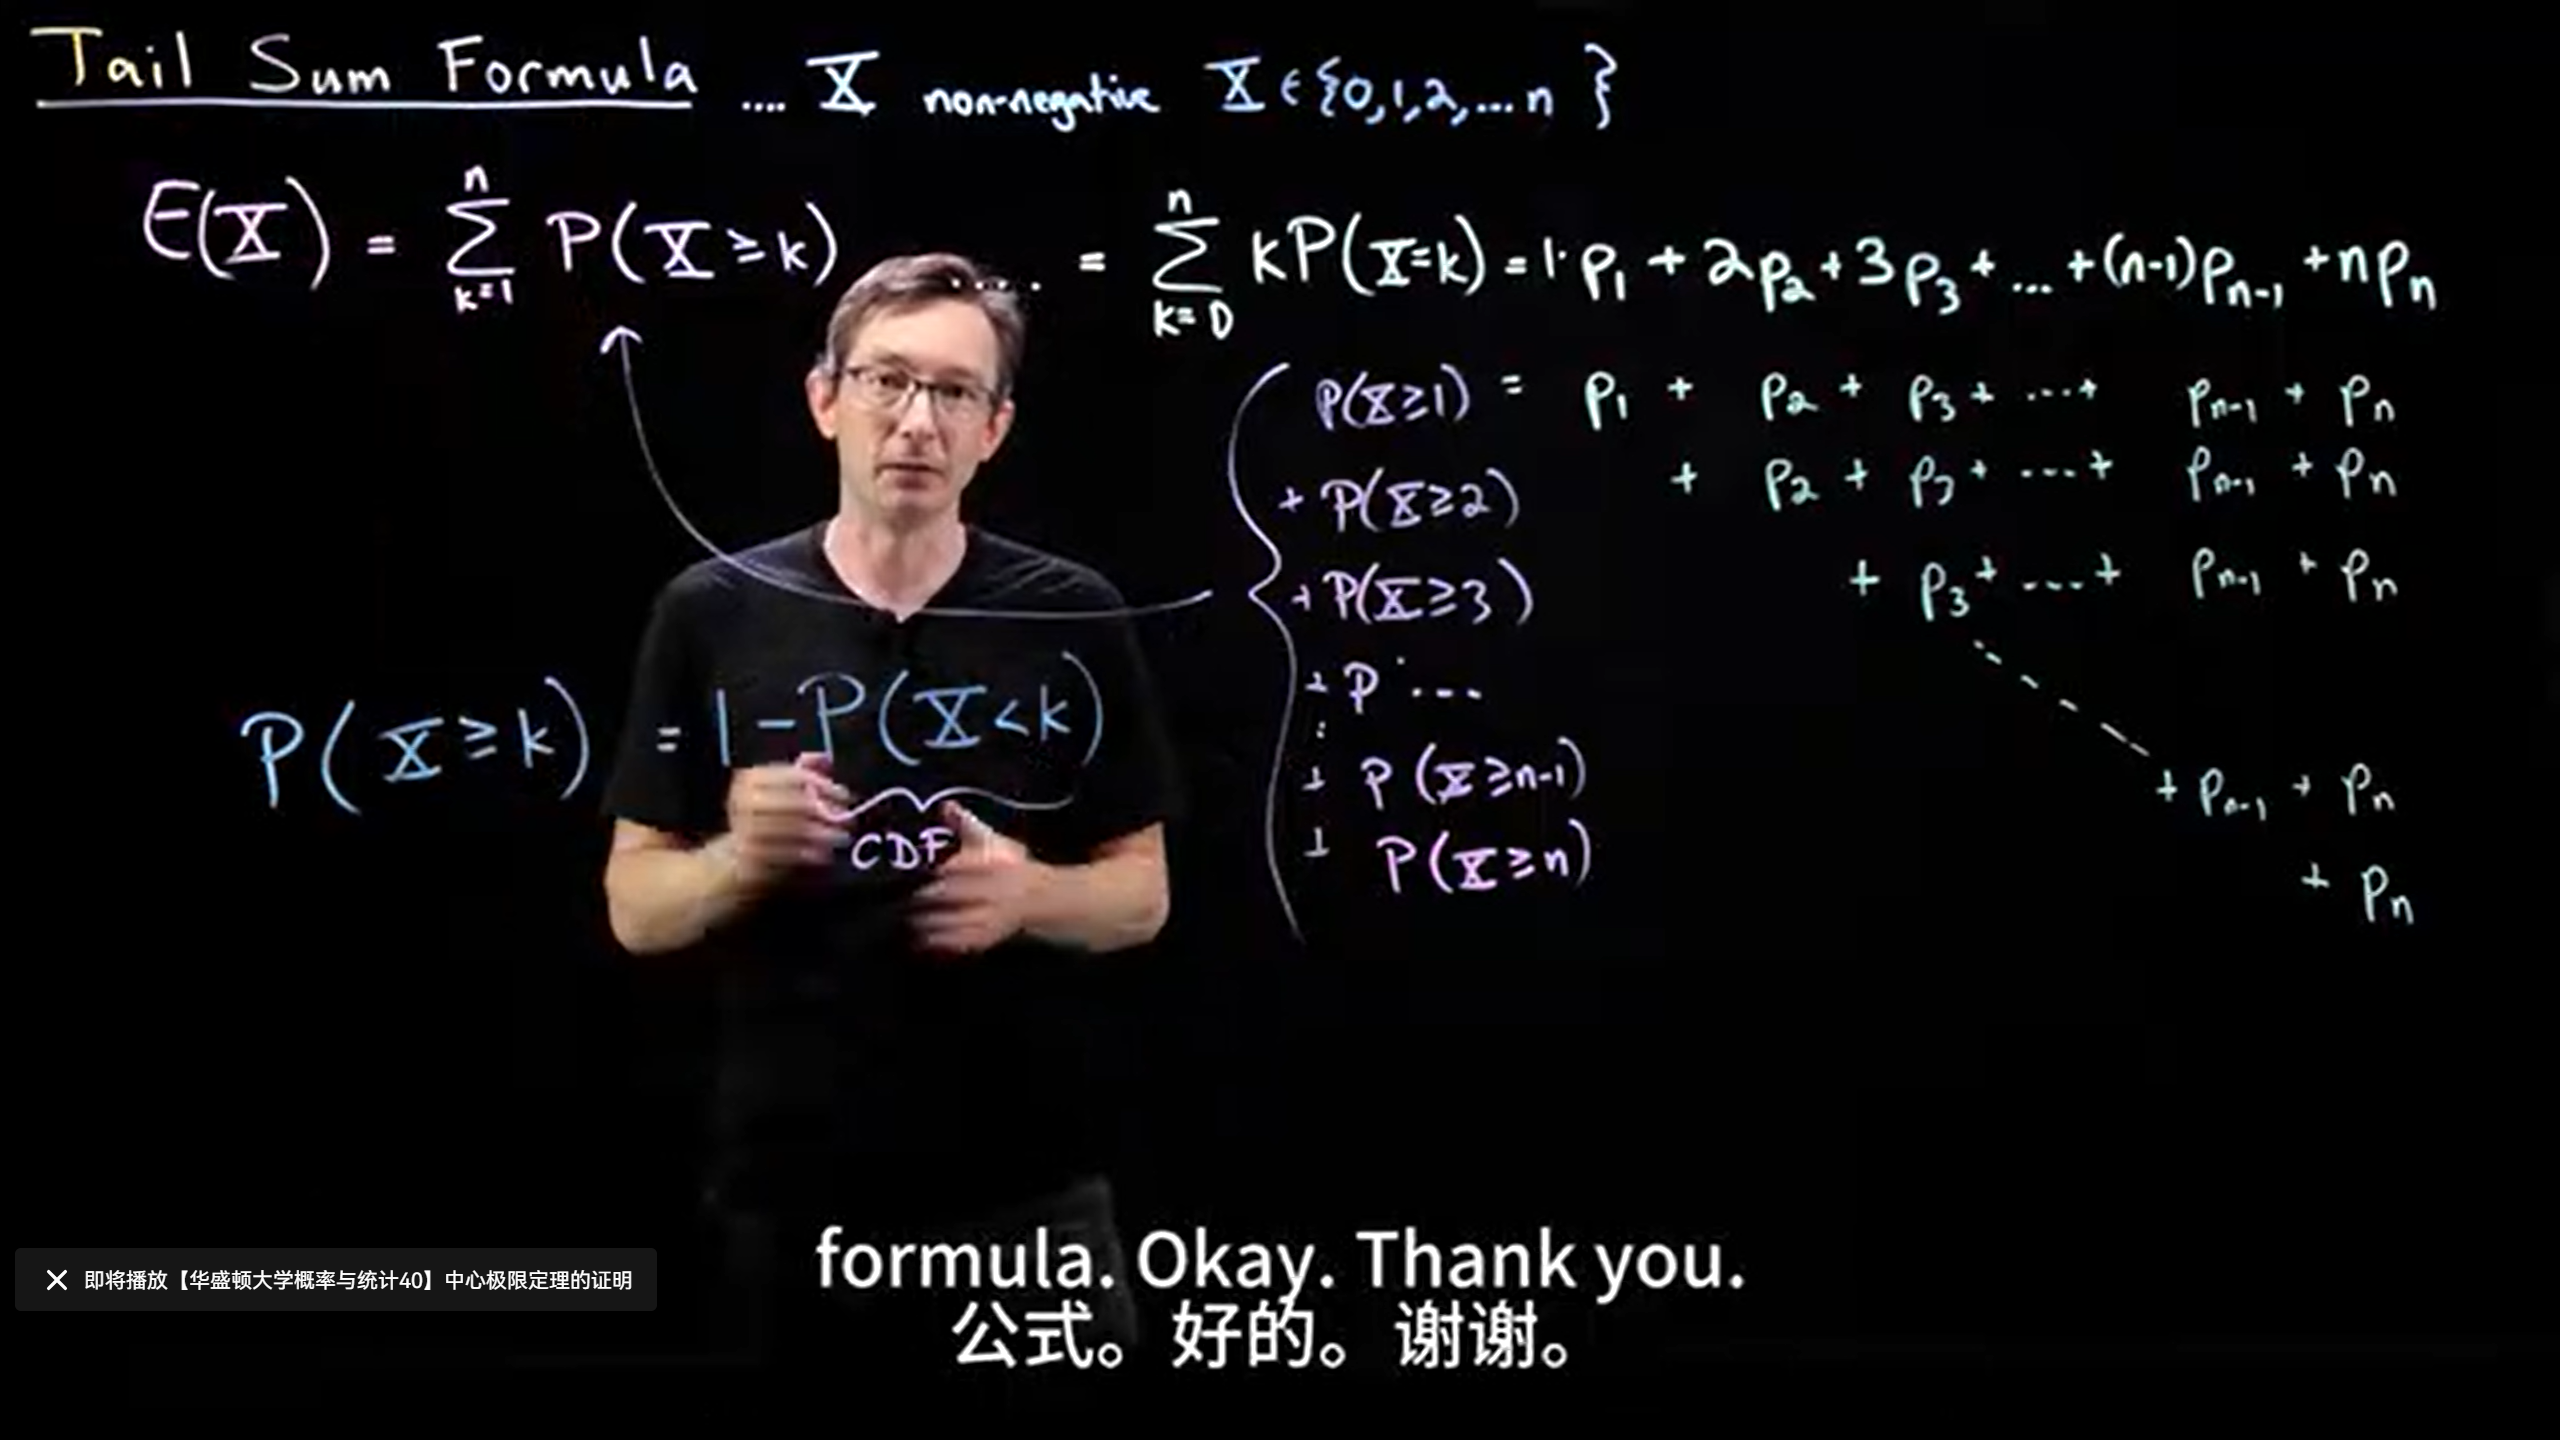
【【华盛顿大学概率与统计39】概率中的尾和公式】 https://www.bilibili.com/video/BV1yvYKzbEU3/?share_source=copy_web\&vd_source=a8517498a540532a70fc29d2e9b1a5ec
3.4 梯度估计器
- 对每个阈值τ,定义:Kτ=∑i=1NI{ri>τ}K_\tau=\sum_{i=1}^N \mathbb{I}\{r_i>\tau\}Kτ=∑i=1NI{ri>τ}表示奖励超过阈值τ的个数
- 阈值τ下的二元 MaxRL 估计器:
g^τ(N)(x)=1Kτ∑i:ri>τSi\hat g_\tau^{(N)}(x)=\frac{1}{K_\tau}\sum_{i:r_i>\tau} S_ig^τ(N)(x)=Kτ1i:ri>τ∑Si
MaxRL论文中MaxRL的梯度估计器的数学形式:
- 固定输入 xxx,抽取 NNN 条轨迹 z1,...,zN∼mθ(⋅∣x)z_1,\dots,z_N \sim m_\theta(\cdot|x)z1,...,zN∼mθ(⋅∣x),并记:
- ri:=I{f(zi)=y∗(x)}r_i := \mathbb{I}\{f(z_i)=y^*(x)\}ri:=I{f(zi)=y∗(x)}:第 iii 条轨迹是否成功;
- Si:=∇θlogmθ(zi∣x)S_i := \nabla_\theta\log m_\theta(z_i|x)Si:=∇θlogmθ(zi∣x):score function;
- K:=∑i=1NriK := \sum_{i=1}^N r_iK:=∑i=1Nri:成功样本总数。
- MAXRL 估计器 (REINFORCE 风格):
g^N(x)={1K∑i=1Nri Si,K≥1,0,K=0.(9)\widehat{g}N(x)=\begin{cases}\dfrac{1}{K}\displaystyle\sum{i=1}^N r_i\,S_i, & K\ge 1,\\2mm 0, & K=0.\end{cases} \tag{9}g N(x)=⎩ ⎨ ⎧K1i=1∑NriSi,0,K≥1,K=0.(9)- 定理4.2(估计器-目标等价性) :g^N(x)\widehat{g}N(x)g N(x) 是截断阶数 T=NT=NT=N 的 MAXRL 梯度的无偏估计:
∇θJMAXRL(N)(x)=Eg\^N(x)\nabla\theta J^{(N)}_{\text{MAXRL}}(x)=\mathbb{E}\big\\widehat{g}_N(x)\\big∇θJMAXRL(N)(x)=Eg N(x)
- ArgMaxRL 估计器是对其进行积分:
g^ArgMaxRL(N)(x)=∫0∞g^τ(N)(x) dτ\hat g^{(N)}{ArgMaxRL}(x)=\int_0^\infty \hat g\tau^{(N)}(x)\,d\taug^ArgMaxRL(N)(x)=∫0∞g^τ(N)(x)dτ
将g^τ(N)(x)\hat g_\tau^{(N)}(x)g^τ(N)(x)代入,并交换积分与求和:
g^(N)(x)=∑i=1N(∫0ri1Kτ dτ)Si\hat g^{(N)}(x) = \sum_{i=1}^N \left( \int_0^{r_i}\frac{1}{K_\tau}\,d\tau \right) S_ig^(N)(x)=i=1∑N(∫0riKτ1dτ)Si
定义权重:wi=∫0ri1Kτ dτw_i=\int_0^{r_i}\frac{1}{K_\tau}\,d\tauwi=∫0riKτ1dτ,则:g^(N)(x)=∑i=1NwiSi\hat g^{(N)}(x)=\sum_{i=1}^N w_i S_ig^(N)(x)=∑i=1NwiSi
- 定理(连续梯度估计器-目标等价性) :
ArgMaxRL梯度估计器与目标梯度等价
Eg\^ArgMaxRL(N)(x)=∇θJArgMaxRL(N)(x)=∑k=1N1k∇θbest@k(x)\mathbb{E}\\hat g\^{(N)}_{ArgMaxRL}(x)=\nabla_\theta J^{(N)}{ArgMaxRL}(x)=\sum{k=1}^N \frac{1}{k}\nabla_\theta \text{best@}k(x)Eg\^ArgMaxRL(N)(x)=∇θJArgMaxRL(N)(x)=k=1∑Nk1∇θbest@k(x)
证明
- 根据二元MaxRL定理,对每个固定的τ,有:
Eg\^τ(N)(x)=∑k=1N1k∇θpassτ@k(x) \mathbb{E}\left\\hat{g}_\\tau\^{(N)}(x)\\right = \sum_{k=1}^{N} \frac{1}{k} \nabla_\theta \operatorname{pass}_\tau @\mathrm{k}(x) Eg\^τ(N)(x)=k=1∑Nk1∇θpassτ@k(x)- 将等式两边对τ\tauτ积分:
Eg\^(N)(x)=∫0∞Eg\^τ(N)(x)dτ=∫0∞∑k=1N1k∇θpassτ@k(x) dτ \mathbb{E}\left\\hat{g}\^{(N)}(x)\\right = \int_{0}^{\infty} \mathbb{E}\left\\hat{g}_\\tau\^{(N)}(x)\\right d\tau = \int_{0}^{\infty} \sum_{k=1}^{N} \frac{1}{k} \nabla_\theta \operatorname{pass}_\tau @\mathrm{k}(x) \,d\tau Eg\^(N)(x)=∫0∞Eg\^τ(N)(x)dτ=∫0∞k=1∑Nk1∇θpassτ@k(x)dτ- 交换求和与积分的顺序,并利用关系式passτ@k(x)=P(Mk>τ)\operatorname{pass}\tau @\mathrm{k}(x) = P(M_k > \tau)passτ@k(x)=P(Mk>τ):
=∑k=1N1k∇θ∫0∞P(Mk>τ) dτ=∑k=1N1k∇θEMk=∇θJ(N)(x) = \sum{k=1}^{N} \frac{1}{k} \nabla_\theta \int_{0}^{\infty} P(M_k > \tau) \,d\tau = \sum_{k=1}^{N} \frac{1}{k} \nabla_\theta \mathbb{E}M_k = \nabla_\theta J^{(N)}(x) =k=1∑Nk1∇θ∫0∞P(Mk>τ)dτ=k=1∑Nk1∇θEMk=∇θJ(N)(x)
注:最后一步∫0∞P(Mk>τ)dτ=EMk\int_0^\infty P(M_k>\tau)d\tau = \mathbb{E}M_k∫0∞P(Mk>τ)dτ=EMk就是前面讲的尾和公式。
3.5 权重机制
- 将奖励降序排列:r(1)≥r(2)≥⋯≥r(N)≥0,r(N+1):=0r_{(1)}\ge r_{(2)}\ge \dots \ge r_{(N)}\ge 0,\qquad r_{(N+1)}:=0r(1)≥r(2)≥⋯≥r(N)≥0,r(N+1):=0
- 对于阈值区间 τ∈(r(m+1),r(m))\tau \in (r_{(m+1)},r_{(m)})τ∈(r(m+1),r(m)) 内,有K_\\tau = m 个样本\>τ,因此将积分拆分成:个样本\>τ,因此将积分拆分成:个样本\>τ,因此将积分拆分成:w(j)=∫0ri1Kτ dτ=∑m=jN∫r(m+1)r(m)1mdτ=∑m=jNr(m)−r(m+1)mw_{(j)}=\\int_0\^{r_i}\\frac{1}{K_\\tau}\\,d\\tau=\\sum_{m=j}\^N \\int_{r(m+1)}\^{r(m)} \\frac{1}{m} d \\tau=\\sum_{m=j}\^N \\frac{r_{(m)}-r_{(m+1)}}{m}w(j)=∫0riKτ1dτ=∑m=jN∫r(m+1)r(m)m1dτ=∑m=jNmr(m)−r(m+1)
- 每个样本的权重=沿着奖励排列,从0到自己所在的排名,经过的每条"奖励带"(r(m)−r(m+1)r(m)-r(m+1)r(m)−r(m+1))上分到的份额(r(m)−r(m+1)m\frac{r(m)-r(m+1)}{m}mr(m)−r(m+1))之和(∑\sum∑)。
g^ArgMaxRL(N)(x)=∑i=1N(∫0ri1Kτ dτ)Si\hat g^{(N)}{ArgMaxRL}(x)=\sum{i=1}^N\left(\int_0^{r_i}\frac{1}{K_\tau}\,d\tau\right)S_ig^ArgMaxRL(N)(x)=i=1∑N(∫0riKτ1dτ)Si
定义权重:wi=∫0ri1Kτ dτw_i=\int_0^{r_i}\frac{1}{K_\tau}\,d\tauwi=∫0riKτ1dτ,则:g^ArgMaxRL(N)(x)=∑i=1NwiSi\hat g^{(N)}{ArgMaxRL}(x)=\sum{i=1}^N w_i S_ig^ArgMaxRL(N)(x)=∑i=1NwiSi
与 REINFORCE、GRPO 对比:
- REINFORCE:ri/Nr_i/Nri/N,只依赖自身奖励。
- GRPO:(ri−μ)/σ(r_i-\mu)/\sigma(ri−μ)/σ,依赖批次均值和标准差。
- MaxRL:ri/Kr_i/Kri/K,依赖成功数。
- ArgMaxRL:∫0ri1/Kτdτ\int_0^{r_i}1/K_\tau d\tau∫0ri1/Kτdτ,依赖整个批次的完整排名结构。
| RL (REINFORCE) | GRPO | MaxRL (binary) | ArgMaxRL (continuous) | |
|---|---|---|---|---|
| Gradient estimator 梯度估计量 | 1N∑iriSi\displaystyle \frac{1}{N}\sum_{i} r_i S_iN1i∑riSi | 1N∑iri−μσSi\displaystyle \frac{1}{N}\sum_{i} \frac{r_i-\mu}{\sigma} S_iN1i∑σri−μSi | 1K∑iriSi\displaystyle \frac{1}{K}\sum_{i} r_i S_iK1i∑riSi | ∑i(∫0ri1Kτ dτ)Si\displaystyle \sum_{i} \left(\int_{0}^{r_i} \frac{1}{K_\tau} \,d\tau\right) S_ii∑(∫0riKτ1dτ)Si |
3.6 实现对比
MaxRL 实现:一行 advantage 修改。
ArgMaxRL 实现:排序 + 反向累积求和。
python
import numpy as np

def argmaxrl_weights(rewards):
    """
    输入一批rollout的奖励[r1,......,rN]
    输出是和输入顺序对应的权重[w1,......,wN]
    """
    N = len(rewards)
    order = np.argsort(-rewards)
    r_sorted = rewards[order] #排好序的奖励 r_(1) >= r_(2) >= ... >= r_(N)
    gaps = -np.diff(r_sorted, append=0.0)   # 数组元素间乡间得到gaps[m]=r(m)-r(m+1)
    terms = gaps / np.arange(1, N + 1)      # terms[m-1]=gap[m] / m
    w_sorted = np.cumsum(terms[::-1])[::-1] # 反向累积w_sorted[j-1]=\sum_j^N terms[m-1]
    weights = np.empty(N)
    weights[order] = w_sorted  # 按排名散回原始顺序
    return weights
梯度:
g^=∑iwiSi\hat g=\sum_i w_i S_ig^=i∑wiSi
计算量 (O(N\log N)),相对 LLM 前向反向可忽略。
3.7 ArgMaxRL 是 MaxRL 的严格泛化
当奖励为二元 {0,1}\{0,1\}{0,1} 时,设K=∑iriK=\sum_i r_iK=∑iri是采样中成功的数量:
- ri=0r_i=0ri=0:积分区间为空,wi=∫001Kτdτ=0w_i=\int_0^0 \frac{1}{K_\tau}d\tau=0wi=∫00Kτ1dτ=0。
- ri=1r_i=1ri=1:对所有 τ∈0,1\tau\in0,1τ∈0,1,成功样本都超过 τ\tauτ,失败样本都不超过τ,故Kτ=KK_\tau=KKτ=K。
wi=∫011K dτ=1Kw_i=\int_0^1 \frac{1}{K}\,d\tau=\frac{1}{K}wi=∫01K1dτ=K1
代入梯度估计器:
g^ArgMaxRL(N)(x)=1K∑i=1NriSi=g^MaxRL(N)(x)\hat g^{(N)}{ArgMaxRL}(x)=\frac{1}{K}\sum{i=1}^N r_i S_i=\hat g^{(N)}_{MaxRL}(x)g^ArgMaxRL(N)(x)=K1i=1∑NriSi=g^MaxRL(N)(x)
二元 MaxRL 是 ArgMaxRL 在 ({0,1}) 奖励上的唯一特例。
四、核心对比总表
| RL (REINFORCE) | GRPO | MaxRL (binary) | ArgMaxRL (continuous) | |
|---|---|---|---|---|
| Gradient estimator 梯度估计量 | 1N∑iriSi\displaystyle \frac{1}{N}\sum_{i} r_i S_iN1i∑riSi | 1N∑iri−μσSi\displaystyle \frac{1}{N}\sum_{i} \frac{r_i-\mu}{\sigma} S_iN1i∑σri−μSi | 1K∑iriSi\displaystyle \frac{1}{K}\sum_{i} r_i S_iK1i∑riSi | ∑i(∫0ri1Kτ dτ)Si\displaystyle \sum_{i} \left(\int_{0}^{r_i} \frac{1}{K_\tau} \,d\tau\right) S_ii∑(∫0riKτ1dτ)Si |
| Unbiased for 无偏估计目标 | ∇θpass@1\nabla_\theta \operatorname{pass@1}∇θpass@1 | ∇θpass@1\nabla_\theta \operatorname{pass@1}∇θpass@1 | ∑k=1N1k ∇θpass@k\displaystyle \sum_{k=1}^{N} \frac{1}{k}\, \nabla_\theta \operatorname{pass@k}k=1∑Nk1∇θpass@k | ∑k=1N1k ∇θbest@k\displaystyle \sum_{k=1}^{N} \frac{1}{k}\, \nabla_\theta \operatorname{best@k}k=1∑Nk1∇θbest@k |
其中 Si=∇θlogmθ(yi∣x)S_i = \nabla_\theta \log m_\theta(y_i \mid x)Si=∇θlogmθ(yi∣x),K=∑iriK = \sum_i r_iK=∑iri 表示二元任务中成功的次数,Kτ=∑i1{ri>τ}K_\tau = \sum_i \mathbb{1}\{r_i > \tau\}Kτ=∑i1{ri>τ} 用于统计回报超过阈值 τ\tauτ 的样本数量(1{⋅}\mathbb{1}\{\cdot\}1{⋅} 为指示函数)。