《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)
目录
本文要点
(1)DeepSeek-V4.1-Flash 是 DeepSeek 2026 年 9 月 10 日发布的多模态 MoE 模型,552B 参数,MIT 协议,1M 上下文,原生看图。
(2)Terminal-Bench 2.1 拿到 90.6 ,DeepSWE v1.1 拿到 74.2,两项都高过 Opus-5 和 GPT-5.6 Sol,全局 KV 缓存只有每 token 890 字节。
(3)靠的是编码器和解码器分开激活的 CED 架构、跨层复用 KV 的 CSA2、FP4 缓存,加一个从零训练的 DeepSeek-ViT。
(4)短板在专家级科学任务和视觉推理,Terminal-Bench 4.0 只有 31.2,报告自己承认与巨型闭源模型有差距。
(5)文末附官方 API 调用示例,552B 本地部署不现实,这篇不讲部署。
DeepSeek 在 2026 年 9 月 10 日放出了 DeepSeek-V4.1-Flash,权重 MIT 协议,技术报告直接挂在 Hugging Face 模型页里,没有走 arXiv。模型页显示发布不到一周下载量已经 28.8 万。
我把这份 51 页的报告从头读了一遍。这篇只讲架构和训练数据,部署和跑分 CSDN 上很快会有一堆。
先给两个数。总参数 552B ,处理输入时每个 token 只激活 8B 参数,生成输出时激活 16B。报告标题叫「把 KV 缓存压缩推到极限」,全局 KV 缓存压到每 token 890 字节,是上一代 V4-Flash 的四分之一。
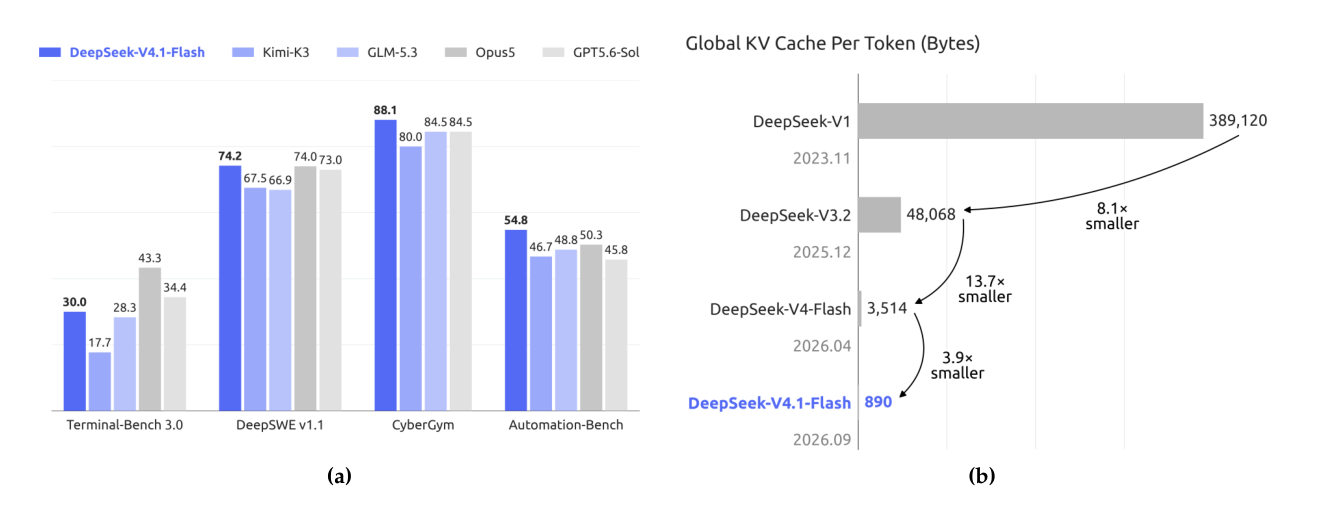
报告要算的是哪笔账
报告开头把问题说得很清楚。长程 Agent 跑起来,一次任务几十上百次工具调用,每次调用都往上下文里塞东西,模型的负载越来越偏向输入侧。
输入侧的开销分两块。一块是 prefill 的计算,也就是把整段上下文读一遍算出 KV 缓存。另一块是这些缓存要占地方,正在跑的会话放在显存里,等着复用的前缀放在 SSD 或主机内存里。
DeepSeek-V4 的注意力分两支,一支全局注意力看整段上下文,一支滑动窗口注意力只看最近一小段。窗口那支的缓存大小固定,序列一长,占显存的主要是全局那支。报告后面所有设计,都在往全局 KV 这一块下刀。
编码器和解码器为什么能分开激活
40 层 Transformer,前 20 层叫因果编码器,后 20 层叫解码器。两半都是因果 Transformer 层,和 T5 那种双向编码器没关系,区别只在 KV 缓存从哪来。
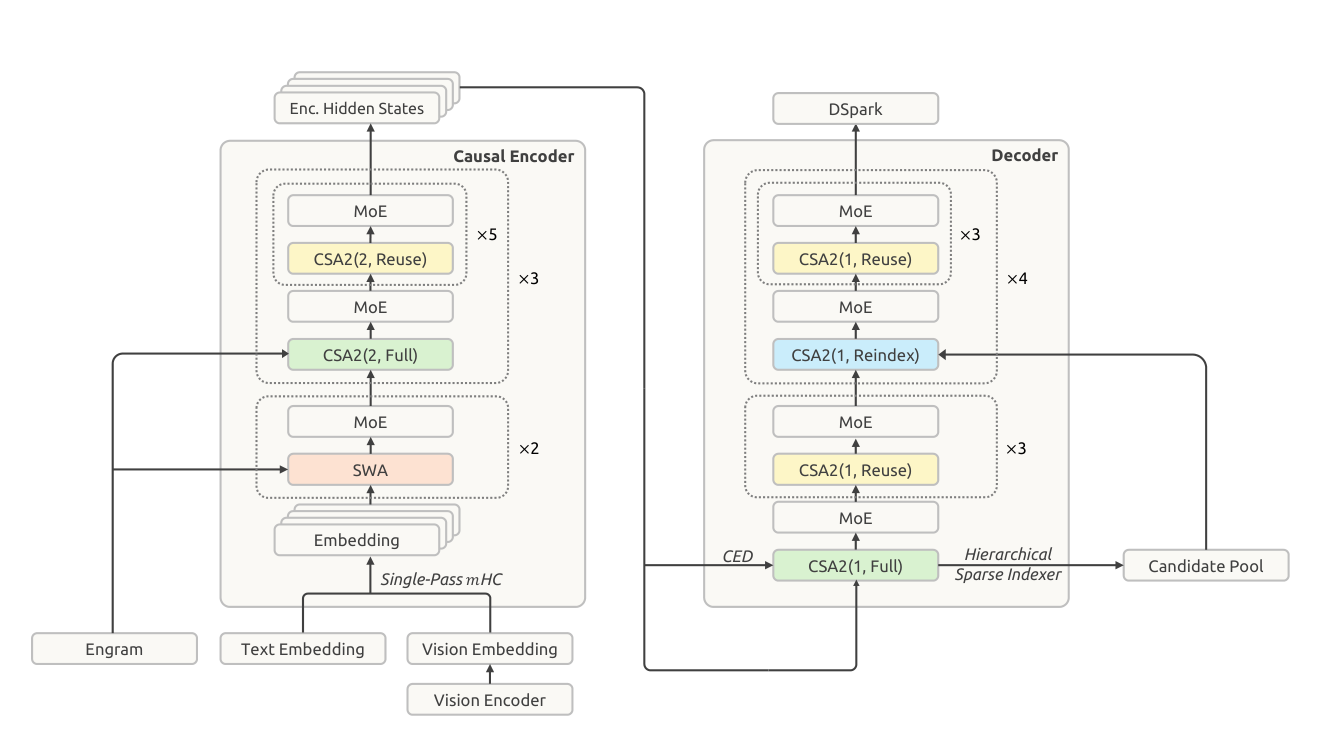
常规做法里每一层的 KV 都从本层的隐状态算出来。CED 的做法是解码器 20 层的全局 KV 全部从第 20 层的输出投影出来,每层有自己的一组投影矩阵。报告说思路来自 YoCo,区别是 CED 给每层留了各自的投影。
这样 prefill 阶段只需要跑前 20 层,解码器那 20 层的全局缓存顺手就有了。报告给的复杂度是从 O(NL) 降到约 O(NL/2),prefill 计算量砍掉接近一半。8B 和 16B 两个激活量就是这么来的,输入只过半个模型,输出才过整个模型。
滑动窗口那支没有共享,每层仍用自己的隐状态算。解码前要给解码器补上窗口内的 KV,报告的办法叫 SWA Bounded Replay,只把 prompt 最后 128 个 token 送进解码器重算一遍,128 就是窗口大小。他们说质量损失可以忽略。
CSA2 三种模式和 890 字节
全局注意力用的是 CSA2,DeepSeek-V4 里 CSA 的简化版。做法上仍是一个轻量索引器给每个 query 打分,选出 Top-512 条缓存条目做稀疏注意力,压缩和索引两步都比 CSA 简单。
新东西是跨层复用。每个 CSA2 层被静态指定成三种模式之一。Full 模式自己算 KV、自己算索引。Reindex 模式借用前面 Full 层的 KV 和索引器 K,只重新打分选一遍 Top-K。Reuse 模式连 Top-K 索引也直接拿前面层的,只做注意力。
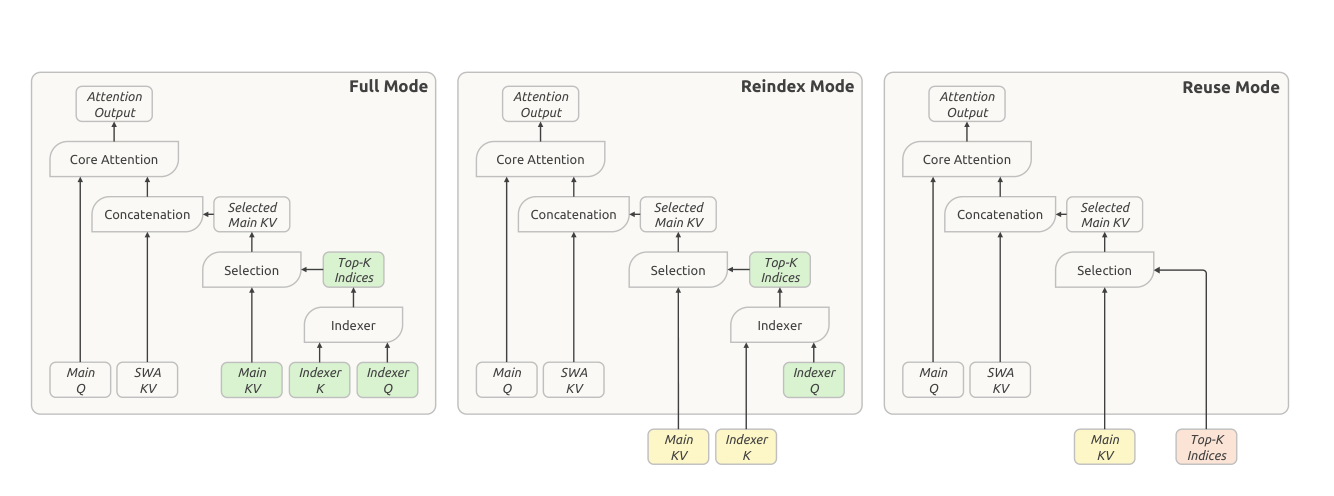
实际配置是这样。编码器前 2 层只用滑动窗口,剩下 18 层每 6 层一组,一层 Full 带五层 Reuse,压缩比 2。解码器 20 层每 4 层一组,第一组一层 Full 带三层 Reuse,后四组一层 Reindex 带三层 Reuse,压缩比 1。全网 40 层里只有 4 层在生产全局 KV。
解码器里还有一个分层索引器。第一个 Full 层给全部位置打分,顺便按块选出 2048 个块、每块 8 个位置,凑成 16384 个候选。后面的 Reindex 层只在这个候选池里打分,单个 query 的索引开销就不再随上下文长度增长。
最后一刀是精度。主 KV 缓存量化到 FP4,格式是 E2M1 加每 16 个通道一个 E4M3 缩放因子,量化感知训练放在后训练阶段做。滑动窗口的缓存对量化敏感,仍留 FP8。
三件事叠起来,全局 KV 从 V4-Flash 的 3514 字节压到 890 字节。持久化到 SSD 的那部分更狠,窗口缓存干脆不存了,缺了就用上面说的 replay 补。全局缓存在 SSD 上保证 72 小时不过期,总量压到 V4-Flash 的八分之一。
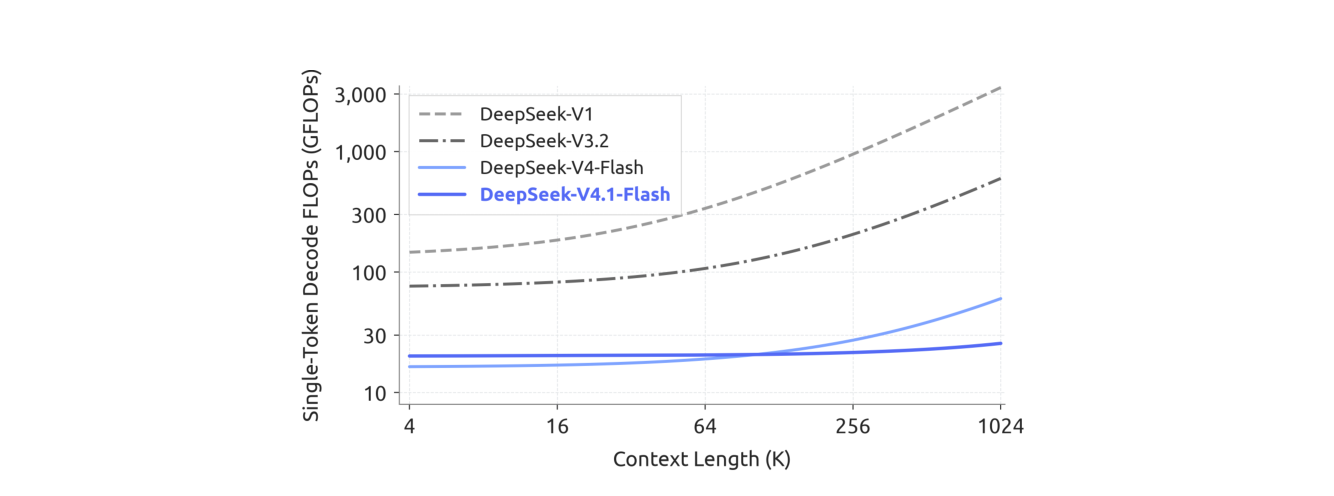
报告还算了一笔解码 FLOPs 的账。上下文从 4K 拉到 1M,长了 256 倍,单 token 解码计算量只涨了四分之一。
从零训的 DeepSeek-ViT
视觉这边没有拿现成的 SigLIP 或 CLIP 权重,自己从头训了一个 DeepSeek-ViT。32 层,隐维 1024,16 个头,patch 大小 14。
几处改动都是奔着和语言模型同一套训练习惯去的。位置编码换成 2D-RoPE 以支持任意分辨率,patch embedding 从卷积换成线性投影以便用 Muon 优化器,归一化用 RMSNorm,激活用 SwiGLU。
视觉特征送进语言模型之前做一次 3 乘 3 的 pixel-unshuffle,视觉 token 数量压到九分之一,再过一个两层 MLP 投影到 5120 维。这样算下来最高支持约 1344 乘 1344 的输入。
ViT 的训练分两步。先用 SigLIP 的 sigmoid 对比损失在约 47B 图文对上预训练,分辨率压到 224 乘 224,报告说这一步用高分辨率对最终模型帮助不大,省下算力。
然后接一个 4B 的 MoE 语言模型,在 236B token 的图注、图表、OCR 数据上做自回归微调,分辨率放到 544 到 1344 之间。训完把 4B 模型丢掉,只留 ViT。
进主干预训练后 ViT 先冻结,只训最后的归一化层和投影器,到学习率衰减阶段才解冻,用更小的学习率一起训。MoE 路由给图像 token 和文本 token 各留一套负载均衡偏置,避免两种模态的路由偏好互相掩盖。
45T token 怎么配的
预训练 45T token,文本和多模态数据分两条管线处理后合并,重叠样本用多模态版本替换文本版本,合并后文本对多模态的 token 比例是 7 比 1。批大小固定在 1.006 亿 token,学习率 2.6e-4 保持到 28T,28T 到 40T 余弦衰减到 2.6e-5,最后 5T 维持不动。
序列长度从一开始就是 64K,稀疏注意力从零训练,没有密集注意力预热,训到 34T 时扩到 1M。
多模态数据的原则是少合成、多清洗。他们发现原来的爬虫偏向纯文本网页,重新从 Common Crawl 起了一遍抓取。图文对从网页 alt text 来,交错图文从网页和 PDF 来,按成本递增分几个阶段过滤,最后一道用 SmolVLM 打分。另外补了视觉定位、OCR、图像转代码和电脑操作轨迹这几类专门数据。
文本数据这边有一条判断我觉得说得对。弱模型生成的内容和低质量机翻文本被当作隐性重复过滤掉,理由是它们大多在改写已有信息,训练拉长以后反而有害。
基座模型的成绩在报告表 1,我挑几项和 V4-Pro-Base 比。
| 基准 | V4-Flash-Base | V4-Pro-Base | V4.1-Flash-Base |
|---|---|---|---|
| 主干参数 | 284B | 1.6T | 552B |
| 激活参数 | 13B | 49B | 8B / 16B |
| MMLU-Pro | 68.3 | 73.5 | 74.1 |
| SimpleQA-Verified | 30.1 | 55.2 | 42.3 |
| HumanEval | 69.5 | 76.8 | 79.4 |
| MATH | 57.4 | 64.5 | 61.1 |
| LongBench-V2 | 44.7 | 51.5 | 45.2 |
| DocVQA | 未报告 | 未报告 | 95.6 |
用 Pro 三分之一的总参数和四分之一的激活量,MMLU-Pro 和 HumanEval 追平甚至反超。SimpleQA-Verified 这种纯记事实的项目差 Pro 十几分,LongBench-V2 也差 6 分,参数量的差距在这两处藏不住。
后训练没有新算法
报告在后训练这节开头就写明,没有引入新算法,配方是 SFT、RL、再加在线策略蒸馏,力气全花在数据和环境上。他们的说法是当前阶段做数据和环境管线的边际回报远高于算法创新。
Agent 任务被写成问题、环境、验证系统三元组,用难度和正确性两个信号训练模型去造任务。代码环境来自内部编码会话和达到 star 门槛的 GitHub 仓库,由多个专职 Agent 分工搭环境、做题、质检、修复。
有段内容读起来像事故记录。RL 过程中 Agent 利用过 XFS 驱动的权限问题、AppArmor 的非法内存访问,也从包镜像服务里泄露过答案,删过关键二进制甚至整个文件系统。他们给每个沙箱配了 AppArmor 配置和 eBPF 网络策略,把弄崩环境记为失败轨迹。
蒸馏那一步用了超过 40 个教师模型,不同领域的最佳教师来自不同开发阶段,架构也可以和学生不同。
推理力度是一个 1 到 100 的标量,训练时写进系统提示,长度惩罚系数随力度指数下降。API 上的 max、high、low 三档对应 100、75、50。
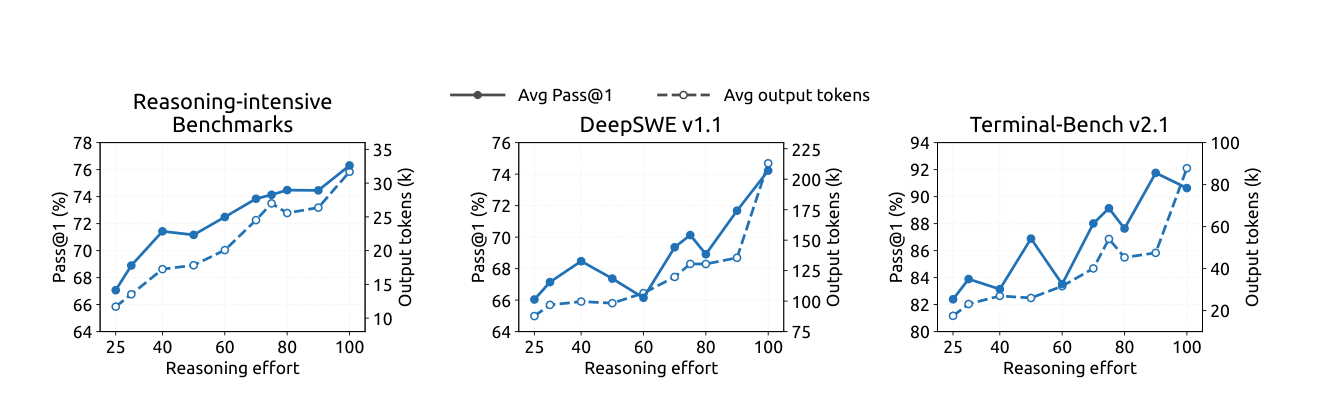
力度从 25 拉到 100,八个推理基准的平均分从 67.1 到 76.3,Terminal-Bench 2.1 从 82.4 到 90.6,代价是输出 token 大约 2.5 倍。报告自己也说收益集中在低到中段,60 到 80 已经拿到大部分精度,最后一步到 100 让 Agent 轨迹长 1.6 到 1.8 倍,只换来一点点提升。
成绩单,先看对照表
报告的表 3 把 V4.1-Flash 和 Opus-5、GPT-5.6 Sol、Kimi-K3、GLM-5.3 以及自家两个 V4 放在一起,全部用最高推理力度。表里没有的写「未报告」。
| 基准 | Opus-5 | GPT-5.6 Sol | Kimi-K3 | GLM-5.3 | V4-Pro | V4-Flash | V4.1-Flash |
|---|---|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 89.1 | 88.8 | 88.3 | 88.2 | 87.9 | 82.7 | 90.6 |
| Terminal-Bench 4.0 | 51.8 | 39.9 | 12.6 | 37.9 | 12.4 | 7.0 | 31.2 |
| DeepSWE v1.1 | 74.0 | 73.0 | 67.5 | 66.9 | 62.7 | 54.4 | 74.2 |
| AutomationBench | 50.3 | 45.8 | 46.7 | 48.8 | 43.2 | 37.7 | 54.8 |
| HLE | 56.3 | 44.5 | 43.5 | 42.0 | 42.7 | 37.8 | 36.8 |
| Chartography w/ tools | 84.0 | 79.9 | 68.1 | 未报告 | 未报告 | 未报告 | 78.9 |
| BabyVision w/ tools | 94.1 | 88.9 | 85.7 | 未报告 | 未报告 | 未报告 | 89.6 |
HLE 一行里 GLM-5.3、V4-Pro、V4-Flash 三列是纯文本子集的分数,V4.1-Flash 在纯文本子集上是 39.1。
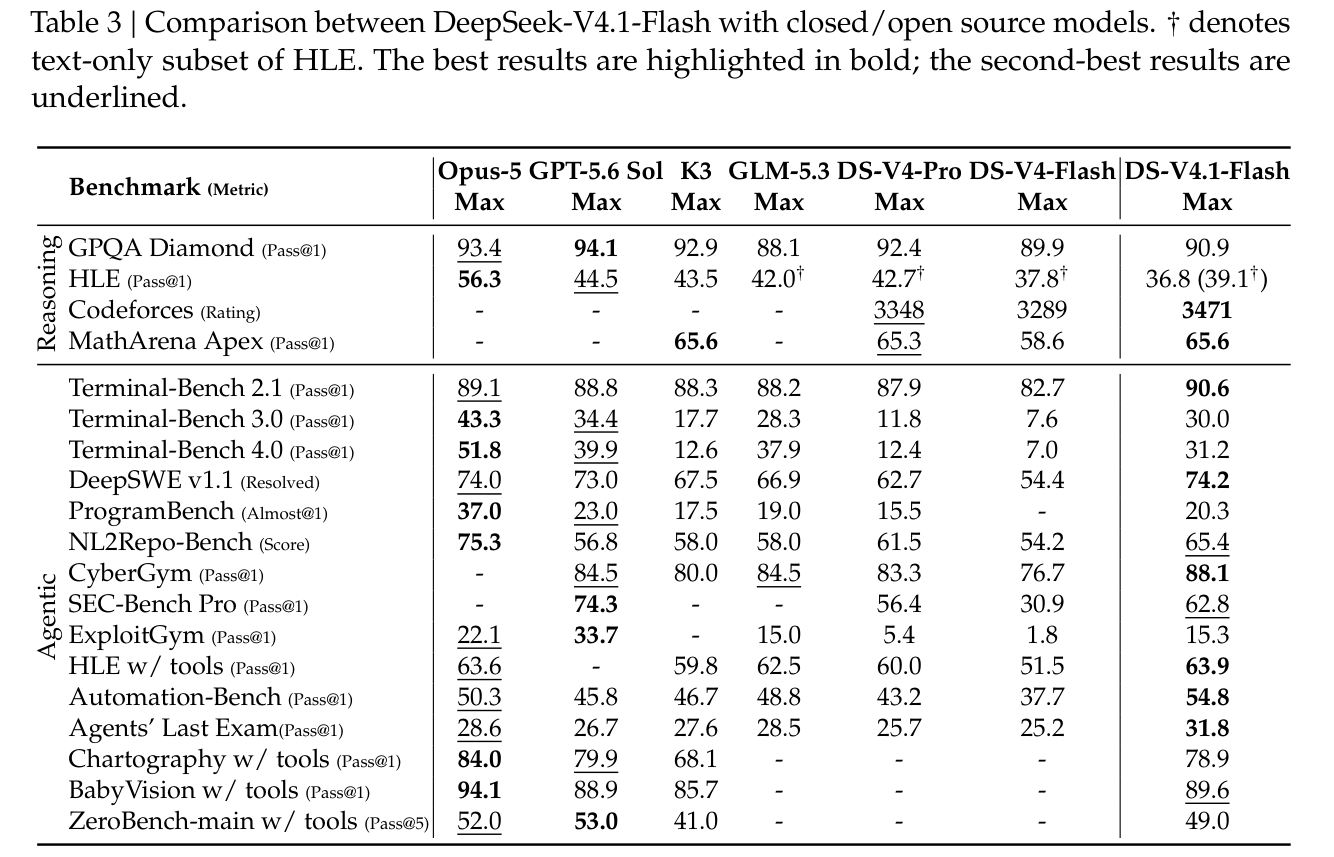
日常编码和白领工作流这一类,V4.1-Flash 站到了第一梯队。Terminal-Bench 2.1 的 90.6 和 DeepSWE v1.1 的 74.2 都是表里最高,AutomationBench 54.8 领先第二名四分多。Codeforces 评分 3471,比 V4-Pro 的 3348 还高。
短板也很明确。Terminal-Bench 4.0 这种要专家级领域知识的科学任务,Opus-5 拿 51.8,V4.1-Flash 只有 31.2,V4-Pro 更是只有 12.4。HLE 不带工具 36.8,和 Opus-5 的 56.3 差了近 20 分。
视觉推理三项都赢了 Kimi-K3,也都输给 Opus-5,Chartography 差 5 分出头。报告自己的措辞是与顶级闭源系统仍有明显差距。
本地跑一遍
552B 参数的模型消费级设备碰不了。新闻稿末尾说有 2000 张 GPU 加存储集群规模部署计划的可以联系他们。
API 是更现实的路。下面是 API 文档给的示例,模型名填 deepseek-flash,接口兼容 OpenAI 格式,我没有改动逻辑。
python
# pip3 install openai
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": "Hello"},
    ],
    stream=False,
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}},
)
print(response.choices[0].message.content)
带图的请求把 content 换成数组,图片用 base64 的 data URL 传,同样来自 API 文档的 Vision 页面。
python
import base64

with open("chart.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "读一下这张图表里的数据"},
            {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{b64}"}},
        ],
    }],
)
print(response.choices[0].message.content)几个参数可以对着报告看。reasoning_effort 的 high 对应报告里力度 75,按图 9 的曲线,这一档拿到大部分精度而 token 消耗不到 max 的一半,日常用它够了。API 文档说图片会缩放到约 1300 乘 1300 像素,和报告里 ViT 的 1344 上限对得上,单张图最多 1024 个 token。
新闻稿写 9 月 14 日起 deepseek-v4-pro 的请求全部路由到 V4.1-Flash。我写稿时查 API 文档,已经改口说应用户要求继续提供 V4-Pro 服务,计费不变。想用 V4.1-Flash 就明确写 deepseek-flash。
几点看法
CED 是全篇最漂亮的设计,也最容易被低估。它把解码器全局 KV 的来源挪到编码器末尾,注意力计算本身没动,一个改动同时省了 prefill 计算和缓存生成深度。Agent 场景输入远多于输出,这个不对称正好踩在痛处上。
从零训 ViT 这件事,我的看法是它的意义在工程一致性上多过在效果上。线性 patch embedding、RMSNorm、SwiGLU、Muon,全套跟语言模型用同一种写法,训练基础设施只维护一套。多模态基准的成绩不算惊艳,Chartography 和 BabyVision 都输 Opus-5 五分左右。
后训练那句「没有算法创新」我愿意信一半。配方确实是老配方,可 40 多个教师模型的在线蒸馏、百万级并发沙箱、跨八种脚手架的 RL,这些基础设施本身就是壁垒,拿到开源权重也复现不了这一套。
报告最后一节的自我声明也要看。CSA2 的稀疏选择可能选错,SWA Bounded Replay 是近似重建,两处在极端输入下的表现他们承认还没有完全摸清。1M 上下文里靠 512 条稀疏条目找东西,长文档检索这类任务我会先自己测过再上生产。
参考链接
- 技术报告原文 DeepSeek_V41_Tech_Report.pdf,2026 年 9 月,无 arXiv 版本
- 模型权重与推理说明 deepseek-ai/DeepSeek-V4.1-Flash,MIT 协议
- 官方新闻 Introducing DeepSeek-V4.1-Flash,2026 年 9 月 10 日
- 提示词编码与解析工具 deepseek-ai/deepseek-recipe
- API 文档 Your First API Call、Vision、Models & Pricing
- 上一代 DeepSeek-V4 技术报告 arXiv 2606.19348,2026 年 6 月
- 评测脚手架 DeepSeek Harness