1.你为什么要来我们公司?
我认可贵公司的平台实力,看重技术岗位的发展空间。我有 C++ 和 Linux 相关开发实践,项目经历和岗位需求匹配,希望在这里发挥软件开发能力,持续学习成长,长期稳定深耕。
2.你在项目开发中会用到ai吗?
在项目开发中,我会把 AI 作为辅助工具,核心业务代码和底层逻辑都是自己独立编写、调试和理解的。我主要使用 AI 来写一些 Shell 测试脚本、查询语法、排查 bug 思路,用来提升开发效率。像高并发服务器、Qt 上位机的核心逻辑、数据接收与缓冲区处理这些关键模块,从需求设计到代码实现都是我亲手完成,每一行核心代码我都理解原理,并且在 Gitee 上提交了完整代码。我会对 AI 生成的内容仔细审核、修改验证,不会直接复制粘贴使用。
3.目前有拿到offer吗?
暂时没有正式 offer,现阶段在参加秋招面试。贵司岗位和我的技术背景契合,是我很看重的机会。
4.你的学校在成都为什么没有考虑在成都发展
我在成都就读,也投递过成都的岗位。杭州的技术生态成熟,有不少 Linux、网络开发方向岗位,和我 C++ 开发的技术栈匹配,我希望在这个领域持续成长,所以选择来杭州寻找机会。
5.为什么不打算考研
我认真思考过考研,结合自身情况最终决定直接就业。我个人更偏向工程实践,自学 C++、Linux 计算机相关知识,独立完成了高并发服务器、Qt 上位机这些项目,在动手写代码、调试的过程中收获更大。 我的目标是从事 C++ 开发方向,现阶段希望尽快进入行业,在真实业务场景里积累工程经验。后续如果工作中有需要,我再针对性去补充学习。
6.你是宁夏人,为什么考虑来杭州,之后会不会回老家?
未来五年的职业规划是在杭州积累技术经验,深耕 C++ 开发;长期会结合个人发展再规划,现阶段专注在岗位上做好开发工作。
7.为什么不考六级?
之前我把主要精力投入 C++、Linux 等技术学习和项目开发,没有报考六级。不过我具备基础英文阅读能力,可以看懂英文开发文档、开源代码注释,能够满足岗位开发需求。
8.你的专业主要上什么课?
本专业课程以环境工程、化学相关内容为主。我基于职业规划自学计算机核心知识,包括 C/C++、数据结构、操作系统、计算机网络,并落地到项目实践。跨专业学习锻炼了我的自学和问题排查能力。
9.你们是有专门开设linux的相关课程吗
学校本专业没有开设 Linux 相关课程。是我确定想做 C++ 开发之后,自主学习的。我系统学习了 Linux 命令、进程线程、IPC 通信、Socket 网络编程,并且在我的高并发服务器、Qt 上位机项目里,全部在 Linux 环境下开发调试,实操练习。遇到问题查阅文档、使用 gdb 调试,把 Linux 相关知识落地到项目中。
10.你了解我们公司吗?
潮流网络 Grandstream 是全球统一通信方案厂商,杭州是核心研发中心,主打 VoIP、音视频、网关、企业网络设备。主要使用 C++ 和 Linux 做通信软件开发,和我 C++、网络编程的项目背景契合,我希望在这里深耕网络通信方向。
11.说一说你参加的杭州其他公司一般都在招聘什么
杭州这边大量招聘 C++、Linux 开发岗位,分为互联网后端、音视频通信、嵌入式和工业上位机几类。不少岗位偏向业务开发,潮流网络聚焦通信设备底层网络开发,和我的 UDP 高并发项目经验契合,是我优先选择的方向。
12.说一说你为什么想参加这个行业的工作?
我对网络设备底层开发感兴趣,交换机作为网络核心转发设备,正是我想深耕的方向。我自学 C/C++、Linux,做过 UDP 高并发报文处理项目,熟悉 TCP/IP 协议。这个岗位在 Linux 下做交换机功能开发,和我的技术背景匹配,希望在这里持续积累网络设备开发经验。
13.你在做心理委员的生涯中有哪些收获
担任心理委员,锻炼了我的沟通倾听能力与责任心。我需要耐心倾听同学诉求,做好情绪疏导和信息同步。这让我在团队协作中,能够更好地和同事沟通需求、交流问题,适配开发岗位的团队合作要求。
14.你是独生子女吗
不是,家里有兄弟姐妹,家庭方面不会影响我在杭州的工作。
15.你更倾向于哪个部门的工作
我更倾向交换机开发部门,我的技术栈和项目经历和交换机开发的工作比较契合。同时我也服从公司岗位调配,交给我的任务我都会认真完成。
16.期望薪资?
结合岗位 JD、杭州同类型应届生 C++ 开发行情,我的期望薪资是12k 左右。当然薪资方面可以沟通,我更看重这个交换机开发岗位,希望能在网络设备方向长期成长。
17.面试问到比较基础的问题但是忘记了怎么回复(模板)
这个知识点我之前学过,短时间内没办法完整复述,我记得它主要是做 XXX。面试结束后我会立刻重新复习这块内容。
18.面试问到比较难的问题不会怎么回复(模板)
这个问题我目前没有深入学习过,暂时答不上。如果工作里遇到这类问题,我会先查阅内核文档 / 相关技术手册,写小 demo 验证,动手调试把原理搞明白。后续我会主动学习这块知识。
19.多态有哪几种?
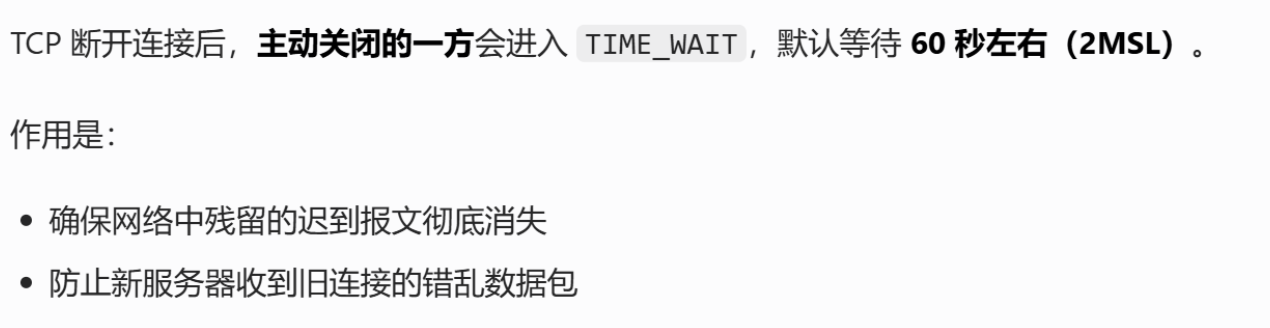
20.什么是timewait?
21.什么是会话?
在 Linux 系统里,会话是进程的一种分组管理单元,一个会话里可以包含多个进程组,最开始由第一个创建会话的进程做会话首进程;我们打开一个终端窗口,这个终端本身就是一个独立会话,你在终端里敲命令运行的程序、启动的服务进程,默认都归属于这个终端会话,一旦关闭终端,会话销毁,里面所有进程都会被系统杀掉。
22.会话和守护进程的关系是什么?
守护进程想要不被终端关闭杀死,关键就是脱离原来的终端会话:创建守护进程时,会主动新建一个独立会话,让自己成为新会话的首进程,脱离原先绑定的终端会话、脱离终端进程组,既不占用终端窗口,也不受终端关闭、会话退出的影响,从此脱离前台终端束缚,永久后台运行;简单说:脱离旧会话、自建新会话,是进程变成守护进程的核心步骤,会话机制就是 Linux 用来帮守护进程脱离终端、实现后台常驻的底层基础。
23.什么是守护进程?
守护进程就是脱离终端、后台静默运行的服务进程,像服务器、日志进程都是它,它不需要依赖终端输入输出,就算关掉终端也不会退出,一直后台跑。
24. 什么是序列化与反序列化?
序列化:内存中的结构体 / 对象,转为可以网络传输、落地保存的数据格式。 反序列化:收到的数据流,还原成程序内存里的结构体。
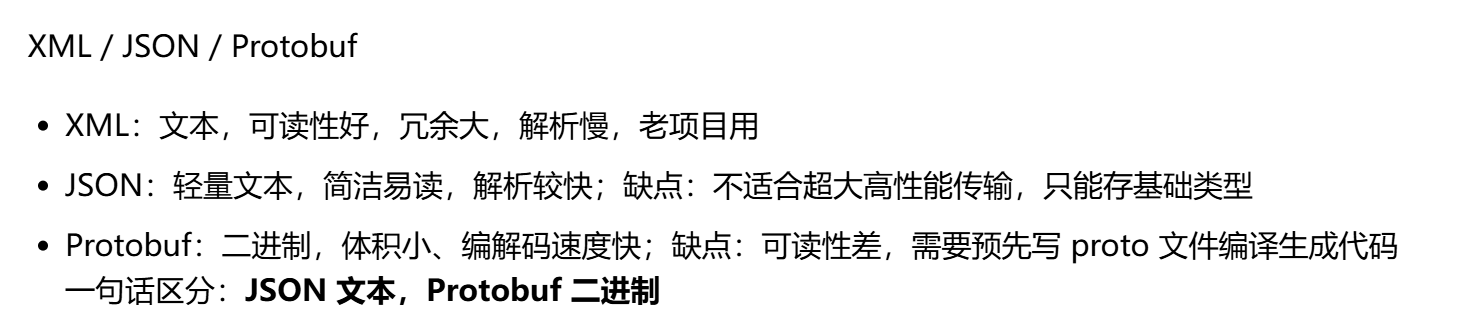
25.列举常见序列化格式,对比优缺点(核心必考)
26.JSON 和 Protobuf 怎么选?什么时候用哪个
SON:配置文件、Web 接口,需要人直接查看、调试的场景
Protobuf:服务器之间高性能网络通信,大量数据传输,追求小包、低 CPU 开销(交换机 / 网络设备通信很爱考这个)
它们都是数据序列化的 "通用语言",让不同程序 / 不同语言之间能看懂、传输和解析数据,只是 XML 和 JSON 是文本格式,Protobuf 是二进制格式,适用场景不同。
27.为什么Tcp是全双工?
因为TCP连接两端,两端分别都有各自的发送缓冲区和接收缓冲区,可以同时接收数据和发送数据,所以认为Tcp是全双工的。
28.TCP 面向字节流是什么意思?会带来什么问题?
TCP不保留应用层的消息边界,把数据当作一连串的字节流进行输出,带来的问题就是粘包,多个多个数据包在缓冲区合并在一起,应用层无法区分原始消息边界,需要我们在应用层自己做分包处理(加长度头 / 分隔符)。
29.TCP的write/send 的时候,是直接把数据发给对端吗?
不是。调用write/send只是把用户态 buffer 的数据拷贝到内核 TCP 发送缓冲区,系统调用返回不代表数据已经发到对方主机。什么时候真正发出去,由操作系统内核 TCP 协议栈控制。这也是为什么TCP叫做传输控制协议的原因。
30.read/recv 的过程,如果接收缓冲区为空会发生什么?
调用 read,本质是把内核接收缓冲区的数据拷贝到用户提供的 buffer 。 如果内核接收缓冲区没有数据,默认会阻塞等待,直到收到数据才返回。
31.TCP 缓冲区是什么结构?TCP 靠什么做流量控制?
TCP 收发缓冲区内核用链表管理。 流量控制:依靠对端的接收缓冲区剩余容量(滑动窗口),发送方根据接收方的窗口大小,控制发送速率,避免发送太快把对方缓冲区打爆
32.全双工和半双工的区别
全双工:双方可以同时收发(TCP); 半双工:同一时间只能一方发,另一方收,不能同时双向传输。
33.粘包怎么解决?
一般在应用层解决,①在报文头部加数据长度 ②设置特殊分割符 ③固定长度报文
34.TCP 的滑动窗口和流量控制是什么关系?
滑动窗口机制用来实现流量控制,窗口大小就是接收缓冲区剩余容量,告诉发送方最多还能发多少字节。
35.简单介绍一下 TCP 协议(最直接原题)
TCP 全称传输控制协议,是传输层可靠协议。特点是面向连接、面向字节流、可靠传输。通信前三次握手建立连接;传输过程依靠确认应答、超时重传、流量控制、拥塞控制,保证有序无差错,丢包会重传、重复报文会去重;通信结束用四次挥手断开连接。适合文件传输、网页这类对数据完整性要求高的场景。
36.TCP 流量控制 和 拥塞控制有什么区别(超级高频)
流量控制 :控制发送方不要把接收方缓冲区打爆,解决收发双方能力不匹配,依靠滑动窗口(接收方告知剩余缓冲区大小)。
拥塞控制 :控制不要把中间网络链路打爆,解决网络拥堵,维护拥塞窗口。
37.什么是面向连接?
通信双方必须先建立连接(三次握手),之后才能传输数据;通信结束正常断开(四次挥手)。UDP 是无连接,不用提前建立。
38.为什么 TCP 需要四次挥手,不是三次?
因为 TCP 是全双工,两个方向独立关闭。一方关闭写通道,另一方还可以继续发数据;等双方都不再发送数据,连接才完全释放。
39.UDP和TCP的区别是什么?
TCP:面向连接、可靠、字节流、有重传 / 流量 / 拥塞控制;开销大。 UDP:无连接、不可靠、数据报;开销小,适合音视频、实时报文传输。
40.什么场景适合 TCP?什么场景用 UDP?
TCP:文件传输、网页、数据库访问,要求数据不能丢。 UDP:视频通话、游戏、实时网络报文,允许少量丢包,优先保证低延迟。
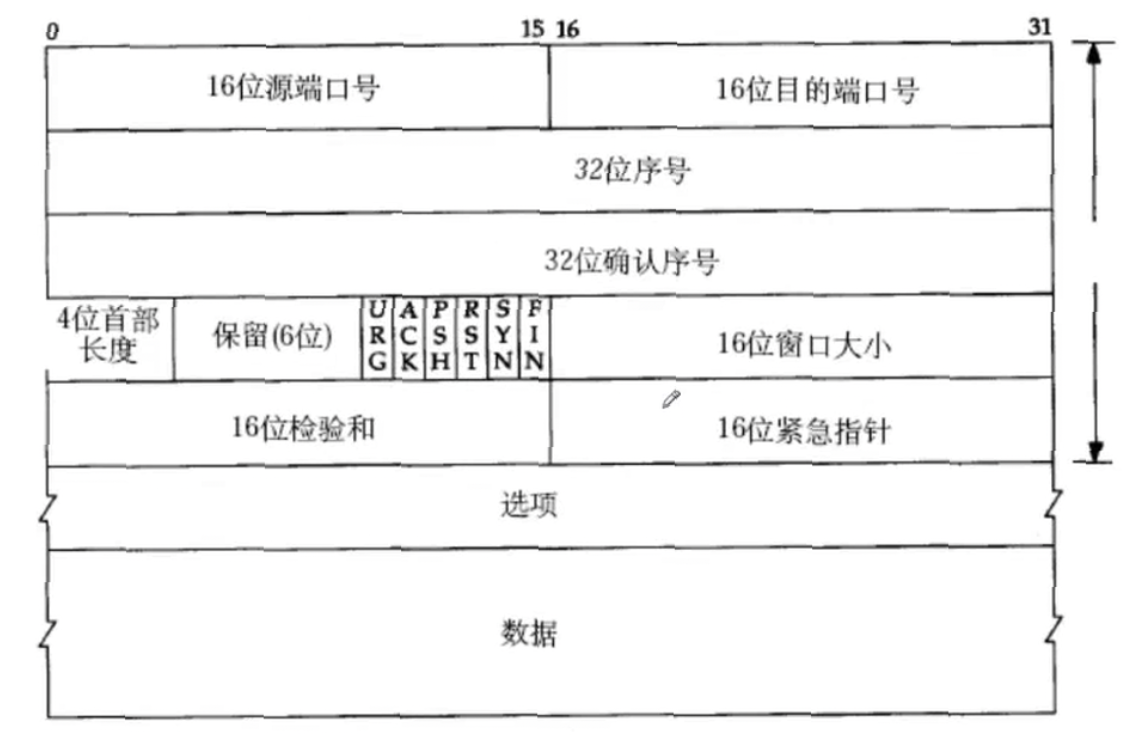
41.TCP报文结构
42.确认应答发的究竟是什么?
发送方发送的是报头+有效载荷,而接收端发送的确认应答则是一裸的TCP报头,并非我们想的只有一个1或者0,这很重要;
43.如果网络很好,还需要拥塞控制吗?
需要。网络状态随时变化,拥塞控制是为了防止发送方发包太多,导致路由器缓存占满、网络大面积丢包,引发网络风暴。
44.4位首部长度的作用是什么?
4 位首部长度,又叫数据偏移,单位是 4 字节。用来标识 TCP 头部的总长度。TCP 头部最小 20 字节,最大 60 字节。接收端通过这个字段跳过 TCP 头部,找到后面携带的数据。
45.TCP 头部为什么不是固定长度?
因为支持可选字段,比如时间戳、MSS 等选项,所以头部变长,需要这个字段标记头部结束位置。
46.32 位序号(Sequence Number)作用
序号对 TCP 每个字节编号,用于接收端完成报文排序,同时识别重复报文,实现去重。
47.32 位确认序号(Ack Number)作用
确认序号代表接收方期望收到的下一字节编号,用来告诉发送方,这个编号之前的数据已经全部接收完毕。
48.为什么同时需要序号和确认序号两个字段?
TCP 是全双工通信,两端可以同时收发数据。
①序号 :标记我方发给对方的数据字节编号;
②确认序号 :标记对方发给我 的数据,我确认收到到哪了。 两个方向的数据独立。同时还有捎带应答机制:接收方在回复业务数据的时候,把 ACK 确认信息 "捎带" 放在同一个报文头部,不用单独发一个纯 ACK 包,减少报文数量,提升传输效率。所以头部必须同时携带序号和确认序号。
49.什么是捎带应答(捎带 ACK,本页重点)
当接收方需要回复业务数据给发送方时,TCP 会把确认 ACK 信息,合并到要发送的业务报文头部一起传回,不再单独发送一个只用来确认的 ACK 报文。 好处:减少网络报文数量,降低开销,提升传输效率。
50.TCP 头部 16 位窗口字段是什么?(基础题)
16 位窗口大小,代表接收端接收缓冲区剩余容量 。接收方在 ACK 报文中把这个值发给发送方,用来做流量控制。发送方不能发送超过窗口大小的数据,防止把对方接收缓冲区打满、造成丢包。 16bit 最多只能表示 65535 字节。如果需要更大窗口,可以在 TCP 选项中启用窗口扩大因子 M,实际窗口 = 窗口字段的值 << M。
51.什么是 TCP 流量控制?流量控制是不是单纯降低发送速度?(红框重点!高频)
流量控制目的:控制发送方速率,不要超过接收方的接收能力,避免接收缓冲区溢出 。 流量控制≠一味减少发送。窗口大的时候,说明对方缓冲区空闲多,可以提高发送量;窗口变小才降低发送量。是动态匹配接收方能力,不是无脑降速。
52.建立连接初期,发送方怎么知道对方接收窗口大小?
在三次握手阶段协商窗口信息。SYN 报文里就携带自身的初始窗口大小、窗口扩大因子等选项。握手完成后,双方就知道对方初始接收能力。后续每次 ACK 报文持续更新窗口。
53.如果接收方窗口变成 0 会发生什么?
接收方返回窗口 = 0,告诉发送方:接收缓冲区满了,请停止发数据。 发送方会停止发送,同时启动零窗口探测 定时器,定期发探测报文(不携带数据的一个裸的报头就叫做窗口探测),查询窗口有没有恢复,避免死锁。
54.流量控制窗口 rwnd 和拥塞窗口 cwnd,哪个由接收方提供,哪个是发送方自己维护?
rwnd(接收窗口)是接收方在 ACK 报文中带给发送方;cwnd 拥塞窗口,是发送端自己估算、维护的。
55.什么时候会触发拥塞窗口减小?
检测到超时重传,或者收到重复 ACK,认为网络发生拥塞,就缩小拥塞窗口。
56.什么是超时重传?
发送方发送 TCP 报文后,操作系统会为这个报文设置超时计时器。 如果在超时时间内,没有收到对应的 ACK 确认应答,发送方就认为报文丢失,会重新发送这份数据,这个机制就是超时重传。 丢包分两种情况:①业务数据报文丢了;②数据到了对方,但是 ACK 应答报文在路上丢了。发送方无法区分这两种情况,超时了都会重传。接收端依靠序号,自动处理重复报文,完成去重。
57.超时时间为什么不能固定?太长、太短会有什么问题
超时设置过长:丢包之后,要等很久才重传,降低整体传输效率。
超时设置过短:网络稍微延迟波动,就误判丢包,触发不必要的重复发包,浪费带宽。 所以 TCP动态计算超时时间,根据网络往返时间 RTT 实时调整,不是固定值。
58.Linux 超时重传等待时间规则(考点)
以 500ms 为基础单位,指数退避:
①第一次超时没收到 ACK:等待 2 × 500ms 后重传
②再次超时:等待 4 ×500ms,以此类推,等待时间指数增长
③重传次数到达上限,TCP 判定网络 / 对端故障,强制关闭连接。
指数退避含义:每次重传失败,翻倍延长等待时间,避免持续大量发包冲击已经拥堵的网络
59.超时重传和快速重传的区别
- 超时重传:等待计时器到期才重传,被动触发,等待时间长。
- 快速重传:收到 3 个重复 ACK,不等超时定时器到期,立刻重传,更快恢复。
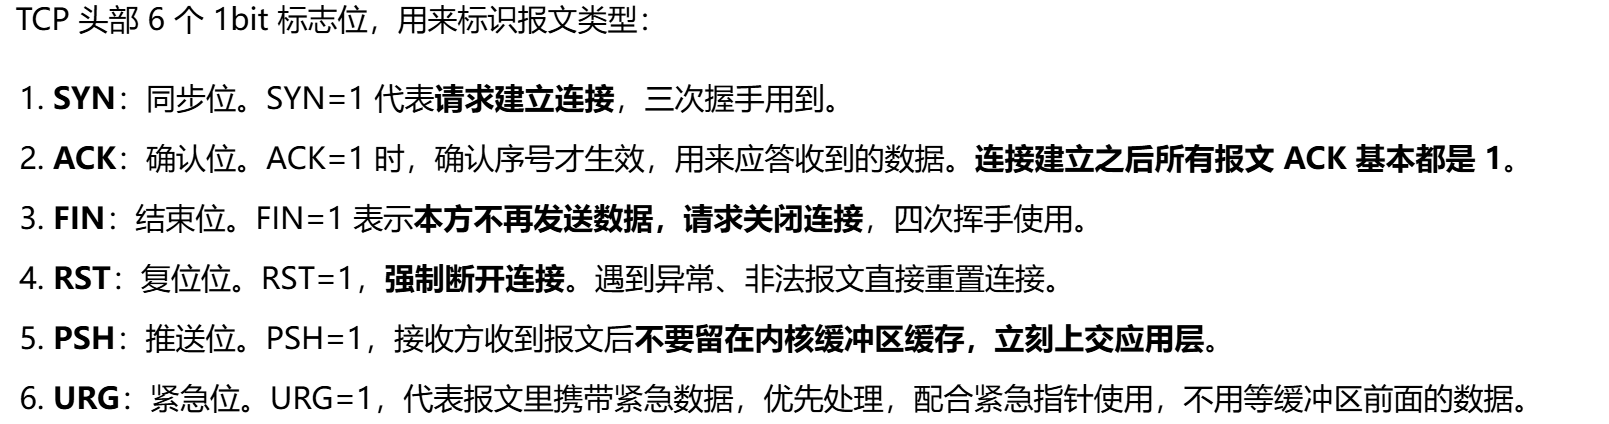
60.请介绍 TCP 的 6 个标志位分别是什么,作用?
61.简述三次握手过程(必问)
①客户端发送SYN 报文 ,请求建立连接,客户端状态变为 SYN_SENT
②服务端收到,回复SYN+ACK 报文 :SYN 代表服务端也同意建立连接;ACK 确认客户端的 SYN。服务端状态变为 SYN_RCVD
③客户端收到 SYN+ACK,回复ACK 报文 。双方状态都变成ESTABLISHED,连接建立完成。
原理:第二次报文把 SYN 和 ACK 合并在一个包,这个就叫捎带应答,所以原本四次交互合并成三次握手。
62.为什么是三次握手,不是两次?
核心要验证双方收发能力都正常 。 两次握手只能证明:客户端能发、服务端能收。但是服务端无法确认,服务端发给客户端的报文,客户端能不能收到。 三次握手可以验证:客户端、服务端收发双向通路都正常。
63.connect、accept 和三次握手的关系(很爱问)
①connect:客户端系统调用,触发内核发送 SYN,内核完成握手,握手成功 connect 函数才返回;connect 本身不参与握手报文组装,只是触发。
②listen:提前准备,内核维护半连接队列、全连接队列。
③accept:不参与三次握手。三次握手全部由内核完成;accept 只是从内核全连接队列取出已经握手成功的连接,返回新的套接字。
64.最后一次 ACK 丢了会怎么样?
客户端认为连接建立成功;服务端没收到 ACK,停留在SYN_RCVD,不会进入 ESTABLISHED。超时之后服务端会重传 SYN+ACK,多次失败就丢弃连接。
65.什么是半连接队列什么是全连接队列
服务端调用 listen 之后,内核维护两个队列:
①半连接队列(SYN 队列):保存收到 SYN 报文、进入 SYN_RCVD 状态,握手还没完成的连接。当收到客户端 SYN,放入这个队列,并回复 SYN+ACK。
②全连接队列:三次握手成功,连接状态变为 ESTABLISHED,连接就迁移到全连接队列。accept 就是从全连接队列拿连接。 当全连接队列满的时候,新握手完成的连接无法入队,会丢弃或者直接回复 RST,导致客户端连接失败。
66.如果全连接队列满了会发生什么?
Linux 默认情况下,新完成握手的连接无法放进队列,直接丢弃;客户端可能出现 connect 超时失败。
67.SYN 攻击是什么?
攻击者大量发送 SYN 报文,但是不回复最后一次 ACK。大量连接卡在半连接队列,把半连接队列打满。正常用户发 SYN 直接被丢弃,无法建立连接,实现拒绝服务。
68.为什么挥手是四次,握手能合并成三次?
握手阶段:SYN(建连请求)和 ACK(确认)可以捎带,合并成一个包。
挥手阶段:收到 FIN 之后,服务端可能还有业务数据没发完,不能立刻发送 FIN。ACK 和 FIN 不能打包在一起,所以必须分成两个报文,总共四次。
特殊场景:服务端没有剩余数据,ACK+FIN 可以合并,四次挥手简化成三次,但是属于特例。
69.TIME_WAIT 是什么?为什么需要等待 2MSL?
① 保证最后这个 ACK 报文能到达服务端。如果 ACK 丢包,服务端会重发 FIN,客户端还能再次回复 ACK。
② 等待网络中残留的旧报文全部消失,防止旧连接的延迟报文,被新建立的连接接收,造成脏数据。
70.如果服务端收到客户端 FIN 之后,一直不调用 close 会发生什么?
服务端停留在CLOSE_WAIT状态,对应的文件描述符不会释放。文件描述符资源泄漏,持续占用内核内存;文件描述符耗尽之后,accept会失败,新客户端无法接入服务。
71.TCP的三种丢包场景
①最左侧丢包,确认序号只有1,表示没有收到1-1001的内容;
②中间丢包,确认序号1001,表示只收到了1-1001的内容,后面的都需要重传
③最右侧丢包,和最左侧丢包的逻辑一样
72.什么是快重传
当报文段丢失之后,接收方收到后续正常报文,会持续回复同一个重复的确认 ACK 。 发送方连续收到 3 个重复 ACK ,不等超时计时器到期,立刻重传丢失的报文段,这个机制就叫快重传。 特点:不用等超时时间,更快恢复丢包,提升传输效率。
73.快重传和超时重传的区别
- 超时重传:等待超时计时器到期才重传,被动等待,等待时间长。
- 快重传:收到 3 个重复 ACK 就主动重传,不用等超时,丢包恢复更快。
74.为什么是 3 个重复 ACK,不是 2 个?
防止网络中 ACK 报文乱序(单纯网络延迟乱序,不是丢包)造成误触发重传。 如果只是网络乱序,一般只会产生 1~2 个重复 ACK;连续 3 个重复 ACK,大概率是报文真的丢了。
75.什么是延迟应答机制?
接收方收到数据,不马上回 ACK,短暂等待,尽量合并多个确认,减少 ACK 小包,节省网络资源;还支持捎带应答。不能无限延迟,有超时上限,防止发送方超时重传。
76.HTTP 是什么?在哪一层?HTTP 是有状态还是无状态?
HTTP 基于 TCP:HTTP 是应用层协议,本身不负责网络传输,依靠 TCP 完成可靠的数据收发,TCP 负责连接、重传、拥塞控制。
应用层协议,基于 TCP;无状态,服务器不保存上一次请求信息,靠 Cookie/Session/JWT 来维持会话。
无状态:服务器默认不会记住客户端历史请求。每一条 HTTP 请求都是独立的,服务器无法区分两次请求是不是同一个用户,不会保存上一次请求的用户信息。
Cookie 保存在浏览器客户端。登录成功后服务器下发 Cookie,后续浏览器每次请求自动带上 Cookie。Cookie 里面通常存放 sessionId。
Session 保存在服务端,根据 Cookie 携带的 sessionId,找到保存在服务器上的用户会话信息,从而识别同一个用户,维持登录状态。
77.GET 和 POST 的区别(超级高频)
- GET:参数放在 URL,有长度限制,一般用于查询,幂等,可缓存
- POST:数据放请求体,适合提交、上传,不幂等
78.http状态码
- 200 成功,201 创建成功,204 无返回内容
- 301 永久重定向(会缓存);302 临时重定向;304 协商缓存命中
- 400 请求错误、401 未认证、403 禁止访问、404 找不到资源、405 方法不允许
- 500 服务器内部错误,502 网关错误,503 服务不可用
79.HTTP 和 HTTPS 区别?HTTPS 握手流程
HTTP 明文,80 端口;HTTPS=HTTP+TLS,443 端口,加密、身份认证、防篡改,需要 CA 证书,握手有 RTT 开销
80.put post get三者的区别
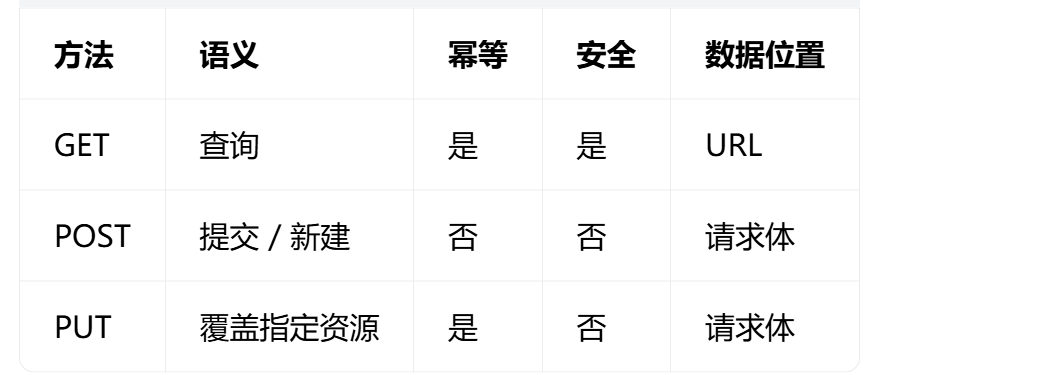
什么是幂等?多次发起同一个请求,对服务器产生的业务效果和只执行一次完全一样,不会产生额外副作用,就是幂等。
81.PUT 和 POST 都能新增资源,怎么区分?
核心看资源位置是谁决定。PUT 是客户端知道资源唯一 id,直接操作这个地址;POST 是客户端不知道 id,提交给集合,由服务器生成 id。
82.Cookie 是服务器自动下发的吗?
是的,通过 Set-Cookie 响应头下发。
83.如果我把浏览器 Cookie 删掉会发生什么?
Cookie 里面的 sessionId 丢失,下次请求不带编号,服务器找不到 Session,需要重新登录。
84.UDP协议的样子
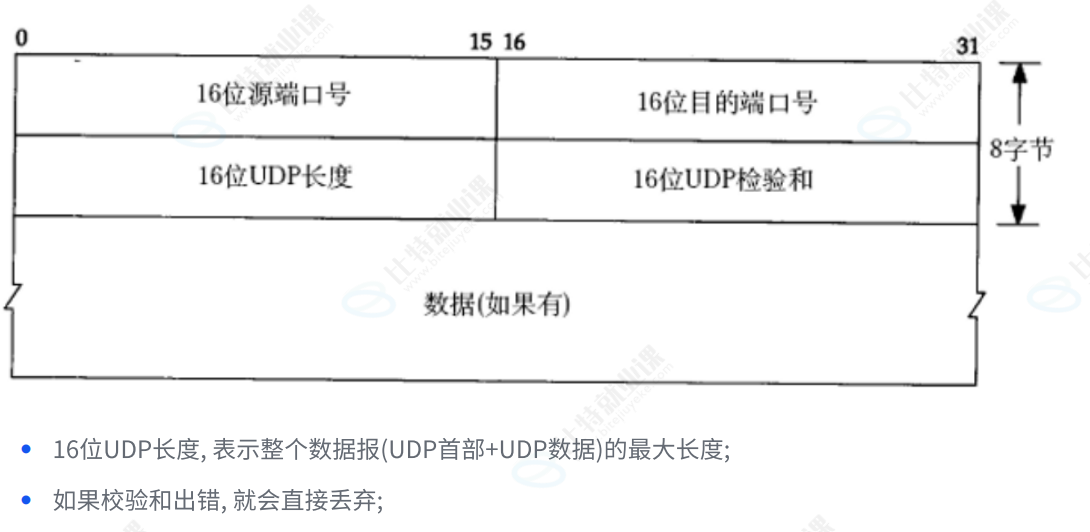
84.UDP 头部 和 TCP 头部的核心区别
①UDP首部固定 8 字节;TCP 头部是 20~60 字节,可变长,有选项字段。
②UDP:无序号、无确认 ACK 字段,不保证可靠、不做重传;TCP 有序号、确认应答,保证可靠传输。
③UDP 只有长度字段;TCP 没有长度字段,靠 IP 头部的总长度减去头部算出数据长度。
④UDP 校验和是可选(部分系统可关闭);TCP 校验和强制启用。
⑤UDP 没有窗口、紧急指针、标志位(SYN/ACK/FIN 等);TCP 全部都有。
85.什么叫做udp的无连接?
⽆连接: 知道对端的IP和端⼝号就直接进⾏传输, 不需要建⽴连接;
86.UDP 有没有发送缓冲区?接收缓冲区呢?(必考)
UDP没有真正的发送缓冲区 ,调用sendto直接交给内核,内核往下传给网络层。 UDP有接收缓冲区 ,用来缓存收到的 UDP 数据包;但是不保证包顺序和发送端一致;缓冲区满了之后新来的包直接丢弃。
87.CP 发送缓冲区和 UDP 的区别?
TCP 有发送缓冲区,没收到 ACK 前数据会留在缓冲区等待重传。UDP 不需要重传,所以不需要发送缓冲区。
88.UDP socket 是全双工吗?
是全双工,同一个 UDP socket,既能收数据,也能发数据,读写可以同时进行。
89.UDP 接收缓冲区的特点(高频)
①报文是一个个独立的数据包,不会像 TCP 字节流那样粘包;
②不保证顺序,先发的包可能后到;
③缓冲区满,新来 UDP 包直接丢包,不会阻塞发送方。
90.基于 UDP 的应用层协议(背诵)
DNS、DHCP、TFTP、NFS、BOOTP。
面试经常问:DNS 为什么选用 UDP? DNS 请求报文很小,UDP 开销小、不需要建立连接,速度快;如果返回报文太长,会走 TCP。
91.UDP 是面向数据报,TCP 面向字节流,结合缓冲区怎么理解?
UDP 一次 recvfrom,读取一个完整的 UDP 报文,不会读到半个包;TCP 是字节流,没有边界,会出现粘包拆包。
92.如果问我有没有用过 wireshark 在什么场景用的,我该怎么回答,
我用过 Wireshark 做网络抓包分析,主要是在开发频谱上位机项目的时候使用。 项目里 FPGA 通过 UDP 向上位机持续发送 IQ 原始采样数据包。遇到丢包、乱序的问题时,我用 Wireshark 抓包:
①查看 UDP 报文,检查自定义包头里的序列号、时间戳是否正常;
②观察报文到达情况,定位是 FPGA 发送侧、网络链路,还是上位机接收缓冲区满导致的丢包;
③校验数据包长度,排查数据截断、报文解析异常的问题。
Linux 环境下我也了解 tcpdump,是命令行抓包工具,适合服务器环境抓包;Wireshark 带图形界面,方便直观查看每一层协议的详细信息,调试阶段排查问题更方便。
93.不同进程的 fd 是独立的吗?
是的。fd 只在当前进程内部有效。同一个数字,在 A 进程是 socket,在 B 进程可能是普通文件。父子进程 fork 之后,子进程会拷贝父进程的文件描述符表。
94.fd 和 FILE*(fopen 返回的)区别?*
fd 是内核层面的整数(系统调用 open 返回);FILE 是 C 库的用户态文件指针,里面封装了 fd,自带用户态缓冲区。fileno()可以从 FILE * 拿到 fd。
95.什么叫做IO多路复用?
如果一个连接开一个线程,大量连接会带来巨大内存和上下文切换开销;如果单线程非阻塞轮询,会持续占用 CPU。 IO 多路复用让单个线程阻塞在内核,同时监听多个 fd。没有事件(读、写、异常事件)时线程休眠不占 CPU;只要任意 fd 就绪,内核唤醒线程处理,用少量线程管理大量连接,提升并发能力。
96.什么是select?
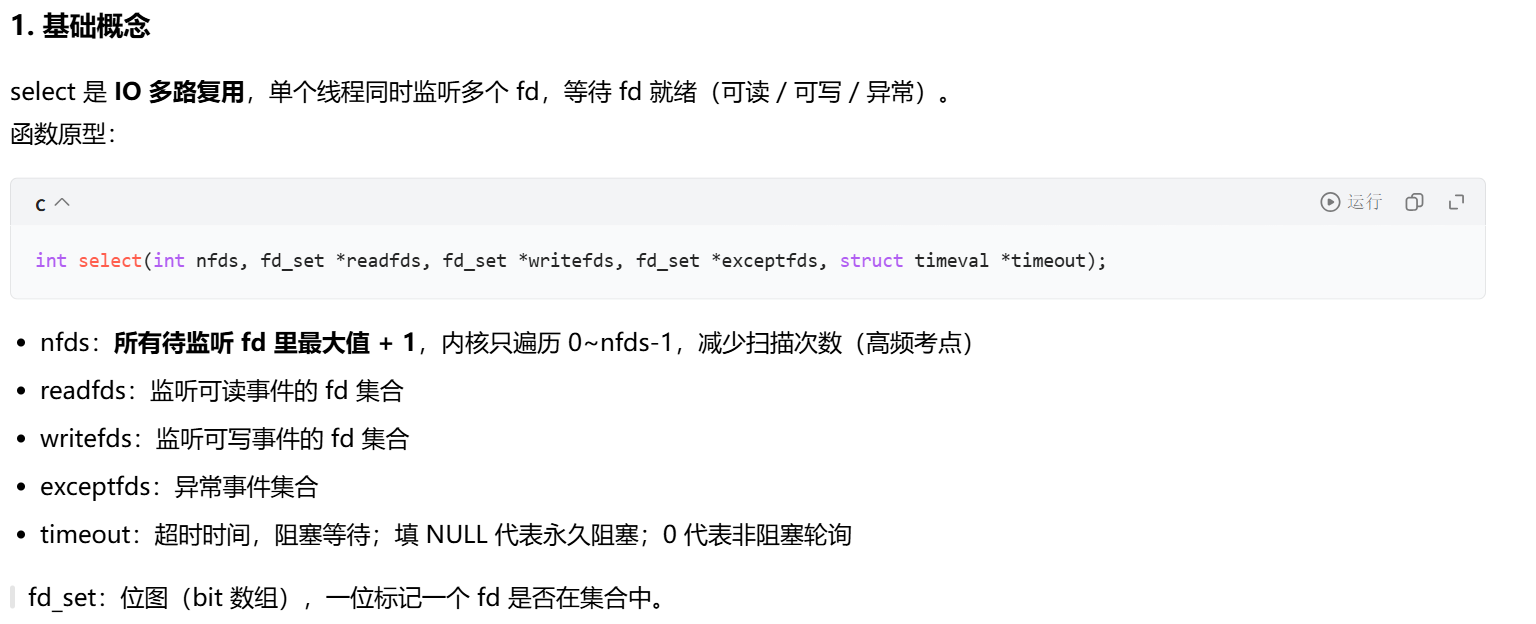
97.select的特点是什么?
①fd_set 是传入传出参数 内核会修改这个位图:清除没有就绪的 fd,只保留就绪 fd 。 所以每一轮 select 循环之前,必须 FD_ZERO 清空 + FD_SET 重新添加所有 fd,否则下一轮部分 fd 不再被监听。
②有硬上限:FD_SETSIZE 默认 1024 fd 位图固定大小,只能监听 0~1023 的文件描述符。可以改宏重编内核,但工程不推荐。
③返回之后,用户代码必须遍历所有 fd,判断哪个就绪 select 只会告诉你 "有事件来了",不会直接返回就绪 fd 列表,需要循环 FD_ISSET 挨个检查。
98.select 的优缺点
①优点:跨平台兼容性最好,Windows、Linux 都支持。
②缺点:
最多监听 1024 个 fd;
每次调用,都要把整个 fd 集合从用户态拷贝到内核;
内核轮询扫描全部 fd;返回后用户态还要遍历 fd 找就绪项;
每次循环都要重新构建 fd_set 集合。
99.水平触发 LT(select/poll只支持 LT)
LT 水平触发:只要缓冲区数据还在,每次 select 都会持续通知就绪。 举例:缓冲区有 1000 字节,你本次只读了 200 字节,剩下 800 还在内核缓冲区。下一次 select 依然会继续触发可读事件。
风险:如果只读一部分数据,事件反复触发,容易造成死循环,一般搭配非阻塞 IO。
100.LT 和 ET 在这里的区别?
LT:数据还在缓冲区,每次多路复用都通知;
ET 边缘触发:只有新数据到达的一瞬间通知一次 ,如果这次不全部读完,剩下的数据不会再触发事件,会造成数据滞留。所以 ET 强制要求非阻塞。机会只有一次 ,事件通知一闪而过。必须在这次回调里,循环读,一直读到缓冲区空,read 返回 EAGAIN,确保全部数据拿完,不然残留数据永远不会再有事件提醒。
101.poll和select的关系
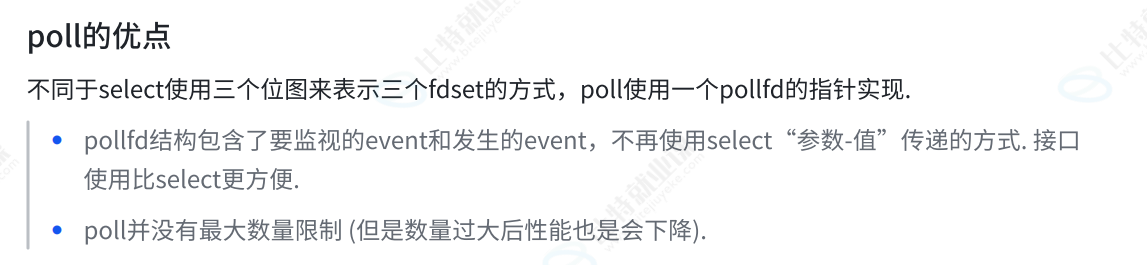
select 有 1024 上限,位图,fd_set 会被内核修改,每次循环重建集合; poll 用 pollfd 数组,无 1024 上限,内核只修改 revents,不用重建监听集合; 二者底层都是轮询,大量连接性能都差,都是 LT。
102.poll的特点
103.epoll的特点
104.select/poll/epoll的区别
- select/poll:每次调用拷贝全部 fd;内核轮询扫描所有 fd;返回后用户遍历全部 fd;只有 LT;有 1024 上限。
- epoll:fd 一次性注册;内核就绪链表,只返回就绪
- fd;LT+ET 双模式;无 1024 硬限制。连接越多,epoll 优势越明显。
105.epoll 底层数据结构?
红黑树保存所有注册的 fd;就绪链表存放已经发生事件的 fd。
106.epoll 有什么缺点?
跨平台差,只在 Linux 支持,Windows 没有 epoll。