一 支持的事物隔离
达梦几种隔离级别都支持,默认的隔离级别是读已提交。
|-------------------|------------|
| 隔离级别\数据库 | 达梦 |
| 未提交读 | 支持 |
| 已提交读 | 支持(默认) |
| 可重复读 | 支持 |
| 可串行化 | 支持 |
|--------------------|------------|---------------|------------|
| 隔离级别 \ 解决 | 脏读 | 不可重复读 | 幻读 |
| 未提交读 | 可能 | 可能 | 可能 |
| 已提交读 | 不可能 | 可能 | 可能 |
| 可重复读 | 不可能 | 不可能 | 可能 |
| 可串行化 | 不可能 | 不可能 | 不可能 |
二 相关验证
2.1 读未提交
查看当前的隔离级别
|------------------------------|
| select isolation from v$trx; |
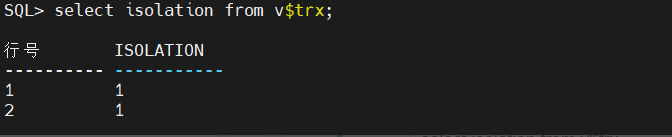
1表示为默认的读已提交,0为读未提交,3为可重复读与可串行读。
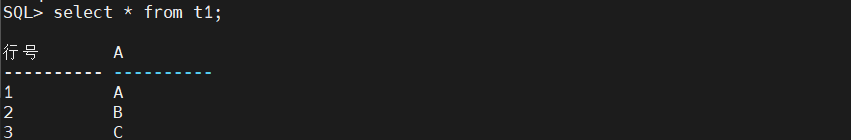
查看当前T1表中的数据
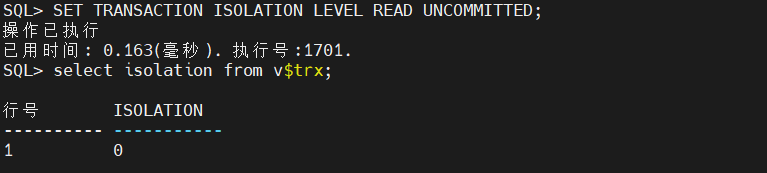
新开会话,修改当前会话隔离级别为读未提交。
|---------------------------------------------------------|
| SQL> SET TRANSACTION ISOLATION LEVEL READ UNCOMMITTED; |
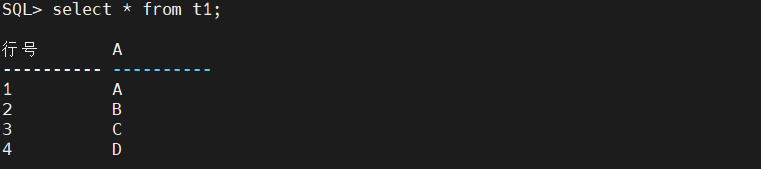
在另一个会话中插入一行新数据,不用提交,回到会话1中查看数据
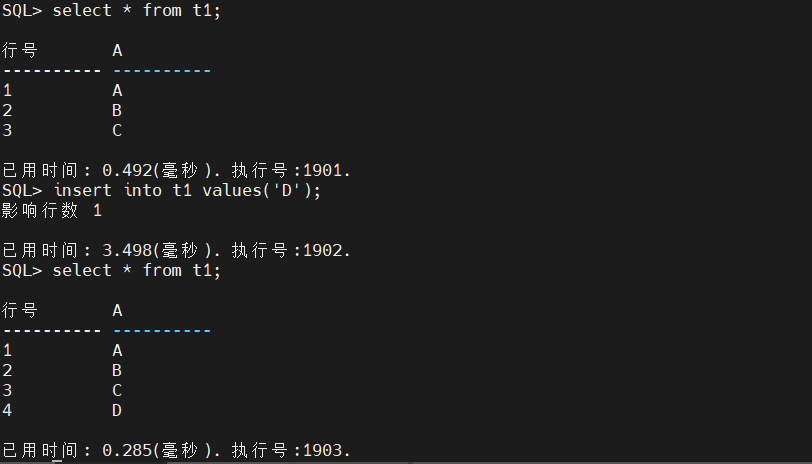
会话1:
此时的会话1能够查到会话2没有提交的数据。
2.2 读已提交
读已提交是达梦的默认隔离级别,只能查询到其他事物提交之后的数据。
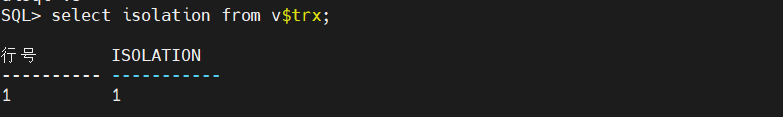
新开一个会话,查看当前的隔离级别。
|------------------------------|
| select isolation from v$trx; |
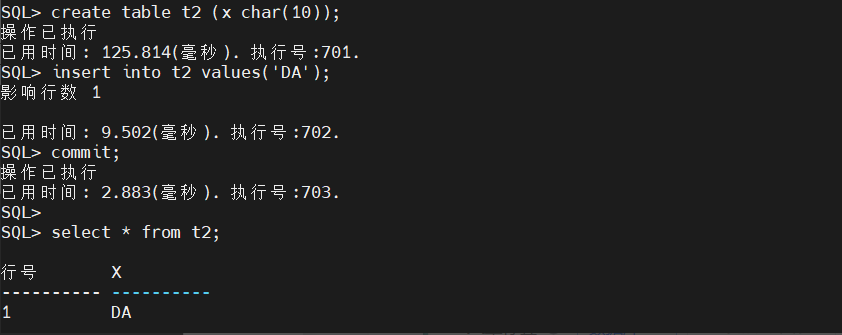
构建T2表,插入一行数据
新开一个会话,插入一行数据不提交。
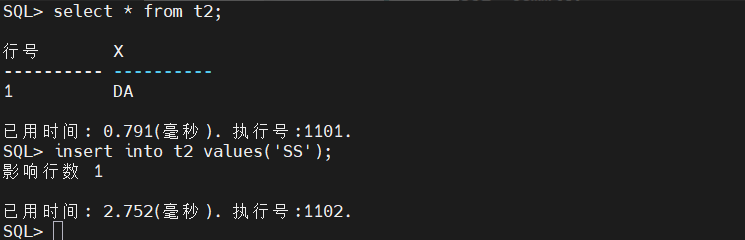
回到会话1查看是查询不到新插入的数据的。
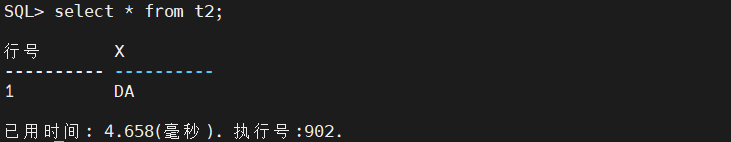
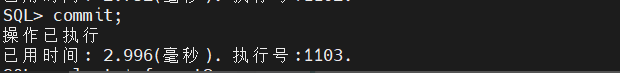
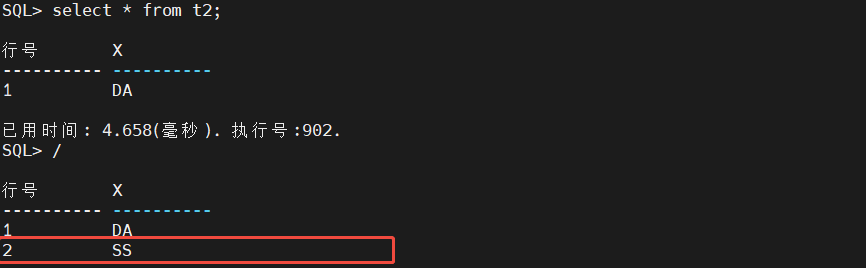
在会话2中提交后返回会话1查看
会话1:能看到添加的数据能够查看到了。
2.3 可重复读
构建新表T3,并插入新的数据。
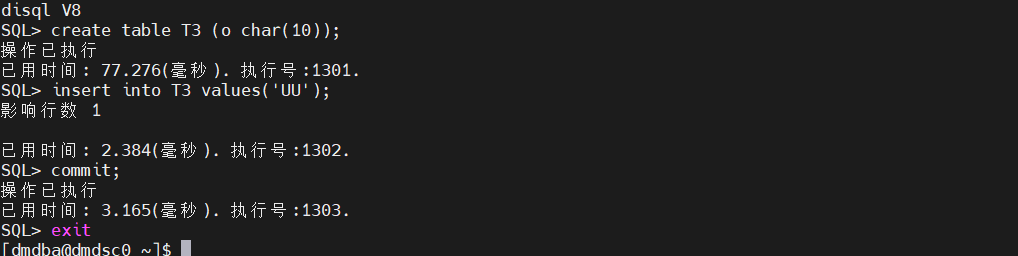
新开一个会话并设置隔离为可重复读。
|---------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| SQL> SET TRANSACTION ISOLATION LEVEL repeatable read ; 操作已执行 已用时间: 7.290(毫秒). 执行号:1501. SQL> SELECT isolation FROM V$TRX; 行号 ISOLATION ---------- ----------- 1 3 |
在当前会话中修改一行数据的值但是不提交。
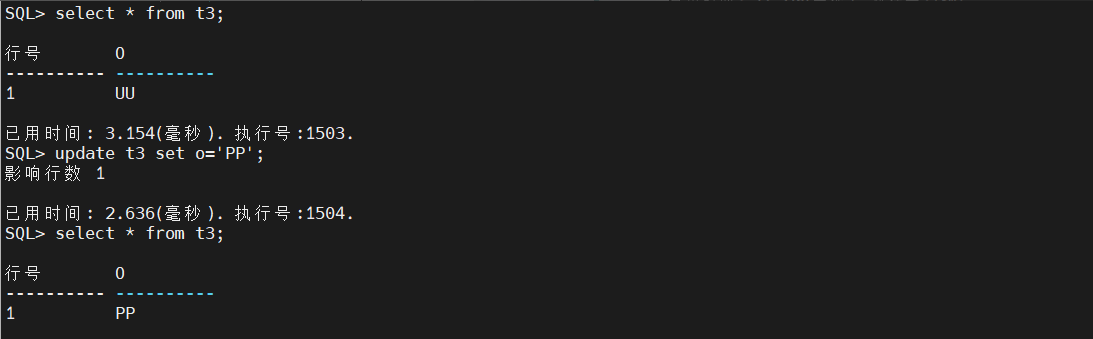
此时会话1已经正常修改。
新开一个会话2并设置隔离为可重复读。
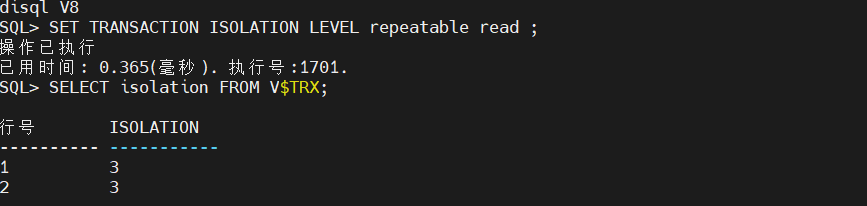
在会话2中查看T3表的数据,能看到还是修改之前的。
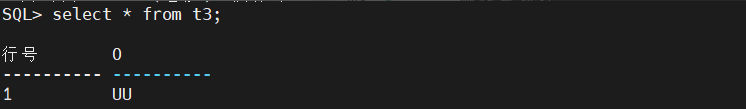
此时在会话1中提交数据,返回会话2再次查看。

会话2看到的还是修改之前的。
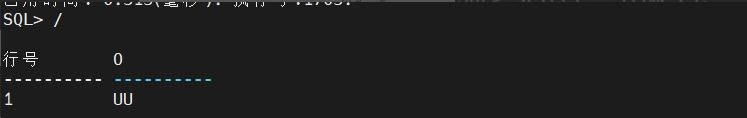
其他会话修改并提交的数据不会影响当前会话的读取结果。这保证了在同一个事务中多次读取同一数据时,能够得到相同的结果。
2.4 可串行读
验证过程与结果跟可重复度类似,可串行读要求消除不可重复读取和幻像读现象,本身查询不会增加任何代价,但是当串行化事物更新或者删除数据时,其他事物会被当前事物阻塞,只有当串行化事物提交或者回滚后才会释放,报错:"串行化事物被打断"。
创建新表,插入数据。
|-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| SQL> create table t4 (id number(10),name char(10)); 操作已执行 已用时间: 94.853(毫秒). 执行号:2101. SQL> insert into t4 values(1,'AA'); 影响行数 1 已用时间: 3.777(毫秒). 执行号:2102. SQL> commit; 操作已执行 已用时间: 2.794(毫秒). 执行号:2103. SQL> select * from t4; 行号 ID NAME ---------- -- ---------- 1 1 AA 已用时间: 2.977(毫秒). 执行号:2104. |
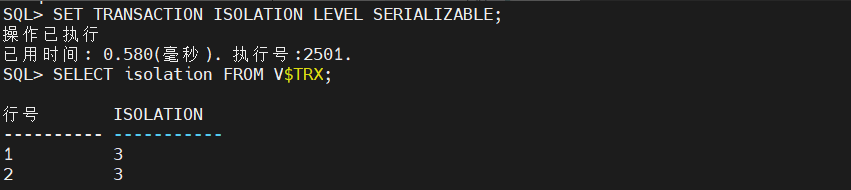
新开会话1,设置隔离级别为可串行读
|--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| SQL> SET TRANSACTION ISOLATION LEVEL SERIALIZABLE; 操作已执行 已用时间: 1.634(毫秒). 执行号:2301. SQL> SELECT isolation FROM V$TRX; 行号 ISOLATION ---------- ----------- 1 3 已用时间: 0.197(毫秒). 执行号:2302. |
更新新表数据但是不提交
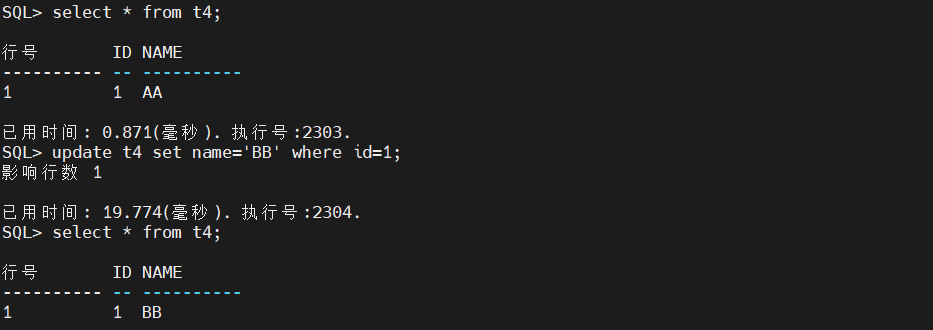
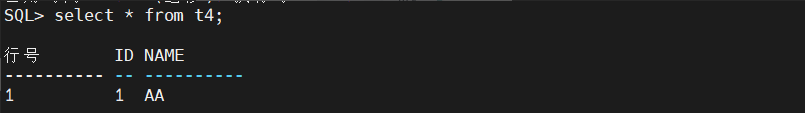
新开一个会话2设置隔离级别为可串行读。查看T4表数据
此时还是修改之前的数据
在会话1中提交

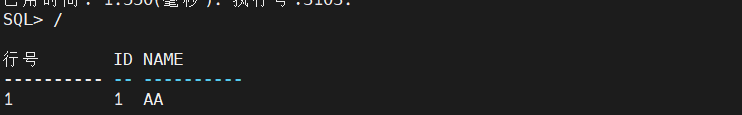
会话2查看还是修改之前的数据。
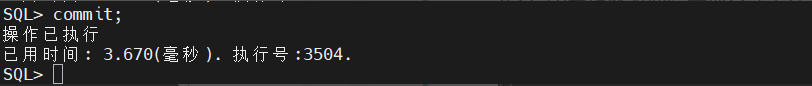
此时在会话1中再更新一下数据不要提交。
|-----------------------------------------------------------------------------|
| SQL> update t4 set name='CC' where id=1; 影响行数 1 已用时间: 3.637(毫秒). 执行号:3006. |
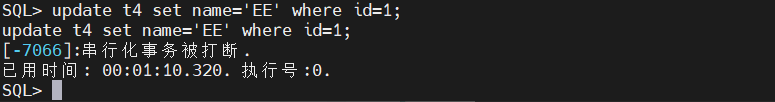
在会话2中也修改此行发现会话卡住。

在会话1中commit或者rollback之后这边会话才能结束。
此时会话2出现串行化事物被打断
MVCC机制
达梦数据库为用户提供了两种MVCC模式,通过参数TRX_VIEW_MODE控制:
1.基于回滚记录的MVCC(TRX_VIEW_MODE=0):
数据行包含事务TID和版本指针RPTR,使得记录间单向连接,形成链式版本结构。
事务根据当前活动事务的视图,依据链式版本结构,构成可见的记录集合\[\]。
2.基于时间戳的MVCC(TRX_VIEW_MODE=1):
全局维护一个大数组CMTARR(Commit Array),长度由参数TRX_CMTARR_SIZE控制(单位:百万)。事务在启动时获取一个时间戳SNAP_CMTSEQ,提交时将CMTARR中对应位置(事务号)的值设置为当前时间。数据版本的可见性通过比较SNAP_CMTSEQ和CMTSEQ来判断:如果SNAP_CMTSEQ >= CMTSEQ,则数据版本可见;否则不可见。

默认为基于时间戳的MVCC。
1、进行多版本读时,这个视图的使用方式是这样的:
在形成活动事务视图TRX_VIEW时,一个事务还收集当前最下活动事务号MIN_ACTIVE_ID,以及全局下一个事务号NEXT_ID。这样,一个事务在读一条记录时,就可以进行如下的比对:
|---------------------|-------|
| 记录事务ID大于(等于)下一个事务ID | 记录不可见 |
| 记录事务ID等于自身事务ID | 记录可见 |
| 记录事务ID小于当前最小已激活事务ID | 记录可见 |
| 记录事务ID不在事务视图中 | 记录可见 |
| 记录事务ID在事务视图中 | 记录不可见 |
对于可见的记录,则取这条记录为最终版本;对于不可见的记录,则通过链式版本继续向这条记录的过往版本进行上述的比对,直到找到可见的版本(或不取这条记录)。
2、DM数据库提供给用户第二种MVCC方式,也是当前版本DM数据库的默认MVCC方式,即基于时间戳的MVCC。
这种MVCC的实现方式是,全局只维护一个大数组CMTARR(长度一般在千万级);DM数据库令事务在启动时,将这个数组中对应位置(事务号)上的数据CMTSEQ置为0,而在事务提交时,则将这个位置上的数据CMTSEQ置为当前的时间。
这样的话,事务或SQL启动时,只需要获取一个当前的时间戳SNAP_CMTSEQ,再与记录ID在CMTARR对应位置上的时间戳比对,就可得出可见与否了。具体比对方式如下:
|------------------------|-----|
| SNAP_CMTSEQ >= CMTSEQ | 可见 |
| SNAP_CMTSEQ < CMTSEQ | 不可见 |
这个大数组的长度,可以由静态参数TRX_CMTARR_SIZE控制(单位:百万)。这个参数设置 越大,内存消耗越多;单位时间内事务完成数量大时,可将此参数值设大。
DM在这种MVCC策略下,对于"长事务",也有对应的处理方案。
所谓"长事务",就是事务号<下一个事务号-(数组长度/2)的事务,即当前的下个事务(即全局最新的事务)与这个长事务间隔超过了CMTARR数组长度的一半,也就是执行时间超长,以至于在其执行期间由大量新事务启动的事务。