作者:来自 Elastic Sergey Sidorov, Felix Barnsteiner
PromQL 运行在与 ES|QL 相同的 Elasticsearch 计算引擎上,无需插件,也无需运行单独的进程进行运维。要实现这一点,我们需要改变引擎评估时间窗口和构建分组键的方式。
上手体验 Elasticsearch:深入了解我们在 Elasticsearch Labs 仓库中的示例 notebook,开始免费云试用,或者现在就在你的本地计算机上试用 Elastic。
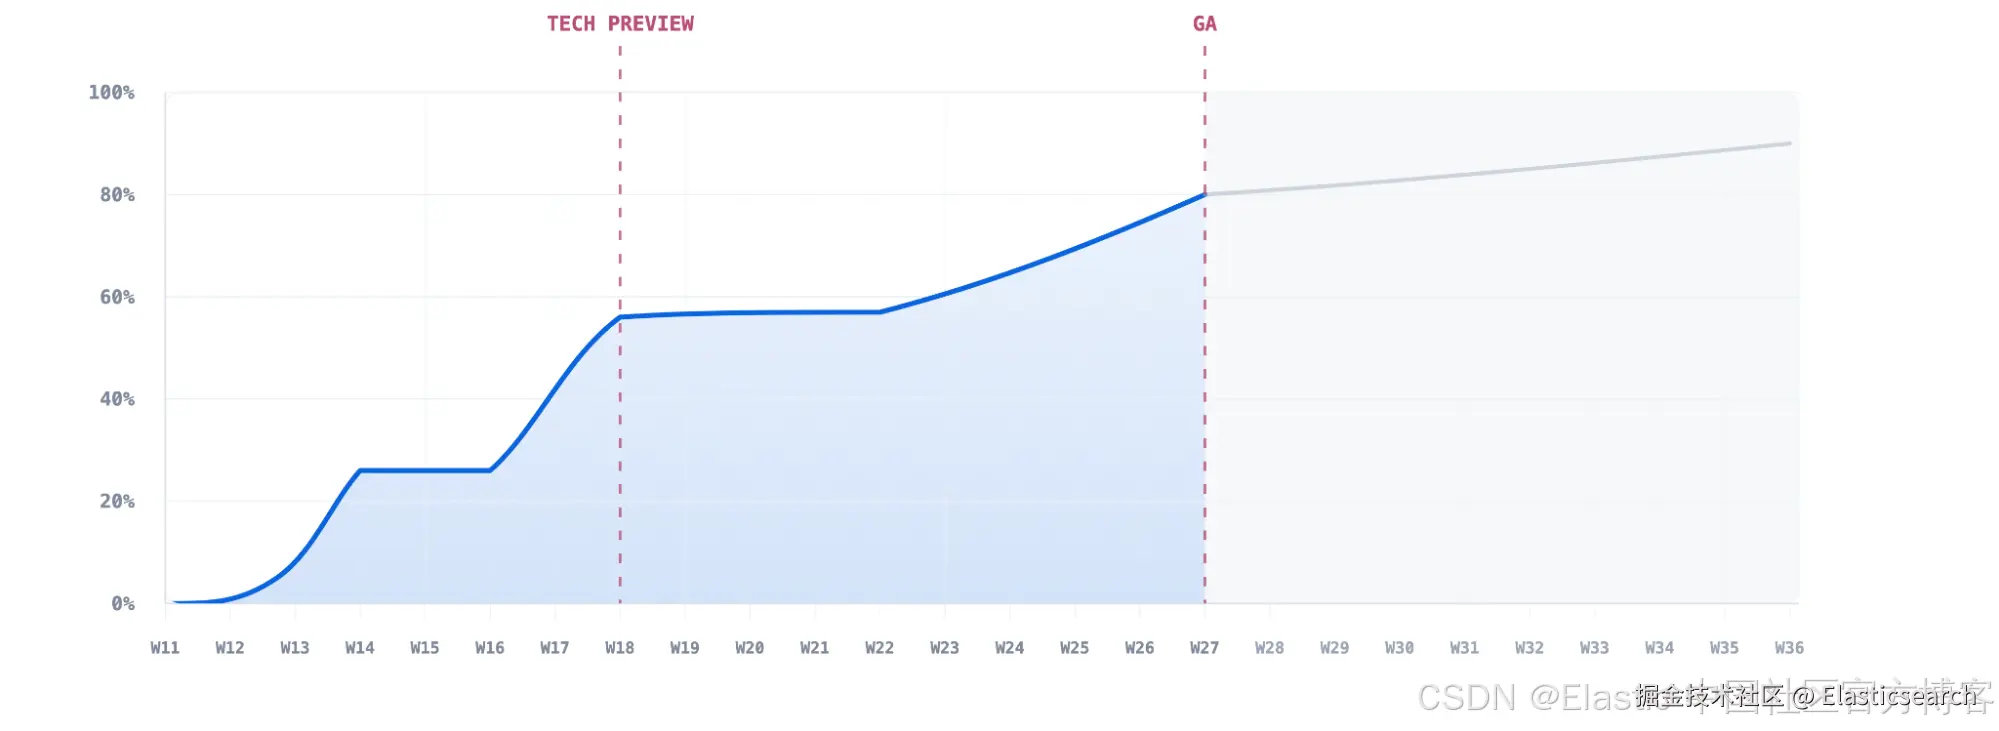
在我们的真实世界查询语料库中,超过 80% 的 Prometheus 查询语言(PromQL)查询无需修改即可在 Elasticsearch 上运行。Elasticsearch 9.5 让 PromQL 和兼容 Prometheus 的 API 正式发布,因此你可以通过远程写入导入 Prometheus 指标,并通过 Prometheus HTTP API 或 Elasticsearch 查询语言(ES|QL)中的 PROMQL 命令查询这些指标。
PromQL 会编译到运行 ES|QL 的同一个计算引擎中,并继承其规划器和 分布式 执行能力,以及相同的发布流程。我们没有为此构建第二个引擎,也无需安装插件。
这篇文章介绍我们是如何构建它的。
主要要点:
-
**一个引擎:**该实现将 Elasticsearch 成熟的分布式规划、存储和测试基础设施,与其较新的计算引擎结合起来,后者提供基于列式的数据执行运行时。这使 PromQL 可以复用经过验证的 Elasticsearch 能力,同时通过现代化的原生向量化流水线执行,而无需引入单独的运行时。
-
**一个服务器:**Elasticsearch 直接实现 Prometheus 远程写入和查询 API,因此兼容 Prometheus 的数据写入和查询无需任何额外插件即可运行。
-
**针对效率进行工程优化:**支持 PromQL 需要为引擎增加新的基础能力,包括范围对齐的评估网格、向后查看的时间窗口、动态标签分组、流水线结果重塑以及紧凑的宽型聚合键。这些基础能力使 PromQL 查询能够端到端高效执行,相关语义直接在计算引擎中实现,而不是通过外部后处理实现。
-
**通过真实使用场景衡量兼容性:**除了 Prometheus 兼容性测试之外,我们还针对从公共代码仓库收集的 2,000 多条 PromQL 查询,构建了差分测试和质量控制流水线。
了解更多:
为什么要在 Elasticsearch 上运行 PromQL
许多团队已经将日志和 跟踪数据 存储在 Elasticsearch 中,同时在 Prometheus 或其他专用指标后端中运行指标。
Prometheus 及其生态系统功能强大且得到广泛采用,但大规模部署也可能带来运维系统繁杂、扩展方面的挑战,以及有限的数据保留时间。
因此,我们着手将 Elastic 高度优化的时间序列数据库(TSDB)与一流的指标生态系统结合起来。最终得到的是一个更加精简的可观测性技术栈,需要运维的系统更少,同时指标存储可以进行水平扩展并支持长期数据保留。
一个引擎:PromQL 和 ES|QL 共享相同的计算引擎
我们很早就做出了一个架构决策:不在 Elasticsearch 旁边运行一个独立的 PromQL 引擎。
相反,PromQL 是 Elasticsearch 计算引擎的另一个前端。
这使 PromQL 可以进入正常的 Elasticsearch 开发生命周期。它与 Elasticsearch 本身使用相同的规划器、分布式执行引擎、测试基础设施和发布流程。
要进一步了解 Elasticsearch 的查询引擎,请查看我们的博客。
与使用 TS 源命令的 ES|QL 时间序列查询一样,PromQL 会被转换为高度优化的查询计划,并在整个集群中执行。节点通过向量化算子处理列式数据批次,同时部分结果通过交换操作不断传递,直到最终结果组装完成。
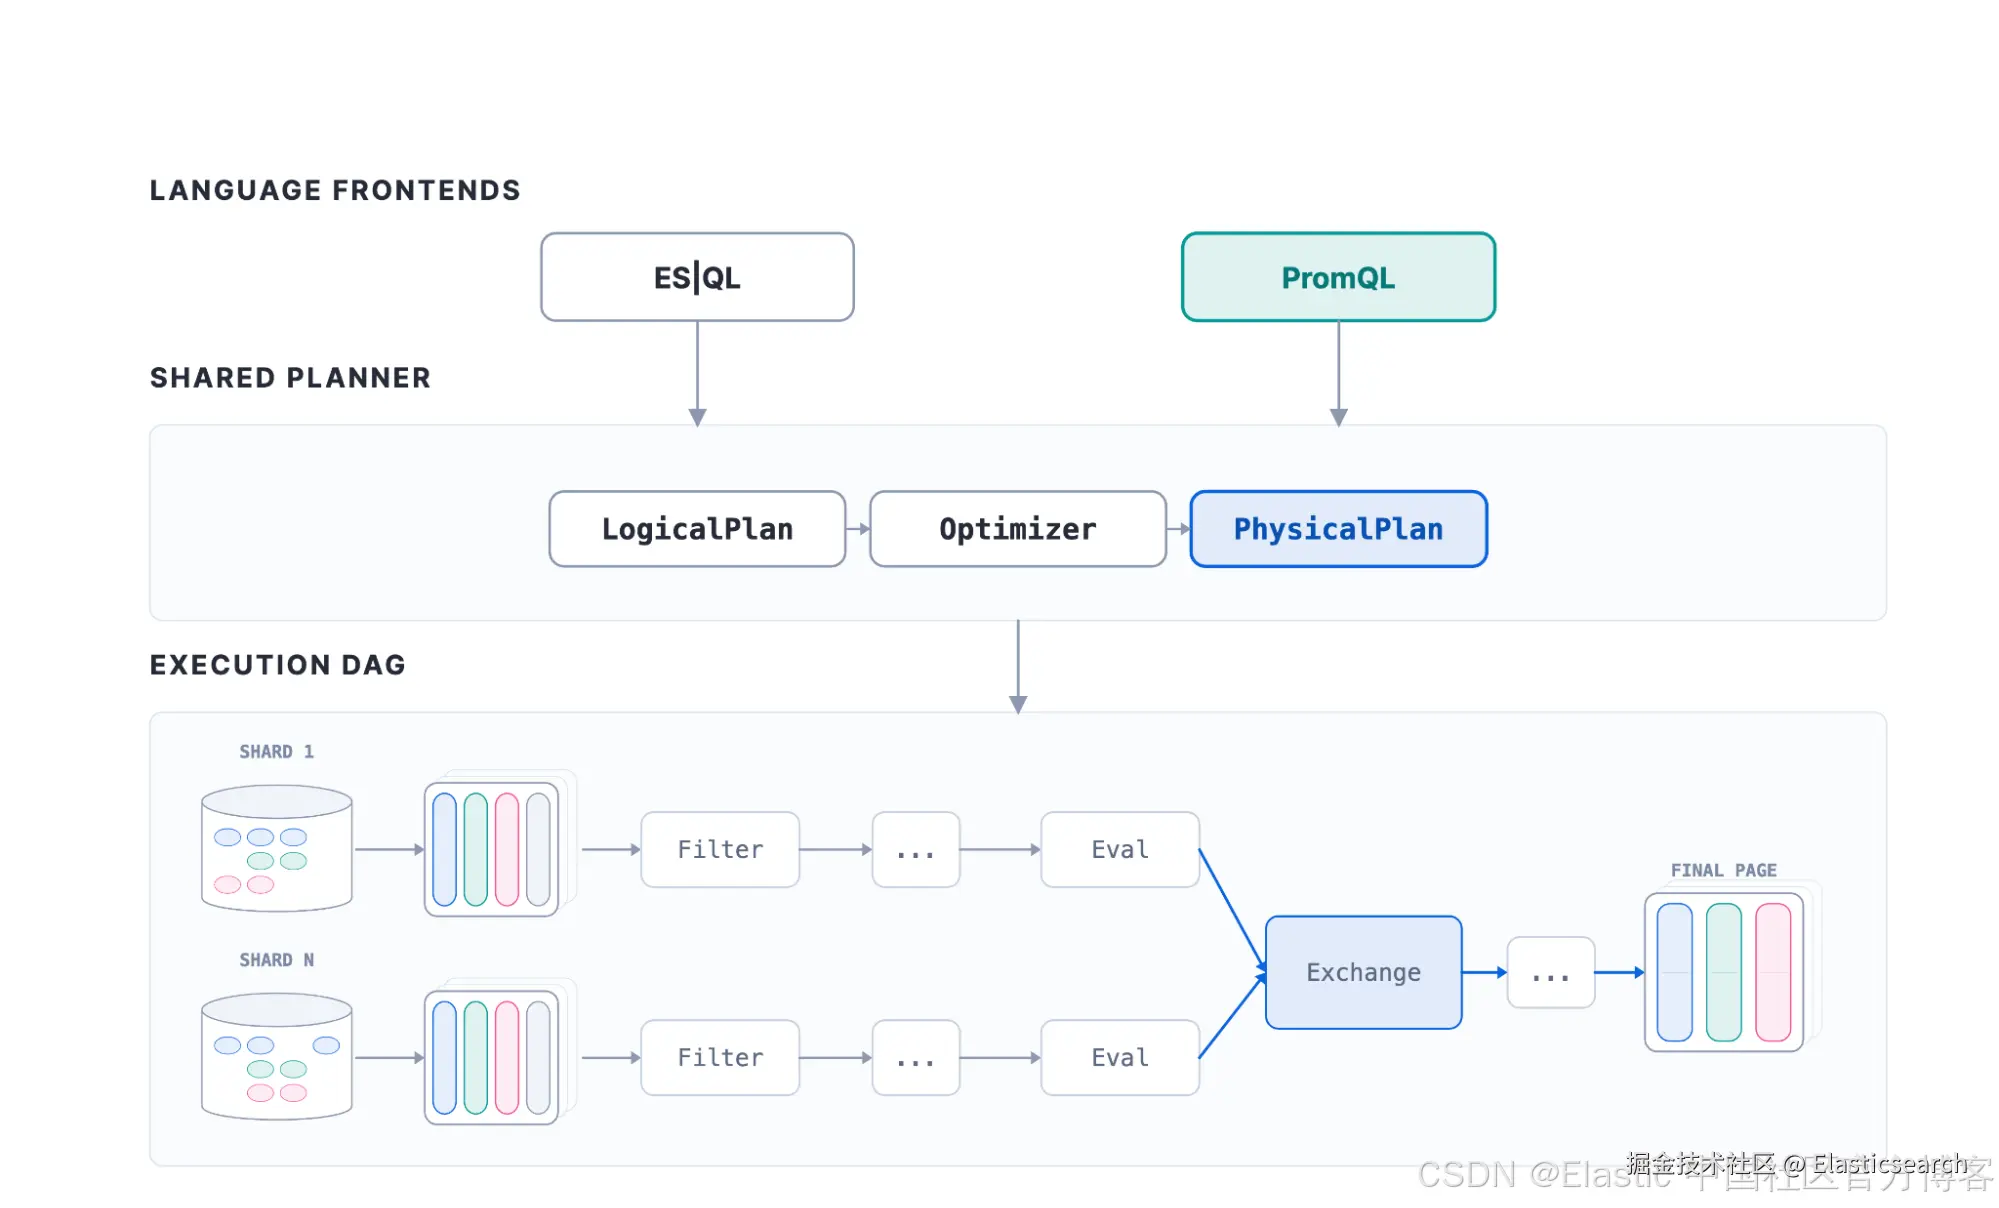
这也意味着 PromQL和 ES|QL运行在同一个执行引擎上,并处理相同的时间序列数据。ES|QL 还可以进一步对 PromQL 计算结果进行后处理,而这些处理是 PromQL不 支持的,例如lookup连接和内联聚合。
例如,假设 Prometheus 请求计数器存储在 metrics-* 中,并以 service 标签作为键。一个名为 service_registry 的 lookup 索引将每个实例映射到其所属的团队和环境,以及其服务层级:
ini
`

1.  PROMQL index=metrics-*
2.    error_rate=(
3.      sum by (service) (
4.        rate(http_requests_total{status=~"5.."}[5m])
5.      )
6.    )
7.  | LOOKUP JOIN service_registry ON service
8.  | WHERE error_rate > 0.15
9.  | SORT error_rate DESC

`AI写代码
这种架构要求执行引擎原生且高效地支持 PromQL 语义,而不是将其作为 ES|QL 的语法糖。以下章节将介绍我们为实现这一目标所做的修改,以及引入的新执行基础能力。
一个服务器:Prometheus 远程写入和 HTTP API 内置于 Elasticsearch
查询执行只是其中一半。Prometheus 生态系统同样需要熟悉的数据写入和查询 API。
Prometheus 协议几乎已经成为每个团队可观测性技术栈中指标相关功能的事实标准。因此,我们直接在 Elasticsearch 服务器中构建了 HTTP API,从而消除了对第三个组件的需求,并增强了集成的稳定性和性能。
在数据写入方面,我们添加了一个用于 Prometheus 远程写入协议的端点。它接受经过 Snappy 压缩的 Protocol Buffer 消息,将标签映射到 TSDS 维度,将指标名称和值映射到指标字段,推断计数器和仪表的映射方式,并直接写入 TSDS。内置模板是动态的,因此用户无需预先声明每个 Prometheus 标签或指标。
在查询方面,Elasticsearch 提供了 Prometheus 查询 API。请求通过 Prometheus 端点进入,并在计算引擎中执行。
PromQL 时间网格:使评估步骤与 TSTEP 对齐
时间序列查询引擎针对按时间进行分组进行了优化。
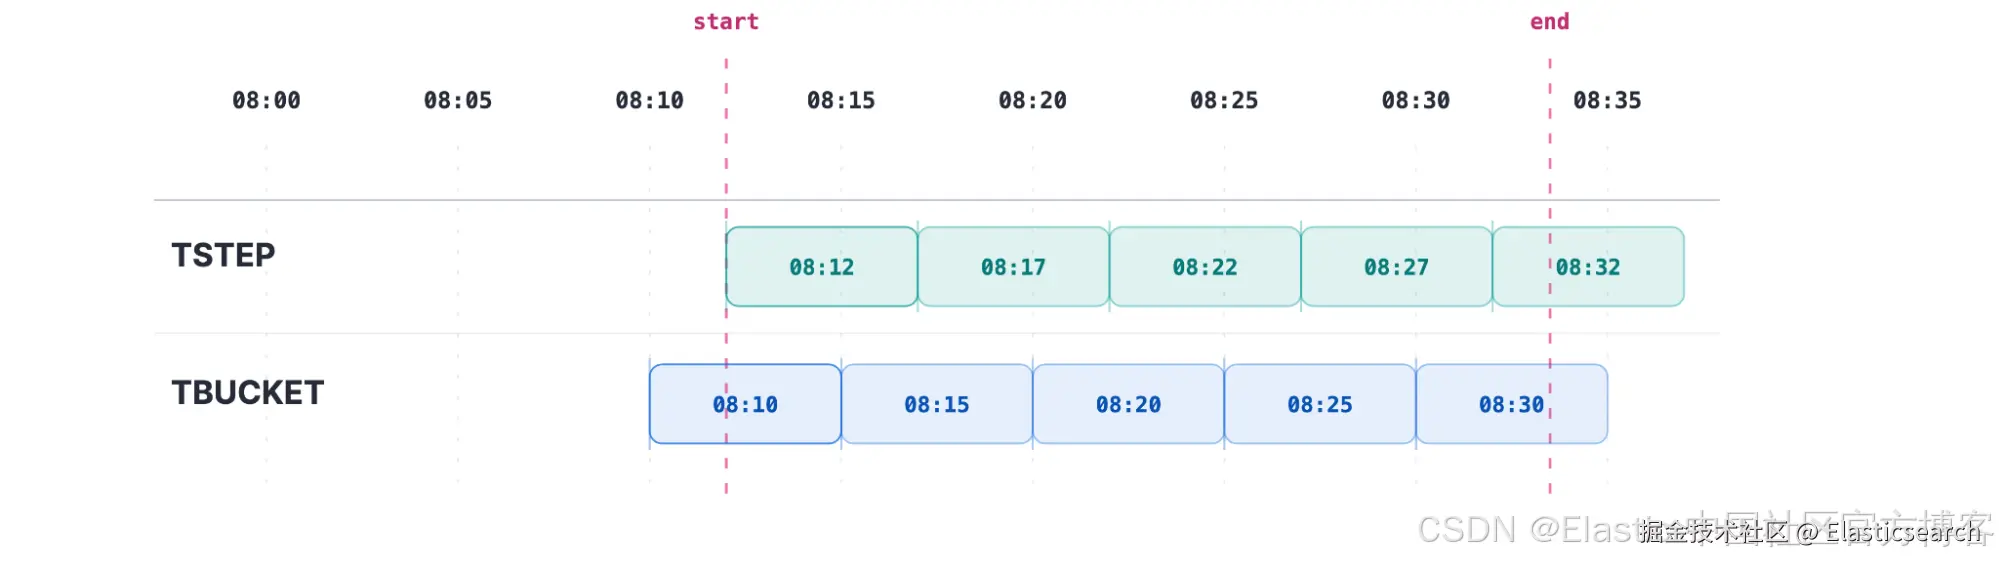
Elasticsearch 通常使用 TBUCKET(...) 对时间戳进行分组,它会将每个时间戳截断到固定的时间间隔边界。截断操作开销低,并且可以产生确定性的分桶边界。同时,这也使中间结果更容易复用。
Prometheus 以不同的方式定义评估点。对于范围查询,时间戳按照固定的步骤排列,并以查询范围为锚点,而不是通过截断每个样本的时间戳来确定。因此,两个具有相同步长但范围边界不同的查询,可能会产生不同的评估网格。
为了保留这些语义,我们引入了 TSTEP(...),它根据查询范围和步长生成分组网格,而不是将时间戳截断到全局对齐的边界。
PromQL 在内部使用 TSTEP(...),在保留 Prometheus 时间戳语义的同时,仍然可以将该操作降低为原生的 Elasticsearch 执行基础能力。
有些人可能会认为这是一个简单的问题,但其中的细微差异很重要。
例如,考虑一个用于计算某个指标 5 分钟滚动平均值的查询:
scss
`avg_over_time(http_request_duration_seconds[5m])`AI写代码在评估时间点 T,结果表示前面五分钟范围内的平均值:
(T - 5m, T]
当查询以五分钟为步长执行时,每个输出值都会标记为其对应五分钟窗口的上界。
Elasticsearch 之前缺少这种语义,只支持向前看的窗口聚合函数:
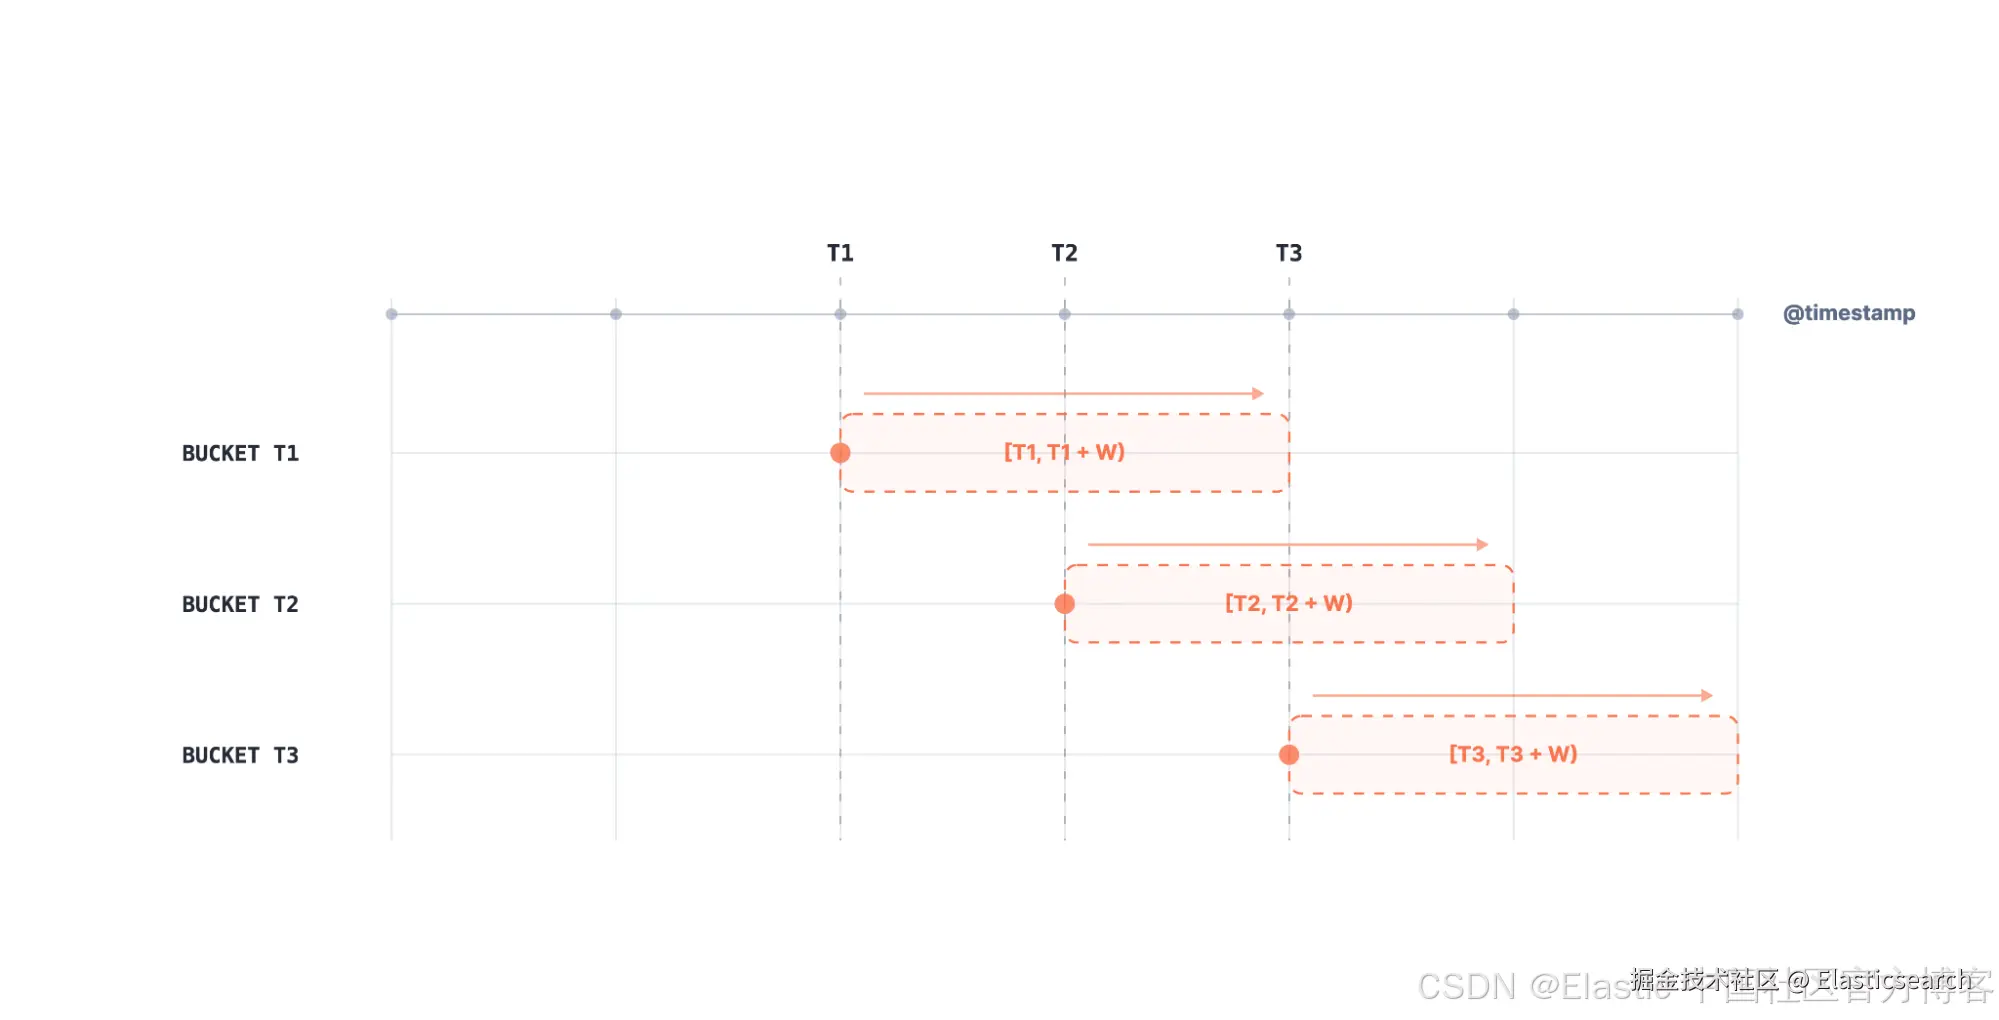
我们重写了窗口评估路径,使 ES|QL 和 PromQL 都使用一种通用的向后窗口实现:
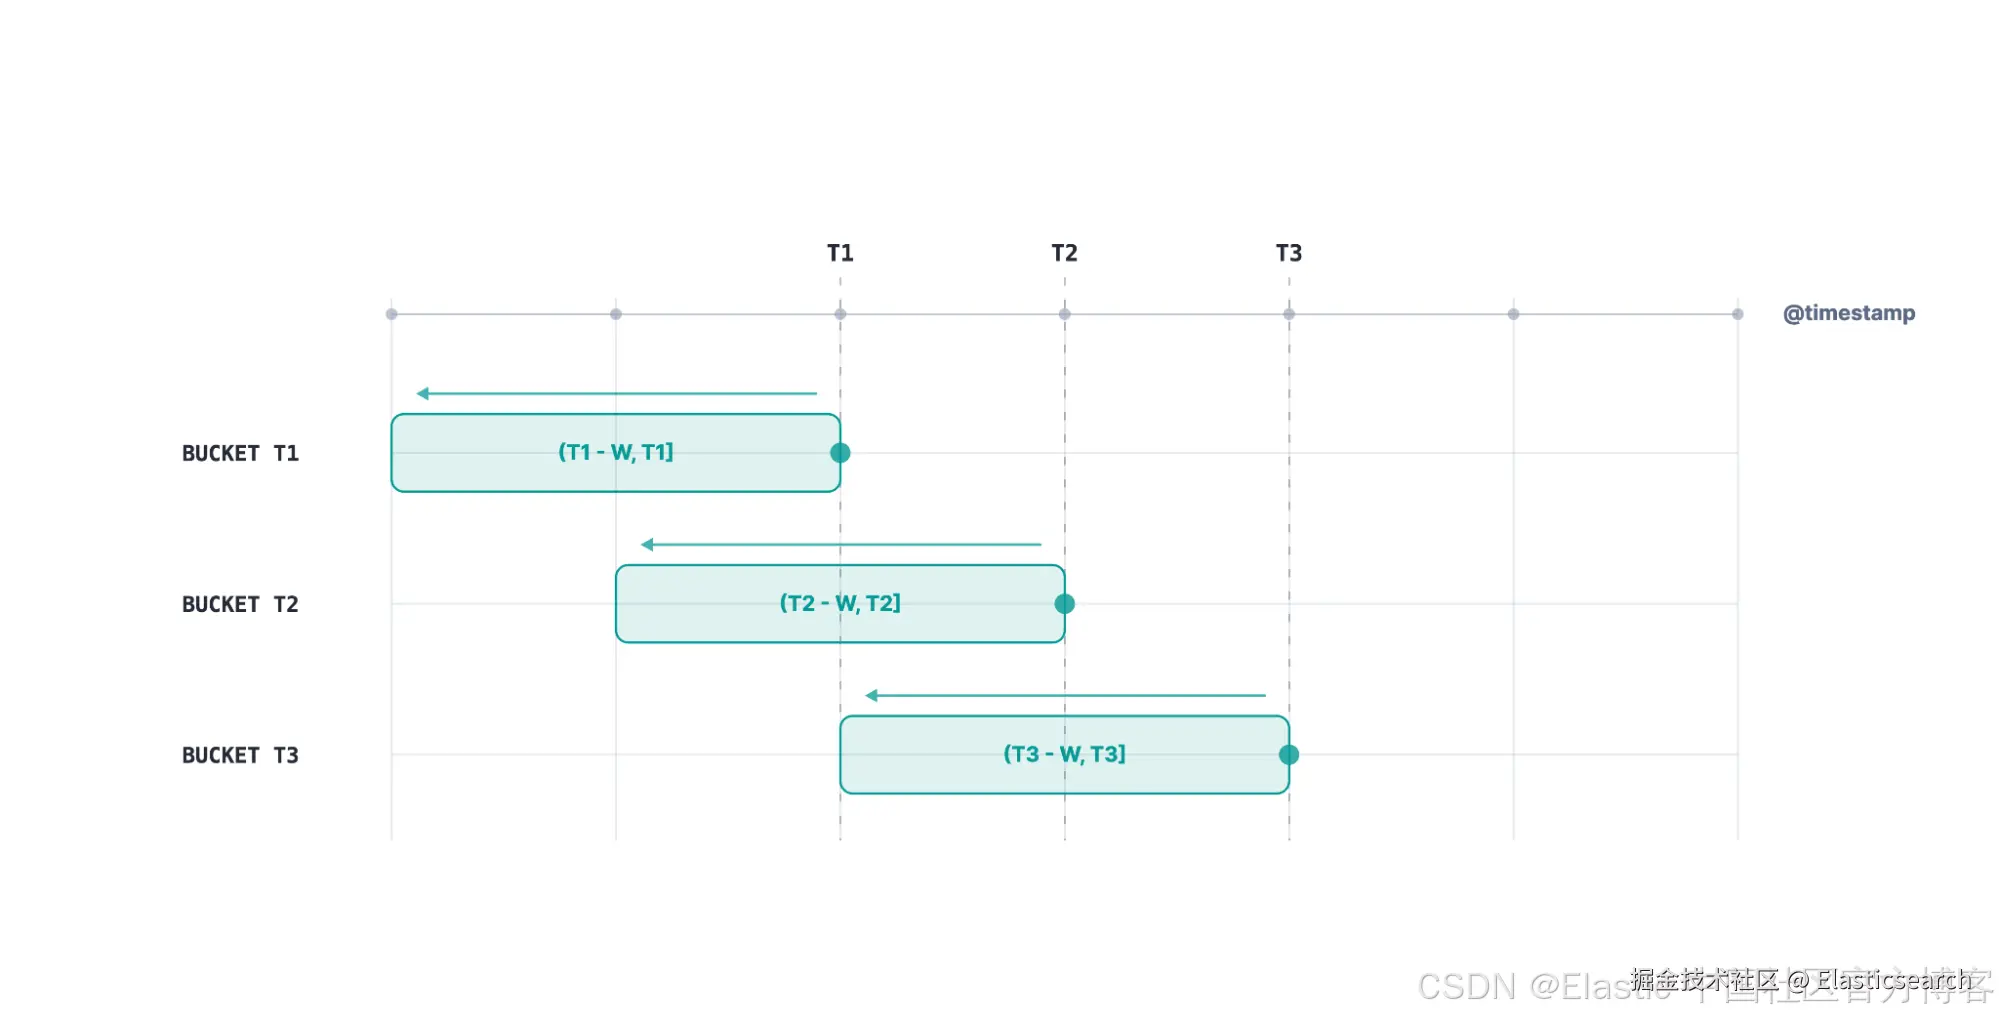
TSTEP(...) 和向后窗口结合使用,可以保留 PromQL 范围评估所需的两种重要时间语义。
动态标签分组:PromQL 的 without() 如何在运行时解析
时间网格决定 PromQL 表达式 何时进行评估。聚合则决定哪些输入序列会被组合,以及哪些标签用于标识每个输出序列。
对于大多数分析型查询引擎来说,这种标识在查询规划时就已经确定。规划器可以分配分组列并选择聚合策略,同时在执行流水线中携带一个固定的键。
ES|QL 就是这样工作的:
scss
`STATS sum(x) BY cluster, namespace`AI写代码输出序列按照显式键 (cluster, namespace) 进行分组。
PromQL 则可以反向表达相同的操作:
scss
`sum without(instance, pod) (http_requests_total)`AI写代码现在我们知道哪些维度_不应该_使用。但在查询执行之前,我们不一定知道完整的分组键。这只是语言上的一个小差异,却会对执行产生显著影响。
一种可能的实现方式是发现指标使用的所有标签,减去 instance 和 pod,然后将表达式重写为普通的 by(...) 聚合。这会在规划之前增加一个发现阶段。对于高维度指标而言,这种方式也会变得低效,因为在某个特定序列中,所有可能的维度中可能只有一部分具有有用的值。大多数查询只需要可用维度中的很小一部分,因此将整个维度集合都作为聚合键会浪费 内存 ,并增加额外的管理开销。
相反,我们扩展了时间序列执行路径,引入动态分组列。引擎在读取序列时加载维度,并针对每个时间序列应用排除项。这样既不需要将分组模式作为查询规划的前置条件,也避免在聚合过程中携带大量稀疏的分组列。
维度打包:让宽泛的 PromQL 分组键保持低成本
惯用的 PromQL 聚合写法大量使用 without(...),而不是 by(...):
scss
`sum without(instance, pod) (http_requests_total)`AI写代码通过排除标签而不是显式列出标签,可以让仪表板和告警更好地适应模式演变。如果指标中新增了一个标签,只要没有被显式排除,查询就会继续保留它。
对于执行引擎而言,这意味着实际的分组键可能会很宽。其中许多标签通常具有较低的基数,但每个标签仍然会参与每一个聚合阶段。
在列式引擎中,每个分组列通常都表示为一个独立的向量。因此,10 个分组标签就意味着 10 个向量需要流经每个聚合算子:
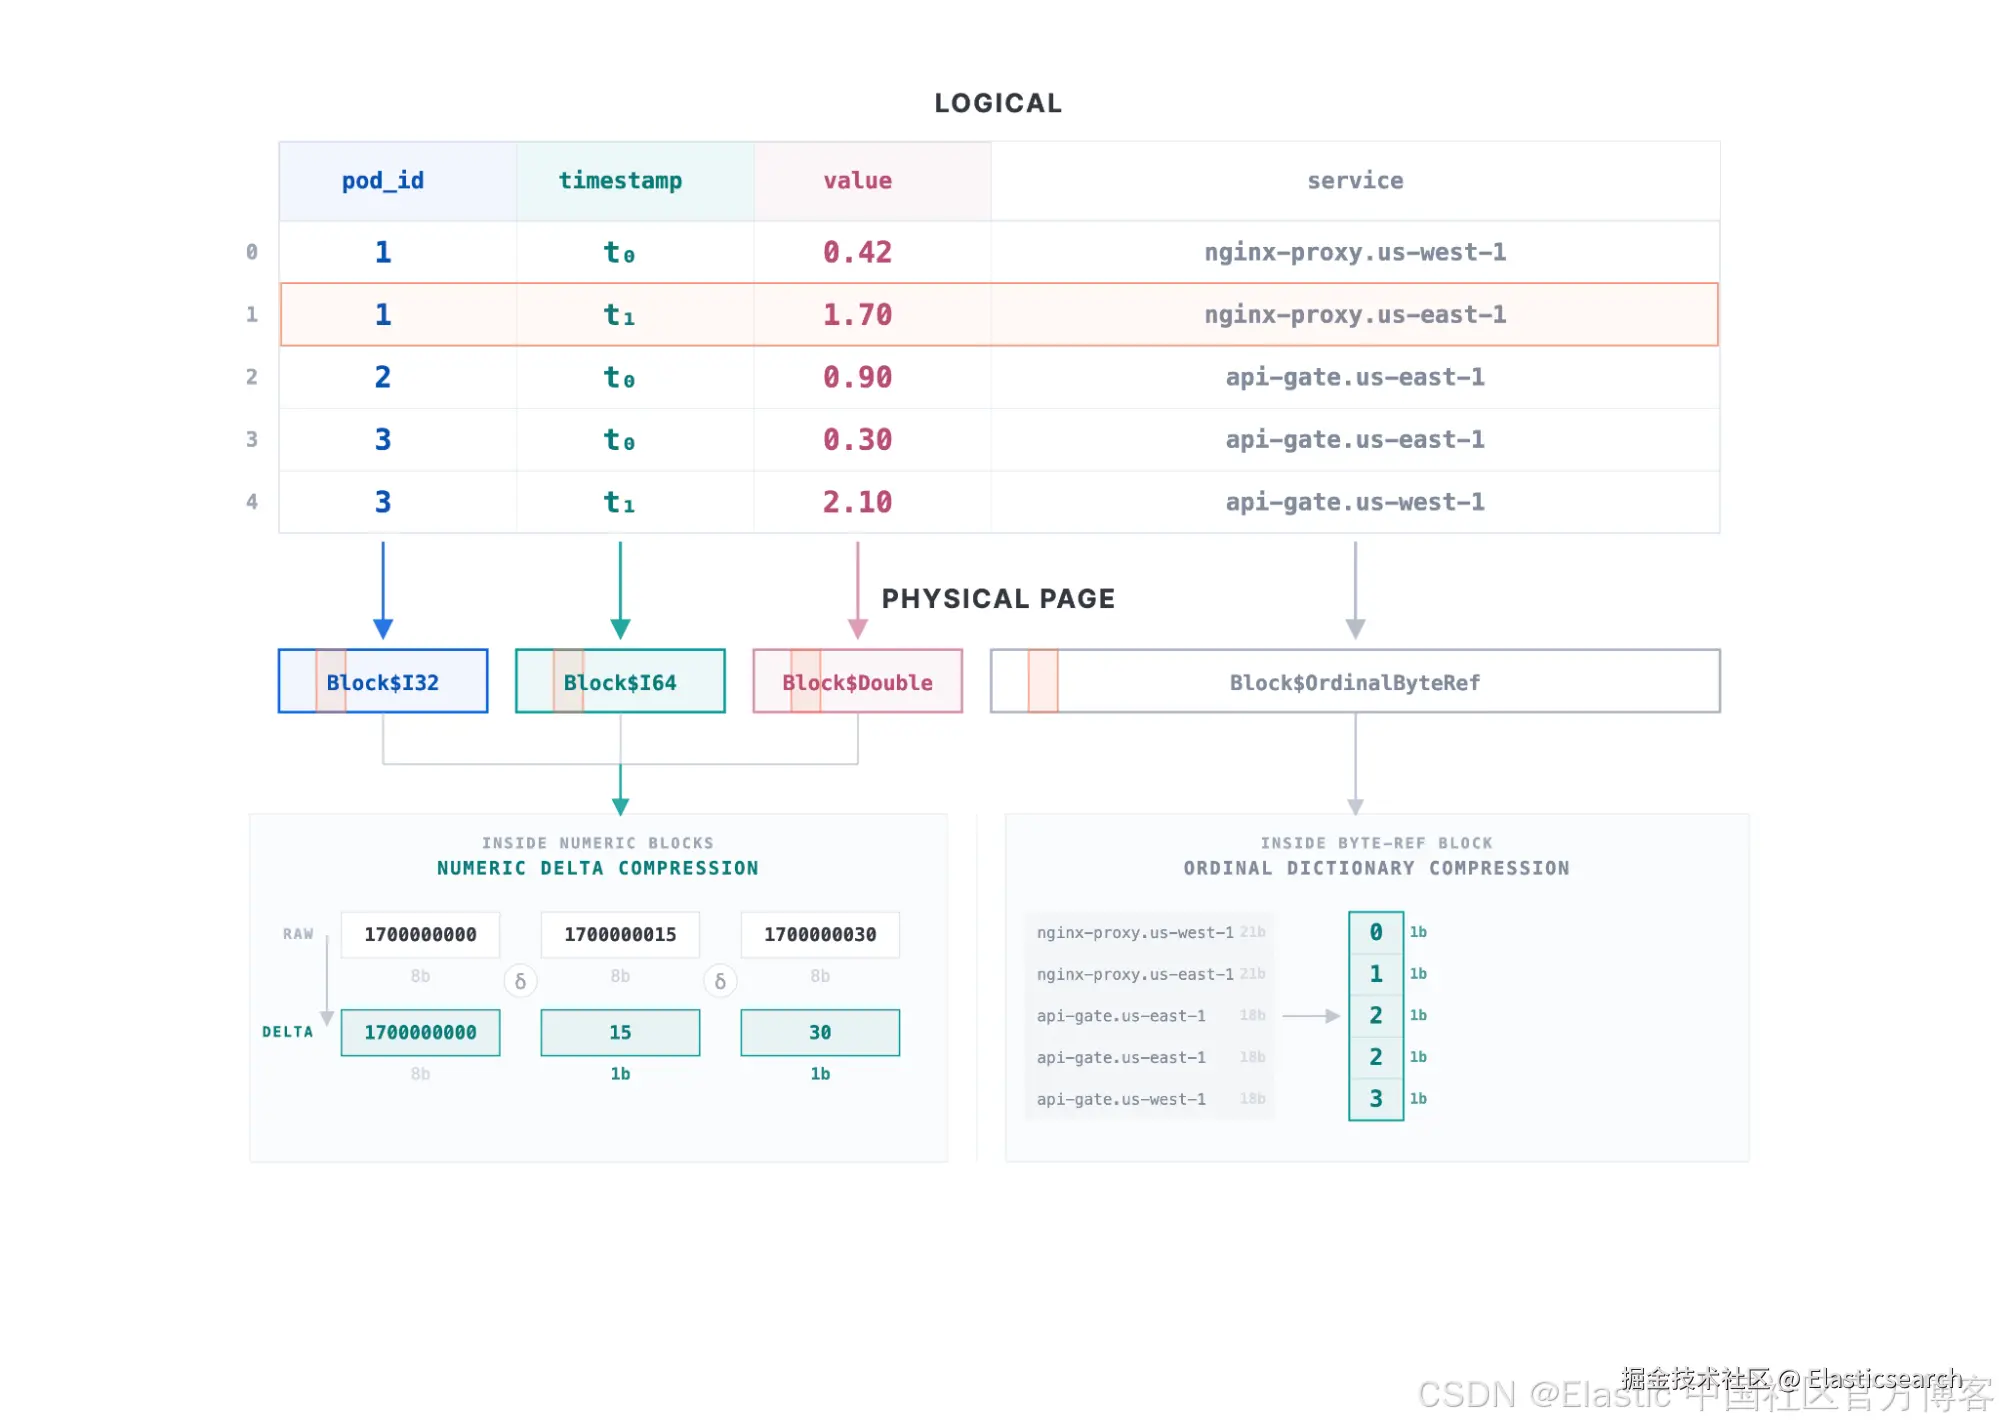
维度字段在索引映射中声明;规划器可以预先知道模式,分组键也因此保持精简且具有可预测性。
在列式引擎中,每个分组标签都作为一个独立的向量或数据块进行传递。因此,一个包含 10 个标签的键需要由聚合算子读取、哈希、比较和保留 10 个向量。随着键宽度增加,需要在流水线中传递的数据量和管理开销也会随之增加:
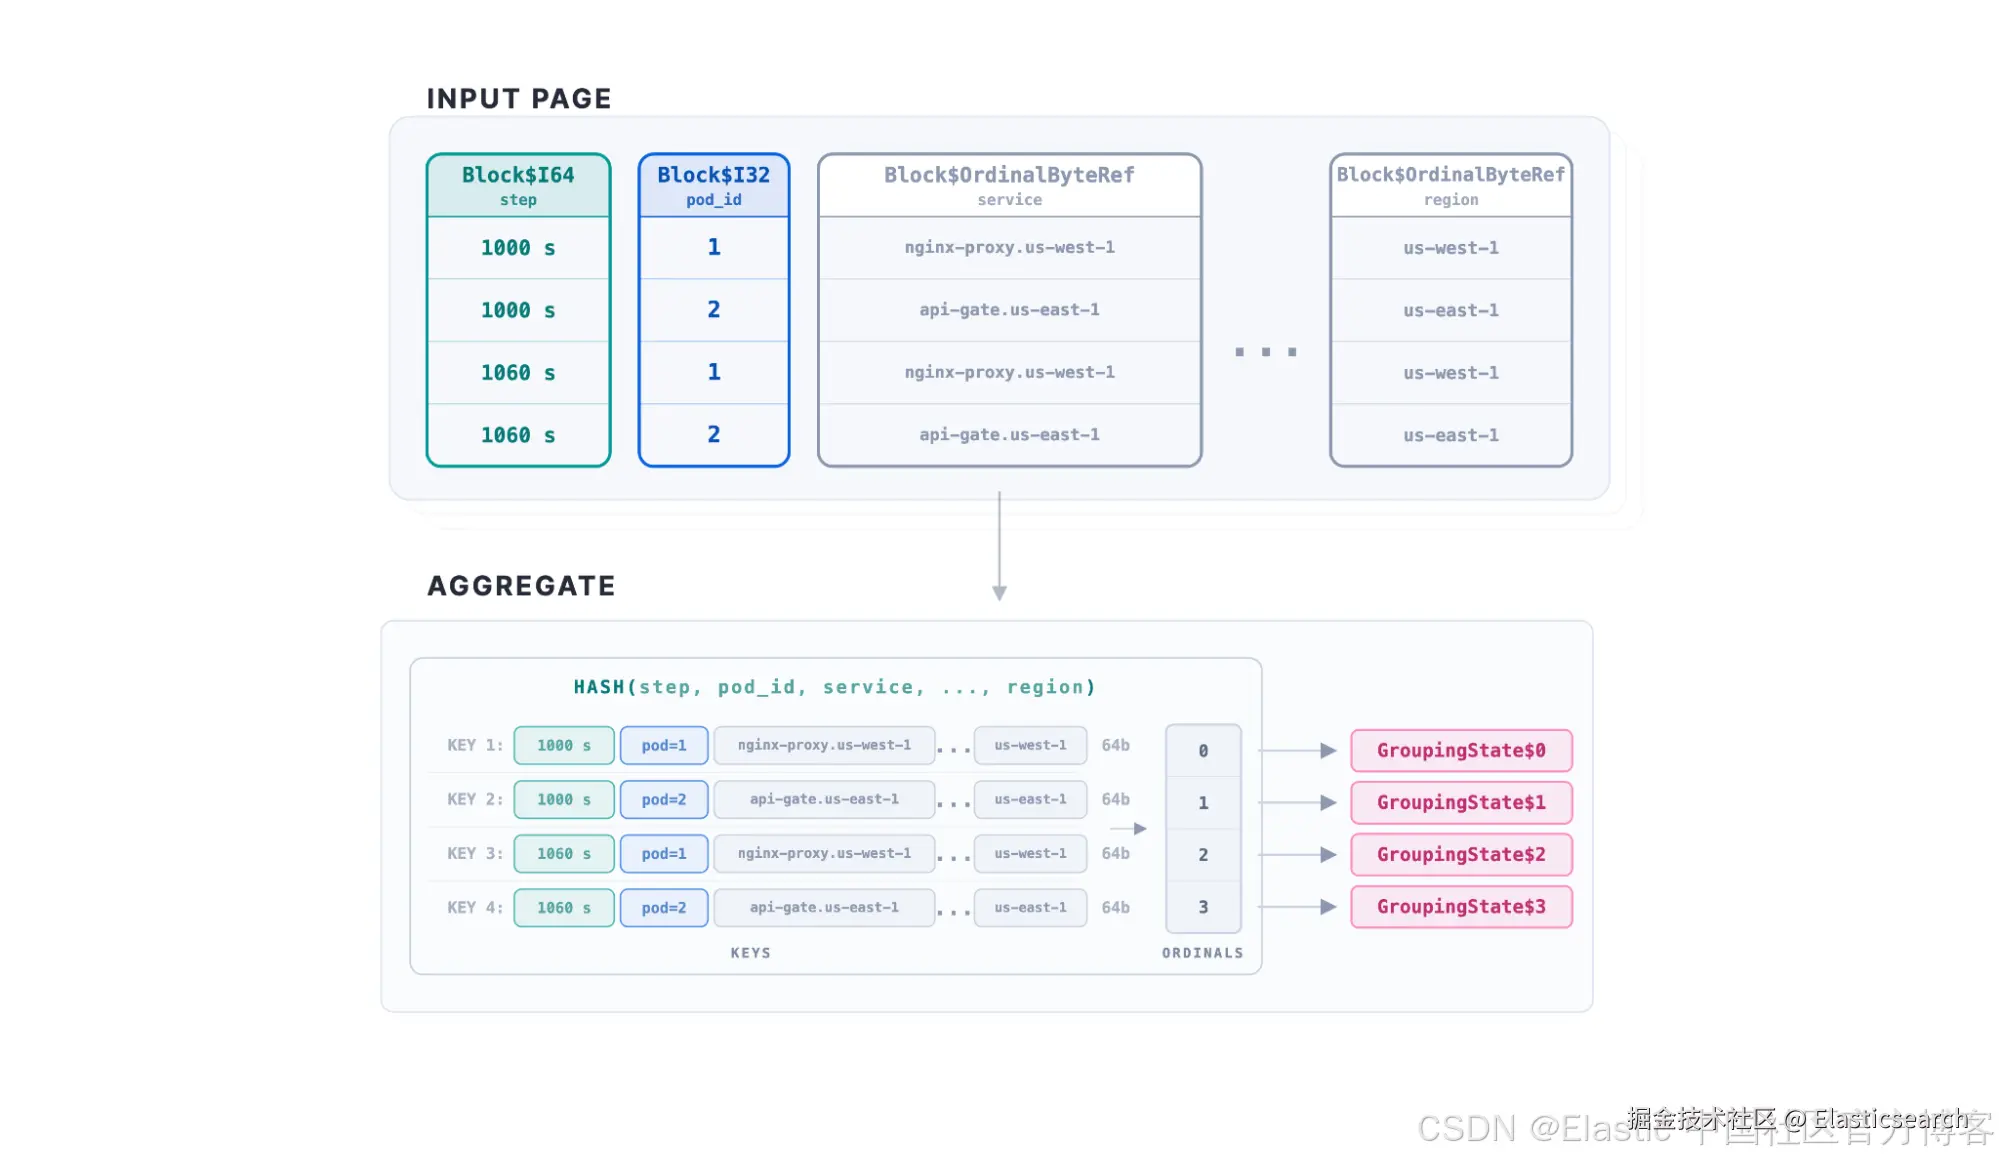
为了避免每增加一个标签就产生额外的逐列开销,我们引入了维度打包。在聚合开始之前,引擎会将完整的分组键编码为一个紧凑的表示形式。哈希和比较操作直接针对打包后的键执行,而不是分别针对每个数据块执行:
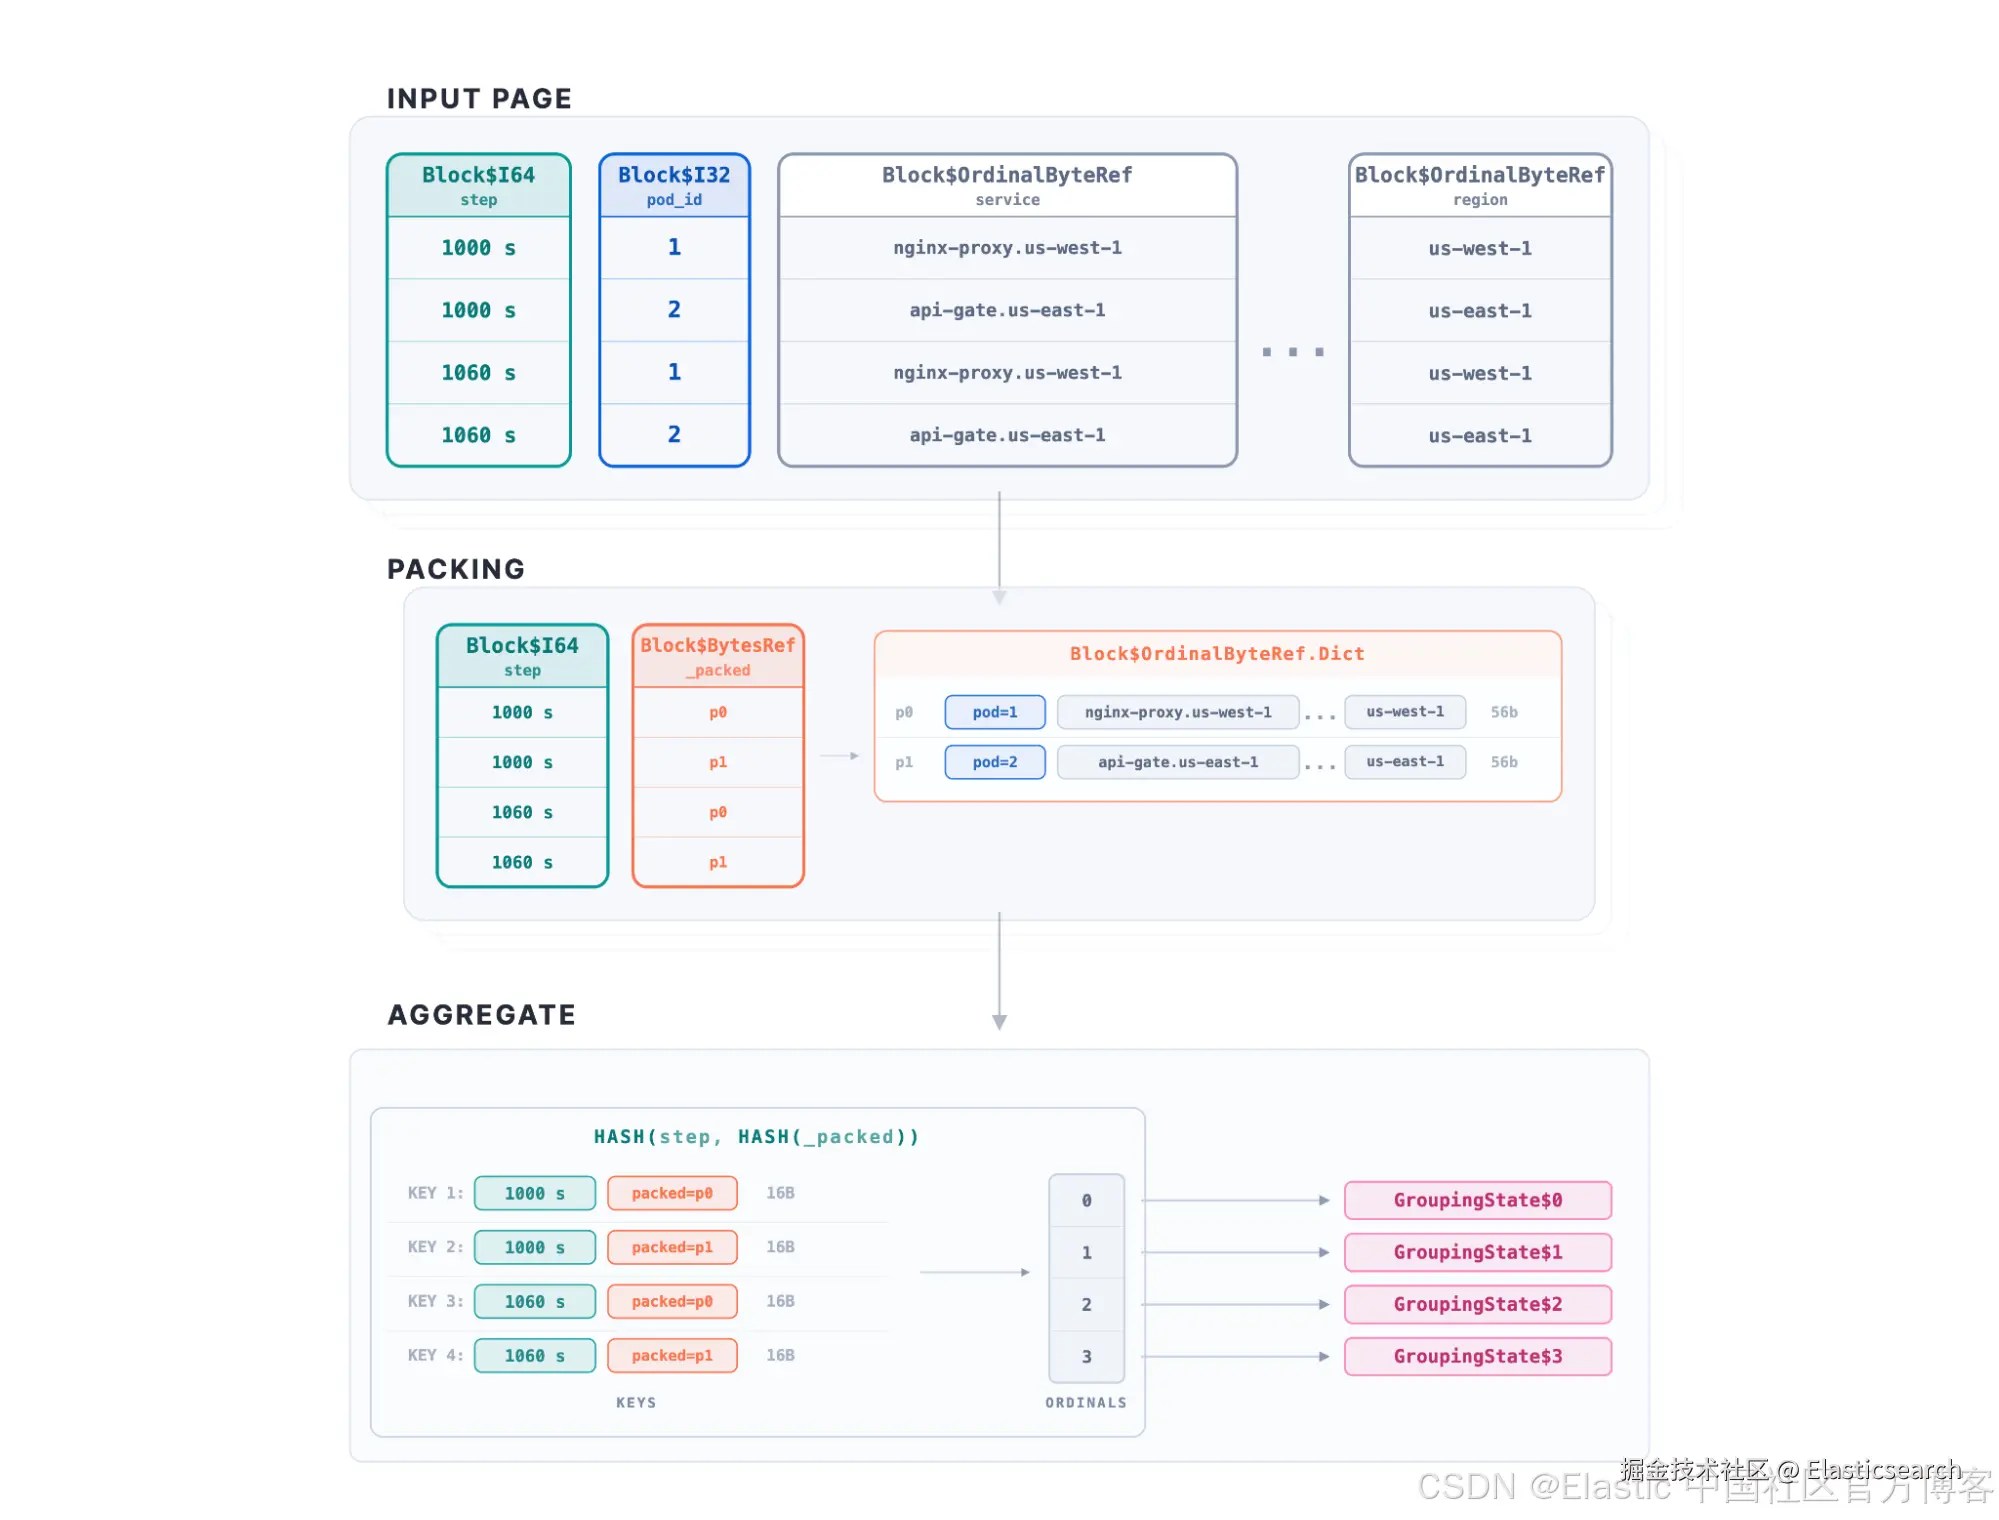
维度打包使哈希和比较操作可以针对单个紧凑键执行,而不必处理数量不断增加的 分组数据 块,从而让聚合开销对键宽度不那么敏感。由于两个查询语言共用同一个引擎,ES|QL 时间序列查询也将从这一优化中受益。
在流水线内部构建 Prometheus HTTP API 响应
与 Elasticsearch 的面向列的 ES|QL 响应格式不同,Prometheus 响应采用面向行的格式。Prometheus API 为每个时间序列返回一行结果,其样本表示为时间戳-值对。
为了支持兼容的 API 层,我们必须在 HTTP 层重新进行分组,将列式结果转换为封装后的行对象,并将它们累积到基于映射和列表的数据结构中,直到可以生成完整的 Prometheus 响应。
我们使用 TimeSeriesCollapse 计算算子替代了这种方式。它按照时间序列对行进行分组,并将样本与查询固定的步长时间网格对齐。它将重新组织后的结果作为普通的列式页面输出,每个时间序列对应一行,其中包含经过对齐的多值时间戳数据块和值数据块。同时,它在整个流水线中保持紧凑的向量化数据块表示:
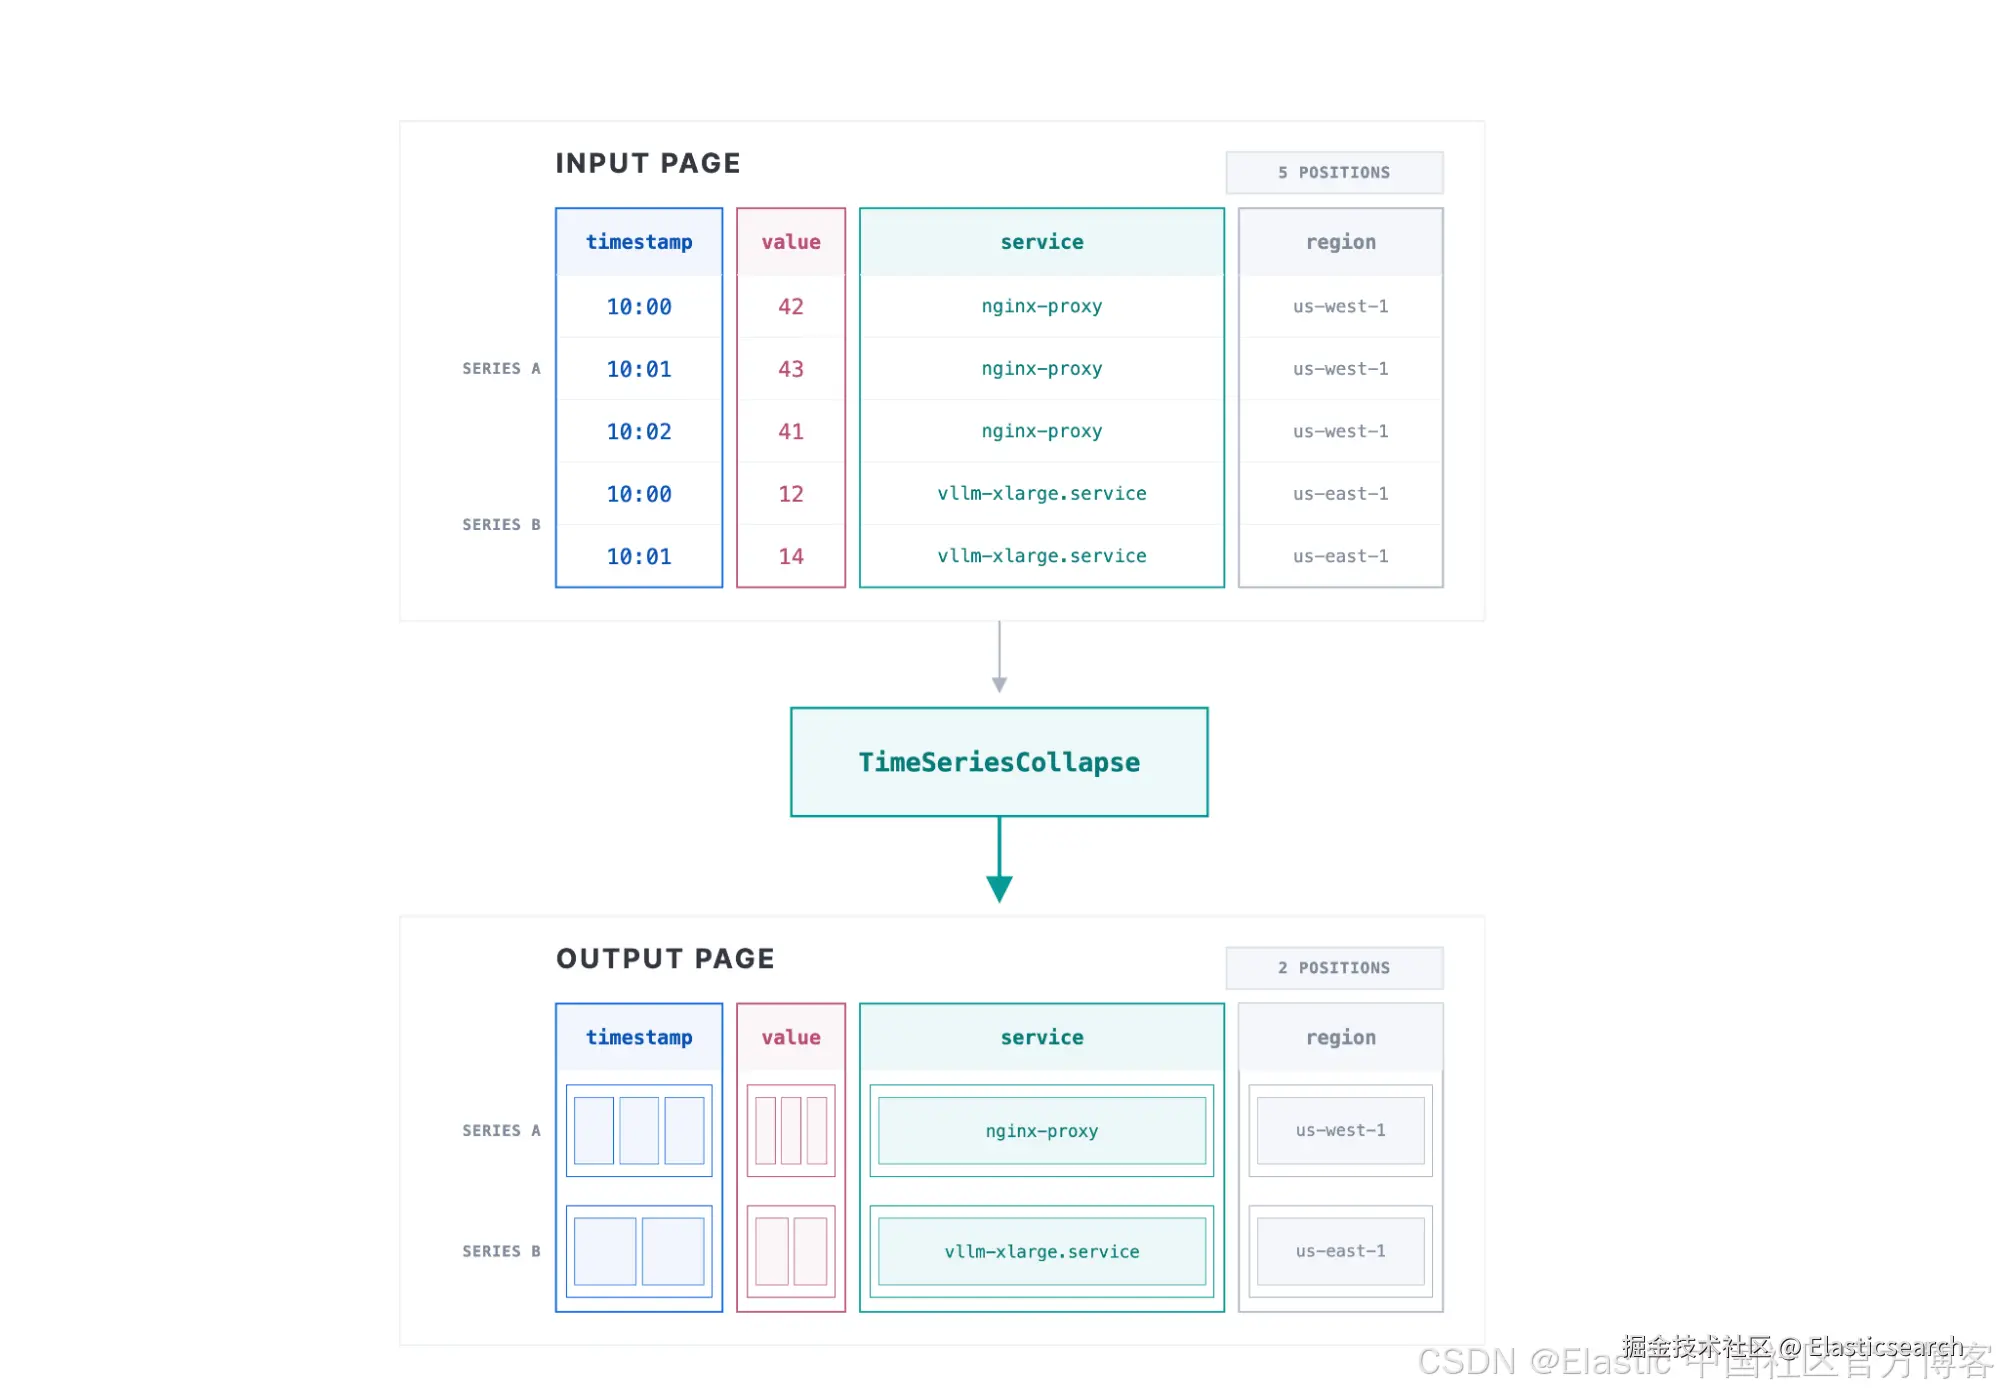
HTTP 层现在可以直接序列化这些数据块,从而避免了早期实现所需的映射、列表、封装对象以及与之相关的内存分配。
使用 2,000 个真实查询测试 PromQL 兼容性
Prometheus 兼容性测试 是我们的起点。
尽管这些测试为我们提供了一个可靠的基线,但它们无法告诉我们 PromQL 的各项功能在真实工作负载中出现的频率。为了补充这一基线,我们从公共代码仓库中收集了超过 2,000 个 PromQL 查询,并基于这些查询构建了第二个测试语料库。
然后,我们根据这些查询所使用的语言功能和表达式模式对其进行分类:
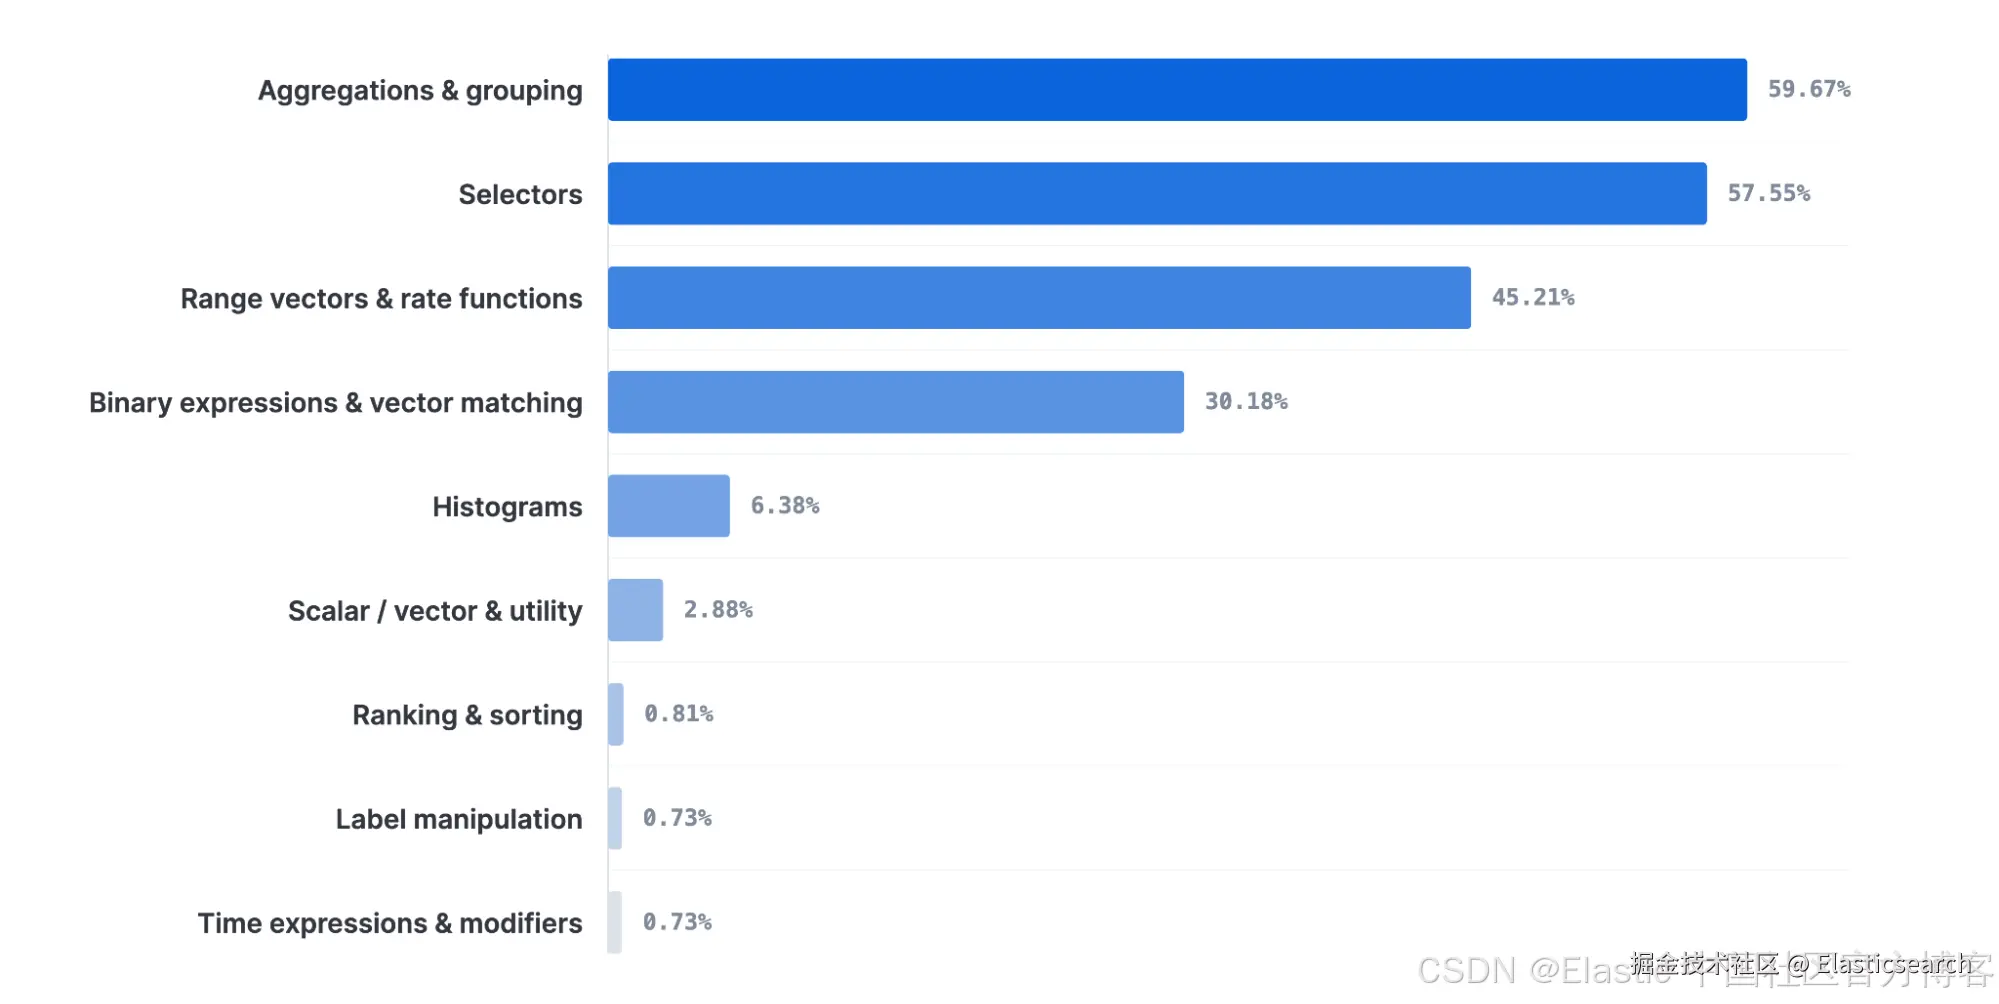
对于每一种兼容的查询形态,我们都会在 Elasticsearch 和 Prometheus 上运行相同的查询,并比较结果。
除此之外,我们还积极依赖模糊测试。它可以捕获仅靠单元测试不太可能发现的问题,包括时间戳对齐、标签保留、聚合行为、范围向量评估以及响应编码方面的差异。
9.5 中支持哪些 PromQL 函数和 API
自 9.4(技术预览)以来,Elasticsearch 中对 PromQL 的支持已经大幅扩展。在 Elasticsearch 9.5 中,ES|QL 中的 PROMQL 命令和 Prometheus HTTP API 都已正式发布,目前我们真实世界查询语料库中超过 80% 的 PromQL 工作流都可以无需修改直接运行:
自技术预览版以来,主要新增功能包括:
| 功能 | 示例 | 状态 |
|---|---|---|
| Prometheus 远程写入数据 | POST /_prometheus/api/v1/write |
9.5 正式发布 |
| 范围查询 | /api/v1/query_range |
9.5 正式发布 |
| 即时查询 | /api/v1/query |
9.5 正式发布 |
| 指标元数据和构建信息 | /api/v1/metadata、/api/v1/status/buildinfo |
9.5 正式发布 |
| 原生直方图函数 | histogram_quantile、histogram_count、histogram_sum |
9.5 正式发布 |
| 每个选择器的 offset 修饰符 | [5m] offset 1h |
9.5 正式发布 |
顶层 or 运算符 |
rate(a[5m]) or rate(b[5m]) |
9.5 正式发布,最多支持 8 个操作数 |
Prometheus 远程写入数据
Elasticsearch 接受 Prometheus 远程写入(v1)消息:
bash
`

1.  POST /_prometheus/api/v1/write
2.  Content-Type: application/x-protobuf
3.  Content-Encoding: snappy

`AI写代码
Snappy 压缩的 Protocol Buffer 消息会被解码,标签会映射到 TSDS 维度。指标名称和值会写入时间序列索引。内置模板是动态的,因此用户无需预先声明每个 Prometheus 标签或指标。
通过 Prometheus HTTP API 进行范围查询和即时查询
范围查询和即时查询端点都可用:
sql
`GET /_prometheus/api/v1/query_range?query=...&start=...&end=...&step=15s`AI写代码
bash
`GET /_prometheus/api/v1/query?query=up&time=...`AI写代码范围查询返回在一个时间窗口内进行评估的矩阵,即时查询则返回在单个时间戳上进行评估的向量。这些端点可以供 Kibana、Grafana、Prometheus 兼容的告警工具以及自定义仪表板使用。
指标元数据和构建信息端点
Elasticsearch 提供可用指标的元数据以及构建信息端点:
bash
`GET /_prometheus/api/v1/metadata`AI写代码
bash
`GET /_prometheus/api/v1/status/buildinfo`AI写代码元数据端点返回指标类型和帮助文本,构建信息端点返回 Prometheus 兼容服务器的版本。Grafana 和其他工具会使用这些端点来检测功能以及确定 UI 行为。
原生直方图函数:histogram_quantile、count 和 sum
Elasticsearch 支持对原生直方图执行主要的 PromQL 操作:
scss
`histogram_quantile(0.95, http_request_duration_seconds)`AI写代码
scss
`histogram_count(http_request_duration_seconds)`AI写代码
scss
`histogram_sum(http_request_duration_seconds)`AI写代码原生直方图会根据数据动态调整桶布局,从而在较大的值范围内提供有用的精度,而无需用户预先配置每个桶的边界。经典直方图仍然可以与原生直方图一起使用。
PromQL 中每个选择器的 offset 修饰符
Offset 修饰符会将选择器的时间窗口向过去移动:
scss
`rate(http_requests_total[5m] offset 1h)`AI写代码这会返回一小时前的请求速率。每个选择器的 offset 通常用于将当前流量、延迟或资源使用情况与更早的基线进行比较,例如与一周前的同一时间段进行比较。
PromQL 中的顶层 or 运算符
Elasticsearch 支持顶层 PromQL or 运算符:
scss
`rate(http_requests_total[5m]) or rate(http_requests_legacy[5m])`AI写代码在 PromQL 中,or 不是布尔运算。它会对两组时间序列执行并集操作。左侧的结果会被保留;只有当右侧某个序列的标签集与左侧已经返回的序列不匹配时,该序列才会被添加。这在迁移过程中非常有用,因为同一个逻辑指标可能同时存在于旧名称和新名称下。
该实现遵循 Prometheus 的左侧优先规则,并保留 __name__ 标签。顶层最多支持包含 8 个操作数的链式表达式。
Elasticsearch 尚未支持的 PromQL 功能
正式发布并不意味着已经实现完整的 PromQL 兼容性。PromQL 中一些不太常用且更加复杂的部分仍然不受支持。这些缺口现在定义了下一阶段的工作:
| 功能 | 示例 | 状态 |
|---|---|---|
| 高级向量匹配 | on(instance) group_left |
计划中 |
| 排序和排名 | topk、bottomk、limitk、sort、sort_desc |
计划中 |
| 标签操作 | label_replace、label_join |
计划中 |
| 绝对时间修饰符 | @ 1710000000 |
计划中 |
| 混合 offset 的复合表达式 | rate(...) - rate(... offset 1h) |
计划中 |
| 告警和目标端点 | /api/v1/alerts、/api/v1/targets |
不在范围内 |
使用 on() 和 group_left 的高级向量匹配
一些需要 Prometheus 向量匹配的二元运算目前还不是正式发布功能的一部分。
例如,下面的查询将每个实例的请求速率除以每个实例的容量指标:
scss
`

1.  rate(http_requests_total[5m])
2.    / on(instance) group_left
3.      machine_cpu_cores

`AI写代码
on(instance) 子句指定哪些标签用于标识需要匹配的序列。group_left 允许多个请求速率序列匹配单个每实例容量序列,同时保留左侧具有更高基数的序列中的标签。
当需要将详细指标与元数据或低基数容量指标连接时,这类表达式很常见。在适用情况下,基本二元表达式已经得到支持,而其余的向量匹配形式则属于计划中的工作。
排序和排名:topk、bottomk 和 sort
Prometheus 的排序和排名函数目前也还不是正式发布功能的一部分:
scss
`topk(10, sum by (service) (rate(http_requests_total[5m])))`AI写代码这会返回请求速率最高的 10 个服务。类似查询广泛用于流量、延迟、错误和资源消耗的"问题最多对象"仪表板。
其余函数包括:
scss
`topk(10, ...)`AI写代码
scss
`bottomk(10, ...)`AI写代码
scss
`limitk(10, ...)`AI写代码
scss
`sort(...)`AI写代码
scss
`sort_desc(...)`AI写代码使用 label_replace 和 label_join 进行标签操作
PromQL 可以在查询评估期间构建或重写标签。当仪表板变量、命名约定或标签模式并不完全一致时,这些函数尤其有用:
bash
`

1.  label_replace(
2.    up,
3.    "environment",
4.    "$1",
5.    "cluster",
6.    "^(prod|staging)-.*$"
7.  )

`AI写代码
这会根据 cluster 标签创建一个 environment 标签。
另一个常见示例是将现有标签组合成一个面向显示的标签:
vbscript
`

1.  label_join(
2.    up,
3.    "target",
4.    "/",
5.    "namespace",
6.    "pod"
7.  )

`AI写代码
这会生成一个 target 标签,例如 payments/api-7f6d9。label_replace(...) 和 label_join(...) 目前还未包含在正式发布版本中。
高级时间修饰符:@ 修饰符和混合 offset
一些高级时间修饰符和表达式形式仍不属于正式发布范围。
例如,绝对时间 @ 修饰符会在固定的 Unix 时间戳上评估选择器,而不是在查询正常的评估时间上进行评估:
scss
`rate(http_requests_total[5m] @ 1710000000)`AI写代码这对于与固定的历史时间点进行比较非常有用。
PromQL 还允许表达式的两侧使用不同的 offset:
scss
`

1.  rate(http_requests_total[5m])
2.    - rate(http_requests_total[5m] offset 1h)

`AI写代码
这会将当前流量与一小时前的流量进行比较。每个选择器的 offset 已在正式发布版本中提供,但并非所有 offset 组合和复合表达式都已包含在正式发布范围内。
尚未实现的 Prometheus API 端点
此外,Prometheus HTTP API 的功能范围目前还没有完全实现。值得注意的包括:
通过以下端点提供告警元数据:
bash
`/api/v1/alerts`AI写代码该端点供检查当前活动告警状态的工具使用。
通过以下端点进行目标发现:
bash
`/api/v1/targets`AI写代码该端点用于检查抓取目标、健康状态和标签。
这些端点涉及 Prometheus 服务器和抓取目标的状态,而不是查询存储在 Elasticsearch 中的指标。
有关完整的限制列表,请参阅 PromQL 限制页面。
在 Elasticsearch 9.5 中试用 PromQL
要在 Elasticsearch 9.5 或 Serverless 中查询 Prometheus 指标,请参阅 PromQL 文档和 Prometheus HTTP API 参考。
原文:PromQL in Elasticsearch: 80% of queries run unmodified | Elasticsearch Labs