作者:来自 Elastic Attila Sahi
ES|QL 如何让当前的 TopN 阈值下推到 Lucene,以及为什么这种 100 倍的性能提升会出现在某些排序查询中,而在另一些查询中几乎感觉不到。
上手操作 Elasticsearch:深入了解我们在 Elasticsearch Labs repo 中提供的示例笔记本,开始免费云试用,或者现在就在你的本地机器上尝试 Elastic。
在 Elasticsearch 9.6 中,一个过滤 3.46 亿条 Nginx 日志文档的查询,在单节点上从大约 500 秒降至 5 秒。这意味着速度提升了 100 倍,而同一个查询在 Elastic Cloud Serverless 上的速度提升了 37 倍。这项优化称为 min-competitive TopN 。随着 Elasticsearch Query Language(ES|QL) 不断累积结果候选项,它会提高 Lucene 必须返回的最小值,因此那些已经不可能改善结果的文档范围就完全不需要加载或解码。最终你仍然会得到相同的 500 行,而数亿个文档则完全无需读取。
对 3.46 亿条日志文档执行排序的 ES|QL 查询
sql
`

1.  FROM logs_*
2.  | WHERE message LIKE "*request body too large*" OR message LIKE "*queue is full*"
3.  | SORT @timestamp DESC
4.  | LIMIT 500

`AI写代码
使用真实世界的 Nginx 日志进行基准测试,该查询搜索了 3.46 亿条文档,覆盖总计 432 GB 的索引数据。它返回了 500 个结果,耗时约 500 秒。也就是超过 8 分钟。
底层发生了什么?
在这项优化之前,候选行会先被加载、解码,然后由用户过滤条件进行评估,之后 TopN 才能确定其中哪些结果已经不可能再对最终结果产生贡献。
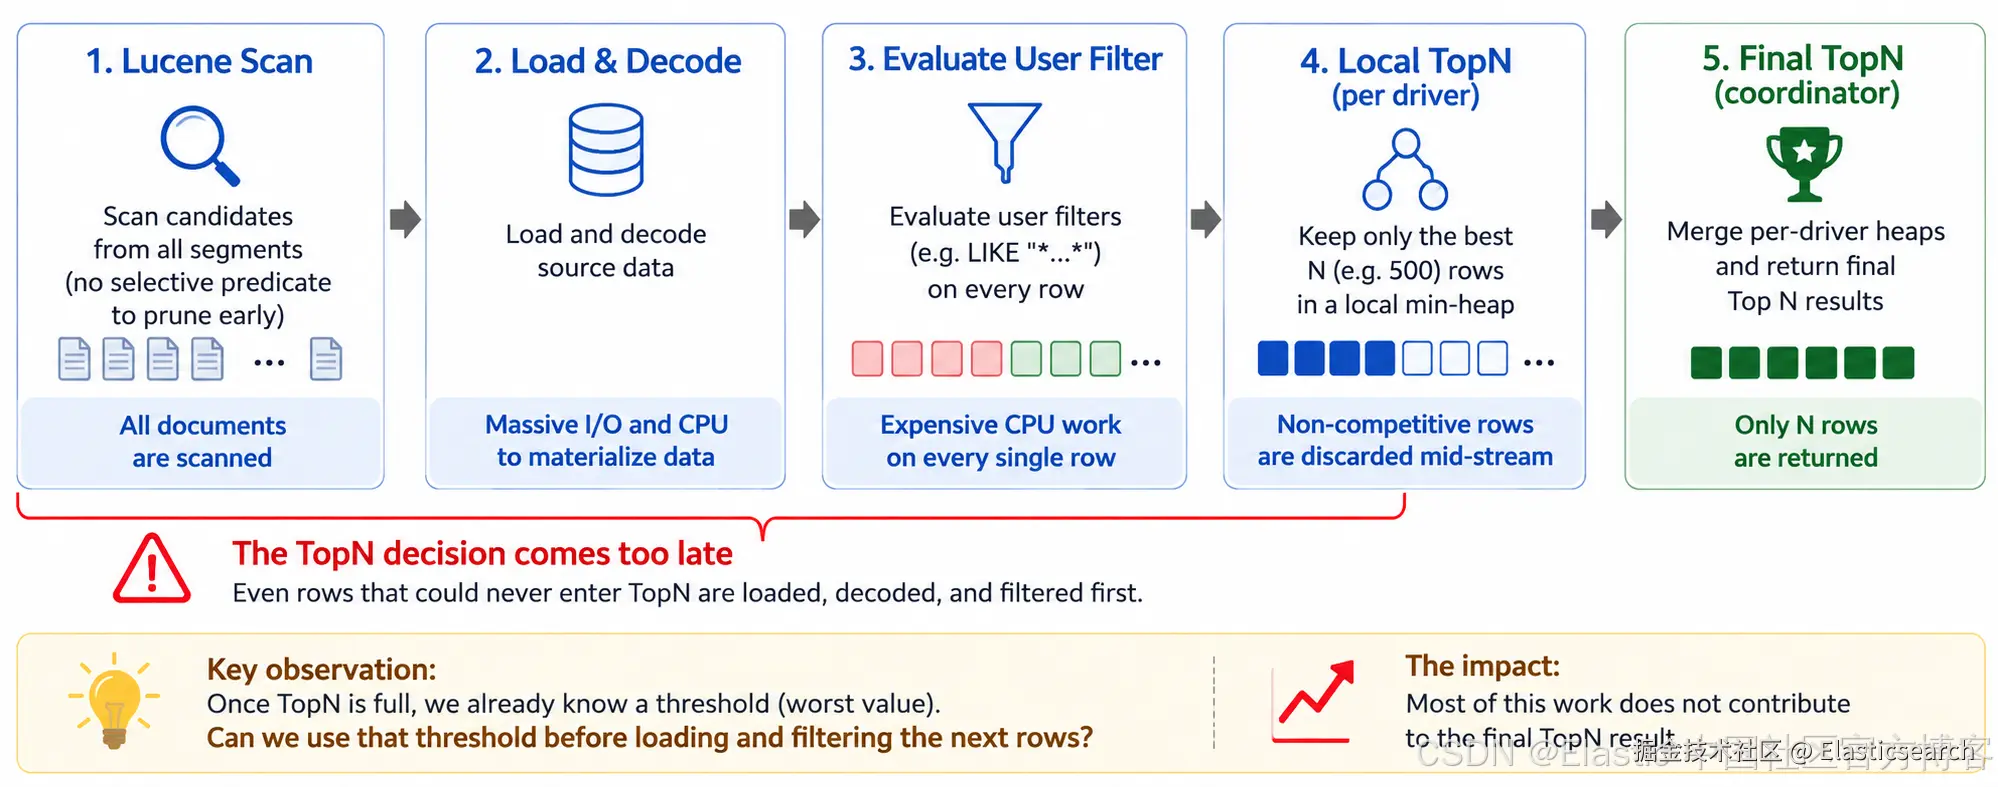
ES|QL 中 min-competitive TopN 剪枝的工作原理
TopN 会在查询仍在运行时获取一些有用的信息。一旦其堆已填满,当前堆中最差的值就会成为一个竞争阈值:也就是说,任何无法超过该值的行都不可能进入最终结果。
ES|QL 可以将该阈值反馈给更早的执行阶段。两项变化使这一过程成为可能:
-
动态 Lucene 下推。随着 TopN 找到更好的候选项,其竞争阈值也会不断提高。ES|QL 将该阈值下推到 Lucene,使 Lucene 可以跳过那些无法超过当前 TopN 最差值的候选项。这样就无需加载、解码和评估那些根本没有机会进入结果的行。
-
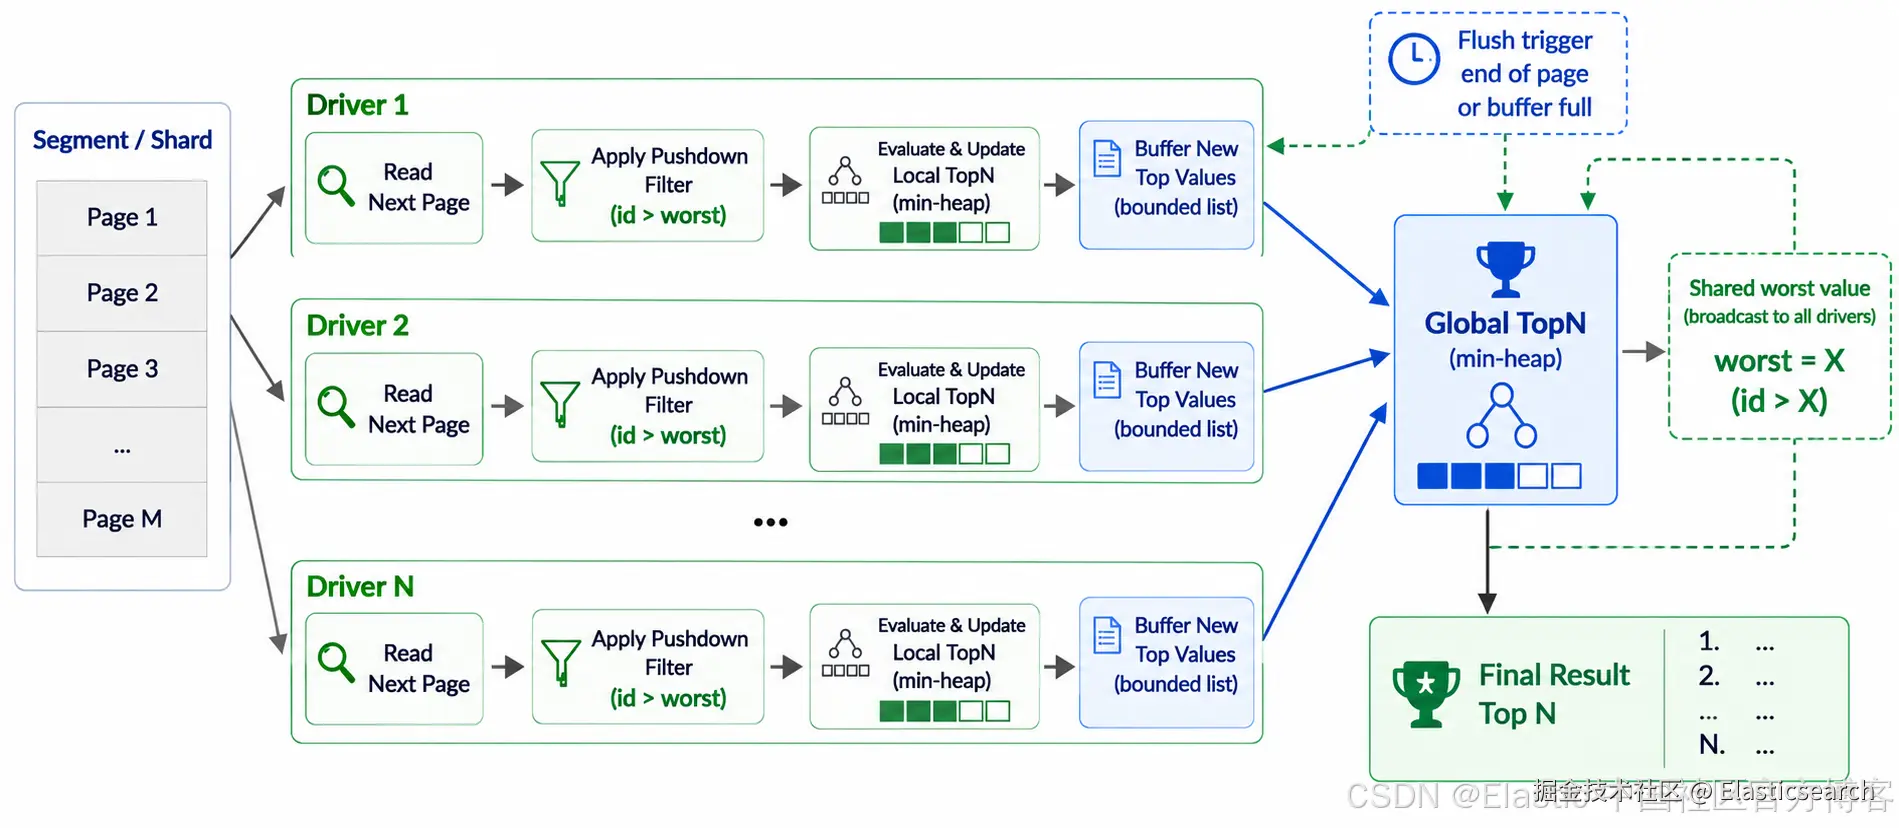
在多个 driver 之间共享阈值。ES|QL 会通过多个 driver 并行处理数据。如果每个 driver 只使用自己的本地阈值,那么一个 driver 就无法利用另一个 driver 发现的更好候选项。共享已知的最佳竞争阈值意味着,一个 driver 找到的优秀结果可以立即帮助其他所有 driver 对剩余工作进行剪枝。
这两项变化共同将 TopN 从一个后期阶段的过滤器,转变为一种能够在查询执行流程更早阶段就影响查询执行的机制。
min-competitive TopN 优化是如何工作的?
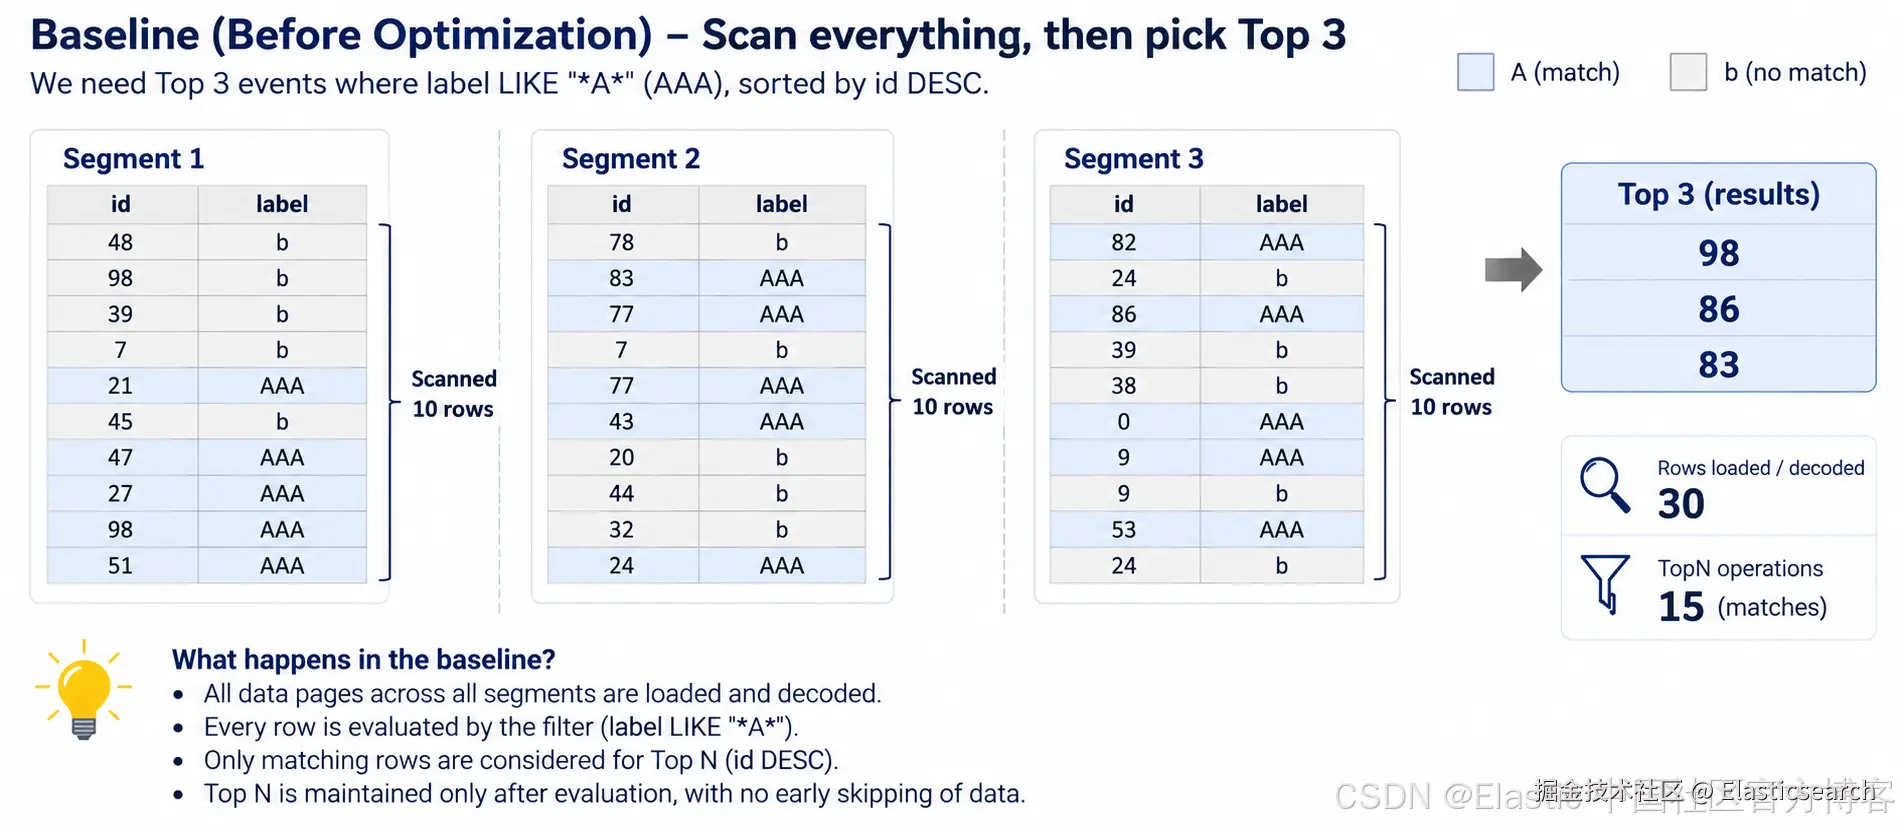
查询要求从三个各包含 10 行的 segment 中,找出匹配 wildcard 过滤条件的前三行,并按降序排序。在没有这项优化的情况下,TopN 看到任何结果之前,全部 30 行都必须先被加载、解码,并根据过滤条件进行评估,代价是加载 30 行并执行 15 次 TopN 操作。
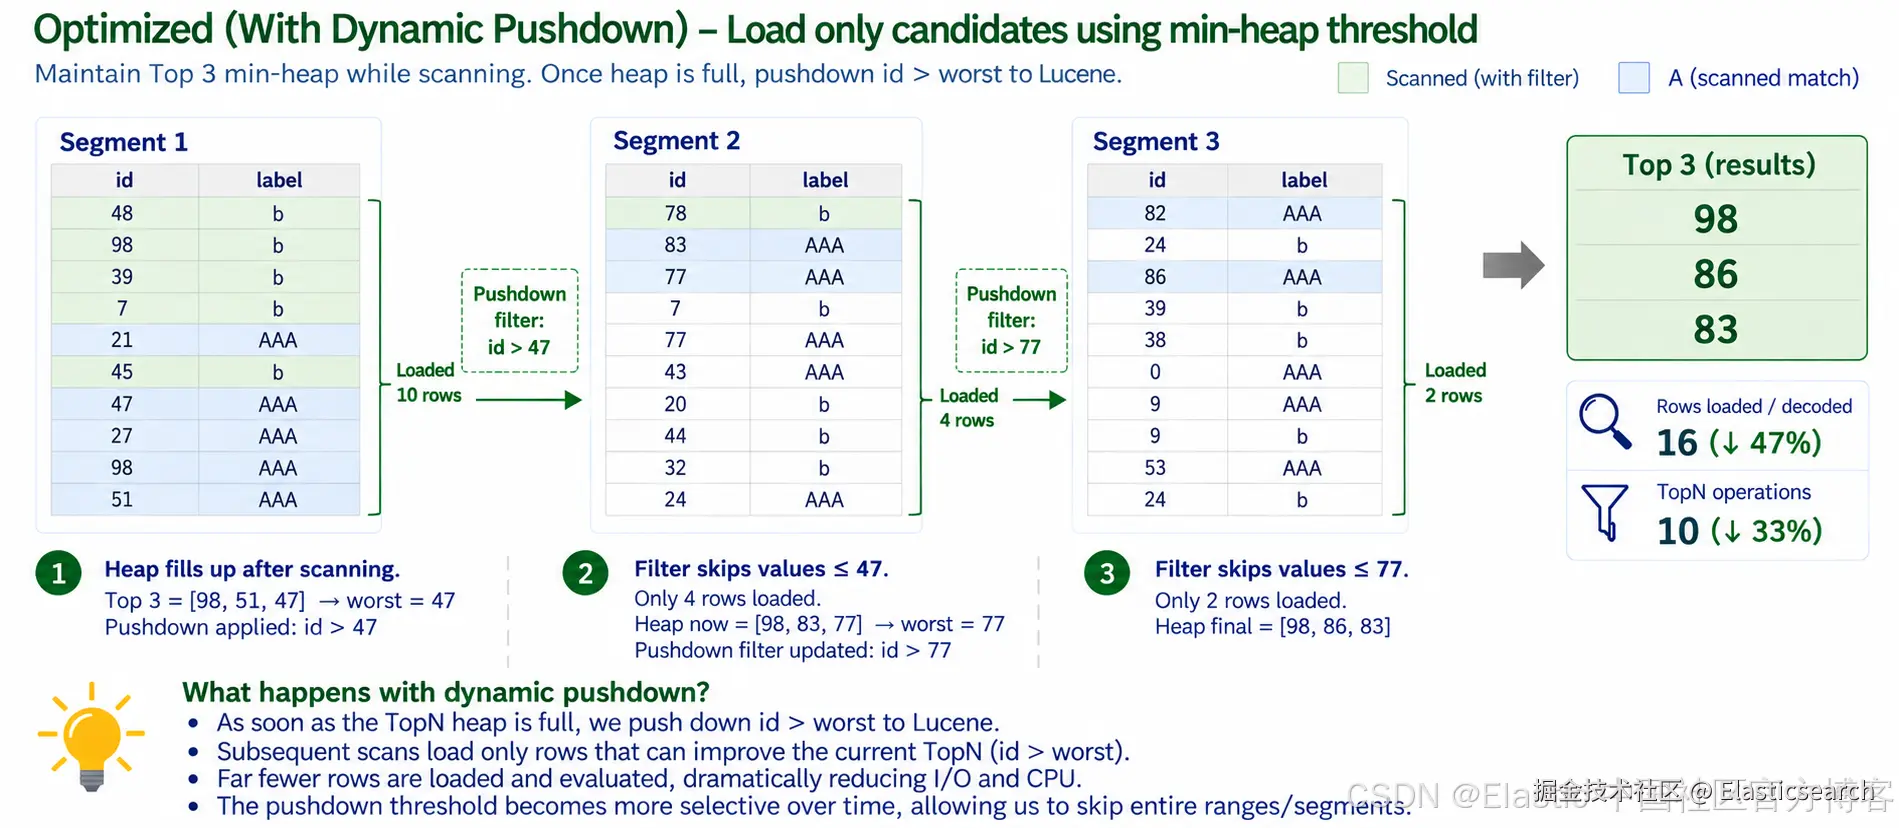
通过动态下推,ES|QL 会在扫描过程中维护 TopN 堆。在第一个 segment 结束时,堆中填入 [98, 51, 47],其中最差的条目会作为竞争阈值下推到 Lucene。这使第二个 segment 从 10 行减少到只需处理 4 行,堆也随之提升为 [98, 83, 77],并再次收紧阈值,因此第三个 segment 中只需加载 2 行。最终得到相同的 3 个结果,但只需加载 16 行并执行 10 次 TopN 操作。
在多个 driver 之间共享 TopN 阈值
一个 driver 可能会立即找到非常优秀的最新候选项。如果没有协调,另一个 driver 不知道这一点,仍会使用一个较宽松的阈值继续工作。共享全局最差竞争值,可以让这一发现惠及所有 driver。
在本地节点和 Elastic Cloud Serverless 上的基准测试结果
min-competitive TopN 优化在 Elasticsearch 9.6 中正式发布。针对真实世界的 Nginx 数据进行基准测试(相同查询、相同 数据集 ,取 51 次测量的 p50,并舍弃 20 次预热运行):
| 本地节点 | Serverless (GCP) | |
|---|---|---|
| 优化前 | ~500 秒 | ~520 秒 |
| 生产实现 | ~5 秒 | ~14 秒 |
| 运行时间改进 | ~99% | ~97% |
| 加速比 | 100 倍 | 37 倍 |
基准测试硬件
| 本地节点 | Serverless(GCP) | |
|---|---|---|
| CPU | Apple M4 | 小型 GCP 主机 |
| RAM | 48 GB | 8 GB |
| Java Virtual Machine(JVM)堆 | 24 GB | 4 GB |
| 存储 | 本地外置 TB5 NVMe SSD | 云存储 |
| Shards | 100 | 100 |
这种查询优化技术什么时候最有帮助?
当 TopN 很早就开始具有竞争力时,收益最大。如果在执行开始阶段就出现了优秀的候选项,阈值就会快速提高,后续扫描也会得到积极的剪枝。以下三个条件会进一步放大这一效果:
-
N 相对于候选项总量很小。从 3.46 亿个文档中找出 500 行,相比返回很大一部分匹配结果,优化器有更多空间消除不必要的工作。
-
Lucene 之后的处理成本足够高,以至于跳过一行能够节省可测量的开销,例如避免加载较大的字符串、解压缩或执行 wildcard 评估。
-
一开始就有很多候选项通过 Lucene 的粗略扫描。如果几乎没有任何结果匹配初始过滤条件,那么能够消除的不必要工作就不多了。
如果匹配行很少,或者很晚才发现优秀的候选项,阈值需要更长时间才能变得有用,因此收益可能会小得多。
当前实现适用于按 @timestamp 排序的查询。按其他字段排序的查询目前还无法从这一优化中受益。
ES|QL 查询性能的下一步
同样的思路还有多个发展方向,包括:
-
**其他数值排序字段。**底层方法本身并不局限于时间戳,因此将其扩展到其他数值排序字段,可以让更广泛的排序 TopN 查询受益。
-
**优先处理有希望的数据。**阈值变得有用的速度取决于 TopN 多早能够看到优秀的候选项。优先处理更有希望的数据切片,可以更早建立一个强阈值,从而对后续工作进行更积极的剪枝。
-
**提前终止。**随着阈值在执行过程中不断加强,可以判断剩余范围是否已经不可能产生更好的结果,并完全停止处理这些范围,而不是一直运行到执行完成。
-
**跨节点协调。**当前优化会在一个节点内的多个 driver 之间共享竞争信息。进一步在多个节点或集群之间进行协调,可以让分布式查询某一部分发现的优秀候选项减少其他地方的工作量。
-
**延迟物化和结果流式传输。**竞争过滤和延迟物化从不同角度解决同一个问题。竞争过滤会尽早消除那些不可能进入最终 TopN 的行,而 fetch 阶段则可以将昂贵字段值的加载推迟到可能成为最终结果的候选项集合大幅缩小之后。结果流式传输还可以进一步扩展这一思路。如果引擎能够确定某些排名靠前的结果已经不可能被替换,就可以在整个查询完成之前返回这些行。对于交互式分析来说,快速获得第一个有用结果与查询的总运行时间同样重要。
这对 Elasticsearch 性能调优意味着什么
Elasticsearch 9.6 中的 min-competitive TopN 优化展示了这样一个事实:当查询执行过程中发现的信息能够反馈给更早的阶段时,可以避免大量工作。在我们的 Nginx 日志基准测试中,这使单节点上一个大约 500 秒的查询缩短到了大约 5 秒。
这也只是一个起点。将竞争过滤扩展到更多排序字段、更早找到优秀候选项、更早终止工作,以及最终在节点之间协调这些决策,都为进一步推进这一思路提供了机会。
我们越早知道哪些结果仍然有可能胜出,就越少需要为那些不可能胜出的结果进行工作。
常见问题
min-competitive TopN 如何让 Elasticsearch 查询变得更快?
min-competitive TopN 优化是 Elasticsearch 9.6 中的一项 ES|QL 执行改进,它会将不断增长的结果集反馈给查询执行的更早阶段。当 ES|QL 为一个排序 LIMIT 查询不断累积候选项时,它会动态提高 Lucene 需要返回的最小值,从而跳过那些已经不可能改善最终结果的文档范围。这可以让大型数据集上的查询时间最多缩短 99%。
所有排序 LIMIT 查询都能同等程度地从这一优化中受益吗?
不能。这项改进目前专门针对按 @timestamp 排序的 TopN 查询,其效果取决于有用竞争阈值建立的速度、请求的 TopN 大小、匹配行的分布,以及加载和评估候选项的成本。
这一优化会改变我的查询结果吗?
不会。这项优化改变的是找到 TopN 所需的工作量,而不是哪些行符合条件。只有在候选项不可能改善当前竞争结果时,才会跳过这些候选项。
Elasticsearch Search API 查询也支持这一功能吗?
目前还不支持。本文介绍的优化适用于 ES|QL 排序查询。针对 Elasticsearch Search API 采用 类 似方法是已知的发展方向,团队正在开展相关工作。跟踪 issue #136267 涵盖了更广泛的 min-competitive 优化工作,包括未来可能的扩展。
原文:Elasticsearch query performance: 100x faster ES|QL TopN | Elasticsearch Labs