项目名:ripwire(redhat-et/ripwire,Red Hat 红帽官方开源) GitHub:https://github.com/redhat-et/ripwire 协议:Apache-2.0 | Star:2.1k+(截至 2026-09-15)| 语言:C++23 形态:单个零依赖二进制(CLI)+ 可选 MCP Server | 适配:Claude Code、Codex、Cursor、Windsurf、Gemini、opencode、aider 一句话:让 Agent 在读代码之前先拿到一张确定性的调用图------改哪里、会炸到谁、该跑哪些测试,一目了然。
开篇:Agent 读代码的方式,又慢又贵
观察一下你的 AI 编程助手是怎么理解一个陌生仓库的:
grep -rn 某个关键词 → 刷出一堆噪音 → 逐个 read 打开好几个整文件 → 在几千行里人肉分辨「这是真调用还是注释里提了一嘴」。
这个过程有两个致命问题:
-
慢:要反复 grep、反复读文件,一个问题常常要三四轮才搞清楚;
-
贵:整文件读进上下文,大量是无关代码。你按 Token 付费,却为一堆注释、空行、无关函数买了单。
红帽(Red Hat)的 emerging technologies 团队最近开源的 ripwire ,想当的就是「AI 上下文界的 ripgrep」:
别让你的 Agent 一头扎进代码里瞎摸,先给它一张地图。
它指向任意仓库,产出一张排序过的、确定性的调用图(call graph):该碰什么、会破坏什么、该跑哪些测试------一次调用给全,不用再 grep、不用再连开几个整文件。
这篇我们详细拆。
目录
-
[它到底是什么:一个 C++23 单二进制,不是又一个图数据库](#它到底是什么:一个 C++23 单二进制,不是又一个图数据库)
-
[十个高频场景,Token 到底省多少(附实测表)](#十个高频场景,Token 到底省多少(附实测表))
-
[CLI 还是 MCP?作者的建议出人意料](#CLI 还是 MCP?作者的建议出人意料)
-
[和 graphify 等同类工具什么区别](#和 graphify 等同类工具什么区别)
-
[适合谁 / 不适合谁](#适合谁 / 不适合谁)
一、它到底是什么:一个 C++23 单二进制,不是又一个图数据库
ripwire 的技术选型非常「红帽」:C++23 写的单个自包含可执行文件,运行时零依赖、纯本地、离线、不需要 API key、不做 embedding、不启索引服务器、没有常驻 daemon。
所有语法解析依赖都在构建时 vendor(内联)进来,所以装完就是一个二进制,断网也能跑。
它内置了 24 种语法(tree-sitter 系),覆盖一大票语言:Rust、C/C++、Objective-C、Python、Go、Swift、TypeScript/JavaScript、Java、Kotlin、Dart、Ruby、PHP、C#、Bash、Elixir、Lua,外加 JSON/TOML/YAML/Markdown 这类配置标记语言,甚至连 Metal、CUDA 都认。
速度和内存有多夸张?官方在 django、webpack 和它自己仓库上,拿一个「领先的图数据库代码上下文 MCP server」做了 48 个匹配问题的对照实测:
| 指标 | ripwire | 图数据库 MCP server |
|---|---|---|
| 索引耗时 | 0.25--0.45 秒 | 23--52 秒 |
| 索引内存 | 6.6--16.5 MB | 391--623 MB |
| 热查询响应 | 197 ms | 1,082 ms |
在 llvm-project(18 万+ 文件)这种怪兽仓库上,冷解析约 156 秒 CPU;更夸张的是 0.6.1 版本把「被拒绝调用」的索引从 114 MB 压到了 368 KB,而输出的计数和字节完全不变。这就是「不要图数据库、直接确定性解析」带来的收益。
它的理论底子也很有意思:README 里折叠了一份 docs/LINEAGE.md,声称把 49 个仓库和 71 篇论文 的结论折叠进了这一个可执行文件------从 1976 年 McCabe 的圈复杂度、1972 年 Spärck Jones 的词项特异性,一直到 2026 年最近两个月刚出的 Agent 检索、上下文压缩成本论文(每条都带 arXiv 编号可查)。甚至还列了一份「237 个调研过但什么都没贡献的工具」清单并说明原因。这种把学术血统摆出来给人审的做法,在快餐式开源项目里很少见。
二、十个高频场景,Token 到底省多少
这是全文最值得看的一张表。官方在自己仓库上实测(2026-08-08,数字按「Token ≈ 字节数/4」估算,每条都附了可复现的命令),按「理解 → 导航 → 审查改动」排序:
| 你想问的 | 命令 | ripwire | 朴素读法(grep+读文件) | 省多少 |
|---|---|---|---|---|
| 快速熟悉这个仓库 | ripwire . |
~5.6K | 读 README+架构文档 ~20--25K | 3.6--4.5× |
| 功能 X 在哪处理 | ripwire . --for="..." |
~2.1K | grep+读文件 ~4.9--20K | 2.3--9.3× |
| 我已经知道些什么 | --recall="..." |
~15K | 读全部 119 篇 md ~445K | 29.2× |
| 为这个任务备好上下文 | --pack-task="..." |
~2.1K | 读所有相关整文件 ~16--80K | 7.7--37.7× |
| 只看这一个函数 | --expand=SYM |
~260--16.5K | 读整个文件 ~43--174K | 2.6--670× |
| 谁调用了这个函数 | --callers=SYM |
~580 | grep 噪音+开 2--3 文件 ~40--52K | 69--89× |
| 改这个安全吗 | --impact+--uses |
~1.3K | 开所有直接使用文件 ~18K | 14.4× |
| 我手上有个堆栈 | --from-trace=FILE |
~1.4K | grep 7 个帧名+开文件 ~124--298K | 87--208× |
| 改了这些文件,跑啥测试 | --situ |
~410 | git diff+grep ~3--132K | 7.3--324× |
| 审查这个 PR/diff | --pr-context=REF |
~1.9K | git diff+开文件 ~4.8--51K | 2.6--27.5× |
几个我特别有共鸣的点:
-
--callers(谁调用了它)只要约 580 Token。日常我们 grep 一个函数名,返回一大片,其中大部分是注释、字符串、同名变量,还得开两三个文件才能确认真正的调用点。ripwire 直接给你解析过的、确定的调用者; -
--from-trace(堆栈溯源)能省 200 多倍。把报错堆栈喂给它,它把每一层帧名直接解析到定义,而不是你手动一帧一帧 grep; -
--situ(改完该跑啥测试)约 410 Token。它能找到文件名 grep 都找不到的测试------因为测试是通过被测符号间接关联的,光看文件名根本发现不了。
它追求的目标叫 terminality(终结性):问一个问题,答案应该一次给全,不用再补 grep、不用再读三个整文件。因为「一次调用 + 三次 grep」等于同一个搜索付了两遍钱,并没有真正省到。
三、最难得的品质:对「自己不知道」保持诚实
代码分析工具最危险的不是报错,而是自信地给你一个不完整的答案,你却以为是全貌。ripwire 在这点上相当克制,README 里反复强调两条「台阶」:
-
对缺失保持诚实 :一个不可能是全集的计数会明确标成
floor(下界);零结果表示「没找到」而不是「不存在」;任何截断都会在输出头里披露。解析不了的文件会带一行「解析健康度」,没索引的语言在地图第一行就点名; -
给开销明码标价 :你可以给答案设一个 Token 预算(
--token-budget)。完整答案塞不下时,它会告诉你「超预算了」,而不是默默丢掉你最需要的那一行。
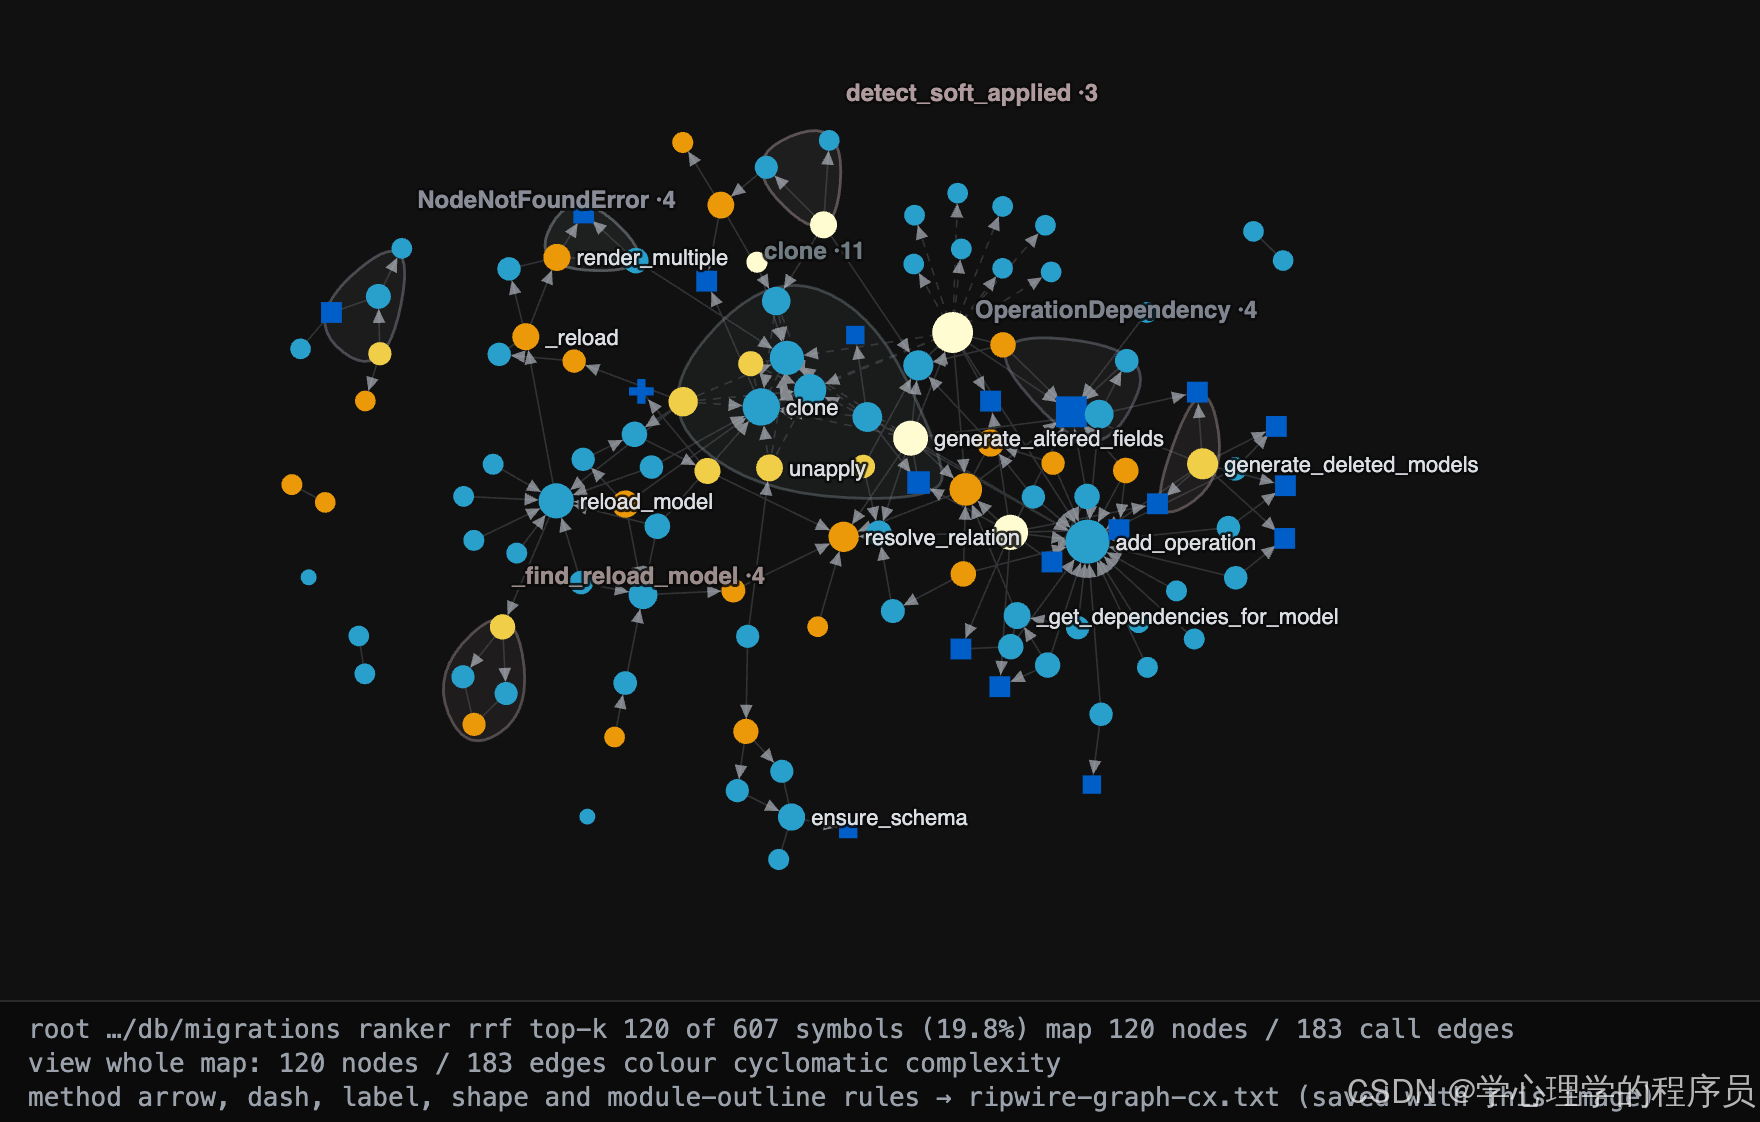
最能体现这一点的是虚线箭头 :解析器无法 100% 确定该连到哪个目标的调用边,会画成虚线,并给出分叉的两个候选。README 自豪地说「没有别的工具会标出自己对哪条箭头没把握」。在上面那张 Django 迁移自动检测器的图里,183 条边中有 31 条是虚线------猜测被明确标成猜测。
还有个很诚实的反例:当你要看一个很小的文件里的某个函数时,如果附带的「排序邻域包」反而比整个文件还大(实测一个 5.5KB 的函数,邻域包要 27.9KB),它会干脆把整个文件原样给你,并在响应里标注 mode="whole-file",而不是偷偷做个更贵的选择。docs/EVALS.md 里专门有一节发布「对自己不利的反例」。
另外它只给排序和披露,绝不改写(paraphrase)你的代码------你拿到的是真实代码,不是模型「理解后转述」可能走样的版本。
四、安装与使用
⚠️ 先说最重要的平台限制(Windows 用户必看)
我特意去核实了发布页和安装文档,这里必须给国内大量 Windows 读者提个醒:
-
官方预编译二进制目前只有 macOS 和 Linux(arm64 / x86-64),没有 Windows 的 .exe;
-
从 0.6.0 起,x86-64 预编译包要求 x86-64-v3 级 CPU(大致是 Intel 2013 年 Haswell、AMD 2015 年 Excavator 之后),安装脚本会先检查;老 CPU 需要从源码编译;
-
Linux 版在 RHEL 8+ 运行(红帽亲儿子,每个发布在 RHEL 9 上冒烟测试)。
所以 Windows 用户目前的路径 :用 WSL2(推荐 Ubuntu/RHEL),或者在 Mac/Linux 机器/服务器、开发容器里用。想原生 Windows 跑只能等官方支持或自己折腾编译(需要 CMake 3.24+ 和 C++23 编译器,clang 16+/gcc 13+,依赖全 vendor、可离线构建)。考虑到它是红帽出品,这个平台优先级并不意外。
macOS / Linux 一行装
RIPWIRE_REPO=redhat-et/ripwire bash -c "$(curl -fsSL https://raw.githubusercontent.com/redhat-et/ripwire/main/scripts/install.sh)"
export PATH="$HOME/.local/bin:$PATH"
ripwire --version
安装器会:下载对应平台的 Release 并校验 SHA-256 → 把二进制装到 ~/.local/bin/ripwire(免 sudo)→ 把 Agent skill 和 hook 暂存到 ~/.local/share/ripwire/ → 自动为它在机器上检测到的每个 Agent(Claude Code、Codex、Hermes 等)激活 skill,每激活一个打印一行。它默认不注册 hook、不改你的 shell 配置。
立刻试用
cd your-repo
ripwire . --for="我准备做的改动,用一句话描述"
安装动作会顺手「教会」你的 Agent:不光告诉它怎么用 每条命令,还告诉它什么时候该用哪条。所以大多数人最简单的用法就是开场跟 Agent 说一句:「Use ripwire on this repo.」
想可视化看地图也可以:
ripwire path/to/django/db/migrations --rank-by=rrf --top-k=120 --color-by=cx --html=map.html这会生成一张按圈复杂度上色的 HTML 调用图(就是本文封面那张 Django 图)。还能换成按 git 提交频次上色(--color-by=churn),对比「结构上复杂的地方」和「历史上频繁改动的地方」是不是同一批------README 的例子里 76% 的节点在两种着色下落到了不同色带,说明结构复杂度和改动热度经常不是一回事。
维护命令:ripwire . --doctor 检查二进制、skill、hook 是否就位;升级就是再跑一遍安装命令。
五、CLI 还是 MCP?作者的建议出人意料
ripwire 同时提供 CLI 和一个 MCP Server,但 README 明确建议:
先用 CLI,它更便宜。MCP 是可选的第二入口。
原因很实在:一旦注册 MCP server,它所有工具的参数 schema 会常驻在你 Agent 的上下文里,不管你这轮到底调没调用,都在烧 Token。而 CLI 只在你真正需要的那一刻通过 shell 管道进来。
如果确实要 MCP(比如你想让客户端 UI 原生集成),用 ripwire wrap <agent> 打印对应配置,支持 claude/codex/cursor/gemini/windsurf/opencode/hermes 等。Claude Code 就是一行:
claude mcp add ripwire -- ripwire --mcp还有个贴心命令 --help-task:面对 180 多个长参数不知道用哪个?它会根据你的任务推荐唯一一条可执行命令并给出选择依据;证据不足时它宁可不给建议,也不乱指。
六、和 graphify 等同类工具什么区别
这个系列第三弹介绍过 graphify(把代码库变知识图谱),可能有人会问是不是重复了。两者思路其实是两条路线:
| 维度 | ripwire | 图数据库 / 向量系工具 |
|---|---|---|
| 形态 | 单二进制,即起即用,无服务 | 通常要起索引服务器 / 图数据库 |
| 索引成本 | 0.25s / 6.6MB 级 | 几十秒 / 数百 MB 级 |
| 解析方式 | 确定性 AST/调用图,离线 | 部分依赖 embedding / 常驻服务 |
| 不确定性 | 虚线显式标注 | 多数不标注置信度 |
| 代码保真 | 不改写,只排序+披露 | 有的会做摘要转述 |
ripwire README 也很大气:它把「Vexp、CodeIndexer」这类有免费额度上限的工具标注为「排除,而非击败」(因为节点/项目/chunk 受限,没法公平对比),而不是靠踩对手抬自己。
七、适合谁 / 不适合谁
✅ 适合
-
日常在大仓库(几十万文件级)里让 Agent 改代码的人------冷启动 orient 的成本越高,它省得越狠;
-
用多 Agent 编排、每个子 Agent 都空上下文冷启动的进阶玩法------官方点名这是它最想解决的场景:每条并行线程都要重新认识一遍仓库,是整个系统里重复次数最多的成本,而地图是唯一不需要每个 Agent 重新发现的产物;
-
在意 Token 账单的人------callers/situ 这种查询动辄省几十到几百倍;
-
Mac/Linux/WSL2 用户,尤其喜欢「一个二进制走天下」的。
❌ 不适合
-
纯原生 Windows、又不想用 WSL 的人------暂时没有 exe,这是硬门槛;
-
维护的都是小型玩具项目------几秒就能读明白的仓库,用不上地图;
-
指望它支持的 24 种语言之外的冷门语言------未索引语言它会诚实告诉你,但帮不上忙;
-
想要可视化建模、拖拽编辑代码图的人------它是给 Agent 和命令行用的分析工具,不是给人画图的 IDE。
最后总结
ripwire 代表了 2026 年 Agent 工具链一个很清醒的方向:与其让模型用 grep 和整文件读取去「重新发现」代码库,不如先用确定性的静态分析,把一张准确、便宜、还自带置信度标注的地图递到它手里。
它最打动我的不是那些几百倍的省 Token 数字,而是贯穿全项目的工程诚实:零结果不等于不存在、猜测画成虚线、超预算明说、连对自己不利的反例都写进评测。一个测量你代码的工具,理应建立在那些「活了五十年、被反复验证」的结论之上------McCabe、Halstead 不是观点,是地基。
Apache-2.0、红帽背书、纯本地离线。Mac/Linux/WSL2 上天天跟大仓库搏斗的同学,非常值得装来跑一句 ripwire . 感受一下。