10 月 4 日(北京时间),一条推文把一篇论文推上了 X 的热门,1,329 个赞,10.7 万次浏览,配文是「这可能是今年关于 AI agent 最有用的一篇论文」。论文叫《Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents》,作者是咨询公司 Wavestone 的四位研究者,7 月 15 日提交到 arXiv,正文 83 页,是他们 4 月一份研究的扩充版。
论文做的事情很直接:把 11 个生产级 coding agent 的源码逐个读一遍,看它们到底是怎么搭起来的。这 11 个是 Claude Code、Codex CLI、Gemini CLI、Mistral Vibe 四个大模型厂商的官方产品,加上 OpenHands、Aider、Mini-SWE-Agent、Hermes、Pi、OpenCode、OpenClaw 七个开源项目,代码总量约 400 万行,涉及 Python、TypeScript 和 Rust。
本文挑出论文里对写代码、用 agent 的人最有用的五个结论:
- 所有 coding agent 都由同样的 7 个部分组成,差别只在每部分做得多大。
- 最小的和最大的差了三个数量级,任务完成率却差不多,大的那部分代码花在了别处。
- 11 个系统里没有一个用 LangChain 这类 agent 框架,也没有一个用向量检索来找代码。
- 4 月到 7 月的 90 天里,各家开始直接照搬彼此的设计,Codex 原样采用了 Claude Code 的 hook 事件名。
- 作者据此给出了 18 条设计建议,其中好几条和直觉相反。
最后一节讲读这篇论文要注意的地方,其中最重要的一点是:论文里的 Claude Code 分析,依据的是一份 3 月流出的源码快照。
agent 等于模型加 harness,harness 有 7 个部分
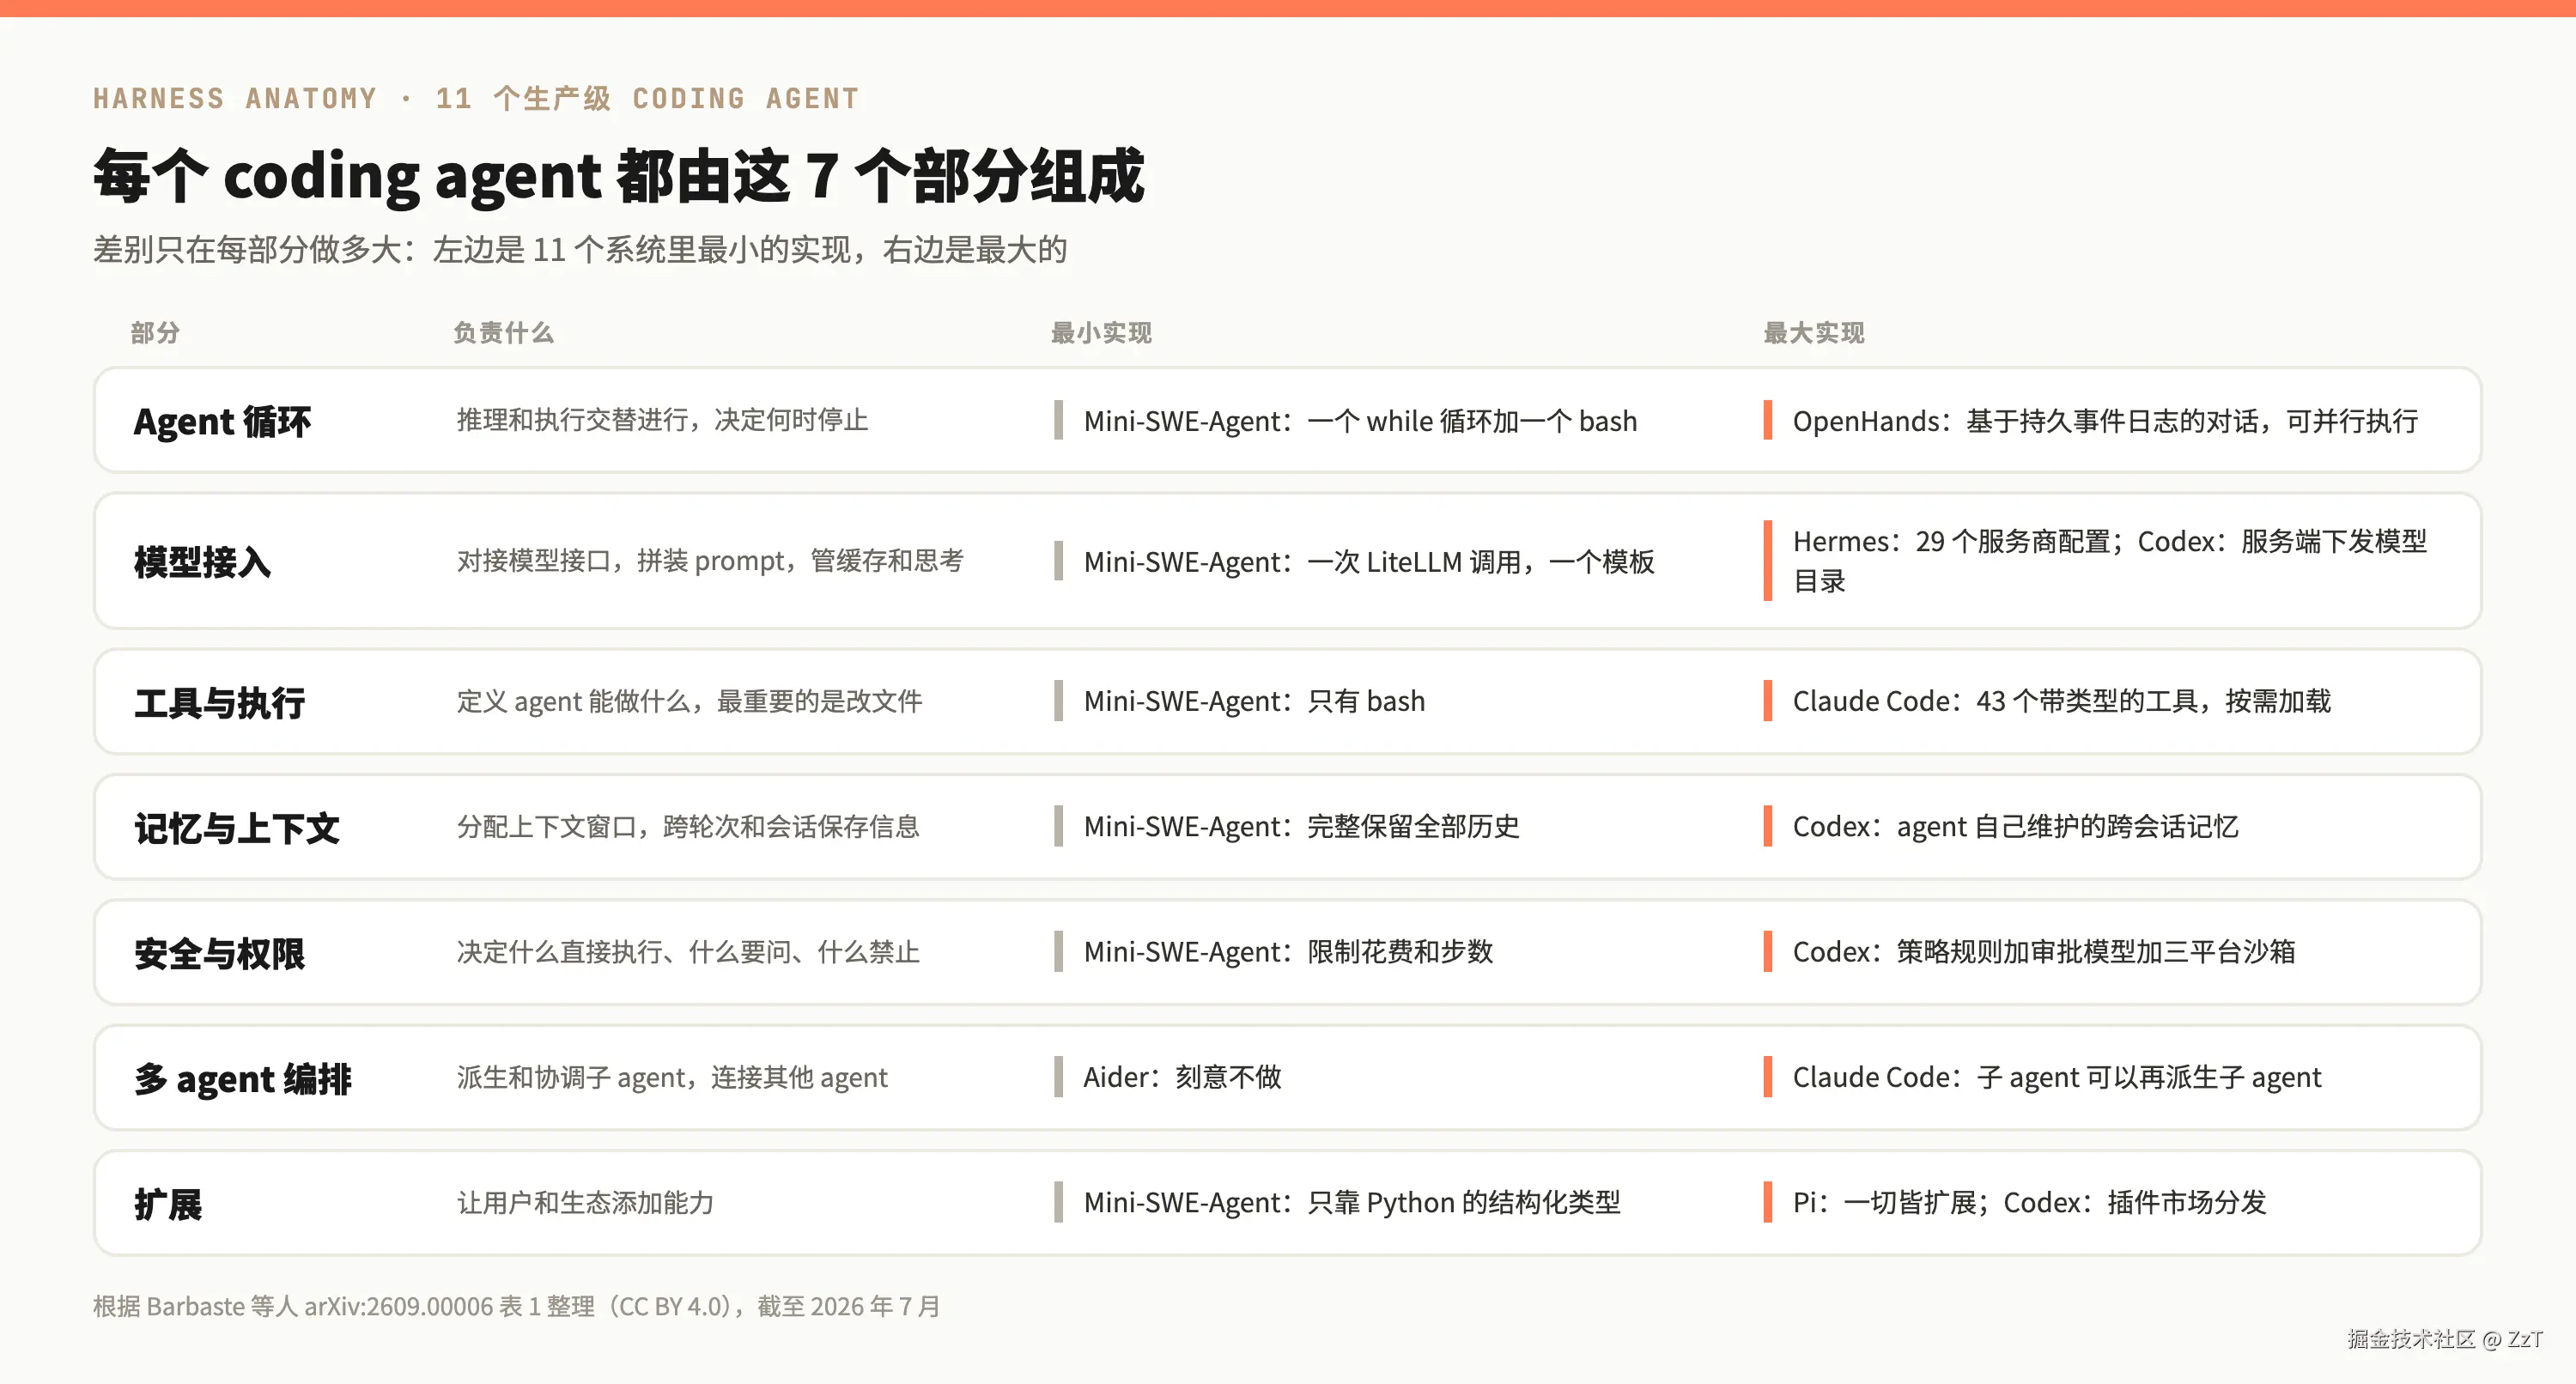
论文开篇给的定义是:agent 是模型加上 harness。模型提供智能,harness 负责把智能变成实际的工作,也就是循环、工具、上下文管理、安全控制、多 agent 编排和扩展接口这些东西。harness engineering 这个说法 2026 年初才出现,论文的目标是给它一份有源码依据的参考。
作者的核心论点是,所有 coding agent,从 100 行的研究原型到上百万行的产品,都要在同样 7 个部分上做选择,哪怕选择是「不做」。上图列出了每个部分在 11 个系统里最小和最大的实现。
几个两端差距最大的例子:
- 工具:Mini-SWE-Agent 只有一个 bash,Claude Code 有 43 个带类型的工具,而且按需加载。
- 安全:Mini-SWE-Agent 只限制调用次数和花费,Codex 是策略规则加一个负责审批的模型,再加覆盖三个操作系统的沙箱。
- 多 agent 编排:Aider 刻意不做子 agent,Claude Code 支持子 agent 再派生子 agent。
7 个部分之外,还有两个贯穿各部分的面:一个是人和程序驱动 harness 的界面层(终端界面、IDE 协议、HTTP 服务、SDK),另一个是会话存储(对话记录、持久化、恢复和分叉)。
规模差了三个数量级,任务完成率差不多
11 个系统的代码量跨度非常大。Mini-SWE-Agent 约 100 行就实现了全部 7 个部分:一个 while 循环、一个模板、一个工具、一个消息列表、两个上限。Codex 到 7 月已经是约 112 万行 Rust。
但规模和任务完成率没有对应关系。论文 4 月版列过各家自报的 SWE-bench Verified 成绩:OpenHands 77.6%,Mini-SWE-Agent 74% 以上,Claude Code 72.7%,Codex 69.1%。作者在 7 月版里把这一列删了,理由是这些数字都是自报的,用的模型和配置不同,有些还早于现在的默认设置。不过结论不变:做到能完成任务,门槛很低。
那大系统的代码都花在哪里了?论文的回答是:安全、用户体验、扩展能力,以及越来越多的客户端和传输层。OpenCode 去掉测试之后,约五分之三的代码是终端界面、网页、桌面和 SDK 客户端,不是 harness 本身。Codex 7 月的代码里,有上十万行用在应用服务的传输、插件和实时语音上,这些都不会体现在任何基准测试里。
没有一个用 agent 框架,也没有一个用向量检索代码
这是论文最受关注的发现,作者称之为两个缺席。
第一个缺席是 agent 框架。作者检查了每个项目的依赖清单,又在源码里搜索 LangChain、LangGraph、LlamaIndex、AutoGen、CrewAI、Pydantic AI、Genkit、Semantic Kernel、Google ADK 等框架的引用。在约 400 万行代码里,没有一条 agent 运行路径用到它们。Gemini CLI 连 Google 自家的 Genkit 和 ADK 都没用。作者在脚注里写,他们原本以为至少开源项目里会有人用 LangChain,为了找反例,查了几个星期,包括打包进来的依赖、动态导入和编译后的 TypeScript,最后才接受这个结果。
所有系统的循环都是用各自语言自带的异步机制手写的:Python 的 asyncio、TypeScript 的 Promise 和异步迭代器、Rust 的 Tokio。工具注册表都是自己围绕 Pydantic、Zod 这类校验库写的,prompt 模板都是普通的 Markdown、Jinja2 或者字符串拼接。
第二个缺席是代码的向量检索。作者搜了 Chroma、Pinecone、FAISS、sqlite-vec 等向量库,以及名字带 embedding、rag、retrieval 的文件和目录。结果是 11 个系统里,没有一个用 embedding 检索代码。
它们找代码用的是这些:
| 系统 | 找代码的方式 |
|---|---|
| Claude Code | ripgrep 关键词搜索、bash、按需读文件,自动发现 CLAUDE.md |
| Codex | Rust 写的文件搜索,从项目根目录到当前目录逐级拼接 AGENTS.md |
| Gemini CLI | 内置 ripgrep 和 glob,自动发现 GEMINI.md |
| Aider | 用 tree-sitter 提取符号,按 token 预算排序生成仓库地图 |
| Pi | 自动下载 ripgrep 和 fd |
embedding 只出现在对话记忆里,不出现在读代码上:OpenClaw 默认的记忆插件用 sqlite-vec 做混合检索,Hermes 则刻意用 SQLite 全文检索来搜历史会话,embedding 只在可选插件里。
作者给的解释是,代码本身有大量确定性的结构,比如路径、语言服务器、语法树,语义相似度替代不了;而且代码每分钟都在变,embedding 很快就过时。
顺带一提,那条热门推文说「检索代码都不用 embedding,而是用 ripgrep 和 tree-sitter」,后半句不太准确。按论文的表格,大多数系统用的是 ripgrep 一类的关键词搜索,tree-sitter 只在 Aider 的仓库地图等少数地方出现。
90 天里,各家开始直接照搬彼此
这次的 11 个系统里,有 8 个在 4 月版里已经分析过。作者没有换掉它们,而是在 7 月重新取了一次源码,所以论文里有一组难得的对照:同一批 harness,相隔一个季度的源码差异。作者总结了四个变化。
第一,趋同变成了模仿。4 月时各家的相似大多是各自独立想到的,到 7 月已经能在代码里找到来源:
- Codex 原样采用了 Claude Code 的 hook 事件名,以及它的 plan 模式交互。
- OpenHands 采用了 Claude Code 的插件清单格式和 task 工具的签名。
- OpenCode 会直接读取
~/.claude/skills目录。 - Hermes 的源码注释里写明了哪些设计分别借鉴自 OpenCode、Codex、OpenClaw 和 Goose。
第二,好的设计扩散得很快。工具按需加载从 1 个系统扩到 3 个,只读的 plan 模式从 2 个扩到全部 4 个厂商产品,用模型来判断是否放行的审批机制从 Claude Code 一家扩到加上 Codex 的 Guardian。作者的说法是,一个竞争优势在这个领域的半衰期是以周计算的。
第三,行为规则从 prompt 搬到了配置里。Codex 新版的模型 prompt 删掉了「不要提交」「不要过度设计」这类规则,改用功能开关控制;Mistral Vibe 删掉了「绝不提交」这条硬规则。随着模型自己学会了这些规范,harness 的治理能力也变强了,规则正从模型读的 prompt,转移到平台强制执行的配置。
第四,代码量增长得像平台一样快。Codex 的代码一个季度里从约 62 万行涨到约 112 万行 Rust,Mistral Vibe 增长了 77%。作为对比,最早的 Aider 在这 90 天里只有 18 个提交,已经进入社区维护状态。
另一个结论和我们日常用 Claude Code 直接相关:skill 的采用率已经超过了 MCP。11 个系统里有 9 个支持 skill,8 个支持 MCP。Pi 是打破平局的那一个,它实现了 skill 标准,同时明确拒绝 MCP。
18 条建议里最反直觉的几条
论文第 16 节把前面的观察整理成 18 条设计建议,每条都注明依据和已经这么做的系统。下面是和常见做法差别最大的几条:
| 建议 | 依据 |
|---|---|
| 从一个线性 while 循环开始,同时出现三个以上独立的轮次策略时再改成中间件管道 | Mini-SWE-Agent 50 行的循环自报 74% 以上 |
| 一开始只给一个 bash 工具,遇到具体问题再加 | 输出被截断时加读写文件,find 不好用时加 grep,整文件重写太费 token 时加局部替换 |
| 工具超过约 15 个时再做按需加载 | Claude Code 的按需加载让初始 prompt 减少约 40% |
| 不要按行号编辑文件,按上下文精确匹配 | 模型在行号上的偏差比在上下文匹配上更大 |
| 不要给代码做向量检索 | 11 个系统里 0 个这么做;真觉得需要,先在测试集上证明它比 ripgrep 加 tree-sitter 强 |
| 不要用 LangChain、AutoGen、CrewAI 这类框架做 agent 运行时 | 11 个系统里 0 个这么做;想要现成起点,用 Claude Agent SDK 这类 harness SDK |
| 确认任务里有能并行探索的阶段之前,保持单 agent | 引 Anthropic 的数据:多 agent 系统的 token 消耗约是普通对话的 15 倍 |
| 如果支持跳过所有确认的 YOLO 模式,下面要留一层底线 | Hermes 有 12 条硬性规则在 YOLO 模式下依然生效 |
| 不要过度设计卡死检测,但简单的上限要有 | Claude Code 和 Codex 都没有自动卡死检测;连续三次相同调用就询问用户,十几行就够 |
论文最后附了一个约 90 行的 Python 骨架,把线性循环、中间件式的策略、四个工具(bash、读、写、局部替换)、逐级发现 Markdown 上下文文件和到阈值自动压缩放在了一起。作者强调它不是能直接用的库,是一个用来复制和改造的起点。
这些建议里有一部分和 Anthropic 2024 年 12 月到 2025 年 9 月发的几篇 agent 工程文章一致,作者专门列了出来,并承认分不清这是因为大家面对的是同样的现实,还是因为大家都读了这些文章。
读这篇论文要注意的地方
- Claude Code 的分析依据的是一份 3 月流出的源码快照,作者在表格注释里写明了这是他们能拿到的最新源码,而 7 月实际发布的版本是 2.1.206,可能有差异。Claude Code 后来又加了 Mods 等能力,论文里都没有。
- SWE-bench 成绩都是各家自报的,作者已经把它们从对比表里删掉,只在脚注里留作记录。
- 作者自己提醒,工具数量、功能清单、版本号这类数据几周就会过时,循环的分类、7 个部分的划分和两个缺席这类结构性结论到目前为止比较稳定。论文里有 3 条 4 月得出的观察,在 7 月版里被新证据推翻后改写了。
对用 Claude Code 的人来说,这篇论文最有用的不是哪一条具体数据,而是一张地图:你在 CLAUDE.md、skill、hook、权限规则、子 agent 上做的每一项配置,都落在这 7 个部分里的某一个。下次犹豫要不要给 agent 接一个向量库、套一个框架、多拆几个子 agent 时,可以先看看这 11 个系统是怎么选的。
资料来源:Paul Barbaste、Tristan Darrigol、Germain Vu、Tom Wiltberger,《Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents -- A Source-Code Study of Eleven Systems》,arXiv:2609.00006,2026 年 7 月,原文链接,以 CC BY 4.0 协议发布。本文的表格和配图根据论文内容重新整理,非原图。