Nginx 通常守在业务系统最前面,反向代理、负载均衡、TLS 卸载、缓存和限流这些活儿,很多都要经过它。用户访问慢了、接口报错了,或者后端服务不可用了,请求往往也都会先经过 Nginx。
所以别只把 Nginx 当成一个代理服务。它其实还是离用户最近的观察点,也是我们判断业务流量和系统健康状况的重要入口。
为什么要做 Nginx 可观测
不少团队对 Nginx 的监控还停留在"进程活着、端口能通"。这当然有用,但也只能告诉我们服务有没有彻底挂掉。真到排障时,大家更想知道的往往是这些问题:
- 当前请求量是否正常?
- 502、504 是 Nginx 引起的,还是后端服务出了问题?
- 请求变慢发生在客户端、Nginx 还是上游应用?
- 哪个域名、接口或上游节点正在大量报错?
- 活跃连接不断增加,是正常流量,还是出现了连接堆积?
说白了,基础监控只能告诉我们"Nginx 好像出问题了",而可观测要继续回答"哪里出了问题、影响了谁、为什么会出问题"。
为什么选择观测云作为后端
Prometheus、Grafana、ELK、Loki 和 Jaeger 等开源组件都可以用来监控 Nginx,这套组合本身没有问题。不过,它们通常分别负责指标、日志和链路,数据天然分散在不同系统里。
真正麻烦的是排障过程:先到 Grafana 看指标,再去 ELK 翻日志,最后打开 Jaeger 找调用链。页面来回切换还是小事,更费精力的是自己维护存储、权限、告警,以及不同数据之间的关联关系。
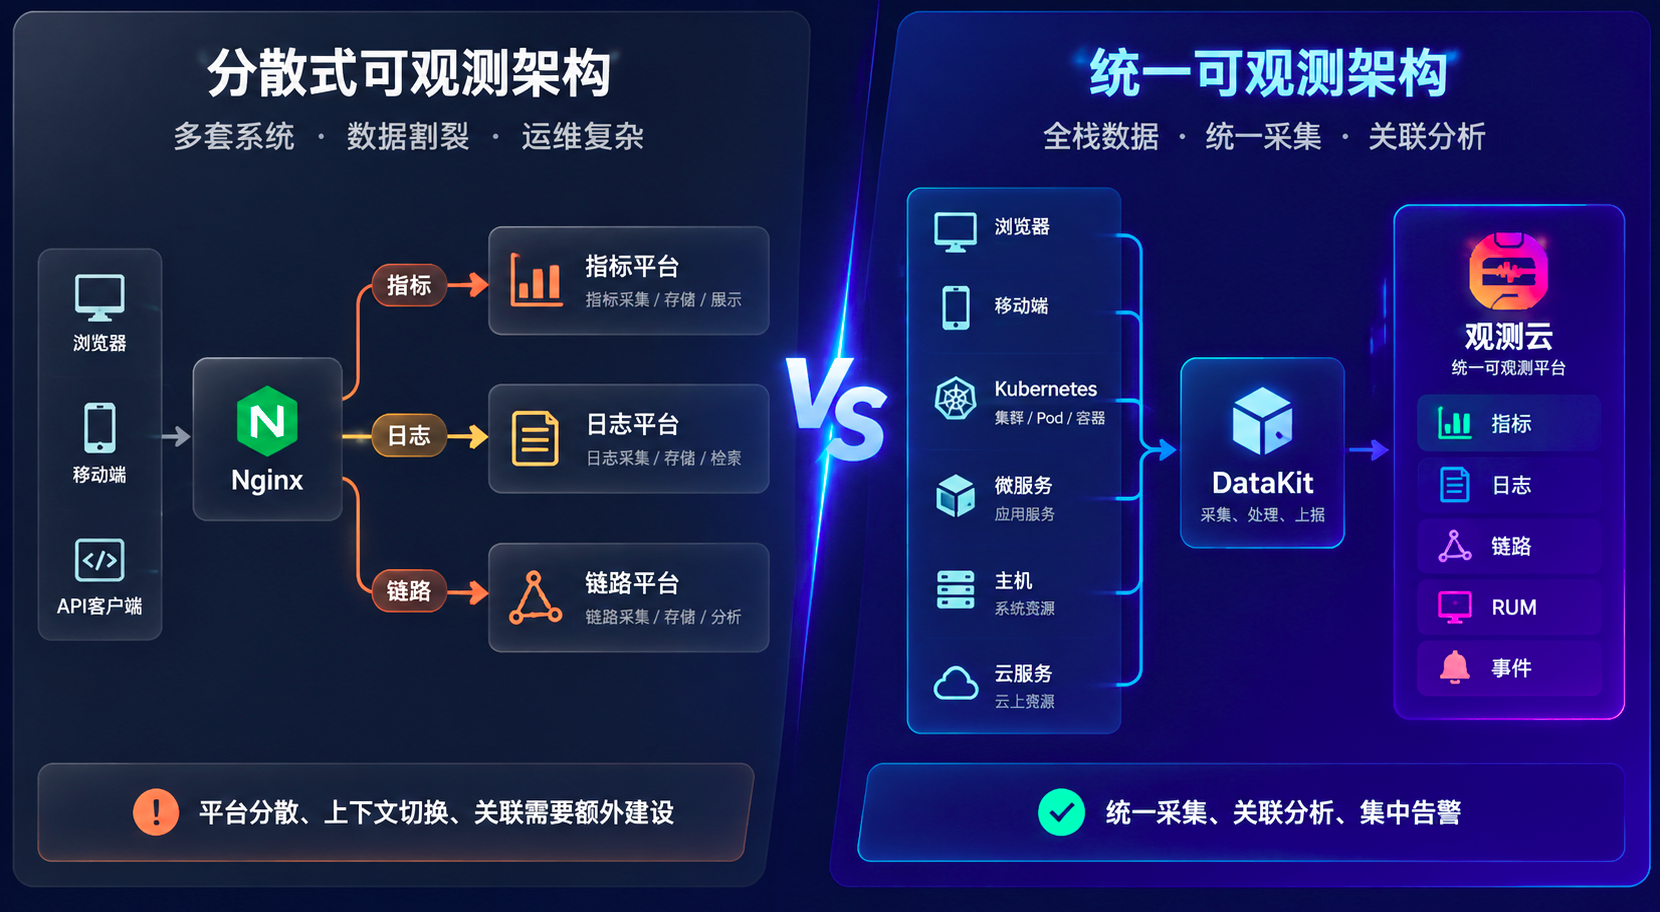
选择观测云,并不是说其他后端不能采集 Nginx,而是希望把排障链路缩短一些。和 Nginx 有关的数据可以放在同一个平台里分析,包括:
- Nginx 性能指标;
- Access Log 和 Error Log;
- 主机及容器资源;
- 后端应用链路;
- RUM 用户访问数据;
- 可用性监测和告警事件。
只要统一好 env、service、version、request_id 和 trace_id,排障时就不用在几个系统里反复"对时间、猜服务",而是可以顺着一条比较自然的路径往下查:
text
收到告警
   ↓
查看 Nginx 异常指标
   ↓
检查对应时间段的日志
   ↓
根据 request_id 或 trace_id 查看调用链
   ↓
定位异常接口、上游节点或后端服务
当然,如果企业已经有成熟的 Prometheus、ELK 和 Grafana 平台,还有专门的平台团队负责维护,自建方案依然很有价值。如果更在意快速落地,希望少花一些时间搭平台、做关联,观测云的一体化采集与分析会省事不少。
Nginx 需要观测哪些方面
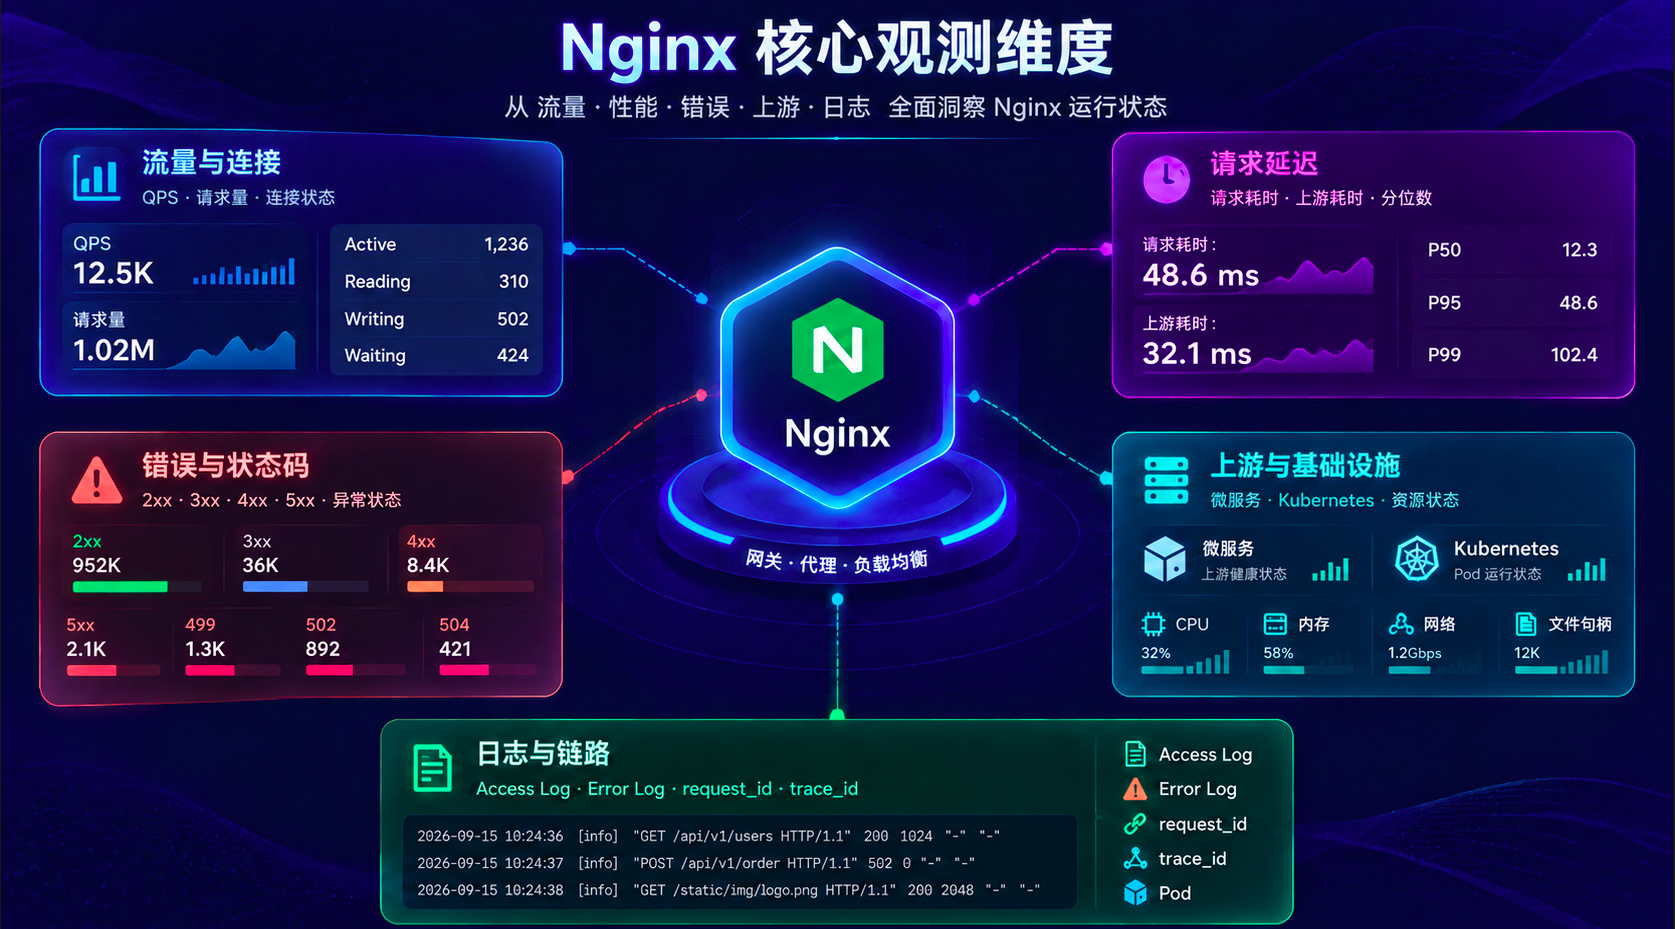
流量与连接
第一步先别急着看错误,先回答"流量有没有变化"。重点关注 QPS、请求量趋势,以及 Active、Reading、Writing、Waiting 等连接状态。
比如 Active Connections 持续升高,可能只是业务流量增长,也可能是慢请求堆积,或者连接迟迟没有释放。只看这一条曲线还不能下结论,需要继续结合延迟和资源指标判断。
错误与状态码
看到错误先别急着把锅甩给 Nginx。建议分别统计 2xx、3xx、4xx、5xx 的数量和比例,尤其关注:
- 499:客户端提前断开,也可能是接口太慢导致客户端超时;
- 502:连接上游失败或上游返回异常;
- 503:服务不可用或触发限流;
- 504:等待上游响应超时。
只看错误数量很容易误判。业务高峰期请求量更大,错误数跟着上升并不奇怪,所以一定要把错误数量和错误率放在一起看。
请求延迟
除了请求总耗时,还要记录上游连接耗时、等待响应头耗时和上游完整响应耗时。平均值看起来可能很漂亮,但少量慢请求很容易被它"平均掉",所以 P95 和 P99 往往更值得看。
如果上游响应耗时明显升高,问题大概率在后端应用;如果 Nginx 请求总耗时很高,但上游耗时并不高,就要把注意力转向客户端网络、响应传输或者 Nginx 自身资源。
上游与基础设施
Nginx 自己没报警,不代表上游服务就没问题。还要继续看各上游节点的请求量、错误率和响应时间,以及 Nginx 所在主机或容器的 CPU、内存、网络、文件句柄和进程状态。
日志与链路
指标负责告诉我们"哪里不对劲",日志和链路则负责把问题落到具体请求上。建议在 Nginx 和应用日志中统一记录 request_id、trace_id、service、env 和 version。
其中,request_id 用来串起 Nginx 与后端日志,trace_id 可以继续跳到 APM 调用链。这样发现一条 502 或慢请求后,就能顺藤摸瓜找到具体的后端服务和异常调用。
如何将数据接入观测云
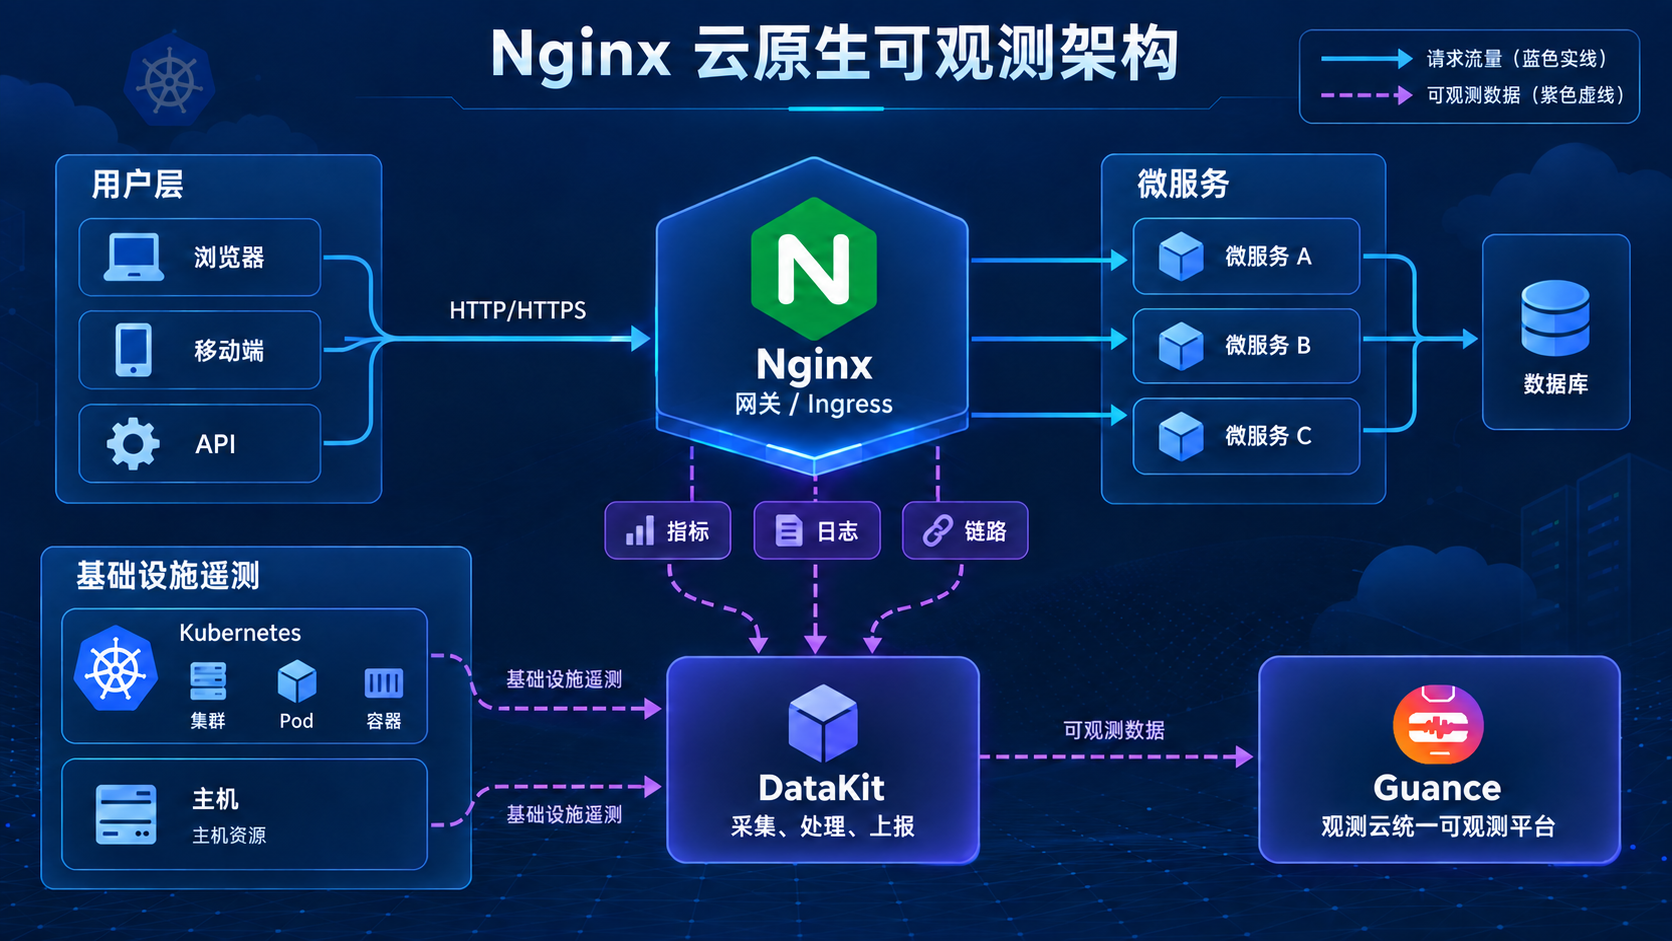
Nginx 指标和日志可以通过 DataKit 统一采集并上报观测云。接入步骤这里不再把官方文档抄一遍,直接按下面的文档操作即可:
在观测云中怎么分析
数据接进来只是第一步,真正有价值的是出了问题以后能不能快速找到原因。建议先建一张 Nginx 总览仪表板,把 QPS、错误率、P95/P99 延迟、活跃连接、慢接口、异常上游节点和容器资源放到一起看。
先看流量、连接和延迟
实际排查时,可以先从流量和连接开始。请求速率能看出流量有没有突然升高或掉下去,Active、Reading、Writing 和 Waiting 则能帮助判断连接是否堆积。响应流量适合发现大响应或突发下载,请求耗时最好同时看 P50、P95 和 P99,别让平均值把尾部慢请求藏起来。
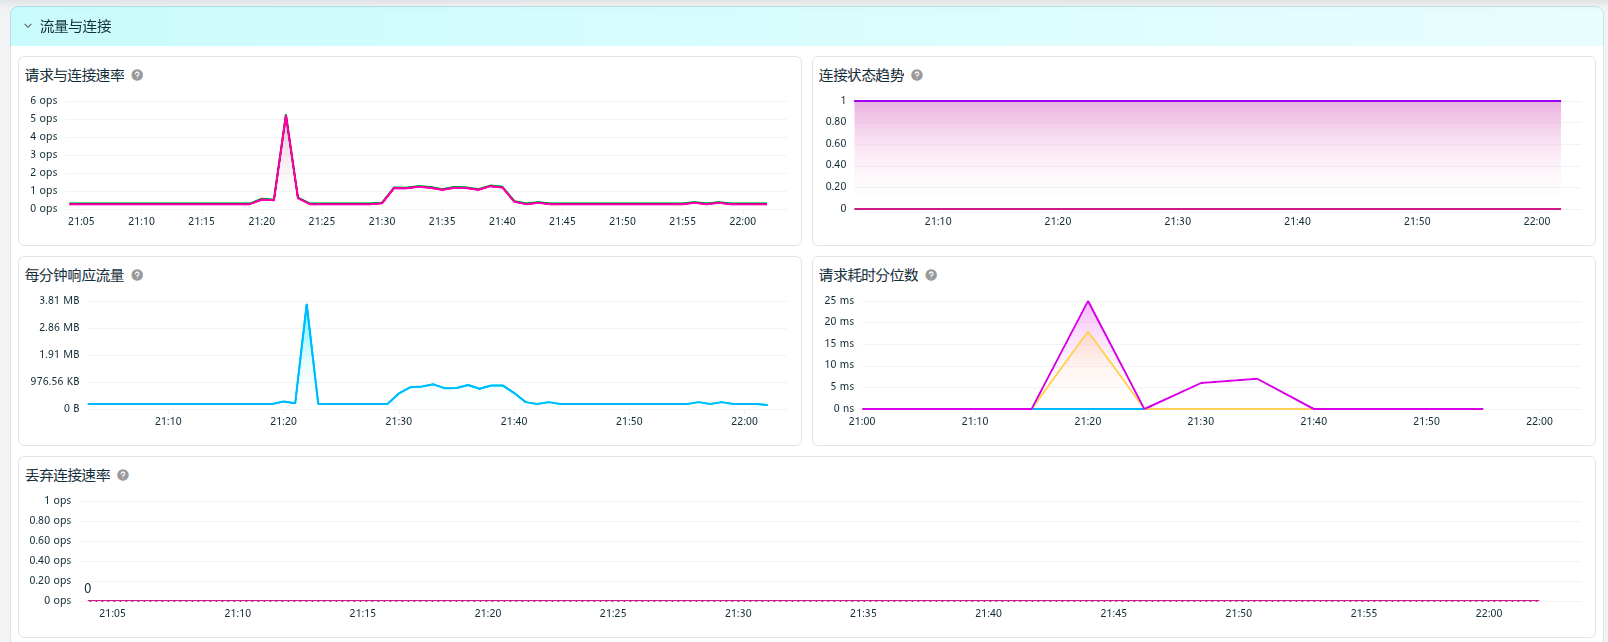
这里还有一个容易踩的坑:对于耗时非常短的请求,Nginx 的 request_time 可能记录为 0.000 秒。如果零值请求占比超过 95%,全量 P95 显示为 0 并不代表计算错了,而是正常的统计结果。遇到这种情况,可以继续看 P99,并把合成流量和真实业务流量分开分析,不要简单粗暴地删掉所有零值请求。
再看访问地域
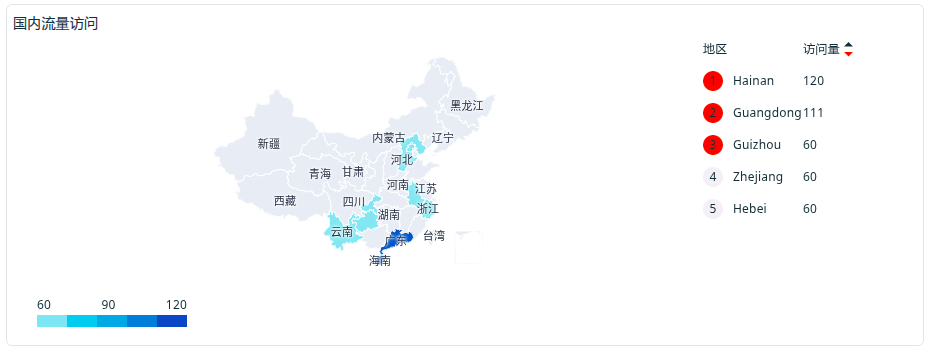
从可信客户端 IP 补全 country、province、city 和 isp 后,地图能让我们一眼看出流量主要来自哪里,异常请求是不是集中在某个国家、省份或运营商。全球地图负责展示国家级分布,Invalid IP address 作为未解析分组单独统计,不影响其他有效国家的结果,还能顺便反映地域数据治理的覆盖情况。
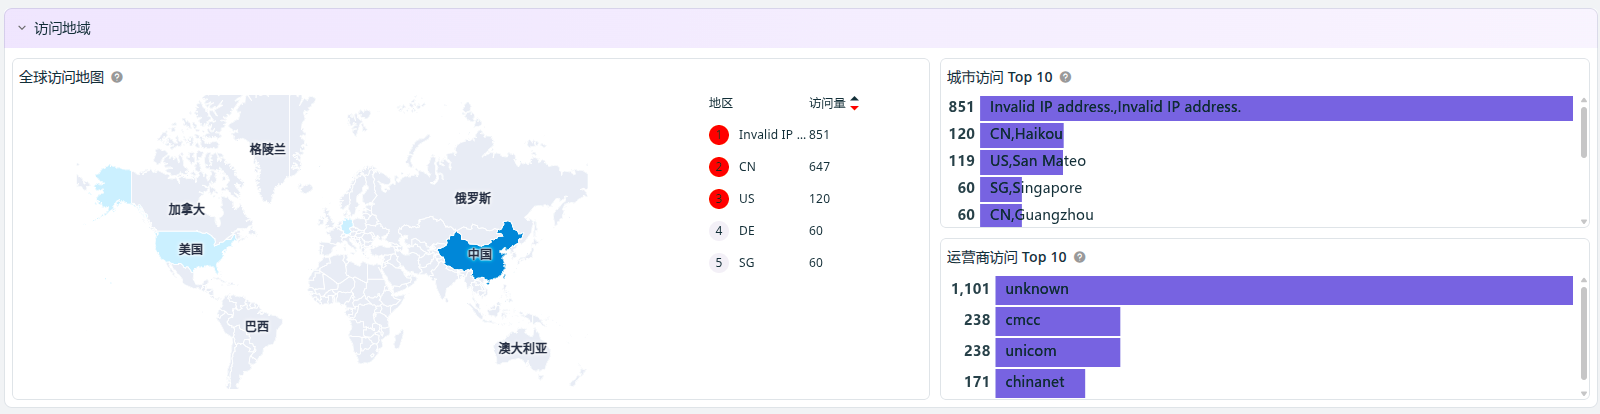
如果还想继续看国内分布,记得明确加上 country=CN 条件,否则 California 这类境外省州也可能混进中国地图。
最后下钻到结构化日志
图表把问题范围缩小以后,就该下钻到日志了。比如 5xx 突然升高,可以先按域名、接口、状态码和上游节点确认影响范围,再去看同一时间段的 Error Log。如果发现上游连接或响应异常,就沿着 request_id 或 trace_id 继续查看后端日志和调用链。
如果遇到请求变慢,就把 Nginx 请求总耗时和上游耗时放在一起对比。时间主要花在上游,就继续查应用和数据库;两者差距很大,则重点检查 Nginx、网络和客户端连接。
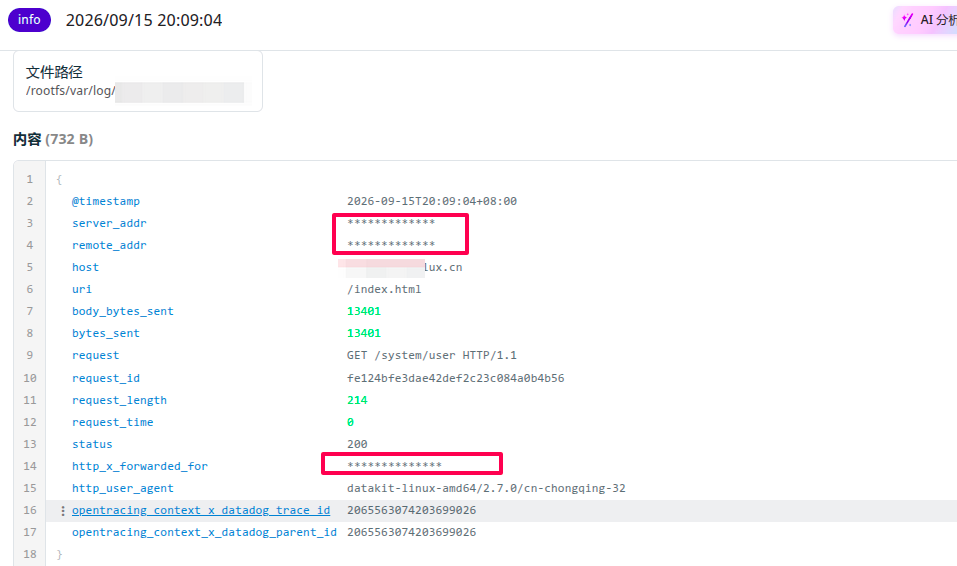
日志明细也不用一股脑展示所有字段,能支撑定位就够了。建议保留 HTTP 方法、状态码、实际请求地址、请求耗时、响应大小、客户端地域、request_id、trace_id 和 Pod。客户端 IP 等敏感信息应在展示或上报前完成脱敏,原始日志则留给授权后的进一步排查。
告警建议
告警不是越多越好,关键是值班人员收到以后知道该做什么。可以先盯住这些真正影响可用性的异常:
- 5xx 错误率持续超过基线;
- 502、504 数量异常增长;
- P95 响应时间超过业务目标;
- 活跃连接接近容量上限;
- Nginx 进程退出或频繁重启;
- CPU、内存或文件句柄持续高水位;
- Nginx 指标或日志停止上报。
阈值不要简单照搬网上的固定数值,最好结合历史基线和业务 SLO 来定。告警里也别只写一句"超过阈值",最好带上环境、服务、主机、异常接口和观测云分析链接,让值班人员点进去就能直接看到问题现场。
总结
说到底,做好 Nginx 可观测,不能只盯着进程活没活着,而是要把流量、错误、延迟、连接、上游服务和基础设施放在一起看。
通过 DataKit 将这些数据统一上报到观测云,再把指标、日志、链路和用户访问数据关联起来,就能串起一条从发现异常到定位根因的完整排障路径。最终目的不是为了多做几张漂亮的图,而是真出问题时,我们能更快知道问题在哪里、影响有多大,以及下一步该查什么。