准备工作 :
① 准备需要用到的文档, 并在项目上一级目录中创建 doc 文件夹, 将文档放入
② openai api key
目标 : 当用户询问知识库中的内容时, 会根据要求, 让 llm 决定是否需要调用检索工具; 检索到相关文档后进行评估; 如果内容相关直接生成答案, 如果内容不相关, 则重写问题后重新检索
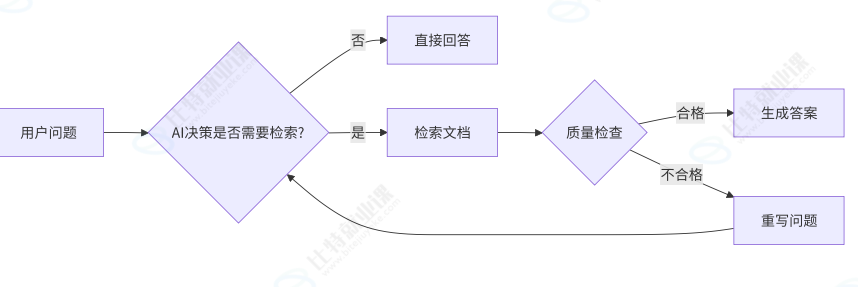
步骤 1 : 创建 检索工具和向量数据库(LangChain 内容)
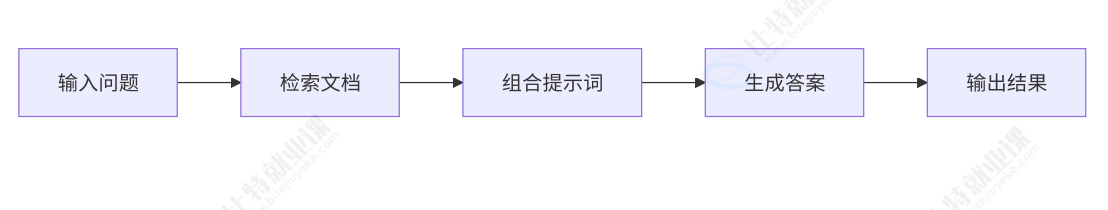
1. 初始化模型
model = init_chat_model("gpt-4o-mini")
embeddings = OpenAIEmbeddings(model="text-embedding-3-large")- 逻辑:准备两个模型。一个是用于对话和推理的聊天模型,另一个是用于将文本转化为数字向量(Embeddings)的模型。
- 方法解析:
-
init_chat_model(model_name): LangChain 的快捷方法:model_name: 指定模型名称(如gpt-4o-mini)。它会自动根据名称推断服务商(这里是 OpenAI)。OpenAIEmbeddings(model=...): 初始化嵌入模型 :model: 指定嵌入模型版本。text-embedding-3-large是 OpenAI 目前性能最强的文本向量化模型之一,适合处理复杂语义。
2. 加载文档
paths = ["../bit/企业介绍.md", ...]
docs = [UnstructuredMarkdownLoader(path).load() for path in paths]
docs_list = [item for sublist in docs for item in sublist]- 逻辑 :遍历文件路径列表,读取 Markdown 文件内容。
UnstructuredMarkdownLoader能智能解析 Markdown 的标题、列表等结构,比纯文本读取效果更好。最后将嵌套列表"拍平"为一个包含所有文档对象的单一列表。 - 方法解析:
-
UnstructuredMarkdownLoader(file_path):file_path: 文件的相对或绝对路径。.load(): 执行加载操作,返回一个Document对象列表(通常每个文件是一个 Document)。- 列表推导式 :
[item for sublist in docs for item in sublist]是 Python 的标准写法,用于将[[doc1], [doc2]]这种二维列表转换为[doc1, doc2]一维列表,方便后续统一处理。
3. 文本分割
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    encoding_name="cl100k_base",
    chunk_size=1000,
    chunk_overlap=50
)
doc_splits = text_splitter.split_documents(docs_list)- 逻辑 :大模型有上下文长度限制,且长文本检索精度低,因此需要切分。这里使用了递归字符分割器,它会尝试按段落、句子、单词的顺序进行切分,尽量保持语义完整。
- 方法解析:
-
.from_tiktoken_encoder(...): 这是一个类方法,专门用于适配 OpenAI 模型的 Tokenizer。
-
-
encoding_name="cl100k_base": 这是 GPT-4/GPT-3.5 系列使用的编码格式。关键点 :使用它能确保chunk_size计算的是 Token 数量而不是字符数,避免超出模型限制。chunk_size=1000: 每个切片的目标大小(约 1000 个 Token)。chunk_overlap=50: 切片之间的重叠部分(50 个 Token)。作用:防止关键信息被切断在两个切片的交界处,保持上下文连贯。
-
-
.split_documents(documents): 接收文档列表,返回切分后的新文档列表。
4. 向量化存储
vectorstore = InMemoryVectorStore.from_documents(
    documents=doc_splits,
    embedding=embeddings
)- 逻辑:将切分好的文本通过 Embedding 模型转化为向量,并存储在内存中。这相当于建立了一个临时的"本地知识库索引"。
- 方法解析:
-
InMemoryVectorStore: 基于内存的向量数据库,无需安装额外数据库软件,适合开发和测试。.from_documents(documents, embedding): 一站式完成"向量化 + 存储"。
-
-
documents: 上一步切分好的文档列表。embedding: 第 1 步初始化的OpenAIEmbeddings实例。
-
5. 创建检索工具
retriever = vectorstore.as_retriever(search_kwargs={"k": 2})
retriever_tool = create_retriever_tool(
    retriever,
    "retrieve_bit",
    "搜索并返回有关比特就业课的信息。"
)- 逻辑:将死板的数据库查询转化为 Agent 可以调用的"工具"。Agent 在对话时,如果检测到用户问题与描述匹配,就会自动触发这个工具去查库。
- 方法解析:
-
.as_retriever(search_kwargs={"k": 2}): 将向量库转换为检索器接口。
-
-
k=2: 每次检索返回最相关的 2 个文档片段。数值越小越精准,越大信息越全但可能引入噪音。
-
-
create_retriever_tool(retriever, name, description): LangChain 的工具封装器。
-
-
retriever: 上一步创建的检索器。name: 工具的内部调用名称(如retrieve_bit),Agent 代码中会用到。description: 非常重要。这是给 LLM 看的说明书。LLM 根据这句话判断何时使用该工具。如果描述不清,Agent 可能不知道该查库。
-
完整代码 :
from langchain.chat_models import init_chat_model
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_core.tools import create_retriever_tool
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_openai import OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 准备工作

# ①定义聊天模型与嵌入模型
model = init_chat_model("gpt-4o-mini")
embeddings = OpenAIEmbeddings(model = "text-embedding-3-large")

# ②加载文档列表
paths = [
    "../bit/企业介绍.md",
    "../bit/C++开发方向.md",
    "../bit/Java开发方向.md",
    "../bit/测试开发方向.md"
]

docs = [UnstructuredMarkdownLoader(path).load() for path in paths]
docs_list = [item for sublist in docs for item in sublist]

# ③文本分割器
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    encoding_name="cl100k_base",
    chunk_size = 1000,
    chunk_overlap = 50
)
doc_splits = text_splitter.split_documents(docs_list)

# ④使用内存中向量存储和OpenAI嵌入
vectorstore = InMemoryVectorStore.from_documents(
    documents=doc_splits,
    embedding=embeddings,
)

# ⑤使用langchainD 预构建 create_retriever_tool 创建检索工具
retriever = vectorstore.as_retriever(search_kwargs = {"k":2})
retriever_tool = create_retriever_tool(
    retriever,
    "retrieve_bit",
    "搜索并返回有关比特就业课的信息",
)
步骤 2 : LangGraph 部分结构
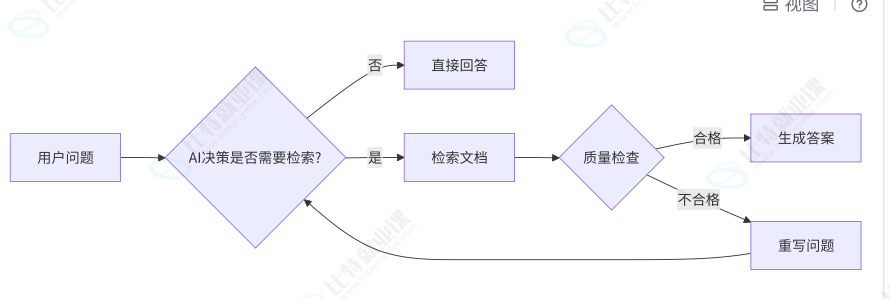
1. 状态定义 (State)
from langgraph.graph import MessagesState- 使用了 LangGraph 预置的
MessagesState。 - 核心特性 :这是一个包含
messages列表的状态对象,且内置了 Reducer 机制 。这意味着当节点返回{"messages": [new_msg]}时,新消息会自动 追加 到历史列表中,而不是覆盖。这对于多轮对话和工具调用至关重要
2. 节点设计 (Nodes)
整个图包含 4 个核心节点,各自承担独立职责:
|-----------------------------|-------------------------------|-------------------------------|---------------------------------------------------|
| 节点名称 | 函数 | 作用 | 关键技术点 |
| generate_query_or_respond | generate_query_or_respond() | 入口决策节点。判断用户问题是否需要检索,还是可以直接回答。 | model.bind_tools() 让 LLM 自主决定是否调用工具 |
| retrieve | ToolNode | 执行实际的向量检索操作。 | LangGraph 预构建的工具执行节点,自动解析 AIMessage 中的 tool_calls |
| rewrite_question | rewrite_question() | 当检索结果不相关时,重写用户问题以优化检索。 | 提取原始问题 → LLM 改写 → 输出新的 HumanMessage |
| generate_answer | generate_answer() | 基于检索到的上下文生成最终答案。 | 将 Question + Context 组装 Prompt,限制回答简洁性 |
3. 图结构与条件边 (Edges & Routing)
这是 LangGraph 的核心价值所在,定义了动态执行逻辑:
① 第一层路由:是否需要检索?
workflow.add_conditional_edges(
    "generate_query_or_respond",
    tools_condition,  # LangGraph 预置的条件函数
    {"tools": "retrieve", "__end__": END}
)- tools_condition:自动检查上一个节点输出的 AIMessage 中是否包含
tool_calls。
-
- 如果有 → 路由到
"retrieve"节点执行检索。 - 如果没有 → 说明 LLM 认为可以直接回答(如闲聊),直接走向
END。
- 如果有 → 路由到
② 第二层路由:检索结果是否相关?(核心纠错机制)
workflow.add_conditional_edges(
    "retrieve",
    grade_documents,  # 自定义评分路由函数
    ["generate_answer", "rewrite_question"]
)
这里实现了一个 Grader(评估器) 模式:
- 结构化输出 :使用
GradeDocumentsPydantic 模型 +with_structured_output()强制 LLM 返回"yes"或"no",避免自由文本解析的不稳定性。 - 消息过滤 :使用
filter_messages(state["messages"], include_types="human")精准提取最新的用户问题,避免被中间的 ToolMessage 干扰。 - 闭环反馈:
-
score == "yes"→ 文档相关 → 进入generate_answer生成回答 → 结束。score == "no"→ 文档不相关 → 进入rewrite_question重写问题 → 重新回到generate_query_or_respond→ 再次尝试检索。
4. 完整执行流程图
START
  ↓
generate_query_or_respond ←──────────────────────┐
  ↓                    ↓                          │
(无tool_calls)      (有tool_calls)                │
  ↓                    ↓                          │
 END              retrieve                        │
                     ↓                            │
               grade_documents                    │
                  ↙        ↘                      │
            (yes)          (no)                   │
               ↓              ↓                   │
        generate_answer   rewrite_question ────────┘
               ↓
             END
完整代码
from typing import Literal

from langchain.chat_models import init_chat_model
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_core.messages import HumanMessage, filter_messages
from langchain_core.tools import create_retriever_tool
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_openai import OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langgraph.constants import START, END
from langgraph.graph import MessagesState, StateGraph
from langgraph.prebuilt import ToolNode, tools_condition
from pydantic import BaseModel,Field

# 准备工作

# ①定义聊天模型与嵌入模型
model = init_chat_model("gpt-4o-mini")
embeddings = OpenAIEmbeddings(model = "text-embedding-3-large")

# ②加载文档列表
paths = [
    "../doc/markdown/企业介绍.md",
    "../doc/markdown/C++开发方向.md",
    "../doc/markdown/Java开发方向.md",
    "../doc/markdown/测试开发方向.md"
]

docs = [UnstructuredMarkdownLoader(path).load() for path in paths]
docs_list = [item for sublist in docs for item in sublist]

# ③文本分割器
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    encoding_name="cl100k_base",
    chunk_size = 1000,
    chunk_overlap = 50
)
doc_splits = text_splitter.split_documents(docs_list)

# ④使用内存中向量存储和OpenAI嵌入
vectorstore = InMemoryVectorStore.from_documents(
    documents=doc_splits,
    embedding=embeddings,
)

# ⑤使用langchainD 预构建 create_retriever_tool 创建检索工具
retriever = vectorstore.as_retriever(search_kwargs = {"k":2})

# ⑥创建检索器工具
retriever_tool = create_retriever_tool(
    retriever,
    "retrieve_bit",
    "搜索并返回有关比特就业课的信息",
)

# # 测试
# test_queries = [
#     "比特提供了哪些课程",
#     "Java开发方向的课程安排",
#     "测试开发方向的主线课程有哪些",
#     "C++开发方向的项目列表",
#     "Redis课程内容是什么"
# ]
#
# for query in test_queries:
#     print("-" * 50)
#     print(f"查询:{query}\n")
#     result = retriever_tool.invoke({"query": query})
#
#     # 只显示前100个字符,避免输出过长
#     content_preview = result[:100] + "..." if len(result) > 100 else result
#     print(f"结果预览:{content_preview}")
#     print(f"结果长度:{len(result)} 字符")

# -----------------RAG 检索系统代码(langgraph)---------------------------

# 1. 状态定义
# 对话式的系统, 要维护一个可追加的message
# 和案例 2 不同, 这次我们直接使用langchain提供好的状态


# 2. 创建节点
# ①llm节点
def generate_query_or_respond(state:MessagesState):
    """调用模型以基于当前状态生成响应
    给定问题, 它决定使用检索工具检索, 或者简单的生成用户响应"""

    result = model.bind_tools([retriever_tool]).invoke(state["messages"])
    # result 是一个AIMessage
    return {
        "messages":[result]
    }
# 测试节点
# generate_query_or_respond({
#         "messages":[
#             {
#                 "role":"user",
#                 "content":"你好"
#             }
#         ]
# })["messages"][-1].pretty_print()

# ②工具节点
retriever_node = ToolNode([retriever_tool])

# ③重写问题节点
REWRITE_PROMPT = (
    "查看输入并尝试推断潜在的语义意图/含义。\n"
    "这是最初的问题:"
    "\n ------- \n"
    "{question}"
    "\n------- \n"
    "提出一个改进后的问题:"
)

def rewrite_question(state:MessagesState):
    """重写原始用户问题"""
    # state message 包含[HumanMessage,AIMessage,ToolMessage]
    question = state["messages"][0]
    prompt = REWRITE_PROMPT.format(question = question)      # 实例化提示词
    result = model.invoke([HumanMessage(content=prompt)])
    # 将 AIMessage转换为HumanMessage并追加到历史消息messages中
    return {
        "messages":[HumanMessage(content=result.content)]
    }
# 测试节点
# input_state = {
#     "messages" : [
#         {
#             "role":"user",
#             "content":"比特提供了哪些课程"
#         },
#         {
#             "role":"assistant",
#             "content":"",
#             "tool_calls":[
#                 {
#                     "id":"1",
#                     "name":"retrieve_bit",
#                     "args":{
#                         "query":"比特课程"
#                     }
#                 }
#             ]
#         },
#         {
#             "role":"tool",
#             "content":"c++,java,测开",
#             "tool_call_id":"1"
#         }
#     ]
# }
# rewrite_question(state=input_state)["messages"][-1].pretty_print()

# ④答案生成节点
GENERATE_PROMPT = (
    "你是负责回答问题的助手。 "
    "使用以下检索到的上下文片段来回答问题。 "
    "如果你不知道答案,就说你不知道。 "
    "最多只用三句话,回答要简明扼要。\n"
    "Question: {question} \n"
    "Context: {context}"
)
def generate_answer(state:MessagesState):
    """"生成答案"""
    # state message 包含[HumanMessage,AIMessage,ToolMessage]

    # 问题+检索结果
    question = state["messages"][0].content
    context = state["messages"][-1].content
    prompt = GENERATE_PROMPT.format(question = question, context = context)    # 实例化提示词
    result = model.invoke([HumanMessage(content=prompt)])
    return {
        "messages":[result]
    }


# 3. 创建图,并添加节点和边
workflow = StateGraph(MessagesState)
workflow.add_node(generate_query_or_respond)
workflow.add_node("retrieve",retriever_node)
workflow.add_node(rewrite_question)
workflow.add_node(generate_answer)

workflow.add_edge(START,"generate_query_or_respond")
workflow.add_conditional_edges(
    "generate_query_or_respond",        # 起始节点
    tools_condition,                         # 使用langchain提供的方法, 和案例二中的(should_continue)类似, 作用 : 查找message中的AIMessage中是否包含tool_calls
    {                                 # 将方法中的路径映射为真实节点名称
        "tools":"retrieve",
        "__end__":END,
    }

)

GRADE_PROMPT = (
    "你是一个评分员,评估检索到的文档与用户问题的相关性。 \n "
    "以下是检索到的文档: \n\n {context} \n\n"
    "以下是用户的问题: {question} \n"
    "如果文档包含与用户问题相关的关键字或语义,则将其评为相关。 \n"
    "给出一个二元分数"yes"或"no",以表明该文档是否与问题相关。"
)
class GradeDocuments(BaseModel):
    score: str = Field(default=None,description = "相关性评分, 相关为 'yes', 不相关为'no")

# 路由函数
def grade_documents(state:MessagesState)-> Literal["generate_answer", "rewrite_question"]:             # Literal用来限制返回值
    """"确定检索到的文档是否与问题相关"""
    # 问题+检索文档交给LLM 来判断是否合格
    user_messages = filter_messages(state["messages"],include_types = "human")
    question = user_messages[-1].content
    tool_messages = state["messages"][-1]
    context = tool_messages.content
    prompt = GRADE_PROMPT.format(question = question, context = context)             # 实例化提示词
    result = model.with_structured_output(GradeDocuments).invoke(
        [HumanMessage(content=prompt)]
    )
    if result.score == "yes":
        return "generate_answer"
    else:
        return "rewrite_question"

workflow.add_conditional_edges(
    "retrieve",        # 起始节点
    grade_documents,         # 路由函数
    ["generate_answer", "rewrite_question"]     # 映射节点
)
workflow.add_edge("generate_answer",END)
workflow.add_edge("rewrite_question","generate_query_or_respond")

# 4. 编译图
graph = workflow.compile()

# 5. 执行图
# graph.invoke()
for chunk in graph.stream(
    {
        "messages":[HumanMessage(content="请问比特教育提供哪些类型的课程?")]
    }):
    # print(chunk)
    for node , update in chunk.items():
        print(f"节点{node}跟新消息")
        print()
        update["messages"][-1].pretty_print()
        print("-------------------------------------------------")