一、概述
1.1 为什么需要记忆(Memory)
记忆是一种记住之前互动信息的系统。随着Agent处理涉及大量用户交互的复杂任务,记忆变得至关重
要!
大多数的大模型应用程序都会有一个会话接口,允许我们进行多轮的对话,并有一定的上下文记忆能
力。比如:
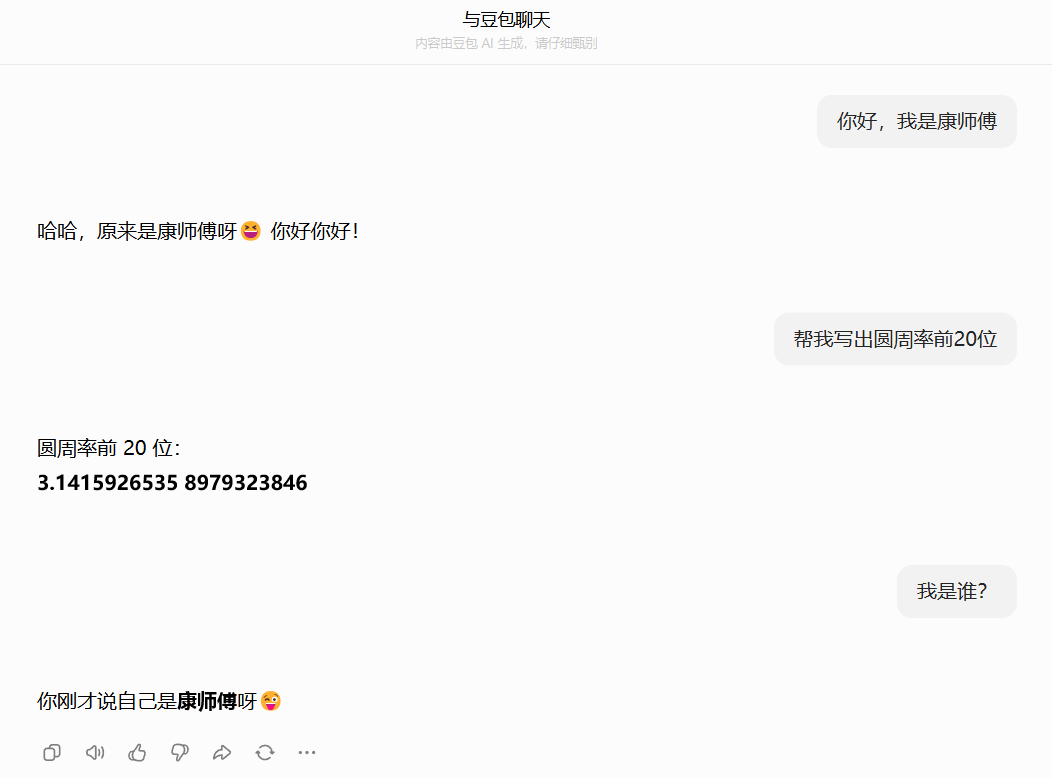
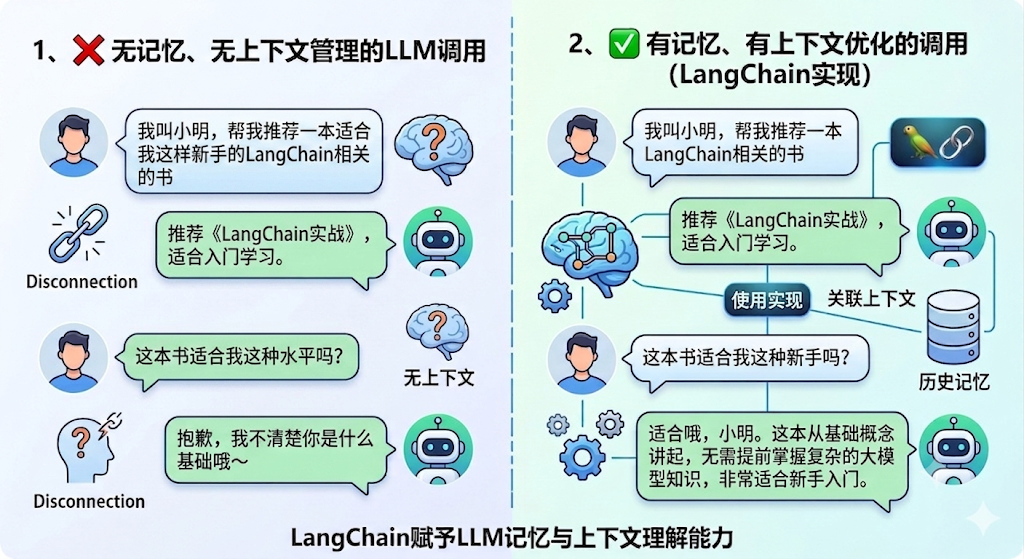
但实际上,大模型本身是"无状态"的,不会记忆任何上下文的。即每次调用 agent.invoke() 都是全新
的开始,不记得之前的对话。
举例:
text
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 从.env文件中加载环境变量
load_dotenv(override=True)

model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL")
)
情况1:
text
from langchain.agents import create_agent
from langchain_core.messages import HumanMessage, AIMessage

messages1 = [
    HumanMessage("你好,我叫小明"),
    AIMessage("很高兴认识你,小明"),
    HumanMessage("你用一句话介绍下你自己"),
]

agent = create_agent(
    model=model,
    tools=[],
)

response1 = agent.invoke({"messages" : messages1})

for msg in response1["messages"]:
    msg.pretty_print()
text
================================ Human Message =================================

你好,我叫小明
================================== Ai Message ==================================

很高兴认识你,小明
================================ Human Message =================================

你用一句话介绍下你自己
================================== Ai Message ==================================

我是一个可以帮助你回答问题、写作、翻译和思考的 AI 助手。
text
messages2 = [HumanMessage("我叫什么名字?")]

response2 = agent.invoke({"messages" : messages2})

for msg in response2["messages"]:
    msg.pretty_print()
text
================================ Human Message =================================

我叫什么名字?
================================== Ai Message ==================================

我不知道你的名字,除非你告诉我。
如果你愿意,可以直接告诉我,我就记住并称呼你。
情况2:
text
messages3 = [
    HumanMessage("你好,我叫小明"),
    AIMessage("很高兴认识你,小明"),
    HumanMessage("你用一句话介绍下你自己"),
    AIMessage("我是一个由 OpenAI 训练的人工智能助手,可以帮你回答问题、写作和解决各种任务。"),
    HumanMessage("我叫什么名字?")
]

response3 = agent.invoke({"messages" : messages3})

for msg in response3["messages"]:
    msg.pretty_print()
text
================================ Human Message =================================

你好,我叫小明
================================== Ai Message ==================================

很高兴认识你,小明
================================ Human Message =================================

你用一句话介绍下你自己
================================== Ai Message ==================================

我是一个由 OpenAI 训练的人工智能助手,可以帮你回答问题、写作和解决各种任务。
================================ Human Message =================================

我叫什么名字?
================================== Ai Message ==================================

你叫小明。
我们希望的智能体应该是右图的情况:
1.2 如何解决记忆问题
1.2.1 上下文工程
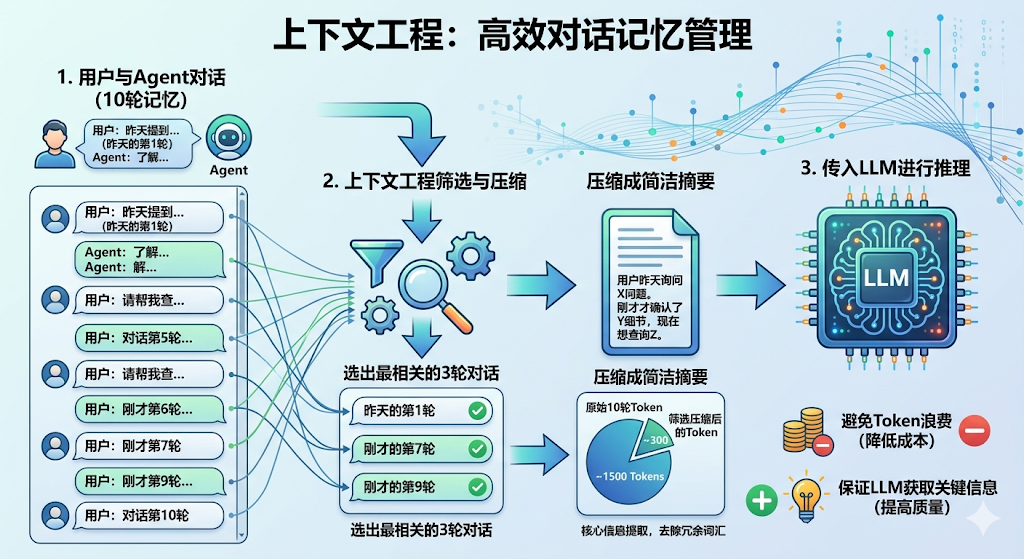
实现这个记忆功能,就需要额外的模块去保存我们和模型对话的上下文信息,然后在下一次请求时,
把历史信息都输入给模型,让模型输出结果。
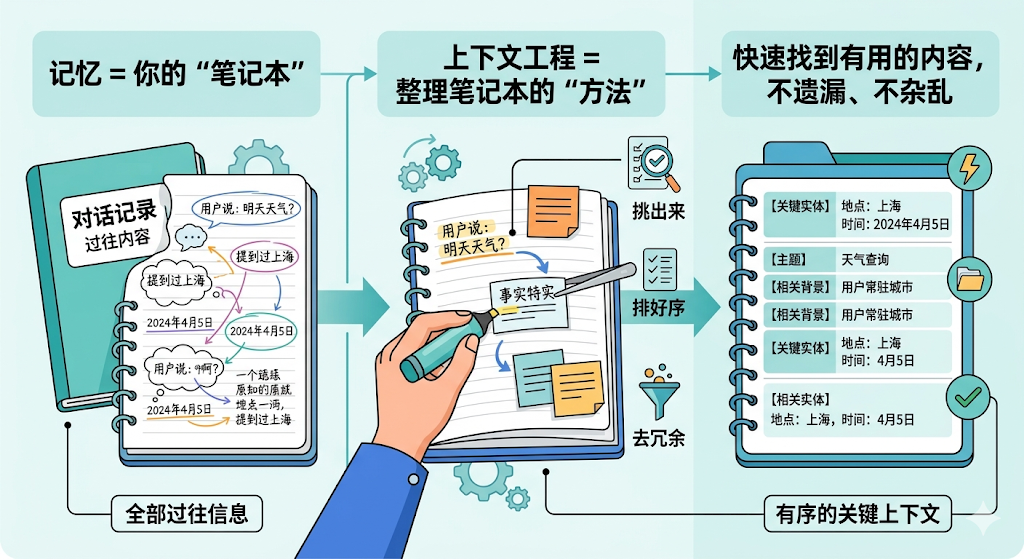
在 LangChain 中,记忆(Memory) 就是专门负责" 存储历史交互信息"的组件,核心作用是「保存上下
文」和「提供上下文」,让LLM在每次响应时,都能"看到"之前的对话内容。
上下文工程(Context Engineering) 负责"合理组织"这些记忆和任务信息,让LLM的响应更连贯、更贴合需求。这也是Agent能实现复杂多轮交互的核心基础。
类比:
举例:
1.2.2 上下文类型及相关的API
LangChain的上下文工程是基于Agent讨论的,而上下文工程是构建在LangGraph之上的。
LangGraph 提供了三种管理上下文的方法,这些方法结合了可变性和生命周期维度:
| 上下文类型 | 描述 | 可 变 性 | 生命 周期 | 访问方法 |
|---|---|---|---|---|
| 动态运行时 上下文 | 在单次运行中会演变的可变数据 | 动 态 | 单次 运行 | LangGraph state对象 |
| 动态跨会话 上下文 | 在对话间共享的持久数据。比如用户偏好、 历史洞察、知识条目 | 动 态 | 跨对 话 | LangGraph store对象 |
| 静态运行时 上下文 | 在启动时传入的用户元数据、工具、数据库 连接 | 静 态 | 单次 运行 | LangGraph context对象 |
1.3 LangChain的记忆
1.3.1 记忆的分类
官方说明:https://docs.langchain.com/oss/python/concepts/memory
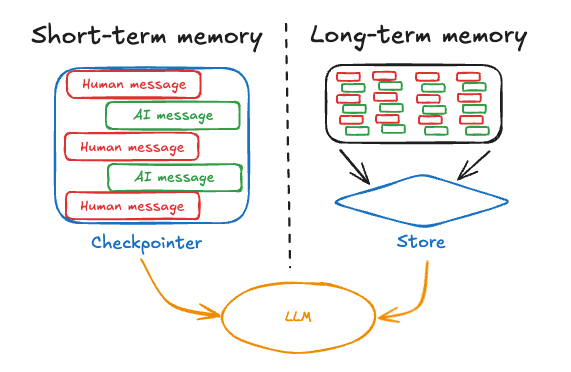
记忆分为短期记忆和长期记忆,对应不同的使用场景:
-
短期记忆(Short-term memory、会话级记忆、thread-scoped memory):作用范围是单个
对话线程(Thread)内,一旦开启新对话(更换 thread_id ),记忆即消失。
-
长期记忆(Long-term memory,跨会话级记忆 ):在会话间存储用户特定或应用级数据, 并
在会话线程间共享。它可以随时在任何线程中被调用。记忆的范围是任意自定义命名空间,而不
仅仅是单一线程 ID。
1.3.2 记忆的管理
在LangChain v0.x版本中,通过专用的xxxMemory类管理记忆。
在LangChain v1.x版本中,Agent是构建在LangGraph图结构之上的,通过上文提到的state和store构
建记忆系统。使用更简单、功能更统一。
-
state:短期记忆对象,以会话为单位组织,包含当前会话的所有消息记录以及自定义信息。
-
store:长期记忆对象,跨会话持久化的数据,通常需要结合向量数据库或外部存储实现。
二、短期记忆
LangChain1.x 的短期记忆是三者的组合:
State(会话内部状态) + Checkpointer(持久化机制) + Thread ID(会话作用域)
-
State :默认存储历史消息列表messages ,通过State 管理历史消息
-
Checkpointer :负责将State 作为检查点持久化保存,检查点是某个时刻的State 快照
-
Thread ID :用于唯一标识State ,LangChain运行时会按照 thread_id 读写State快照
这就像玩 RPG 游戏时的"自动存档":你不需要手动保存,系统在关键节点自动记录,下次进入游
戏随时可以从上次的存档点继续。
2.1 基于内存的持久化器
这是最便捷的使用方式,适合快速测试或调试。
2.1.1 举例1:没有记忆
text
from langchain.agents import create_agent
from langchain.messages import HumanMessage

agent = create_agent(
    model=model,
    tools=[]
)

print("\n第一轮对话:")
response1 = agent.invoke({
    "messages": [HumanMessage("我叫张三")]
})
print(f"Agent: {response1['messages'][-1].content}")

print("\n第二轮对话:")
response2 = agent.invoke({
    "messages": [HumanMessage("我叫什么?")]
})
print(f"Agent: {response2['messages'][-1].content}")
text
第一轮对话:
Agent: 你好,张三!很高兴认识你。有什么我可以帮你的吗?

第二轮对话:
Agent: 我不知道你的名字,除非你告诉我。
如果你愿意,可以直接发给我,我就能记住在这次对话里称呼你。
2.1.2 举例2:拥有记忆
步骤1:第一二轮对话
text
from langgraph.checkpoint.memory import InMemorySaver

checkpointer = InMemorySaver()

# 1. 创建 Agent 时添加 checkpointer
agent = create_agent(
    model=model,
    checkpointer=checkpointer  # 添加内存管理
)

# 2. 调用时指定 thread_id
config = {
    "configurable": {
        "thread_id": "1"
    }
}

print("\n第一轮对话:")
response1 = agent.invoke({
    "messages": [HumanMessage("我叫张三")]},
    config=config  # 传入 config
)
print(f"Agent: {response1['messages'][-1].content}")

print("\n第二轮对话:")
response2 = agent.invoke({
    "messages": [HumanMessage("我叫什么?")]},
    config=config  # 使用相同的 thread_id
)
print(f"Agent: {response2['messages'][-1].content}")
text
第一轮对话:
Agent: 你好,张三!很高兴认识你。有什么我可以帮你的吗?

第二轮对话:
Agent: 你叫张三。
说明:你只需传入 checkpointer 和 config,Agent 就能自然具备连续对话能力。
text
from rich import print as rprint

latest_state = agent.get_state(config)
rprint(latest_state)
text
StateSnapshot(
 values={
     'messages': [
         HumanMessage(
             content='我叫张三',
             additional_kwargs={},
             response_metadata={},
             id='16672c9b-4fac-44ca-830d-12908bad2c59'
         ),
         AIMessage(
             content='你好,张三!很高兴认识你。有什么我可以帮你的吗?',
             additional_kwargs={'refusal': None},
             response_metadata={
                 'token_usage': {
                     'completion_tokens': 22,
                     'prompt_tokens': 10,
                     'total_tokens': 32,
                     'completion_tokens_details': {
                         'accepted_prediction_tokens': 0,
                         'audio_tokens': 0,
                         'reasoning_tokens': 0,
                         'rejected_prediction_tokens': 0
                     },
                     'prompt_tokens_details': {'audio_tokens': 0, 'cached_tokens': 0},
                     'latency_checkpoint': {
                         'engine_tbt_ms': 5,
                         'engine_ttft_ms': 52,
                         'engine_ttlt_ms': 155,
                         'pre_inference_ms': 80,
                         'service_tbt_ms': 5,
                         'service_ttft_ms': 696,
                         'service_ttlt_ms': 792,
                         'total_duration_ms': 721,
                         'user_visible_ttft_ms': 616
                     }
                 },
                 'model_provider': 'openai',
                 'model_name': 'gpt-5.4-mini-2026-03-17',
                 'system_fingerprint': None,
                 'id': 'chatcmpl-DpDsXsSSbHRvHJlJ42b19uMDGKRGQ',
                 'service_tier': 'default',
                 'finish_reason': 'stop',
                 'logprobs': None
             },
             id='lc_run--019eb1db-f785-79a1-b52a-d3b718e5b1da-0',
             tool_calls=[],
             invalid_tool_calls=[],
             usage_metadata={
                 'input_tokens': 10,
                 'output_tokens': 22,
                 'total_tokens': 32,
                 'input_token_details': {'audio': 0, 'cache_read': 0},
                 'output_token_details': {'audio': 0, 'reasoning': 0}
             }
         ),
         HumanMessage(
             content='我叫什么?',
             additional_kwargs={},
             response_metadata={},
             id='ea385d96-ba1e-4b40-9b53-9e2848f751f0'
         ),
         AIMessage(
             content='你叫张三。',
             additional_kwargs={'refusal': None},
             response_metadata={
                 'token_usage': {
                     'completion_tokens': 9,
                     'prompt_tokens': 41,
                     'total_tokens': 50,
                     'completion_tokens_details': {
                         'accepted_prediction_tokens': 0,
                         'audio_tokens': 0,
                         'reasoning_tokens': 0,
                         'rejected_prediction_tokens': 0
                     },
                     'prompt_tokens_details': {'audio_tokens': 0, 'cached_tokens': 0},
                     'latency_checkpoint': {
                         'engine_tbt_ms': 3,
                         'engine_ttft_ms': 38,
                         'engine_ttlt_ms': 64,
                         'pre_inference_ms': 96,
                         'service_tbt_ms': 4,
                         'service_ttft_ms': 295,
                         'service_ttlt_ms': 310,
                         'total_duration_ms': 227,
                         'user_visible_ttft_ms': 199
                     }
                 },
                 'model_provider': 'openai',
                 'model_name': 'gpt-5.4-mini-2026-03-17',
                 'system_fingerprint': None,
                 'id': 'chatcmpl-DpDsYCdO16maB6yakkiFJknskxd0C',
                 'service_tier': 'default',
                 'finish_reason': 'stop',
                 'logprobs': None
             },
             id='lc_run--019eb1dc-0139-7cc3-bd9a-1d608b2fd48f-0',
             tool_calls=[],
             invalid_tool_calls=[],
             usage_metadata={
                 'input_tokens': 41,
                 'output_tokens': 9,
                 'total_tokens': 50,
                 'input_token_details': {'audio': 0, 'cache_read': 0},
                 'output_token_details': {'audio': 0, 'reasoning': 0}
             }
         )
     ]
 },
 next=(),
 config={
     'configurable': {
         'thread_id': '1',
         'checkpoint_ns': '',
         'checkpoint_id': '1f164d5b-625c-679d-8004-1ef8a3347091'
     }
 },
 metadata={'source': 'loop', 'step': 4, 'parents': {}},
 created_at='2026-06-10T14:07:27.193684+00:00',
 parent_config={
     'configurable': {
         'thread_id': '1',
         'checkpoint_ns': '',
         'checkpoint_id': '1f164d5b-570f-6b8f-8003-88f1894a5042'
     }
 },
 tasks=(),
 interrupts=()
)
步骤2:第三轮对话
当我们再次进行对话时,直接带入线程ID,即可带入此前对话记忆:
text
print("\n第三轮对话:")
response3 = agent.invoke({
    "messages": [HumanMessage("我刚才问了什么问题?")]},
    config=config  # 使用相同的 thread_id
)
print(f"Agent: {response3['messages'][-1].content}")
text
第三轮对话:
Agent: 你刚才问的是:"我叫什么?"
text
from rich import print as rprint

latest_state = agent.get_state(config)
rprint(latest_state)
输出:略
说明:第三轮对话中的 "我刚才问了什么问题?" 就能在第二轮存储的消息历史中找到答案。所有消息
历史都会自动追加到 AgentState 的 messages 字段中,无需手动维护。
步骤3:更新线程ID
而如果更新线程ID,则会重新开启对话:
text
config2 = {
    "configurable": {
        "thread_id": "2"
    }
}

response4 = agent.invoke(
    {"messages": [HumanMessage("你还记得我叫什么名字么?")]},
    config=config2
)

print(response4['messages'][-1].content)
text
我目前**不知道你的名字**,因为你还没有告诉我。
如果你愿意,可以直接发我你的名字,我就用这个称呼你。
说明:thread_id 隔离不同会话空间。
2.1.3 关键步骤说明
第1步:初始化记忆引擎:checkpointer = InMemorySaver() ------创建一个内存级的记忆存储。
注意:InMemorySaver内存中保存,进程结束就丢失数据,适合测试。生产环境可换成数据库持
久化的 SqliteSaver 、PostgresSaver 等
第2步:绑定 Agent:在 create_agent 时传入 checkpointer ,让 Agent 具备状态存储能力。
第3步:设定会话 ID:通过 config = {"configurable": {"thread_id": "1"}} 为每次调用指定线程标识。
同一个 thread_id 共享记忆,不同 thread_id 完全隔离。
text
# 会话 1
config1 = {"configurable": {"thread_id": "1"}}
agent.invoke({...}, config=config1)

# 会话 2
config2 = {"configurable": {"thread_id": "2"}}
agent.invoke({...}, config=config2)

# 两个会话完全独立
thread_id 是记忆管理的核心开关:在会话2里询问会话1的会话信息,Agent 会表示不知道------因为双
方记忆空间完全隔离。
生产环境中:
场景1:多用户聊天
不同 thread_id = 不同会话,Agent 能正确记住每个会话的内容。
text
agent = create_agent(
    model=model,
    tools=[],
    checkpointer=InMemorySaver()
)

# 用户 Alice
config_alice = {"configurable": {"thread_id": "user_alice"}}
agent.invoke({"messages": [...]}, config_alice)
...


# 用户 Bob
config_bob = {"configurable": {"thread_id": "user_bob"}}
agent.invoke({"messages": [...]}, config_bob)
...

# 两个会话完全独立
场景2:同一用户的不同任务
text
# 任务 1:写代码
config_task1 = {"configurable": {"thread_id": "task_coding"}}
agent.invoke({"messages": [...]}, config_task1)
...


# 任务 2:写文档
config_task2 = {"configurable": {"thread_id": "task_docs"}}
agent.invoke({"messages": [...]}, config_task2)
...
2.1.4 工作原理
内存保存了什么?
text
agent.invoke({"messages": [{"role": "user", "content": "你好"}]}, config)
# InMemorySaver 保存:
# {
#     "thread_id": "xxx",
#     "messages": [
#         HumanMessage("你好"),
#         AIMessage("你好!有什么可以帮助你的吗?")
#     ]
# }

agent.invoke({"messages": [{"role": "user", "content": "天气"}]}, config)
# InMemorySaver 更新:
# {
#     "thread_id": "xxx",
#     "messages": [
#         HumanMessage("你好"),
#         AIMessage("你好!有什么可以帮助你的吗?"),
#         HumanMessage("天气"),
#         AIMessage("...")
#     ]
# }
自动追加历史
text
# 你只需要传新消息
agent.invoke(
    {"messages": [{"role": "user", "content": "新问题"}]},
    config
)
此时,checkpointer 自动:
① 读取之前的历史
② 追加新消息
③ 调用模型(传入完整历史)
④ 保存新的历史
说明:checkpointer 会自动管理历史
2.1.5 常见问题
1、为什么 Agent 不记得?
检查:
-
✅ 是否添加了 checkpointer=InMemorySaver() ?
-
✅ 是否传入了 config 参数?
-
✅ 两次调用的 thread_id 是否相同?
text
# ❌ 错误:没有 checkpointer
agent = create_agent(model=model, tools=[])
agent.invoke({...})  # 不会记住


# ❌ 错误:没有 config
agent = create_agent(model=model, tools=[], checkpointer=InMemorySaver())
agent.invoke({...})  # 不会记住


# ❌ 错误:thread_id 不同
agent.invoke({...}, config={"configurable": {"thread_id": "1"}})
agent.invoke({...}, config={"configurable": {"thread_id": "2"}})  # 不同会话


# ✅ 正确
agent = create_agent(model=model, tools=[], checkpointer=InMemorySaver())
config = {"configurable": {"thread_id": "1"}}
agent.invoke({...}, config)
agent.invoke({...}, config)  # 记得!
2、InMemorySaver 会丢失数据吗?
会! InMemorySaver 只保存在内存中:
-
✅ 同一进程内有效(不支持跨进程共享)
-
❌ 程序重启后丢失(或进程重启后丢失)
-
❌ 不同进程无法共享
解决方案:持久化(SQLite、PostgreSQL)
3、内存会无限增长吗?
会! 默认情况下,InMemorySaver 会保存所有消息。
问题:
-
消息越来越多(无限增长,需要管理上下文)
-
token消耗增加,甚至会超过模型的 token 限制
-
响应速度变慢、成本增加
解决方案:上下文管理(修剪、摘要)
4、如何清空某个会话的历史?
目前 InMemorySaver 没有提供删除 API。
临时方案:
-
使用新的 thread_id
-
或重新创建 Agent
2.2 基于外部存储介质的持久化器
如果将状态检查点(checkpointer) 保存在内存,进程结束则状态丢失,生产环境不可接受。因此,生
产环境要用持久化的外部存储介质,如PostgreSQL。LangGraph提供的checkpointer后端列表如下
https://docs.langchain.com/oss/python/langgraph/persistence#checkpointer-libraries
此处选择PostgreSQL作为持久化器。
2.2.1 数据库环境准备
在此之前,先准备好PostgreSQL环境,此处在云服务器的Ubuntu系统安装PostgreSQL。大家需要根据
自己云服务器位置,更改URL中的IP即可。
具体云服务器安装和PostgreSQL的安装,见文件02-资料下的《Linux云服务器安装与PostgreSQL安
装》
text
URL:postgresql://langchain_user:abcd1234@118.195.128.47:5432/langchain_db?sslmode=disable说明:
1、上述URL中的用户名、密码、IP地址,需要根据自己的情况替换。
2、要在LangChain中对接PostgreSQL,还需要额外的依赖,比如:
text
pip install langgraph-checkpoint-postgres其实我们在课程开始的requirements.txt中已经提供了相关依赖,此处不必也不能重新安装,否则版本
可能冲突。
2.2.2 代码实现
text
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 从.env文件中加载环境变量
load_dotenv(override=True)

model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL")
)
text
from langchain.agents import create_agent
from langchain.messages import HumanMessage
from langgraph.checkpoint.postgres import PostgresSaver


DB_URL = "postgresql://langchain_user:abcd1234@118.195.128.47:5432/langchain_db?sslmode=disable"
with PostgresSaver.from_conn_string(DB_URL) as checkpointer:
    # 初始化PostgreSQL数据库
    checkpointer.setup()

    agent = create_agent(
        model=model,
        checkpointer=checkpointer
    )

    config = {"configurable": {"thread_id": "1"}}
    response1 = agent.invoke(
        {"messages": [HumanMessage("你好,我是老王")]},
        config=config
    )
    print("=" * 30, "-> 第一次调用 <-", "=" * 30)
    for msg in response1["messages"]:
        msg.pretty_print()

    response2 = agent.invoke(
        {"messages": [HumanMessage("你好,我是谁?")]},
        config=config
    )

    print("=" * 30, "-> 第二次调用 <-", "=" * 30)
    for msg in response2["messages"]:
        msg.pretty_print()
输出
text
============================== -> 第一次调用 <- ==============================
================================ Human Message =================================

你好,我是老王
================================== Ai Message ==================================

你好,老王!很高兴认识你。有什么我可以帮你的?
============================== -> 第二次调用 <- ==============================
================================ Human Message =================================

你好,我是老王
================================== Ai Message ==================================

你好,老王!很高兴认识你。有什么我可以帮你的?
================================ Human Message =================================

你好,我是谁?
================================== Ai Message ==================================

你是老王。
setup() 用于初始化PostgreSQL数据库,首次运行会创建必要的表,重复执行不会重新建表,底层逻辑
是Create IF Not Exists ,相关源码如下
text
def setup(self) -> None:
    """Set up the checkpoint database asynchronously.

    This method creates the necessary tables in the Postgres database if they don't already exist and runs database migrations. It MUST be called directly by the user the first time checkpointer is used.
    """
    ...
2.2.3 查看持久化数据
查看PostgreSQL数据库,可以通过命令行或图形化工具查看
text
ubuntu@VM-0-6-ubuntu:~$ psql "postgresql://langchain_user:abcd1234@localhost:5432/langchain_db?sslmode=disable"
text
psql (16.13 (Ubuntu 16.13-0ubuntu0.24.04.1))
Type "help" for help.

langgraph_db=>
PostgreSQL的存储结构是Database -> Schema -> Table
-
Database :数据库
-
Schema :分区
-
Table :表
需求1:查看所有数据库
text
langgraph_db=> \l
                                                              List of databases
     Name     |     Owner      | Encoding | Locale Provider | Collate |  Ctype  | ICU Locale | ICU Rules |         Access privileges
--------------+----------------+----------+-----------------+---------+---------+------------+-----------+-----------------------------------
 langgraph_db | langgraph_user | UTF8     | libc            | C.UTF-8 | C.UTF-8 |            |           | =Tc/langgraph_user               +
              |                |          |                 |         |         |            |           | langgraph_user=CTc/langgraph_user
 postgres     | postgres       | UTF8     | libc            | C.UTF-8 | C.UTF-8 |            |           |
 template0    | postgres       | UTF8     | libc            | C.UTF-8 | C.UTF-8 |            |           | =c/postgres                      +
              |                |          |                 |         |         |            |           | postgres=CTc/postgres
 template1    | postgres       | UTF8     | libc            | C.UTF-8 | C.UTF-8 |            |           | =c/postgres                      +
              |                |          |                 |         |         |            |           | postgres=CTc/postgres
(4 rows)
命令行前缀langgraph_db 标识了当前所在数据库
需求2:查看所有schema
text
langgraph_db=> \dn
      List of schemas
  Name  |       Owner
--------+-------------------
 public | pg_database_owner
(1 row)
需求3:查看当前所处的schema
text
langgraph_db=> select current_schema();
 current_schema
----------------
 public
(1 row)
需求4:查看当前schema下的所有表
text
langgraph_db=> \dt
                    List of relations
 Schema |         Name          | Type  |     Owner
--------+-----------------------+-------+----------------
 public | checkpoint_blobs      | table | langgraph_user
 public | checkpoint_migrations | table | langgraph_user
 public | checkpoint_writes     | table | langgraph_user
 public | checkpoints           | table | langgraph_user
(4 rows)
这四张表都是setup() 函数初始化时创建的。
-
checkpoints :这是主表,存每个 thread 在某个时刻的 checkpoint 快照。
-
checkpoint_blobs :这张表专门存不适合直接内联进 checkpoints.checkpoint 的较复杂
channel 值。
-
checkpoint_writes :这张表存的是中间写入 / pending writes,不是最终完整 checkpoint。
-
checkpoint_migrations :这张表不是业务数据表,而是迁移版本表。
2.3 对比两种方式
举例1:基于内存存储
text
from langchain.agents import create_agent
from langchain.messages import HumanMessage
from langgraph.checkpoint.memory import InMemorySaver

agent = create_agent(
    model=model,
    checkpointer=InMemorySaver()
)
config = {"configurable": {"thread_id": "1"}}


print("=" * 30, "-> 第一次调用 <-", "=" * 30)
response1 = agent.invoke(
    {"messages": [HumanMessage("你好,我是谁?")]},
    config=config
)
for msg in response1["messages"]:
    msg.pretty_print()


print("=" * 30, "-> 第二次调用 <-", "=" * 30)
response2 = agent.invoke(
    {"messages": [HumanMessage("我是老王")]},
    config=config
)
for msg in response2["messages"]:
    msg.pretty_print()


print("=" * 30, "-> 第三次调用 <-", "=" * 30)
response3 = agent.invoke(
    {"messages": [HumanMessage("你好,我是谁?")]},
    config
)
for msg in response3["messages"]:
    msg.pretty_print()
输出如下
text
============================== -> 第一次调用 <- ==============================
================================ Human Message =================================

你好,我是谁?
================================== Ai Message ==================================

你好!我不知道你的真实身份,除非你告诉我。
如果你愿意,我可以根据你提供的信息,帮你判断你是谁、你像哪类人,或者帮你整理一段自我介绍。
============================== -> 第二次调用 <- ==============================
================================ Human Message =================================

你好,我是谁?
================================== Ai Message ==================================

你好!我不知道你的真实身份,除非你告诉我。
如果你愿意,我可以根据你提供的信息,帮你判断你是谁、你像哪类人,或者帮你整理一段自我介绍。
================================ Human Message =================================

我是老王
================================== Ai Message ==================================

你好,老王!很高兴认识你。
如果你愿意,我可以直接这样称呼你。
============================== -> 第三次调用 <- ==============================
================================ Human Message =================================

你好,我是谁?
================================== Ai Message ==================================

你好!我不知道你的真实身份,除非你告诉我。
如果你愿意,我可以根据你提供的信息,帮你判断你是谁、你像哪类人,或者帮你整理一段自我介绍。
================================ Human Message =================================

我是老王
================================== Ai Message ==================================

你好,老王!很高兴认识你。
如果你愿意,我可以直接这样称呼你。
================================ Human Message =================================

你好,我是谁?
================================== Ai Message ==================================

你好,老王。你是老王。
可以发现,每次执行的输出完全相同,而我们并没有更改thread_id ,之所以看不到上次运行的状态是
因为每次运行创建新的Saver(),历史State被丢弃了。
举例2:基于外部存储器存储
text
from langchain.agents import create_agent
from langchain.messages import HumanMessage
from langgraph.checkpoint.postgres import PostgresSaver

DB_URL = "postgresql://langchain_user:abcd1234@118.195.128.47:5432/langchain_db?sslmode=disable"
with PostgresSaver.from_conn_string(DB_URL) as checkpointer:
    # 初始化数据库
    checkpointer.setup()

    agent = create_agent(
        model=model,
        checkpointer=checkpointer
    )

    config = {"configurable": {"thread_id": "3"}}

    print("=" * 30, "-> 第一次调用 <-", "=" * 30)
    response1 = agent.invoke(
        {"messages": [HumanMessage("你好,我是谁啊?")]},
        config
    )
    for msg in response1["messages"]:
        msg.pretty_print()


    print("=" * 30, "-> 第二次调用 <-", "=" * 30)
    response2 = agent.invoke(
        {"messages": [HumanMessage("我是老王~")]},
        config
    )
    for msg in response2["messages"]:
        msg.pretty_print()


    print("=" * 30, "-> 第三次调用 <-", "=" * 30)
    response3 = agent.invoke(
        {"messages": [HumanMessage("你好,我是谁??")]},
        config
    )
    for msg in response3["messages"]:
        msg.pretty_print()
第一次输出:
text
============================== -> 第一次调用 <- ==============================
================================ Human Message =================================

你好,我是谁啊?
================================== Ai Message ==================================

你好!我只能知道:你现在是这次和我对话的用户。
如果你是想问"我记不记得你是谁",那我其实**不会自动知道你的真实身份**,除非你在对话里告诉我。

你可以直接告诉我你想让我怎么称呼你。
============================== -> 第二次调用 <- ==============================
================================ Human Message =================================

你好,我是谁啊?
================================== Ai Message ==================================

你好!我只能知道:你现在是这次和我对话的用户。
如果你是想问"我记不记得你是谁",那我其实**不会自动知道你的真实身份**,除非你在对话里告诉我。

你可以直接告诉我你想让我怎么称呼你。
================================ Human Message =================================

我是老王~
================================== Ai Message ==================================

你好,老王~ 很高兴认识你!
接下来我可以怎么帮你?
============================== -> 第三次调用 <- ==============================
================================ Human Message =================================

你好,我是谁啊?
================================== Ai Message ==================================

你好!我只能知道:你现在是这次和我对话的用户。
如果你是想问"我记不记得你是谁",那我其实**不会自动知道你的真实身份**,除非你在对话里告诉我。

你可以直接告诉我你想让我怎么称呼你。
================================ Human Message =================================

我是老王~
================================== Ai Message ==================================

你好,老王~ 很高兴认识你!
接下来我可以怎么帮你?
================================ Human Message =================================

你好,我是谁??
================================== Ai Message ==================================

你好,老王 🙂
第二次运行输出
text
============================== -> 第一次调用 <- ==============================
================================ Human Message =================================

你好,我是谁啊?
================================== Ai Message ==================================

你好!我只能知道:你现在是这次和我对话的用户。
如果你是想问"我记不记得你是谁",那我其实**不会自动知道你的真实身份**,除非你在对话里告诉我。

你可以直接告诉我你想让我怎么称呼你。
================================ Human Message =================================

我是老王~
================================== Ai Message ==================================

你好,老王~ 很高兴认识你!
接下来我可以怎么帮你?
================================ Human Message =================================

你好,我是谁??
================================== Ai Message ==================================

你好,老王 🙂
================================ Human Message =================================

你好,我是谁啊?
================================== Ai Message ==================================

你好,老王。
============================== -> 第二次调用 <- ==============================
================================ Human Message =================================

你好,我是谁啊?
================================== Ai Message ==================================

你好!我只能知道:你现在是这次和我对话的用户。
如果你是想问"我记不记得你是谁",那我其实**不会自动知道你的真实身份**,除非你在对话里告诉我。

你可以直接告诉我你想让我怎么称呼你。
================================ Human Message =================================

我是老王~
================================== Ai Message ==================================

你好,老王~ 很高兴认识你!
接下来我可以怎么帮你?
================================ Human Message =================================

你好,我是谁??
================================== Ai Message ==================================

你好,老王 🙂
================================ Human Message =================================

你好,我是谁啊?
================================== Ai Message ==================================

你好,老王。
================================ Human Message =================================

我是老王~
================================== Ai Message ==================================

你好,老王~ 有什么我可以帮你的?
============================== -> 第三次调用 <- ==============================
================================ Human Message =================================

你好,我是谁啊?
================================== Ai Message ==================================

你好!我只能知道:你现在是这次和我对话的用户。
如果你是想问"我记不记得你是谁",那我其实**不会自动知道你的真实身份**,除非你在对话里告诉我。

你可以直接告诉我你想让我怎么称呼你。
================================ Human Message =================================

我是老王~
================================== Ai Message ==================================

你好,老王~ 很高兴认识你!
接下来我可以怎么帮你?
================================ Human Message =================================

你好,我是谁??
================================== Ai Message ==================================

你好,老王 🙂
================================ Human Message =================================

你好,我是谁啊?
================================== Ai Message ==================================

你好,老王。
================================ Human Message =================================

我是老王~
================================== Ai Message ==================================

你好,老王~ 有什么我可以帮你的?
================================ Human Message =================================

你好,我是谁??
================================== Ai Message ==================================

你好,老王。
根据输出判断,状态是累积的。
由此可以得出结论:即便重新创建Saver() ,只要thread_id 一致,历史状态就可以和当前调用串联起
来。
总结:
- InMemorySaver()将状态持久化到内存,进程结束或重建Saver() 则历史状态丢失
- 基于外部存储介质(如PostgreSQL)的持久化器,其存储的状态不会随进程终止而丢失,只要不
显式删除历史状态,即可通过thread_id 加载历史状态。
2.4 记忆治理策略(上下文管理)
随着对话的进行,历史消息不断累积,state会持续增长,为模型带来挑战:
- LLM的上下文窗口是有限的,完整历史可能无法装入LLM的上下文窗口,导致上下文丢失或错误。
- 即便模型的上下文窗口够大,多数LLM在长上下文场景仍然表现不佳。模型会被陈旧或离题的内容"分散注意力" 。
- 同时,会带来高昂的token花费。
此时需要对上下文进行管理:对历史记录进行压缩、清理、重组等。
2.4.1 消息裁剪
调用模型前裁剪上下文。
目标是控制token用量,通常保留系统初始消息和最近若干消息,或按token数保留末尾内容。
适合成本敏感、对旧上下文依赖不强的场景。
text
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 从.env文件中加载环境变量
load_dotenv(override=True)

model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL")
)
text
from langchain_core.messages import HumanMessage
from langchain.messages import RemoveMessage
from langgraph.graph.message import REMOVE_ALL_MESSAGES
from langgraph.checkpoint.memory import InMemorySaver
from langchain.agents import create_agent, AgentState
from langchain.agents.middleware import before_model
from langgraph.runtime import Runtime
from langchain_core.runnables import RunnableConfig
from typing import Any

@before_model
def trim_messages(state: AgentState, runtime: Runtime) -> dict[str, Any] | None:
    messages = state["messages"]

    if len(messages) <= 3:
        return None

    first_msg = messages[0]
    recent_messages = messages[-3:] if len(messages) % 2 == 0 else messages[-4:]
    new_messages = [first_msg] + recent_messages

    return {
        "messages": [
            RemoveMessage(id=REMOVE_ALL_MESSAGES),
            *new_messages
        ]
    }

agent = create_agent(
    model=model,
    middleware=[trim_messages],
    checkpointer=InMemorySaver(),
)

config: RunnableConfig = {"configurable": {"thread_id": "1"}}

agent.invoke({"messages": [HumanMessage("你好,我是老王")]}, config)
agent.invoke({"messages": [HumanMessage("从现在起,你叫小王")]}, config)
agent.invoke({"messages": [HumanMessage("今天天气不错")]}, config)
final_response = agent.invoke({"messages": [HumanMessage("告诉我,你是谁?我是谁?")]}, config)

for msg in final_response["messages"]:
    msg.pretty_print()
假设有 5 条消息:H1, A1, H2, A2, H3 (当前总数 5,奇数)。
执行 messages-4: 取出 A1, H2, A2, H3 。加上第一条 H1 ,最终大模型看到的是 [H1, A1,
H2, A2, H3] (相当于没剪掉什么)。
输出
text
================================ Human Message =================================

你好,我是老王
================================== Ai Message ==================================

好的,从现在起你可以叫我小王。
那我也叫你老王,可以吗?
================================ Human Message =================================

今天天气不错
================================== Ai Message ==================================

是啊,天气不错的话,心情也容易好起来。
你今天有什么安排吗?
================================ Human Message =================================

告诉我,你是谁?我是谁?
================================== Ai Message ==================================

我是你的AI助手。
你是老王。
显然,裁剪生效了。
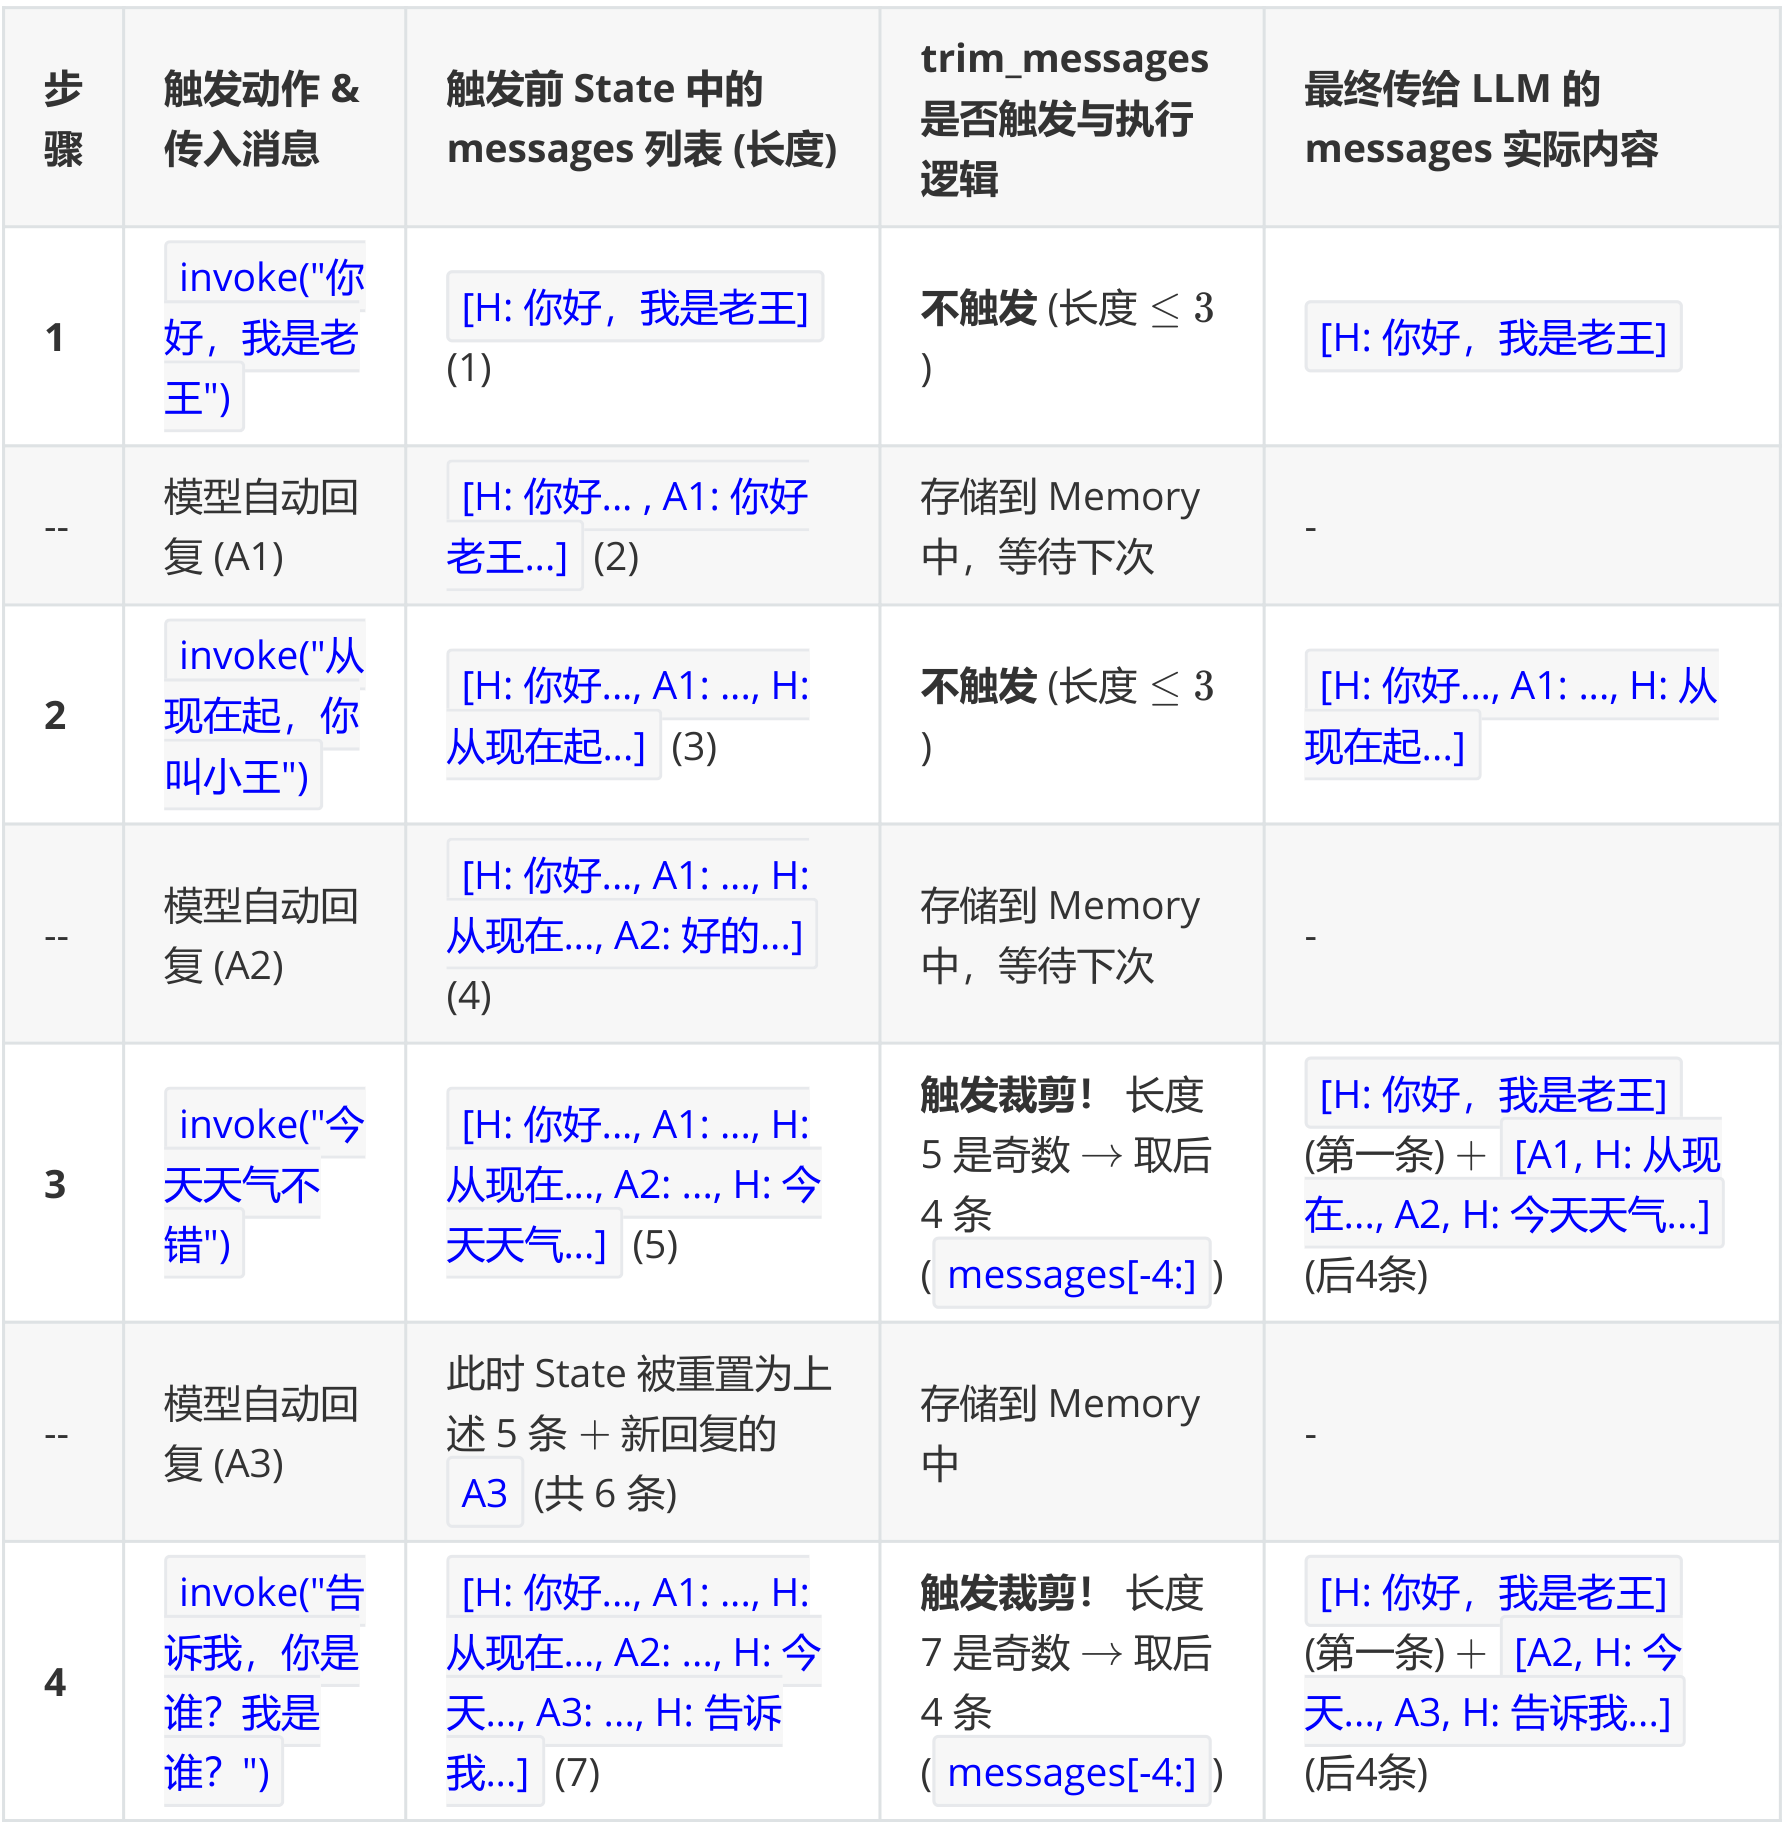
分析:
我们来看看连续 4 次 invoke 时,内存里到底发生了什么:
2.4.2 消息删除
消息裁剪强调"在模型调用前裁剪消息列表,控制模型可以看到的上下文范围",而消息删除强调模型
调用完成后将某些消息从消息列表中移除,永久更改状态。
适合明确要遗忘、清理、重置某些历史。
text
from langchain.messages import RemoveMessage
from langchain.agents import create_agent, AgentState
from langchain.agents.middleware import after_model
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.runtime import Runtime
from langchain_core.runnables import RunnableConfig


@after_model
def delete_old_messages(state: AgentState, runtime: Runtime) -> dict | None:
    messages = state["messages"]
    # 保持最近的 5 条消息
    if len(messages) > 5:
        # 框架中通常使用 RemoveMessage 来标记删除,并返回更新状态。
        to_delete = len(messages) - 5
        return {"messages": [RemoveMessage(id=m.id) for m in messages[:to_delete]]}
    return None


agent = create_agent(
    model=model,
    middleware=[delete_old_messages],
    checkpointer=InMemorySaver()
)

config: RunnableConfig = {"configurable": {"thread_id": "1"}}

agent.invoke({"messages": "你好,我是老王"}, config)
agent.invoke({"messages": "从现在起,你叫小王"}, config)
agent.invoke({"messages": "今天天气不错"}, config)
final_response = agent.invoke({"messages": "告诉我,你是谁?我是谁?"}, config)

for msg in final_response["messages"]:
    msg.pretty_print()
输出
text
================================== Ai Message ==================================

好的,从现在起你可以叫我小王。
================================ Human Message =================================

今天天气不错
================================== Ai Message ==================================

是啊,天气不错的时候心情也容易变好。你今天打算出去走走,还是在家休息一下?
================================ Human Message =================================

告诉我,你是谁?我是谁?
================================== Ai Message ==================================

我是小王,你是老王。
显然,模型调用后消息列表规模超过阈值触发了消息裁剪。
说明:只要消息总数超过 5 条,就计算超出几条(to_delete ),然后精准地删掉最老的那几条,使剩
下的消息总数永远保持在 5 条。
分析消息列表 messages 的数量变化:
📥 第一轮:
-
用户说:"你好,我是老王"(第 1 条)
-
AI 回复:"你好,老王!"(第 2 条)
-
数量:此时 len(messages) == 2 (不大于 5)。
-
结果:中间件不触发。(记忆:记住你是老王)
📥 第二轮:
-
用户说:"从现在起,你叫小王"(第 3 条)
-
AI 回复:"好的,我是小王。"(第 4 条)
-
数量:此时 len(messages) == 4 (不大于 5)。
-
结果:中间件不触发。(记忆:记住你是老王、我是小王)
📥 第三轮:
-
用户说:"今天天气不错"(第 5 条)
-
AI 回复:"是啊,天气好心情也好。"(第 6 条)
-
数量:此时 len(messages) == 6 。触发中间件条件 ( > 5 )!
-
清理发生:
计算 to_delete = 6 - 5 = 1 。
清理 messages:1 ,也就是只删除了第 1 条消息("你好,我是老王")。
- 剩余消息(共 5 条):
- AI 回复:"你好,老王!"(第 2 条)
- 用户说:"从现在起,你叫小王"(第 3 条)
- AI 回复:"好的,我是小王。"(第 4 条)
- 用户说:"今天天气不错"(第 5 条)
- AI 回复:"是啊,天气好心情也好。"(第 6 条)
📥 第四轮(最终提问):
- 用户输入:"告诉我,你是谁?我是谁?"(第 7 条)
大模型读取上下文:在 AI 做出最终回复前,大模型会读取当前留存的 5 条历史记录 + 用户的
这句新提问。
大模型通过上下文里 AI 自己说过的"你好,老王!",依然能够推断出"哦,原来坐在对面的人
叫老王"。
-
AI 做出最终回复:比如 "你是老王,我是小王啊。"(第 8 条)
-
数量:此时回复完后,总数 len(messages) == 8 。再次触发中间件!
-
清理发生:
计算 to_delete = 8 - 5 = 3 。
清理 messages:3 ,即把目前列表中最老的前 3 条消息删除。
- 剩余消息:依然精准保持在最后 5 条。
AI 回复:"好的,我是小王。"(第 4 条)
用户说:"今天天气不错"(第 5 条)
AI 回复:"是啊,天气好心情也好。"(第 6 条)
用户说:告诉我,你是谁?我是谁?(第 7 条)
AI回复: 你是老王,我是小王啊。(第 8 条)
RemoveMessage到底干了什么?
当你在中间件里返回 RemoveMessage(id=m.id) 时,你实际上是向框架发送了一个删除指令。
框架的底层处理逻辑如下:
text
[历史消息池 (内存中持续存在)]
 ├── Message(id="1", content="你好,我是老王")
 ├── Message(id="2", content="...")
└── RemoveMessage(id="1") <-- 这是一个新追加进去的"墓碑"标记-
追加"墓碑"标记:框架收到 RemoveMessage(id="1") 后,并不会去内存的数组里把 id="1" 的
对象删掉,而是把这个 RemoveMessage 作为一条新记录追加到当前线程的状态历史中。这个
RemoveMessage 就像是一个"墓碑"。
-
运行时过滤合并(Reducer):当下一次你再次调用 agent.invoke 或者大模型要去读取上下文
时,框架的内置合并器(Reducer)会把"原始消息"和"墓碑标记"放在一起进行计算:
原始消息墓碑标记对外隐藏
它在丢给大模型之前,会自动把被标记删除的消息过滤掉。
2.4.3 摘要
把早期历史压缩成摘要,再替换原始消息。
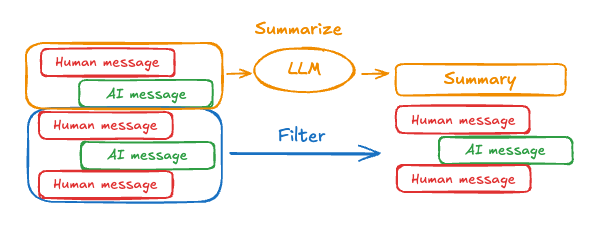
消息裁剪和删除都会导致上下文缺失,影响回答质量和用户体验。和它们相比,摘要是更适合长会话的
折中方案:保语义,不保原文。官方推荐内置SummarizationMiddleware 。上一章已有讲解。
text
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 从.env文件中加载环境变量
load_dotenv(override=True)

model_out = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL")
)
text
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 从.env文件中加载环境变量
load_dotenv(override=True)

model_in = init_chat_model(
    model="gpt-4o-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL")
)
text
from langchain.agents.middleware import SummarizationMiddleware
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver


# 创建带摘要中间件的 Agent
agent = create_agent(
    model=model_out,
    tools=[],
    checkpointer=InMemorySaver(),
    middleware=[
        SummarizationMiddleware(
            model=model_in,
            trigger=[
                ("tokens", 100),  # 超过 100 tokens 就摘要
            ],
            keep=("messages", 2),
            summary_prompt="对历史消息摘要,消息列表如下\n{messages}",

        )
    ]
)

config = {"configurable": {"thread_id": "1"}}

print("\n进行多轮对话...")
conversations = [
    "我叫张三,是工程师。这里是一段非常长非常长的废话..." * 20, # 强制撑爆 100 tokens
    "请总结一下我的信息"
]

for msg in conversations:
    response = agent.invoke(
        {"messages": [{"role": "user", "content": msg}]},
        config=config
    )
    for msg in response["messages"]:
        msg.pretty_print()
    print("*" * 50)
text
进行多轮对话...
================================ Human Message =================================

我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...我叫张三,是工程师。这里是一段非常长非常长的废话...
================================== Ai Message ==================================

你好,张三。你想让我基于这段内容做什么?
如果你愿意,我可以帮你:

1. **提炼关键信息**
2. **总结成一句话/一段话**
3. **改写成更正式的自我介绍**
4. **识别并去掉重复废话**
5. **翻译成英文**

例如,提炼后可以写成:

> 张三是一名工程师。

如果你告诉我目标,我可以直接帮你处理。
**************************************************
================================ Human Message =================================

Here is a summary of the conversation to date:

根据历史消息,用户"张三"自称是一名工程师,并重复发送了大量无实质内容的废话(如"这里是一段非常长非常长的废话")。摘要如下:

**摘要**:用户张三(工程师)发送了重复的冗长废话,内容无实际信息。
================================== Ai Message ==================================

你好,张三。你想让我基于这段内容做什么?
如果你愿意,我可以帮你:

1. **提炼关键信息**
2. **总结成一句话/一段话**
3. **改写成更正式的自我介绍**
4. **识别并去掉重复废话**
5. **翻译成英文**

例如,提炼后可以写成:

> 张三是一名工程师。

如果你告诉我目标,我可以直接帮你处理。
================================ Human Message =================================

请总结一下我的信息
================================== Ai Message ==================================

根据你提供的内容,目前能总结出的信息是:

- **姓名**:张三
- **职业**:工程师
- **特点**:之前发送的内容以重复、冗长的无实质信息为主

如果你愿意,我还可以帮你把这些信息整理成:
- **正式简介**
- **一句话自我介绍**
- **简历风格描述**
- **更自然的个人介绍**
**************************************************
text
final_state = agent.get_state(config)
print("\n--- 最终保存在 State 中的真实消息 ---")
for msg in final_state.values.get("messages", []):
    msg.pretty_print()
text
--- 最终保存在 State 中的真实消息 ---
================================ Human Message =================================

Here is a summary of the conversation to date:

根据历史消息,用户"张三"自称是一名工程师,并重复发送了大量无实质内容的废话(如"这里是一段非常长非常长的废话")。摘要如下:

**摘要**:用户张三(工程师)发送了重复的冗长废话,内容无实际信息。
================================== Ai Message ==================================

你好,张三。你想让我基于这段内容做什么?
如果你愿意,我可以帮你:

1. **提炼关键信息**
2. **总结成一句话/一段话**
3. **改写成更正式的自我介绍**
4. **识别并去掉重复废话**
5. **翻译成英文**

例如,提炼后可以写成:

> 张三是一名工程师。

如果你告诉我目标,我可以直接帮你处理。
================================ Human Message =================================

请总结一下我的信息
================================== Ai Message ==================================

根据你提供的内容,目前能总结出的信息是:

- **姓名**:张三
- **职业**:工程师
- **特点**:之前发送的内容以重复、冗长的无实质信息为主

如果你愿意,我还可以帮你把这些信息整理成:
- **正式简介**
- **一句话自我介绍**
- **简历风格描述**
- **更自然的个人介绍**
工作原理
text
对话历史: [消息1, 消息2, ..., 消息20]  (超过 100 tokens)
    ↓
SummarizationMiddleware 自动触发
    ↓
摘要旧消息: "用户是张三,在北京工作,喜欢编程..."
    ↓
新历史: [摘要, 最近消息]  (减少到 100 tokens)
常见问题
1. 摘要会丢失信息吗?
会有一些细节丢失,但:
-
重要信息会保留(姓名、关键事实)
-
最近的消息完整保留
-
对于大部分场景足够
2. 设置最大token数触发摘要的标准是啥?
text
# 模型上下文窗口 4k → 设置 3000
# 模型上下文窗口 8k → 设置 6000
# 模型上下文窗口 16k → 设置 12000

# 留一些余量给工具调用和系统提示
3. 摘要成本高吗?
-
摘要只在超过阈值时触发
-
可以使用便宜的模型(如 gpt-4o-mini)
-
相比传输全部历史,通常更便宜
4. 摘要触发的频率要关注吗?
要关注,根据监控摘要触发频率,调整阈值。
-
如果频繁触发 → 提高阈值
-
如果从不触发 → 降低阈值
2.4.4 自定义过滤策略
通过中间件可以随意更改消息列表,因此可以实现任意的过滤策略。
此处不再演示。
2.5 了解:state的理解
state是agent底层有状态运行图的状态信息,是AgentState类型的实例,定义如下:
text
class AgentState(TypedDict, Generic[ResponseT]):
    """State schema for the agent."""

    messages: Required[Annotated[list[AnyMessage], add_messages]]
    jump_to: NotRequired[Annotated[JumpTo | None, EphemeralValue, PrivateStateAttr]]
    structured_response: NotRequired[Annotated[ResponseT, OmitFromInput]]
说明:
-
AgentState是TypedDict的子类,这意味着我们可以按照字典的读写方式访问其实例的元素。
-
该类有三个字段
messages :截止到当前节点的历史会话消息记录,标记为Required。
jump_to :中间件章节介绍过,表示跳转至运行图的指定节点,标记为NotRequired,表示
该字段可以为None。(后续案例可以看到这一点)
structured_response :结构化输出内容,当我们启用结构化输出时,结构化后的内容会被
记录在这里,见下文案例。
举例:
text
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os

# 从.env文件中加载环境变量
load_dotenv(override=True)

model = init_chat_model(
    model="gpt-5.4-mini",
    model_provider="openai",
    api_key=os.getenv("CLOSEAI_API_KEY"),
    base_url=os.getenv("CLOSEAI_BASE_URL")
)
text
from langchain.agents import create_agent
from langchain.agents.middleware import AgentState, before_model, wrap_tool_call, after_agent
from langchain.tools.tool_node import ToolCallRequest
from langchain.messages import HumanMessage, AIMessage, ToolMessage
from langchain.tools import tool
from langgraph.runtime import Runtime
from langgraph.types import Command
from typing import Any, Callable
from pydantic import BaseModel, Field


class WeatherInfo(BaseModel):
    """城市天气情况"""
    city: str = Field(description="城市名称")
    temperature: str = Field(description="气温")
    desc: str = Field(description="当日天气概述")

@tool(parse_docstring=True)
def get_weather(city: str):
    """
    获取当日天气

    Args:
        city: 城市名称
    """
    return f"[{city}] 今天气温9~16度,万里无云,天气不错适合外出"

@before_model(can_jump_to=["tools"])
def direct_tool_call(state: AgentState, runtime: Runtime) -> dict[str, Any] | None:
    last_msg = state["messages"][-1]
    if isinstance(last_msg, HumanMessage) and "天气" in last_msg.text and "北京" in last_msg.text:
        fake_tool_call = AIMessage(
            content="人工构造的消息",
            tool_calls=[
                {
                    "name": "get_weather",
                    "args": {
                        "city": "北京"
                    },
                    "id": "direct_call_id"
                }
            ]
        )
        return {
            "messages": [fake_tool_call],
            "jump_to": "tools"
        }

    return None

@wrap_tool_call
def first_check(
        request: ToolCallRequest,
        handler: Callable[[ToolCallRequest], ToolMessage | Command]
    ) -> ToolMessage | Command:
    print("=" * 30, '-> In first_check Middleware <-', "=" * 30)
    print(f"{request.state.get("jump_to", None) = }")
    print(f"{request.state.get("structured_response", None) = }")

    return handler(request)

@after_agent
def final_check(state: AgentState, runtime: Runtime) -> dict[str, Any] | None:
    print("=" * 30, '-> In final_check Middleware <-', "=" * 30)
    for msg in state["messages"]:
        msg.pretty_print()

    print("=" * 30, "-> 消息打印完毕 <-", "=" * 30)
    print(f"{state.get("jump_to", None) = }")
    print(f"{state.get("structured_response", None) = }")

    return None

agent = create_agent(
    model = model,
    response_format=WeatherInfo,
    middleware=[direct_tool_call, first_check, final_check],
    tools=[get_weather],
)

response = agent.invoke({
    "messages": [
        HumanMessage("请帮我查询北京当日天气")
    ]
})
输出
text
============================== -> In first_check Middleware <- ==============================
request.state.get("jump_to", None) = 'tools'
request.state.get("structured_response", None) = None
============================== -> In final_check Middleware <- ==============================
================================ Human Message =================================

请帮我查询北京当日天气
================================== Ai Message ==================================

人工构造的消息
Tool Calls:
get_weather (direct_call_id)
Call ID: direct_call_id
Args:
 city: 北京
================================= Tool Message =================================
Name: get_weather

[北京] 今天气温9~16度,万里无云,天气不错适合外出
================================== Ai Message ==================================

{"city":"北京","temperature":"9~16℃","desc":"万里无云,天气不错适合外出"}
============================== -> 消息打印完毕 <- ==============================
state.get("jump_to", None) = None
state.get("structured_response", None) = WeatherInfo(city='北京', temperature='9~16℃', desc='万里无云,天气不错适合外出')
分析
- 我们在模型调用之前通过jump_to直接跳转至工具节点
- 在工具调用前打印状态信息,此时的jump_to非空
- 在Agent执行完毕之后打印状态信息,此时的structure_response非空而jump_to为空。