《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star
AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入 (https://t.zsxq.com/33pJ0)
目录
本文要点
AuK 是腾讯混元语音团队和上海交大 2026 年 9 月开源的语音基础模型,一条自然语言指令加一段可选音频,同一个 1.5B 主干接下 TTS、改台词、改情绪口音音色、调语速音高、降噪和分离。
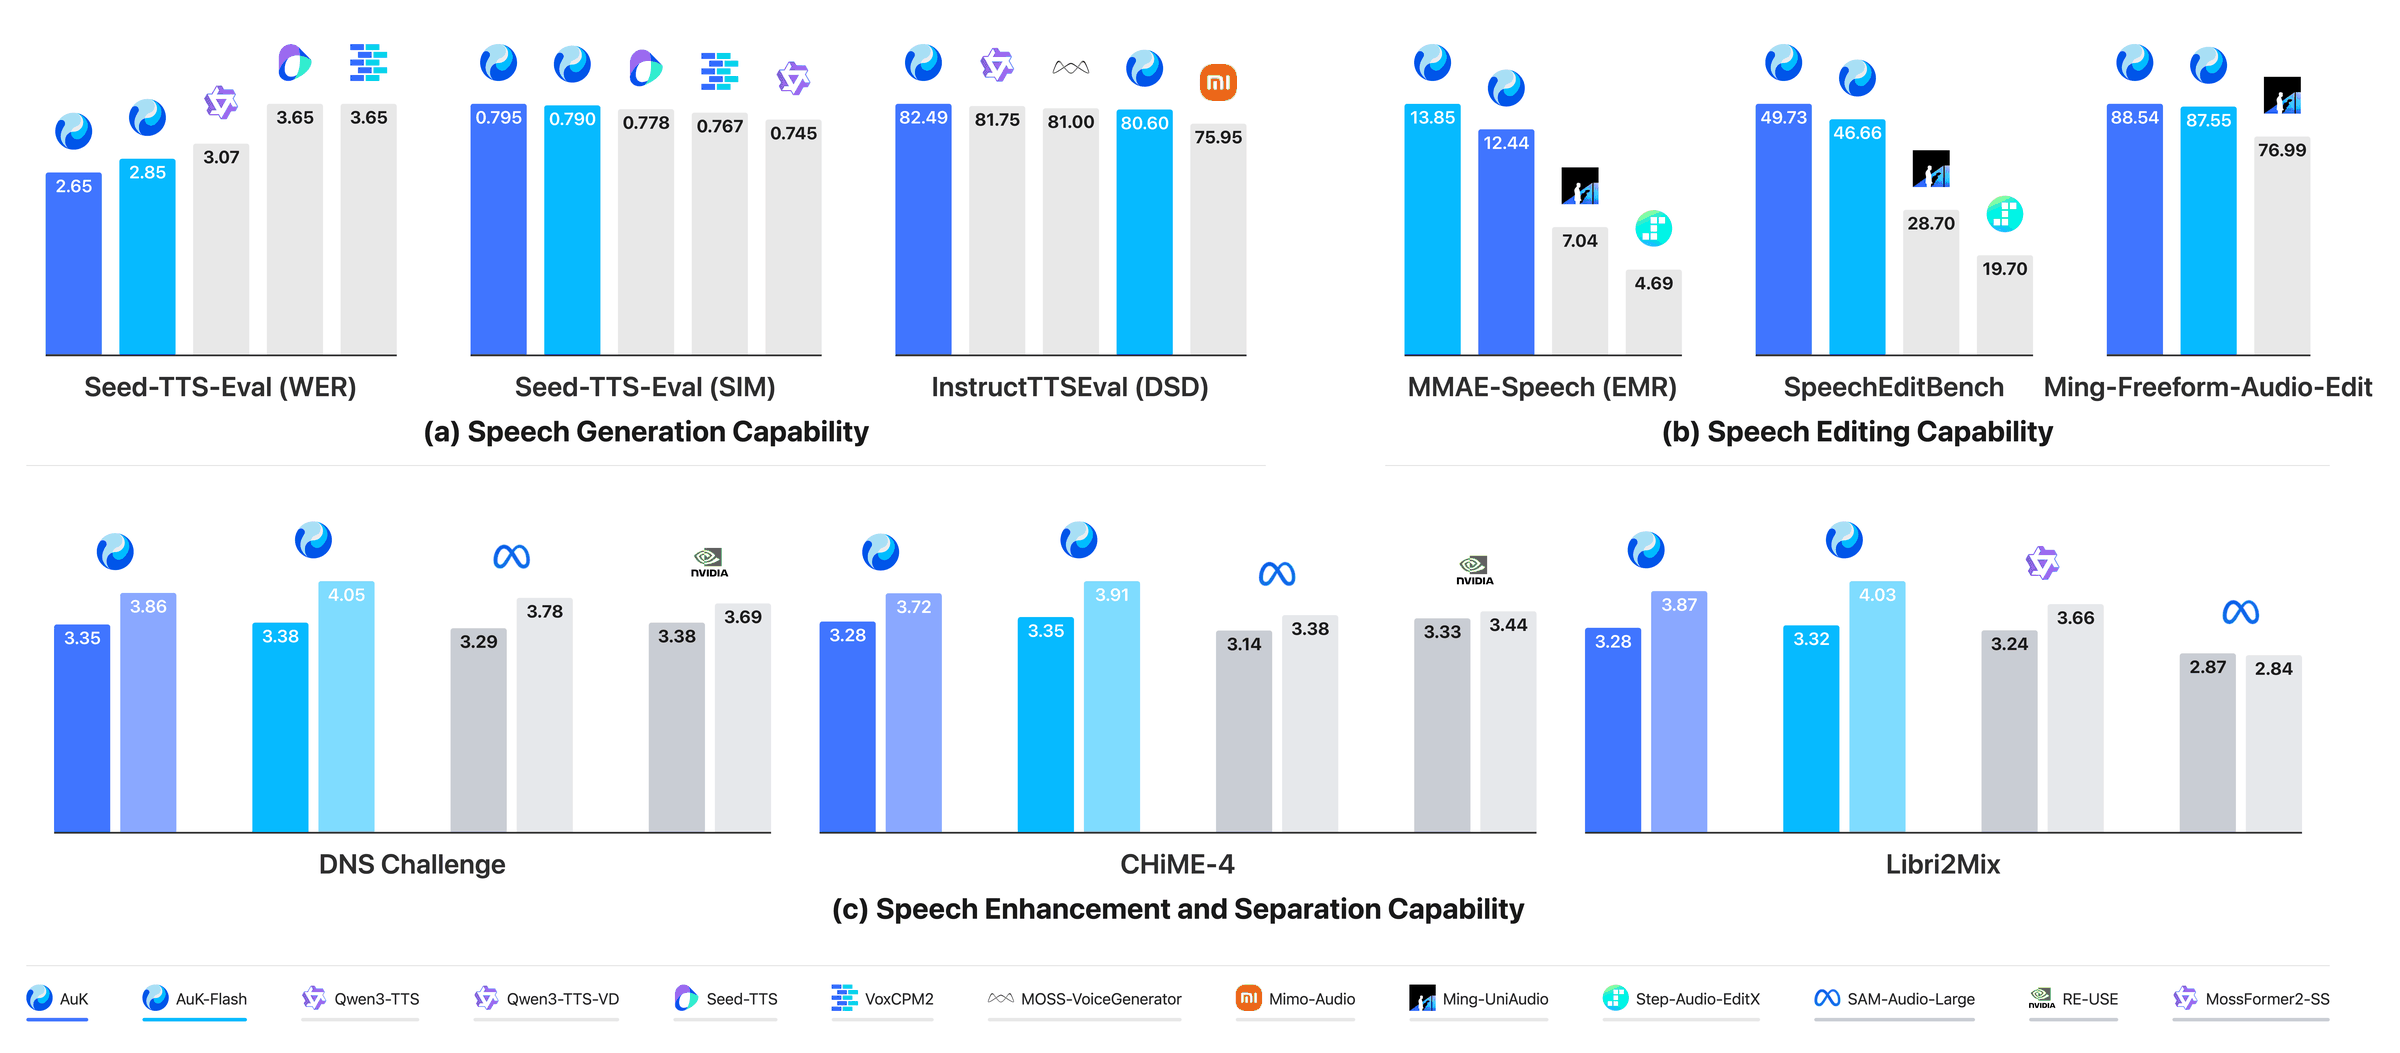
Seed-TTS-Eval 平均识别错误率 2.65% ,SpeechEditBench 内容编辑成功率 91.83%,MMAE-Speech 三项指标由完整版和 Flash 版分占第一,降噪分离只算有竞争力。
训练对靠一整套现成工具合成,蒸馏时把分离任务单独路由到监督回归,避开 DMD 对分离的破坏,得到 4 步无 CFG 的 AuK-Flash。
短板在情绪编辑成功率不到 10%,自由指令仍要靠外部 LLM 做 Prompt Enhancer 改写,跑起来还得再带一个 Qwen2.5-Omni-3B。
文末附官方 README 的命令行推理示例和 ComfyUI 节点用法。
腾讯混元语音团队联合上海交通大学、上海创智学院,在 2026 年 9 月 8 日放出了 AuK 的技术报告,代码和两版权重同步开源。我把报告、GitHub README 和 ComfyUI 文档从头对了一遍,CSDN 上还没有专文,所以单独写一篇。
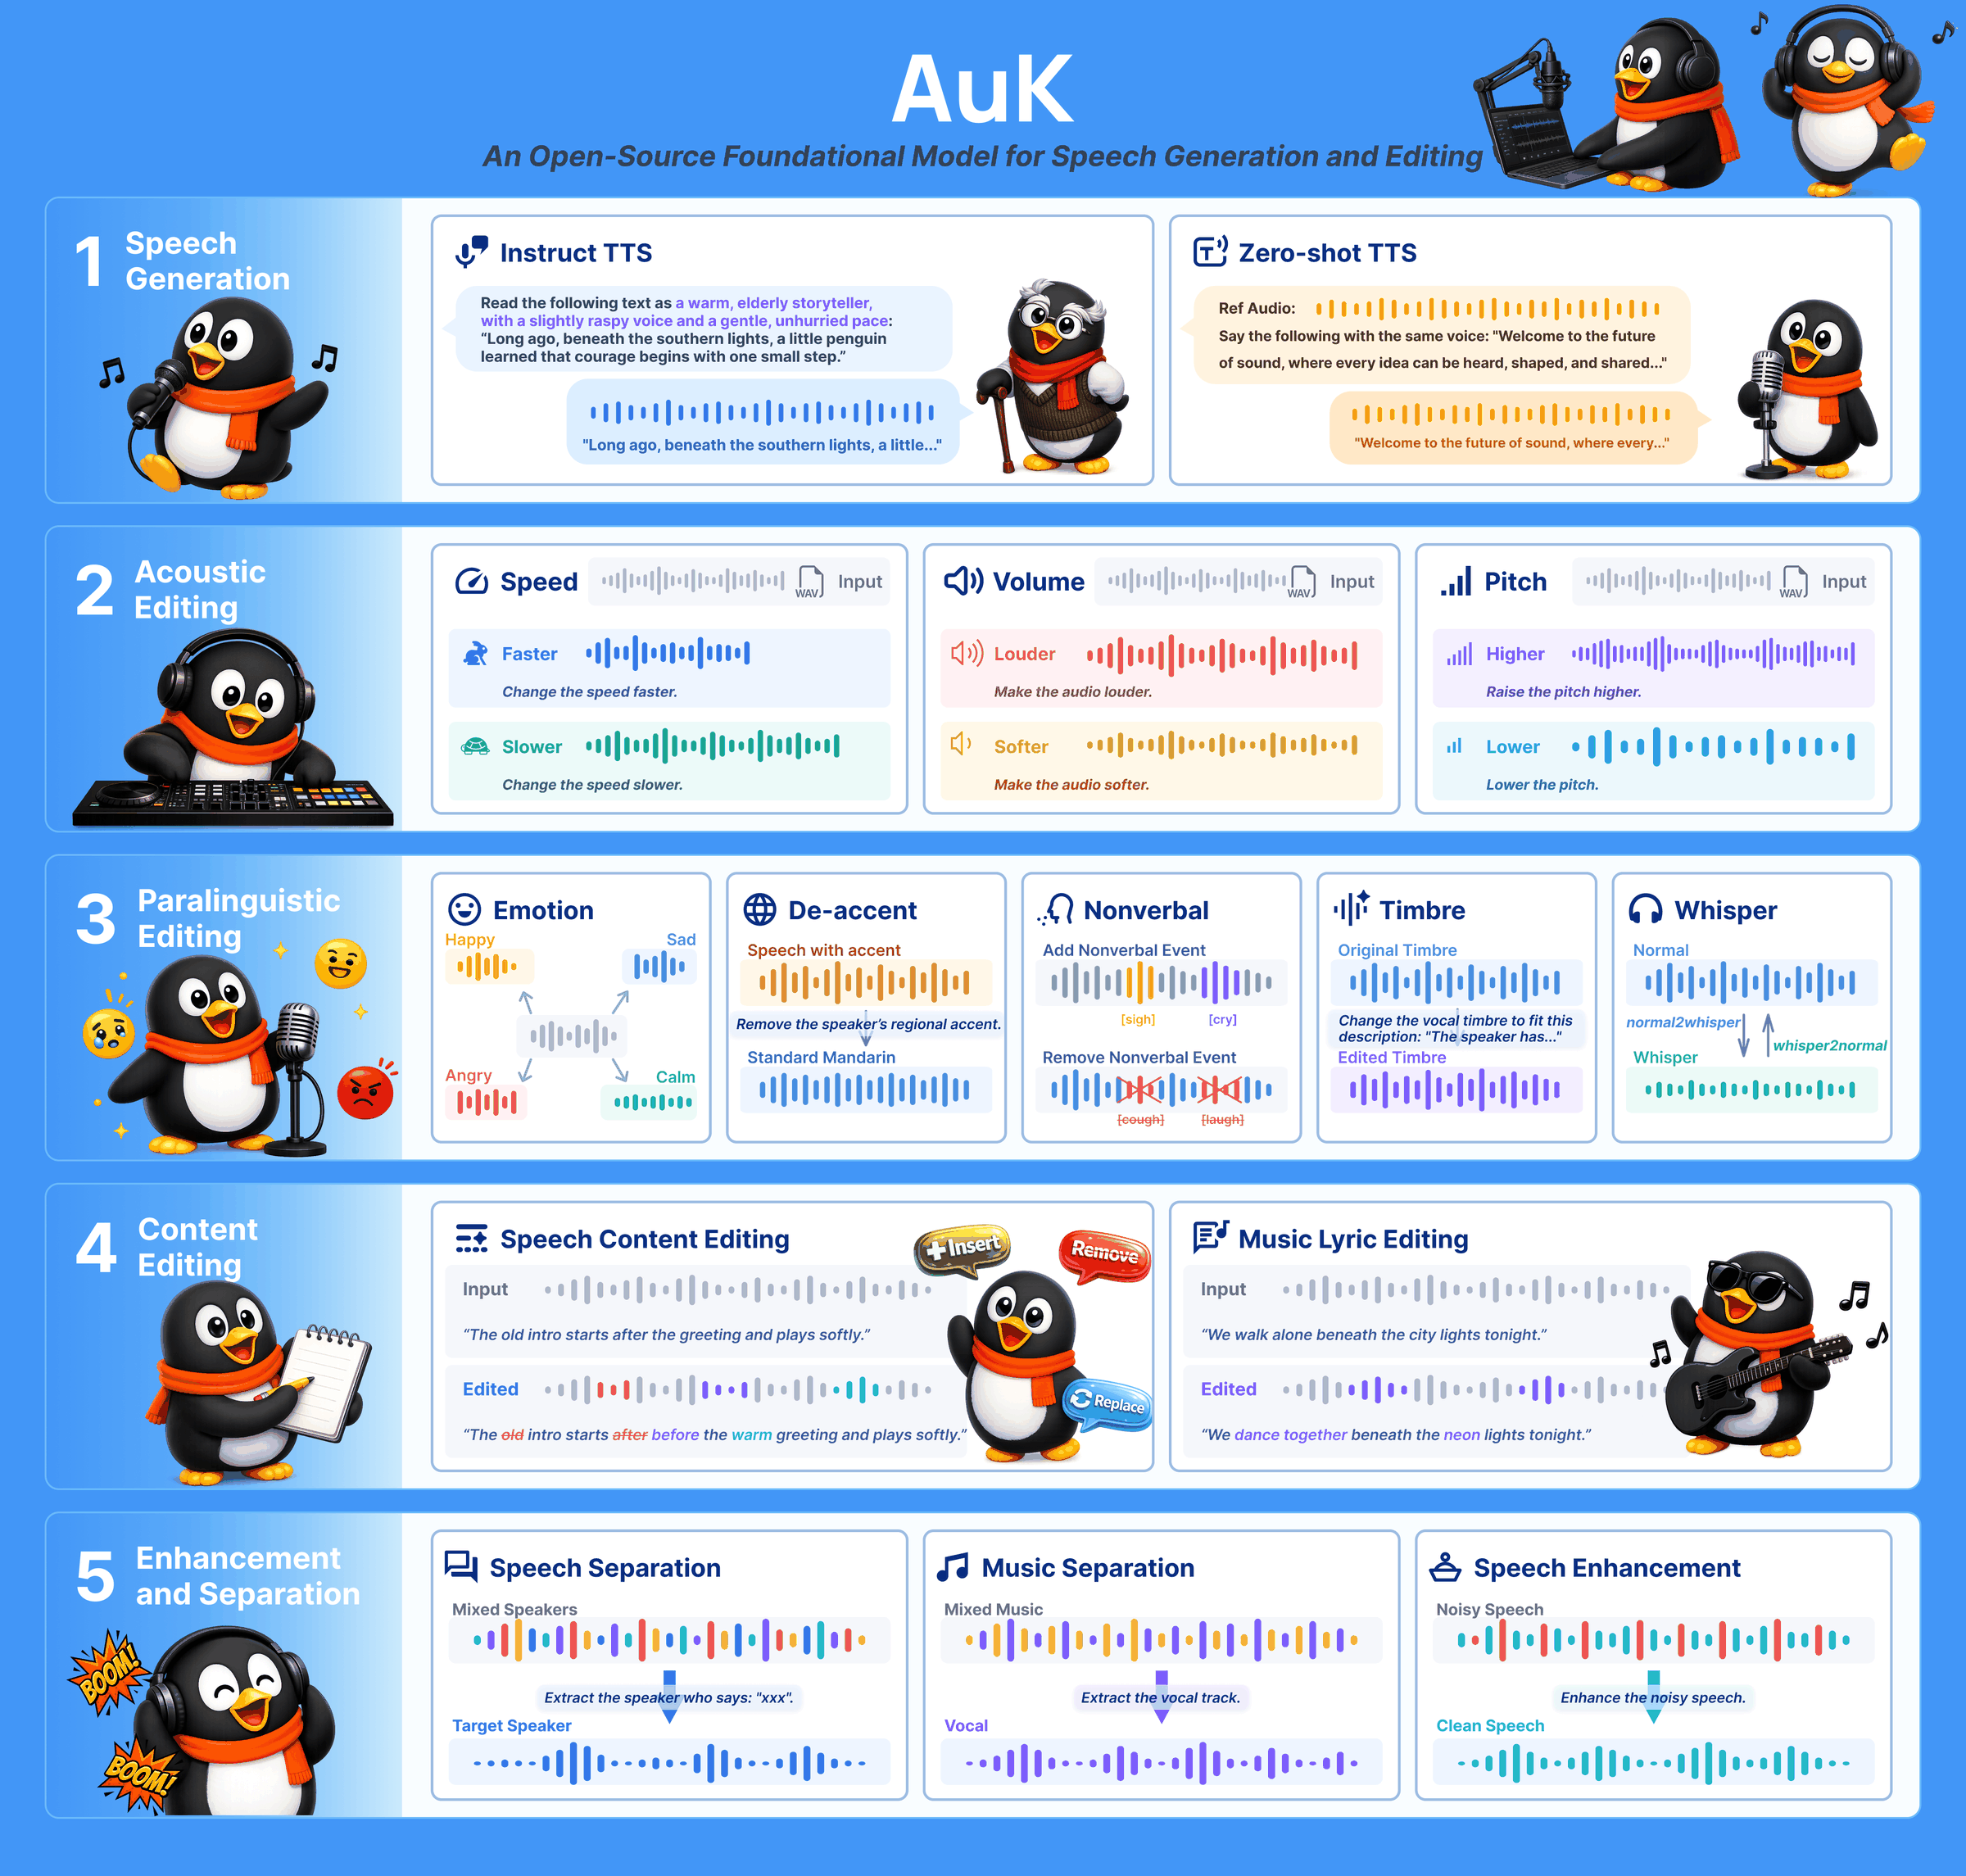
它做的事一句话能说完。一条自然语言指令,加一段可选的输入音频,同一个模型输出目标波形,指令可以是「用这个声音念这段话」,也可以是「只保留第二个说话人」。
一条指令接五类任务
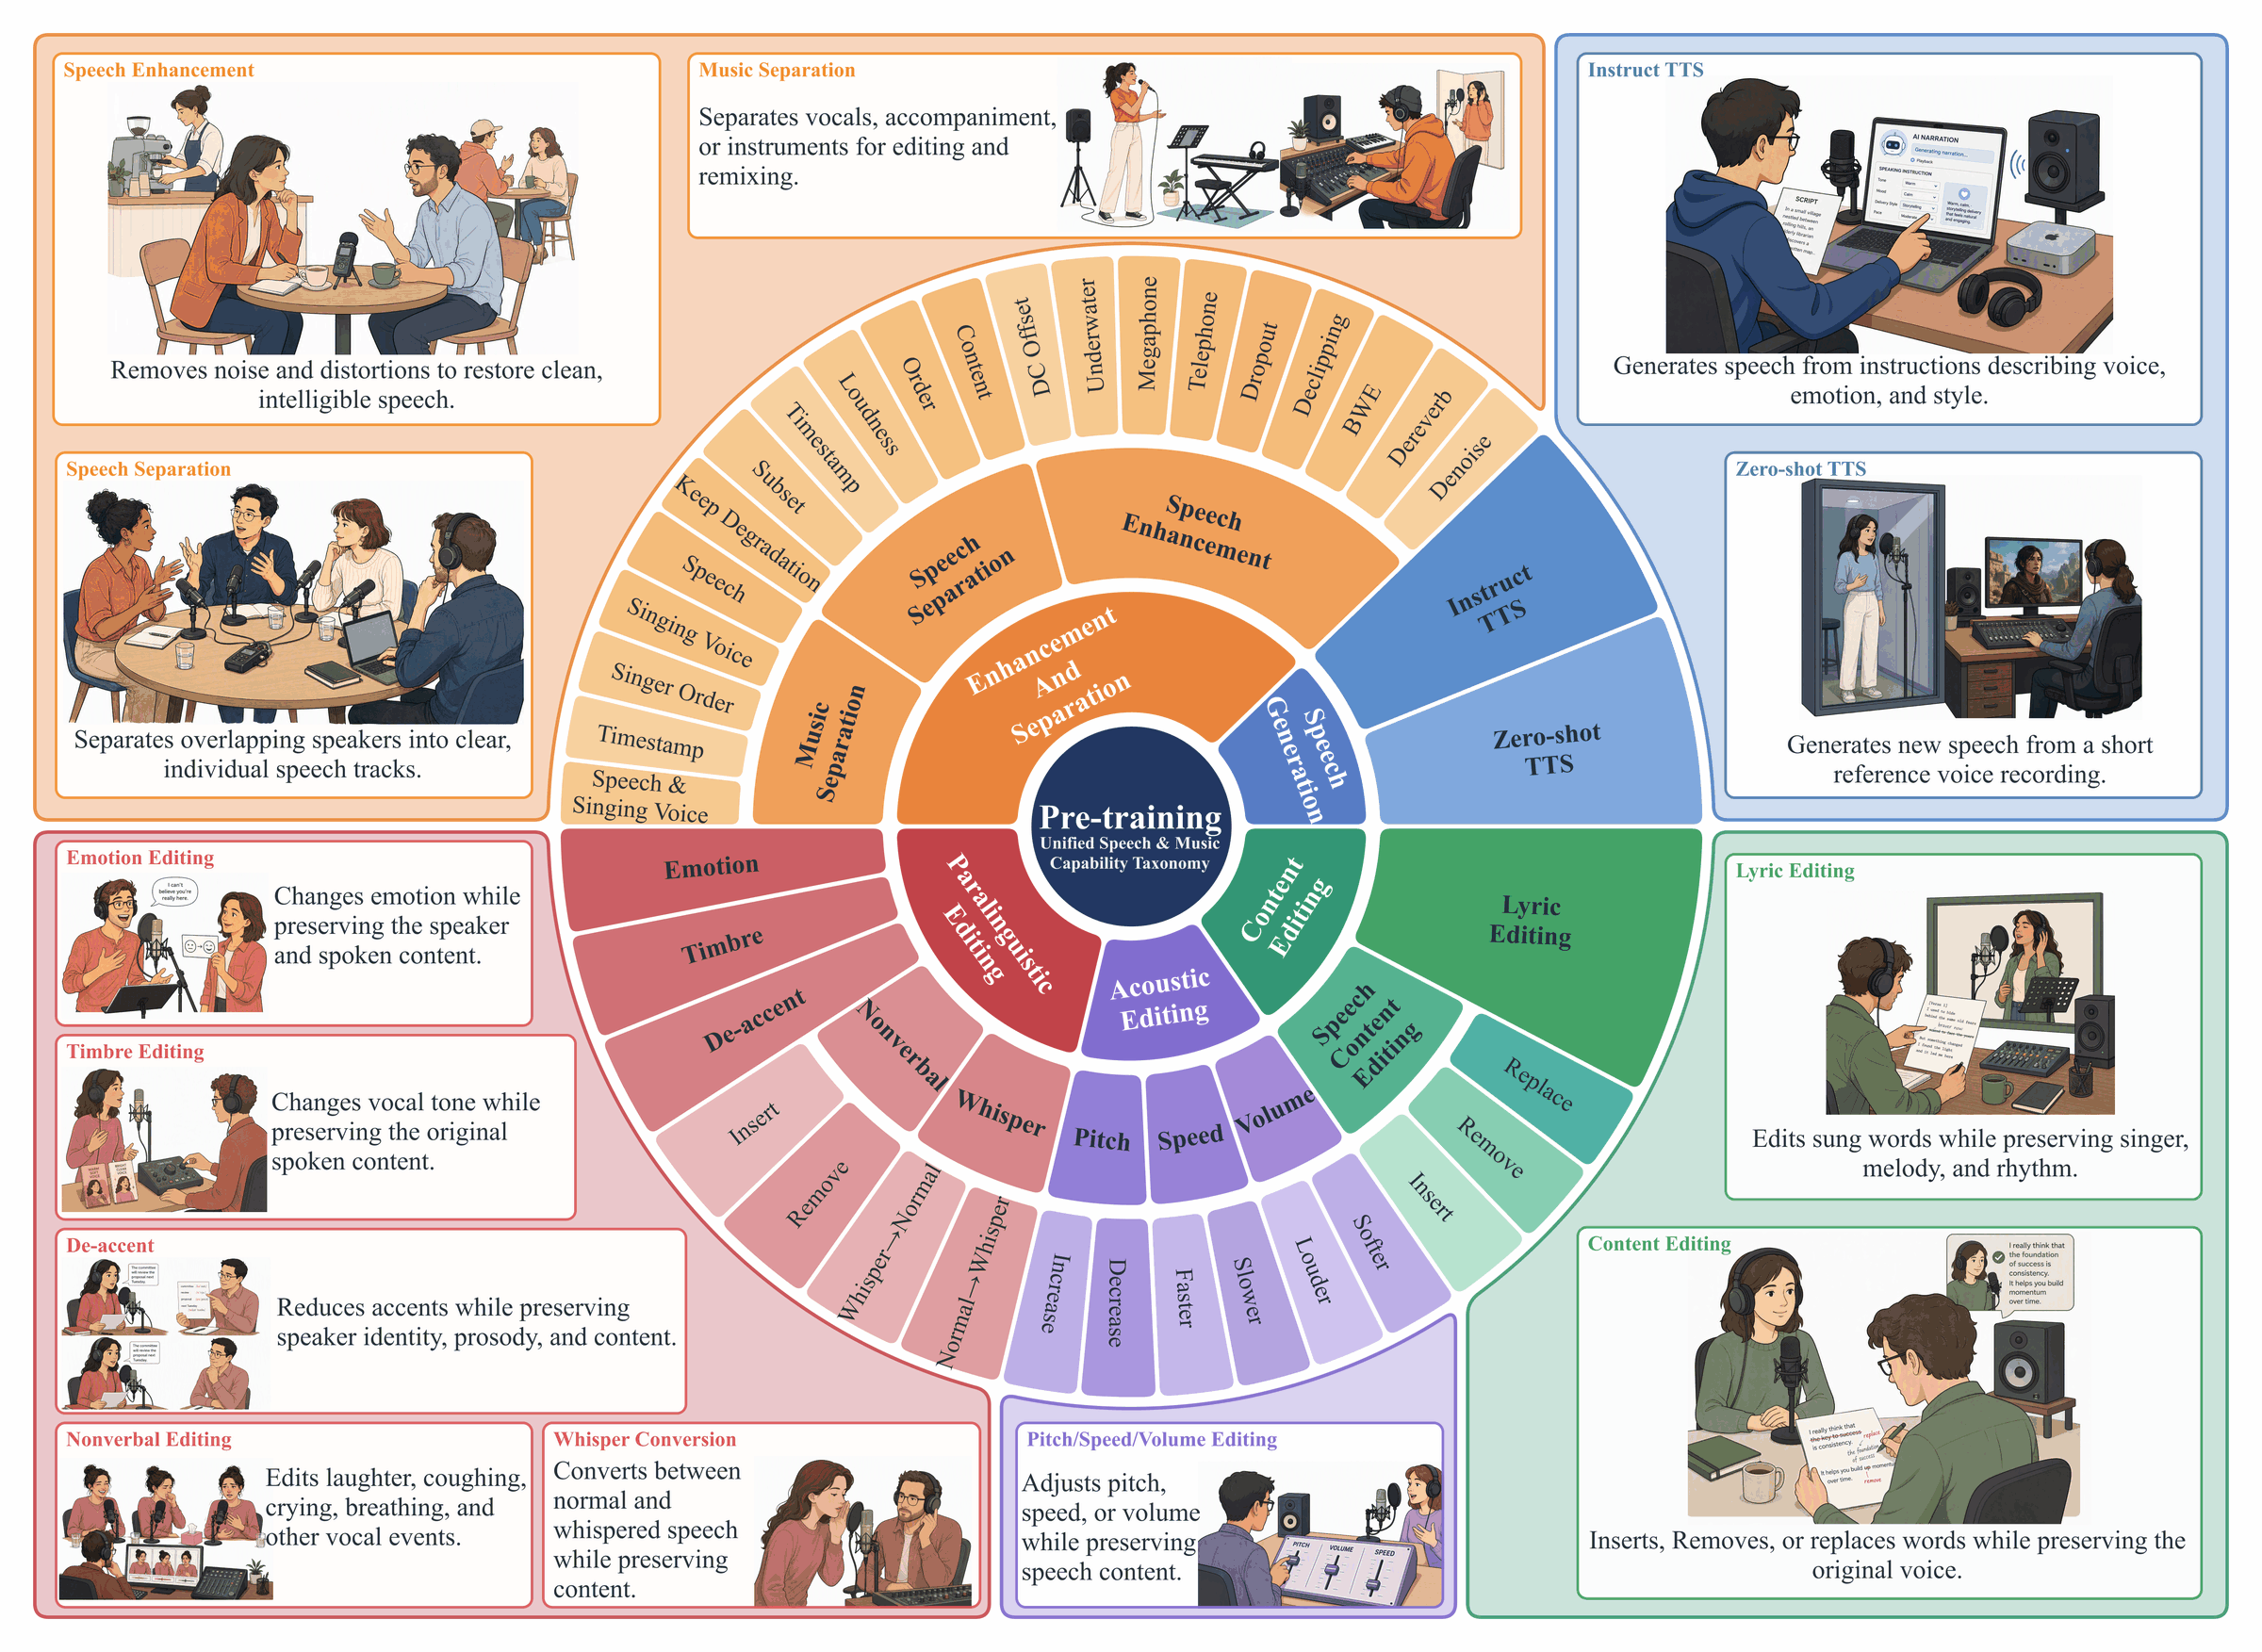
报告把任务分成五族。语音生成,含零样本 TTS 和指令 TTS。声学编辑,改语速、音量、音高。副语言编辑,改情绪、音色、口音、非言语声和低语转换。内容编辑,改台词和歌词。增强与分离,降噪、去混响、提取或删除某个声源。
这五类拧在一起难在输出约束互相打架。生成要凭空造出新语音,内容编辑只许动选中的一小段,副语言和声学编辑一个字都不能改,增强分离只留指令点名的声音。
报告给的数据规模是约 30.3 亿 条指令音频样本,合计 195 万小时有效监督,同一段音频在不同任务下反复出现,所以样本数远多于小时数。
训练对从哪里来
编辑任务需要成对数据,同一个人同一句话,编辑前后各一版。这种东西自然界没有,报告花了最大篇幅讲怎么造。
零样本 TTS 的做法和主流不同。常规做法把一条录音切成提示段和目标段,AuK 找同一说话人的 n 条不同录音两两配对,一条当音频提示一条当合成目标,得到 n 乘 n 减 1 个训练对。提示段的转写从头到尾不给模型,推理时用户也就不用提供参考文本。
指令 TTS 用 Qwen3-Omni 给每条语音写一段自由描述,外加性别、年龄、语速、口音、情绪等结构化属性,描述和目标文本拼成指令。
声学编辑最省事,全靠确定性信号处理。五档语速倍率,正负 5、10、15 dB 六档音量,正负 1、2、3 个半音六档音高,每档配一句写明幅度的指令。
副语言编辑是一场工具接力。情绪编辑先让 Qwen3-TTS-CustomVoice 合成一条带目标情绪的参考音,再让 IndexTTS2 保留原说话人音色、借用参考音的情绪重新合成。去口音覆盖 13 种中文方言和地方口音,CosyVoice2 合成同说话人的标准普通话参考,OmniVoice 再按参考重建源音频。
非言语声归一成 39 类事件,Qwen3-ForcedAligner 定位时间段,遮住之后用 F5-TTS 补出一版没有该事件的音频,一对数据同时支持删除和插入两种指令。
内容编辑走同一套局部遮罩补全。LLM 生成插入、删除、替换三种目标文本,Qwen3-ForcedAligner 把要改的词映射到时间区间,只遮这一段让 F5-TTS 补全,合成结果再过一遍 ASR,词错率高的丢掉。
增强与分离的目标随指令变。同一段脏音频,降噪指令的目标可以保留混响,去混响指令的目标可以保留环境音。
五族数据在第二阶段预训练里的采样比例在表 1 里。生成 28.10%,内容编辑 23.02%,增强分离 23.17%,副语言编辑 21.75%,声学编辑只有 3.96%。
三块拼起来的模型
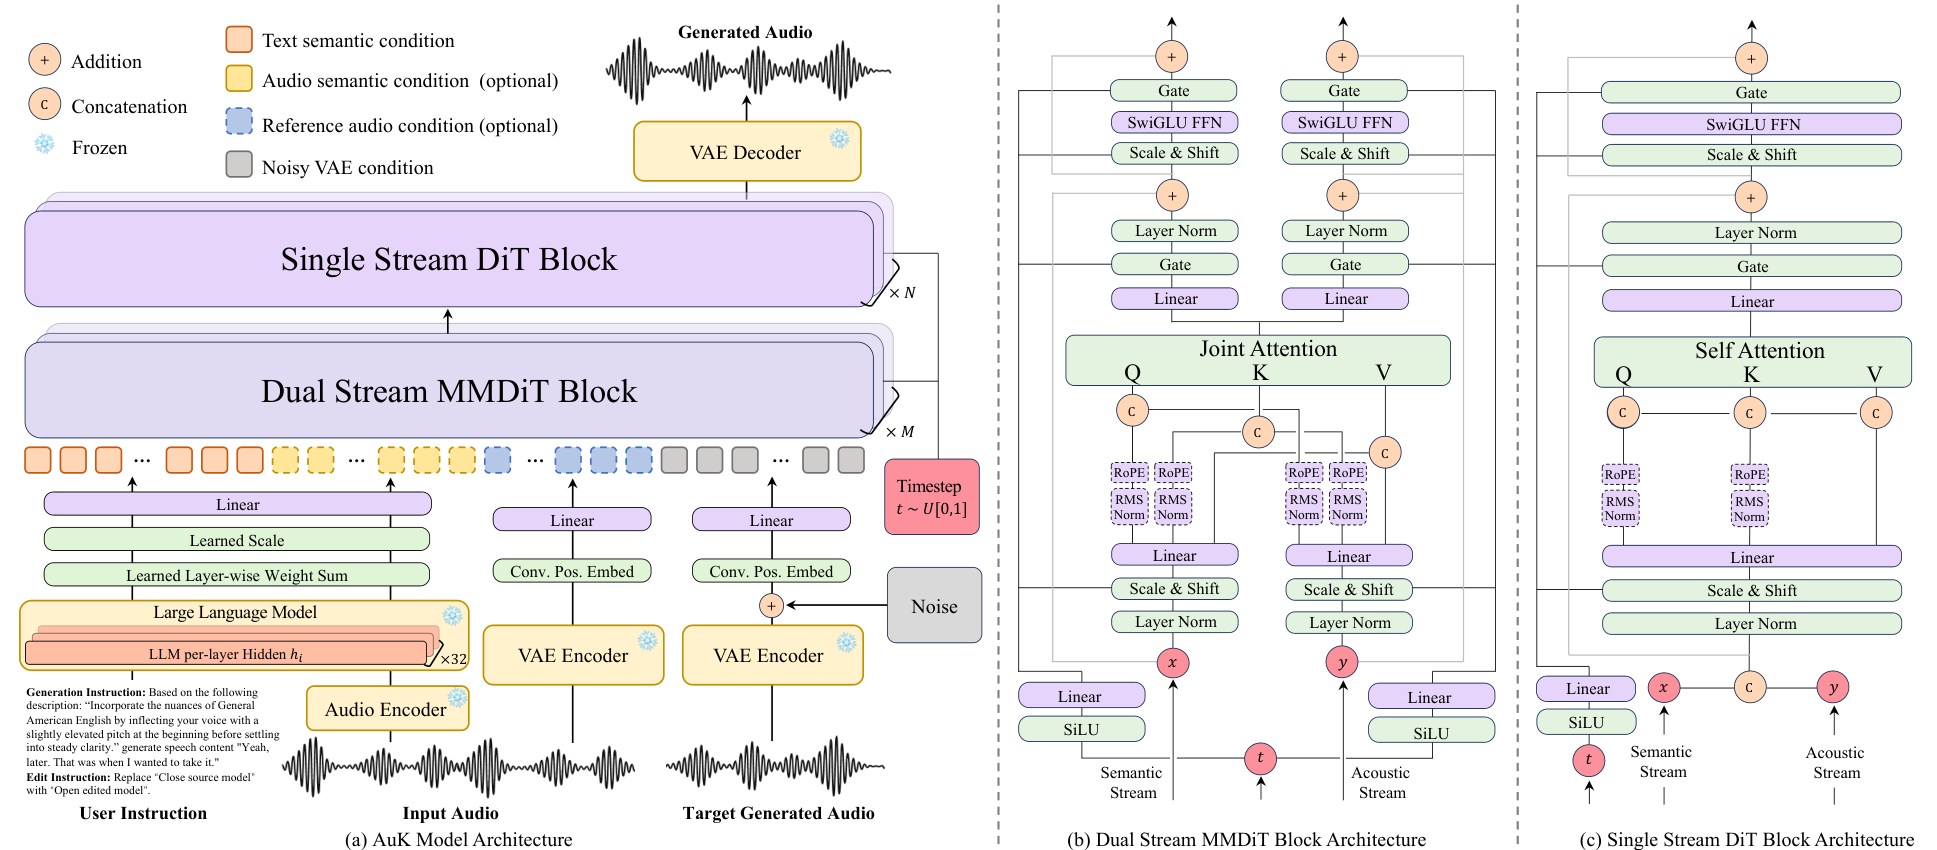
语义条件来自冻结的 Qwen2.5-Omni。指令文本和输入音频一起送进去,取每一层的隐藏状态做 LayerNorm 后按可学习权重加权求和,只取最后一层会丢掉浅层的声学线索。
声学条件来自自家训的 AuK-VAE。24 kHz 波形压成 50 Hz、64 维的隐变量,训练数据约 300 万小时 语音、通用音频、音乐,训了 124 万步。输入音频过 VAE 编码器得到参考隐变量,和加噪的目标隐变量沿序列方向拼接。
主干是 FLUX 式混合结构,10 层双流 MMDiT 接 20 层单流 DiT,隐藏维度 1536,约 1.5B 参数。双流阶段语义流和声学流各走各的残差通路,只在注意力里交换信息,单流阶段把两路拼起来一起精炼,输出流速度。
预训练先只用生成任务训 5 万步打底,再五类任务联合训 60 万步。256 张 GPU,每步全局批次最多 6144 条语音,约 14 小时音频。
后训练,编辑靠人评,生成靠奖励
编辑任务没有现成的奖励模型,一次编辑算不算成功也很难用单个指标量出来,报告的办法是直接收人的反馈。每条编辑指令让预训练模型采 10 或 20 个候选,标注员打三档分,失败、部分完成、成功。全组同分的丢掉,剩下 818 组、9080 个评过分的候选。
优化用流匹配版的 DPO 打隐式偏好分,再套 LiPO 的列表式目标处理三档序数标签,只训了 104 步。
生成任务用 Flow-GRPO,固定 1 万条零样本提示,中英各半,指令 TTS 另建 5000 条,刻意多采基座模型最弱的控制维度。
奖励设计有个防作弊的细节。ASR 错误率分宽松版和严格版,同音字替换不算发音失败。说话人相似度只在内容零错误的候选之间做标准化,防止相似度高把内容错误抹平。
四步无 CFG 是怎么蒸出来的
完整版 AuK 推理要 32 步 Euler 积分,CFG 系数 2.0。CFG 是无分类器引导,每一步要跑有条件和无条件两次前向再做差。蒸馏分两阶段,老师始终是后训练完的完整模型。
第一阶段是一致性初始化。学生从老师复制过来,学习从任意噪声状态直接跳到轨迹终点。老师用一步带 CFG 的速度把状态往前推一小段,学生从前后两个状态预测的终点要一致。这一阶段只训 500 步,给后面一个四步能出声的起点。
第二阶段用解耦 DMD。DMD 是分布匹配蒸馏,训一个 fake score 网络追踪学生自己的输出分布,冻结的老师当 real score,两者之差给学生梯度,把学生往老师那边推。解耦版把学生更新拆成两块,CFG 增强负责把老师的条件引导传给学生,分布匹配负责让两边分布对上。
这里踩了一个坑。直接拿老师的 CFG 目标喂 CFG 增强分支,四步学生会过饱和,波形过冲,听得到削波。报告把这条分支的 CFG 换成 APG,一种自适应投影引导,压掉过头的引导分量,引导系数 4.0。
第二个坑更要紧。对所有任务一律做 DMD,多说话人分离和人声分离会退化,一部分学生输出退回成没处理过的混合音频。
报告给的解释是分布不匹配。分离做错的输出重加噪后落在老师训练分布之外,老师的速度场倾向于给出全局听着合理但没分干净的音频,学生越学越回去。
解法是按任务路由。分离样本走监督回归,学生的干净终点预测直接对真值隐变量算均方误差,也不参与 fake score 的更新。其余任务照常走解耦 DMD。学生训 2500 步,每步配 5 步 fake score 更新,没有另加对抗判别器。
最终 AuK-Flash 4 步、无 CFG,报告在同硬件同输出时长同批次下测到 4.5 倍壁钟提速。32 步带 CFG 对 4 步不带 CFG,账面上前向次数差得远不止这个数,剩下的时间估计花在 Qwen2.5-Omni 编码和 VAE 解码上,报告没拆,这是我的推测。
成绩单
先把生成侧的关键数字放在一起。Seed-TTS-Eval 的 WER 和 SIM 取中英文和中文难例三个子集的平均,InstructTTSEval 的 DSD 考模型能不能按一段自由描述造出对应音色。
| 模型 | Seed-TTS-Eval 平均 WER | Seed-TTS-Eval 平均 SIM | InstructTTSEval DSD-ZH | InstructTTSEval DSD-EN |
|---|---|---|---|---|
| AuK | 2.65 | 0.795 | 83.37 | 81.60 |
| AuK-Flash | 2.85 | 0.790 | 78.80 | 82.40 |
| Qwen3-TTS / Qwen3-TTS-VD | 3.07 | 0.745 | 81.10 | 82.40 |
| Seed-TTS | 3.65 | 0.778 | 未报告 | 未报告 |
| VoxCPM2 | 3.65 | 0.767 | 未报告 | 未报告 |
| MOSS-VoiceGenerator | 未报告 | 未报告 | 80.00 | 82.00 |
编辑侧对手只有两个专门做编辑的开源模型。MMAE-Speech 的 IFR 是指令执行率,CR 是无关属性保持率,EMR 是两项全部达标的样本占比。后五列是 SpeechEditBench 各类编辑的成功率。
| 模型 | MMAE IFR | MMAE CR | MMAE EMR | 内容 | 情绪 | 韵律 | 副语言 | 声学 |
|---|---|---|---|---|---|---|---|---|
| AuK | 48.23 | 88.11 | 12.44 | 91.83 | 9.94 | 71.33 | 38.50 | 37.07 |
| AuK-Flash | 46.62 | 86.41 | 13.85 | 87.50 | 6.29 | 70.00 | 39.25 | 30.26 |
| Ming-UniAudio | 34.13 | 76.01 | 7.04 | 76.46 | 3.43 | 26.50 | 11.25 | 25.85 |
| Step-Audio-EditX | 43.52 | 77.27 | 4.69 | 16.50 | 7.71 | 20.13 | 31.25 | 22.89 |
生成这边赢得干净。平均识别错误率从 Qwen3-TTS 的 3.07 降到 2.65,中文难例子集 5.91 是所有对比系统里最低的。指令 TTS 中文 DSD 领先 Qwen3-TTS-VD 2.27 个百分点,英文却输给它和 MOSS-VoiceGenerator,Flash 版反而在英文上追平。
编辑这边领先幅度更大,内容编辑成功率从 Ming-UniAudio 的 76.46 拉到 91.83,韵律编辑从 26.50 拉到 71.33。可是看绝对值,情绪编辑 9.94 的成功率意味着十次改情绪九次不过关,全场没有一家过 10%。MMAE 的 EMR 也只有 12% 到 14%。
增强与分离报告自己定性为有竞争力。DNS Challenge 上 AuK 的 dWER 2.66 最低,DNSMOS 总分 3.35 却低于 AnyEnhance 的 3.41。Libri2Mix 上 AuK 的 WER 9.12 略好于专用模型 MossFormer2-SS 的 9.34,Flash 版 10.07 已经落后。
Flash 和完整版的分界很稳定,完整版识别错误率更低,Flash 版 UTMOS 感知质量分几乎处处更高。
本地跑一遍
我没有跑过这个模型,下面全部来自官方 GitHub README 和 ComfyUI 文档。代码 MIT 协议,权重分两版,另外要单独下 Qwen2.5-Omni-3B 当语义编码器。
bash
git clone https://github.com/Tencent-Hunyuan/AuK
cd AuK
conda create -n auk python=3.10 -y
conda activate auk
pip install -e .              # 只装核心推理和 CLI
# pip install -e ".[comfyui]"  # 加 ComfyUI 节点、Prompt Enhancer 和 ASR

pip install -U "huggingface_hub[cli]"
hf download tencent/AuK --local-dir ./ckpts/AuK
hf download tencent/AuK-Flash --local-dir ./ckpts/AuK-Flash
hf download Qwen/Qwen2.5-Omni-3B --local-dir ./ckpts/Qwen2.5-Omni-3B
所有任务共用一个命令行入口,指令必填,音频按任务可选。README 给的内容编辑示例如下。
bash
auk-infer \
    --audio assets/demo-input-audio/content-edit/content.wav \
    --instruction "Replace 'but accepting what we cannot have' with 'and living well with dreams unmet'." \
    --output out_content_edit.wav \
    --gen_seconds 7.0
换 Flash 版只需加 --ckpt ckpts/AuK-Flash/auk_flash.safetensors,它固定 4 步、CFG 为 0。--gen_seconds 是目标时长,流匹配模型要先定输出长度再采样,报告里由 Prompt Enhancer 按文本字节长度比估算。
显存方面 README 在一张 A800 上测过,bf16 推理峰值约 24.78 GiB ,加 --cpu_offload 降到 16.75 GiB。大头在 Qwen2.5-Omni-3B 和 VAE,这是 README 的测量,我没有复现。
自由指令想用满模型能力要开 Prompt Enhancer,它需要一个 OpenAI 兼容的 LLM 接口,README 默认指向腾讯云 TokenHub 的 hy3 模型,靠 LLM_API_KEY、LLM_BASE_URL、LLM_MODEL_NAME 三个环境变量配置。带音频的任务还要 ASR,默认回落到本地 SenseVoiceSmall。
ComfyUI 官方节点在仓库 comfyui/ComfyUI-AuK 目录,AuK Model Loader 负责加载,AuK Generate / Edit 负责生成和编辑。把目录软链到 custom_nodes,导出 AUK_HOME,打开 comfyui/workflows/auk.json 就有一个 3 秒纯文本示例。
切 Flash 要把 nfe_steps 设 4、cfg_strength 设 0、sway_sampling_coef 设负 1。文档特别提到源音频加生成目标合计不能超过 30 秒,节点不会自动切分。
几点看法
任务路由的蒸馏是全篇我最愿意抄的一条。多任务扩散模型做分布匹配蒸馏时,有些任务的失败输出在老师眼里反而像一段合理的音频,这种任务不能交给 DMD,直接用真值回归更稳。做统一音频或视频编辑模型加速的人,大概率还会碰到这个坑。
数据一节读完,我对 AuK 的定位是一台整合机。它的编辑能力几乎每项都靠另一个专用模型合成训练对,F5-TTS、IndexTTS2、CosyVoice2、OmniVoice 各管一段。好处是五类任务能压进一个 1.5B 主干,代价是上限被这些工具卡住。情绪编辑 9.94 的成功率,我猜和合成情绪对本身的质量脱不开关系。
Prompt Enhancer 是绕不开的隐性成本。报告在 7.4 节自己承认,模型对任意措辞的原生理解还不够,要碰到能力上限得靠外部 LLM 先识别任务、归一参数、把请求改写到训练分布附近。部署时多一次 LLM 调用,多一份 API 费用,任务识别错了后面全白搭。
最后,1.5B 这个数字别按小模型理解。加上 Qwen2.5-Omni-3B 和 VAE,显存接近 25 GiB,消费级 24 GB 卡要靠 cpu_offload 才够。想轻量部署,等社区量化版或 MLX 分支成熟再看。
参考链接
- 技术报告原文 arXiv 2609.08936 v1,2026 年 9 月
- 代码与 README Tencent-Hunyuan/AuK,含 ComfyUI 文档
- 模型权重 tencent/AuK、tencent/AuK-Flash
- 项目页,SGLang-Omni 部署手册
- 对比方案 Qwen3-TTS 技术报告、Ming-UniAudio、Step-Audio-EditX
- 编辑基准 MMAE、SpeechEditBench
- 蒸馏方法来源 Decoupled DMD、Z-Image、Flow-GRPO