文章目录
-
- 前言
- 一、它卡在架构的哪个位置
- [二、为什么非要拆成 Loop 和 Runner 两层](#二、为什么非要拆成 Loop 和 Runner 两层)
- [三、为什么这套对象是 per-agent 的](#三、为什么这套对象是 per-agent 的)
- 四、AgentLoop.process:一轮对话的完整编排
-
- [动作 1:开 trace + 触发 onTurnStart 钩子](#动作 1:开 trace + 触发 onTurnStart 钩子)
- [动作 2:组装 system prompt + 折叠历史里的"摘要"](#动作 2:组装 system prompt + 折叠历史里的"摘要")
- [动作 3:历史文件块的处理(省 token 的关键)](#动作 3:历史文件块的处理(省 token 的关键))
- [动作 4:调 Runner 流式跑 ReAct(+ 请求过大兜底)](#动作 4:调 Runner 流式跑 ReAct(+ 请求过大兜底))
- [动作 5:触发记忆压缩(L2 Consolidator)](#动作 5:触发记忆压缩(L2 Consolidator))
- [动作 6:记 trace + 日志 + 触发 onTurnEnd](#动作 6:记 trace + 日志 + 触发 onTurnEnd)
- [动作 7:返回 + 错误兜底](#动作 7:返回 + 错误兜底)
- [五、AgentRunner:真正的 ReAct 循环](#五、AgentRunner:真正的 ReAct 循环)
-
- [1. 准备工作](#1. 准备工作)
- [2. 循环主体(流式版)](#2. 循环主体(流式版))
- [3. 终止条件------循环什么时候结束](#3. 终止条件——循环什么时候结束)
- [4. 继续循环------把 assistant 回复追加进历史](#4. 继续循环——把 assistant 回复追加进历史)
- [5. 执行工具(并行)](#5. 执行工具(并行))
- [6. 超过最大迭代------兜底报错(流式/非流式分工)](#6. 超过最大迭代——兜底报错(流式/非流式分工))
- [六、GatewayCore -> Loop -> Runner 三层衔接](#六、GatewayCore -> Loop -> Runner 三层衔接)
-
- 三层各自的边界
- 历史的两次写入------谁写、写哪
- signal(AbortSignal)怎么穿透三层
- [跟 Mid-turn Queue 怎么配合(同一会话串行)](#跟 Mid-turn Queue 怎么配合(同一会话串行))
- 三层错误处理的分工
- 七、设计局限与演进记录
-
- [1. 提示层/执行层的文件访问不一致(已修复)](#1. 提示层/执行层的文件访问不一致(已修复))
- [2. Provider 只有 model 级 per-agent(已修复)](#2. Provider 只有 model 级 per-agent(已修复))
- [3. 主 AgentLoop 的 per-agent max_iterations 覆盖实际未生效(仍在)](#3. 主 AgentLoop 的 per-agent max_iterations 覆盖实际未生效(仍在))
- [4. getEntry 不校验 active 状态(仍在)](#4. getEntry 不校验 active 状态(仍在))
- [5. max_iterations 是粗粒度的死循环防护(仍在)](#5. max_iterations 是粗粒度的死循环防护(仍在))
- 小结
P.S. 推荐一个大神的教程给想要了解或者学习人工智能知识的读者,这个教程里内容讲解通俗易懂且风趣幽默,对我帮助很大。我想与大家分享这个宝藏教程,请点击下方链接查看, 传送门https://blog.csdn.net/qq_74013365
前言
先别急着往下翻,回答我一个问题:你给一个 Agent 发了一句"帮我查一下工单 1024",对面到底经历了什么?
如果你的答案是"调一次大模型然后返回",恭喜你,跟三年前的我一样天真。真这么简单,做 Agent 的人早集体转行送外卖了。
真相是:大模型是个只会背书、不会看路的选手。它没有实时时钟,没有业务系统权限,连自己五秒钟前说过什么都记不住。你指望它一次调用就给你正确答案?它连今天星期几都得靠你喂。
所以现实里的 Agent 都是这么干活的:思考 → 动手 → 看结果 → 再思考,直到得出答案。这个循环叫 ReAct,翻译成人话就是"想一下、干一下、看一下"。而把它包装成"一条消息进、一段回复出"的那层东西,就是今天的主角------AgentLoop。
下面进入正题。尽量别打瞌睡,我尽量讲得不那么像上课。
一、它卡在架构的哪个位置
先看一张图,别怕,这图不咬人:
scss
渠道消息 -> 消息总线进站队列 -> GatewayCore.dispatch
  ├─ 找 agent(按 agent_hint 或渠道绑定路由)
  ├─ 命令路由
  ├─ 拿会话 + 拿锁
  ├─ handleAgent ← Agent Loop 在这一层
  │   ├─ 用户消息进历史
  │   ├─ reply("处理中...")
  │   ├─ entry.loop.process(msg, history, signal, sink) ← Agent Loop
  │   ├─ 回复进历史
  │   └─ sink 推 done 事件(full_text)出站,不再 reply(回复)
  └─ finally: 释放锁 + 排空 Mid-turn Queue
GatewayCore 干的事其实就四件:找 agent、拿锁、把消息丢给 processor、最后把回复送出去。注意看中间那行------entry.loop.process(msg, history, signal, sink),这就是 Agent Loop 上班的地方。
有个细节值得单独夸一下:GatewayCore 手里没有任何一个全局 loop。它先通过 AgentRegistry 找到消息对应的 agent,再调用这个 agent 自己的 loop。GatewayCore 就是个包工头:活是谁的就丢给谁,至于你怎么干,那是你的事。
打个比方:你点了个外卖,平台只负责派单,做饭是商家的事。平台不会自己开火炒菜吧?GatewayCore 就是那个平台。
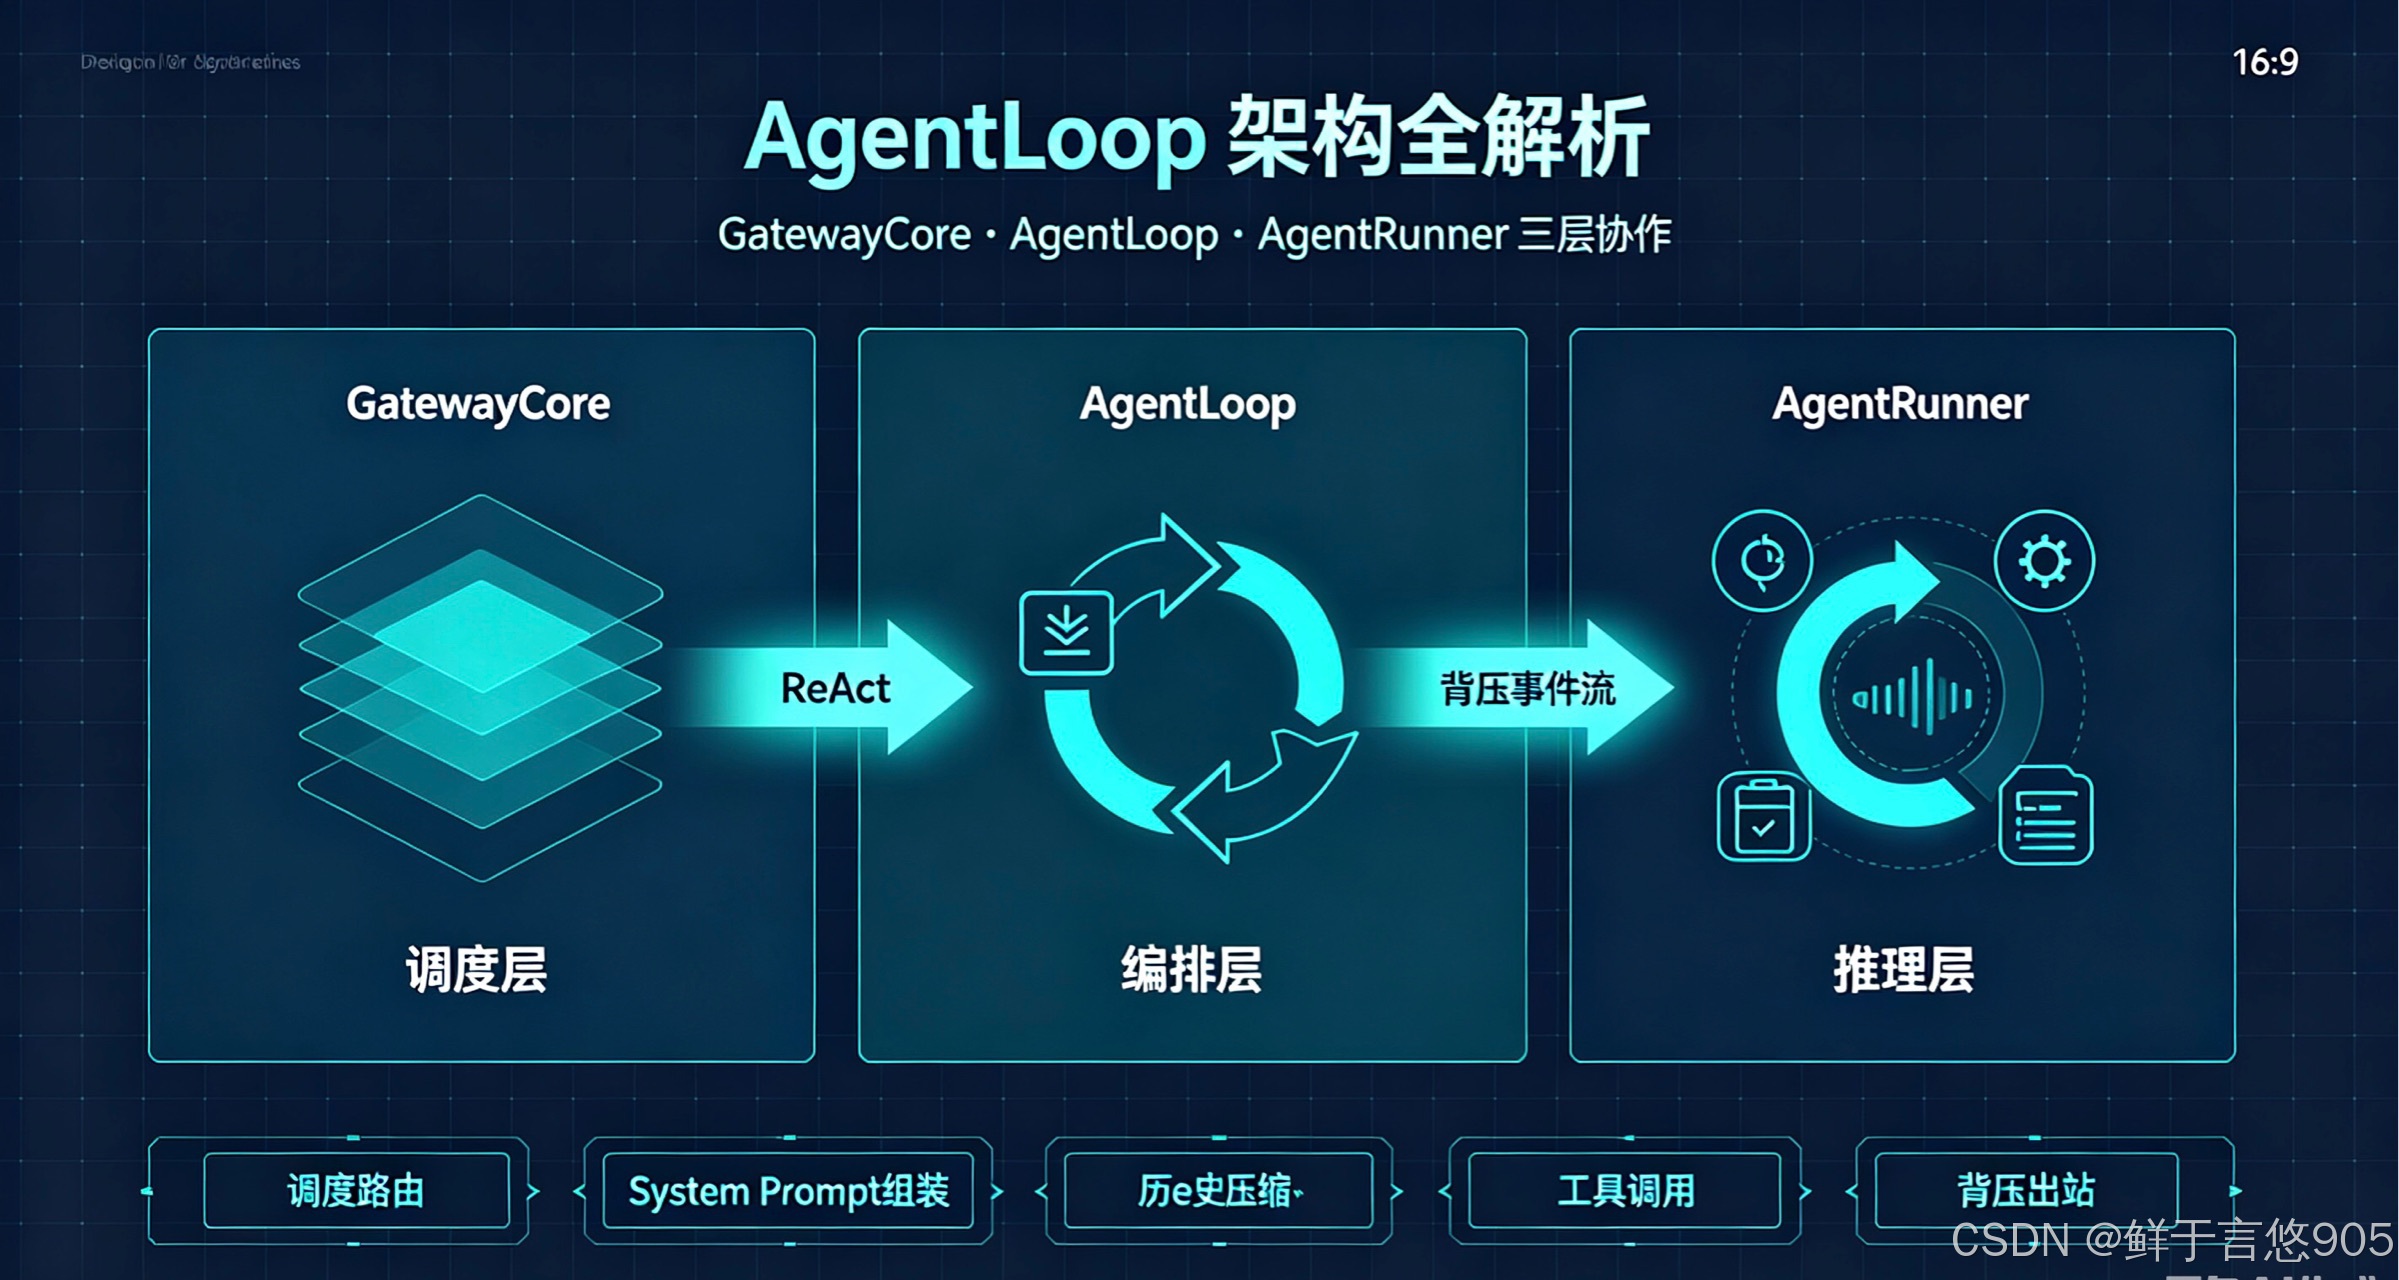
二、为什么非要拆成 Loop 和 Runner 两层
ReAct 循环本身很好写,一个 for 循环而已,让实习生来十分钟就能写完。
难的是循环外面那一圈东西:这一轮要不要先压缩历史?图片要不要转 base64?请求太大怎么办?模型挂了怎么跟用户交代?这些破事全塞进一个 for 循环里,那个本该精悍的循环会肿成一个三斤重的皮球。
所以项目把两层拆开:
| 层 | 职责 | 比喻 |
|---|---|---|
| AgentLoop(外层,编排层) | system prompt 组装、历史文件块省 token、请求过大兜底、记忆压缩、错误兜底 | 导演 |
| AgentRunner(内层,推理层) | 跑 ReAct:问 LLM、调工具、喂结果、直到它收手 | 演员 |
用户的每一条消息都是一场戏。Loop 是导演,决定这场戏怎么排------开演前要不要先剪一下历史?演完了要不要让助理整理一下记忆?Runner 是演员,在台上反复"思考-行动-观察",直到把戏演完。
有人可能会问:导演和演员为什么不能是同一个人?省一份工钱不好吗?
道理很简单:导演操心的是"这场戏怎么排",演员操心的是"这台词怎么念"。你把两件事混在一起,改个台词还得惊动导演,改个排期还得找演员。更要命的是测试------两层的逻辑混在一起,你都不知道 bug 是排戏排出来的还是念词念出来的。
哦对了,还有个实际好处:请求过大兜底是在 Loop 层"重新跑一遍整个 Runner"实现的。如果两层合体,这种"重跑"逻辑根本没法干净地写出来。就像你不能让一个人同时兼任导演、编剧、场务和灯光------会累死在台上。
三、为什么这套对象是 per-agent 的
AgentHub 以前是单 agent 时代:全局一个 AgentLoop 单例,一个 ContextBuilder,一个 Consolidator,大家排队用。就像公司只有一台饮水机,所有人都去那儿接水。
后来架构升级了:从一个全局 agent 变成多个可配置的 agent 并存。比如一个业务审核 agent、一个 default 通用 agent,各有各的人格、工具、模型、记忆。
这就直接改变了 Loop 的持有方式。
旧设计(单 agent 时代):全局一个 AgentLoop 单例,一个 ContextBuilder,一个 Consolidator,大家共享。
新设计(多 agent 时代):AgentRegistry 管理所有 agent,每个 agent 加载成一个 AgentEntry,里面是该 agent 专属的一整套运行时对象:
typescript
export interface AgentEntry {
  definition: AgentDefinition;    // agent.json 配置
  state: AgentState;              // draft / active / archived
  loop: AgentLoop;                // 该 agent 自己的 AgentLoop(不再全局单例)
  toolRegistry: ToolRegistry;     // 该 agent 自己的工具集
  contextBuilder: ContextBuilder; // 该 agent 自己的 system prompt 组装器
  consolidator: Consolidator;     // 该 agent 自己的 L2 记忆压缩器
  ctx: AgentContext;              // 该 agent 自己的运行环境(路径/护栏覆盖)
  provider: BaseProvider;         // 该 agent 自己的 LLM Provider(model/provider 槽位均可 per-agent)
  providerName: string;           // 该 agent 选中的 provider 槽位名
  subagents: Map<string, SubagentDefinition>;
  sessionRuntimes: Map<string, Map<string, SubagentDefinition>>;
}
这套对象在 AgentRegistry.loadOne(name) 里逐个构建:
csharp
loadOne(name: string): void {
  const def = this.store.loadDefinition(name);
  const ctx = createAgentContext(name, projectDir, def.file_access, def.shell, def.email);
  const toolRegistry = this.buildToolRegistry(def); // 按 def.tools 白名单过滤
  const provider = resolveModel(def.model, def.provider); // model + provider 槽位均可 per-agent
  const contextBuilder = new ContextBuilder(
    join(projectDir, "agents", name), name, def.skills, ctx,
  );
  const consolidator = new Consolidator( // 阈值可 per-agent 覆盖
    provider,
    def.memory?.consolidate_at_tokens ?? getConfig().memory.consolidate_at_tokens,
  );
  const loop = new AgentLoop(provider, toolRegistry, contextBuilder, consolidator, {}, ctx);
  // ...存进 this.agents
}
为什么这样设计,而不是共享一个 loop、靠参数区分 agent?
因为 agent 之间的差异是深 的,不是浅 的:不同 agent 有不同的 SOUL(人格)、不同的工具白名单、不同的 skill、可能不同的模型、不同的记忆压缩阈值、不同的文件访问护栏。这些差异如果全靠调用时传参,Loop/Runner/ContextBuilder 的每个方法签名都得塞一堆 agent 相关参数,内部到处是 if (agent === "张三") 这种分支------你写的时候是爽了,三个月后回来看代码的你会想抽写代码的你。
把差异固化进"每个 agent 一套预构建好的对象",调用方只需 entry.loop.process(...),对象内部完全不用感知"我是哪个 agent"。配置的复杂度在加载期一次性消化掉,运行期是干净的。
打个比方:这就像每个员工入职时办好自己的工牌、门禁、电脑,上班直接刷卡进门。而不是每天早上在公司门口现问你"哪个部门的、能进哪层楼、能开哪扇门"。
需要澄清一个共享边界:工具的来源池是共享的 。builtinTools / mcpTools 全局只构建一次,每个 agent 的 ToolRegistry 只是从这个共享池里按 def.tools 白名单过滤挂载。per-agent 的是"这个 agent 能用哪些工具"这份视图,不是工具实现本身。
Provider 也 per-agent 化了,方式是槽位制 :全局配置 llm.providers.<name> 定义多个 provider 槽位,agent.json 用 provider 字段选槽位、model 字段覆盖槽位默认模型。配错直接抛错、不隐式降级------旧版的静默 fallback 会拿错 key/模型,坑死人不偿命。
四、AgentLoop.process:一轮对话的完整编排
AgentLoop.process 就是 GatewayCore 调的那个 processor。它做的是"一轮对话的完整编排",不是 ReAct 循环本身(ReAct 在 Runner 里)。拆成 7 个动作:
动作 1:开 trace + 触发 onTurnStart 钩子
每轮生成一个唯一 trace id 绑 session_key,Tracer 后面每步都 record,最终拼成完整调用链。onTurnStart 挂了逻辑就跑,没挂就跳过(?. 可选链)。
翻译:先给这场戏立个档案,然后再开演。档案都没有,回头复盘你连这场戏演没演过都不知道。
动作 2:组装 system prompt + 折叠历史里的"摘要"
ini
const system = this.contextBuilder.buildSystem(msg.channel);
const allHistory = history.load(msg.session_key);
const summaries = allHistory.filter(m => m.role === "system").map(...).join("\n\n");
const effectiveSystem = summaries ? `${system}\n\n---\n\n${summaries}` : system;
const nonSystemHistory = allHistory.filter(m => m.role !== "system");
两个关键点:
(a) system prompt 由该 agent 自己的 contextBuilder 组装。 产出按顺序拼装:SOUL.local.md(或 SOUL.md,从该 agent 目录读)→ 当前时间块 → 已启用 skill 的索引 → 用户授权的工作目录 → platform-policy/<channel>.md。
这里有三处 per-agent 化:SOUL 从 agent 自己的目录读,不同 agent 人格不同;platform-policy 也 per-agent 化,不同 agent 在同一渠道可以有不同安全指令;skill 索引按 enabledSkills 清单查找,顺序是"agent 专属优先 > 全局"------同一个 skill 名,某个 agent 可以有自己定制的版本覆盖全局版本。
当前时间块值得单独说一句:buildSystem 在 soul 之后注入一段"## 当前时间"(zh-CN 时间 + 时区 + 星期)。
为什么?因为 LLM 没有实时时钟。用户说"五分钟后提醒我",模型要是靠训练数据猜时间,会猜成不知道哪年的星期二------到时候提醒你的是上个世纪的闹钟。这个机制很小,但极其实用,属于"花五分钟救一整天"的典型。
(b) 历史里 role === "system" 的消息是 Consolidator 的摘要,要折叠进 system prompt。 为什么?Anthropic Messages API 不接受 system 作为消息 role(只认 user/assistant),但 Consolidator 压缩历史时会把摘要写成 role: "system" 存进 JSONL。所以这里把所有 system 摘要拼成一坨追加到 system prompt 末尾,再从消息列表滤掉。摘要不是普通历史消息,是系统上下文的一部分。
动作 3:历史文件块的处理(省 token 的关键)
ini
const lastUserIdx = nonSystemHistory.map(m => m.role).lastIndexOf("user");
const messages = nonSystemHistory.map((m, idx) => ({
  role: m.role,
  content: Array.isArray(m.content)
    ? (idx === lastUserIdx ? resolveStoredBlocks(m.content) : compactStoredBlocks(m.content))
    : m.content,
}));
用户发的图片/PDF 在历史里存的是文件路径,不是 base64。处理规则:
- 只有最后一条 user 消息:resolveStoredBlocks------把文件路径解析成 base64 真正喂给模型(这一轮模型要看这个文件);
- 历史里所有旧消息 :compactStoredBlocks------文件路径转成文本占位(图片用
[图片: xxx.png],PDF/文档用[文件: xxx.pdf])。
为什么这么设计?重发历史里的图片 base64 会浪费大量 token,还可能撞请求大小上限。模型当初已看过图、结论也在历史里,后面只需知道"这里曾有一张图"即可。
打个比方:你上个月给领导交过身份证复印件,这个月再交一次,领导只会觉得你脑子有病。文件也一样------看过一次就够了,别每次都把整个 PDF 再喂一遍。
顺带一提,resolveStoredBlocks 读文件失败时不会让整轮崩溃,而是降级成 [图片无法加载: ...] 文本占位继续跑。注意,是继续跑,不是原地躺平。这份"出错了也要把戏演完"的精神,值得所有程序员学习。
动作 4:调 Runner 流式跑 ReAct(+ 请求过大兜底)
javascript
for await (const ev of this.runner.runStream(effectiveSystem, messages, signal, msg.session_key)) {
  const done = await this.forwardRunnerEvent(ev, sink, t => { assistantText += t; }, () => assistantText);
  if (done) {
    totalInputTokens += done.input_tokens;
    totalOutputTokens += done.output_tokens;
  }
}
ReAct 循环真正发生在 this.runner.runStream(...)。Loop 用 forwardRunnerEvent 把每个 Runner 事件转成 OutboundEvent 并 await sink(ev) 推给 GatewayCore------这个 await 是有意为之的背压:sink 推得多慢,循环就消费得多慢,不会在内存里缓冲事件。
注意 runStream 还传了 msg.session_key,一路透传到工具执行,让工具能感知自己属于哪个会话。非流式的 runner.run 仍保留,但只有子 agent 路径在用。
这里有个兜底,且流式/非流式行为不同 :如果跑的时候报"请求过大"(413)------无 sink(非流式调用方)时保留原语义,Loop 用 stripFileBlocks 把所有消息里的图片/PDF 块全替换成 [图片已移除]/[PDF 文档已移除] 文本再重跑一次;有 sink(流式)时不重试------已推出去的 token 无法撤回,重跑会让 SSE 客户端看到重复 token,所以直接抛出,由外层 catch 推 error 事件。
用大白话说:非流式就像话说到一半发现稿子太长,赶紧把图片全删了重说一遍;流式就像直播说错话------话已经出去了,撤回只会让观众看到你卡壳,不如直接承认错误继续播。
动作 5:触发记忆压缩(L2 Consolidator)
kotlin
if (this.consolidator?.shouldConsolidate(totalInputTokens)) {
  await this.consolidator.consolidate(msg.session_key, history);
}
Runner 流式跑完,Loop 把各 done 事件携带的 token 累加成 totalInputTokens,超过阈值就触发 Consolidator:保留最近若干条,其余让 LLM 摘要,重写 JSONL。
关键 per-agent 点:这个 consolidator 是该 agent 自己的实例,阈值可以 per-agent 覆盖(def.memory?.consolidate_at_tokens ?? 全局默认 80000)。
这一步在 process 内部同步 await,因为压缩完历史才能给下一轮用。你总不能让下一轮对话拿着昨晚的聊天记录当上下文吧?那跟拿着上个月的天气预报决定今天穿什么有什么区别。
动作 6:记 trace + 日志 + 触发 onTurnEnd
记完成 trace、打日志(含 token 消耗、耗时、回复前 500 字)。onTurnEnd 传的是"历史快照 + 手动补上这条 assistant 回复"------因为此时 GatewayCore 还没把回复 append 进历史,所以手动 push 一份给钩子用。
这个细节有点绕,翻译一下:演出结束了,导演要写总结,但记录员还没把今天的台词归档。怎么办?导演先自己抄一份递给写总结的人。虽然麻烦,但总比总结里缺了今天这场戏强。
动作 7:返回 + 错误兜底
javascript
return assistantText;
} catch (err) {
  await this.hooks.onError?.(err);
  if (signal.aborted) {
    await sink?.({ type: "error", message: "已停止", partial_text: assistantText });
    return "已停止";
  }
  logger.error("agent turn failed", ...);
  // 配置类错误对用户可操作,原样或翻译后透出;其余保持通用文案防内部细节泄漏
  const errText = err instanceof Error ? err.message : String(err);
  let userFacing = "处理时发生错误,请稍后重试";
  if (errText.startsWith("LLM API Key 未配置")) userFacing = errText;
  else if (/\b401\b|\b403\b|无效的授权|authentication/i.test(errText)) {
    userFacing = "LLM 认证失败(key 无效或过期):请在配置页检查 API Key 后重试";
  }
  await sink?.({ type: "error", message: userFacing, partial_text: assistantText });
  return userFacing;
}
正常返回 assistantText(流式累加出的最终回复文本)。错误兜底分三档:
- 用户主动 /stop(signal.aborted)返回"已停止";
- 配置类错误透出:API Key 缺失/认证失败这类错误用户自己能修,原样或翻译后透出,不让用户面对一句无法行动的通用报错;
- 其余错误统一返回"处理时发生错误,请稍后重试",防内部细节泄漏。
所有错误路径都会先 await sink 推一个 error 事件(带上已产出的 partial_text)再 return------SSE 流必须收到终止事件,客户端才知道流结束了,还能看到已生成的半截内容。
注意错误也返回字符串,不抛。 因为 GatewayCore 是 const response = await this.processor(...),如果抛异常,虽然 finally 能释放锁,但"用户消息进历史了却没对应的 assistant 回复"会让历史不一致。所以 Loop 把错误吃掉返回兜底文案,保证历史总是 user/assistant 成对。
翻译成大白话:哪怕你演砸了,也得先把这出戏的账记平。抛异常就像演员当场撂挑子走人------剧务账本上记了"此人上台",却没人记"此人下场",这账就永远对不上了。
整张图看 process 的 7 个动作:
scss
GatewayCore 调 entry.loop.process(msg, history, signal, sink)
  │
  ▼
① 开 trace + onTurnStart 钩子
  │
  ▼
② contextBuilder.buildSystem(channel) ← 该 agent 的 SOUL + 当前时间 + 已启用 skill 索引 + 渠道 policy
   + 把历史里的 system 摘要折叠进 system prompt
   + 滤掉 system 角色消息
  │
  ▼
③ 处理历史文件块:
   最后一条 user -> 文件解析成 base64(模型这轮要看)
   旧消息 -> 文件路径转文本占位(省 token)
  │
  ▼
④ for await runner.runStream(...) 流式跑 ReAct,事件逐个 await sink 推出 ← ★ 真正的推理在这里
   (请求过大兜底:非流式全去文件块重跑;流式不重试,直接抛给外层 catch 推 error 事件)
  │
  ▼
⑤ 累加的 totalInputTokens 超阈值? -> 该 agent 的 Consolidator 压缩历史(L2)
  │
  ▼
⑥ 记 trace + 日志 + onTurnEnd 钩子
  │
  ▼
⑦ 返回 assistantText(流式累加的回复)
   (异常:先 await sink 推 error 事件带 partial_text,再按错误分档返回兜底文案,不抛)
五、AgentRunner:真正的 ReAct 循环
Loop 把活交给 Runner,Runner 才是反复"思考-行动-观察"的地方。
1. 准备工作
ini
const tools = this.toolRegistry.definitions(); // 该 agent 的工具 schema 给 LLM
const history: LLMMessage[] = [...messages];   // 复制一份历史,循环里往里追加
let totalInputTokens = 0;
let totalOutputTokens = 0;
tools 从该 agent 自己的 ToolRegistry 拿(已按白名单过滤),history 复制一份,后面每轮的 assistant 回复、tool_result 都往这个数组追加------这就是 ReAct 循环的"记忆累积"。
注意:这是复制,不是引用。你要是直接拿原数组往里面塞东西,回头历史被改得面目全非,你都不知道该怪谁。
2. 循环主体(流式版)
ini
for (let i = 0; i < this.maxIterations; i++) { // Runner 的 maxIterations,默认 30(回退全局 config.llm.max_iterations)
  let response: LLMResponse | null = null;
  for await (const ev of this.provider.streamComplete(system, history, tools, signal)) {
    if (ev.type === "text_delta") yield { type: "text", text: ev.text }; // 逐 token 往外推
    else if (ev.type === "tool_use_start") yield { type: "tool_call", id: ev.id, name: ev.name };
    else if (ev.type === "message_complete") response = ev.response;     // 本轮完整响应
  }
  if (!response) break;
  totalInputTokens += response.input_tokens;
  totalOutputTokens += response.output_tokens;
  ...
}
provider 接口是双方法:主路径用 streamComplete(...)(AsyncGenerator,逐条产出 text_delta/tool_use_start/tool_input_delta/message_complete 四种 StreamEvent),非流式的 complete(...) 保留给子 agent 路径用。
Runner 把 provider 的细粒度事件边转发(yield)边攒,收到 message_complete 就拿到和非流式等价的完整 LLMResponse------从这往后的判断逻辑(stop_reason、组装 assistant 消息、并行工具)与非流式 run 完全一致。
关键:每一轮都把完整的累积 history 发过去。 LLM 是无状态的,它不记得上一轮说了啥,全靠我们把历史原样回放。所以 history 数组越来越长,token 越烧越多------这就是为什么 Loop 外面要有 Consolidator 压缩历史。
这个设定怎么说呢?就像你有个同事,记忆力只有三秒。你每次都得把从上班第一天到现在的所有事情重新讲一遍,他才能接着干。你说这 token 能不烧吗?
3. 终止条件------循环什么时候结束
lua
if (response.stop_reason !== "tool_use" || response.tool_calls.length === 0) {
  yield { type: "done", input_tokens: totalInputTokens, output_tokens: totalOutputTokens };
  return;
}
这是 ReAct 循环的唯一正常出口:LLM 这轮返回的 stop_reason 不是 tool_use(或没有 tool_calls),说明它不想再调工具,直接输出最终文本------循环结束,yield 一个 done 事件后返回。
stop_reason 两种典型值:"tool_use"(想调工具,继续循环)、其他如 "end_turn"(答完了,返回结束)。
这就是 ReAct 的核心机制:LLM 自己决定"继续调工具"还是"输出最终答案",我们只是执行器。它要工具就执行,不要了就结束。
翻译:服务员问你"还要加点什么吗",你说"不用了",人家就给你结账了。你要是每次都回答"再来一份",这顿饭能吃到打烊。
4. 继续循环------把 assistant 回复追加进历史
php
const assistantContent: Array<TextBlock | ToolUseBlock> = [];
if (response.content) {
  assistantContent.push({ type: "text", text: response.content }); // LLM 的思考文本
}
for (const call of response.tool_calls) {
  assistantContent.push({ type: "tool_use", id: call.id, name: call.name, input: call.input });
}
history.push({ role: "assistant", content: assistantContent });
LLM 一轮输出可能含两部分:text(思考过程,可选)+ tool_use(要调的工具 + 参数,可能多个)。组装成一条 assistant 消息 push 进 history。
这条消息同时含 text 和 tool_use 块------Anthropic API 要求 assistant 消息把思考和工具调用放一起,不能拆。
这个约束有点强迫症:你说话的时候不能先说"我要查一下",然后把"查"这个动作单独发一条消息。必须放在一起,像写作文一样"我想了想,然后去做了"。API 爸爸说了算,别问为什么。
5. 执行工具(并行)
javascript
const results = await Promise.all(
  response.tool_calls.map(async call => {
    const result = await this.toolRegistry.execute(call.name, call.input, signal, this.ctx, sessionKey);
    return {
      type: "tool_result" as const,
      tool_use_id: call.id,  // ★ 靠 id 关联回对应的 tool_use
      content: result.content,
      is_error: result.is_error,
    };
  }),
);
history.push({ role: "user", content: results });
两个要点:
(a) 并行执行。 Promise.all------如果 LLM 一次性要调 3 个工具(比如同时查 3 张工单),这三个并发跑,不串行等。
(b) tool_result 用 role: "user" 追加,靠 tool_use_id 关联回上一条 assistant 消息里的 tool_use 块------LLM 靠 id 知道"这个结果对应我刚才哪个工具调用"。
这里还有一处 per-agent 化的细节:toolRegistry.execute 传了 this.ctx(该 agent 的运行环境:路径、护栏覆盖)和 sessionKey。工具执行时的文件访问权限、cwd 校验等,走的是这个 agent 自己的护栏配置(缺省 fallback 全局),不是全局一刀切。
流式版还多一步:工具结果 push 进 history 之前,先逐个 yield tool_result 事件出去------sink 那头的渠道能实时看到"正在调用 X / X 执行完了"的进度。
6. 超过最大迭代------兜底报错(流式/非流式分工)
javascript
// 非流式 run():抛错
throw new Error(`agent exceeded max_iterations (${this.maxIterations})`);
// 流式 runStream():不抛,yield error 事件
yield { type: "error", message: `agent exceeded max_iterations (${this.maxIterations})`, ... };
循环跑满 max_iterations(默认 30)LLM 还在调工具不收尾,直接兜底,防止 LLM 陷入死循环耗尽资源。
两种模式分工不同:非流式 run() 抛 Error,被 Loop 的 catch 兜住;流式 runStream 不抛,而是 yield 一个 error 事件,随后循环正常收尾、已累积的部分文本作为回复返回------流式场景下抛异常会让已推出去的 token 和最终状态对不上。
打个比方:非流式是线下演出,演砸了直接叫停,观众也没看到啥;流式是直播,你只能一边说"刚才那段不算"一边硬着头皮播完。
ReAct 单轮流程图:
scss
进入第 i 轮循环
  │
  ▼
provider.streamComplete(system, history, tools) ← 把累积历史全发给 LLM(流式,逐 token 产出)
  │
  ▼
stop_reason 是 tool_use 且有 tool_calls?
  ├─ 否 ──▶ 返回最终回复 + 累积 token ★ 正常出口
  └─ 是
      │
      ▼
      组装 assistant 消息(text 思考 + tool_use 调用)push 进 history
      │
      ▼
      Promise.all 并行执行所有 tool_calls(带 agent 的 ctx + session_key)
      │
      ▼
      把 tool_result(带 tool_use_id 关联)作为 user 消息 push 进 history
      │
      ▼
      进入第 i+1 轮循环(LLM 拿着工具结果再思考)
用一个例子串一遍------用户问"查一下工单 1024 的处理状态":
ini
第 0 轮:
  history = [user: "查一下工单 1024 的处理状态"]
  LLM 返回: text="好的,我来查" + tool_use: query_ticket({id: 1024})
  stop_reason = tool_use -> 继续
  history 追加: assistant[text + tool_use]
  执行 query_ticket -> 返回 {status: "已办结", handler: "客服A"}
  history 追加: user[tool_result]
第 1 轮:
  history = [user, assistant(text+tool_use), user(tool_result)]
  LLM 返回: text="工单 1024 已由客服 A 办结"(没有 tool_use)
  stop_reason = end_turn -> 返回 ★
两轮就结束。如果 LLM 觉得信息不够,可能第 1 轮还要再调工具(比如查流转记录),那就进第 2 轮,直到它不再要工具为止。
六、GatewayCore -> Loop -> Runner 三层衔接
三层各自的边界
| 层 | 管什么 | 不管什么 |
|---|---|---|
| GatewayCore(调度层) | 找 agent、路由、锁、队列、模型覆盖、流式出站 | 怎么推理、怎么调 LLM |
| AgentLoop(编排层) | system prompt 组装、历史文件块省 token、请求过大兜底、记忆压缩、事件流转、错误兜底 | ReAct 循环本身 |
| AgentRunner(推理层) | ReAct 循环、调 LLM、执行工具、累积 token | 历史怎么来、要不要压缩 |
一句话:GatewayCore 找到对应 agent 并准备消息和历史,该 agent 的 Loop 打磨历史再决定要不要压缩,该 agent 的 Runner 反复问 LLM 调工具直到出答案。
历史的两次写入------谁写、写哪
| 时机 | 谁写 | 写什么 | 落哪 |
|---|---|---|---|
| process 调用前 | GatewayCore | user 消息 | JSONL(持久化) |
| process 内部 | Loop/Runner | assistant 思考、tool_use、tool_result | 只在内存数组 history 里,不落 JSONL |
| process 返回后 | GatewayCore | assistant 最终回复 | JSONL(持久化) |
ReAct 循环过程中的中间步骤(思考、工具调用、工具结果)不进 JSONL 持久化,只存在于 Runner 那次 runStream() 的内存 history 数组里,跑完就丢。JSONL 里只存最终两条:user 消息 + assistant 最终回复。
为什么这么设计:① 持久化的是"对话",不是"推理过程"------用户关心问什么答什么,中间调了啥工具是实现细节;② 省存储------一次推理可能调十几次工具,全存下来 JSONL 膨胀很快;③ 下次恢复不用回放工具结果------工具结果是当时快照,存下来下次也没意义。
翻译:你在跟客户聊天时中间查了十次百度,客户只关心你最后说了啥,不关心你点了哪些链接。记录也一样,记结果不记过程,省钱省心。
另外,GatewayCore 写 user 消息前会加三行元信息前缀 channel: xxx/user_id: xxx/chat_id: xxx 再进历史------让 LLM 知道"这句话是谁、在哪个渠道、哪个会话里说的",群聊多用户场景下尤其重要。
signal(AbortSignal)怎么穿透三层
/stop 命令要能取消正在进行的 LLM 调用,靠 signal 一路传:
scss
GatewayCore:const ac = new AbortController(); 存进 abortControllers map
            processor(msg, history, ac.signal, sink) ← 传 signal + sink
  │
  ▼
Loop.process(msg, history, signal, sink)
  └─ runner.runStream(system, messages, signal, session_key) ← 透传
       └─ provider.streamComplete(system, history, tools, signal) ← 透传给 LLM
用户发 /stop(priority 命令,绕过锁)时,GatewayCore 调 ac.abort()。signal 一路传到 provider.streamComplete,LLM 调用被中断抛 AbortError。这个错误从 provider 抛出 → Runner 的 for 循环没 catch 继续往上抛 → 到 Loop 的 try/catch 被兜住 → Loop 检查 signal.aborted,先 await sink 推一个带 partial_text 的 error 事件,再 return "已停止"。
所以 /stop 之后用户看到"已停止",而不是错误;SSE 客户端也能正常收到流的终止事件。
跟 Mid-turn Queue 怎么配合(同一会话串行)
css
用户连发 A、B、C 三条消息(同一会话)
A 拿到锁 ──▶ GatewayCore.handleAgent(A)
              └─ entry.loop.process(A)
                   └─ Runner 跑 ReAct(可能要好几十秒,调好几次 LLM)
这期间 B、C 进来 ◀─────── 发现会话有锁,进 Mid-turn Queue 暂存
A 跑完,Loop 返回回复
GatewayCore:回复进历史 + finally 释放锁 + 排空 Mid-turn Queue
  │
  ▼
B、C 被取出,各自递归 dispatch,重新拿锁跑 Loop/Runner
锁保证同一会话的 Runner 不会有两个实例同时跑。如果没这个锁,B、C 会各自起一个 Runner,三个 Runner 共享同一份 JSONL 历史并发读写------历史会乱、回复会串、token 三倍烧。
锁是 per-session 的,session_key 是 agent:channel:chat_id 格式(比如 reviewer:wecom:zhangsan)。所以不同 agent 服务同一个用户时,天然是不同的 session_key、不同的锁、不同的历史------一个 agent 在跑几十秒的 ReAct,不会挡住另一个 agent 响应同一个用户。串行约束只在"同一 agent + 同一会话"内成立。
翻译:银行柜台每个窗口都有队,A 窗口办事慢不会影响 B 窗口,但同一个窗口你不能让两个人同时办。
三层错误处理的分工
| 层 | 错误来源 | 怎么处理 |
|---|---|---|
| Runner | 超过 max_iterations | 分流式:非流式 run() 抛错往上抛;流式 runStream 不抛,yield error 事件由 Loop 转发 sink |
| Runner | 工具执行失败 | 不抛------tool_result 带 is_error: true 返给 LLM,让 LLM 决定怎么办 |
| Loop | 请求过大(413) | 非流式兜底:去文件块重跑一次;流式不重试,直接抛给外层 catch |
| Loop | signal.aborted | 先 sink 推 error 事件(带 partial_text),再返回"已停止" |
| Loop | 配置类错误 | 透出可操作的提示(如"请检查 API Key") |
| Loop | 其他所有错误 | 先 sink 推 error 事件,再返回"处理时发生错误,请稍后重试",不抛 |
| GatewayCore | Loop 返回的兜底文案 | 当普通回复处理:进历史 |
特别看 Runner 对工具错误的处理 :工具挂了不抛异常,而是把错误包成 tool_result 的 is_error: true 喂回给 LLM。这是 ReAct 的精髓------LLM 拿到"工具失败了"这个观察,自己决定下一步(换参数重试、换别的工具、或直接告诉用户"查询失败")。
这比直接抛异常中断循环优雅得多,让 LLM 有自我修复的机会。翻译成职场话术:下属办砸了事,不是当场开除,而是把问题反馈给他,让他自己想想怎么补救。这才是管理的艺术。
七、设计局限与演进记录
如实记录几处已知不彻底的地方------前两处后来已修复,正好当作演进素材;后两处还留着。
1. 提示层/执行层的文件访问不一致(已修复)
原来 ContextBuilder.buildSystem 读 system_allowed_paths 用的是全局 getConfig().guardrails,造成"提示层用全局、执行层用 per-agent"的不一致------LLM 可能被提示去访问一个执行层其实不允许的目录,或反之。修复方式:ContextBuilder 构造函数收第 4 参 ctx,buildSystem 改用 getEffectiveFileAccessLevel(this.ctx) / getEffectiveSystemAllowedPaths(this.ctx),提示层和执行层同源,都吃 per-agent 的有效配置。改动小、收益明确,属于"正确性问题优先修"的典型。
2. Provider 只有 model 级 per-agent(已修复)
原来 agent 能选模型,但 api_key/base_url 是全局的------多个 agent 接不了不同供应商账号。后来 LLM 配置重构为多 provider 槽位:全局 llm.providers. 各带 api_key/base_url/model/api 协议,agent.json 用 provider 字段选槽位,resolveModel(def.model, def.provider) 解析,配错抛错不隐式降级。
3. 主 AgentLoop 的 per-agent max_iterations 覆盖实际未生效(仍在)
AgentDefinition.max_iterations 字段在设计上是 per-agent 可覆盖的,registry.ts 装配时也算出了 maxIterations = def.max_iterations ?? 全局,但主 AgentLoop 的构造函数不接受 maxIterations 参数 ,内部 new AgentRunner(provider, toolRegistry, undefined, ctx) 第三参传的是 undefined------所以主 loop 路径的 per-agent 覆盖实际未生效,Runner 回退到全局 config.llm.max_iterations。registry.ts 里算出的那个变量是 dead code。
真正用上 per-agent max_iterations 的是子 agent 路径:子 agent 编译时把 subDef.max_iterations 传给了 new AgentRunner。所以"max_iterations 可 per-agent 覆盖"这个说法,严格讲目前只对子 agent 成立,主 loop 是全局值。
这是装配链路里"设计有、实际没有"的典型------字段加了、配置算了、参数断了,三处只要有一处断链,功能就没通。这就像你装修时设计了全屋智能,插座也装了,网线也埋了,最后发现电工把总闸忘接了。
4. getEntry 不校验 active 状态(仍在)
AgentLoop 处理的消息如果带 agent_hint,dispatch 会走 registry.getEntry(hint) 直接取该 agent,这条路径不校验 active------draft/archived 的非活跃 agent 也能被命中。而 routeAgent 路径只在 active agent 里选。两条路径对"能不能访问未发布 agent"的语义不一致,知道 draft agent 名字的人能通过 hint 直接调用它绕过发布流程。
5. max_iterations 是粗粒度的死循环防护(仍在)
它只能防"跑满 30 轮",但如果 LLM 在第 5 轮就陷入"调同一个工具、拿同样的错、再调"的短循环,现在没有检测重复调用的机制,会白白烧到第 30 轮才兜底报错。改进思路:在 Runner 里记录最近几轮的工具调用签名(name + input 的 hash),如果连续 N 轮调用完全相同且都 is_error,提前终止并给 LLM 一个明确的"你在重复,请换个思路或告诉用户失败"的信号------能省 token、加快失败反馈。
小结
GatewayCore 找到消息对应的 agent、准备好消息和历史,交给该 agent 自己的 Loop;Loop 把历史打磨好(system prompt 组装 + 文件块省 token)交给该 agent 自己的 Runner,Runner 以 runStream 流式地反复问 LLM 调工具直到 LLM 不再要工具,text/tool_call/done 事件逐条 await sink 推出站(背压),回复同时落历史;中间 ReAct 的工具调用全在内存、只有最终对话落 JSONL;同一 agent 同一会话靠锁保证 Runner 串行,工具失败不抛而喂回 LLM 让它自我修复。这套 Loop/Runner/ContextBuilder/Consolidator 不是全局单例,而是每个 agent 在加载期各构建一套------把配置复杂度在加载期消化,运行期保持干净。
最后说句掏心窝子的:很多人觉得 Agent 是魔法,其实它就是"想一下、干一下、看一下"的循环,外加一堆被设计逼出来的兜底。真正难的不是那个 for 循环,而是循环外面那一圈"万一呢"。
P.S. 推荐一个大神的教程给想要了解或者学习人工智能知识的读者,这个教程里内容讲解通俗易懂且风趣幽默,对我帮助很大。我想与大家分享这个宝藏教程,请点击下方链接查看,传送门https://blog.csdn.net/qq_74013365(https://blog.csdn.net/qq_74013365/article/details/16316624