作者:来自 Elastic Yannis Roussos
Elasticsearch 自 2013 年以来一直以列的形式存储数据,但要增加完整的列式数据库能力,则需要一种全新的模式。
想获得 Elastic 认证?了解下一期 Elasticsearch Engineer 培训什么时候开始!你现在就可以开始免费云试用,或者在你的本地机器上试用 Elastic。
当我们写道 Elasticsearch 正在成为一个列式数据库时,我们收到的最犀利的回应是,它本来就是一个列式数据库。就事实而言,这个说法是正确的。Elasticsearch 从 Lucene 继承而来的、按字段存储的列式存储 doc values 于 2013 年加入,而自 Elasticsearch 2.0 将其设为默认存储方式以来,Elasticsearch Query Language(ES|QL)中的几乎所有聚合、排序和查询都一直在读取它们。每个字段的值都存放在磁盘上各自独立的文件中。因此,有趣的问题并不是我们是否存储列,而是一个列式数据库还需要什么,而答案最终归结为五件事。
Doc values 的设计目标是在文档引擎上实现聚合、排序和分组,而且它很好地完成了这项工作。Columnar 模式改变了这些列的用途,而本文将介绍区分 "存储列" 和 "成为列式数据库" 的五个特性。
五个特性区分列式存储和列式数据库
Doc values 是构建在 _source 之上的优化
在过去十年的大部分时间里,原始 JSON 文档都是事实来源,而列则是一种派生出来的便利结构。这种优先顺序对整个引擎都有影响。
因为引擎始终可以回退到 _source,所以允许按字段存储采用有损方式。文本字段完全没有 doc values,因为需要时可以从存储的文档中重新读取文本。即使是 synthetic source ------它不是存储一份副本,而是根据字段重新构建文档 ------ 有时也会读取面向行的结构,以忠实还原收到的 JSON,其中超过 ignore_above 的值以及以未映射状态写入的字段都会进入存储字段。
结果形成了一个清晰的契约:无论你发送什么 JSON,都可以取回它,而列则负责加速其他所有操作。对于一个职责是返回你的文档的引擎来说,这种方式是正确的。Columnar 模式则将其反转。每个字段只以 doc values 的形式存储一次,doc values 不能被关闭,文本字段也会获得 doc values,而当有请求需要文档时,则根据这些列重新构建文档。
字典编码如何处理高基数字段
排序后的 doc values 是 keyword 字段的默认存储方式,它们会存储一个不同值的字典,以及每个文档中指向该字典的一个序号。当值重复时,这是一种非常出色的权衡。一个来自一百台机器的 host.name 字段,或者几乎总是 200 的状态码,都可以实现很好的压缩并快速进行分组。
它的工作方式就像仓库里的索引卡。当 50 个箱子装的是同一种产品时,用一张卡片加上 50 个指针比把产品名称写 50 遍更划算。当 50 个箱子装的是同一种产品时,你可以把产品名称存储在索引中,并附带 50 个箱子的 ID。当每个箱子装的东西都不一样时,还不如直接把产品名称写在箱子上;索引可以帮助你找到想要的箱子,但不会节省墨水。
高基数字段描述了大量真实数据,包括 URL、trace 标识符以及消息正文。Columnar 模式跳过字典,改为对数据块中的值进行压缩,并针对高基数字符串使用二进制 doc values。一个字段究竟使用哪种方式并不是由你配置的。引擎会根据它看到的值为每个字段做出决定,因此每一列都会根据它实际存储的数据进行编码,而不是所有字段都采用同一种默认方式。纯列式系统长期以来就在其类型系统中处理基数问题,但通常需要由你进行声明,而且当底层数据发生变化时,后果也由你承担。在这里,这属于引擎的职责。
为什么每个字段默认都会构建倒排索引
默认情况下,keyword 字段还会构建一个倒排索引,numeric 字段还会构建一棵 BKD 树。每个字段都会这样做,因为在写入时,引擎不知道你在读取时会需要哪种能力,这会显著增加每个字段的存储占用。这些结构还必须在 segment 合并期间重新构建,而这恰好会在数据写入负载最高时消耗 CPU。
我们的 时间序列 引擎(TSDB)证明了,当你不再为工作负载不使用的能力付费时,会发生什么。我们将 @timestamp 和维度字段上的索引替换为 doc value 跳过器 ------ 一种稀疏结构,用于保存每个文档数据块的最小值和最大值 ------ 从而从每个 OpenTelemetry(OTel)数据点原本的 25 字节中减少了 10 字节。在时间范围和维度过滤方面,没有可测量的查询性能下降,同时索引 CPU 还额外降低了约 10%。
Columnar 模式将这一默认行为进行了泛化。除非某些功能需要,否则字段不会建立索引,只有映射为文本的字段会保留倒排索引,以实现快速全文搜索。
_id 和 _routing 等元数据字段采用面向行的方式
那些你从来不会去想的字段也遵循相同的文档优先设计。_id 字段是一个存储字段加上一个倒排索引。自定义 _routing 是一个存储字段。无论工作负载是否曾经更新过文档,序列号都会被保留,用于乐观并发控制。
TSDB 处理了这三种情况。它根据已经用于标识数据点的 _tsid 和 @timestamp 值合成 _id,并使用 segment 级布隆过滤器来捕获重复数据点,在不损失任何功能的情况下,每个数据点减少了 5 字节。当复制不再需要序列号后,它会将其裁剪掉,再减少 4 字节。再加上将 codec 数据块大小从 128 个元素增加到 512 个元素所节省的另外 2 字节,这四项变化从 9.1 到 9.4 的不同版本中共同促成了 OTel 指标存储效率的提升,使每个数据点的大小从 25 字节降至 3.75 字节。
Columnar 模式将这些理念从指标场景推广到了通用场景。在正式发布(GA)时,所有元数据字段都将以 doc values 的形式存储;此外,我们计划后续增加 sort id 模式,根据索引排序字段合成标识符,并增加派生字段,将 _tsid 在时间序列中的做法推广到任意字段集合。
ES|QL 计算引擎中的列式查询执行
只有当引擎以列的方式读取数据时,列式存储才能发挥作用。聚合从搜索继承了逐文档处理的形态,这对于围绕文档构建的引擎来说是很自然的方式。而读取列则可以让引擎将一整个数据块的值交给单条指令处理,这正是下面这些数字的来源。
ES|QL 计算引擎改变了这种处理方式,而 TSDB 再次展示了这种变化的影响有多大:
-
向量化执行时间序列聚合,单独就可以带来最高 8 倍的性能提升。
-
将磁盘上的数据直接解码到引擎执行聚合所使用的原始数组中,不产生中间副本,又带来了大约 10 倍的性能提升。
-
常量数据块将重复值转换成了一种内存中的游程编码形式。
-
过滤下推将过滤操作下推到 Lucene,在那里跳过器可以直接丢弃整个尚未打开的数据块。
结合其他数据块级别的查询工作,与早期版本相比,查询延迟最高提升了 160 倍。
这项工作仍在继续。支持跳过器的算子、基于序号进行分组并尽可能延迟转换为实际值的聚合,以及更丰富的每数据块摘要都在开发中;由于每种索引模式底层都会读取 doc values,因此所有索引模式都将从这些优化中受益。
Columnar 模式为日志和分析数据带来的变化
将值存储在列中是一种存储细节。一个列式数据库需要具备五项能力:
-
列是数据的唯一副本。
-
每一列都针对它实际存储的数据进行编码。
-
元数据同样采用列式存储。
-
只有在某些功能需要时,字段才会添加索引。
-
查询引擎处理的是值的数据块,而不是记录或文档。
在 Elasticsearch 9.4 中,TSDB 已经为指标实现了这五项能力,这也是为什么本文中的数据来自指标,而不是来自演示文稿。Columnar 模式将相同的处理方式应用于日志和安全遥测数据,以及分析数据。该模式目前在 Elasticsearch 9.5 中处于技术预览阶段,目标是在 9.7 中正式发布(GA)。
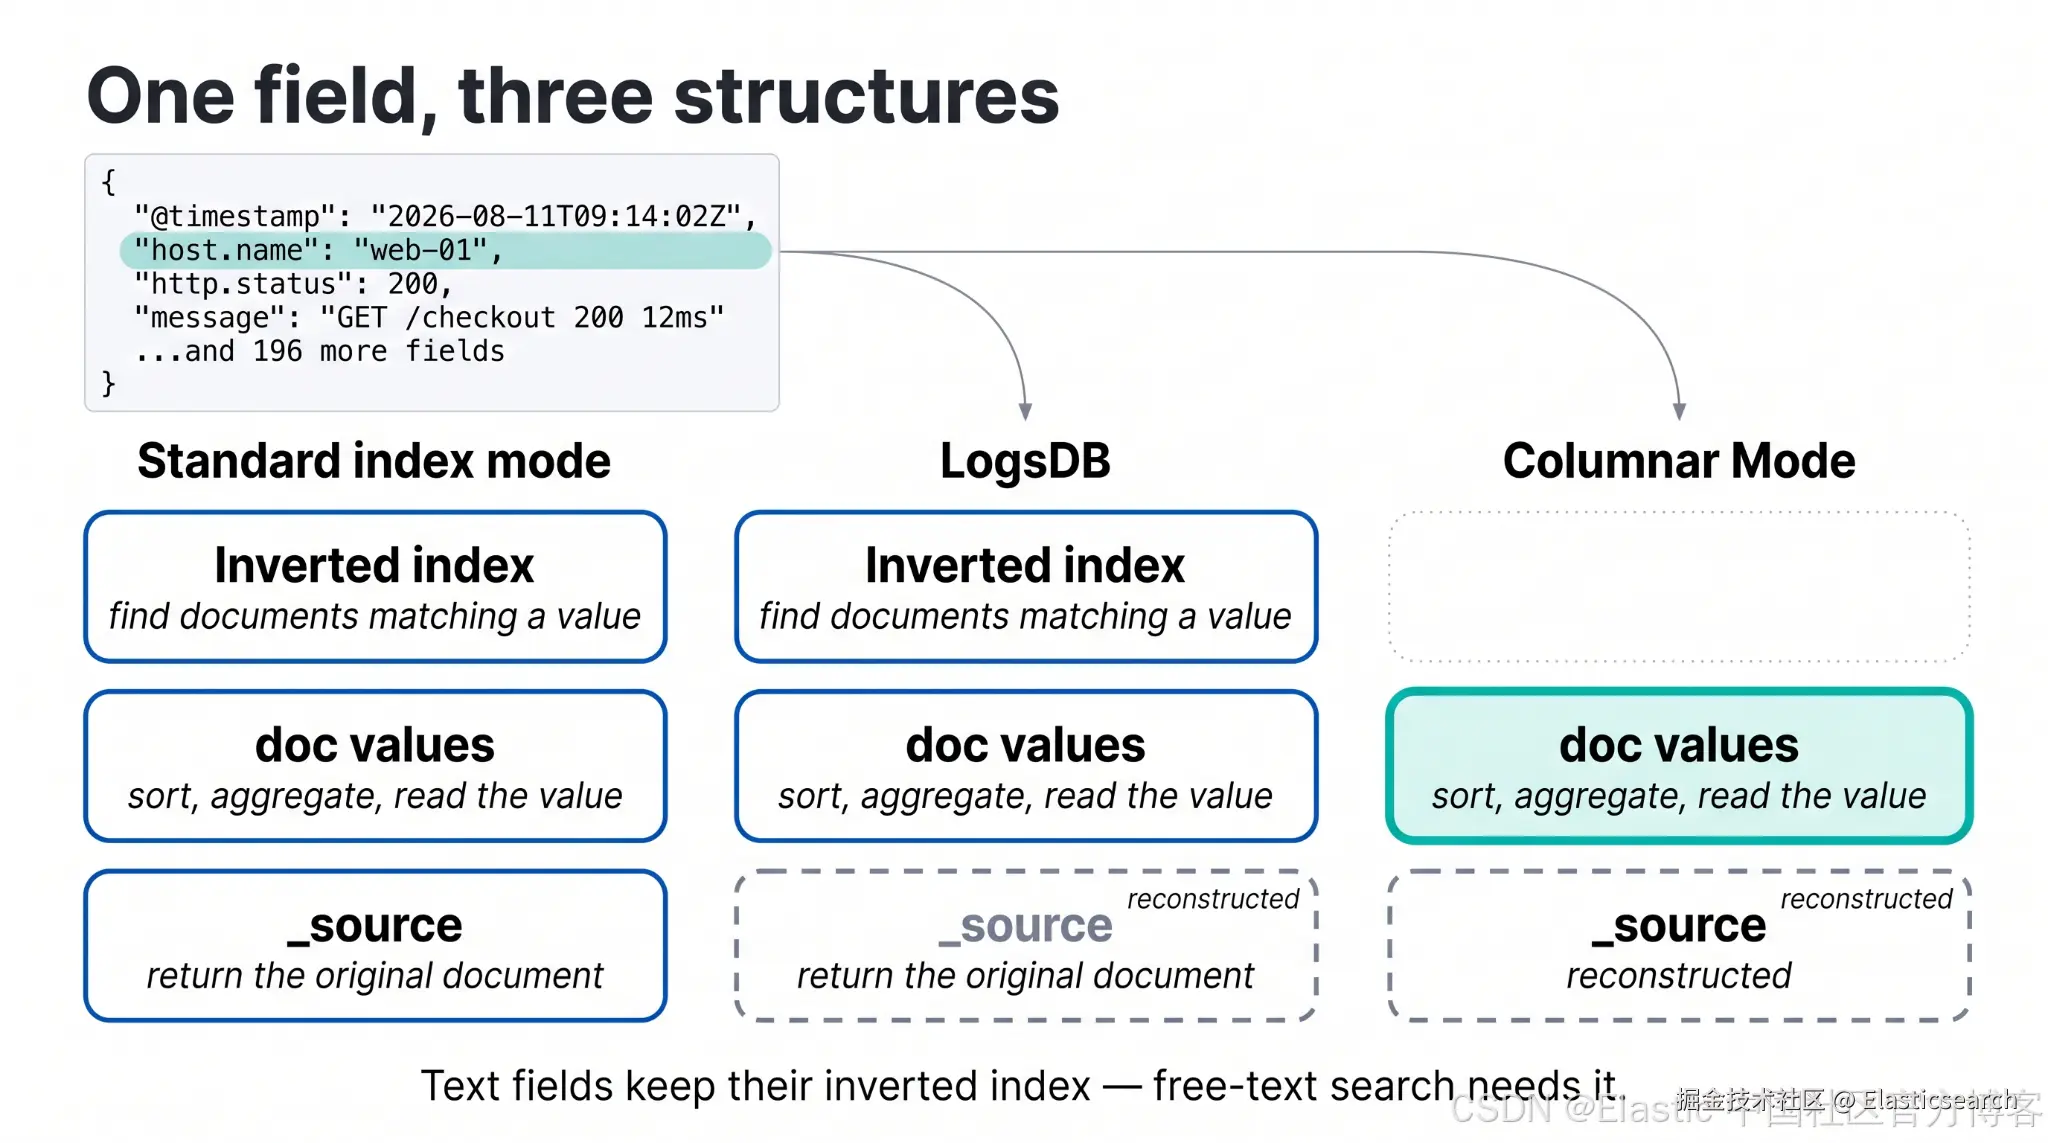 每个字段只存储自身一次,并且只有在需要索引时才添加索引。
本文所述任何功能或特性的发布及时间安排均由 Elastic 自行决定。目前尚未提供的任何功能或特性可能无法按时交付,甚至可能根本不会交付。
原文:Evolving Elasticearch's columnar store to a columnar database | Elasticsearch Labs