机器眼里没有脸,怎么识别人脸?手写 CNN 拆开卷积层与 BatchNorm
 早上七点四十,地铁口,我掏出手机扫了一下脸,锁开了,半秒不到。同一件事的另一面是,过去一年 AI 生成的脸也多了起来。2025 年 9 月 1 日《人工智能生成合成内容标识办法》施行,要求 AI 生成合成的内容打上标识,到今年 9 月刚好跑满一年。
一边是机器要认出你是谁,一边是机器要认出这张脸是不是真的。看着相反,底层是同一件事:一个能在像素里找规律的神经网络。
为了弄清楚怎么识别这件事,这篇想用一个具体的问题来说明:一张 64×64 的灰度小图,机器是怎么从里面分出"这是同一类人"的?为什么有的网络一学就会,有的怎么调都学不动?这后面站着两个主角,卷积层和 BatchNormalization(下面简称 BN)。我用一份真实人脸数据,从零用 numpy 把网络搭起来跑给你看,文章里每个数字都能在我给的脚本里原样跑出来。
先看整条流水线。 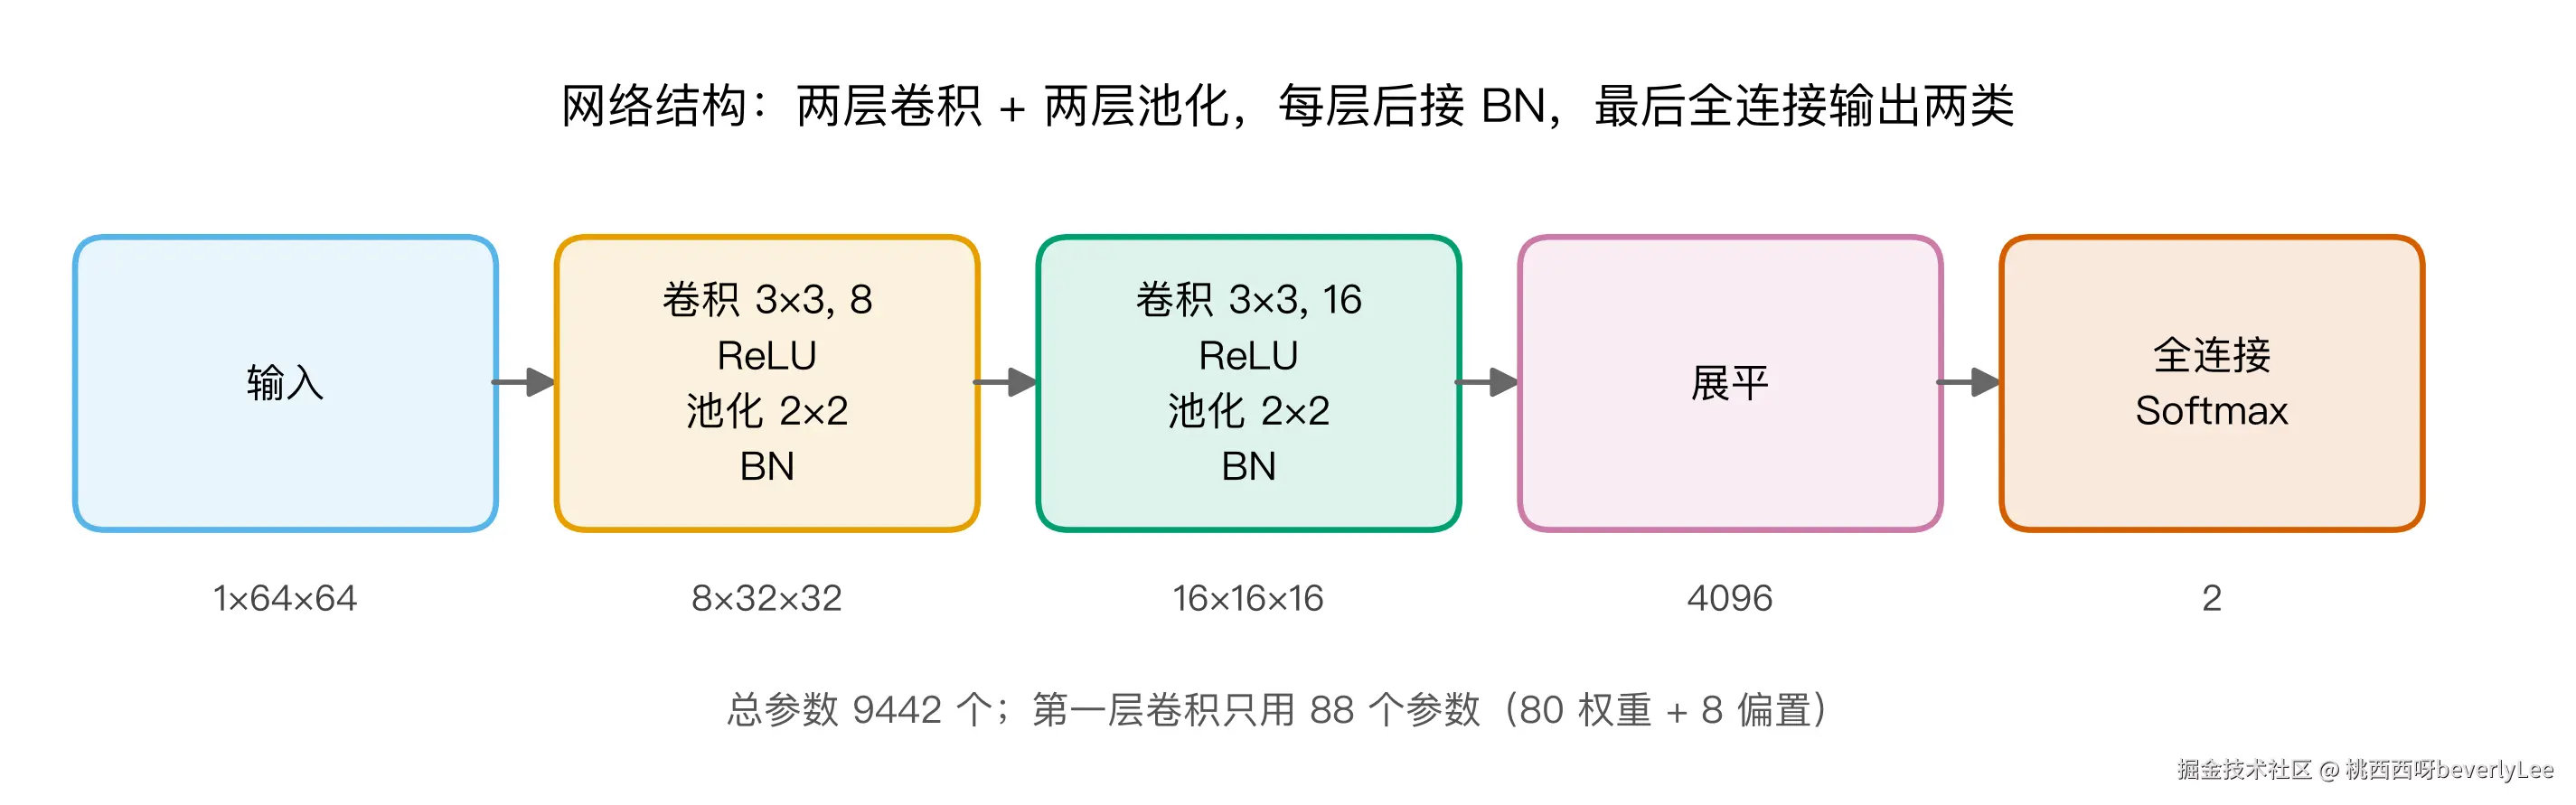
图 1 是网络全貌。一张 64×64 的脸进去,过一层卷积抽出 8 张特征图,再过一层抽出 16 张,中间穿插池化和 BN,最后拍平、全连接、输出两类。整张图只有 9442 个参数,第一层卷积自己只占 88 个,这个数字后面还会出现。
Q1 一张脸进了计算机,变成了什么?
摄像头拍到的"一张脸",在计算机里就是一堆数字。
我用的数据叫 Olivetti Faces,AT&T 剑桥实验室上世纪拍的人脸集,40 个人,每人 10 张,一共 400 张。每张压成 64 行 64 列的灰度图,每个格子的取值在 0 到 1 之间。所以一张脸等于 64 乘 64,4096 个数字。
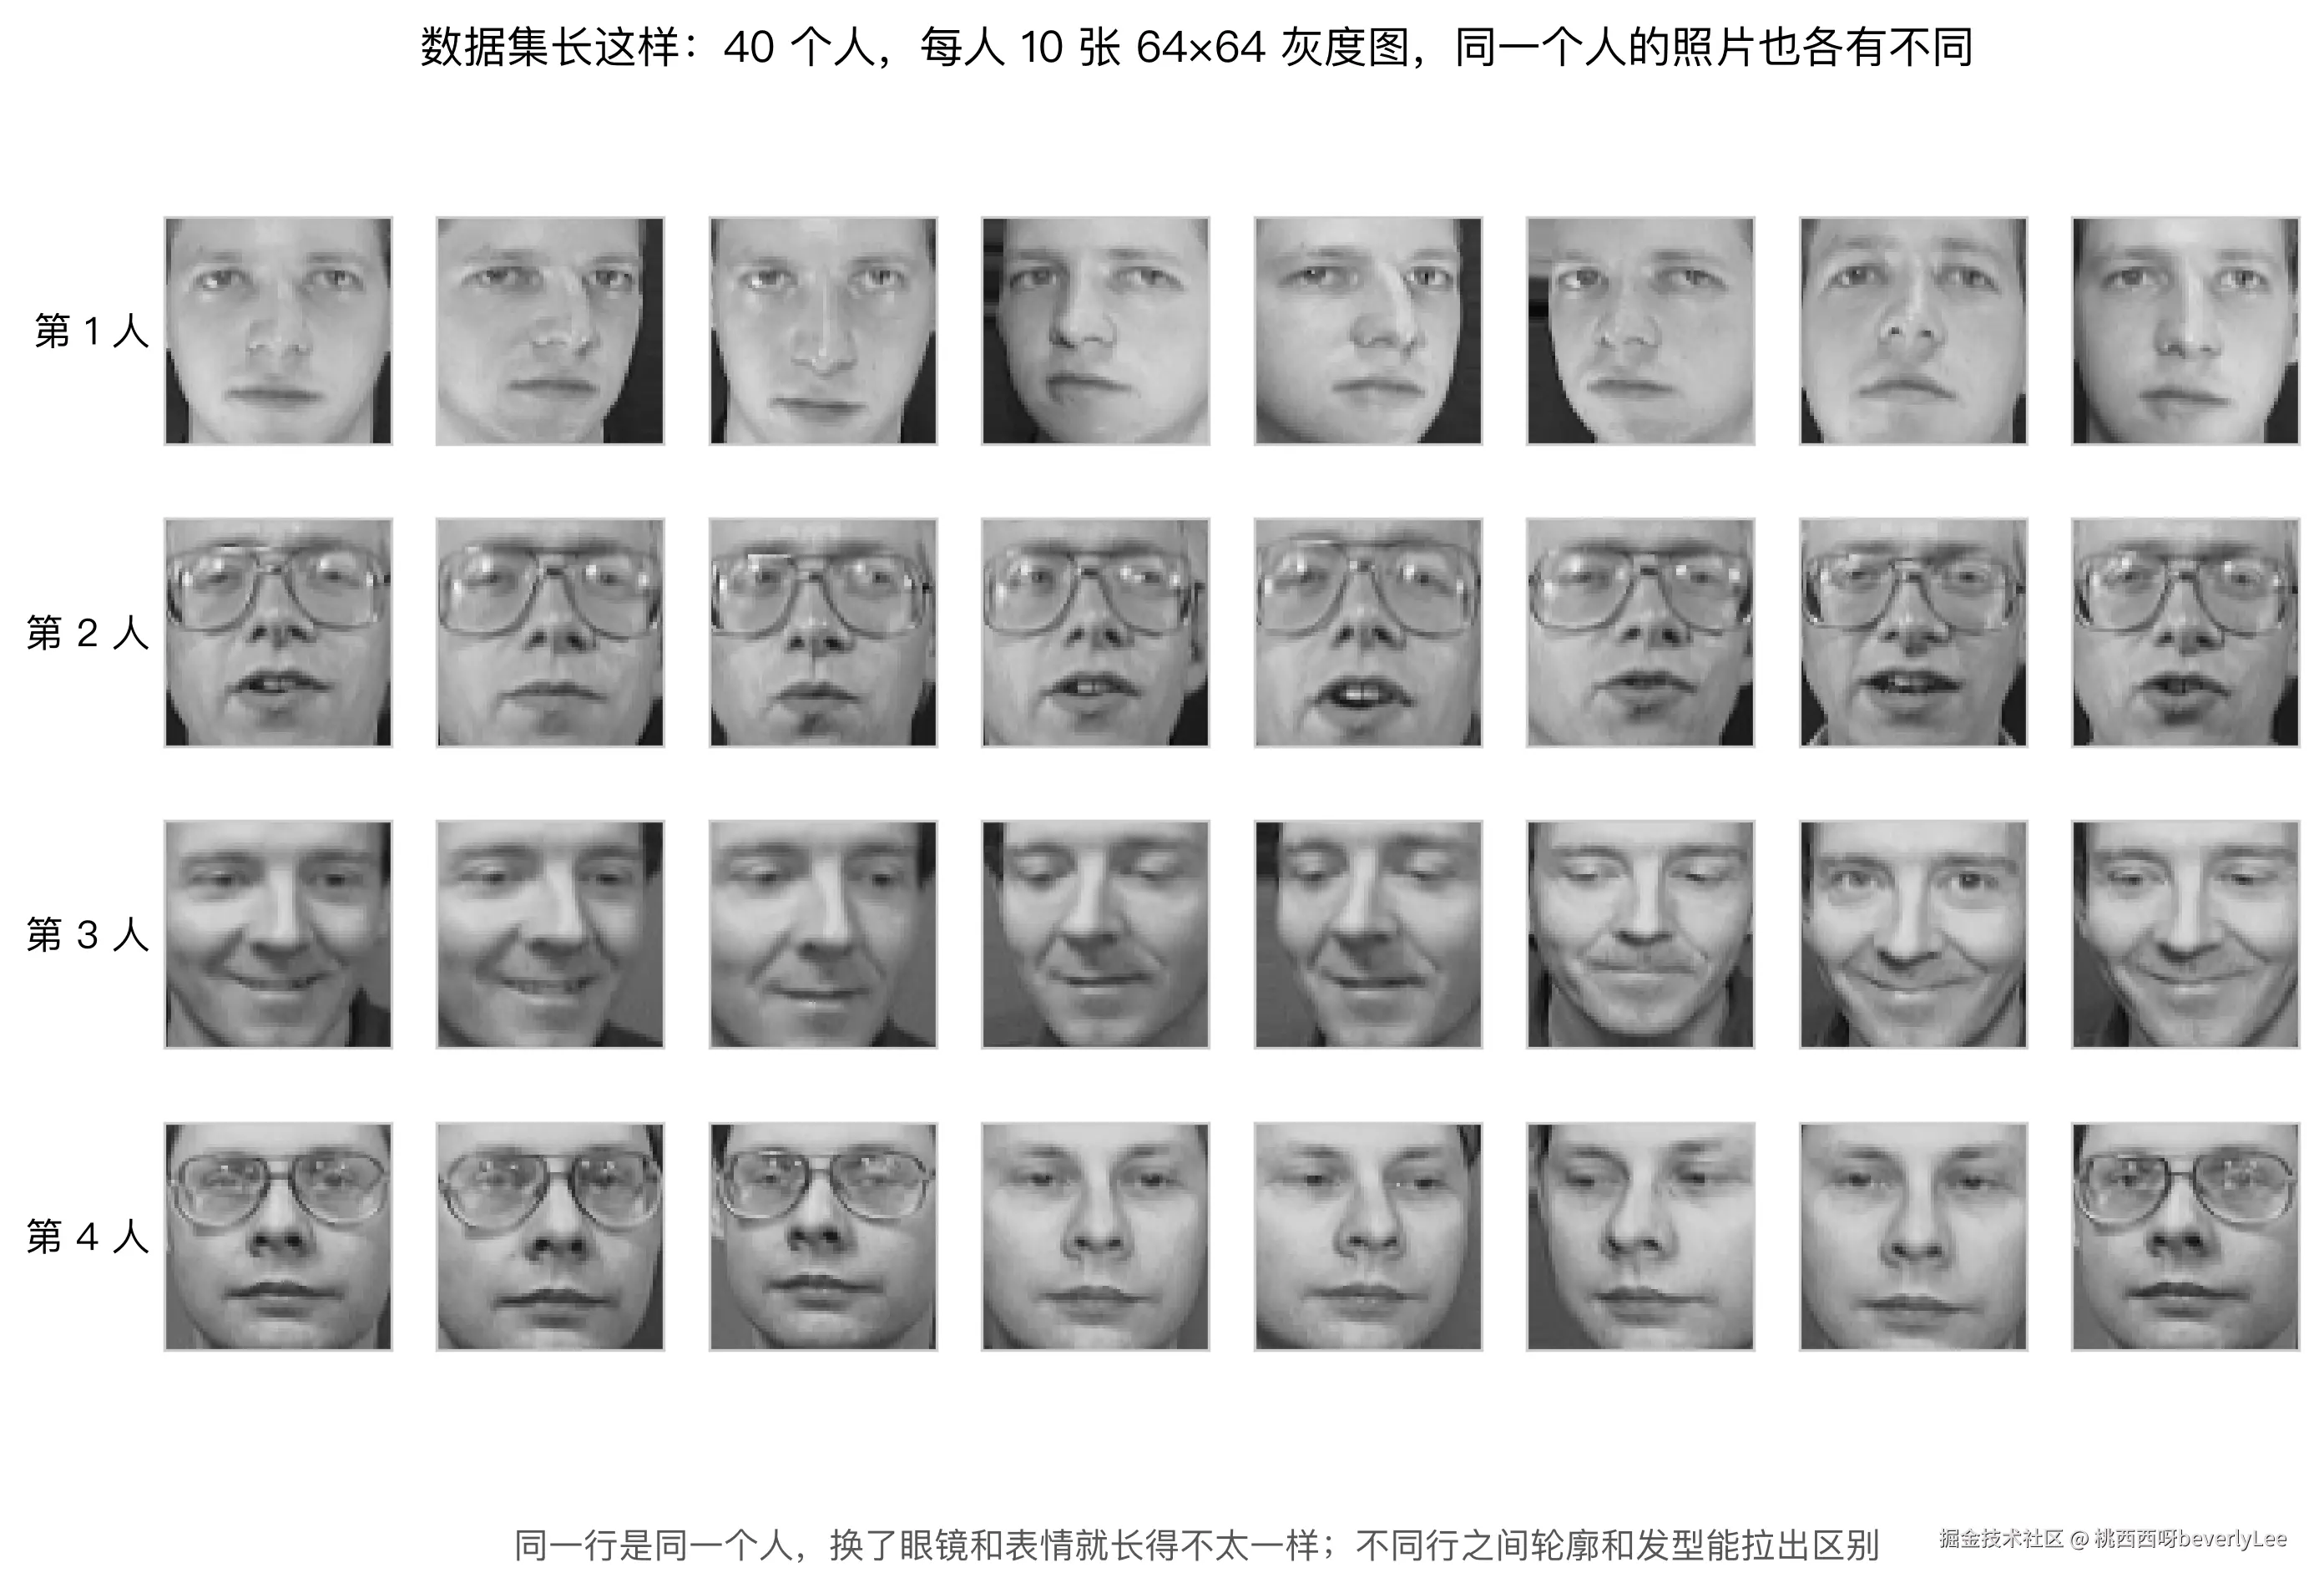 图 2 是前 4 个人的照片,每人 8 张,同一行是同一个人。同一个人换了眼镜、换了表情,样子就不太一样;不同行之间,轮廓和发型又能拉出区别。
你可能会想,把这 4096 个数一股脑喂给分类器不就完了。
-
第一个问题是,用最朴素的全连接层,让 4096 个输入每个都连到后面 8 个神经元,光这一层就要 4096 乘 8,32768 个权重。而 64×64 已经是很小的图,手机照片轻松上千万像素,按这个连法参数根本存不下。
-
第二个问题是,全连接把每个像素当独立输入,它会觉得"左上角那个格子"和"正中间那个格子"毫无关系。可人脸的规律恰恰是局部的、可以搬家的:眼睛的角、鼻子的边,出现在哪个位置不重要,重要的是"有这么一块明暗交界"。全连接表达不了这件事,只能给每个位置单独配一套权重。
所以卷积层出现了,它要做的第一件事,就是把"位置"和"图案"拆开。
把 40 个人分成两拨,前 20 人一类,后 20 人一类,做个二分类。数据随机切成 300 张训练、100 张测试。这么设不是为了造产品,是让一个纯 numpy 的小网络几分钟能跑完,好把每一步摊开给你看。
还有个小处理,我把灰度值除到 0 到 1 之间再送进网络。神经网络对输入尺度敏感,范围不统一训练就容易抖。这一手在输入层做,BN 是在中间层做,思路一样。
Q2 卷积层,到底在脸上一格一格找什么?
卷积最核心的两个词,局部感受野和权值共享,拆开看都很朴素。
局部感受野是说,卷积层不像全连接那样一眼看全图,它手里拿着一个小窗口,比如 3×3,只在脸的一小块地方看。窗口从左到右、从上到下滑,每滑到一个位置,就用手里的 9 个权重跟盖住的 9 个像素做一次加权求和:
yi,j=ΣΣwa,b⋅xi+a,j+b+b
x 是输入图,w 是那 9 个权重,滑动全程一份都不换,这就是权值共享;b 是偏置;yi, j 是滑到第 i 行第 j 列算出的数。窗口滑完全图得到一张新图,叫特征图。
打个好记的比方:同一块雕花印章,在纸上从左到右盖一排,每朵花纹都来自同一块印章,只是落点不同。卷积核就是那块印章。
光看公式还是抽象,我把它摊成一个能对着数的例子。
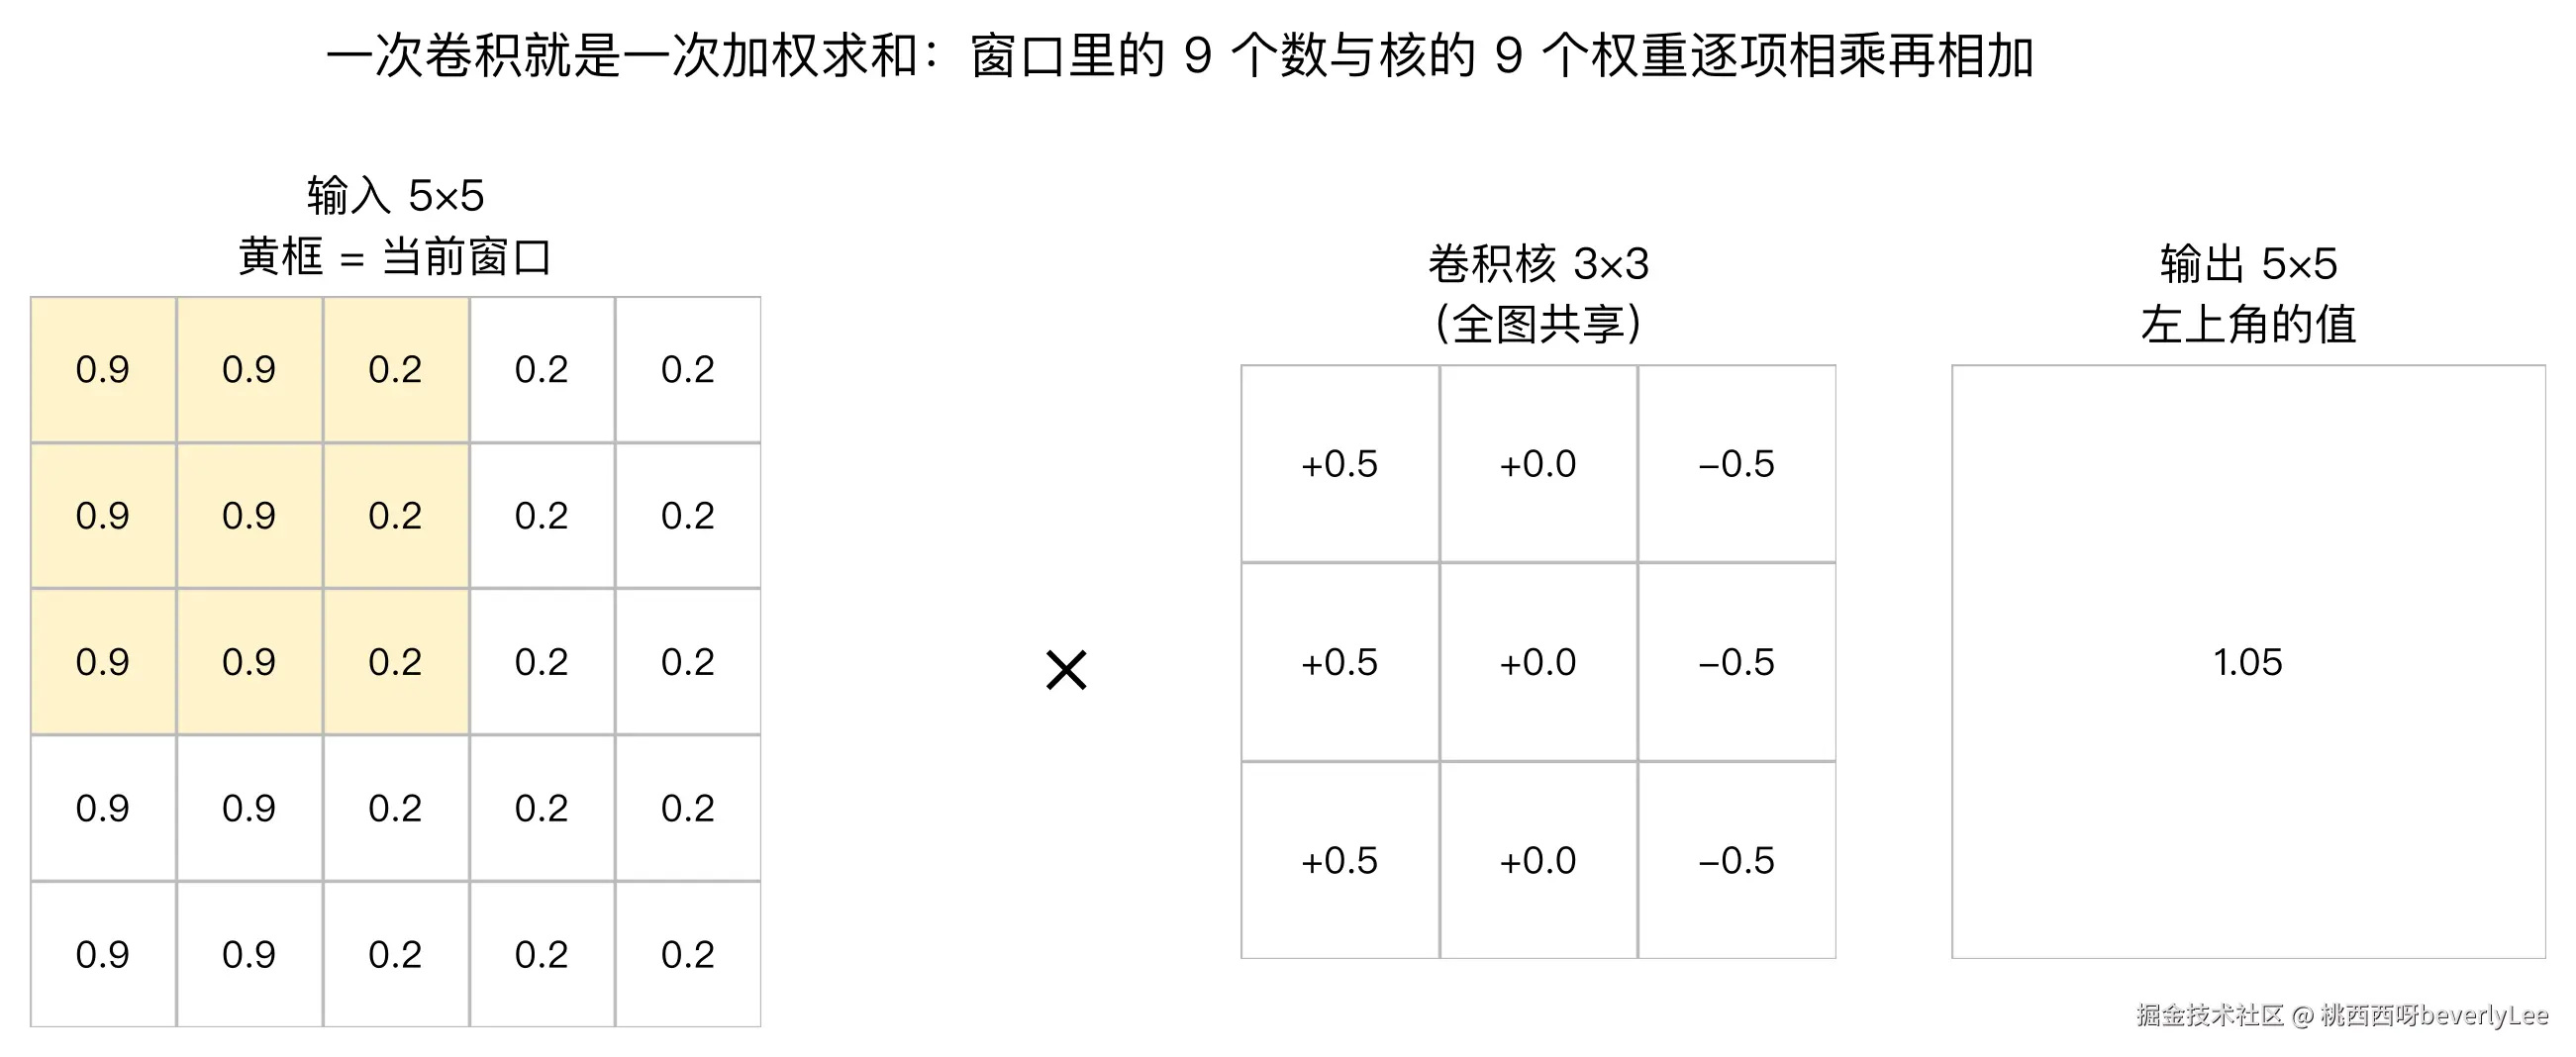 图 3 左边是脸上一小块 5×5 的明暗,黄框是当前窗口盖住的 3×3;中间是卷积核的 9 个权重;右边是算出的结果 1.05。把窗口里那 9 个数和核的 9 个权重一一相乘再相加,就得到它。仔细看这个核,左边一列是正的、右边一列是负的,它专门奖励"左边亮右边暗"的竖直边。黄框里正好是这样一块交界,算出来就大;换成平坦的区域,同一个核算出来接近 0。一个核就是对一种局部图案的探测器。
一组权重滑一遍只能抽一种图案,所以卷积层一次放好几个核。我这一层放了 8 个 3×3 的核,输出 8 张特征图。 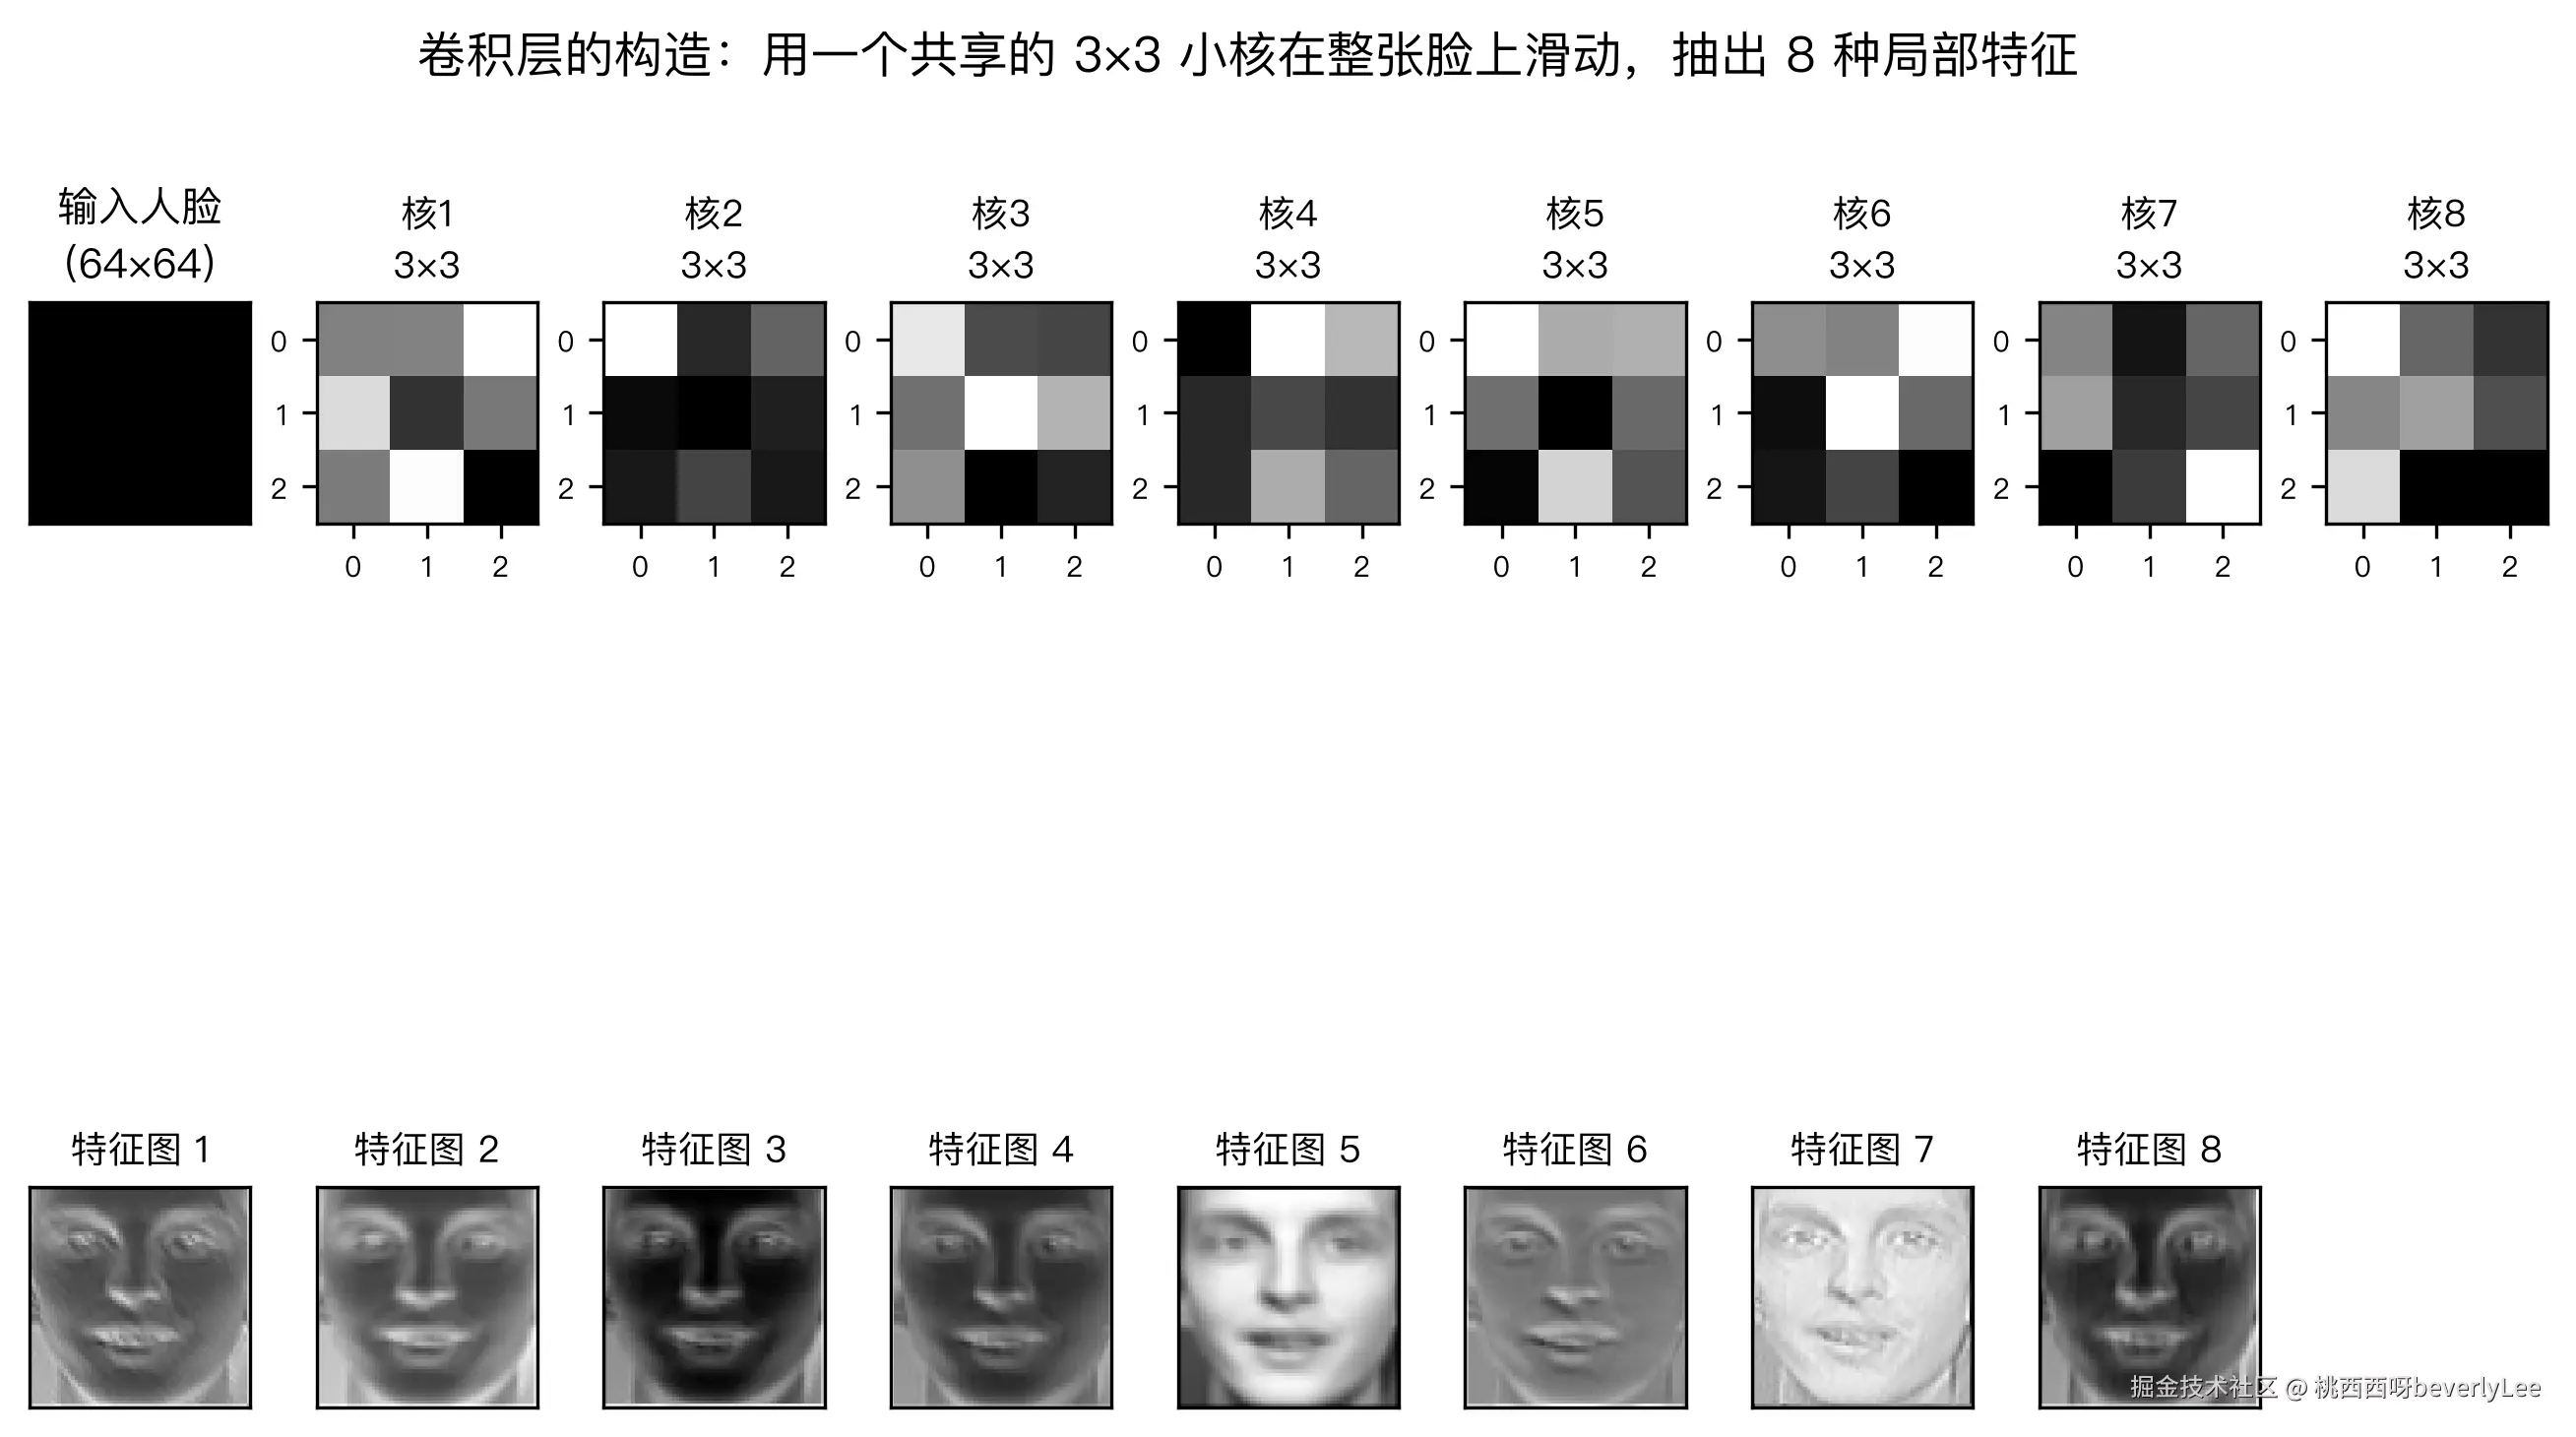 图 4 上面一行是输入的脸和网络学出来的 8 个核,下面一行是 8 张对应的特征图。有的核正中间是个大正数,特征图整张脸都亮;有的核正负交错,只在脸颊和鼻梁附近有反应;还有的响应很弱,输出基本是灰的。这些核不是人设计的,是网络自己从训练图里学出来的。
特征图之后还会过一个 ReLU,把负数全抹成 0。它的意义是引入非线性,没有它,卷积叠再多也还是一堆线性操作,网络只能画直线边界。
再往后是池化。我把 2×2 的范围压成一个数,取最大值,图的长宽各减一半。它干两件事:把特征图变小,减少后面的计算量;让网络对小的位移不那么敏感。一只眼睛稍微挪两个像素,池化取的是同一块区域的最大值,输出基本不变。代价是位置信息被扔掉了,取最大值的那个像素在哪,池化之后不记得了。这对分类是好事,换成要精确定位的任务就成了麻烦。
到这里你可能有个疑问,卷积一圈圈地滑,代码里不会慢死吗。这是我写代码时最有意思的一段。
如果老实写两层 for 循环滑窗口,numpy 里跑一张 64×64 的图就要循环几千次,慢得没法训练。工程上的做法叫 im2col,把滑窗巧换成矩阵乘法:先把输入图按窗口位置展开成一个矩阵,每一行是一次滑动盖住的 9 个像素,64×64 的图展开出来就是 4096 行、每行 9 个数;8 个核也拍平成 8 行 9 列的矩阵。两边一做矩阵乘法,一次性算出所有位置、所有核的输出,比手写循环快几个数量级。我脚本里的 im2col 干的就是这件事,反向传播时再用 col2im 把梯度还原回去。
顺带一个后面会反复用到的式子,输出尺寸怎么算:
Hout=(H+2p−k)/s+1
H 是输入高,p 是边缘补零的圈数,k 是核大小,s 是步长。我用 3×3 的核,边上补一圈 0,步长取 1,代进去 (64+2−3)/1+1=64,尺寸不变。所以卷积层用完图还是 64×64,缩小的活交给池化。
这里有个反直觉的点。局部感受野听起来是个限制,只看 3×3 这么小的地方,不是把信息看窄了吗。可正是这个限制逼出了更好的东西:全连接靠"每个位置配一套权重"换取全局视野,代价是参数随图的大小爆炸;卷积先抓局部,再靠叠层把局部拼成全局。两个卷积层叠起来,第二层的输出点已经看过原图上一块 5×5 的区域,层数越深覆盖越大。这是用层数换视野。
Q3 为什么卷积这么省参数?
同样是把一张 64×64 的图变成 8 个通道,全连接和卷积差多少,我直接用脚本算了一遍。 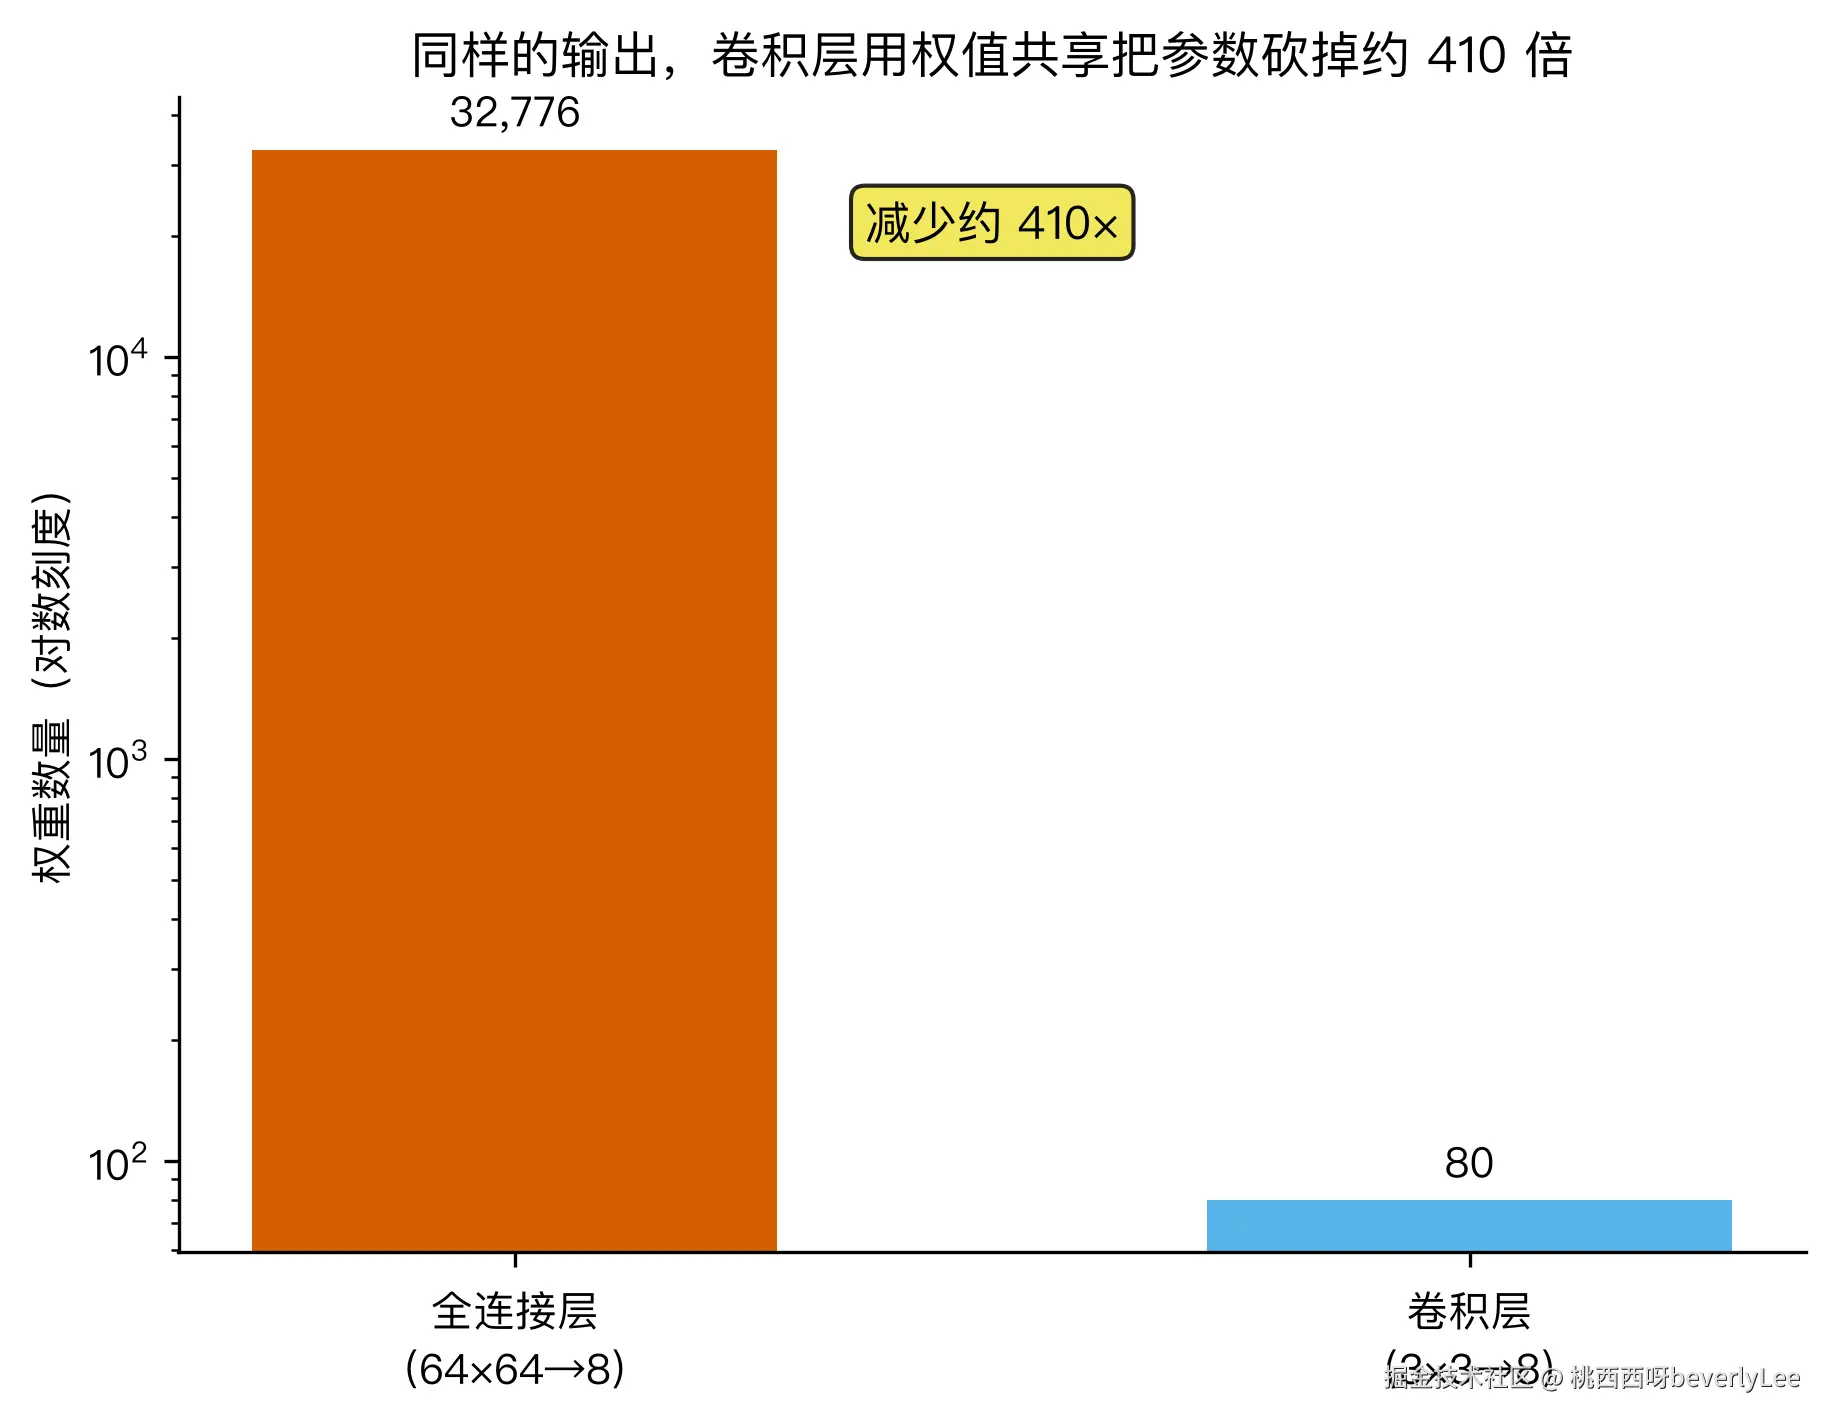 图 5 纵轴是对数刻度,因为两个数差得太远,用线性刻度小柱子会看不见。第一层用全连接,64×64 个输入连到 8 个输出,要 64×64×8 个权重加 8 个偏置,一共 32776 个参数。用卷积,8 个 3×3 的核,8×9 个权重加 8 个偏置,一共 88 个。
32776 除以 88 约等于 372,而脚本打印出来是减少 409.7 倍。差异来自记账口径:只算纯权重、不带偏置,是 32768 除以 80,等于 409.6,取一位小数就是 409.7;连偏置一起算才是 372 倍。我在脚本和图上统一用纯权重口径,因为偏置的数量跟通道数绑在一起,和权重的规模不是一个量级,混着算反而看不清。两种口径结论一样,卷积比全连接少两个数量级。
能省这么多,关键就在权值共享。全连接是"每个输入位置配一套独立权重",4096 个位置就配 4096 套;卷积是"所有位置共用同一套",图多大手里都只有那 9 个数。一张 64×64 的图省了 410 倍,图越大省得越狠。
整个网络的账也顺便算了:两层卷积加两层池化,最后接一个全连接输出层,总参数 9442 个。第一层卷积 88 个;第二层是 8 通道进、16 通道出、3×3 的核,8×16×9 加 16,等于 1168 个;剩下的绝大多数都在最后那个全连接层。
这里有个容易搞混的地方。卷积省的只是参数,不是计算量。还是第一层,8 个 3×3 的核在 64×64 的图上滑一遍,每个位置 9 次乘加,4096 个位置,一共 4096×8×9,接近 30 万次乘加;全连接那次前向,32776 个参数也要参与差不多量级的运算。两者算力在一个数量级,差的是要存下来的参数量。参数少的直接好处是不容易过拟合、对显存友好。把"参数少"和"算得快"当成一回事,是很多人的第一个误解。
卷积的省还有个前提:同一个图案在图上任何位置含义相同。换成每个位置代表不同含义的数据,比如表格,这个前提就不成立,共享反而会犯错。判断一个任务适不适合卷积,先问一句,这个任务的规律是不是可以复用。
Q4 网络稍微一深就学不动,BatchNorm 是怎么把它拽回来的?
我用同样的结构跑了三组对照,先说结果。
- 带 BN,学习率用 0.01:测试集准确率 0.95,CPU 训练 148.7 秒
- 不带 BN,学习率只敢用 0.005:准确率 0.65,CPU 训练 151.1 秒,训练损失几乎没降
- 不带 BN,硬用 0.01 的大学习率:准确率 0.78
这三组不是嘴上说的,是脚本跑出来的,图 6 是终端里的原始输出。
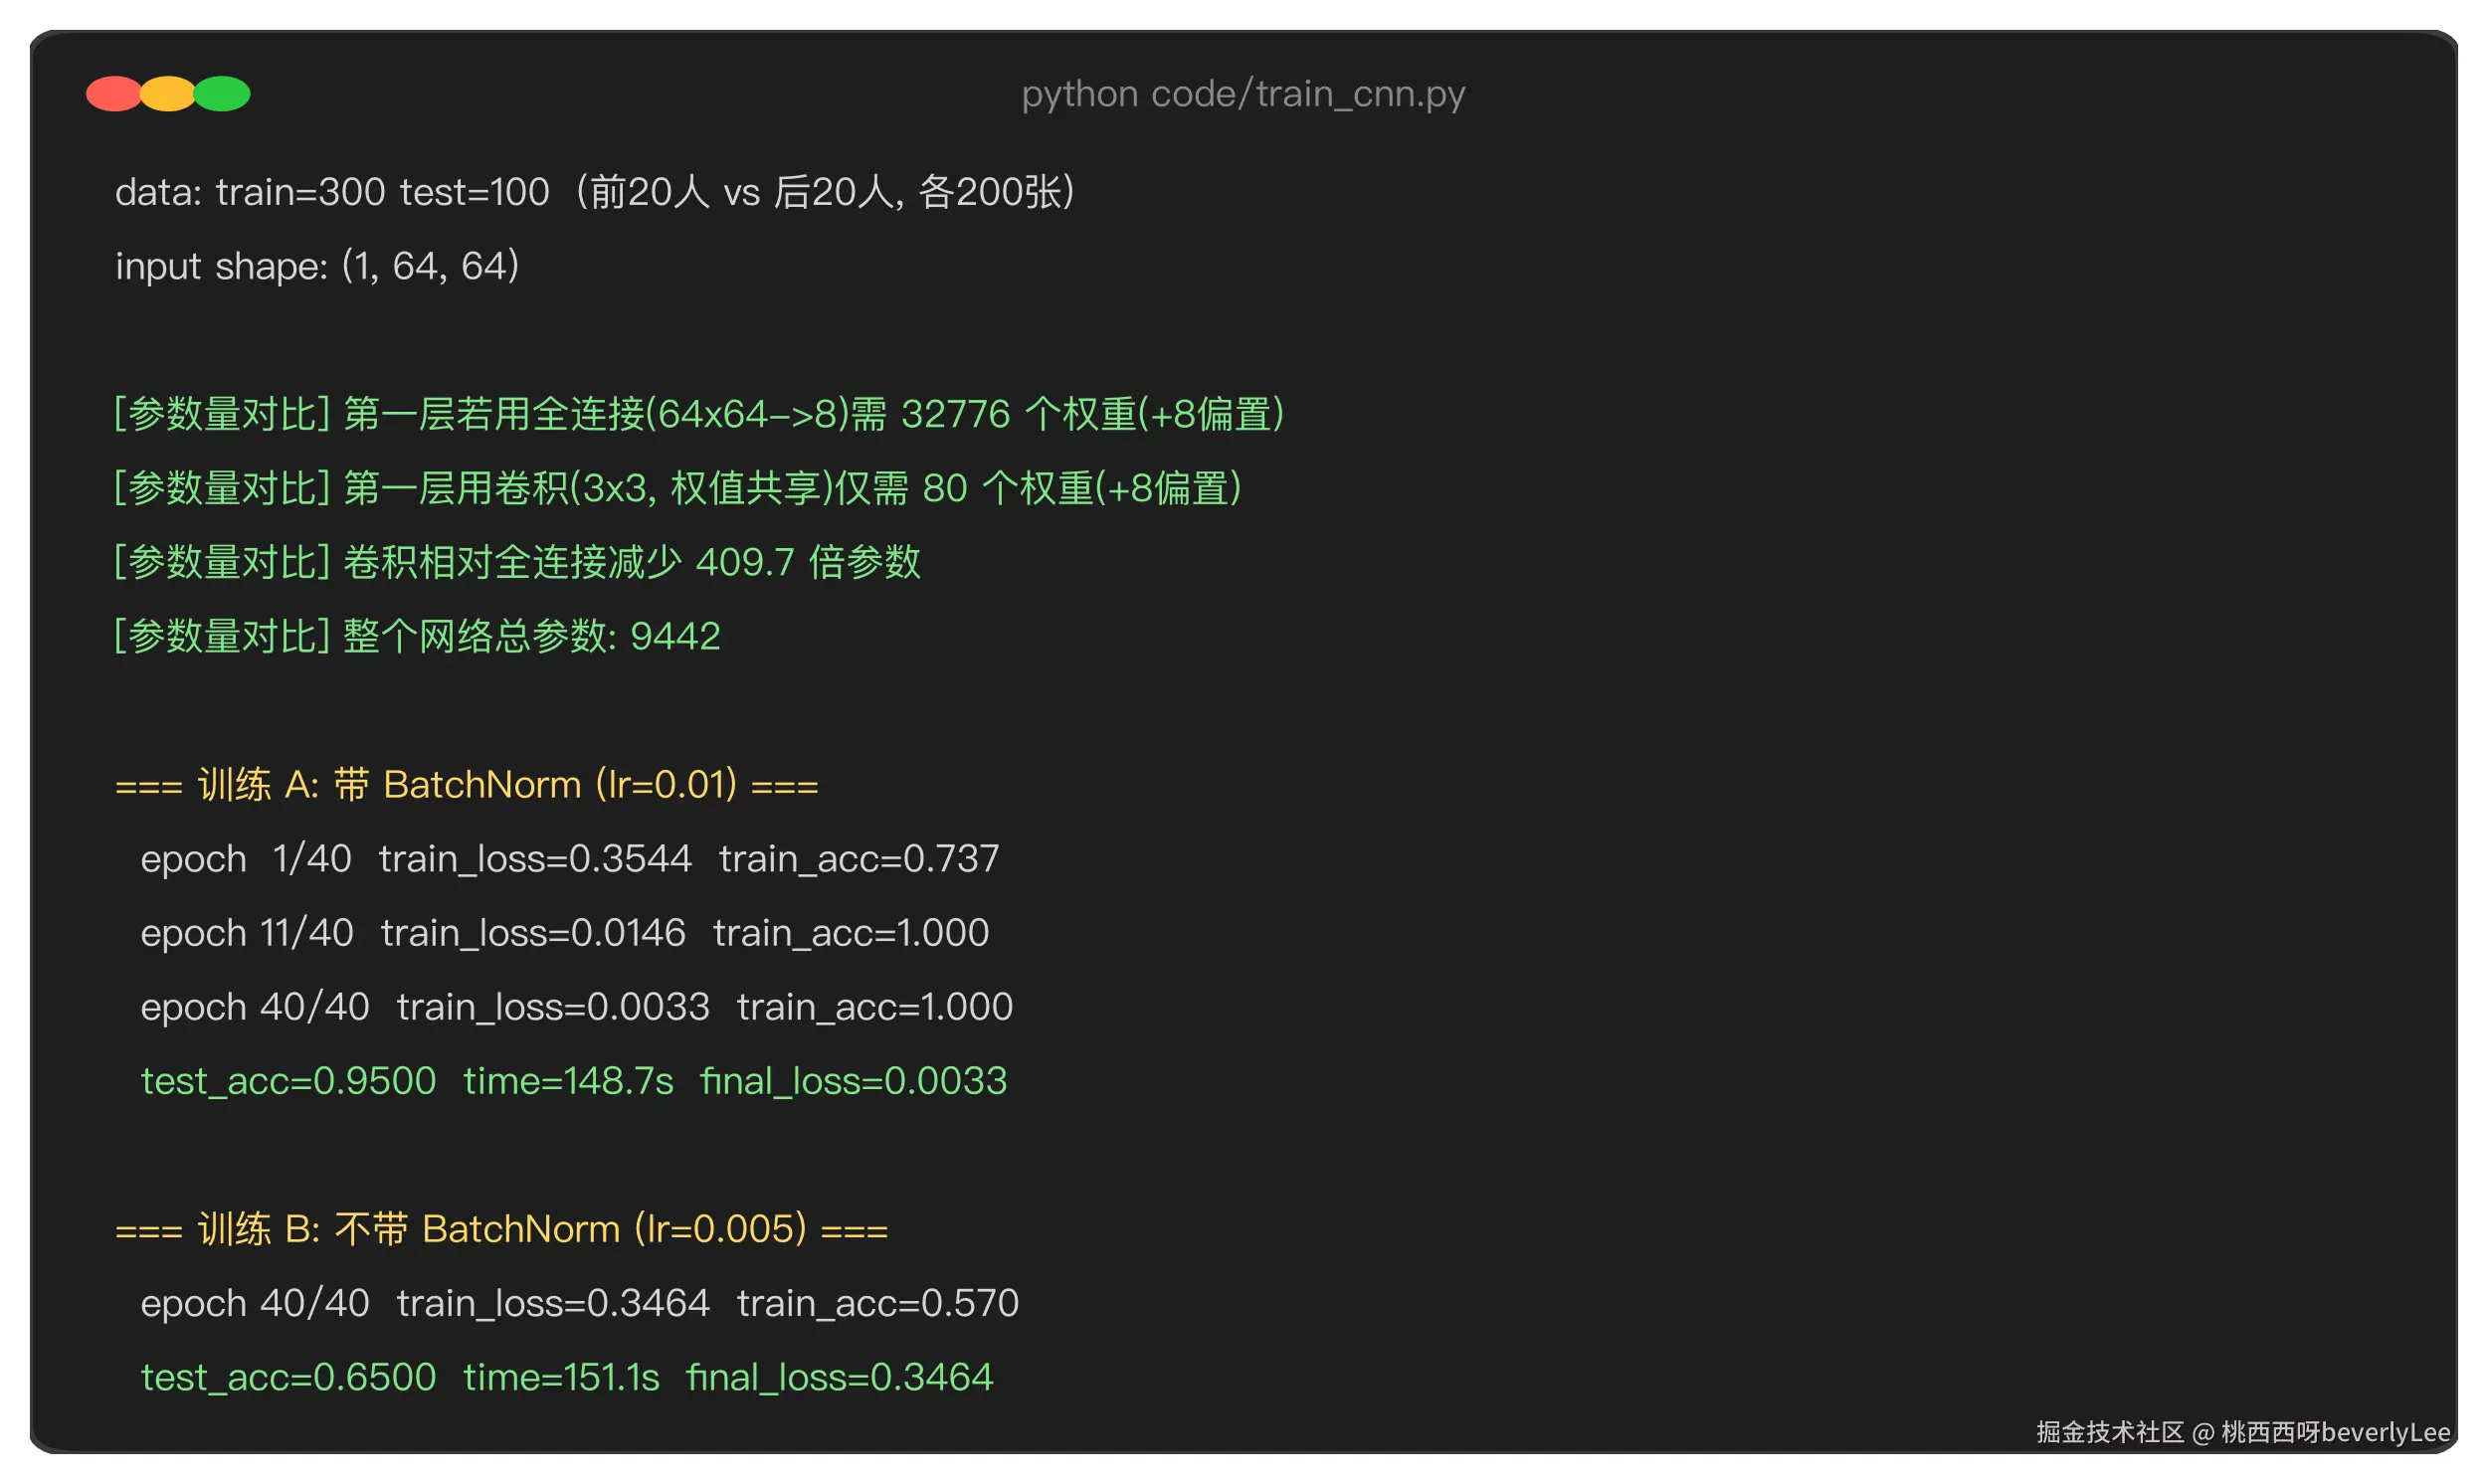
图 6 能看到三件事:第一层卷积只要 80 个权重,全连接要 32776 个;带 BN 那组从第 1 轮的 0.3544 一路降到第 40 轮的 0.0033;不带 BN 那组第 40 轮还停在 0.3464。同一份代码,只差了 BN 这一层。
第一组和第三组只差一个 BN,准确率差了 17 个百分点。第二组更有意思,训练损失从第一轮的 0.3466 到第四十轮的 0.3464,四十轮几乎没动,跟没学一样。顺带说一句,带 BN 那组花了 148.7 秒,不带 BN 那组 151.1 秒,两者几乎一样,BN 多出来的那点计算和它换来的收敛速度比起来可以忽略。 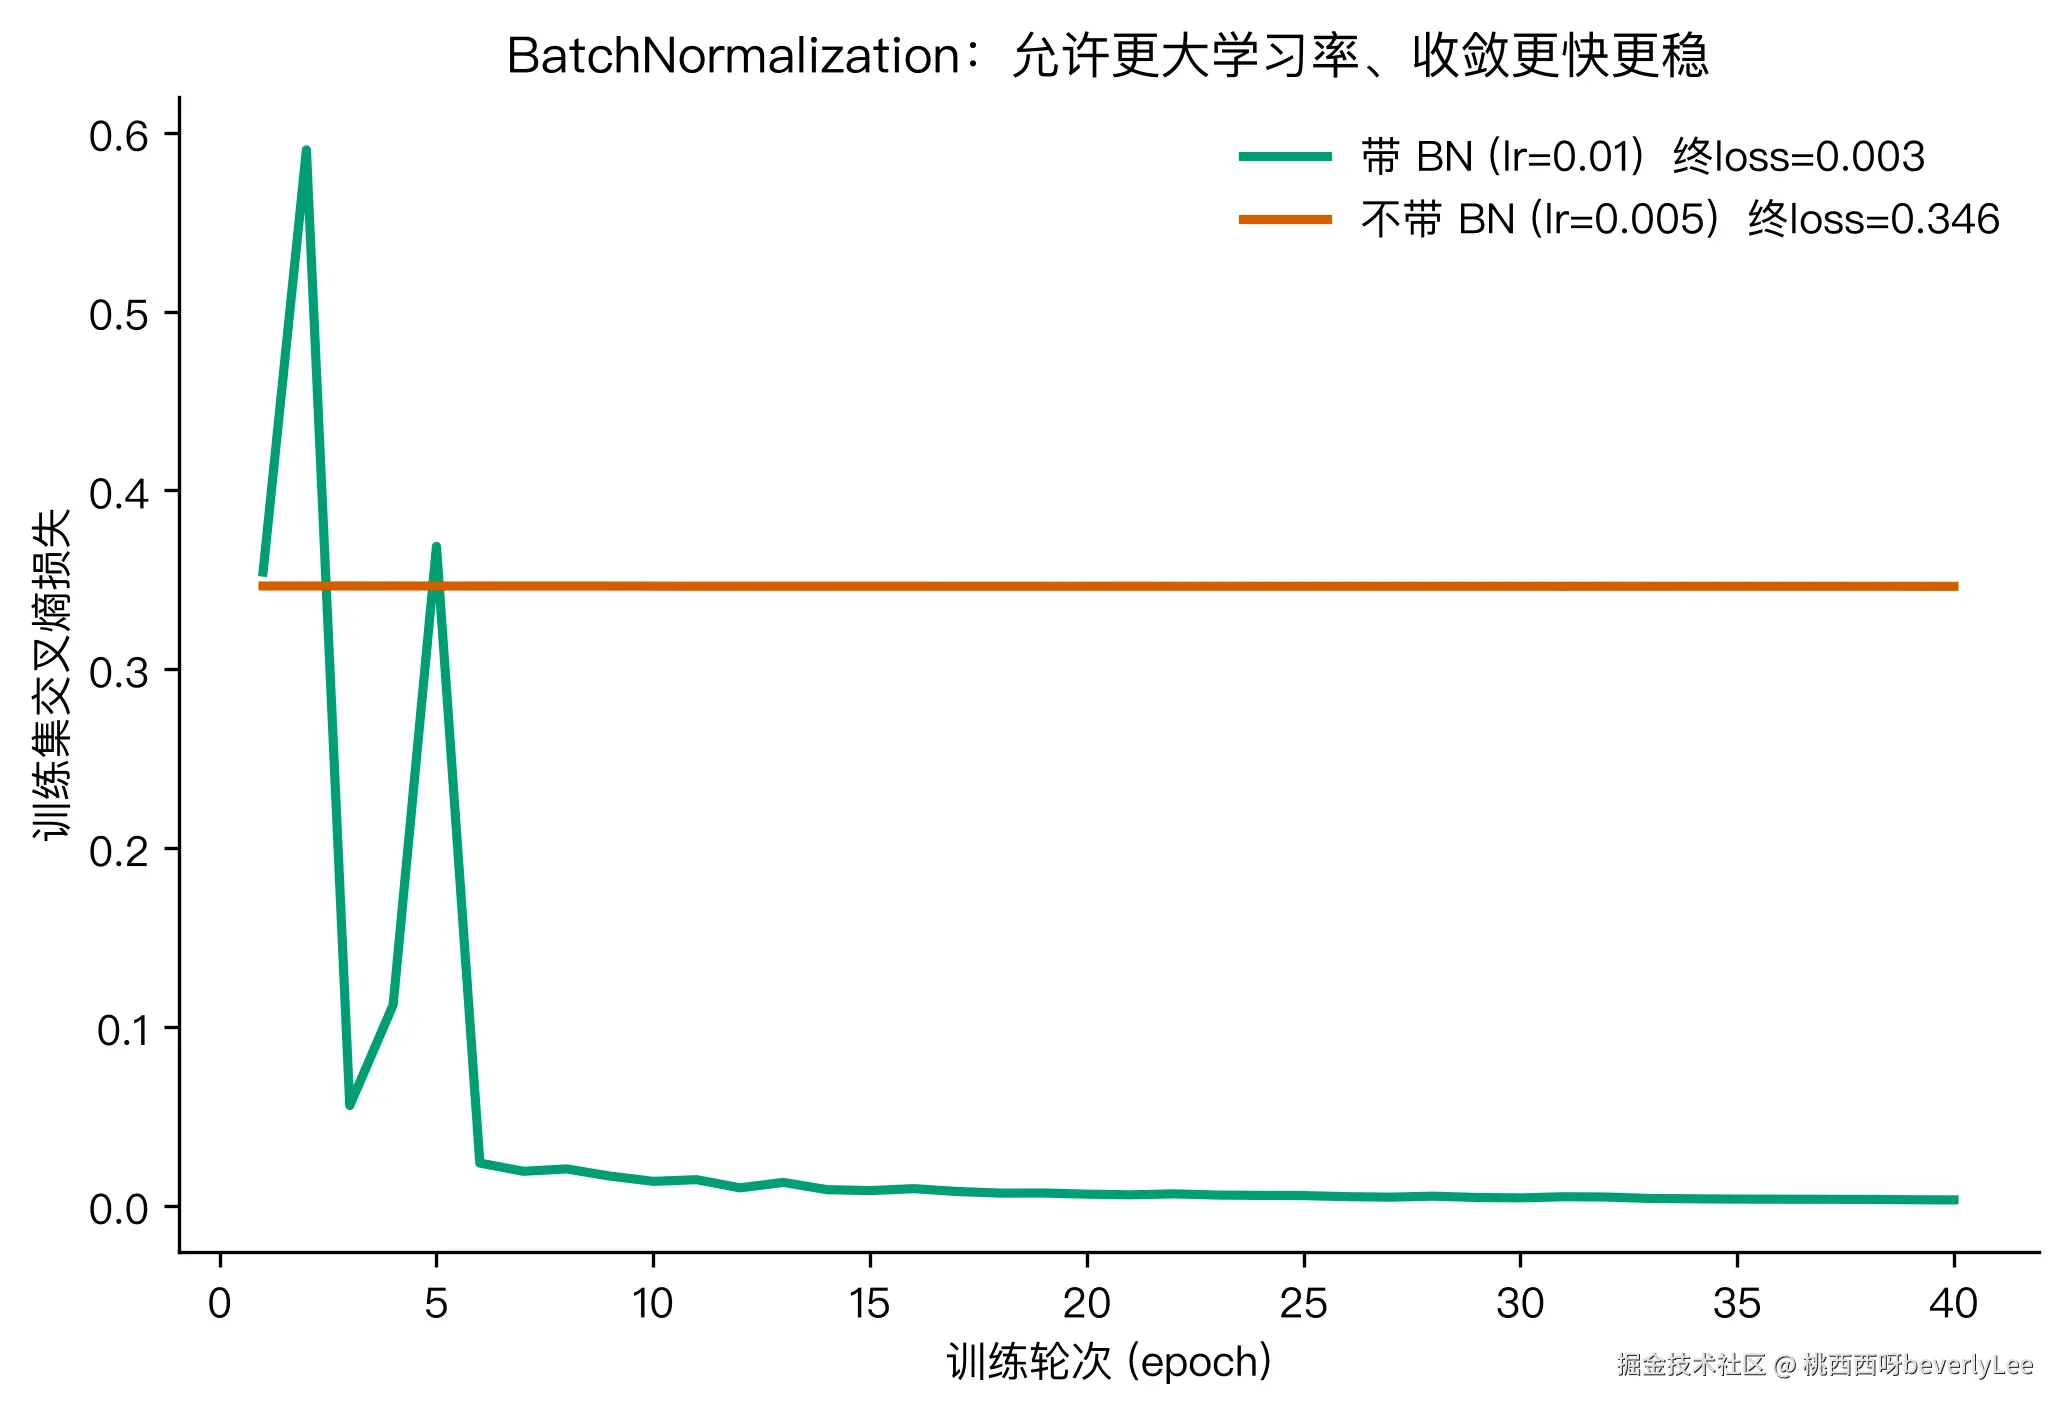
图 7 里绿线是带 BN 的,橙线是不带 BN 的。绿线在第三个轮次冲到 0.59 然后掉下来,之后一路走到 0.003;橙线从头到尾贴着 0.346 躺着,几乎是一条水平线。为什么差这么多?
这里要讲一个概念,内部协变量偏移。名字拗口,意思很直白:网络一层层算,前一层参数一变,后一层看到的输入分布就跟着变。训练时每走一步,每个卷积层的权重都在动,第二层卷积面对的输入,均值和方差一直在漂。后一层像个厨师,刚适应了这锅汤的咸淡,前一层又加了一勺盐。层数越多漂得越厉害,学习率稍微大一点就乱套。第二组卡住,就是因为没有 BN 兜底,学习率只能压得很小,每步挪一点点,四十轮还没走出起点。
BN 干的事很简单,在每一层输出后面插一道标准化。对每个通道,把这批样本的均值 μ 和方差 σ² 统计出来,每个数减均值、除标准差,拉成均值 0、方差 1 的分布:
x^=(x−μ)/√(σ2+ε)
ε 是个很小的数,比如 0.00001,只是防止分母为 0。
光拉成标准分布有个问题。万一这一层本来就需要一个非 0 均值的分布,硬拉回去反而把有用的信息抹掉了。所以 BN 又加了两个可学参数 γ 和 β,做一次缩放和平移:
y=γ⋅x^+β
γ 和 β 跟卷积权重一样,是反向传播学出来的。需要标准分布时,让 γ 取 1、β 取 0 就行;需要别的分布,网络自己把 γ、β 调到合适的位置。所以 BN 不是死板的归一化,是带可学参数、可以撤销的归一化。
反向传播这一层有意思。因为 y 由 x̂ 算出来,而 x̂ 里含了整批样本的 μ 和 σ²,对某一个样本求梯度时,这个样本自己的值、这一批的均值、这一批的方差,三者缠在一起。顺着链式法则推,结果是
dx=(1/(M⋅σ))⋅(M⋅dx^−Σdx^−x^⋅Σ(dx^⋅x^))
M 是这一批的样本数,dx̂ 是从后面传上来的梯度。方括号里三项,第一项是这个样本自己的贡献,后两项是均值和方差被改动带来的连带影响。我第一遍写代码时只留了第一项,漏了后两项,结果梯度算错,loss 死活不降,画出来的曲线跟不带 BN 那条橙线长得一模一样,补上之后绿线才掉下去。这个坑写出来给你避雷:BN 的反向不是简单的逐元素缩放,中间那两个减项一个都不能少。
还有个容易被忽略的工程细节。训练时 BN 用当前这一批样本的均值和方差,测试时你手上只有一张图,凑不出一批。标准做法是训练过程中记一个均值和方差的滑动平均,测试时用这个记下来的值。所以 BN 在训练和推理两种模式下行为不一样,我在脚本里给 BN 的 forward 留了 training 开关,训练时为真、评估时为假。很多人第一次复现 BN 出问题,就是忘了切这个模式。
批大小也影响 BN 的效果。均值和方差是从这一批样本统计出来的,批太小,统计量本身就很多噪声;批够大才稳。我这次批大小用 20,对 300 张训练图算合适。
BN 还有个让人喜欢的作用,它让网络对权重初始化没那么挑。我第一层卷积用的是 He 初始化,本意是让前向传播时信号的尺度保持住,有了 BN,即使初始化稍微偏一点,后一层也能拉回来。
最后看看带 BN 那个模型错在哪。测试集 100 张图,结果是这样。 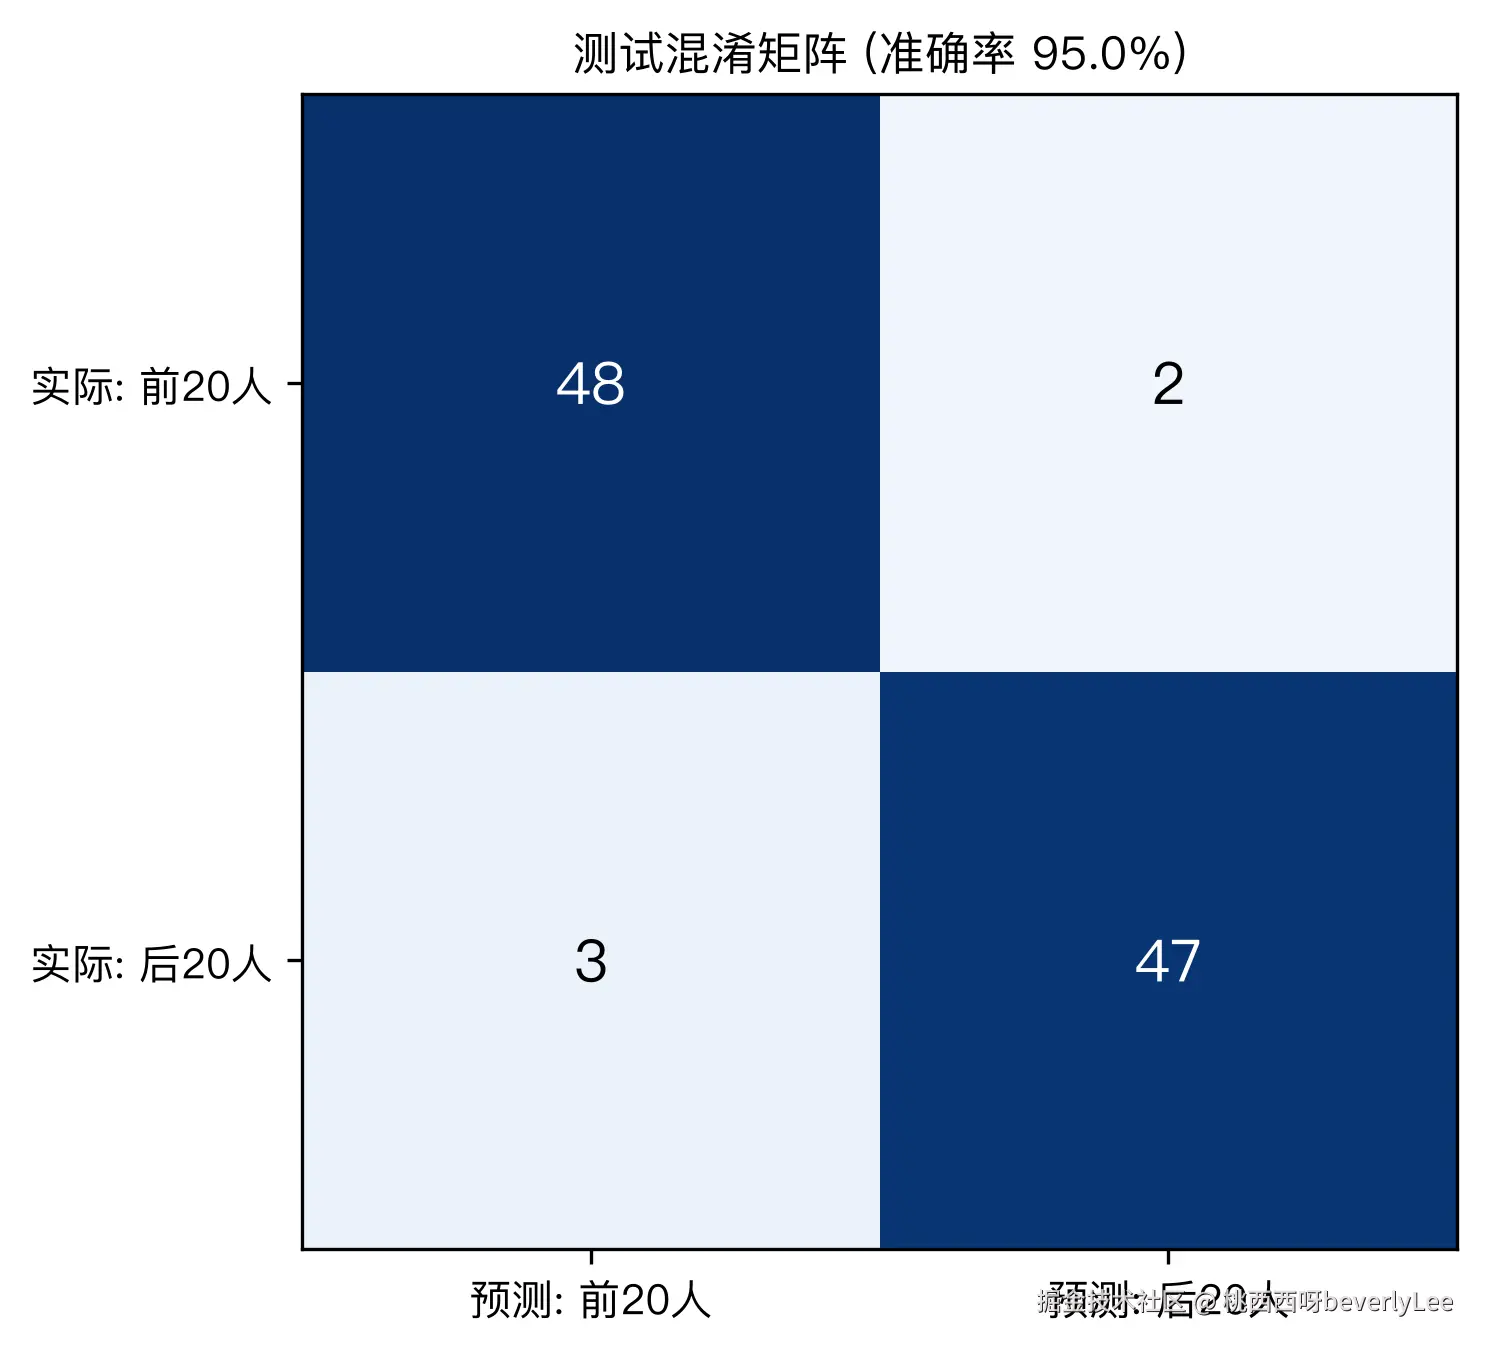 图 8 是混淆矩阵。左上 48 张是"实际第一类、也判成第一类",右下 47 张同理,正确的一共 95 张。错的 5 张里,2 张把第一类判成了第二类,3 张反过来。100 张错 5 张,对一个从零写、只训 40 轮的小网络,我认为可以接受。错的那几张,多半是光照或角度比较特别的样本。
回到开头那个问题
机器看懂一张脸,靠的是把像素当成一张图,让卷积层拿着小窗口在脸上滑动,用共享的权重把局部的明暗图案抽成特征图。权值共享让参数量比全连接少了四百多倍,代价是单个核看得很窄,只能靠层层堆叠去覆盖更大的结构。层一多,前层参数变化会让后层的输入分布漂移,训练又慢又不稳,BN 用一次标准化加两个可学参数把它拽回稳定,于是网络能用更大的学习率,最后在这个任务上拿到 0.95 的准确率。
三个值得记住的点
-
卷积的核心不是"卷积"这个运算,是局部感受野加权值共享这套组合。前者控住感知范围,后者控住参数量。
-
参数量能算得很具体。同样把 64×64 变成 8 通道,全连接要 32776 个参数,卷积只要 88 个,按纯权重口径差了约 410 倍。图越大,这个差距越大。
-
BN 的作用是稳定每一层的输入分布,让优化面更平坦、允许更大的学习率。但它的收益有条件:不带 BN 时,小学习率会卡在平台学不动,大学习率虽不一定爆炸但泛化更差。别迷信"没 BN 必爆"。
复现方法
代码、数据、配图都在 GitHub 上,你可以自己跑一遍,文章里的每个数字都能原样复现:
- 训练脚本:github.com/beverlyLee/...
- 全部数字:github.com/beverlyLee/...
- 整个篇目目录:github.com/beverlyLee/...
跑法:
bash
git clone git@github.com:beverlyLee/ai-guanxingji.git
cd ai-guanxingji/M14_CNN_batch_norm
pip install -r requirements.txt
python code/train_cnn.py
python code/make_figures.py
python code/make_extra_figures.py
数据集不用手动下,脚本里的 fetch_olivetti_faces 会自动从 scikit-learn 拉,1.4 兆。我用的是纯 numpy 手写的 CNN,没有 torch 也没有 TensorFlow,卷积、池化、BN 的前向和反向都是一行行写出来的,方便你对照上面的公式看每一步。整篇跑完 CPU 五分钟,笔记本就能扛。
最后想问你
如果这篇让你把卷积和 BN 的关系理清了,点个收藏,后面继续讲解深度学习有关知识。