【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
224、【AI】【模型部署】基座模型研究:Qwen2 架构总览与 config 对照
背景
上篇 blog
【AI】【模型部署】从 Notebook 到接口:把模型包成 HTTP 推理服务
把模型从 Notebook 搬进了服务:model_utils.py 里 load_model 只在启动时加载一次、chat 负责拼模板→生成→解码,再用 FastAPI 暴露 /chat;实测 55 tokens / 3.2s / 约 17 tok/s,并发两请求被串行处理;并对照了 EAS 的托管能力。到这里"跑起来、服务化"已经打通,但模型本身仍是黑盒 ------from_pretrained 一行就把 5 亿参数装好了,里面到底由什么组成没交代。本篇起转向研究基座 :以 transformers 内置的 modeling_qwen2.py(500 行)为源码,以 config.json 为图纸,把 Qwen2 的结构与数据流拆开看------边读源码、边做实验、边复现
模型部署
前面几篇解决了"怎么用",从这篇开始解决"里面是什么"。研究基座最幸运的一点是:实现代码就在本机 ------transformers 装了哪个模型,它的建模源码就在 site-packages 里;再配上一份 config.json,等于拿到了"图纸 + 施工图"。
🔍 材料清单:三个文件看透一个基座
| 材料 | 位置 | 作用 |
|---|---|---|
modeling_qwen2.py |
transformers/models/qwen2/(500 行) |
网络结构实现(真正的代码) |
config.json |
模型目录 | 超参声明(决定"搭多大") |
model.safetensors |
模型目录 | 权重数值(前面解剖过) |
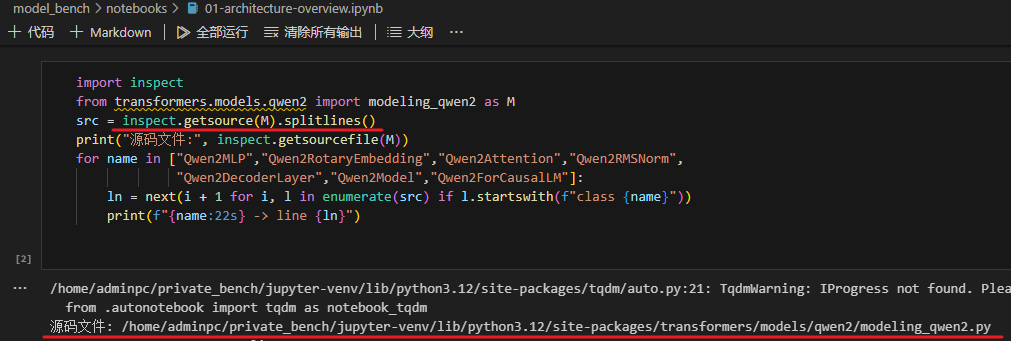
本篇实验都在 model_bench/notebooks/ 的 Notebook 里跑(复用之前的 venv),先把"图纸"读出来。
为什么以源码 为准而不是论文/文档:论文写的是设计意图,代码才是实际执行的规格------张量形状、初始化方式、边界处理都藏在源码里;而且不同版本的实现细节会有差异,读当前 venv 里这份代码,拿到的才是"这台机器上真正在跑"的事实。这也是整个系列的方法:每一节都回到源码那一行。
🧩 config.json:基座的图纸
把关键字段打印出来(实测值):
python
import json, pathlib
MODEL_DIR = pathlib.Path.home() / ".cache/modelscope/models/Qwen--Qwen2.5-0.5B-Instruct/snapshots/master"
cfg = json.loads((MODEL_DIR / "config.json").read_text())
for k in ["model_type","num_hidden_layers","hidden_size","num_attention_heads",
          "num_key_value_heads","intermediate_size","vocab_size","rope_theta"]:
    print(f"{k:24s} = {cfg.get(k)}")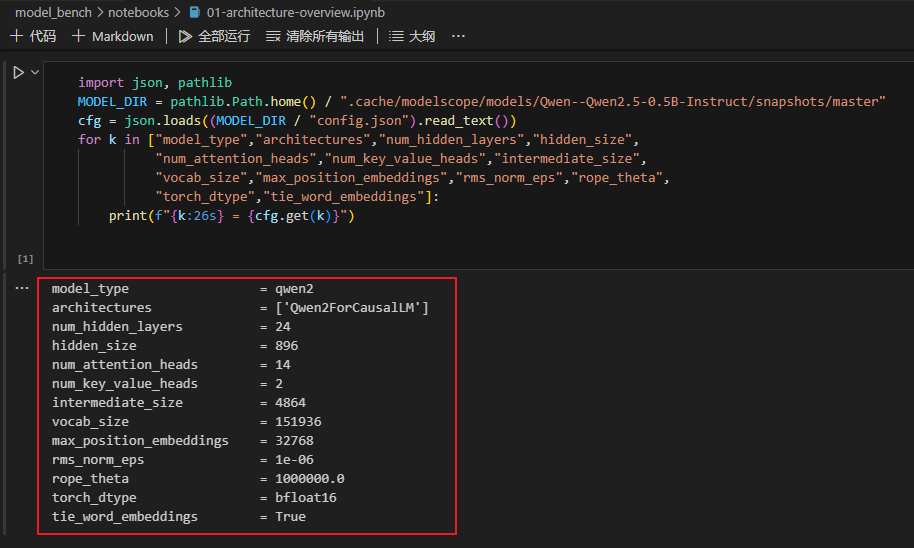
实测输出:model_type=qwen2、24 层、hidden_size=896、14 个注意力头、2 个 KV 头 、intermediate_size=4864、vocab_size=151936、rope_theta=1000000.0。这份图纸里已经藏着后面要讲的几个关键设计:GQA(14 vs 2) 、RoPE(rope_theta) 、SwiGLU(4864 的扩宽)。
🧩 config 字段 → 代码类:图纸怎么变成代码
from_pretrained 读 config 后,由这些类把网络搭起来。用 inspect 列出每个类的行号(实测):
python
import inspect
from transformers.models.qwen2 import modeling_qwen2 as M
src = inspect.getsource(M).splitlines()
for name in ["Qwen2MLP","Qwen2RotaryEmbedding","Qwen2Attention","Qwen2RMSNorm",
             "Qwen2DecoderLayer","Qwen2Model","Qwen2ForCausalLM"]:
    ln = next(i + 1 for i, l in enumerate(src) if l.startswith(f"class {name}"))
    print(f"{name:22s} -> line {ln}")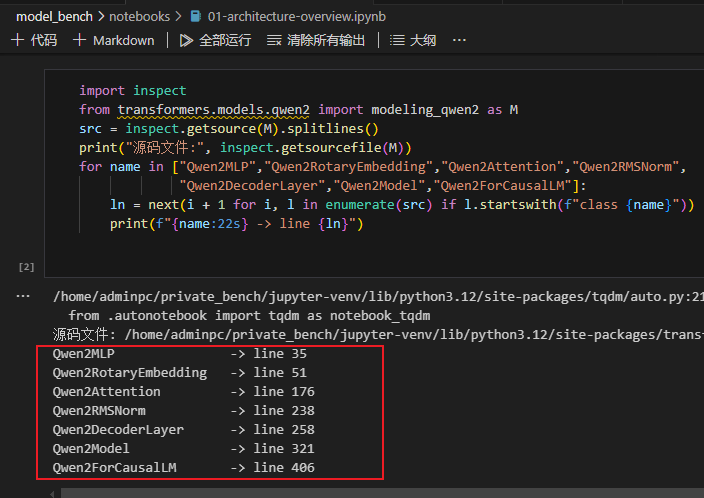
| 类 | 行号 | 职责 |
|---|---|---|
Qwen2MLP |
35 | 前馈网络(SwiGLU,Swish-Gated Linear Unit,Swish 门控线性单元) |
Qwen2RotaryEmbedding |
51 | 旋转位置编码 RoPE(Rotary Position Embedding,旋转位置编码) |
Qwen2Attention |
176 | 注意力(GQA,Grouped-Query Attention,分组查询注意力) |
Qwen2RMSNorm |
238 | RMS 归一化 |
Qwen2DecoderLayer |
258 | 一层:注意力 + MLP(Multi-Layer Perceptron,多层感知机) |
Qwen2Model |
321 | 24 层堆叠 + 词嵌入 |
Qwen2ForCausalLM |
406 | 加 LM 头,输出下一个词概率 |
这张表就是后续几篇的"目录":226 讲 RMSNorm(Root Mean Square Normalization,均方根归一化)、227 讲 RoPE、228 讲 GQA、229 讲 SwiGLU------本篇先把它们的位置和关系看清。
顺带记下三个"伏笔",它们都是从 config 数值直接读出来的:num_attention_heads=14 与 num_key_value_heads=2 不相等 → 用了 GQA (228 详读 repeat_kv);rope_theta=1000000 是 RoPE 的频率基数(227);intermediate_size=4864 比 hidden_size=896 大 5 倍多 → SwiGLU 的扩宽层(229)。带着这三个问题往下读,源码会一处处给出答案。
🧩 加载模型:把结构打印出来
一行加载后直接打印模型对象,就能看到搭好的结构(节选):
text
Qwen2ForCausalLM(
  (model): Qwen2Model(
    (embed_tokens): Embedding(151936, 896)
    (layers): ModuleList( (0-23): 24 x Qwen2DecoderLayer
      (self_attn): q_proj 896->896, k_proj/v_proj 896->128, o_proj 896->896
      (mlp): gate/up 896->4864, down 4864->896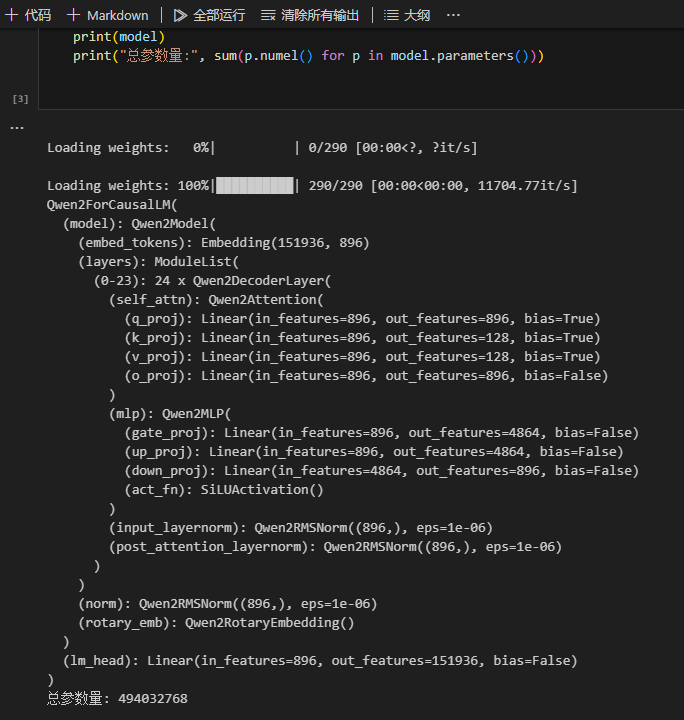
两处能立刻读出信息:k_proj/v_proj 输出只有 128 (= 2 头 × 每头 64 维),而 q_proj 是 896(14 头 × 64)------这就是 GQA ;gate/up_proj 把 896 扩到 4864 再压回 896,这就是 SwiGLU 的 MLP 。实测总参数量 494,032,768(0.494B),与"0.5B"命名吻合。
🧩 一层 DecoderLayer 的骨架(源码)
24 层里的每一层都长一个样,源码(modeling_qwen2.py:279-297,省略参数)把骨架写得很直白:
python
residual = hidden_states
hidden_states = self.input_layernorm(hidden_states)      # 注意力前归一化
hidden_states, _ = self.self_attn(hidden_states, ...)
hidden_states = residual + hidden_states                 # 残差
residual = hidden_states
hidden_states = self.post_attention_layernorm(hidden_states)
hidden_states = self.mlp(hidden_states)
hidden_states = residual + hidden_states                 # 残差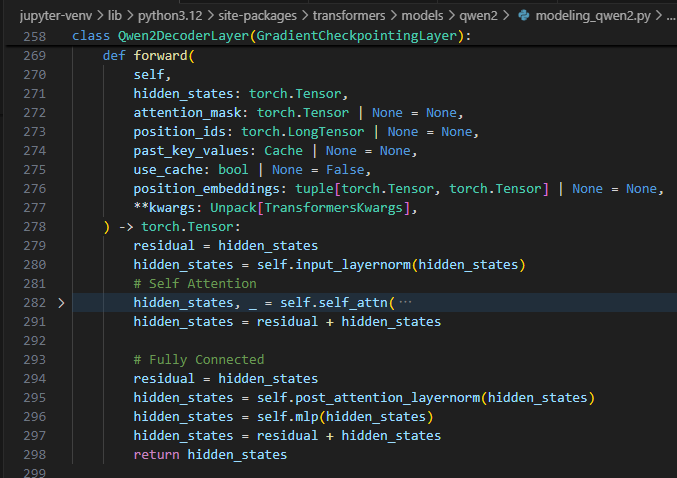
模式是 "归一化 → 子层 → 残差相加" 重复两遍(先注意力、后 MLP),而且归一化在子层之前(pre-norm)。这套结构不是随意的:残差保证梯度能直通深网络,pre-norm 让深层训练更稳------后面复现时会亲手体会去掉它们会怎样。
🧩 一次前向:从文字到 logits
最后看数据怎么流。给模型一个单词 "hello",用 hook 抓中间形状(实测):
python
inputs = tok("hello", return_tensors="pt")
print("input_ids :", tuple(inputs["input_ids"].shape))
with torch.no_grad():
    out = model(**inputs)
print("logits    :", tuple(out.logits.shape))
same = model.lm_head.weight.data_ptr() == model.model.embed_tokens.weight.data_ptr()
print("lm_head 与 embed_tokens 共享权重:", same)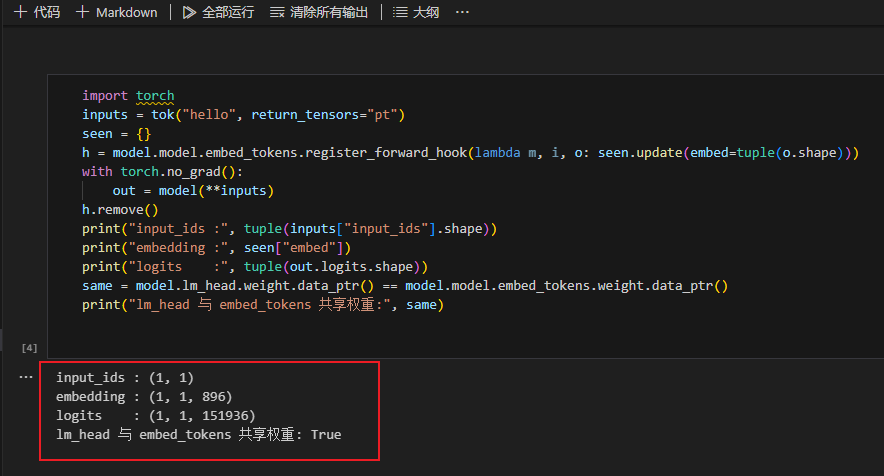
实测:"hello" 被分词成 1 个 token (id 14990),input_ids 形状 (1,1);经词嵌入变成 (1,1,896);最终 logits 形状 (1,1,151936)------词表里每个 token 一个分数 ,取最大(或采样)就是下一个词。lm_head 与 embed_tokens 共享同一份权重 (tie_word_embeddings=true),所以张量清单里没有独立的输出层。
数据流一句话串起来:
text
input_ids(1,1) → embed_tokens → (1,1,896)
  → 24 × DecoderLayer(每层:RMSNorm→GQA→残差;RMSNorm→SwiGLU→残差)
  → 最终 RMSNorm → lm_head → logits(1,1,151936) → 下一个 token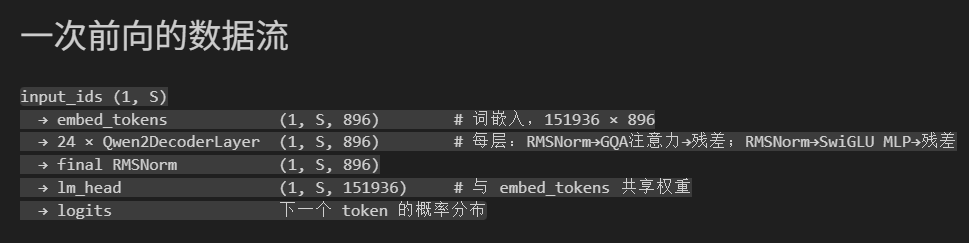
📌 一句话记忆
研究基座的第一站是"图纸对照":
config.json的字段(24 层、hidden 896、14 头/2 KV 头、intermediate 4864、rope_theta、tie_word_embeddings)一一对应modeling_qwen2.py里的类(MLP/RoPE/Attention/RMSNorm/DecoderLayer/Model/ForCausalLM);加载后打印结构能看到 GQA(k/v 投影只到 128)与 SwiGLU(896→4864→896),一次前向把input_ids(1,1)变成logits(1,1,151936)------后续几篇就按这张类表逐个拆开读源码并亲手复现。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!更多内容见下篇 blog