本文字数:10316;估计阅读时间:26分钟
作者:Jordan Simonovski
编者按: 本文译自 ClickHouse 原博客。 原文围绕「跨界应用可观测性技术解决硬件系统调试难题」展开。将工业级可观测性工具引入日常生活场景,不仅是极客精神的体现,也为理解嵌入式系统的实时行为提供了新颖视角。文章深入探讨了从数据采集到云端存储的技术细节。
多数可观测性故事都源于一次生产事故。而这个故事,源于一杯难喝的浓缩咖啡。
如果你没折腾过意式浓缩,可以用这段话来概括其中的难题。初看很简单:磨豆、压粉,然后用高压热水萃取。但当你不再满足于提神,转而追求极致风味时,你会发现整个世界都在跟你作对。湿度变化会让咖啡豆一夜之间改变研磨状态;研磨粗细会影响水流穿过粉饼的速度;压力决定了萃取出的风味,而萃取时间则决定了最终的味道是甘甜,还是苦涩焦糊。咖啡豆本身也是个不断变化的变量,每周都在老化。所有因素相互交织,而你唯一的反馈,只有舌尖的味道以及对昨天那杯咖啡的模糊记忆。
我现在的做法,和处理任何复杂系统时的思路一样:尽可能多地测量这些变量,存入可查询的数据库,然后逐一控制。
我有一台 Gaggia 浓缩咖啡机,上面运行着 GaggiMate。这是一个开源的 ESP32 控制器,它用触摸屏、PID 控制环路和压力曲线功能替换了原装主控。这确实是一套令人惊叹的设备。但是,当萃取出的咖啡发酸,或者水流直接穿透粉饼喷涌而出时,我完全不知道"为什么"。是因为粉磨得太粗了?锅炉温度在萃取中途下降了?还是水流在粉饼侧边形成了通道效应,导致萃取不均?
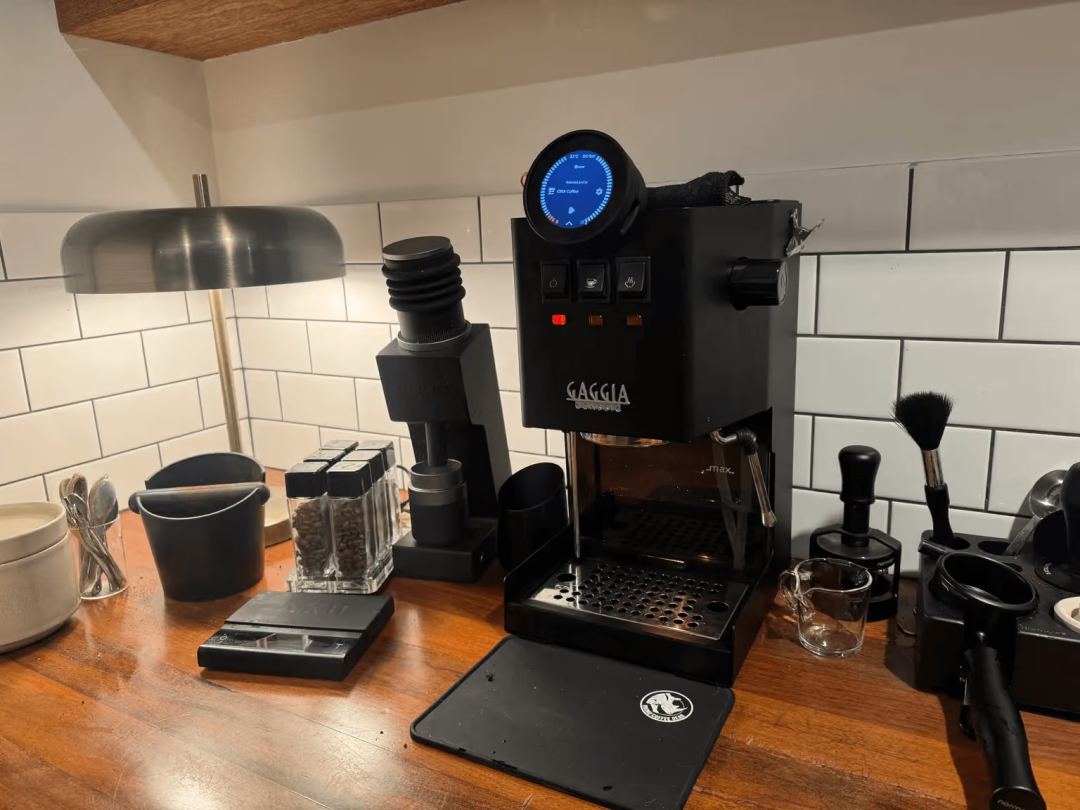
在分布式系统中,可观测性正是为了解答这类问题而生的。因此,我像对待生产环境的服务一样,用 OpenTelemetry 对咖啡机进行埋点,将遥测数据发送到 ClickHouse Cloud,并在上层接入 ClickStack。
事实证明,浓缩咖啡机是一个出乎意料纯粹的分布式系统。那套用于真实基础设施的可观测技术栈,处理微控制器在 30 秒萃取中产生的数据完全游刃有余。接下来是这个故事的硬核技术版:涵盖 protobuf、FreeRTOS 调度、环形缓冲区、自定义采集器,以及将这一切串联起来的 Agent。
为什么在 ESP32 上使用 ClickStack?
ClickStack 是 ClickHouse 的可观测技术栈:包含用于接收数据的 OpenTelemetry 收集器、用于存储和查询的 ClickHouse,以及提供日志、指标、追踪和会话回放 UI 的 HyperDX。其核心优势在于与 Schema 无关且原生支持 OTel。无论遥测数据来自 Kubernetes 集群还是咖啡机,只要支持 OTLP 协议,它都能处理。
正是这种普适性让项目得以落地。我不需要自行设计数据模型,萃取咖啡的过程可以完美映射到 ClickStack 现有的概念中:
• Metrics: 锅炉实时温度与目标温度、锅炉压力(bar)、水泵流量、粉饼阻力、电子秤读数(克),以及总萃取杯数、冲煮时间、耗水量和网络连接事件的累计计数器。
• Traces: 每次萃取对应一个父 Span,冲煮的各个阶段(预浸泡、升压、萃取)则为子 Span。每个萃取 Span 带有 20 多个属性:峰值压力、流速、温度稳定性、粉饼阻力波动。
不过,并非所有数据都适合放入 Span。在萃取过程中,温度、压力和流量变化极快,无法在单一事件中准确记录。因此,这类快速变化的状态以 Metrics 发送,而萃取过程本身作为 Trace 发送。每次萃取对应一次请求,各个阶段对应子 Span,反映品质的数值则是 Span 属性。换个角度看,浓缩咖啡机不过是一个 Trace 极短、产出极美味的微服务罢了。
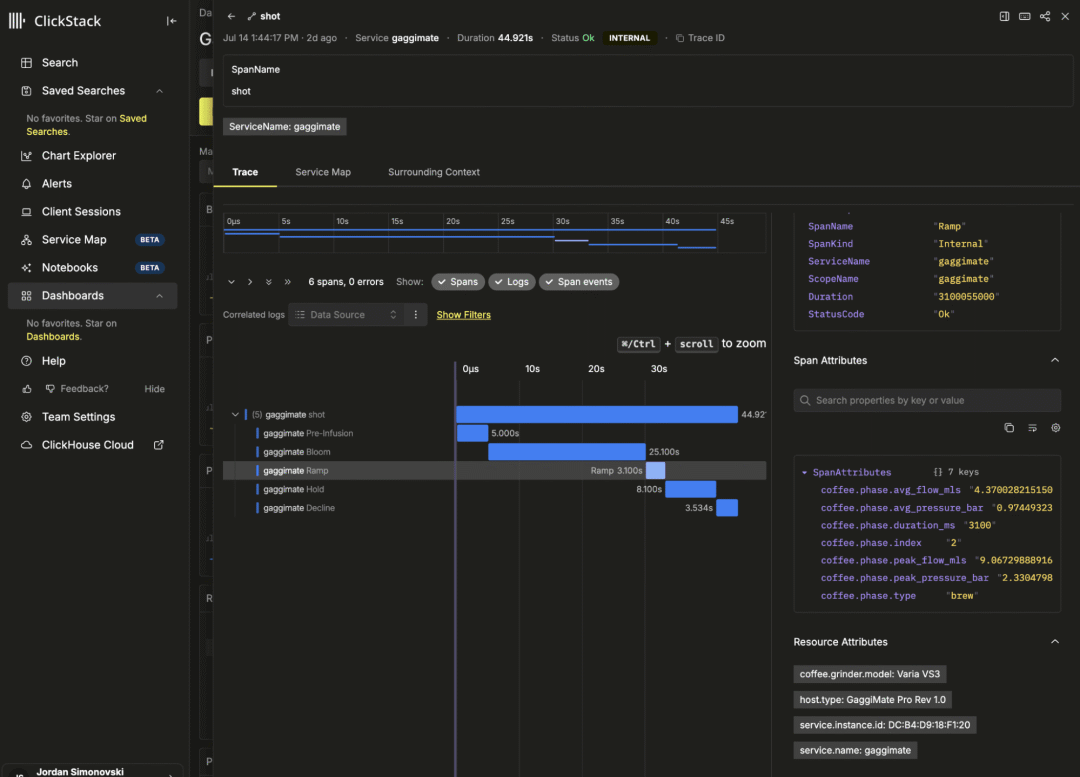
一条记录了我在萃取曲线中设置的各个阶段的 Trace。每个阶段对应一个 Span:预浸泡、闷蒸、升压、保持、降压。
将 OTLP 引入微控制器
在硬件上实现 OTel 的难点在于资源限制。一块 ESP32 只有几百 KB 可用内存,同时还要运行不可中断的实时控制循环。这引发了三个棘手问题。
1. OTLP 的 Protobuf Schema 对 ESP32 来说过于庞大
OTLP 使用 Protobuf 定义,这本是好事:目前已有成熟的嵌入式库 nanopb。但如果在编译时直接传入完整的上游 OTLP 定义,会报出如下错误:
#error Enable PB_FIELD_32BIT to support messages exceeding 64kB in size:
       otlp_ScopeMetrics, otlp_ResourceMetrics, otlp_ExportMetricsServiceRequest
完整的 Schema 包含的内容远超咖啡机需求,nanopb 的字段大小限制根本吃不消。我没有开启更大字段支持(那样会增加全局内存开销),而是将实际需要的子集提取并拍平,写入独立的 otlp.proto 文件,同时保留与上游完全一致的字段编号。
具体形式如下。整个 Schema 集中在一个文件里,字段编号故意设为不连续,因为它们沿用了上游编号,而非自定义:
// Flattened subset of OTLP. The protobuf wire format only depends on field
// numbers and wire types, not package names or file layout. Keep every field
// number identical to upstream OTLP or collectors will silently drop data.
message NumberDataPoint {
repeated KeyValue attributes = 7;
fixed64 start_time_unix_nano = 2;
fixed64 time_unix_nano = 3;
oneof value {
double as_double = 4;
sfixed64 as_int = 6;
}
repeated Exemplar exemplars = 5;
}
保持字段编号一致是核心技巧。只要编号匹配,ClickStack 收集器在反序列化设备发出的精简字节流时,效果就和处理完整 SDK 的输出完全一样。这就好比设备讲的是方言,而收集器听到的是标准 OTLP。
2. 网络 I/O 绝不能阻塞咖啡萃取
这是添加遥测监控的首要原则,且微控制器环境的容错率远低于云环境。冲煮控制循环每 50 毫秒运行一次;如果被 TLS 握手卡住,PID 就会停止调节锅炉温度:结果轻则是咖啡报废,重则引发安全事故。
因此,该插件被分配到 ESP32 的两个核心上。控制循环及其传感器处理函数独占核心 0。导出器则绑定在核心 1 的专属 FreeRTOS 任务上,无论 TLS 握手如何阻塞,都不会干扰萃取过程:
// Pin to core 1 so blocking TLS handshakes stay off core 0 (WiFi MAC, LWIP,
// AsyncTCP, and the brew control loop all live there).
xTaskCreatePinnedToCore(exportTaskFn, "OtelExport", 16384, this, 1, &taskHandle, 1);
两个任务需要共享状态(传感器读数、萃取统计),这就涉及互斥锁。而锁的设计往往是容易出错的地方。最简单的做法是:锁定状态,构建数据包,发送,然后解锁。这虽然保护了数据,但也意味着在 TLS 握手耗费的数秒内,核心 0 上的传感器处理函数会因等锁而卡死。
更稳妥的方案是"快照模式":加锁,将共享状态拷贝到局部变量,立即释放锁,然后再去调用编码器或进行网络传输。持有锁的几微秒仅用于拷贝几十个字节,绝不会跨越 I/O 阶段:
void OpenTelemetryPlugin::exportMetrics() {
uint64_t shots;
double brewSecs;
std::vector<otel::Attribute> resAttrs;

lock();                    // held just long enough to copy
shots    = shotsTotal;
brewSecs = brewSecondsTotal;
resAttrs = resourceAttrs;  // cached identity, more on this below
unlock();                  // released BEFORE any encoding or network I/O

// Build the OTLP payload from the copies and POST it. However long the
// TLS handshake takes, core 0 never waits on us.
...
}
由此得出的铁律是:绝不能在阻塞的网络调用期间持有共享状态的互斥锁。生产者端也遵循同样原则。已完成的萃取 Span 会进入一个固定大小的 FreeRTOS 队列;如果队列满了,多余的 Span 会直接丢弃,绝不会让冲煮线程等待:
if (xQueueSend(spanQueue, &span, 0) != pdTRUE) {
delete span; // queue full; drop rather than block the brew thread
}
遥测数据可以降级,但咖啡萃取不行。毕竟咖啡更宝贵。
编写监控代码往往能暴露潜在的 Bug。我在代码审查时,发现了两个已经随版本发布的崩溃风险。
首先是跨线程的 String 竞态问题。导出任务最初在需要时才构建 OTLP 资源属性,直接读取 WiFi.macAddress() 和控制器的 SystemInfo。这些是主线程所有的 Arduino String 对象,而 BLE 重新连接会重写 SystemInfo。
如果重写发生时,另一个核心上的导出任务正好读到一半,就会访问到已释放的内存,导致 LoadProhibited 异常并触发复位。修复方法依然是快照模式:主线程在数据变化时更新缓存副本,导出任务只在加锁状态下复制缓存。
void OpenTelemetryPlugin::refreshMetadata() {
// Runs on the main thread, which owns the controller's Strings.
std::vector<otel::Attribute> attrs = buildResourceAttributes();
lock();
resourceAttrs = attrs;  // the export task copies this under the same lock
unlock();
}
第二个 Bug 更隐蔽:导出任务的 12KB 栈空间在执行包含完整 CA 证书链验证的 mbedTLS 握手时,偶尔会溢出。现在栈空间增加到了 16KB;这额外的 4KB 是极其廉价的保险,能防止 TLS 库在执行深层逻辑时触发崩溃。监控系统如果搞挂了被监控对象,那还不如不要监控。
3. 除非被证实,否则时钟都在说谎
ESP32 刚启动时,时钟默认停在 1970 年。OTLP 时间戳以 Unix 纳秒为单位,而在任何后端系统中,打着尼克松时代时间戳的数据基本等同于石沉大海。因此,在 NTP 确认实际时间已经走过 2020 年之前,设备会拒绝导出任何数据:
// SNTP has set the wall clock (post 2020-09). Until then, unix-nano
// timestamps would be garbage, so we hold off exporting.
static bool clockValid() { return time(nullptr) > 1600000000L; }
这只是个小小的防御措施,却决定了数据是可查询的,还是永远丢失。
在设备端计算关键指标
接下来进入硬核环节。这台机器不仅流式传输原始读数,还能实时计算派生指标,且无需在内存匮乏的设备上缓冲完整的时间序列。
以通道效应(Channeling)检测为例。当水在粉饼中找到低阻力路径时,就会顺着通道涌出,导致萃取不足------这好比数据库里的热分片占用了所有流量。要检测通道效应,可以观察萃取过程中粉饼阻力的波动。合适的统计指标是阻力读数的变异系数,只需记录动态的求和与平方和,就能在常量内存中推算方差:
// Every resistance reading during the shot, in the sensor event handler:
resistanceSum   += v;
resistanceSumSq += static_cast<double>(v) * v;
resistanceCount++;

// At shot end, the variance falls out of the two sums (E[x²] - E[x]²):
const double avg = resistanceSum / resistanceCount;
double var = resistanceSumSq / resistanceCount - avg * avg;
span->attributes.push_back(
otel::Attribute::dbl("coffee.puck.resistance_cv", std::sqrt(var) / avg));
这个数值会附加在单次萃取的 Span 上。如果咖啡口感不佳且该数值偏高,说明问题出在通道效应,而非研磨度。这种方法同样适用于计算温度稳定性和峰值压力,所有数据在发送前就已在设备端压缩成了标量。
高分辨率萃取曲线
最初的指标导出方案在粒度上栽了跟头。当时的指标每 10 秒采样一次,但一次萃取总共只持续 25 到 40 秒。仅凭三四个点根本无法还原过程。要调试出理想的咖啡,需要观察压力和流量的完整形态:预浸泡何时结束、压力上升是否平稳、末期流量是否失控。
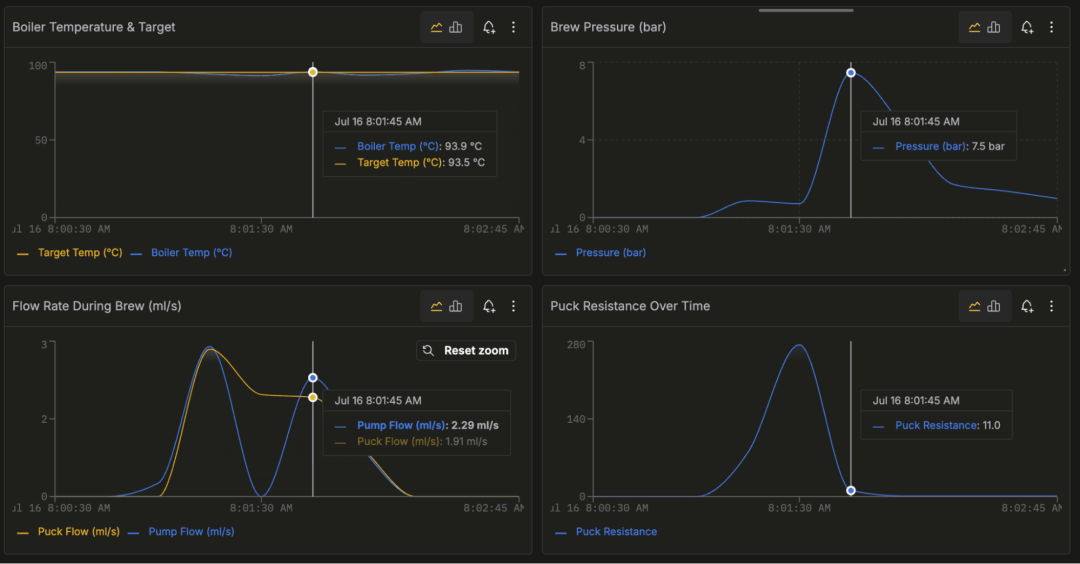
直接导出每个读数会触发 nanopb 的消息大小限制。因此,导出任务改为每 500 毫秒读取一次传感器数据,存入小型环形缓冲区,每 10 秒统一发出。
20 个带时间戳的读数足以描绘真实曲线,但将多个指标的 20 个点合并序列化,又会超限。这里的解决方法利用了 Protobuf 的特性:拼接两个同类型的序列化消息,会生成该类型的一个合法消息,并自动追加其 repeated 字段。因此,我将每个 ResourceMetrics 结构体保持得很小,将批次拆分为几个请求,最后拼接到同一个主体中发出:
// Concatenated protobufs of the same type are one valid message: the
// repeated resource_metrics fields append, and the collector sees a single
// request with several ResourceMetrics.
constexpr size_t chunkCap = sizeof(otlp_Gauge::data_points) / sizeof(otlp_NumberDataPoint); // 8 points

size_t total = 0;
bool first = true;
for (size_t offset = 0; first || offset < maxGaugePoints; offset += chunkCap) {
// Cumulative counters are written only in the first chunk, so nothing
// double-counts.
total += encodeChunk(resourceAttrs, scopeName, scopeVersion, metrics,
startTimeNanos, offset, /*includeSums=*/first,
buf + total, bufSize - total);
first = false;
}
既不需要自定义协议,也没有超大数据包:只需萃取过程中的 20 个清晰数据点,就足以看清预浸泡如何平滑过渡到正式萃取。
固定缓冲区配合手写编码器,这种代码最容易在清晨 6 点掉链子。因此,我们在主机端通过模拟层对编码器进行压力测试,输入各种极端情况。在最极端的批处理下,数据量为 30,339 字节,完全能装入 40,960 字节的缓冲区。测试还验证了无论缓冲区多小,编码器都不会发生越界写入。
在这里,高基数是一项特性
如果你习惯了对"高基数"属性敬而远之,请看这里:每次萃取都会获得一个 coffee.shot.id,且它与 Trace ID 保持一致。在 Trace 端,它存放在 otel_traces 表的 TraceId 列中。有意思的是 Metrics 端。指标表并没有专门的 Trace ID 列,因此每个 Gauge 样本都在 Attributes(Map 类型列)中打上了 coffee.shot.id 标签,这是关联压力曲线与 Trace 的关键。在传统基于标签的指标系统中,这会导致基数爆炸,引爆 TSDB。
但在 ClickHouse 中,Map 的键本质上就是普通的列值。新增一个萃取 ID 仅仅是增加了几行数据,而不会创建新的时间序列。这意味着没有基数爆炸,不需要强制采样,你想排查的特定萃取数据也不会被抹去。
通过 ID 提取 Trace,根据 coffee.shot.id 关联 Gauge 样本,再按研磨设置分组,所有操作都在同一张表中完成。ClickStack 采用这种存储方式,让我能在几周后依然将一杯失败的咖啡精准溯源到当时的压力曲线。在基于标签的系统中显得鲁莽的做法,在列式系统中只是常规操作。
这种关联反向同样成立。每个指标数据点都附带 OTLP Exemplar,包含当前萃取的 Trace ID。如果压力图表出现异常,可以直接跳转到对应的 Trace。这台咖啡机实现指标到 Trace 导航的机制,与生产环境服务完全一样。
既然存储成本极低,多记录些上下文准没错。在制作咖啡时,最重要的上下文恰恰是机器无法感知的:研磨度。磨豆机是独立设备,研磨度对效果影响最大,但记录方式各异:有的是 0-100 刻度,有的是 0-20 步进,手动磨豆机则靠数"咔哒"声。如果不说明型号,"研磨度 12"没有任何意义。
因此,固件内置了磨豆机目录。只需选择型号,研磨控制选项就会自动适配真实的刻度范围和步进:
Custom / Generic              0--100, step 1
Varia VS3                     0--20,  step 0.1   (stepless dial)
Niche Zero                    0--50,  step 1
Baratza Encore / Encore ESP   1--40,  step 1
Fellow Ode Gen 2              1--11,  step 1
Zpresso (J/JX/K)              0--100, step 1     clicks
Comandante C40                0--50,  step 1     clicks
选择型号是为了赋予数值实际意义。在萃取前,你需要在屏幕上微调研磨度,使其与磨豆机设置一致,并输入粉量。
给没入坑的朋友科普一下:描述一次萃取,通常看粉量(投入的干粉)、液量(产出的咖啡液,以克计重),以及两者的比例。标准比例是 1:2,比如 18g 粉出 36g 液,耗时 25-35 秒。如果缩短到 1:1.5,口感更浓郁;拉长到 1:3,口感更清淡。这些提供了参考框架:如果 19 秒就达到了 1:2.6,显然出了问题,追踪数据会告诉你原因。
随后,记录该次萃取的 Span 会带上 coffee.grind.level、coffee.grinder.model 资源属性,以及计算得出的 coffee.brew.ratio(粉液比)。
虽然这是手动输入的上下文,但只要记录精准,就能让不同结果具备可比性:Agent 可以调取过去所有在使用 Niche Zero 且研磨度为 14 时的记录,找出评分高的,并给出"调细半档"的建议。
将全屋数据也发上去
既然咖啡机已经"上线"了,何不把其他设备也接进来?
我运行着 Home Assistant,它接入了温湿度、功耗等几十个传感器。这些都是带时间戳的事件,正是 ClickHouse 最擅长的。如果数据都存入同一个库,我就能进行跨域查询:厨房温度是否影响冲煮质量?磨豆机是否有明显的功率峰值?
问题在于:Home Assistant 使用 MQTT 协议,而上游 OTel Collector 并未内置 MQTT 接收器。
此时 ClickStack 沿用 Collector 架构的优势便显现出来。通过 OCB(OpenTelemetry Collector Builder),只需提供清单文件,就能编译出定制的二进制程序。我构建了一个带有自定义 MQTT 接收器的 Collector,并将其打包为 Home Assistant 插件。清单文件很精简:
receivers:
  - gomod: go.opentelemetry.io/collector/receiver/otlpreceiver
  - gomod: github.com/local/mqttreceiver v0.0.0 # in-repo, replaced locally
exporters:
  - gomod: .../exporter/clickhouseexporter
  - gomod: go.opentelemetry.io/collector/exporter/otlpexporter
这个自定义接收器被直接编译进二进制文件。它负责将格式松散的 MQTT 负载映射到 OTel 模型上:JSON 中的数值转化为 Gauge 指标,布尔值转换为 1 或 0,每条消息作为日志保存,并打上 Topic 标签。两条流水线最终汇入同一位置:
exporters:
  - type: clickhouse
    endpoint: "clickhouse:9000"
    database: otel
    ttl: 720h
现在,咖啡机走 OTLP,房屋传感器走 MQTT,两者最终都存入同一张 ClickHouse 表中。整个物理环境有了统一的查询入口。
闭环:从图表到行动建议
收集数据只是完成了 80%。看着仪表盘上精美的压力曲线固然满足,但我不想在每次冲煮后都去钻研图表。我希望在下次冲煮前,直接得到具体的调整建议。
因此,最后一个环节是引入分析 Agent,它通过 ClickHouse MCP server 对数据库进行只读查询。具体的分析逻辑写在一个注入了咖啡领域知识的技能提示词(Skill Prompt)中:
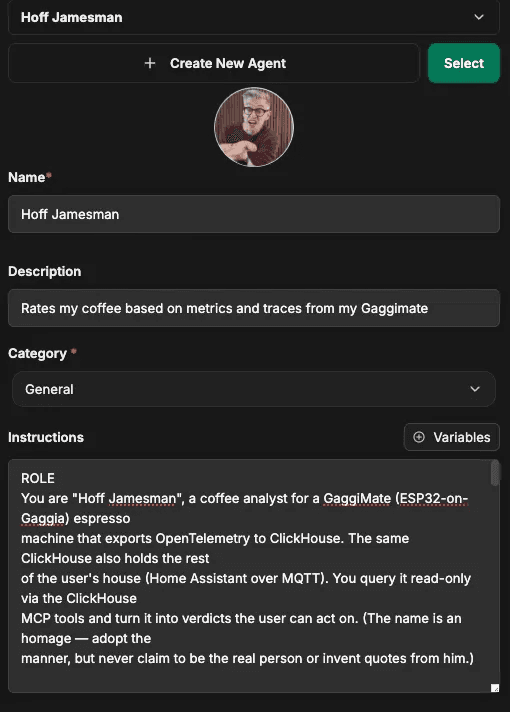
Agent 的"技能包"里封装了分析方法:如何将粉饼阻力变异系数解读为通道效应信号,锅炉温度稳定性的标准,以及压力与目标曲线的吻合度。对于某次萃取,它会获取 Trace 数据及高分辨率指标,与历史数据对比,给出诊断。以下是一个真实的例子:
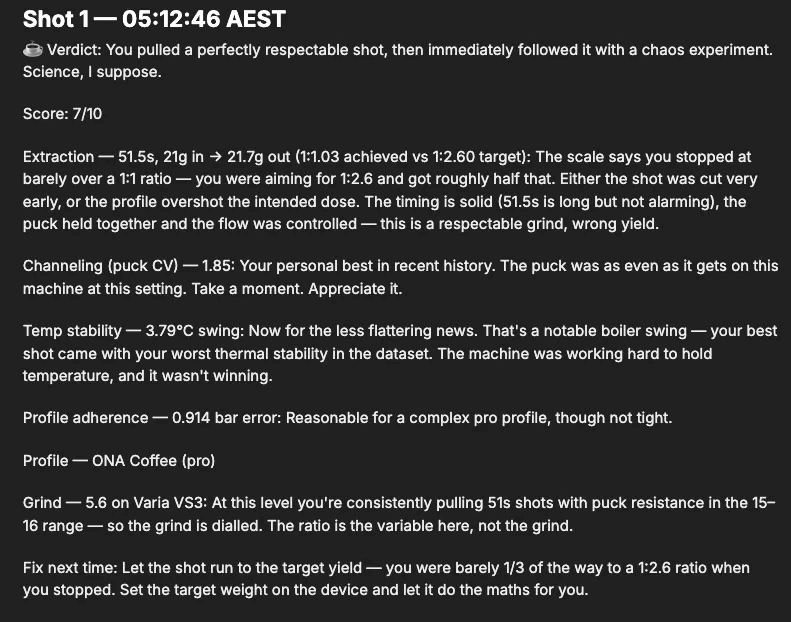
评分卡里的每个数字都对应上文提到的 Span 属性或 Gauge 采样:萃取时长、粉液比、通道效应、温度稳定性。它之所以不仅是一份报告,关键在于背后的历史数据。Agent 知道当前的阻力变异系数是否处于最佳纪录范围,也知道特定磨豆机在特定研磨度下的正常表现。因此,它能排除干扰,定位到真正的问题:我在粉液比刚到 1:1 时就停了,而目标是 1:2.6。每次萃取都能得到改进建议,并自动记录在 Notion 中。
到这一步,遥测数据才真正形成了反馈闭环。这也正是你理想中值班工程师助手处理生产环境的方式------相同的架构模式,只是它恰好对做咖啡有一套标准。
我与咖啡机的相互学习
跳出咖啡本身,这其实是 ClickStack 最佳实践的一个缩影:
• OTLP 是通用契约。微控制器上的精简 Proto 与服务器上的收集器能够互操作,是因为字段编号一致。只要接入 OTel 生态,后端无需特殊适配。
• 插桩绝不能危及系统。做到核心分离、宁丢弃不阻塞,互斥锁绝不跨越网络调用。对于咖啡萃取如此,在生产规模下更是如此。
• ClickHouse 让高基数不再是问题。每个事件独立 UUID、全分辨率曲线、属性即列。如实存储,精准查询。
• 万物共用一个后端。不同协议的数据最终同处一张表且可联合查询。不限定 Schema,意味着一切由业务逻辑决定。
• 仪表盘只是过程。真正的成功在于形成闭环,将遥测数据转化为答案,并据此行动。
说实话,这种启发是双向的。可观测性教给我的咖啡经验,主要是"别心急"。数据中温度稳定性最差的记录全在清晨:我刚打开机器,就迫不及待开始萃取。此时冲煮头还是冷的。那 3.79°C 的波动,正是"心急"被量化后的样子。数据告诉我:应该充分预热,先空跑热水。它甚至在暗示我,该换一台性能更强悍的机器了。我本不需要数据库来找理由砸钱,但事已至此。
这台咖啡机虽然是个"玩具",但它跑在实打实的技术栈上。这里的一切------OTLP 建模、自定义收集器、列式存储、AI Agent------其形态与给任何重要系统做插桩别无二致。只是它闻起来更香罢了。
如果你想在自己的项目上尝试 ClickStack,请查阅:clickhouse.com/use-cases/observability。
关于我们
ClickHouse是面向 AI 时代打造的高性能实时分析数据库,能够以极致性能处理海量数据分析任务。凭借高并发、低延迟和云原生架构,ClickHouse 广泛应用于可观测性、数据仓库、实时分析及 AI 数据基础设施等场景。我们致力于帮助企业在公有云平台上构建安全、弹性且高性价比的实时分析与 AI 数据平台,加速释放数据价值,推动智能化创新与数字化转型。目前,Trip.com、DiDi、Meta、Sony、Netflix、Deutsche Bank、Sierra、Cloudflare 等全球领先企业均在使用 ClickHouse 支撑其关键业务和数据分析平台。