摘要 :本文从"Git 是一个内容寻址文件系统"这一视角出发,逐层拆解 blob / tree / commit / tag 四类对象、SHA-1 如何决定
.git/objects的目录布局、refs 与 HEAD 指针的本质,并深入 packfile 的 delta 增量压缩与git gc的垃圾回收与数据恢复机制。配合可运行的底层命令,帮助你真正读懂.git目录,而不只是会用git add/git commit。
导语
很多人用 Git 两三年,依然把它当成"一个带版本号的文件夹"。一旦遇到 detached HEAD、对象膨胀、误删分支怎么找回、git gc 到底干了什么这类问题,就只能去搜命令、照抄、碰运气。
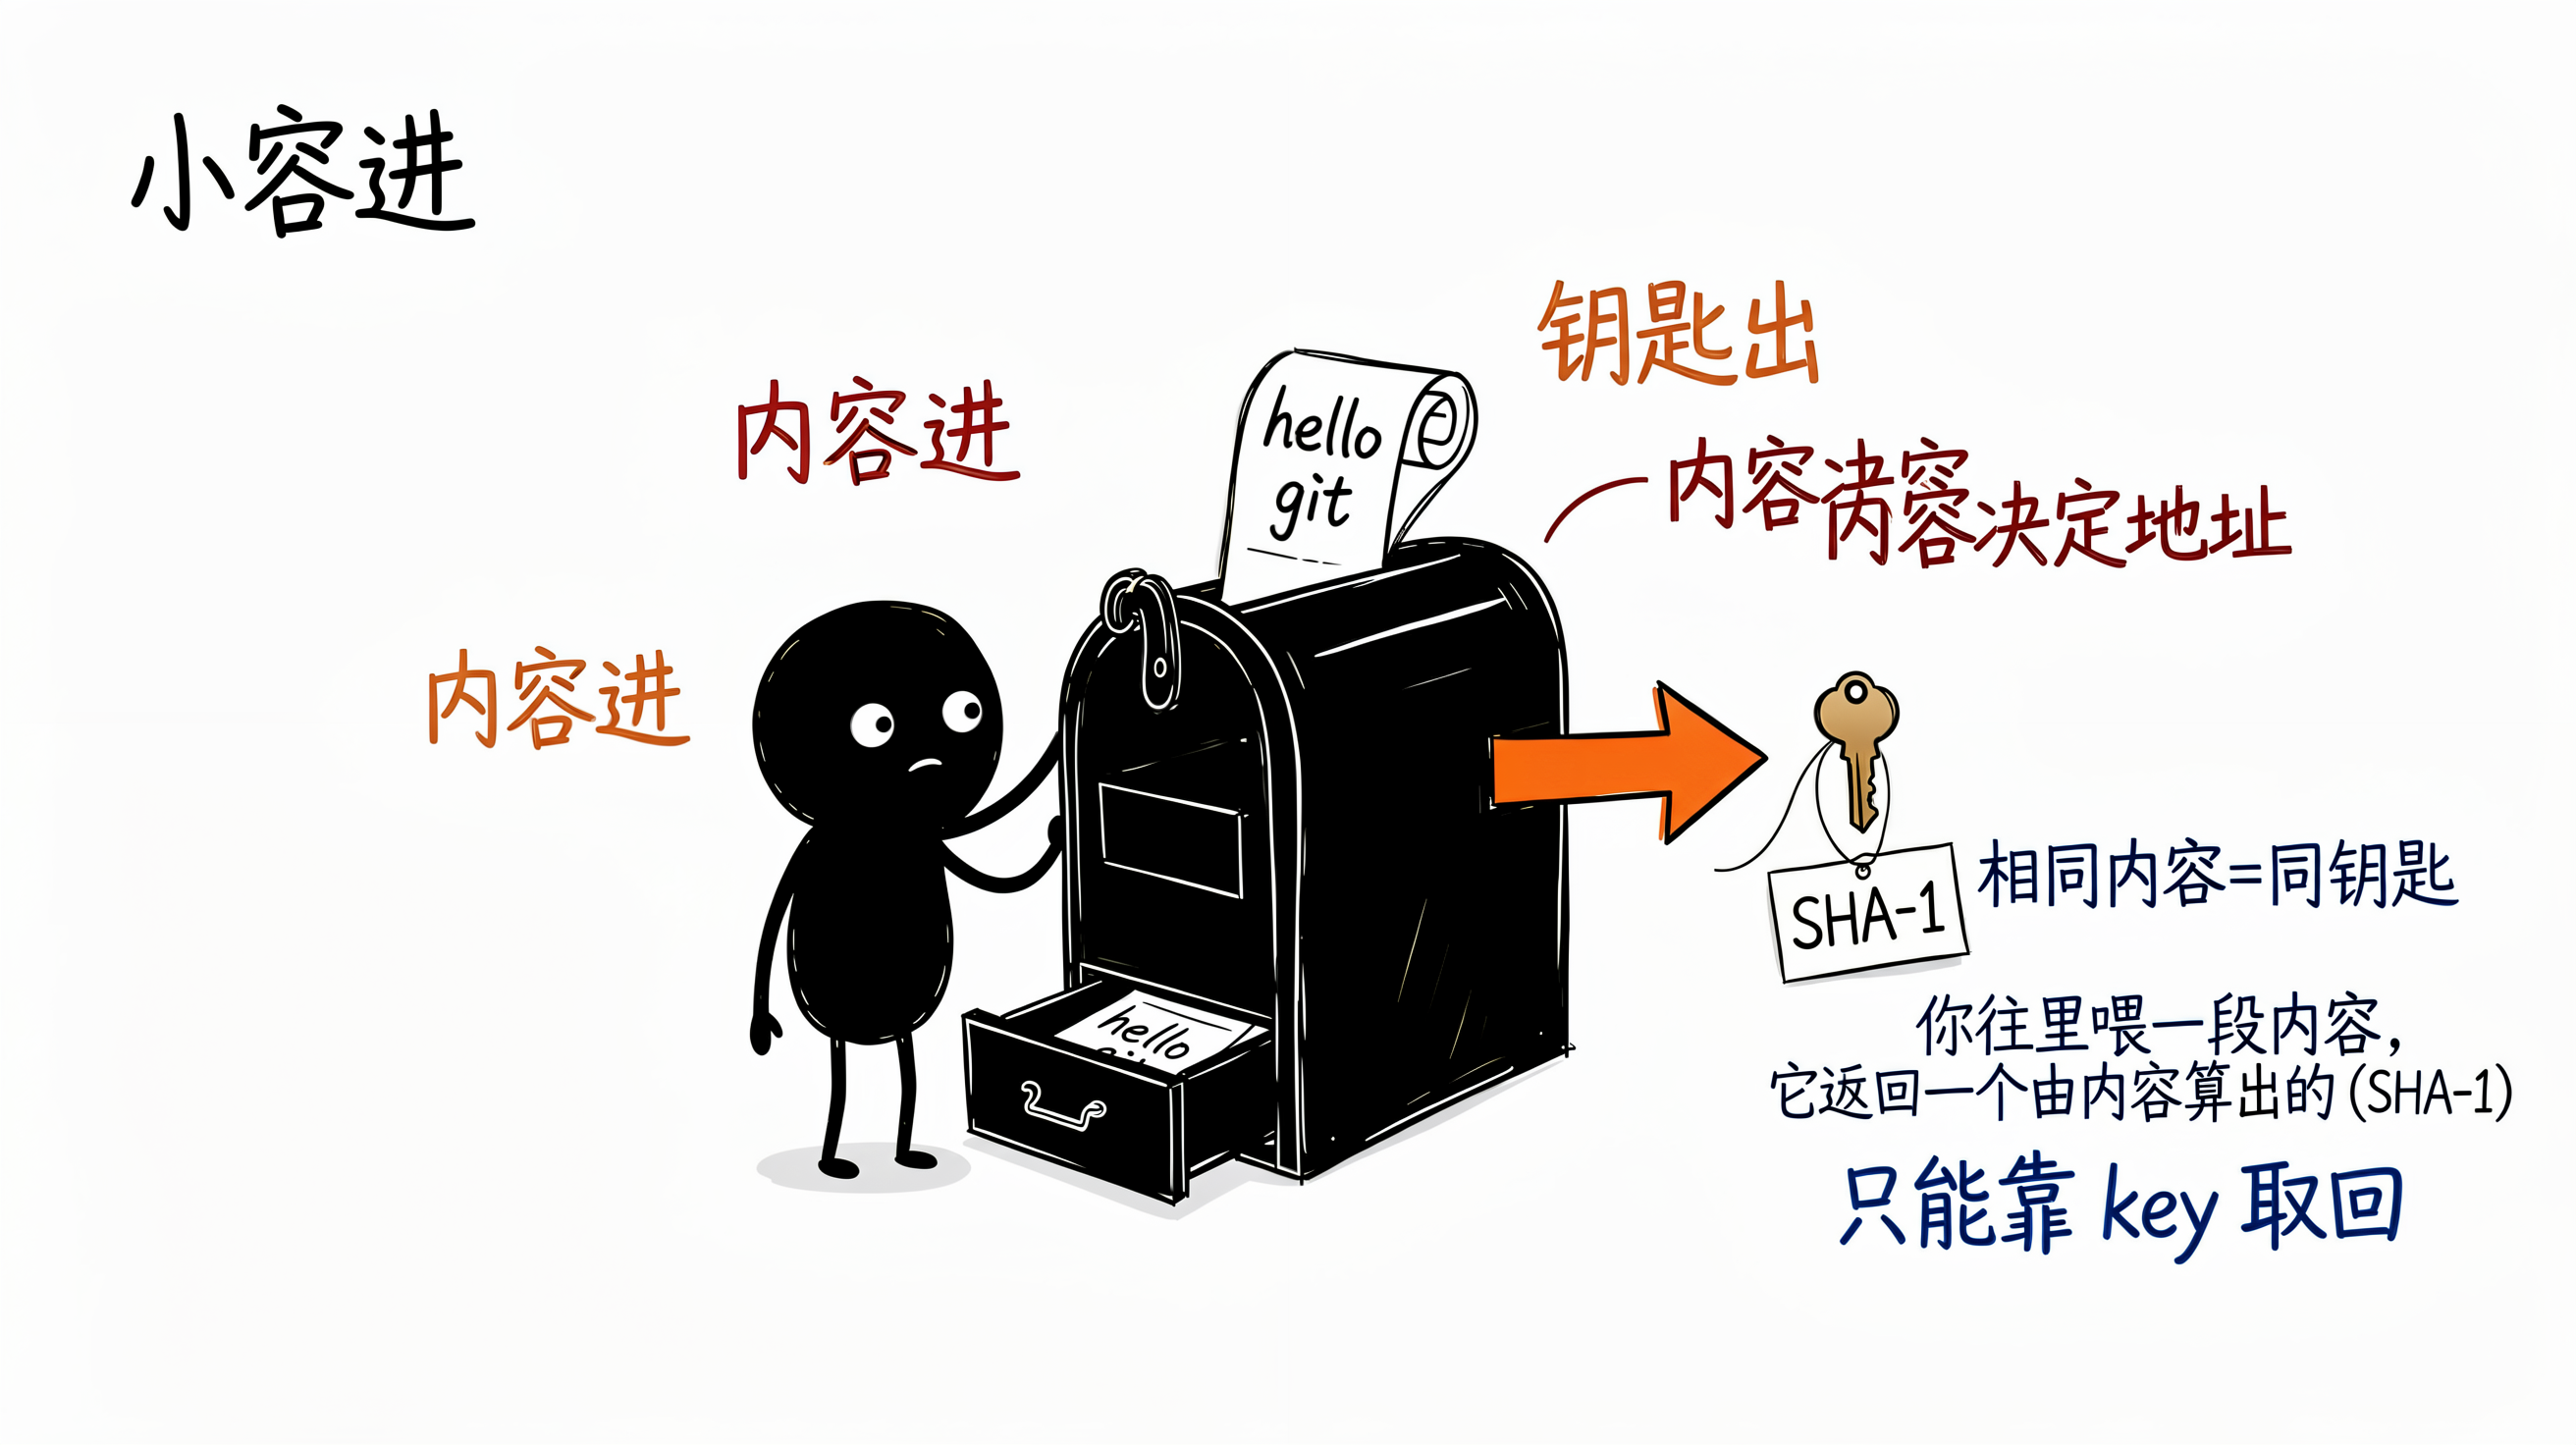
其实 Git 的设计非常优雅:它底层根本不关心"文件"或"版本" ,而是一个简单的内容寻址文件系统(content-addressable filesystem)------你往里喂一段内容,它返回一个 key,之后只能靠这个 key 取回内容。本文就用 Git 自带的"底层(plumbing)命令"亲手摸到这套机制,读完你会发现,分支、标签、历史这些上层概念,全都是在这个简单的键值存储之上搭出来的。
一、重新认识 Git:它本质上是一个内容寻址文件系统
先弄清一个关键区分:Git 的命令分两层。
高层命令(porcelain) 是我们日常用的 git add、git commit、git push,它们像" porcelain(瓷器)"一样光洁好用;而底层命令(plumbing) 是 git hash-object、git cat-file、git update-index 这类,直接操作 Git 的核心数据存储。
Git 的核心是一个键值(key-value)数据库 ,也叫对象数据库(object database)。它的工作模型极简:
- 输入:任意一段字节内容(content);
- 输出:一个由内容算出的 40 位十六进制字符串作为 key;
- 读取:只能拿这个 key 把内容原样取回来。
也就是说,相同的内容永远得到相同的 key,不同的内容几乎不可能撞 key。这就是"内容寻址(content-addressable)"的含义------地址由内容本身决定,而不是由你给文件起的名字或所在路径决定。
text
 写入内容                对象数据库(.git/objects)
+----------------+      +-------------------------+
|  echo "hi"  ───┼─────▶│  key = SHA-1(content)   │
+----------------+      │  value = zlib(content)  │
                        +-------------------------+
                                  │
 读取内容              key 取回    │
+----------------+      +--------▶+
|  cat-file -p   ◀─────┤
+----------------+
理解这一点之后,后面所有对象类型、引用、打包,都只是在这个简单模型上做"组合与索引"。
二、Git 对象数据库:blob / tree / commit / tag 四类核心对象
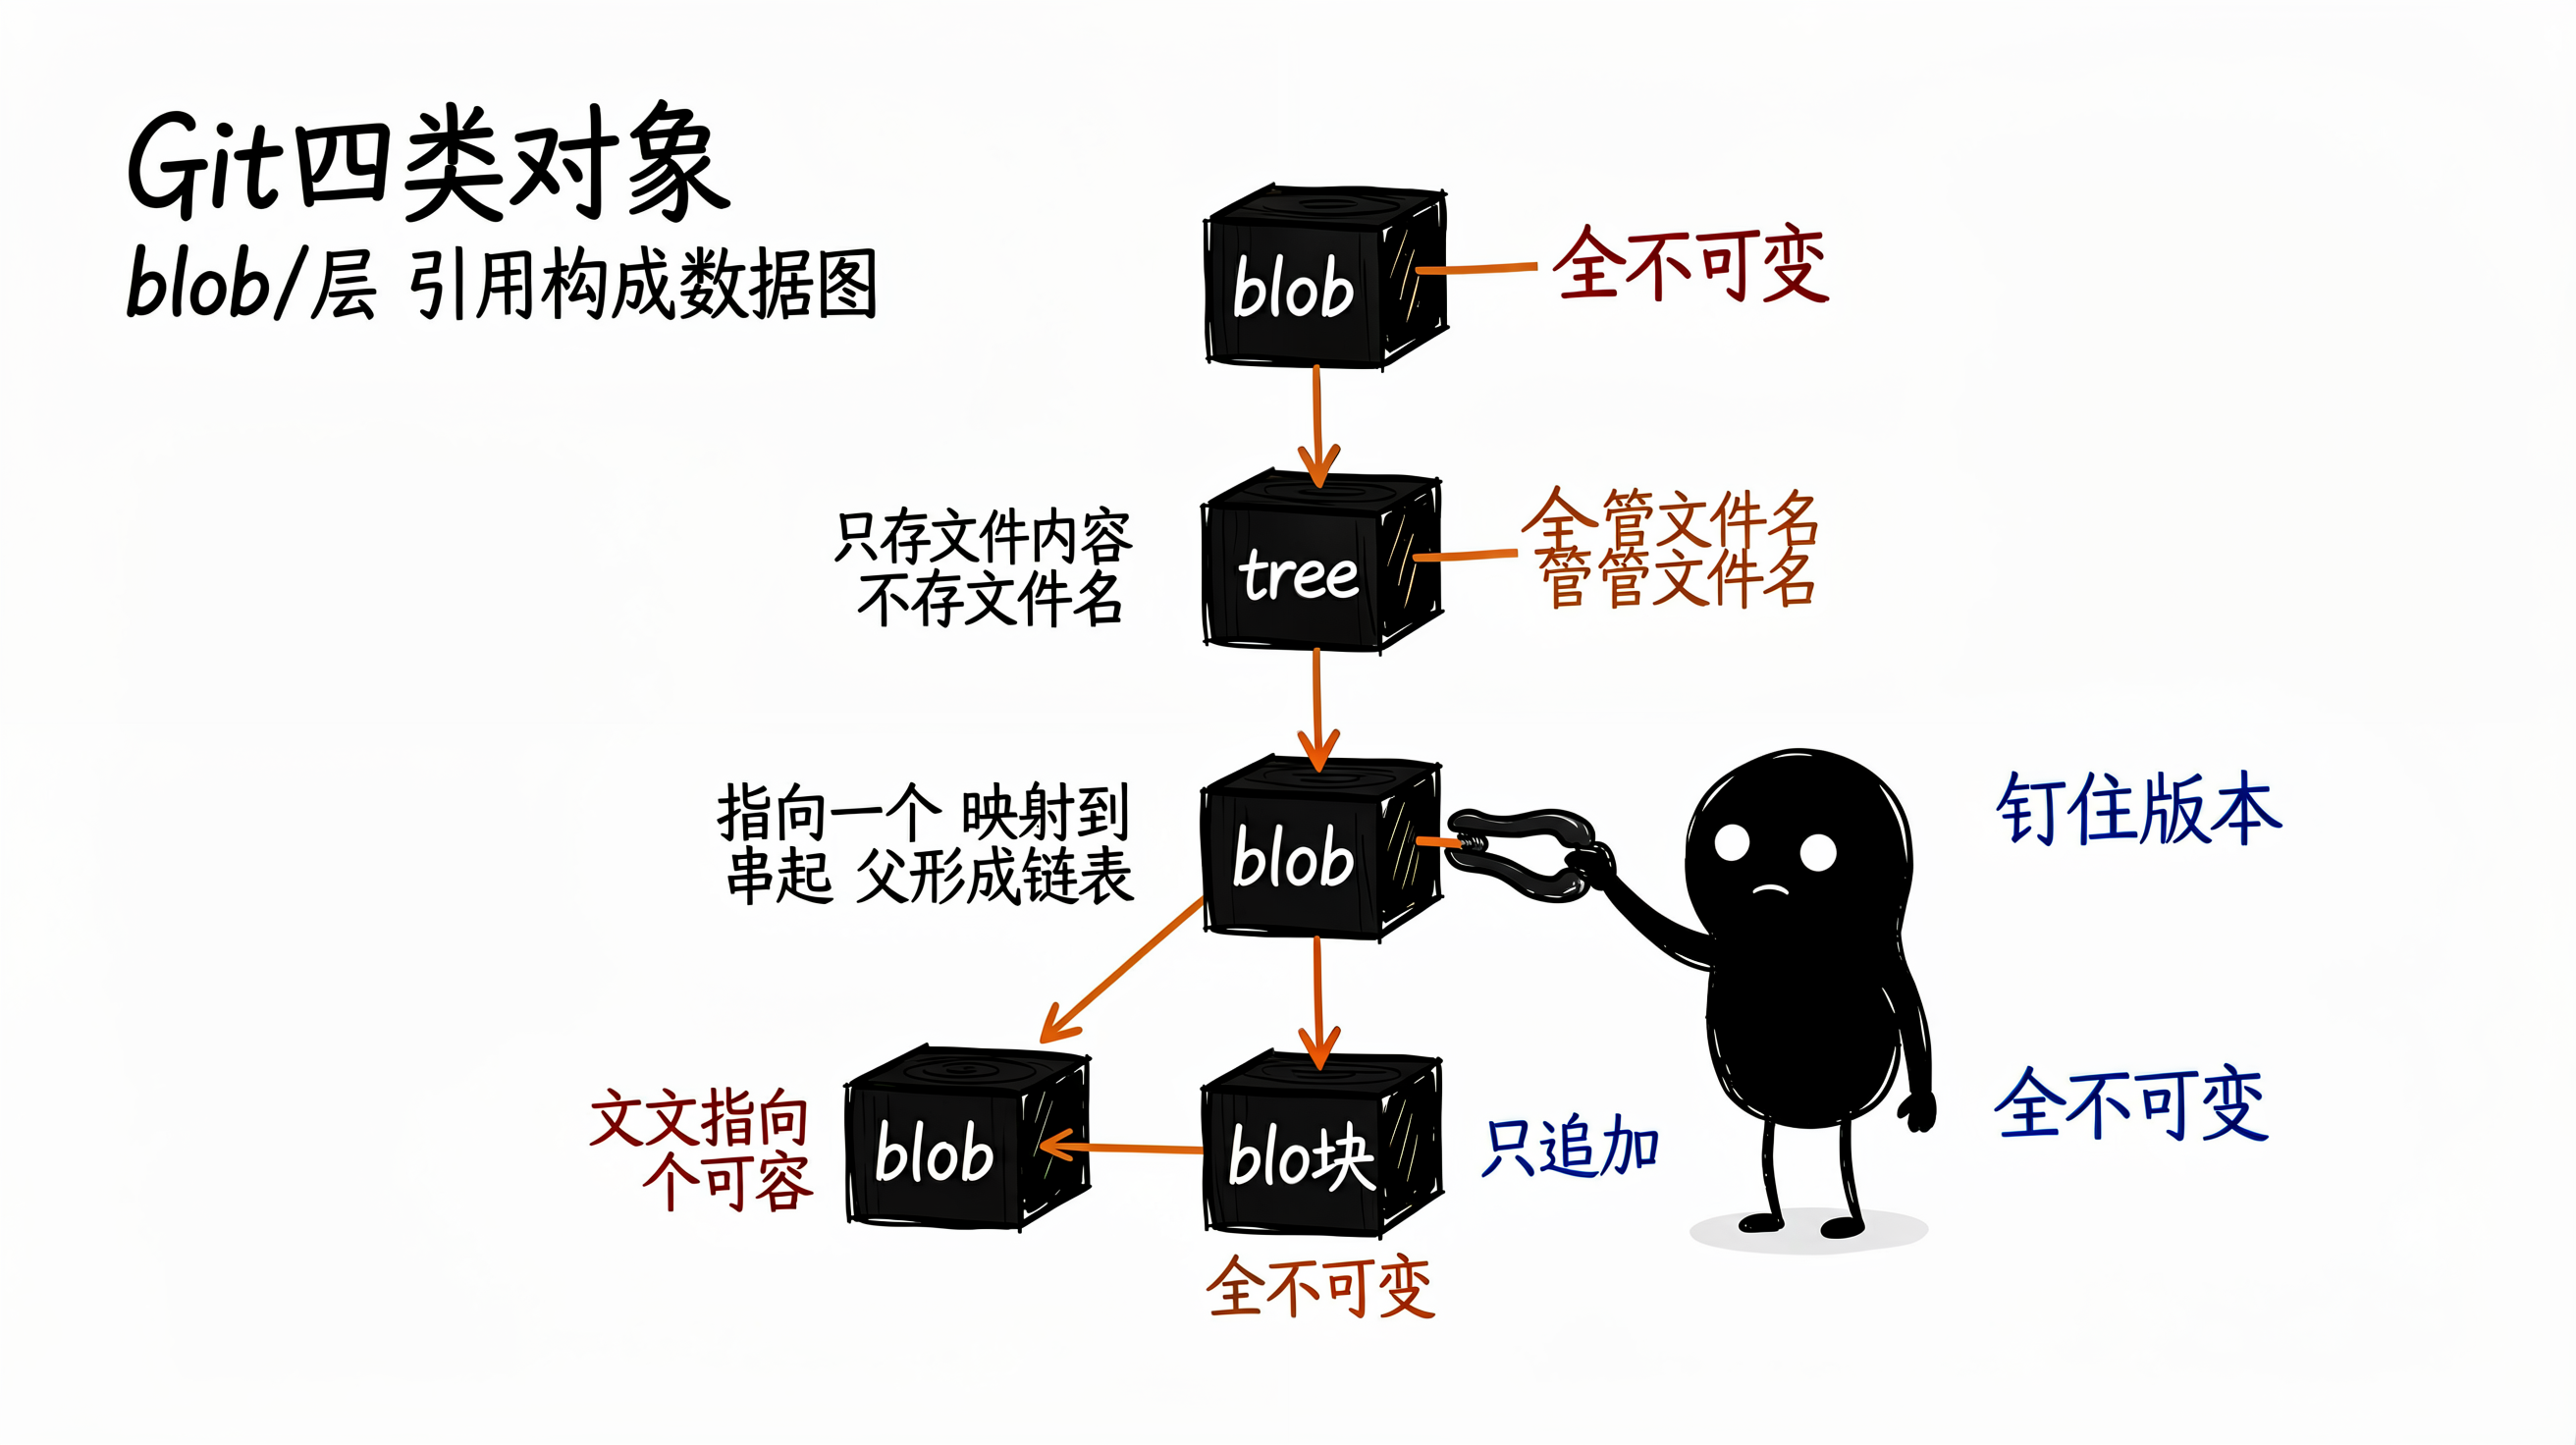
.git/objects 里存的每一种数据,都被称为一个 Git 对象(object)。Git 一共有四种对象类型,它们层层引用、构成整棵数据图。
| 类型 | 存储的内容 | 类比 |
|---|---|---|
| blob | 文件的具体内容(不含文件名) | 一个文件的内容字节 |
| tree | 一组文件名到对象 SHA-1 的映射 | 一个目录的快照 |
| commit | 指向一个 tree + 父 commit + 作者/提交信息 | 一次提交记录 |
| tag | 指向一个 commit/blob/tree + 标签信息 | 带说明的"书签" |
blob 只存内容、不存文件名------这是 Git 去重的关键:两个名字不同但内容相同的文件,在 Git 里是同一个 blob 对象,只占一份空间。
下面用底层命令亲手造出一个 blob 和 tree,验证上面说的模型:
bash
# 1. 初始化一个空仓库
git init demo && cd demo

# 2. 把一段内容直接写成 blob 对象(-w 表示写入数据库,--stdin 从标准输入读)
echo "hello git internals" | git hash-object -w --stdin
# 输出 40 位 SHA-1,例如 8d0e412...,这就是内容的 key

# 3. 用 key 取回内容、查看类型与大小
git cat-file -t 8d0e412   # 输出: blob
git cat-file -s 8d0e412   # 输出: 字节数
git cat-file -p 8d0e412   # 输出: hello git internals

# 4. 写入一个真实文件后,把它登记进索引,再把索引写成一个 tree
echo "version 1" > test.txt
git update-index --add --cacheinfo 100644 \
  $(git hash-object -w test.txt) test.txt
git write-tree
# 输出一个 tree 的 SHA-1,例如 d8329f...

git cat-file -p d8329f
# 输出: 100644 blob 95a... test.txt (这就是"目录"的记录方式)可以看到,tree 对象里只有"权限 + 类型 + 对象 SHA-1 + 文件名",它把 blob 和子 tree 组织成目录结构。commit 对象 则再包一层:它存的是"指向哪个 tree(项目根目录快照)+ 父 commit 的 SHA-1 + 作者/提交者/提交时间 + 提交说明"。理解了这层包裹关系,你就能看明白 git log 实际是在沿着 commit → parent 的链表一路往前走,所谓"历史"就是这条单向链表。
tag 对象 分两种:轻量标签(lightweight)只是一条指向 commit 的 ref,而**附注标签(annotated tag)**是一个真正的 Git 对象,额外保存打标签的人、时间和说明,常用于发布版本。它和 commit 一样不可变,因此发布的"v1.0 对应哪个提交"可以被永久、可靠地钉住。
值得注意的是,这四类对象全部不可变:一旦写入对象数据库,内容就固定了,你不可能"修改"一个已有对象,只能写入新对象。这种只追加(append-only)的特性,是 Git 数据几乎不会损坏、且能轻松做增量同步的根因。
三、内容寻址与 SHA-1:.git/objects 的目录结构
既然每个对象都有 SHA-1,Git 怎么把它们落到磁盘?答案是按 hash 的前两位分目录。
一个对象的完整 SHA-1 是 40 个十六进制字符。Git 取前 2 个字符作为目录名 ,剩下 38 个字符作为文件名,于是你在 .git/objects 下会看到形如 ab/cdef... 的两级结构。这样做是为了避免单个目录下放几万个文件导致文件系统性能下降。
对象的内容 在落盘前会用 zlib 压缩,所以你直接 cat 文件看到的是乱码------必须靠 git cat-file 解压还原。
下面这段 Python 代码直接复现了 Git 计算 blob SHA-1 的全过程,你可以和 git hash-object 的结果逐一对照,验证"内容寻址"不是黑盒:
python
import hashlib
import zlib

# Git 计算 blob SHA-1 的规则:header = "blob <长度>\0",再拼接原始内容
content = b"hello git internals\n"
header = b"blob " + str(len(content)).encode() + b"\0"
store = header + content

sha1 = hashlib.sha1(store).hexdigest()
compressed = zlib.compress(store)

print("SHA-1 :", sha1)                 # 与 git hash-object 输出一致
print("长度   :", len(sha1))            # 40 位十六进制
print("磁盘路径:", sha1[:2] + "/" + sha1[2:])   # .git/objects 的分目录规则
print("zlib头 :", compressed[:2])       # zlib 压缩后的魔数
git cat-file 在背后干的,正是 zlib.decompress 再剥掉 header。顺便说一句:SHA-1 在这里被用来做内容完整性校验 和去重寻址,而不是做安全签名;即便发生理论上的碰撞,对版本控制场景的影响也远小于"密码学碰撞攻击"那种语境。
查看磁盘布局也很直观:
bash
# 列出当前仓库所有松散对象(loose object)
find .git/objects -type f -not -path '*/pack/*'
# 输出示例:
# .git/objects/8d/0e412...   (blob)
# .git/objects/d8/329f...    (tree)

# 看某个对象的原始压缩内容(前几个字节是 zlib 头)
git cat-file -p 8d0e412 | head -c 20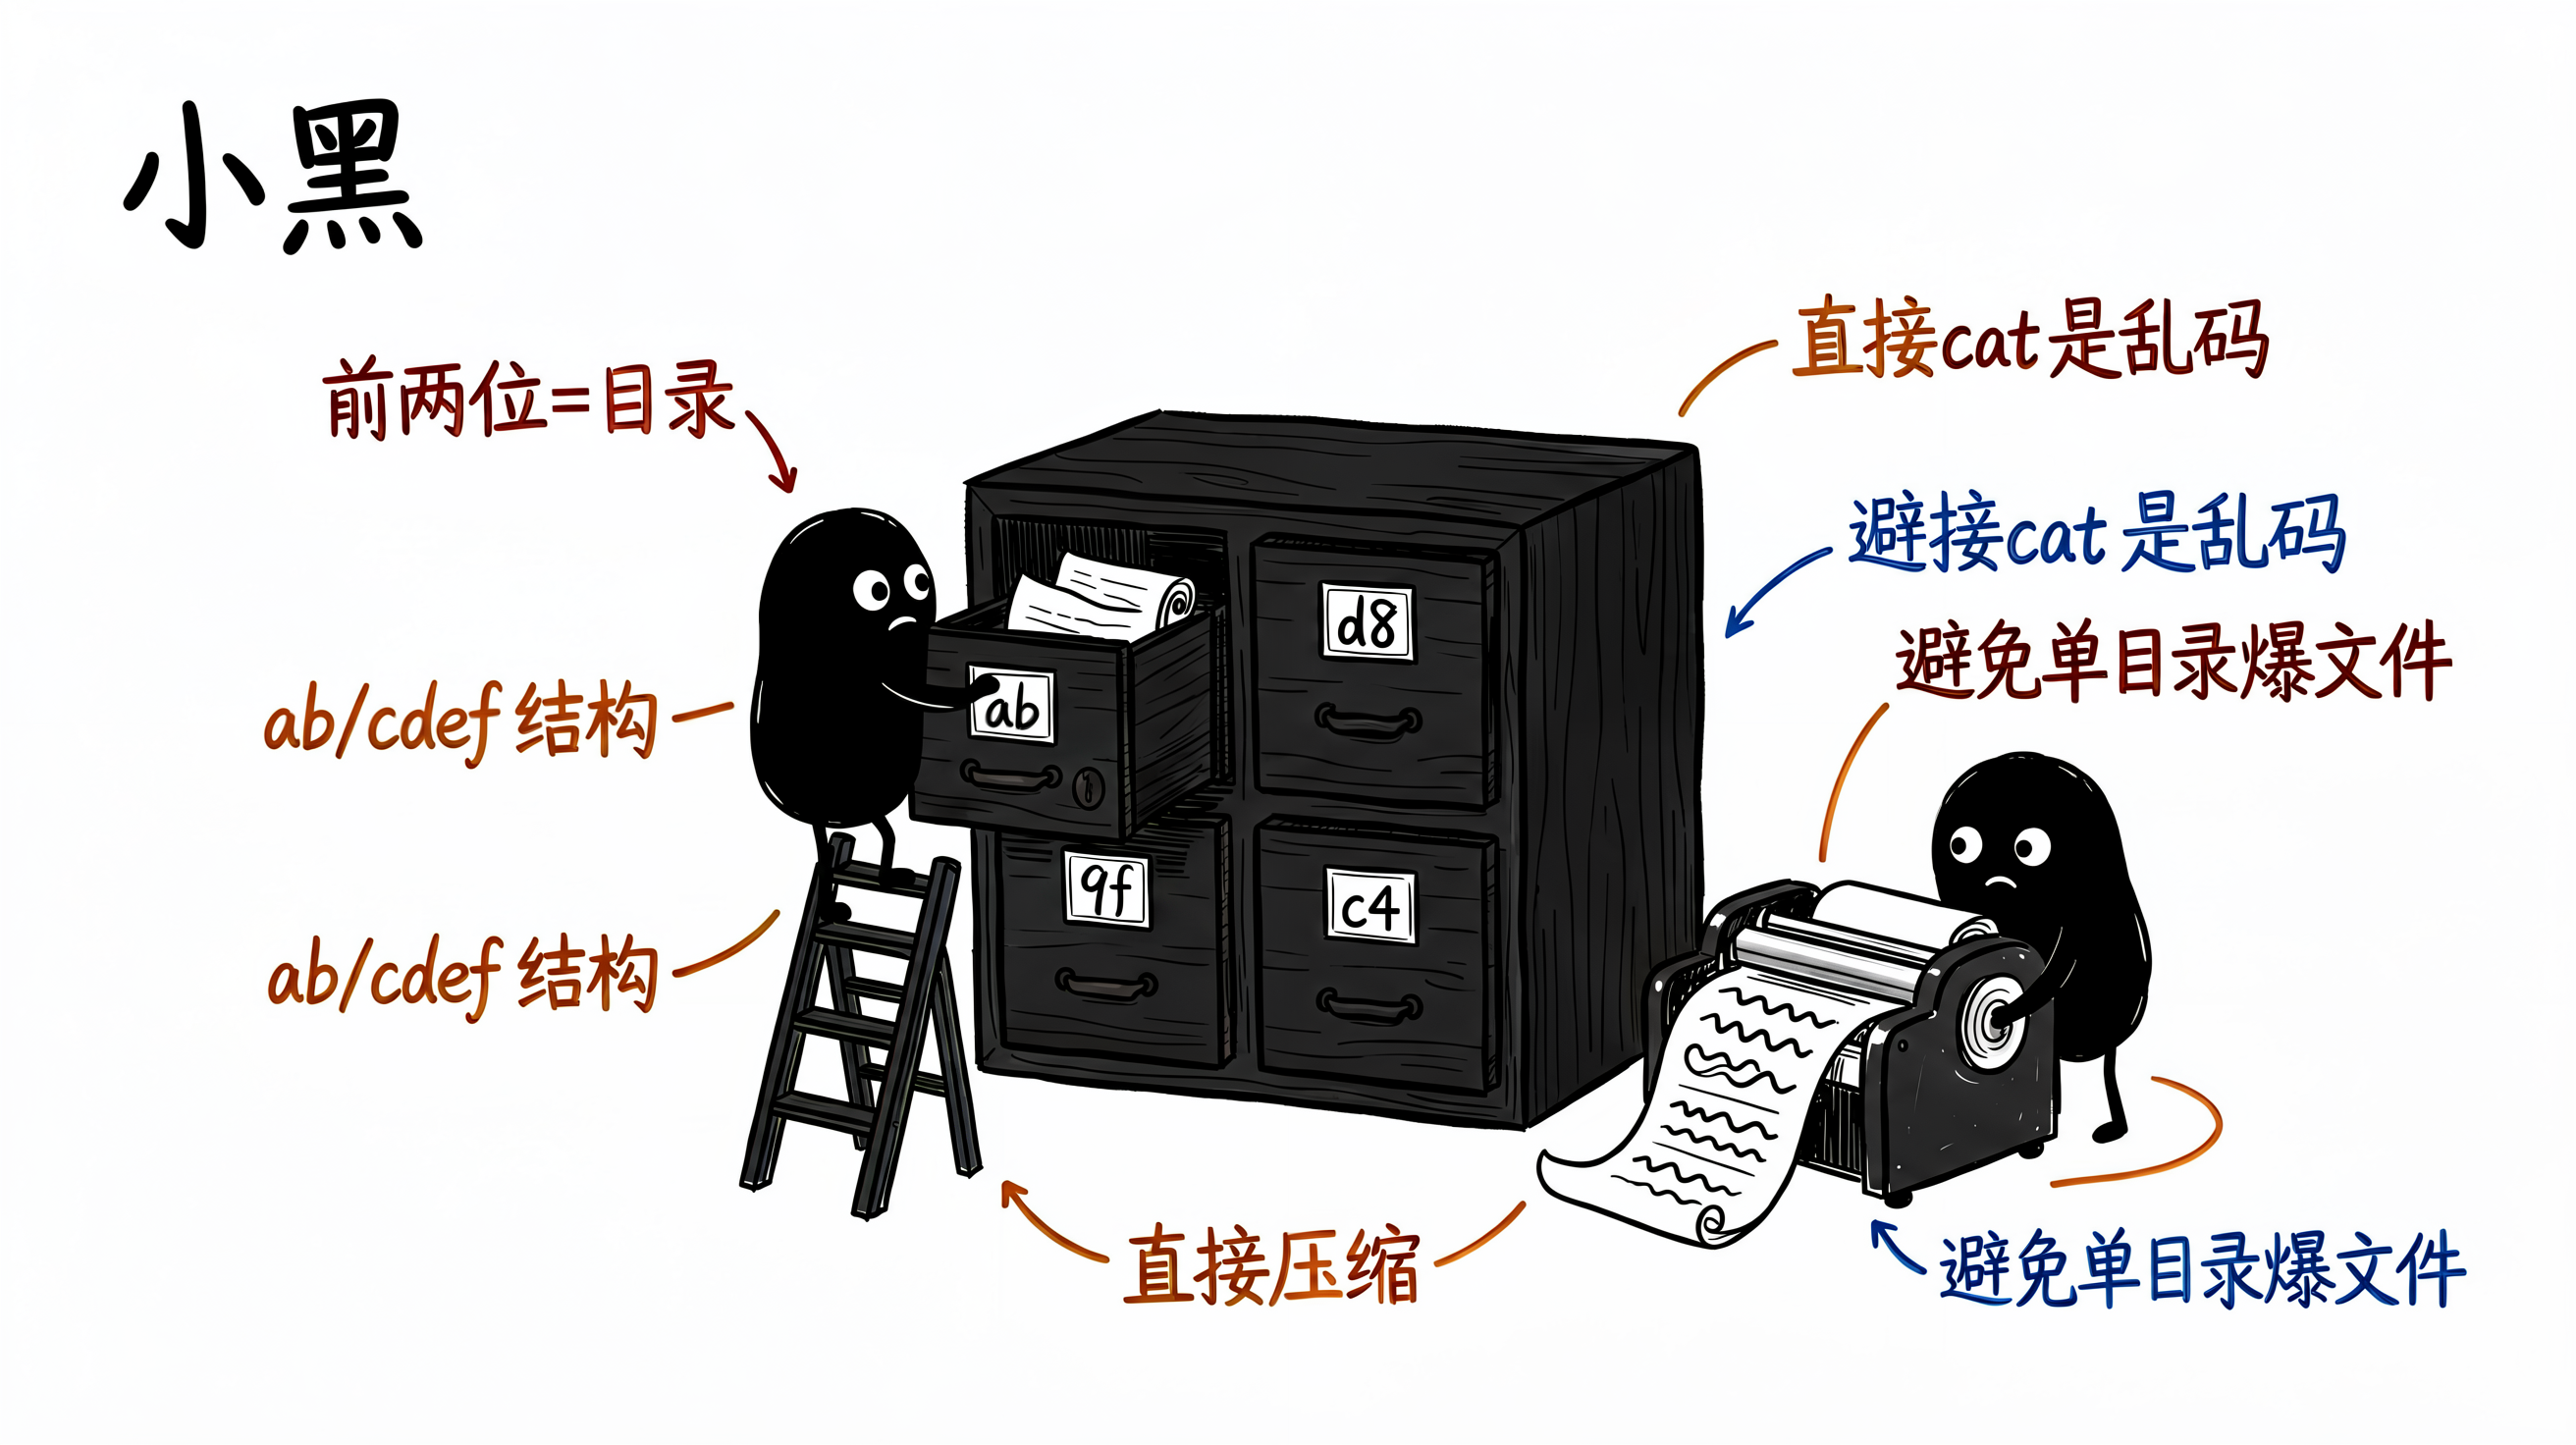
四、引用(refs)与 HEAD:分支其实只是个指针
对象数据库里存的是"不可变的历史快照",那 Git 怎么知道"当前在哪一个提交上"?答案就是 引用(ref)。
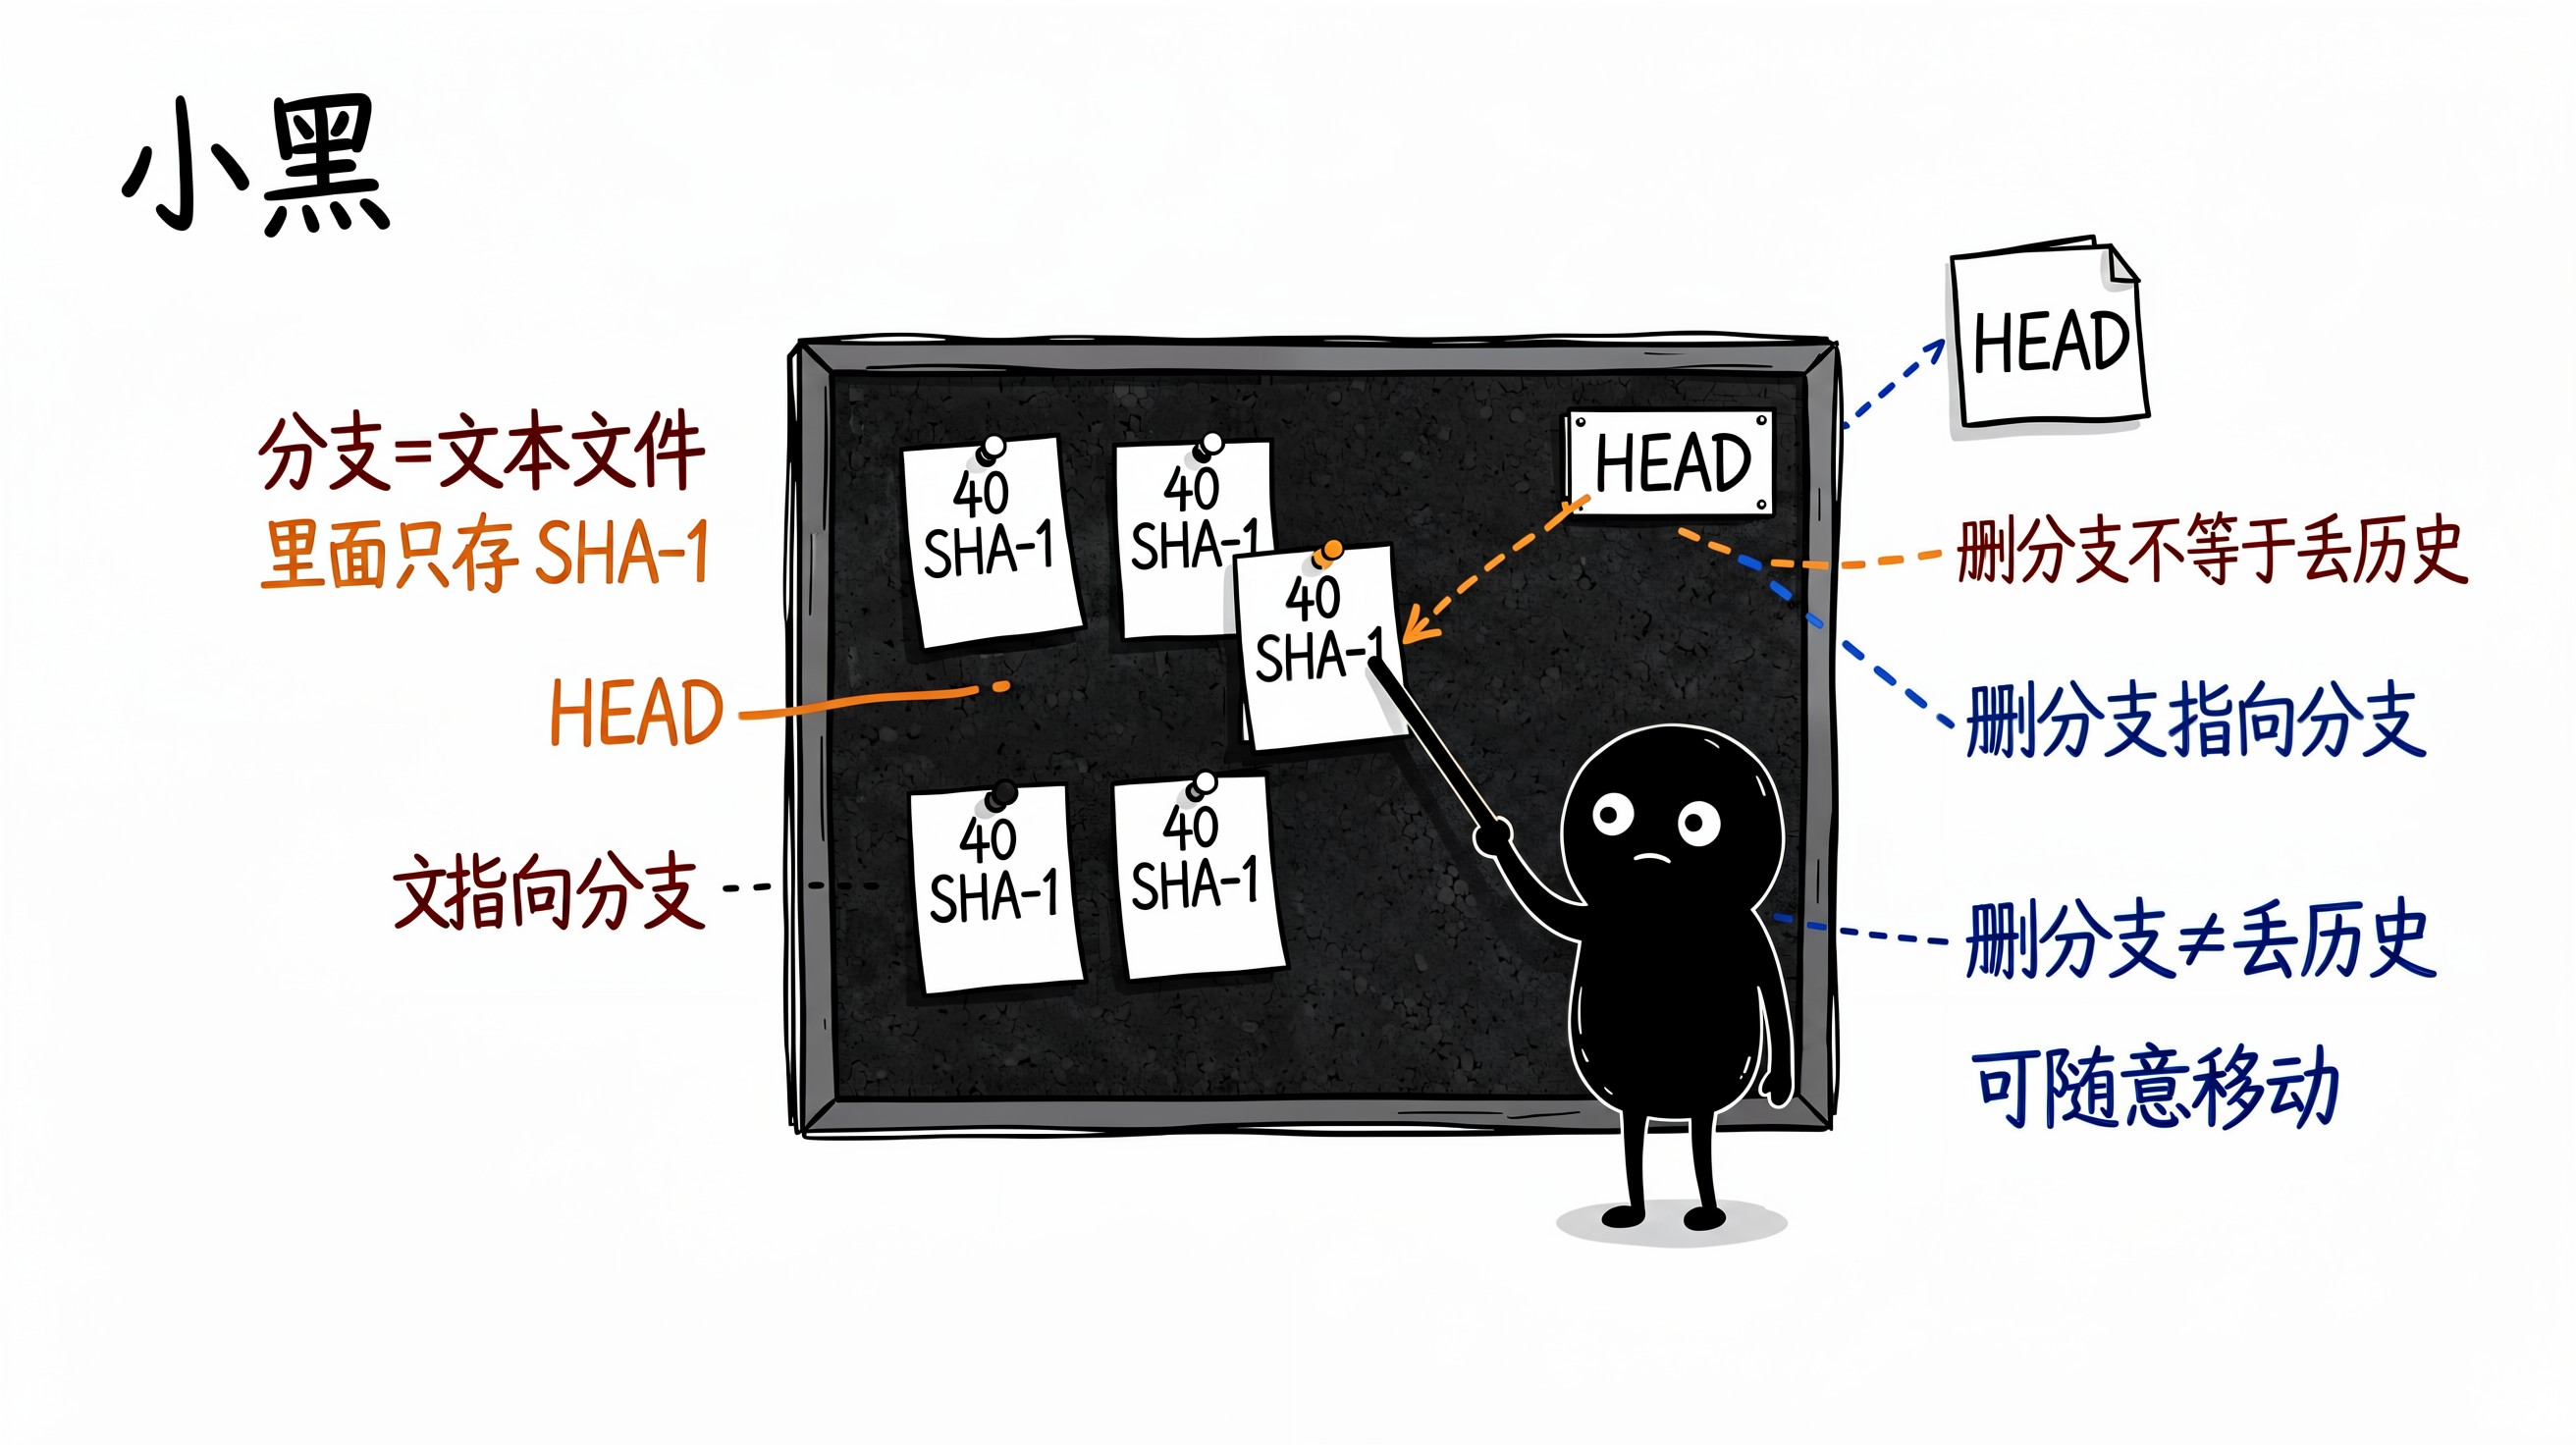
引用 本质上是一个文本文件,里面只存一个 SHA-1。例如分支 master 其实就是文件 .git/refs/heads/master,内容是一行 commit 的 SHA-1。git branch 不过是在 refs/heads/ 下新建/删除这样一个文件;git checkout 则是把 HEAD 指向某个 ref。
HEAD 是一个特殊的"符号引用(symref)",它通常不直接存 SHA-1,而是存"我当前在哪个分支":
bash
# HEAD 默认指向当前分支,而不是某个具体提交
cat .git/HEAD
# 输出: ref: refs/heads/master

# 用底层命令直接创建/更新一个分支引用(等价 git branch)
git update-ref refs/heads/master $(git write-tree)

# 查看所有引用
git show-ref
# refs/heads/master  d8329f...

# 创建一个 commit 对象,并把分支指向它
commit=$(git commit-tree $(git write-tree) -m "first commit")
git update-ref refs/heads/master "$commit"

git log --oneline
# 现在分支真正拥有了提交历史关键点在于:分支可以随意移动、删除、重建,而底层的 commit 对象并不会因此消失 。这解释了为什么"删分支"不等于"丢历史"------只要那个 commit 对象还在数据库里(还没被 gc 回收),就有机会找回来。这也是下一节垃圾回收要处理的"悬空对象"的来源。
顺带解释一个常见困惑:git checkout <某个commit的SHA-1> 会进入 detached HEAD(分离头指针) 状态,意思是 HEAD 这次直接 指向了一个 commit,而不是某个 ref。在这个状态下提交的新 commit 暂时"没有分支挂着",一旦切走就可能变成悬空对象。理解了 HEAD 只是个指针,你就不会再怕 detached HEAD------需要时随时 git branch <名> HEAD 把当前位置接回一个分支即可。
五、Packfile:增量压缩与存储/传输优化
早期的 Git 把每个对象存成独立、各自用 zlib 压缩的松散对象(loose object)。当仓库历史变长、文件反复修改,松散对象会迅速膨胀:同一个文件改 100 次,就产生 100 个几乎一模一样的 blob。
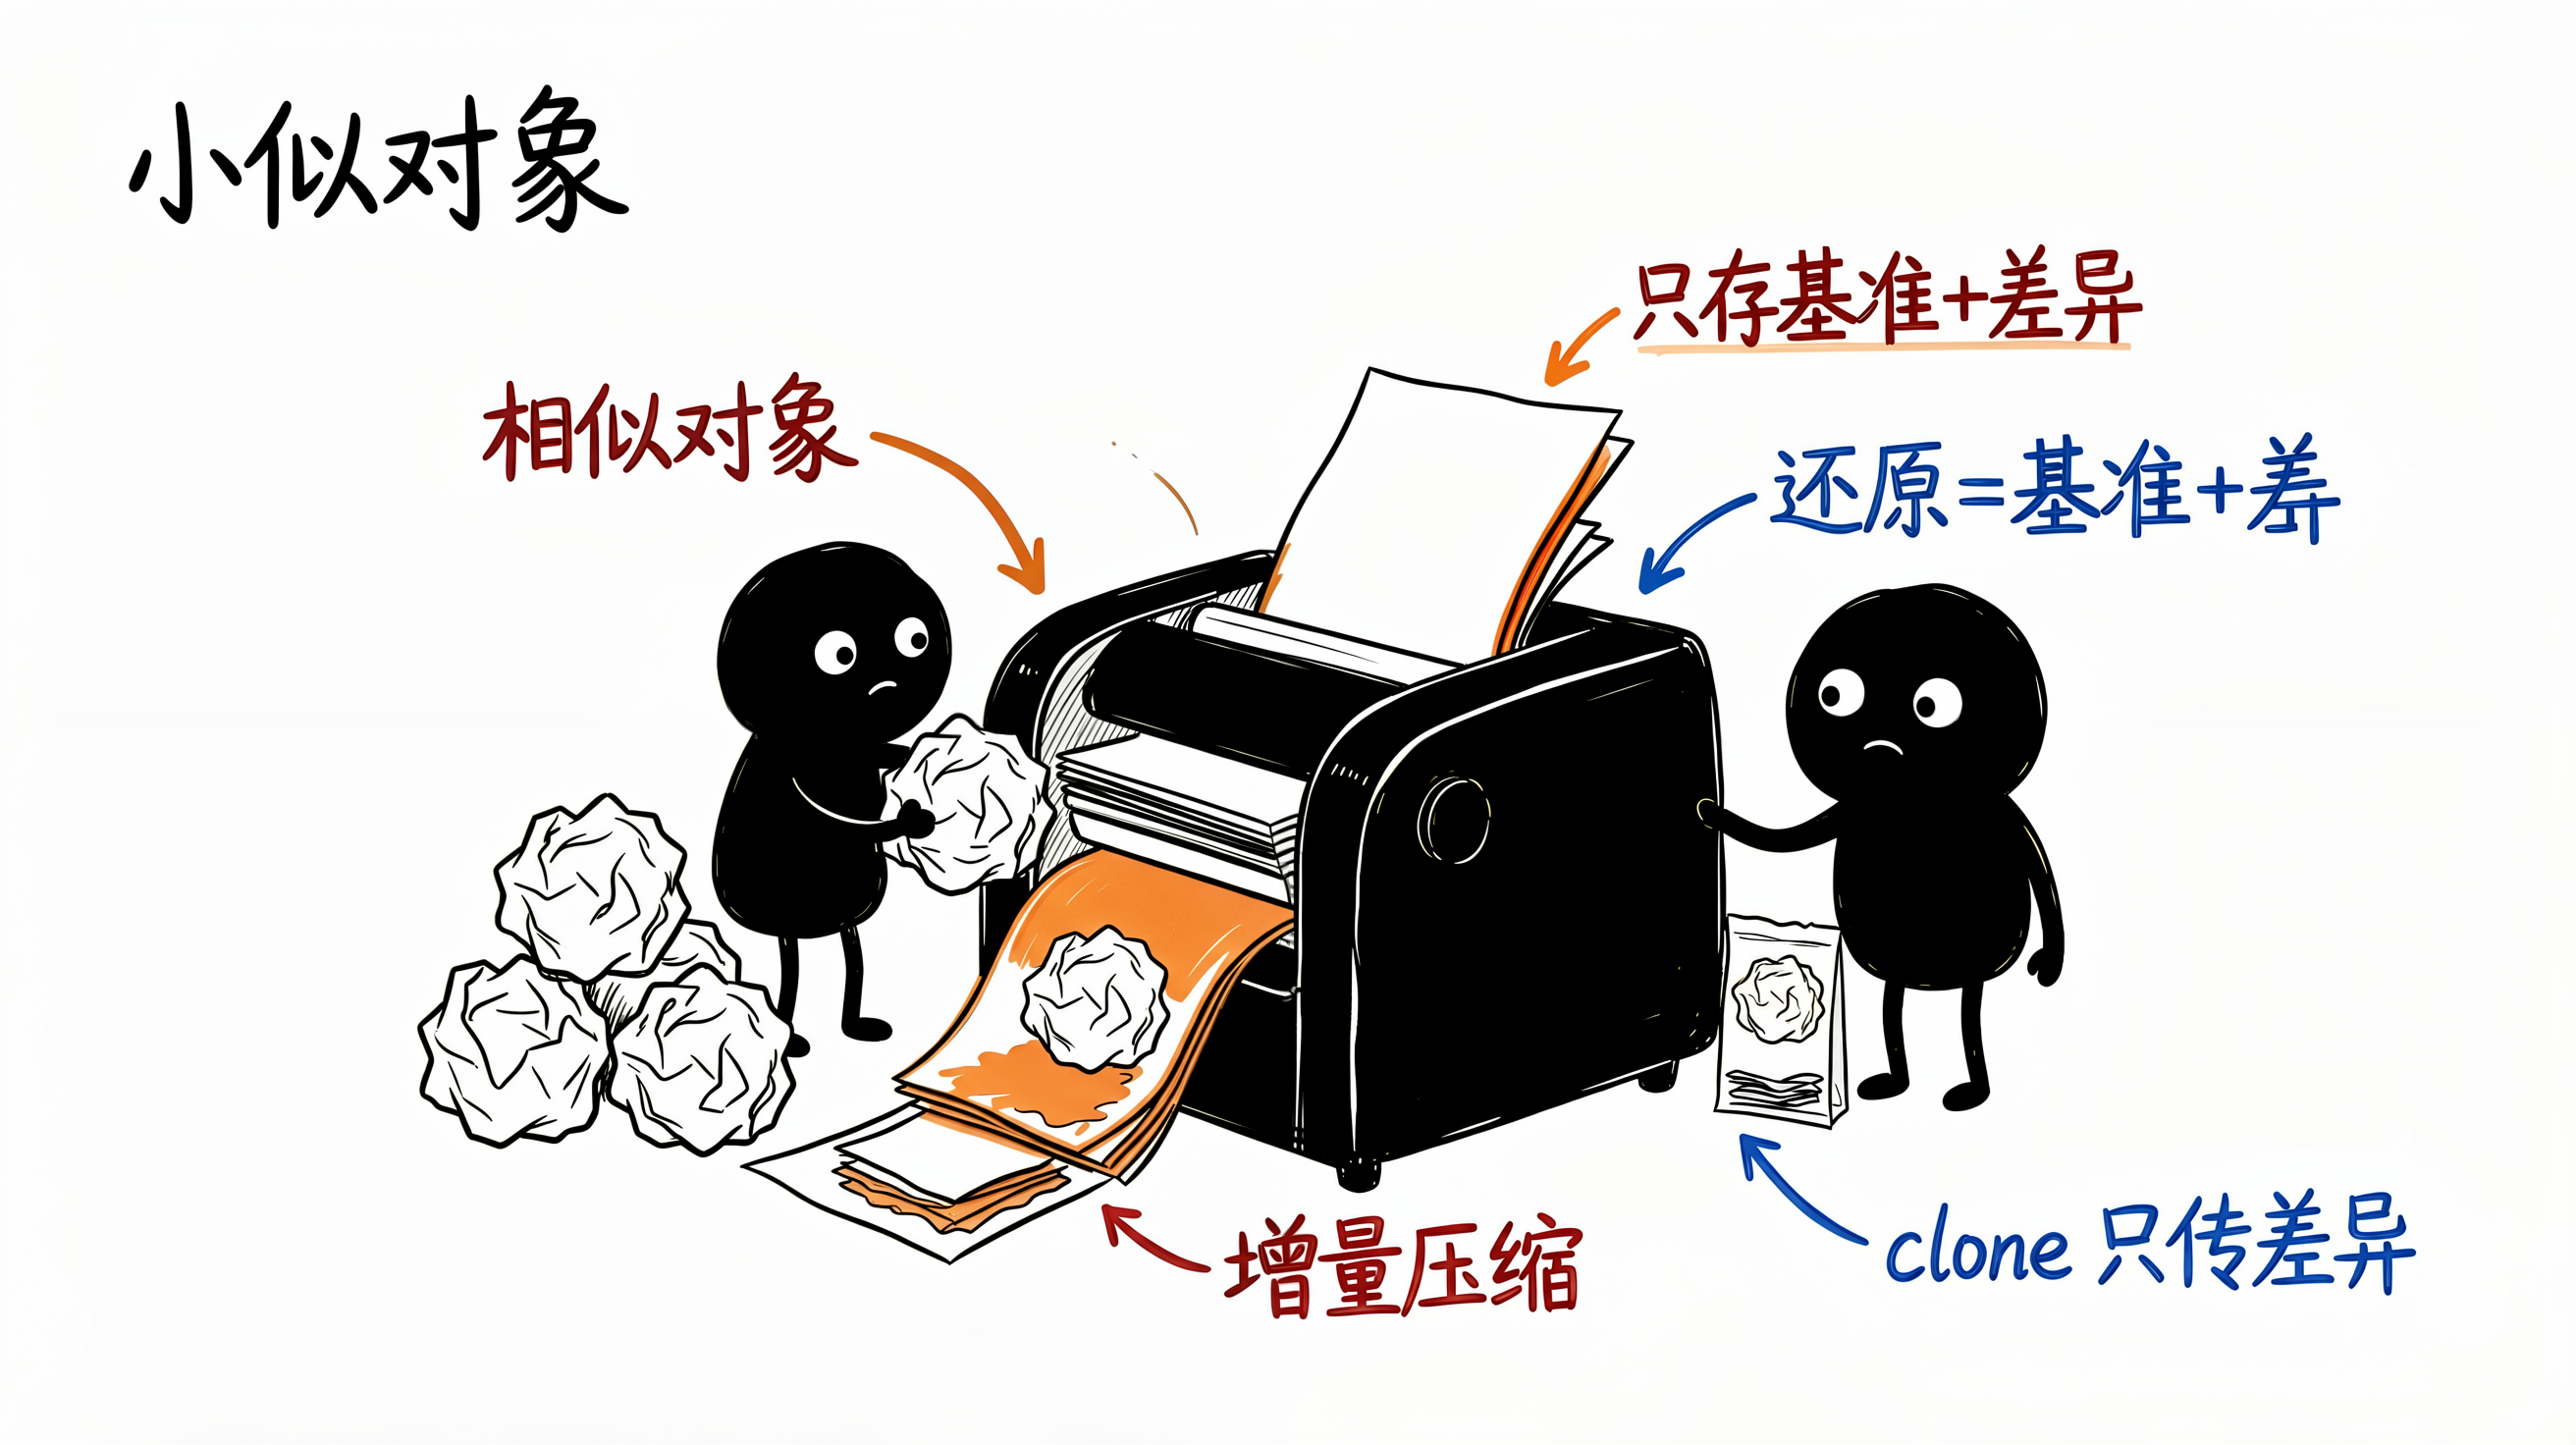
为了解决存储与网络传输成本,Git 引入了 packfile(打包文件) 。它会把一批对象打包进 .git/objects/pack/ 下的一个 .pack 文件(配 .idx 索引),核心优化是 delta 增量压缩:
对于相似的对象,只存"基准对象"和"两者之间的差异(delta)",而不是各自存完整内容。还原时由基准 + delta 推导出来。
delta 的选择本质是一个"找最省钱基准"的贪心问题,下面用伪代码说明它的思路:
text
# 为对象集合构造 delta 压缩的简化思路
for each object O in objects:
    best = NULL
    for each candidate B in (objects smaller than O):
        delta = diff(B, O)              # 计算 B->O 的差异
        if size(delta) < size(O) * threshold:
            if best == NULL or size(delta) < size(best.delta):
                best = (B, delta)
    if best != NULL:
        store_delta(O, base=best.B, delta=best.delta)
    else:
        store_full(O)                   # 找不到更省的基准就存完整对象
实际触发打包最简单的方式就是运行 git gc;也可以直接观察打包结果:
bash
# 制造一批内容相近的对象,制造膨胀
for i in $(seq 1 50); do
  printf 'line %s padding padding padding\n' "$i" >> big.txt
  git hash-object -w big.txt >/dev/null
done

# 打包并查看 pack 信息
git gc --aggressive
ls .git/objects/pack/
# 生成: pack-<sha>.pack  pack-<sha>.idx

# 详细查看包里每个对象、大小与 delta 关系
git verify-pack -v .git/objects/pack/*.idx | head -n 20
verify-pack 输出里能看到每个对象的实际大小、压缩后大小,以及它是否以 delta 形式引用了另一个对象(base 列)。这正是 Git 在 clone/fetch 时只传差异、大幅节省带宽的底层原理。
六、垃圾回收(gc)与数据维护:清理、合并与恢复
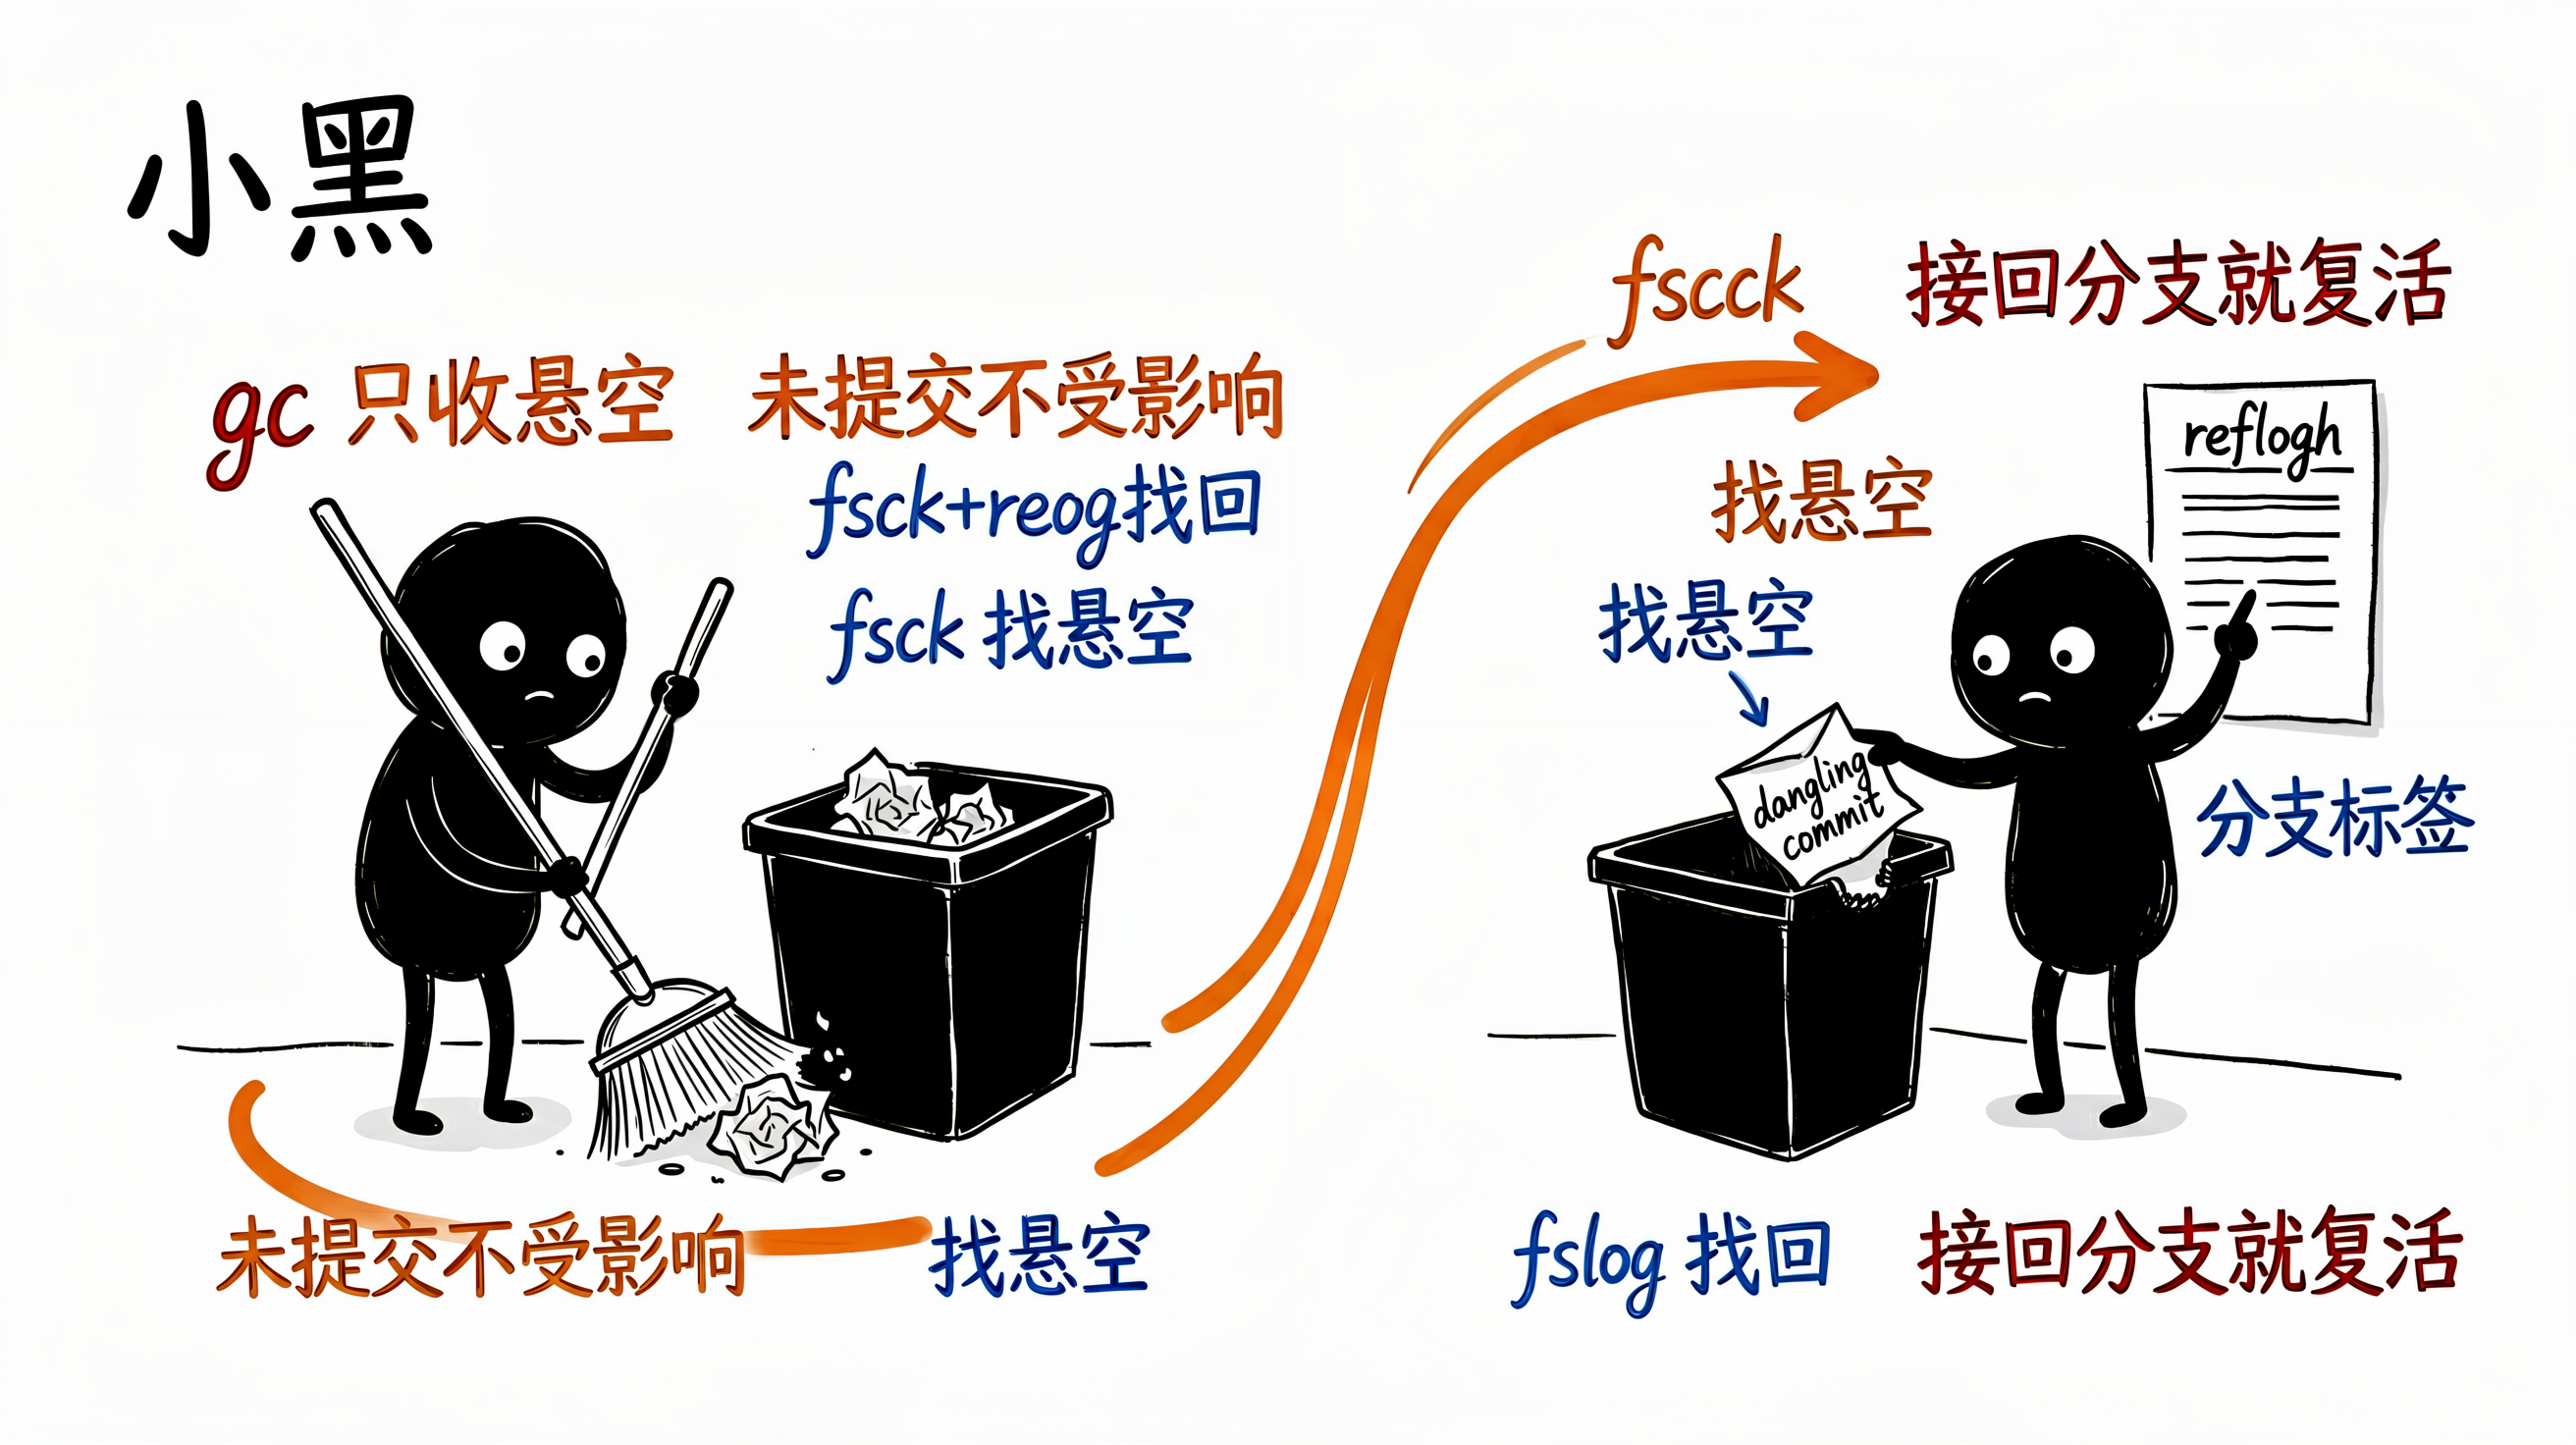
git gc(garbage collection,垃圾回收) 把零散的松散对象合并进 packfile、清理过期的引用日志(reflog),并顺手做容量整理。理解它能避免两个常见恐慌:
- "我
git gc会不会删掉我没提交的工作?" 不会。gc只回收"没有任何引用可达"的悬空对象,且默认保留一定天数的 reflog,未提交内容本就不在对象图里,不受影响。 - "误删了分支/reset 错了,历史没了?" 只要对象还没被回收,就能找回。
恢复的核心工具是 git fsck 和 git reflog:
bash
# 1. 扫描仓库,找出"悬空/不可达"的对象(没人引用的 commit/blob)
git fsck --full --unreachable
# 输出形如: dangling commit  abc1234...
#           dangling blob    def5678...

# 2. 通过 reflog 看 HEAD 都去过哪些提交(误删分支的救命稻草)
git reflog
# abc1234 HEAD@{0}: commit: 误提交的内容
# ...

# 3. 把悬空的 commit 重新接回一个分支,历史就"复活"了
git branch recover-branch abc1234
git checkout recover-branch

# 4. 真正做清理:打包松散对象,并按策略删除过期 reflog/对象
git gc --prune=now          # --prune=now 立即清理不可达对象
git repack -d -l            # 去重合并 packfile
实际应用场景:线上误执行了 git reset --hard 把半天的工作弄丢,只要没跑过 gc --prune,用 git reflog 找到 reset 之前的那个 SHA-1,再 git reset --hard <sha> 即可原样找回------这正是"内容寻址 + 不可变对象 + reflog"三者合力带来的容错能力。
日常维护上,推荐在大型仓库定期跑 git gc --auto(Git 在很多命令后也会自动触发),遇到对象库异常时用 git fsck 自检,而不是等到空间告警才处理。
总结
回到开头那句话:Git 的核心只是一个内容寻址的键值数据库。把这句话吃透,其余概念都顺理成章:
- blob / tree / commit / tag 是在键值存储上搭出来的四种对象,commit 串成链表就是历史;
- SHA-1 既决定内容寻址的 key,也决定
.git/objects的ab/cdef分目录布局; - refs / HEAD 只是存着 SHA-1 的文本文件,分支因此能随意移动、删除、重建;
- packfile 用 delta 增量压缩解决存储与传输膨胀;
- gc 负责打包与清理,而
fsck+reflog让误删数据可恢复。
下次再遇到 Git "怪现象",先问一句"它底层那个对象/引用现在长什么样",用 cat-file、show-ref、fsck 三板斧亲自看一眼,比背一百条命令都管用。
参考资料
- Pro Git 第 10 章 Git Internals(Git 官方文档):https://git-scm.com/book/en/v2/Git-Internals-Plumbing-and-Porcelain
- Git Objects / Packfiles / Maintenance and Data Recovery:https://git-scm.com/book/en/v2/Git-Internals-Git-Objects
© 2026 | 转载请注明出处