jquick-pdf 核心原理解析:基于 HTML 模板动态渲染 PDF 的实现逻辑
引入
当 PDF 出现文字重叠、分页异常或中文缺字时,很多人只能反复改样式,却不知道错误发生在哪一层。直接调用底层 PDF API 的问题是调用方同时承担数据、坐标与输出管理,排查路径不清晰。jquick-pdf 使用类 HTML 模板建立了更高层抽象,但理解它仍然需要知道"模板如何进入渲染器"。本文不讨论源码之外的猜测,而是依据 4.0.0 的入口、配置类与样例,拆开一条真实可验证的执行链路,并给出可复用的排错顺序。
核心讲解
入口、上下文与配置
核心类是 com.github.paohaijiao.executor.JQuickPdfFactory,变量由内部上下文(JContext)保存,页面与文档配置由 JPdfConfig 保存。模板常用 <pdf><body>,元素包括 <h1>、<p>、<div>、<table>、<list>、<image> 与 <svg>。executeContent、executeResource、executeFile 最终都返回字节数组。当前基线为 jquick-pdfx 4.0.0、JDK 8+;类 HTML 不等于浏览器 HTML。
六层渲染链路
把生成过程拆成六层,每一层都可以单独验证:
- 读入层:字符串、classpath 资源或磁盘文件被读成 UTF-8 模板文本。
- 解析层:ANTLR4 解析器识别标签、属性、文本与占位符,形成可遍历的内部结构。
- 变量绑定层:
${requestId}从工厂绑定的变量中取值,&{svg}用于已注册资源。 - 布局与分页层:元素渲染器处理字体、边距、尺寸与表格,并交由布局引擎计算分页位置。
- 渲染输出层:渲染器把结果交给 PDFBox,绘制到内存输出流。
- 结果返回层:执行器取出
byte[]返回调用方。
因此看到异常时,应先确认输入,再确认语法,再看数据与布局,最后才怀疑输出环节。
各层的验证动作
每一层都可以用很小的成本单独确认,避免在整份报表上反复试错:
- 读入层:把模板换成固定的 Java 字符串,排除资源路径与编码问题;
- 解析层:模板里只留一个元素,确认能输出后再逐个加回标签;
- 绑定层:先绑定固定字符串,再绑定业务对象,区分数据为空与占位符写错;
- 布局层:固定字体与尺寸后观察换页位置,再引入长度可变的字段;
- 渲染层:先用纯英文验证字体链路,再验证中文与特殊符号。
分层结构与可插拔资源
jquick-pdfx 内部包含解析器、访问者、元素渲染器、布局与 PDF 输出;visitor 负责把语法节点分派到对应元素,render 负责实际绘制。图表能力通过 jquick-pdf-svg 与配置模型(JOption、JChart、JTitle、JLegend 等)与文档层衔接,属于可插拔资源。这个分层使普通文档无需直接理解 PDFBox 坐标,也让图表不必进入核心依赖。
关键细节
异常的分层定位
不同异常对应不同层次,先分类再排查能节省大量时间:依赖缺失或类加载失败属于第 1 层之前的环境问题;标签未闭合、属性拼写错误通常在第 2 层抛出;变量未替换或值为空应回到第 3 层检查 bind 键;文字重叠、分页断裂属于第 4 层;输出流为空或长度异常则要看第 5、6 层。此外,工厂与内部上下文都不适合跨请求共享:若异常表现为"上一次请求的数据出现在本次文档里",应优先怀疑上下文复用,而不是模板语法。日志中建议记录模板版本、请求编号与输出耗时,不记录客户敏感正文,这样可以把解析错误、数据错误与布局错误分开。
用删减元素做二分排错
当一份复杂模板渲染异常时,推荐用二分法缩小范围:先删除图片与复杂样式,只保留标题与一段文字;确认通过后,再逐项恢复表格、绑定值与分页节点。每恢复一部分就重新执行一次,第一个开始报错或版式异常的元素就是嫌疑点。这种方法虽然朴素,却能快速把问题归因到输入、解析、绑定或布局阶段,不必凭最终 PDF 的视觉现象猜测内部原因。
显式分页与自然分页的行为差异
显式分页元素与内容自然溢出属于两条不同路径:<htmlPageBreak> 给出确定性的换页指令,适合验证"分页功能本身是否可用";自然分页则由布局引擎根据剩余空间决定,受字体、行高与边距影响更大。两者应分别回归,且都应覆盖长表格、中文与空值。keepTogether、keepWithNext 之类属性属于分页提示,不能理解为绝对禁止分页。
变量绑定与资源注册
bind 写入变量上下文,bindAll 适合把 DTO 转换后的 Map 批量注入;变量绑定适合标量与已经格式化的业务值,模板不承担复杂计算。SVG 资源可以先渲染成字符串后通过 ${svg} 绑定,也可以注册图表资源后使用 &{svg},这两条路径都应单独回归。模板复用能力通过 <template> 元素承载,同样以样例为准。
样式属性的分层归属
布局相关属性包括 marginLeft、marginTop、paddingLeft、paddings、width、height、minHeight、maxWidth、verticalAlignment、spacingRatio;文本相关属性包括 font、fontFamilyNames、fontSize、fontColor、bold、italic、underline、textAlignment;视觉相关属性包括 backgroundColor、backgroundImage、border 与四边单独边框、borderRadius、opacity、strokeColor。keepTogether 用于块级分页预留,keepWithNext 在样式模型里可被解析,两者都属于分页提示而非绝对约束;单位与值的写法以 README 与样例为准。
实战说明
Maven 依赖与样例索引
xml
<dependency>
    <groupId>io.github.paohaijiao</groupId>
    <artifactId>jquick-pdfx</artifactId>
    <version>4.0.0</version>
</dependency>
使用 JDK 8+(环境配置细节参见本系列入门篇)。研究原理时建议先阅读 sample/text、sample/layout、sample/style 与 sample/special,它们分别展示文本、布局、样式与变量等最小语法。不要只看 README 的属性列表,要用样例验证属性组合,避免把浏览器行为误认为库的行为;jquick-pdfx/src/test/resources/sample 可作为语法索引。
RenderPipelineDemo
以下程序把绑定、解析、分页与输出串在一条链路上,运行后输出 pipeline.pdf:
java
import com.github.paohaijiao.executor.JQuickPdfFactory;
import java.nio.file.Files;
import java.nio.file.Paths;

public class RenderPipelineDemo {
    public static void main(String[] args) throws Exception {
        String template = "<pdf><body>"
                + "<h1>'运行链路示例'</h1>"
                + "<p>'请求编号:'${requestId}</p>"
                + "<p>'第一阶段:模板已进入解析流程。'</p>"
                + "<htmlPageBreak>'第二页'</htmlPageBreak>"
                + "<p>'第二阶段:分页节点之后继续布局和渲染。'</p>"
                + "</body></pdf>";

        // 绑定请求上下文并触发解析、布局和 PDF 输出
        byte[] pdf = new JQuickPdfFactory()
                .bind("requestId", "REQ-001")
                .executeContent(template);
        Files.write(Paths.get("pipeline.pdf"), pdf);
    }
}
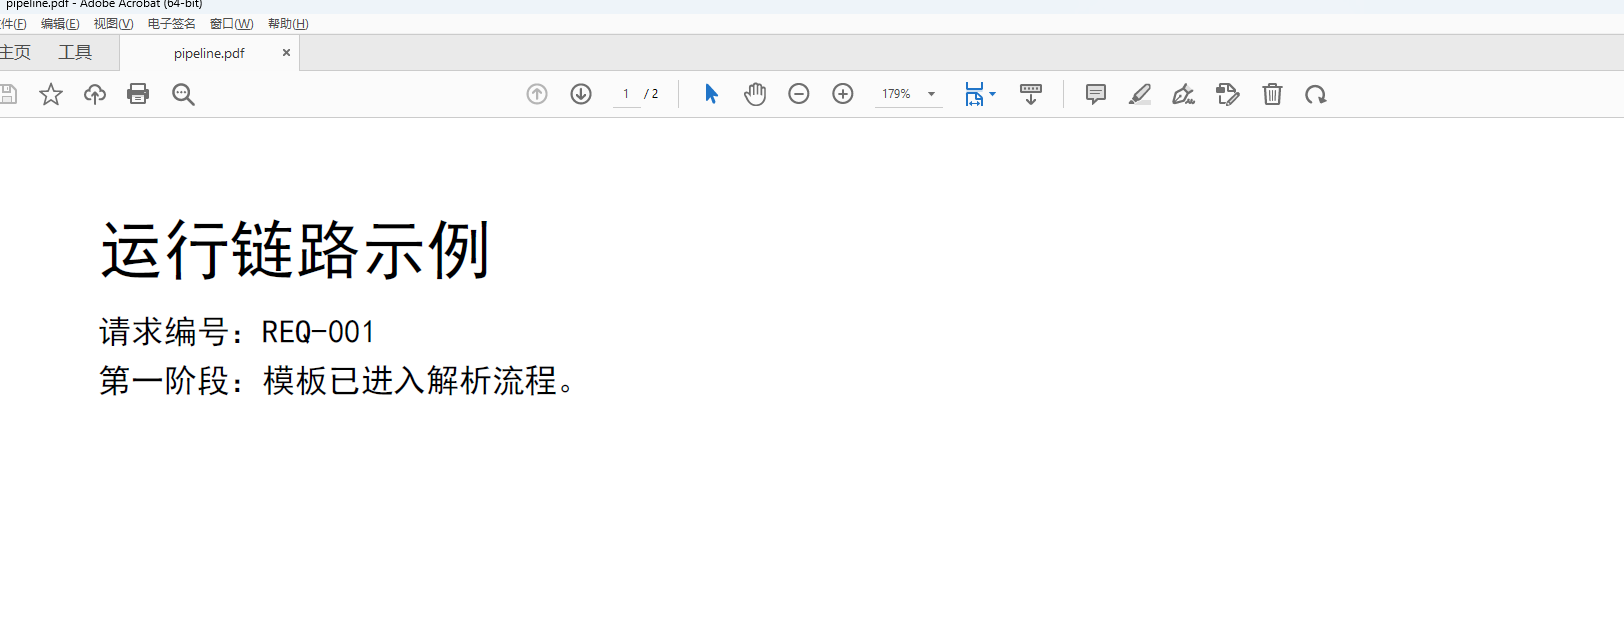
效果 如下:
结果预期与排查路径
运行后应得到两页内容:第一页为标题与两段文字,第二页以 '第二页' 开头并接一段说明。若第一页缺少标题,优先检查解析层;若第二页没有出现,检查分页元素位置;若变量未替换,检查 bind 键名与模板占位符是否一致。把结果与预期逐项对照,就能确认失败落在六层中的哪一层。如果只调整样式而问题依旧,说明问题很可能不在布局层,应回到解析层与绑定层检查模板与数据。
生产边界
最容易误判的是把"HTML"理解成完整浏览器标准,随后使用未实现的 CSS 属性。其次是跨线程复用工厂,造成变量上下文串数据;大图片与超长文本会显著抬高布局阶段内存;只测短文本则无法暴露真实分页问题。模板解析与 PDF 生成都属于请求成本,固定模板可从资源读取并在业务层缓存文本,但带变量的上下文与工厂要按请求创建;高并发服务可把慢导出放入异步队列,接口只返回任务编号。性能测试应统计平均耗时、P95、输出字节与堆内存峰值,而不是只看一次成功结果。
按分层组织落地
合同、信用报告、账单与归档报告需要稳定分页与审计追踪,最适合按六层链路来组织:模板仓库存版式,服务层准备数据,渲染层负责产物,测试层验证关键页。微服务中可以把模板版本随业务版本发布,出现版式回退时按版本定位;对外下载场景则在 PDF 生成成功后再写响应,避免中途异常产生半个文件。
总结
- 六层链路是排错地图:读入、解析、变量绑定、布局与分页、渲染输出、结果返回,异常先分层再定位。
- 二分删减是最实用的定位手段:先保留标题与一段文字,再逐项恢复表格、绑定值与分页节点。
- 显式分页与自然分页必须分开回归;
keepTogether/keepWithNext只是分页提示,不是绝对约束。
适用边界与常见误区:jquick-pdf 位于"模板抽象"与"纯 Java 部署"之间,适合规则明确的业务文档,不适合依赖脚本与完整浏览器布局的页面;它与 iText、PdfBox 不是替代关系,后两者在底层控制上更强。常见误区包括把模板当浏览器页面、跨请求复用工厂、用超长表格单次渲染,以及在没有样例支持的情况下假定额外能力。
版本基线:jquick-pdfx 4.0.0、JDK 8+;许可证与版本强相关,上线前请核对 README 版本对照表;更多示例见 GitHub 仓库。