一、上篇回顾与这节课的增量
上篇(lesson55)咱们把骨架搭好了:模板方法模式封装 Socket、策略模式写日志、双 fork 处理并发、jsoncpp 的基本用法。但那时候的服务器是个"会接电话但不说话"的空壳------
Protocol::GetRequest是空函数,Request::Serialize和Deserialize也是空壳,客户端连上就断。这节课(lesson56)把空壳全部填满,真正跑通一条完整的链路:
cpp
客户端发 "10 + 20" → 服务端算 → 回 "30"和上篇对比,lesson56 新增/改动了这些文件:
| 文件 | 变化 | 增了什么 |
|---|---|---|
Socket.hpp |
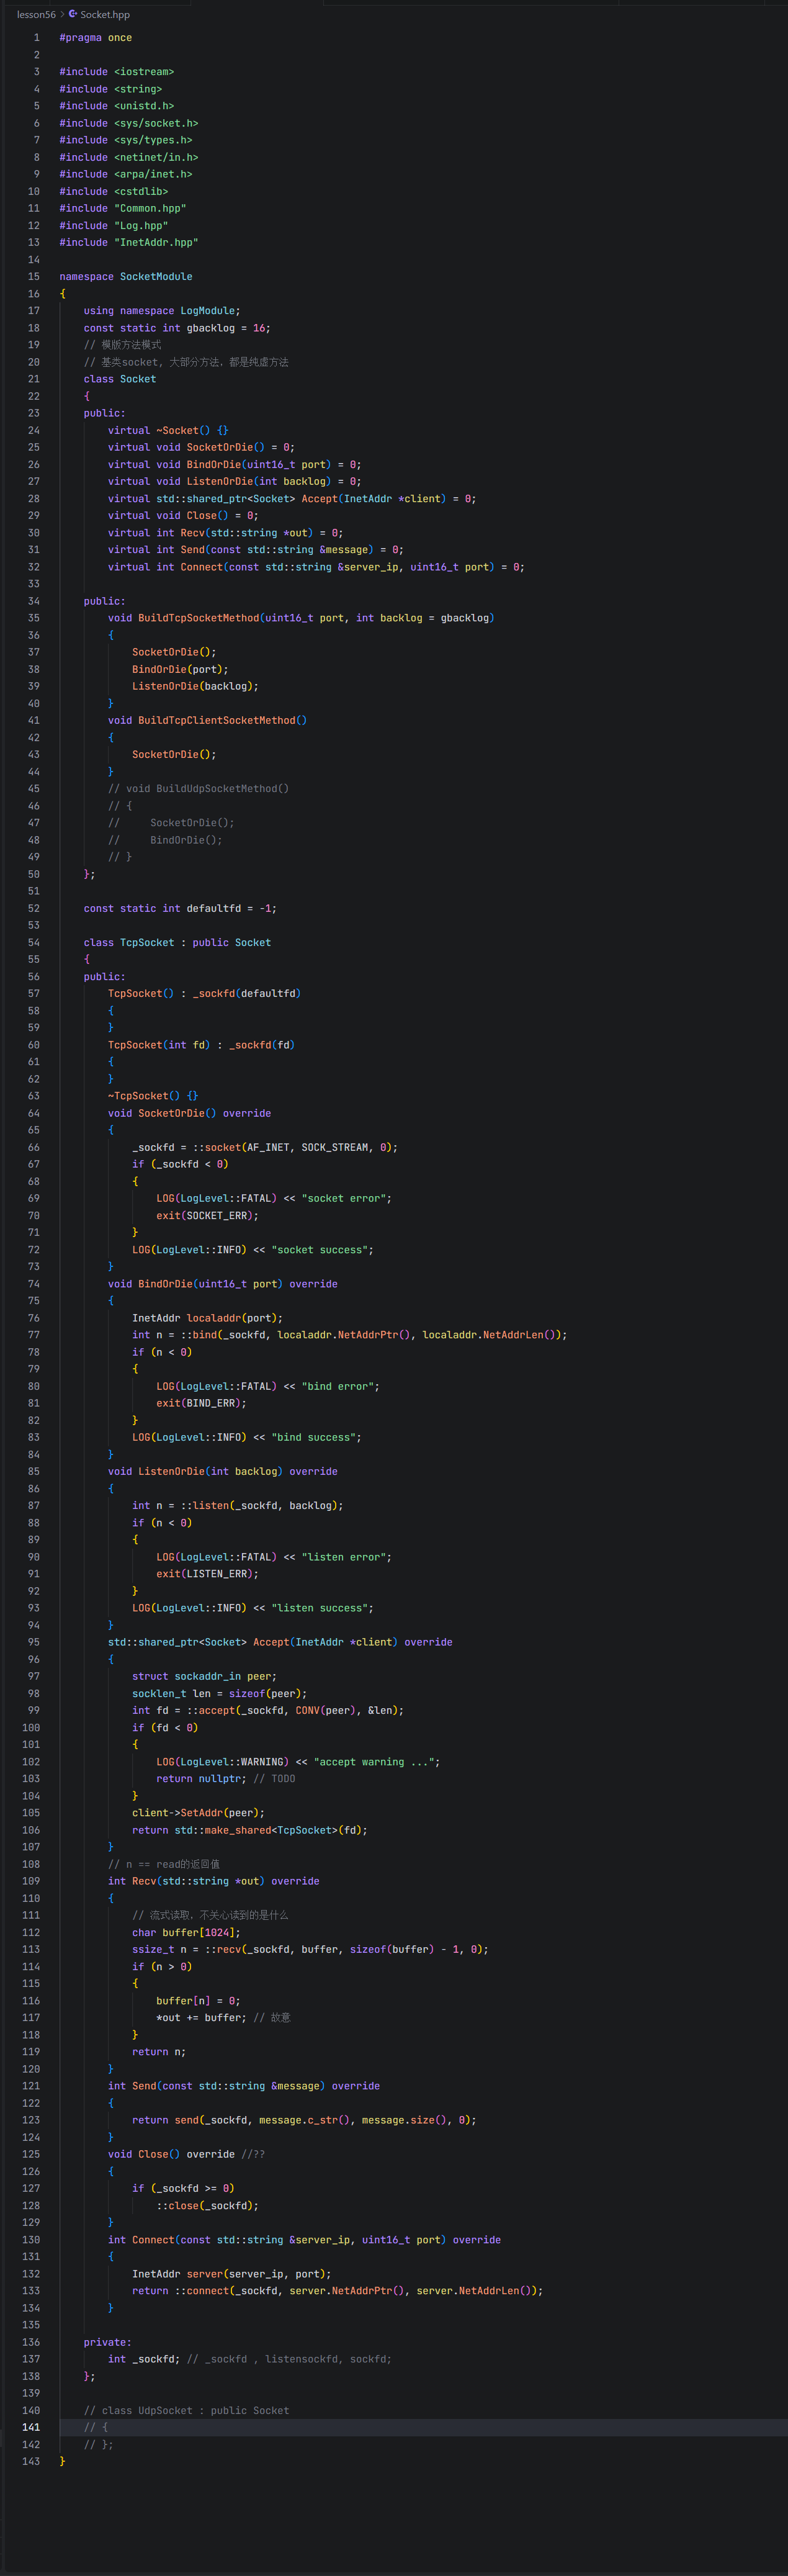
改 | 基类加了 Recv/Send/Connect 三个纯虚函数;加了 BuildTcpClientSocketMethod;Close 补了 override |
Protocol.hpp |
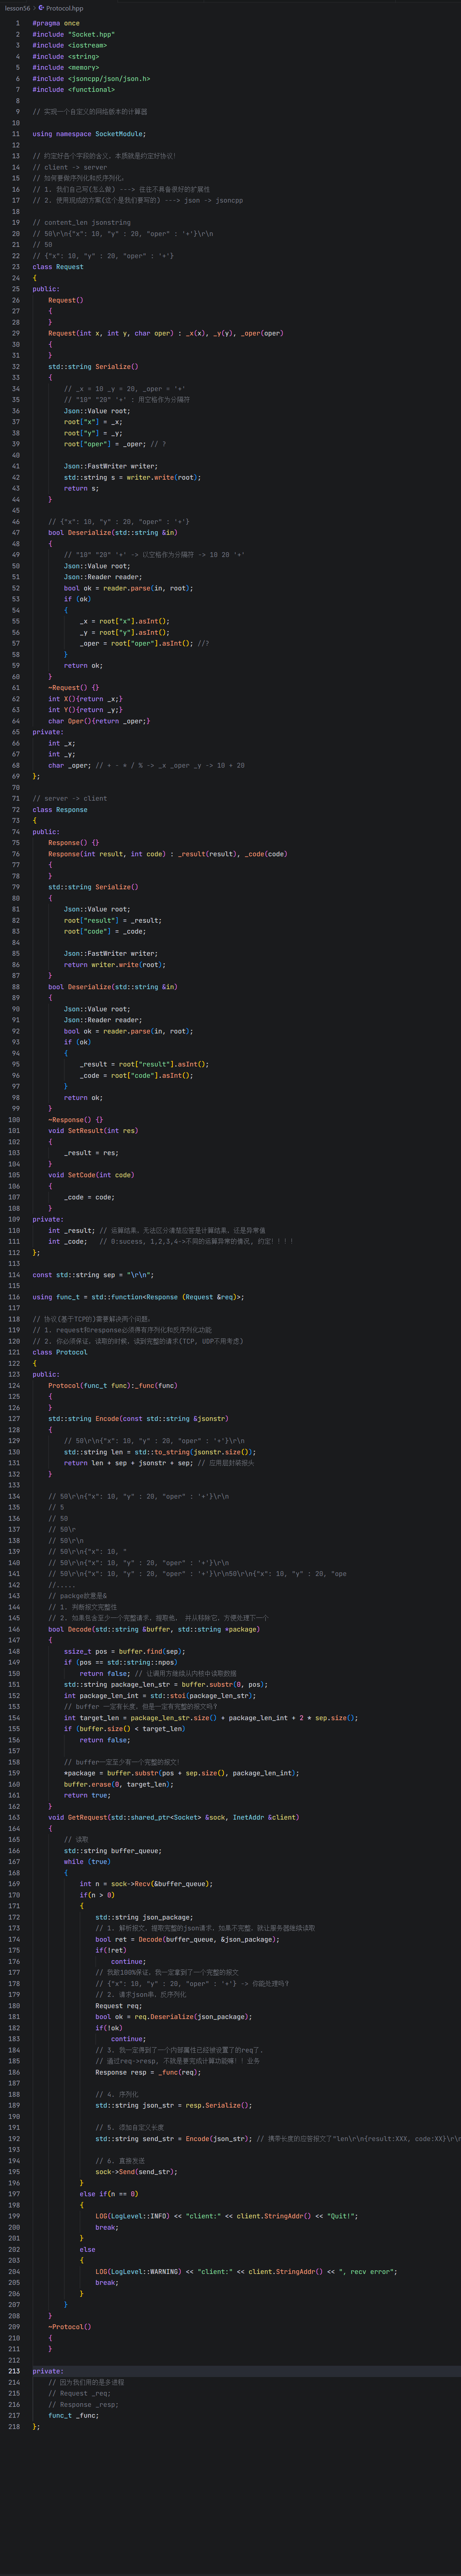
大改 | 序列化/反序列化全部用 JSON 填满;新增 Encode/Decode 解决 TCP 粘包;GetRequest 六步完整流水线 |
NetCal.hpp |
新文件 | Cal 类,真正干计算业务的,+ - * / % 五则运算 |
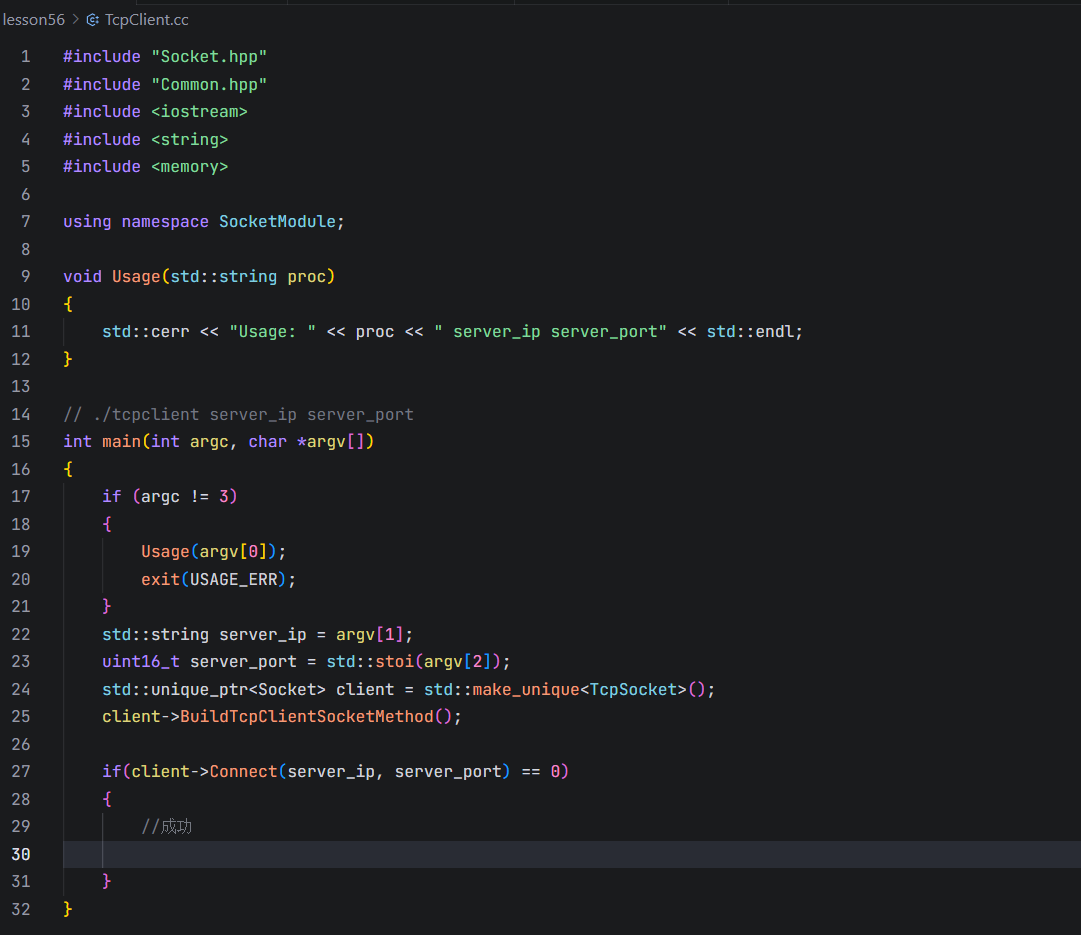
TcpClient.cc |
新文件 | 替代上篇的空 TcpClient.hpp,能连上服务器了 |
Main.cc |
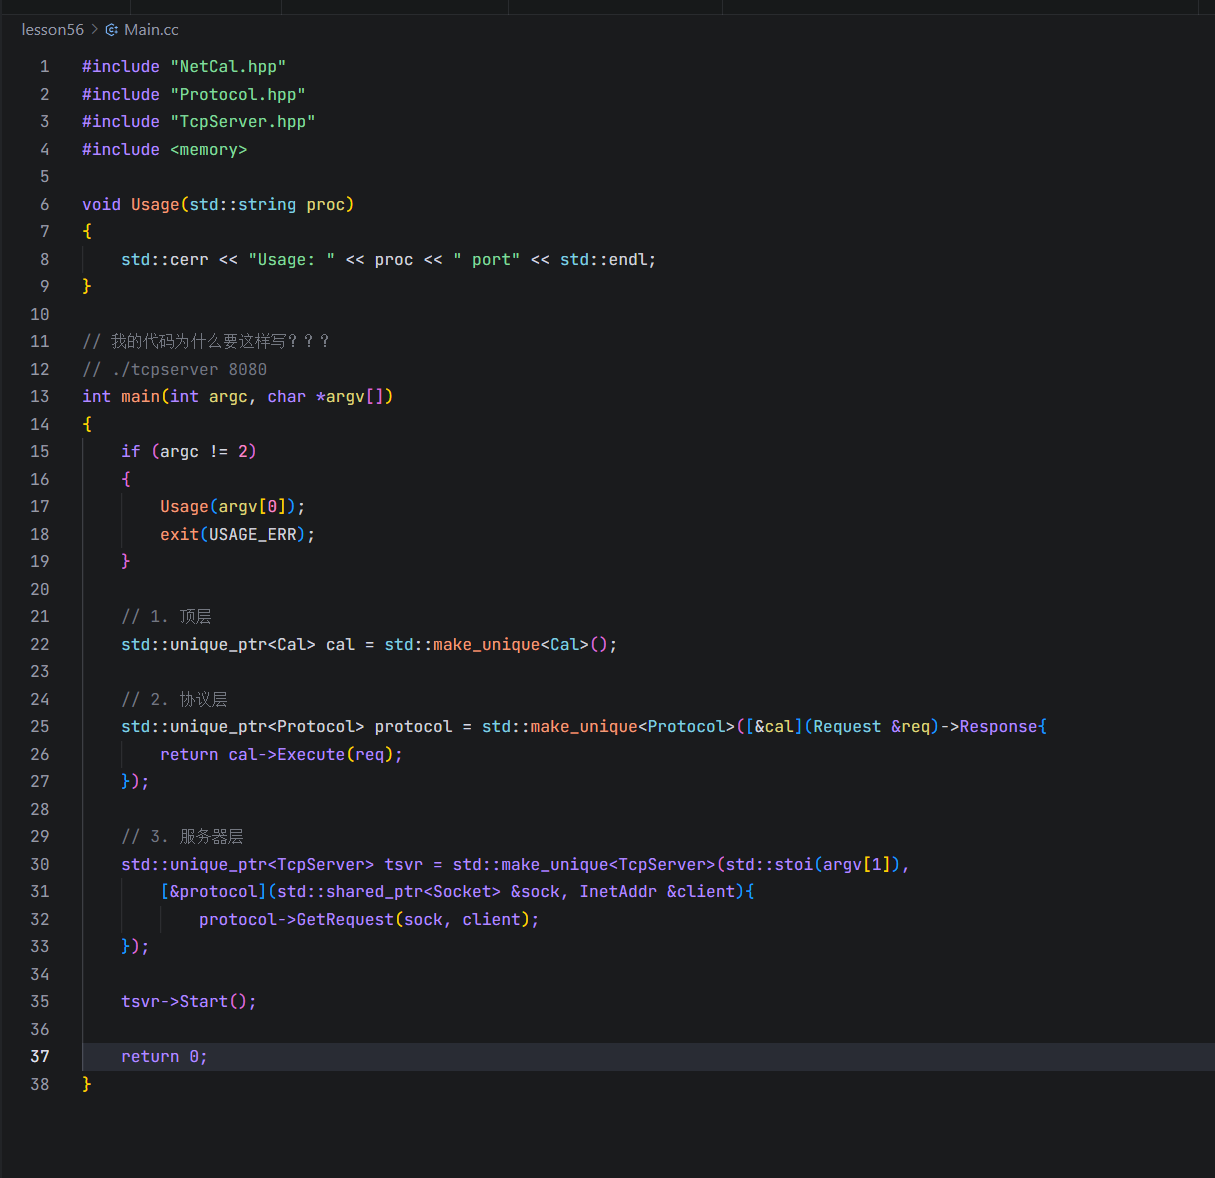
改 | 三层架构:Cal(业务)→ Protocol(协议)→ TcpServer(传输) |
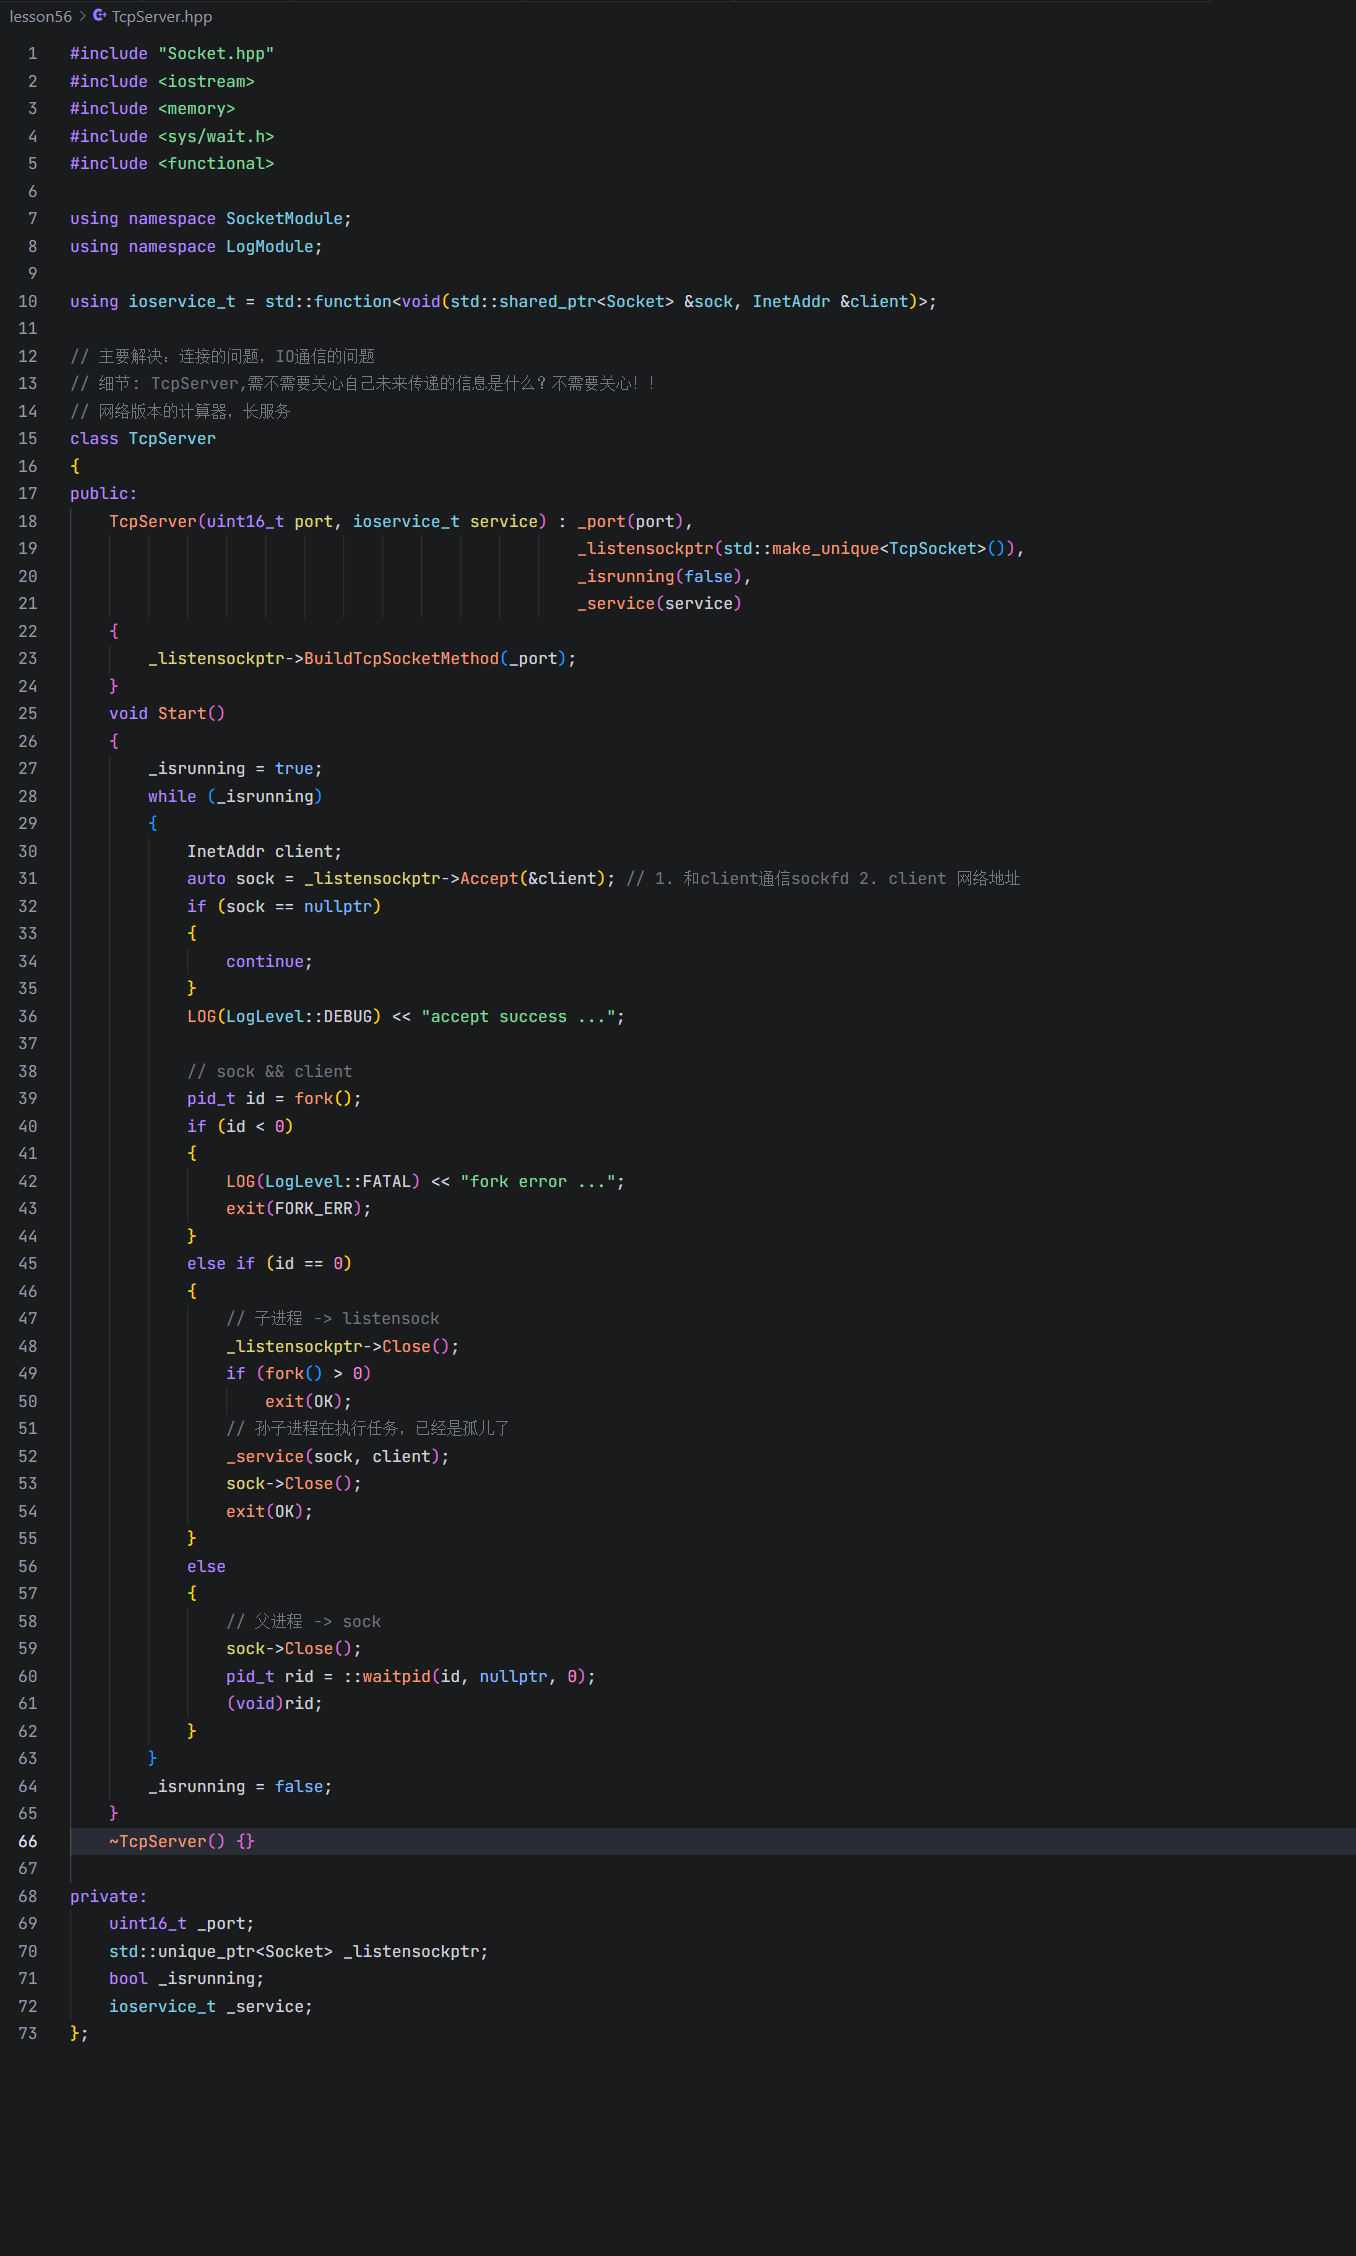
TcpServer.hpp |
小改 | 孙子进程干完活后加了 sock->Close() |
Makefile |
有坑 | main.cc 小写,实际文件名是 Main.cc 大写 |
没变的文件(和 lesson55 一模一样):Common.hpp、InetAddr.hpp、Log.hpp、Mutex.hpp、testjson.cc。这几个上篇讲过了,今天不重复。
二、Socket.hpp:三个新接口和一个客户端模板方法
上篇讲模板方法模式时说了,基类定义步骤、子类填实现。这节课基类加了三个新步骤:
2.1 三个新纯虚函数
cpp
virtual int Recv(std::string *out) = 0;
virtual int Send(const std::string &message) = 0;
virtual int Connect(const std::string &server_ip, uint16_t port) = 0;
注意返回值类型是
int,不是void------因为收发和连接都有"成功/失败/对端关闭"三种状态,必须告诉调用方。
2.2 BuildTcpClientSocketMethod:客户端的模板方法
cpp
void BuildTcpClientSocketMethod()
{
    SocketOrDie();
}
上篇服务器的模板方法是
BuildTcpSocketMethod(socket + bind + listen 三步),客户端不需要 bind 和 listen------客户端只需要创建套接字然后 connect。所以这里只调了SocketOrDie()一步。这进一步体现了模板方法模式的扩展性:同一批步骤函数,换个模板方法就能拼出不同角色的流程。服务器有服务器的模板方法,客户端有客户端的模板方法,但步骤的实现代码是复用的。
2.3 TcpSocket 的三个新实现逐行看
Recv------流式读取,不关心读到的是什么:
cpp
int Recv(std::string *out) override
{
    char buffer[1024];
    ssize_t n = ::recv(_sockfd, buffer, sizeof(buffer) - 1, 0);
    if (n > 0)
    {
        buffer[n] = 0;
        *out += buffer;
    }
    return n;
}
逐行拆:
char buffer[1024]:1024 字节的栈上缓冲区。sizeof(buffer) - 1留一个字节给\0,这是 C 字符串的规矩;
::recv(_sockfd, buffer, sizeof(buffer) - 1, 0):第四个参数0表示默认阻塞读取,没有特殊标志。ssize_t是有符号整数,-1出错,0对端关闭,>0实际读到的字节数;
buffer[n] = 0:手动加结尾符。recv不负责加\0,它只管搬运字节,加不加结尾符是你自己的事,这里n恰好就是数据末尾的下标;
*out += buffer:把读到的东西追加到外部的 string 里,不是覆盖。注释说"故意",因为这是解决粘包的关键设计------每次 recv 读到的可能只是半条报文,先攒着,下次 recv 再追加,凑够了再解析。参数是string*指针而不是引用,风格选择而已。
这里有个细节:为什么返回 n 而不是返回 out->size()?因为调用方需要区分"读到了数据(n>0)"、"对端关闭(n==0)"、"出错(n<0)"三种情况,n 就是 recv 系统调用的原始返回值,语义最清晰。
Send------直接发:
cpp
int Send(const std::string &message) override
{
    return send(_sockfd, message.c_str(), message.size(), 0);
}
send的返回值是实际发出的字节数,可能小于message.size()(叫"短写")。这里直接把返回值丢给调用方,没做短写重试。对学习用的计算器够用了,工业级代码应该循环 send 直到全部发完。
Connect------客户端连服务器:
cpp
int Connect(const std::string &server_ip, uint16_t port) override
{
    InetAddr server(server_ip, port);
    return ::connect(_sockfd, server.NetAddrPtr(), server.NetAddrLen());
}
用
InetAddr(server_ip, port)构造服务器地址(这个构造函数上篇讲过,会调inet_pton把点分十进制 IP 转成网络字节序),然后connect发起三次握手。返回0表示连接成功,-1表示失败(比如服务器没开、端口不对)。
2.4 Close 终于加了 override
上篇里 Close() 写了个 //??,没加 override。这节课补上了:
cpp
void Close() override
{
    if (_sockfd >= 0)
        ::close(_sockfd);
}
上篇讲过为什么该加
override:让编译器帮你校对签名,写错了直接报错而不是悄悄变成一个新函数。这回作者自己也想通了。
三、NetCal.hpp:真正干活的计算器
这是个新文件,短小精悍,但它是整个工程的业务核心。
3.1 Cal 类全貌
cpp
class Cal
{
public:
    Response Execute(Request &req)
    {
        Response resp(0, 0); // code: 0表示成功
        switch (req.Oper())
        {
        case '+':
            resp.SetResult(req.X() + req.Y());
            break;
        case '-':
            resp.SetResult(req.X() - req.Y());
            break;
        case '*':
            resp.SetResult(req.X() * req.Y());
            break;
        case '/':
        {
            if (req.Y() == 0)
            {
                resp.SetCode(1); // 1除零错误
            }
            else
            {
                resp.SetResult(req.X() / req.Y());
            }
        }
        break;
        case '%':
        {
            if (req.Y() == 0)
            {
                resp.SetCode(2); // 2 mod 0 错误
            }
            else
            {
                resp.SetResult(req.X() % req.Y());
            }
        }
        break;
        default:
            resp.SetCode(3); // 非法操作
            break;
        }
        return resp;
    }
};
3.2 逐行拆
Response resp(0, 0):构造时 result=0、code=0,默认假设成功。这个"先成功后纠错"的思路很实用------先设好正常返回值,碰到异常再覆盖 code;
req.Oper()、req.X()、req.Y():这三个是 Request 的 getter,上篇还是空壳的 Request 这节课加了取值接口。Oper()返回char,就是运算符字符;
switch按char分支:C++ 的switch能吃char(因为char是整数类型),'+'、'-'这些字符常量本质就是 ASCII 码(43、45、42、47、37);除法和取模各加了除零保护:
if (req.Y() == 0)直接设 code 不设 result。注意除法和取模用了大括号{}包起来,因为里面定义了局部变量就得分块(这里虽然没定义局部变量,但加了块更清晰);
default设 code=3:非法运算符。
3.3 错误码约定
| code 值 | 含义 |
|---|---|
| 0 | 成功 |
| 1 | 除零错误 |
| 2 | 取模零错误 |
| 3 | 非法运算符 |
这就是上篇说的"约定好各个字段的含义,本质就是约定好协议"。客户端和服务端都得知道这套约定才能正确理解 Response。
3.4 实测验证
我拿 Python 写了个测试客户端,7 种场景全跑了一遍:
cpp
10 + 20 -> code=0, result=30
100 - 5 -> code=0, result=95
7 * 8   -> code=0, result=56
10 / 0  -> code=1, result=0   (除零保护生效)
10 % 0  -> code=2, result=0   (模零保护生效)
10 ^ 5  -> code=3, result=0   (非法运算符)
10 % 3  -> code=0, result=1   (正常取模)
全对。注意 10 ^ 5 里 ^ 不在 +-*/% 里,走 default 分支,code=3。
四、Protocol.hpp:这节课的重头戏
上篇这个文件是空架子,四个序列化函数函数体全空。这节课全部填满,还新增了报文分隔逻辑。我按模块拆开讲。
4.1 Request:序列化与反序列化填满了
序列化------对象 → JSON 字符串:
cpp
std::string Serialize()
{
    Json::Value root;
    root["x"] = _x;
    root["y"] = _y;
    root["oper"] = _oper; // char 赋给 Value,存成整数

    Json::FastWriter writer;
    std::string s = writer.write(root);
    return s;
}
上篇讲过 jsoncpp 的套路:先造
Json::Value,往里塞键值对,再用 Writer 转成字符串。这里用FastWriter------单行紧凑格式,适合网络传输。有个细节必须点出来:
root["oper"] = _oper,_oper是char类型。在 C++ 里char本质是整数,赋给Json::Value时会被当int存。我实测过:
cpp
'+'(ASCII 43) -> {"oper":43}
'-'(ASCII 45) -> {"oper":45}
'*'(ASCII 42) -> {"oper":42}
'/'(ASCII 47) -> {"oper":47}
'%'(ASCII 37) -> {"oper":37}
也就是说 JSON 里的
oper字段是个整数 (ASCII 码),不是字符串"+"。代码注释里那个// ?就是作者在思考这个问题。
反序列化------JSON 字符串 → 对象:
cpp
bool Deserialize(std::string &in)
{
    Json::Value root;
    Json::Reader reader;
    bool ok = reader.parse(in, root);
    if (ok)
    {
        _x = root["x"].asInt();
        _y = root["y"].asInt();
        _oper = root["oper"].asInt(); // int 赋给 char,截断取低字节
    }
    return ok;
}
和上篇讲的反序列化四步一模一样:造 Value + 造 Reader + parse + asXxx 取值。
_oper = root["oper"].asInt()把整数 43 取回来赋给char,43 就是'+'的 ASCII 码,完美还原。
parse失败返回 false,这里检查了ok,不像 testjson.cc 里(void)ok故意不检查。工程代码必须检查。
getter 接口:
cpp
int X(){return _x;}
int Y(){return _y;}
char Oper(){return _oper;}
给 Cal::Execute 用的取值接口,没什么花样。
4.2 Response:和 Request 镜像
cpp
std::string Serialize()
{
    Json::Value root;
    root["result"] = _result;
    root["code"] = _code;

    Json::FastWriter writer;
    return writer.write(root);
}
bool Deserialize(std::string &in)
{
    Json::Value root;
    Json::Reader reader;
    bool ok = reader.parse(in, root);
    if (ok)
    {
        _result = root["result"].asInt();
        _code = root["code"].asInt();
    }
    return ok;
}
结构完全一样,字段换成了 result 和 code。setter 也加上了:
cpp
void SetResult(int res) { _result = res; }
void SetCode(int code) { _code = code; }
Cal::Execute 里除零时只设 code 不设 result(result 保持构造时的 0),成功时只设 result 不设 code(code 保持 0)。这种"先默认成功、出错再覆盖"的写法比每个分支都同时设两个值更简洁。
4.3 报文分隔符与业务回调类型
cpp
const std::string sep = "\r\n";

using func_t = std::function<Response(Request &req)>;
sep是报文分隔符,用\r\n。选\r\n不选\n是因为 HTTP 协议也用\r\n当行分隔符,跟着工业惯例走不会错。而且\r\n不会出现在 JSON 字符串的值里(JSON 里换行是\n或\r\n的转义形态\\n、\\r),不会和内容冲突。
func_t是业务回调的类型定义:吃一个 Request,返回一个 Response。这就是把业务逻辑(Cal::Execute)从协议处理(Protocol)里剥离出来的接口。
4.4 Encode:加报头,给报文套个"信封"
cpp
std::string Encode(const std::string &jsonstr)
{
    std::string len = std::to_string(jsonstr.size());
    return len + sep + jsonstr + sep;
}
函数体就一行拼接。输入是一段 JSON 字符串(比如 {"x":10,"y":20,"oper":43}\n),输出长这样:
cpp
26\r\n{"x":10,"y":20,"oper":43}\n\r\n拆开看结构:
cpp
26              ← JSON 字符串的长度(字节数)
\r\n            ← 分隔符,分隔"长度"和"内容"
{"x":10,...}    ← JSON 正文
\r\n            ← 分隔符,标记正文结束
为什么要加这个长度头?下一节讲。
4.5 Decode:拆信封,解决 TCP 粘包
这是这节课最精妙的代码,也是上篇留下的第二个问题的答案。
上篇留的问题:TCP 是字节流,没有消息边界。
你发了两个请求 {"x":10,...} 和 {"x":20,...},对端可能收到的是:
cpp
情况1: {"x":10,...}{"x":20,...}        (两个粘在一起)
情况2: {"x":10,...}{"x":2               (第二个被切了一半)
情况3: {"x":10,...                      (只收到第一个,第二个还没到)
对端拿到一坨字节,怎么知道一条报文从哪开始、到哪结束?
答案就是 Encode 加的那个长度头。Decode 负责从缓冲区里按"长度头 + 内容"的格式,拆出一条完整的报文。来看代码:
cpp
bool Decode(std::string &buffer, std::string *package)
{
    ssize_t pos = buffer.find(sep);
    if (pos == std::string::npos)
        return false;
    std::string package_len_str = buffer.substr(0, pos);
    int package_len_int = std::stoi(package_len_str);
    int target_len = package_len_str.size() + package_len_int + 2 * sep.size();
    if (buffer.size() < target_len)
        return false;

    *package = buffer.substr(pos + sep.size(), package_len_int);
    buffer.erase(0, target_len);
    return true;
}
逐行拆,这是必须啃透的代码:
第一步:找第一个 \r\n 的位置。
cpp
ssize_t pos = buffer.find(sep);
if (pos == std::string::npos)
    return false;
buffer.find(sep) 找 \r\n 第一次出现的位置。找不到(npos)说明连长度头都不完整------可能只收到 "26" 还没收到 \r\n,让调用方继续 recv。
第二步:解析出内容长度。
cpp
std::string package_len_str = buffer.substr(0, pos);
int package_len_int = std::stoi(package_len_str);
substr(0, pos) 取 \r\n 前面的字符串,就是长度数字(比如 "26")。std::stoi 转成整数 26。
第三步:算出一条完整报文的总长度。
cpp
int target_len = package_len_str.size() + package_len_int + 2 * sep.size();一条完整报文 = 长度数字的位数 + 内容长度 + 两个分隔符的长度。
拿 26\r\n{"x":10,...}\r\n 举例:
| 部分 | 内容 | 字节数 |
|---|---|---|
| 长度数字 | "26" |
2 |
| 第一个 sep | \r\n |
2 |
| JSON 正文 | {"x":10,"y":20,"oper":43}\n |
26 |
| 第二个 sep | \r\n |
2 |
| 总计 | 32 |
target_len = 2 + 26 + 2*2 = 32。
第四步:检查缓冲区里够不够一条完整报文。
cpp
if (buffer.size() < target_len)
    return false;
缓冲区里的字节数不够 32?说明报文还没到齐,返回 false 让调用方继续 recv。这一步是解决"半个报文"的关键。
第五步:提取完整报文,从缓冲区里删掉。
cpp
*package = buffer.substr(pos + sep.size(), package_len_int);
buffer.erase(0, target_len);
substr(pos + sep.size(), package_len_int):从第一个 \r\n 后面开始,取 package_len_int 个字节,正好就是 JSON 正文。erase(0, target_len):从缓冲区开头删掉一整条报文的字节数,剩下的留给下一次 Decode 处理(下一条报文可能已经粘在后面了)。
这一步是解决"粘包"的关键------删掉已处理的,剩下的继续拆。
用注释里的例子走一遍,彻底理解:
代码注释里列了一串渐进式的 buffer 变化,模拟 TCP 逐字节到达的过程:
cpp
5                                    ← 只有长度头第一个字符
50                                   ← 长度头两个字符
50\r                                 ← 第一个 \r
50\r\n                               ← 第一个 \r\n 到齐,长度=50
50\r\n{"x": 10, "                   ← 开始有内容了,但还不够 50 字节
50\r\n{"x": 10, "y" : 20, ...}       ← 内容到齐了
50\r\n{...}\r\n50\r\n{"x": 10, ...   ← 第二条报文粘上来了
Decode 的逻辑能正确处理所有这些中间状态:不够就返回 false,够了一条就取出来删掉,剩下的继续留着。
4.6 GetRequest:六步完整流水线
上篇这个函数是空的,这节课填满了。这是整个协议层的核心:
cpp
void GetRequest(std::shared_ptr<Socket> &sock, InetAddr &client)
{
    std::string buffer_queue;
    while (true)
    {
        int n = sock->Recv(&buffer_queue);
        if(n > 0)
        {
            std::string json_package;
            bool ret = Decode(buffer_queue, &json_package);
            if(!ret)
                continue;
            // 到这里,一定拿到了一个完整的 JSON 报文
            Request req;
            bool ok = req.Deserialize(json_package);
            if(!ok)
                continue;
            // 到这里,req 的字段已经被正确填充
            Response resp = _func(req);   // 调业务回调,算!

            std::string json_str = resp.Serialize();
            std::string send_str = Encode(json_str);
            sock->Send(send_str);
        }
        else if(n == 0)
        {
            LOG(LogLevel::INFO) << "client:" << client.StringAddr() << "Quit!";
            break;
        }
        else
        {
            LOG(LogLevel::WARNING) << "client:" << client.StringAddr() << ", recv error";
            break;
        }
    }
}
六步流水线一张图看懂:
cpp
客户端                              服务端(GetRequest)
                                      │
                    Recv ──→  buffer_queue(追加,不覆盖)
                                      │
                              Decode(拆信封,解决粘包)
                                      │ 不完整?→ continue 继续 Recv
                                      │ 完整?↓
                              Request::Deserialize(JSON → 对象)
                                      │ 解析失败?→ continue
                                      │ 成功?↓
                              _func(req)(调业务回调 Cal::Execute)
                                      │
                              Response::Serialize(对象 → JSON)
                                      │
                              Encode(加报头,套信封)
                                      │
                              Send ←───┘
逐个点说:
buffer_queue在 while 循环外定义,跨多次 Recv 积累数据。每次Recv(&buffer_queue)往后面追加,不是覆盖;
Decode不完整就continue,回到 while 开头继续 Recv。这个 continue 是整个粘包方案能工作的关键------"不够就读,够了再拆";
Deserialize失败也 continue。JSON 格式不对(比如被截断了)就丢掉这条,等下一条;
_func(req)是业务回调。这个_func是 Protocol 构造时传进来的 lambda,实际上调的是Cal::Execute。Protocol 自己不知道算的是加减乘除,它只管"拿请求、给响应";响应也走一遍
Serialize+Encode,保证客户端也能按"长度头 + 内容"的格式正确解析;
n == 0(对端关闭)打日志 break,n < 0(出错)也打日志 break。两种情况都退出循环,孙子进程随后 exit。
注意一个设计细节:GetRequest 是个死循环------只要客户端不断,它就一直在 Recv → Decode → 处理 → Send 循环。这就是"长服务"的意思,一个连接上可以连续发多条请求。
4.7 构造函数:业务回调注入
cpp
Protocol(func_t func):_func(func)
{
}
Protocol 不拥有 Cal 对象,只持有
_func这个std::function。Cal 在 Main.cc 里创建,通过 lambda 注入。这样 Protocol 和 Cal 解耦------Protocol 管协议格式,Cal 管业务逻辑,各改各的互不影响。
五、TcpServer.hpp:一个细节的补全
和上篇对比,TcpServer 只改了一个地方:
cpp
// 上篇(lesson55):
_service(sock, client);
exit(OK);

// 这节课(lesson56):
_service(sock, client);
sock->Close();    // ← 新增
exit(OK);
孙子进程干完活之后,先关掉通信 fd 再 exit。上篇没写这行,靠的是进程退出时内核自动回收 fd。虽然功能上没区别(exit 会关掉所有 fd),但显式 Close 有两个好处:
语义清晰:读代码的人一眼看到"用完了关掉",不用猜;
养成习惯 :将来如果
_service不是死循环而是处理一条就返回的模式,不显式 Close 就得靠进程退出来兜底,不优雅。
六、Main.cc:三层架构
cpp
int main(int argc, char *argv[])
{
    if (argc != 2)
    {
        Usage(argv[0]);
        exit(USAGE_ERR);
    }

    // 1. 顶层:业务层
    std::unique_ptr<Cal> cal = std::make_unique<Cal>();

    // 2. 协议层
    std::unique_ptr<Protocol> protocol = std::make_unique<Protocol>([&cal](Request &req)->Response{
        return cal->Execute(req);
    });

    // 3. 服务器层
    std::unique_ptr<TcpServer> tsvr = std::make_unique<TcpServer>(std::stoi(argv[1]),
        [&protocol](std::shared_ptr<Socket> &sock, InetAddr &client){
            protocol->GetRequest(sock, client);
    });

    tsvr->Start();
    return 0;
}
和上篇对比,上篇只有两层(Protocol + TcpServer),这节课多了 Cal 这一层,变成了三层:
cpp
TcpServer(传输层:accept + fork + 回调)
    ↓ 回调注入
Protocol(协议层:序列化 + 报文分隔 + 反序列化)
    ↓ 回调注入
Cal(业务层:加减乘除)
每一层只跟下一层的接口打交道:
TcpServer 不知道请求是 JSON 还是自定义文本,它只调
_service(sock, client);Protocol 不知道业务是计算器还是聊天室,它只调
_func(req)拿 Response;Cal 不知道传输是 TCP 还是 UDP,它只管吃 Request 吐 Response。
想换业务?把 Cal 换成别的类,Protocol 和 TcpServer 一行不用改。想换协议格式?改 Protocol 里的 Encode/Decode,Cal 和 TcpServer 不动。这就是分层解耦的威力。
注释里写的 // 我的代码为什么要这样写??? 就是在问自己"为什么搞三层而不是两层"。答案就是:多一层 Cal,让业务逻辑和协议逻辑彻底分离。上篇 Protocol 里直接写计算逻辑的话,改协议格式就得动业务代码,改业务就得动协议代码,混在一起。
七、TcpClient.cc:客户端的雏形
上篇的 TcpClient.hpp 是个空文件,这节课换成了 TcpClient.cc,有内容了但还没写完:
cpp
int main(int argc, char *argv[])
{
    if (argc != 3)
    {
        Usage(argv[0]);
        exit(USAGE_ERR);
    }
    std::string server_ip = argv[1];
    uint16_t server_port = std::stoi(argv[2]);
    std::unique_ptr<Socket> client = std::make_unique<TcpSocket>();
    client->BuildTcpClientSocketMethod();

    if(client->Connect(server_ip, server_port) == 0)
    {
        //成功

    }
}
逐行看:
argc != 3:客户端要两个参数------服务器 IP 和端口。和服务器版(只要端口)不同;
BuildTcpClientSocketMethod():上面讲过,只调SocketOrDie()创建套接字,不 bind 不 listen;
Connect(server_ip, server_port):发起三次握手,返回 0 表示连接成功;成功后的
if块是空的------连上之后干什么还没写。
这确实是个半成品。完整的客户端应该在连接成功后:
让用户输入
x oper y构造 Request 并 Serialize
Encode 加报头
Send 发出去
Recv 收响应
Decode 拆报头
Response::Deserialize 还原
打印结果
循环回第 1 步
但即使如此,这个客户端验证了两件事:BuildTcpClientSocketMethod 和 Connect 能正确工作。我实测过,客户端连上服务器后服务端日志确实打了 accept success。
八、Makefile 里的坑:大小写
cpp
tcpserver:main.cc
	g++ -o $@ $^ -std=c++17
注意 main.cc 是小写 m ,但实际文件名是 Main.cc 大写 M 。Linux 文件系统大小写敏感,make 直接报错:
cpp
make: *** No rule to make target 'main.cc', needed by 'tcpserver'. Stop.手动编译绕过这个坑:
cpp
g++ -std=c++17 Main.cc -o tcpserver -ljsoncpp注意这里必须加 -ljsoncpp,因为 Protocol.hpp 里 #include <jsoncpp/json/json.h> 并调用了 jsoncpp 的 API。上篇的 Makefile 不需要 -ljsoncpp 是因为上篇的序列化函数是空的、没真正调 jsoncpp。这节课填满了实现,必须链接。
客户端单独编译(TcpClient.cc 不包含 Protocol.hpp、不用 jsoncpp,所以不需要 -ljsoncpp):
cpp
g++ -std=c++17 TcpClient.cc -o tcpclient九、报文格式与完整通信流程实测
9.1 报文格式总结
请求报文(client → server):
cpp
<JSON长度>\r\n{"x":10,"y":20,"oper":43}\n\r\n
oper是整数(ASCII 码),不是字符串JSON 末尾有个
\n,是 FastWriter 自动加的尾换行
应答报文(server → client):
cpp
<JSON长度>\r\n{"code":0,"result":30}\n\r\n9.2 实测一次完整通信
我拿 Python 当客户端,发了一个 10 + 20:
cpp
json_str = '{"x":10,"y":20,"oper":43}\n'   # 43 是 '+' 的 ASCII 码
packet = str(len(json_str)) + '\r\n' + json_str + '\r\n'
# 发出去: 26\r\n{"x":10,"y":20,"oper":43}\n\r\n
服务端回的:
cpp
23\r\n{"code":0,"result":30}\n\r\n拆解应答:23 是 JSON 字符串 {"code":0,"result":30}\n 的长度(含 FastWriter 的尾换行),code=0 表示成功,result=30 就是 10+20 的结果。
9.3 错误场景实测
cpp
10 / 0  -> 22\r\n{"code":1,"result":0}\n\r\n    (除零,code=1)
10 % 0  -> 22\r\n{"code":2,"result":0}\n\r\n    (模零,code=2)
10 ^ 5  -> 22\r\n{"code":3,"result":0}\n\r\n    (非法运算符,code=3)
注意错误情况下 result 都是 0------因为 Cal::Execute 里异常分支只设了 SetCode,没动 result(保持构造时的默认 0)。
十、TcpServer.hpp 孙子进程的变化:为什么上篇没有 sock->Close
再看一遍 TcpServer 的双 fork 部分:
cpp
else if (id == 0)       // 子进程
{
    _listensockptr->Close();       // 关掉监听 fd
    if(fork() > 0) exit(OK);       // 子进程秒退
    // 孙子进程
    _service(sock, client);        // 干活
    sock->Close();                 // 干完关通信 fd ← 这节课新增
    exit(OK);
}
上篇
GetRequest是空函数,孙子进程调完立刻 exit,fd 靠内核回收。这节课GetRequest是死循环(客户端不断就不退出),所以sock->Close()写在循环后面,理论上只有客户端断开、循环 break 出来才会执行到。但写上是好习惯------显式关闭比隐式靠 exit 回收更清晰。
十一、上篇 vs 中篇:一张表看清增量
| 维度 | 上篇(lesson55) | 下篇(lesson56) |
|---|---|---|
| Socket 接口 | 只有 socket/bind/listen/accept/close | 新增 Recv/Send/Connect |
| Request::Serialize | 空函数 | Json::Value + FastWriter |
| Request::Deserialize | 空函数 | Json::Reader + parse |
| Response::Serialize | 空函数 | Json::Value + FastWriter |
| Response::Deserialize | 空函数 | Json::Reader + parse |
| 报文分隔 | 没有 | Encode(加长度头)+ Decode(拆报文) |
| GetRequest | 空函数 | 六步流水线:Recv→Decode→Deserialize→func→Serialize→Encode→Send |
| 业务逻辑 | 没有 | Cal 类,五则运算 + 错误码 |
| 客户端 | 空文件 | TcpClient.cc,能连接 |
| Main.cc | 两层(Protocol + TcpServer) | 三层(Cal + Protocol + TcpServer) |
| 编译 | 不需要 -ljsoncpp | 必须 -ljsoncpp |
| 通信测试 | 客户端连上立刻断 | 10+20=30 全链路跑通 |
十二、整理收获
序列化落地 :上篇学的 jsoncpp 工具,这节课真正用在 Request/Response 里了。
char类型的_oper赋给Json::Value会存成整数(ASCII 码),这是实操时容易忽略的细节;报文分隔 = 长度头 + 分隔符 :TCP 字节流没有消息边界,靠
Encode加len\r\n{json}\r\n格式,Decode按"找分隔符→解析长度→检查完整性→提取+删除"四步拆报文。不够就继续读,够了一条就拆出来,多余的留着下轮拆。这就是粘包和半包的标准解法;三层解耦 :Cal(业务)→ Protocol(协议)→ TcpServer(传输),每层通过
std::function回调注入下一层,改一层不动其他层;GetRequest 死循环 :一个连接上可以连续处理多条请求,这才是"长服务"。
buffer_queue在循环外定义,跨多次 Recv 积累数据,是粘包方案能工作的基础;错误码设计 :
Response用code字段区分正常/异常,0=成功、1=除零、2=模零、3=非法运算符。正常时result是计算结果,异常时result保持 0,只有code变。
十三.代码如下: