摘要:需求评审过了,口径也定了,接下来是真正的体力活------摸表、建表、接源表、配调度、提交发布、加工、对账。这一篇不讲怎么谈需求,只讲从需求定稿那一刻起,Codex + DataWorks MCP 是怎么把这条链路走完的;并在每一步给出「自己开发要做什么」的对照,最后落到价值。文中示例已脱敏,密钥只走环境变量。
0. 前提:本文从「需求已定」开始
需求确认这一步必须先做完,而且产出必须落到文档里。明确下面这些,才谈得上开工:
| 已定稿的输入 | 内容 | 谁给 |
|---|---|---|
| 指标与口径 | 一共几个指标、各自怎么算、剔除谁 | 业务 + 数据 |
| 粒度 | 明细到什么层级、榜单聚合到什么层级 | 业务 |
| 时间窗口 | 统计时间字段、半开区间 [start, end) |
数据 |
| 单位 | 金额是分还是元、比率保留几位 | 财务 |
| 比较基准 | 「排名靠后」到底是跟谁比 | 业务 |
| 责任与时限 | 谁验收、什么时候上线 | 双方 |
这份清单就是后面所有工作的输入。 反过来说:如果这些还没定,后面的效率再高也只是更快地做错。
我们这次的例子:业务要一条链路,把 6 个指标(欠费、保证金、销售排名、客诉、私收银、诉讼)算到摊位粒度 ,用于月度招商调整。其中三个指标还在靠人每月手工导表------这就是要补的缺口。
先看清这条路是怎么运转的------它是这一篇所有步骤的底座:
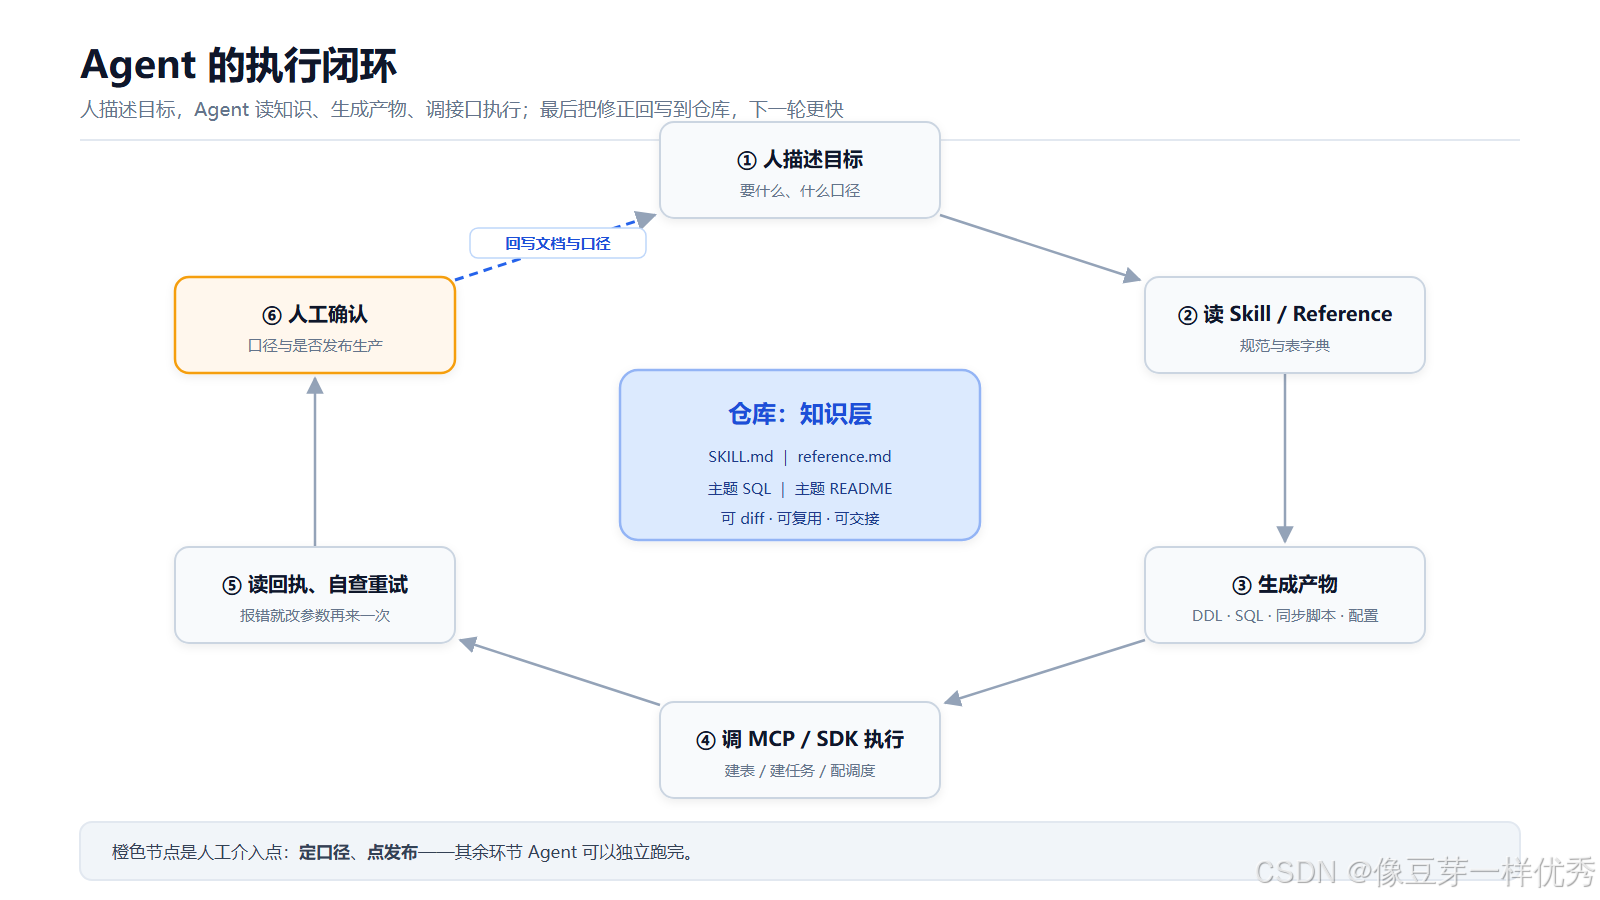
图 1:Agent 的执行闭环。人描述目标,Agent 读知识、生成产物、调接口执行、读回执自查,最后把修正回写到仓库------所以下一轮会更快。
1. 第一件事:把定稿口径翻译成「建设清单」
1.1 定稿口径 → 交付物
| 交付物 | 形态 | 谁用 |
|---|---|---|
| 贴源表 ×3 | 三张源表的日分区全量 | 下游加工 |
| ETL 任务 | 3 个同步任务 + 5 个加工节点 | 调度 |
| 调度依赖 | 上游同步 → 加工 → 榜单 | 调度 |
| 榜单表 ×1 | 摊位粒度、ds 快照 |
业务 |
| 对账项 | 行数 / 金额 / 主键三类 | 验收 |
| 文档 | 主题 README + 口语说明 | 后人 |
1.2 六问六答
清单里出现下面这些,必须确认清楚才能动手:
| 问题 | 为什么要问 |
|---|---|
| 主键是什么? | 决定去重与唯一性约束 |
| 金额单位是分还是元? | 决定要不要 /100,错了差 100 倍 |
| 统计时间用哪个字段? | 支付时间 ≠ 下单时间,差一天就错一期 |
| 测试 / 虚拟 / 统计合并要不要剔? | 不剔就会多算,且业务一眼看出来 |
| 上下游依赖是谁? | 上游没到,跑出来就是「全是 0」的假数据 |
| 窗口是闭区间还是半开? | 期末重复计数,金额差一天的量 |
这六个问题,Agent 答不了,但它能帮你问全。 这是它第一个价值点:把「老手才知道要问什么」变成「每次都会问全」。
2. 七步链路逐段走(每段都带自研对照)
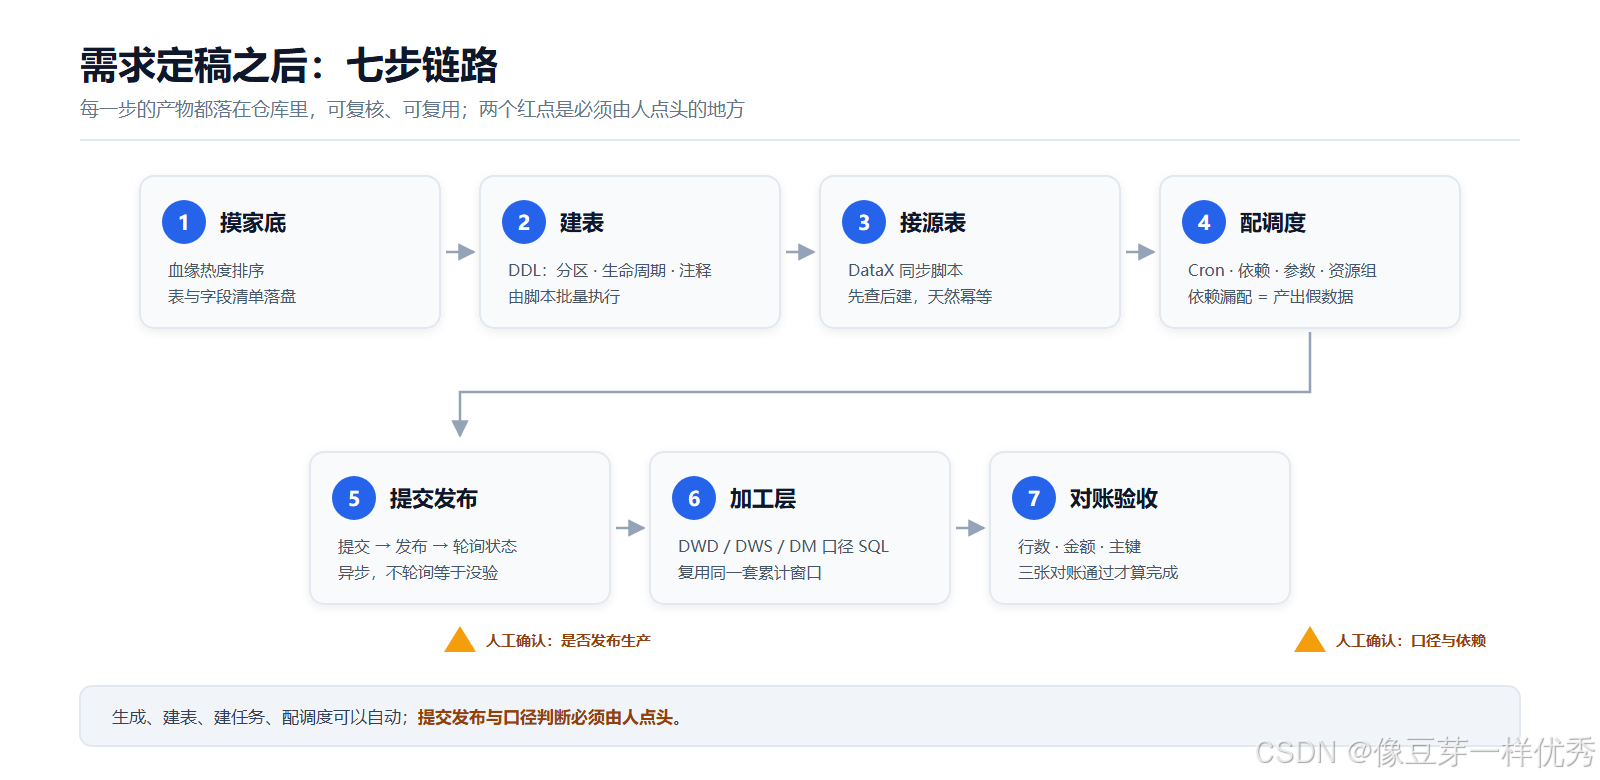
图 2:需求定稿之后的七步链路。每一步的产物都落在仓库里;两个橙点是必须由人点头的地方。
① 摸家底:先知道有什么,再决定建什么
| 自己开发 | Codex + DataWorks MCP | |
|---|---|---|
| 怎么查 | 打开控制台,翻数据地图 / 逐张表点开看字段 | 让 Agent 调只读接口拉项目、数据源、表与字段,或直接读仓库里的 reference.md |
| 能查到什么 | 表名、字段、血缘(要一个个点) | 同上,且一次把结果落盘成文件,可复用、可 diff |
| 血缘 | 在界面上展开,看完就关掉 | 跑一遍脚本,产出 table_usage_rank.csv,可反复看 |
| 遗漏风险 | 靠经验,容易漏看同类表 | 全量扫,不靠记忆 |
我们的做法是先跑一遍血缘热度(工具在 tools/odps_lineage/):
text
hot_score = downstream_count * 2 + upstream_count结论直接改了方案:
| 发现 | 影响 |
|---|---|
| 日期维表被几乎所有任务引用 | 累计窗口直接复用,不自己造日期逻辑 |
| 已有摊位级欠费、保证金汇总表且热度很高 | 不新建同类表,直接 JOIN,避免两套欠费口径 |
| 客诉 / 诉讼没有对应表 | 确认为本次要新建的部分 |
自研和用 Agent 在这一步的差别不是「查得快不快」,而是「有没有查全」。 人查表会带着假设查,Agent 是全量列。
② 建表:DDL 一次写对,两套环境都能用
| 自己开发 | Codex + DataWorks MCP | |
|---|---|---|
| 建表方式 | 控制台建表向导,字段一个个填类型和注释 | Agent 生成 DDL,走 PyODPS 批量执行 |
| 字段数量 | 20 个字段要点 20 遍 | 一次生成 |
| 规范一致性 | 取决于当天状态 | 分区列固定 ds、ALIORC、生命周期按分层给,每次一样 |
sql
CREATE TABLE IF NOT EXISTS ${project}.ods_cs_complaint (
    id               BIGINT   COMMENT '主键',
    booth_id         BIGINT   COMMENT '摊位ID',
    market_id        BIGINT   COMMENT '卖场ID',
    complaint_type   STRING   COMMENT '客诉类型',
    complaint_status STRING   COMMENT '工单状态(口径见README)',
    happen_time      DATETIME COMMENT '发生时间',
    close_time       DATETIME COMMENT '关闭时间',
    create_time      DATETIME COMMENT '创建时间'
)
COMMENT '客诉工单_贴源_日全量'
PARTITIONED BY (ds STRING COMMENT '日期分区,格式yyyyMMdd')
STORED AS ALIORC
LIFECYCLE 732;
贴源层的三条规矩(写进 Skill,Agent 每次都会带):
- 贴源层不加工,不改业务含义
- 分区列固定
ds,格式yyyyMMdd - 生命周期按分层给:贴源层给足,交易明细类可短一些
注释里那句「口径见 README」是有意写的:容易误解的字段,注释要留一个能继续查下去的入口。
③ 接源表:从「点向导」到「生成脚本 + 幂等执行」
这一步是自研与 Agent 差别最直观的地方。
自研怎么做: 新建离线同步任务,选源/目标数据源、选表、逐个字段点映射 、配切分键、配并发、配错误记录数、写目标分区......字段多的时候,一个任务点几十下;column 顺序错了还要重来。
Codex + MCP 怎么做: 把源表 DDL 和目标表 DDL 给 Agent,它生成 DataX 的 TaskContent,再由脚本建任务:
json
{
  "steps": [
    {
      "stepType": "mysql",
      "parameter": {
        "datasource": "src_cs_db",
        "table": ["t_complaint"],
        "column": ["id","booth_id","market_id","complaint_type","complaint_status","happen_time","close_time","create_time"],
        "splitPk": "id"
      }
    },
    {
      "stepType": "odps",
      "parameter": {
        "datasource": "odps_first",
        "table": "ods_cs_complaint",
        "partition": "ds=${bizdate}",
        "truncate": true,
        "column": ["id","booth_id","market_id","complaint_type","complaint_status","happen_time","close_time","create_time"]
      }
    }
  ]
}
js
// 幂等:同名任务存在就复用,避免重复创建
const exist = await client.listFiles(new sdk.ListFilesRequest({
  projectId: PROJECT_ID, exactFileName: TASK_NAME, fileTypes: '23',
}));
let fileId = exist?.body?.data?.files?.[0]?.fileId;
if (!fileId) {
  const resp = await client.createDISyncTask(new sdk.CreateDISyncTaskRequest({
    projectId: PROJECT_ID,
    taskType: 'DI_OFFLINE',
    taskName: TASK_NAME,
    taskContent: JSON.stringify(taskContent),
    taskParam: JSON.stringify({ FileFolderPath: FOLDER, ResourceGroup: DI_RG }),
  }));
  fileId = resp.body.data.fileId;
}| 维度 | 自己开发 | Codex + DataWorks MCP |
|---|---|---|
| 操作形态 | 在界面上点 | 生成配置 + 调接口 |
| 字段映射 | 手点,几十下 | 从 DDL 生成,顺序天然一致 |
| 幂等 | 靠人记得先看有没有 | 脚本先查再建,天然幂等 |
| 记录 | 无(点完就没了) | 配置 JSON 进 Git,可评审可复用 |
注意一个真实边界: 老版单表离线同步任务不在 MCP 工具面里,要走官方 SDK。这恰恰说明用法不是「非 MCP 不可」,而是:
MCP 能覆盖的由 Agent 直接调;覆盖不到的,用 SDK 补位------对使用者来说,都是「描述目标,Agent 执行」。
④ 配调度:业务依赖比参数更容易错
js
await client.updateFile(new sdk.UpdateFileRequest({
  projectId: PROJECT_ID, fileId,
  cronExpress: '00 00 02 * * ?',      // 源库跑批结束后再取数
  cycleType: 'DAY',
  inputList: 'your_project_root',     // 上游依赖
  outputList: 'your_project.ods_cs_complaint',
  paraValue: 'bizdate=$bizdate',      // 与分区里的 ${bizdate} 是两处
  rerunMode: 'ALL_ALLOWED',
  resourceGroupIdentifier: SCHED_RG,  // 资源组标识,不是显示名
  schedulerType: 'NORMAL', stop: false,
}));| 配置项 | 自己开发 | Codex + DataWorks MCP |
|---|---|---|
| Cron | 手敲,容易错位(0 0 2 * * ? vs 0 2 * * ?) |
生成后对照选项核对 |
| 依赖 | 在依赖树上拖 | 写成 inputList / outputList,可 review |
| 调度参数 | 节点属性里填,容易忘 | 与分区参数一起被检查 |
| 资源组 | 下拉选,可能选错同名项 | 用资源组标识,明确 |
这一步最贵的错误不是参数写错,是依赖漏配。
上游数据没到、下游照样跑,跑出来是一个「客诉全是 0」的榜单------数字看着正常,实际上把商户的差评全洗白了。这类错误自研也常犯,区别在于:靠人工检查会漏,靠脚本检查不会。
⑤ 提交 → 发布 → 轮询:把「干等」变成「可追踪」
自研怎么做: 点提交 → 点发布 → 看发布记录等状态;发布是异步的,等的时候干别的,回头可能忘了看到底成没成。
Codex + MCP 怎么做: 三步一次跑完,并轮询到确定结果。
text
SubmitFile → DeployFile → GetDeployment 轮询(status=1 成功 / status=2 失败)| 维度 | 自己开发 | Codex + DataWorks MCP |
|---|---|---|
| 结果确认 | 靠记着回来看 | 轮询到确定状态才结束 |
| 失败处理 | 手工再点一次 | 记录失败项,支持断点重跑 |
| 批量 | N 个任务 = N 遍点击 | 一次循环,失败项单独重试 |
还有一条硬事实:发布完成当天 02:00 之前不会自动生成实例,首个分区必须靠运维中心「补数据」。这件事自研时经常是「上线第二天发现昨天没数」才想起来的。
⑥ 加工层:把定稿口径写成 SQL
骨架由 Agent 出,口径由人定。我们这次最关键的两个加工点:
排名要与自己可比的比。 护肤品摊位和家具摊位比销售额,小品类永远垫底,所以排名按「同卖场 + 同品类」:
sql
,ranked AS (
    SELECT
        booth_id, l2_category_id, sales_net
        ,PERCENT_RANK() OVER (
            PARTITION BY market_id, l2_category_id      -- 同卖场 + 同品类
            ORDER BY sales_net DESC
        ) AS rank_pct
        ,ROW_NUMBER() OVER (PARTITION BY booth_id ORDER BY sales_net DESC) AS cate_rn
    FROM sales_cate
    WHERE sales_net > 0                                  -- 无销售不参与排名
)
-- 分档:前 30% / 中 30% / 后 40%
CASE WHEN rank_pct <= 0.30 THEN 1 WHEN rank_pct <= 0.60 THEN 2 ELSE 3 END AS rank_bucket
综合评分要与排名档位对齐。 榜单说「前 30%」,评分表的销售分就得给满分,两套口径不一致,业务一定会来问:
sql
,CASE WHEN COALESCE(rk.rank_bucket, 3) = 1 THEN 100.0     -- 与排名档位一一对应
      WHEN COALESCE(rk.rank_bucket, 3) = 2 THEN 80.0
ELSE 60.0 END AS score_sales| 自己开发 | Codex + DataWorks MCP | |
|---|---|---|
| 骨架 | 手写 CTE、窗口、JOIN | Agent 按 Skill 规范生成,拆 CTE、显式列、半开区间 |
| 时间窗口 | 每次都重新写,写法各异 | 复用同一个累计窗口 CTE |
| 单位换算 | 靠记 | 写进规范,生成时就带上 |
| 复用 | 复制粘贴,越改越乱 | 读主题 README,按同一套模式新增 |
Agent 负责「不出低级的错」,人负责「不做错的判断」。 这句分工在这篇里最适合体现。
⑦ 对账验收:把「我觉得对」变成「有三张表能证明对」
sql
-- 行数对账
SELECT COUNT(*) FROM ods_cs_complaint WHERE ds = '${bizdate}';
-- 金额对账(同单位)
SELECT SUM(amount) FROM src_table WHERE ... ;   -- 源端
SELECT SUM(amount) FROM ods_table WHERE ds = '${bizdate}';  -- 仓内
-- 主键唯一
SELECT COUNT(*) , COUNT(DISTINCT id) FROM ods_cs_complaint WHERE ds = '${bizdate}';| 对账项 | 不合格的典型表现 | 大概率原因 |
|---|---|---|
| 行数 | 差几百行 | 增量条件或切分键有问题 |
| 金额 | 差整数倍 | 分 / 元换算错了 |
| 主键 | 出现重复 | 切分键选错或源端本身就一对多 |
自研也这么对账,区别是 Agent 会把这三条变成「每次必跑」的动作,而不是「想起来才跑」。
3. 批量:从 1 张到 100 张,边际成本趋近于零
单表跑通之后,输入不再是「再建一张表」,而是一份清单:
| 字段 | 示例 |
|---|---|
task_name |
ods_cs_complaint |
source_datasource / source_table |
src_cs_db / t_complaint |
target_table |
ods_cs_complaint |
columns |
显式列、顺序与 DDL 一致 |
split_pk |
id |
file_folder_path |
与同类任务同目录 |
cron_express / para_value |
00 00 02 * * ? / bizdate=$bizdate |
分五阶段推进,每一阶段都停下来能看、能查、能重跑:
| 阶段 | 动作 | 失败代价 |
|---|---|---|
| A | 批量生成 DDL / 同步脚本 / 计划 | 无(纯离线) |
| B | 批量建目标表 | 低(IF NOT EXISTS) |
| C | 批量建任务 + 配调度 | 中(可改可删) |
| D | 批量提交 + 发布 | 高(人工确认) |
| E | 验证:回读配置 + 补数据 + 抽检 | --- |
这是自研与 Agent 差距最大的地方:
| 表数量 | 自己开发 | Codex + DataWorks MCP |
|---|---|---|
| 1 张 | 约 3~4 小时 | 约 40~60 分钟 |
| 10 张 | 约 30~40 小时(且第 10 张和第 1 张一样累) | 约 1~1.5 人天(含对账) |
| 50 张 | 基本靠排期,人还会疲劳出错 | 清单驱动,并发跑批 |
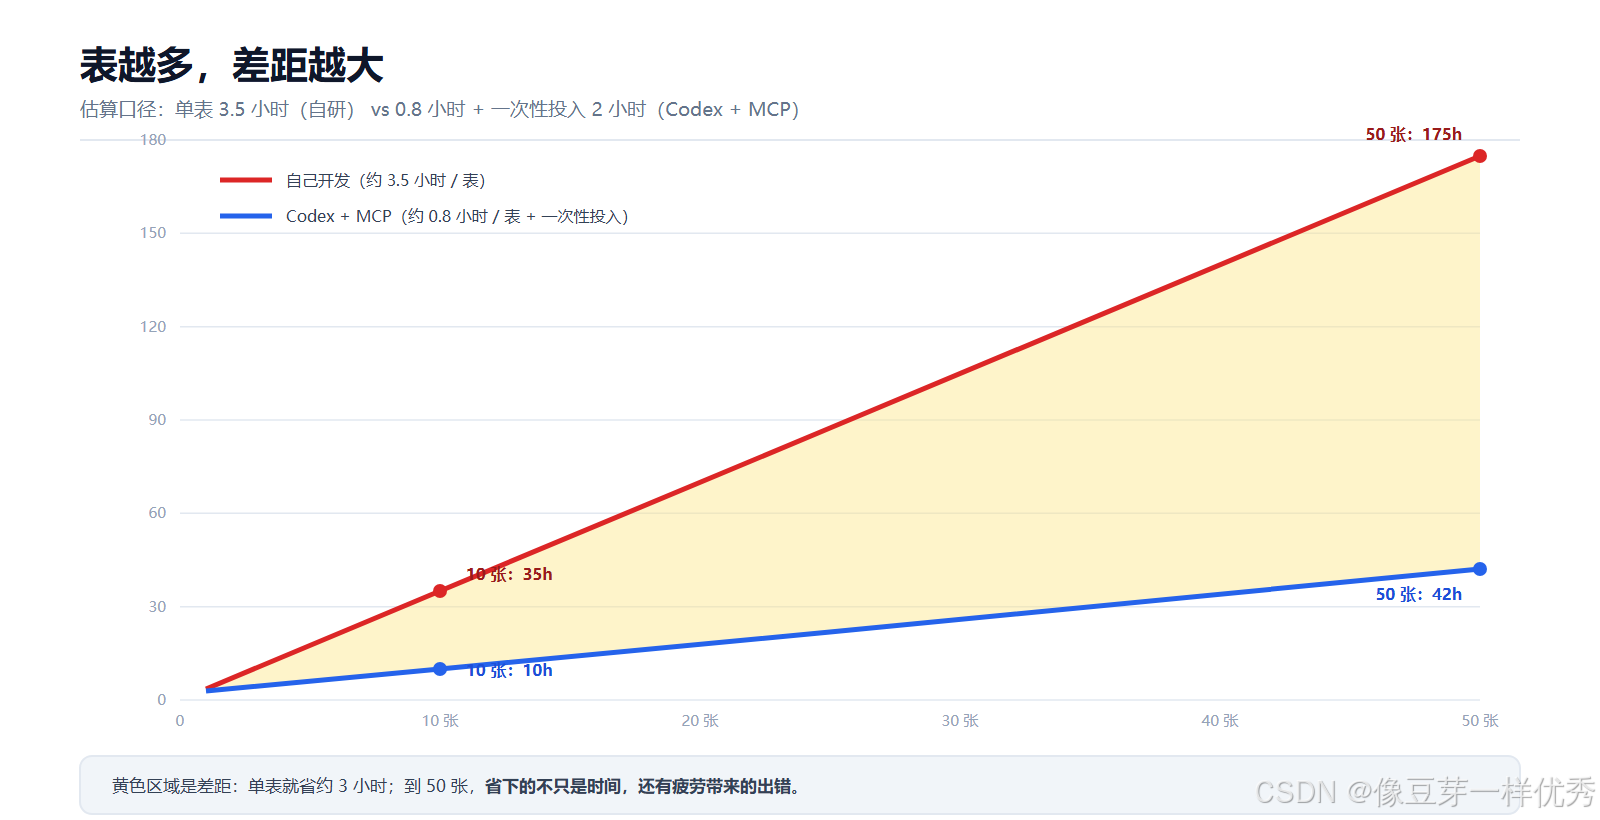
图 3:表越多,差距越大。黄色区域是省下的工时------到 50 张,省下的不只是时间,还有疲劳带来的出错。
注意第三行那句括号:自研的痛不是慢,是「第 50 张的注意力和第 1 张不一样」,而疲劳正是事故的来源。
4. 与自研的差别:四条本质差异
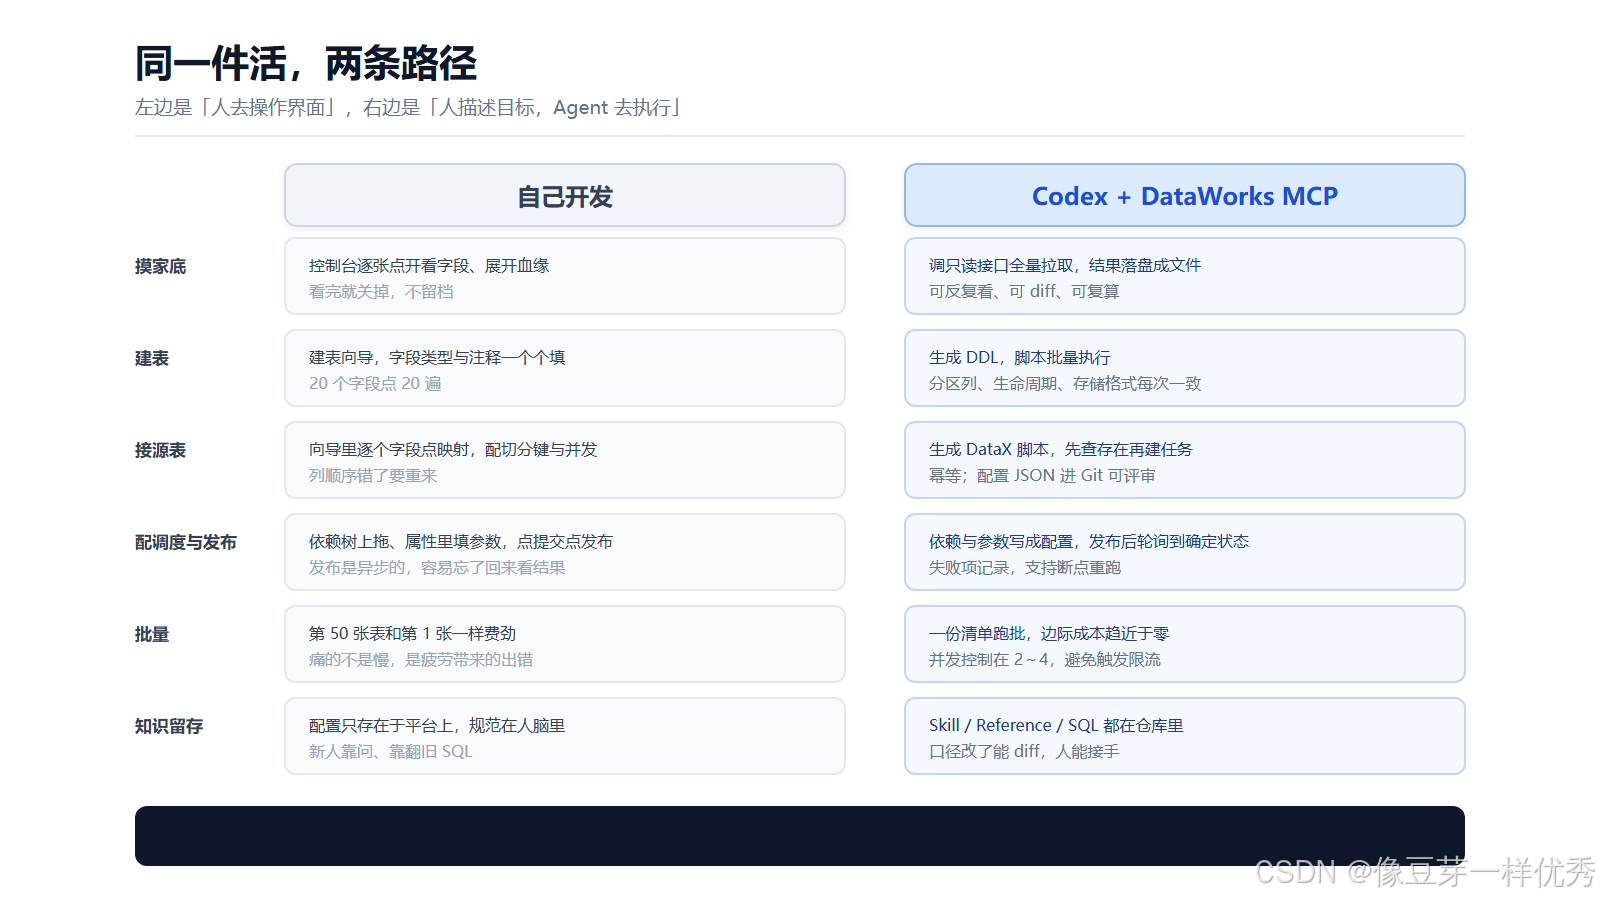
图 4:同一件活的两条路径。左边是「人去操作界面」,右边是「人描述目标,Agent 去执行」。
把上面每一段的对照汇总,差异可以收成四条:
差异一:操作对象不同
| 自己开发 | Codex + DataWorks MCP |
|---|---|
| 操作的是界面:控件、向导、下拉框 | 操作的是接口 + 仓库:脚本、配置、SQL |
| 结果只存在于平台上 | 结果同时在平台上和 Git 里 |
直白的后果: 自研建完任务,配置只存在于平台上,别人想学只能看你操作;Agent 建完任务,配置 JSON 和 SQL 都在仓库里,能 review、能复制、能改。
差异二:知识载体不同
| 自己开发 | Codex + DataWorks MCP |
|---|---|
| 规范在人脑 + 聊天记录里 | 规范在 Skill / Reference 里 |
| 新人靠问、靠看老 SQL 猜 | 新人靠读文档 + 让 Agent 按规范生成 |
| 口径争论完就散了 | 结论回写文档,下一次自动生效 |
差异三:重复成本不同
| 自己开发 | Codex + DataWorks MCP |
|---|---|
| 第 N 张表与第 1 张一样费劲 | 第 N 张表的边际成本趋近于零 |
| 批量任务靠排期和加班 | 批量任务靠清单和脚本 |
差异四:质量来源不同
| 自己开发 | Codex + DataWorks MCP |
|---|---|
| 质量来自个人经验与自觉 | 质量来自规范被执行 + 固定验收动作 |
| 状态好时很稳,状态差时出事 | 每次执行都带上同样的检查 |
一句话总结这四条:自研是「一次性交付」,Codex + MCP 是「交付 + 沉淀」。
什么时候不该用
四条本质差异的另一面,是它的边界。下面这些场景,老老实实自己做:
| 场景 | 为什么 |
|---|---|
| 首次接入与权限铺垫 | 一次性投入:装 MCP、配 AK、开 RAM 权限,绕不过去 |
| 口径与业务判断 | Agent 不该替业务做决定 |
| 破坏性动作(删表、改生产结构) | 必须人工确认,不进自动化 |
| 极小的一次性改动 | 直接在控制台点两下更快,别为了用工具而用工具 |
把 Agent 用在「重复、有规范、可验证」的活上,把人的时间留给「判断、决策、担责」。
5. 价值体现在哪
5.1 交付节奏
| 环节 | 以前 | 现在 |
|---|---|---|
| 三张手工导表 | 每月人工导,导完对格式 | 每日自动入仓,分区可回溯 |
| 榜单产出 | 人工拼表,一个下午 | 调度自动产出,人只核对 |
| 新接一张源表 | 3~4 小时 | 40~60 分钟 |
5.2 质量与一致性
| 常见错误 | 以前 | 现在 |
|---|---|---|
| 分区没滤 / 硬编码日期 | 时有发生 | 规范里写死,Agent 默认带上 |
| 金额单位搞错(分 / 元) | 靠人记 | 单位写进规范,转换显式可见 |
| 上下游依赖漏配 | 靠人记 | 建任务的固定步骤 |
| 发布后不验证 | 靠自觉 | 三张对账成为验收动作 |
| 口径改了没通知 | 靠聊天 | 改文档 + 血缘查影响面 |
5.3 知识资产(这块最容易被低估)
| 资产 | 自研之后 | Codex + MCP 之后 |
|---|---|---|
| 建任务的配置 | 只在平台上 | 配置 JSON 在仓库里 |
| 加工逻辑 | SQL 在平台上,改了没痕迹 | SQL 在 Git,可 diff 可回滚 |
| 规范与口径 | 在人脑 | 在 Skill / Reference |
| 排障路径 | 问人 | 血缘 + 文档 |
| 新人上手 | 口口相传 | 有明确阅读入口 |
5.4 一个可代入的账
| 项目 | 人工方式 | Codex + DataWorks MCP | 省下 |
|---|---|---|---|
| 单张源表:对字段到发布 | 3~4 小时 | 40~60 分钟 | 约 3 小时/表 |
| 4 张表一次性接完 | 2 人天 | 半天(含对账) | 约 1.5 人天 |
| 每月重复导表 | 1~2 小时/月 | 0 | 约 2 人天/年 |
| 一次口径返工 | 半天起步 | 改一处文档 + SQL | 防返工 |
但真正的价值不在省下的工时,而在三件事:
- 错误类型的改变------从「靠人记得」变成「流程兜住」
- 知识的可继承------链路不再跟着人走
- 可复核------每一步都留下痕迹,出问题能查到是哪一步
6. 六个坑
- 以为 MCP 什么都能干 → 老版单表同步不在工具面里,先
listTools查清 - 让 Agent 直接对生产写 → 生成和建表可自动,发布要人工确认
- 只配了分区、忘了调度参数 → 两处都要写
- 发完就走 → 发布是异步的,不轮询等于没验
- 资源组填显示名 → 接口要的是资源组标识
- 依赖漏配 → 上游没到、下游照跑,产出「看着正常」的假数据
7. 结语
把这条链路和自研对照一遍,会发现差别其实只有一句:
自己开发,你在操作工具;用 Codex + MCP,你在描述目标,并且顺手把知识留了下来。
三句话收尾:
- 需求定完之后,第一件事是把口径翻译成建设清单,不是建表。
- Agent 负责不出低级的错,人负责不做错的判断,发布必须由人点头。
- 自研留下的是一个任务,Codex + MCP 留下的是一个任务加一套可复用的资产。
本文涉及的工具接口以阿里云 DataWorks MCP Server 与 DataWorks OpenAPI(2020-05-18)为例;示例中的项目空间、资源组、数据源、表名、指标与权重均已脱敏或替换为占位符。
系列建议:① 从 0 到 1(落地路径)→ ② 体系篇(长期记忆)→ ③ 血缘与高频表 → ④ 本篇(MCP 建仓链路 + 自研对比)→ ⑤ 用 MCP 做数仓治理。
=========================================================
人生得意须尽欢,莫使金樽空对月!
__一个热爱说唱的程序员。
今日份推荐音乐:弹壳Danko《Boss Life》
=========================================================