大模型的上下文窗口再大,也有用完的时候。对 Coding Agent 来说,这个问题更明显:一次任务可能连续读取几十个文件、运行多轮测试、修改代码,再根据结果继续排查。只要任务足够长,前面的消息迟早要退出当前上下文。
常见做法是由客户端监控 token,用到一定比例后调用一次"摘要",再拿摘要替换旧历史。这套方案能工作,但客户端需要决定什么时候压缩、压缩哪些内容、摘要以什么格式组织。更麻烦的是,摘要一旦漏掉某个约束,后面的模型很难知道自己漏了东西。
Codex 的新方案换了一种分工:运行时继续管理 token 预算、持久化和窗口切换;模型自己判断哪些信息值得保留,并把它们写成 checkpoint。旧历史不会硬塞进新窗口,需要细节时再按地址查回原始记录。
本文讨论的是当前源码中按模型配置开启的实验性上下文能力。没有启用这组能力的模型,仍然使用传统 compaction。
这套机制可以概括成三个部分:
notes保存继续工作所需的状态;window_id + item_id指向旧窗口里的原始记录;history根据这些地址或关键词取回细节。
它是一次有索引的任务交接,而不是把整段聊天压缩成一篇摘要。
一次上下文切换如何发生
完整流程如下:
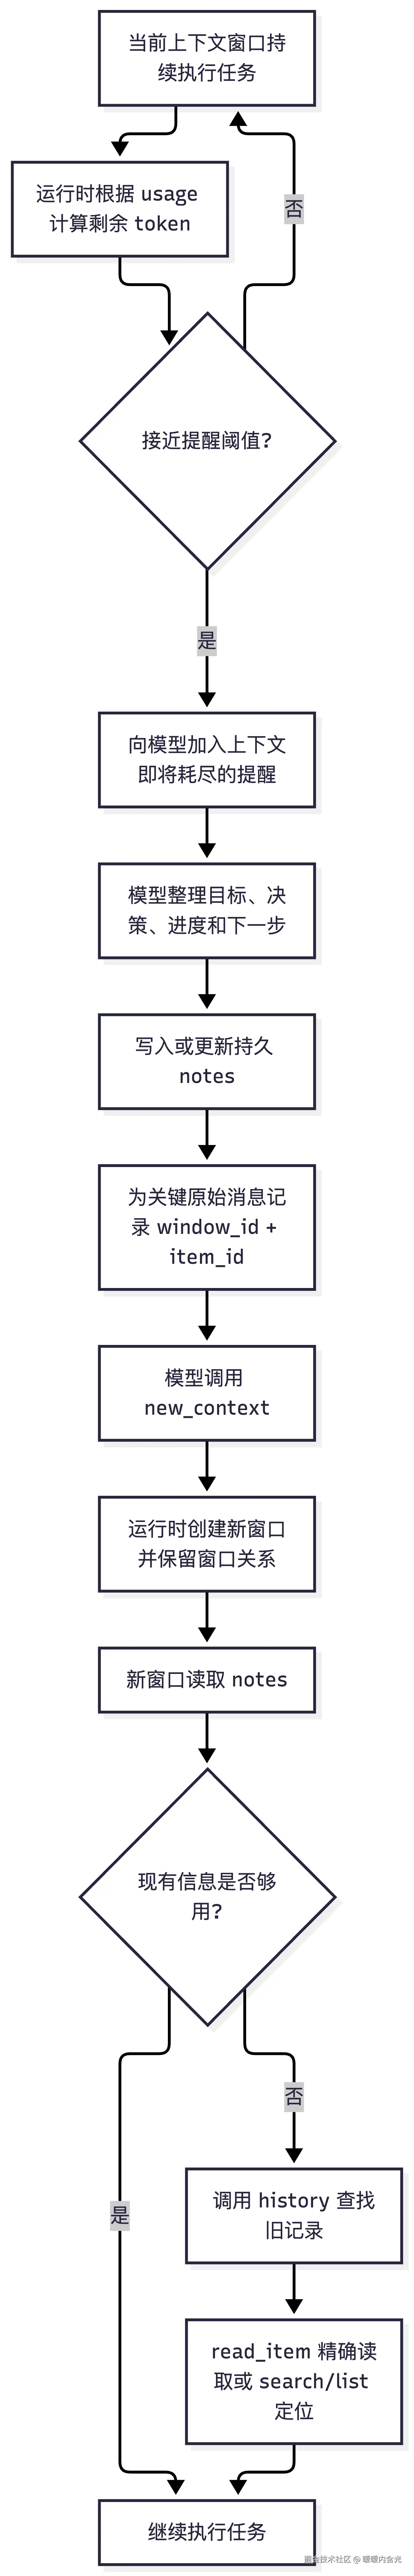
1. 运行时计算剩余预算
每次模型响应都会带回 usage。Codex Core 根据这些实际用量维护当前窗口的 token 消耗,并结合模型配置中的窗口大小,计算还剩多少空间。
这里的运行时只做计数,不替模型判断内容价值。接近阈值后,它会给模型加入一条内部提醒,告诉模型当前窗口即将耗尽,需要先保存状态再切换。
2. 模型写 checkpoint
模型收到提醒后,会把仍然影响后续工作的内容写进持久 notes。典型内容包括:
- 当前任务目标;
- 用户明确提出的约束;
- 已经做出的设计决定及原因;
- 已完成和未完成的工作;
- 排查中确认的关键事实;
- 下一步应该从哪里继续;
- 仍需引用的旧消息地址。
这份 notes 不是完整聊天记录,也不需要复述所有工具输出。它更像工程任务的交接单:新窗口读完后,应该能立刻继续工作。
比如:
markdown
## 当前目标
修复登录请求偶发失败,不能改变现有对外状态码。

## 已确认
- 问题发生在数据库超时后的重试分支。
- 用户明确要求保留原状态码。
- 已定位实现文件,但尚未修改。

## 下一步
1. 调整重试条件。
2. 增加超时后重试成功和最终失败两类测试。
3. 运行登录模块定向测试。

## 原始依据
- 用户最初需求:window_1 / usr_73c2
- 用户关于状态码的纠正:window_1 / usr_d829
- 定位调用链的工具结果:window_1 / tool_c004
最后几行很重要。notes 保存的是压缩后的工作状态,window_id + item_id 保存的是原始证据位置。两者分开后,模型不必为了保留一条可能有用的长日志,把整份日志复制进 checkpoint。
3. 开启新窗口
保存完成后,模型调用 new_context。运行时创建新的上下文窗口,并记录它与前一个窗口的关系。
新窗口不会自动带上旧窗口的完整消息。这是切窗真正节省 token 的地方。它只获得恢复工作所需的入口,例如当前窗口 ID、前一个窗口 ID、notes 的使用提示,以及 history 查询能力。
4. 按需恢复原始信息
新窗口先读取 notes。如果 checkpoint 已经足够,它可以直接继续修改代码。发现细节不足时,再通过 history 回查旧窗口。
已知准确地址时,直接调用:
scss
read_item(window_id, item_id)不知道 item ID 时,可以先使用:
scss
list_items(window_id, role, ...)
search_contents(window_id, query, role, ...)
例如,notes 只写了"用户要求不要改变状态码",模型需要确认原话,就能根据记录的用户消息 ID 精确读取,而不是把整个旧窗口重新装进上下文。
item ID 是怎么用的
Codex 会为会话记录保存结构化 item ID。启用这套上下文机制后,用户消息、developer 消息、工具结果等非 assistant 内容,会在模型可见正文后显示一个短 ID:
bash
不要改变对外状态码,只修复重试逻辑。
[id: usr_d829]
模型在旧窗口里就能看见这个地址,并在写 notes 时把它和窗口 ID 一起保存。新窗口用二者可以精确读取原始记录。
assistant 消息也有结构化 ID,只是不在正文后显示这类尾标记。需要找回某段 assistant 输出时,新窗口可以用 search_contents,并将 role 限定为 assistant;拿到匹配结果的 ID 后,再调用 read_item。
所以,尾部没有显示 [id: ...] 不代表记录不存在。区别只在于:非 assistant item 方便模型当场抄下地址;assistant item 通常需要通过搜索重新定位。
模型负责什么,客户端还负责什么
这套方案把上下文管理很大的自由度交给了模型,但客户端 harness 仍然做了很多保障工作。
模型负责语义判断:
- 哪些约束仍然有效;
- 哪些进度值得带到下一个窗口;
- 哪些原始记录以后可能需要复查;
- checkpoint 应该如何组织;
- 什么时候已经准备好切换窗口。
客户端和服务端负责工程保障:
- 统计 token 用量和剩余预算;
- 在合适的阈值提醒模型;
- 提供 notes、history 和 new_context 工具;
- 持久化旧窗口、checkpoint 和窗口关系;
- 创建新窗口并安装新的工作上下文;
- 模型没有及时交接时执行强制兜底。
模型忘记保存怎么办
自动管理不能只依赖模型自觉。模型可能连续调用工具,也可能在剩余 token 很少时仍试图继续回答。
因此 Codex 还保留了硬兜底。当窗口达到强制阈值后,运行时会要求模型停止当前任务,只允许它完成一次 notes 写入,然后调用 new_context。
仍然存在的边界
这套机制没有消除信息丢失,只是让丢失后更容易恢复。
模型仍可能误判某条信息的重要性,没有把它写进 notes。虽然可以通过 history 搜索补找,但前提是新窗口意识到自己缺了信息。如果它把不完整的 checkpoint 当成全部事实,还是可能走偏。
history 查询也有成本。关键词不准确、旧窗口很多,或者需要反复读取长工具结果时,恢复过程会增加模型调用和 token 消耗。因此 checkpoint 不能过度精简。它至少要留下足够的名词、文件、决定和地址,让后续检索有明确入口。
另外,旧窗口的持久化记录仍然是基础设施的一部分。notes 只是索引和工作状态;如果底层历史已经过期、不可访问,item ID 本身没有意义。
总结
整个过程可以压缩成一句话:
notes 保存可继续工作的状态,
window_id + item_id保存原始证据地址,history 负责按需取回;模型决定保留什么,运行时保证这套交接能够完成。
它比一次性摘要多了一层索引,也多了一条恢复路径。对短对话来说,这套机制没有明显价值;对会连续运行几十轮、跨越多个上下文窗口的 Coding Agent 来说,它把"上下文压缩"从一次不可逆的文本改写,变成了带 checkpoint 和原始记录索引的任务续接。