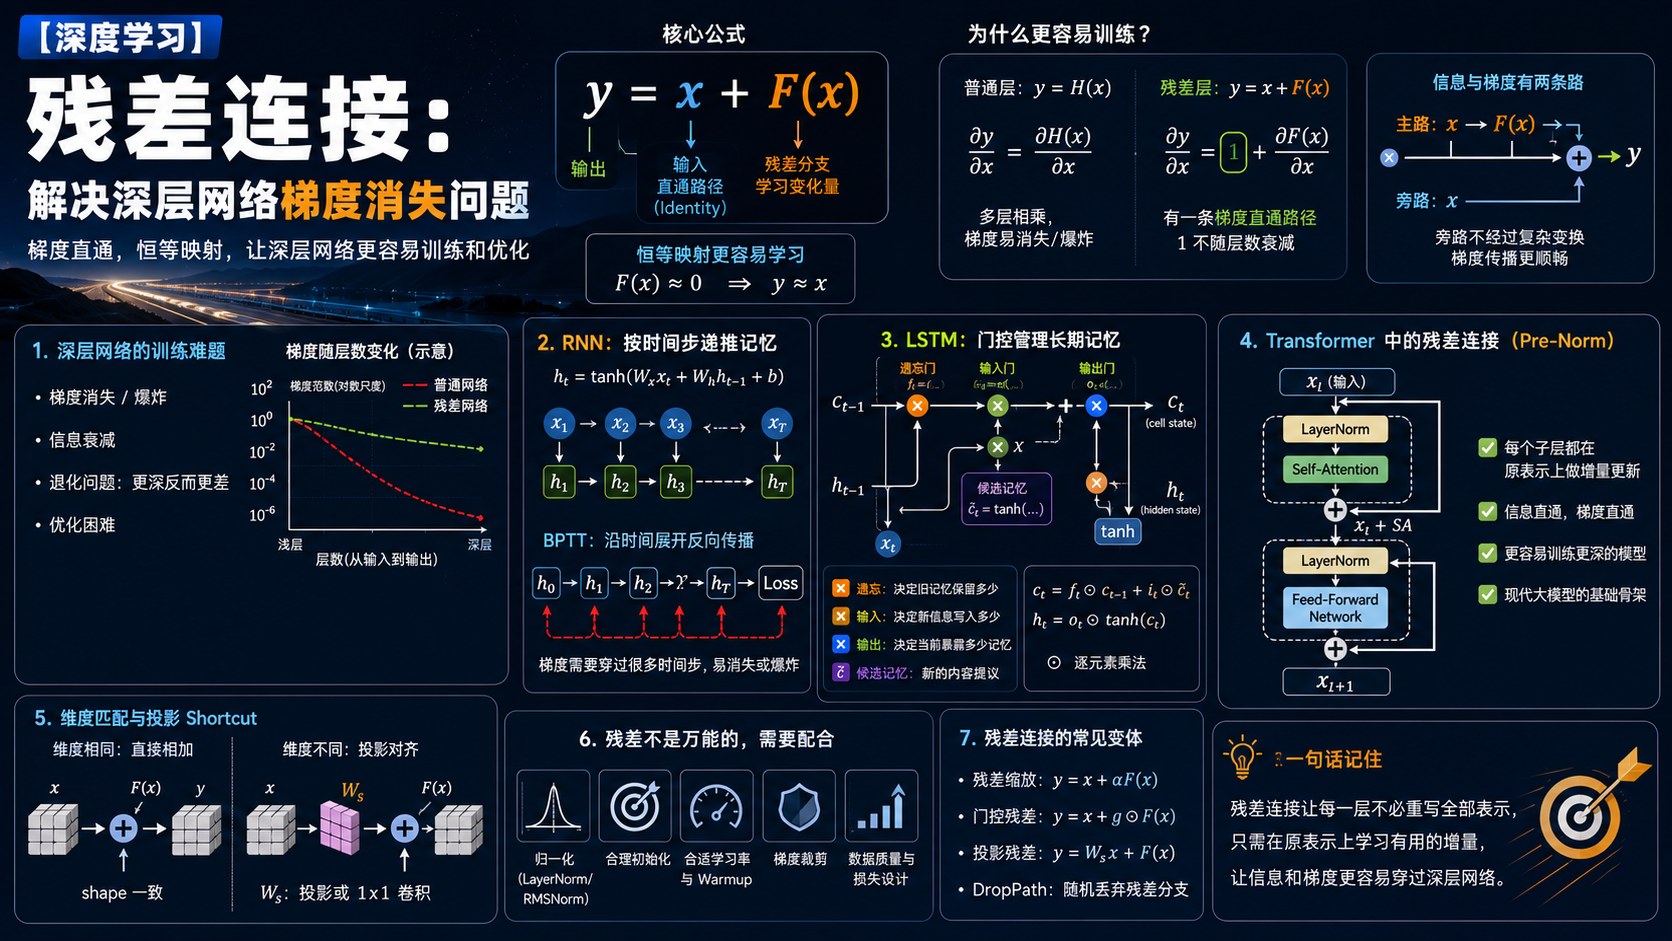
文章目录
-
- 一、深层网络为什么难训练
- 二、残差连接的核心公式
- 三、梯度直通:残差真正关键的地方
- 四、用一个小实验观察梯度
- 五、残差和维度匹配
- [六、残差连接和 LayerNorm 的关系](#六、残差连接和 LayerNorm 的关系)
- [七、Transformer 里的残差连接](#七、Transformer 里的残差连接)
- 八、残差连接不是简单保留原输入
- 九、残差连接的常见变体
- 十、残差不是万能的
- 十一、工程中怎么检查残差相关问题
- 十二、常见误区
- 十三、你应该记住的最小心智模型
- 总结
- 大模型视角
- 下一篇
摘要 :神经网络不是简单地越深越好。层数变深后,信息和梯度要经过很长路径,训练可能变慢、变差,甚至出现"更深模型反而不如浅层模型"的退化现象。残差连接用一个非常朴素的结构缓解这个问题:让输入可以绕过复杂变换,直接加到输出上,也就是
y = x + F(x)。本文从深层网络为什么难训练讲起,解释残差连接的公式、梯度直通、恒等映射、维度匹配、Pre-Norm Transformer 中的残差路径,并用 PyTorch 小实验帮助你理解为什么残差是现代大模型能堆到几十层、上百层的重要基础。
前置知识 :反向传播,最优化,激活函数,归一化
阅读时间 :约 60 分钟
代码环境:Python 3.10+,torch >= 2.0
入门导读:先抓住主线
如果你第一次接触残差连接,不要先把它想复杂。它的核心就是这行式子:
y = x + F ( x ) y = x + F(x) y=x+F(x)
其中:
x是输入;F(x)是某个神经网络模块学到的变化量;y是输出;x这条直通路径让原始信息可以绕过复杂变换。
普通网络让一层直接学习目标映射:
text
x -> H(x)残差网络让模块学习"在 x 基础上改多少":
text
x -> x + F(x)如果某一层暂时学不到有用变化,把 F(x) 学成接近 0,整层就近似恒等映射:
text
y ≈ x这让深层网络更容易优化。
读完先达到这个程度就够了:
- 能解释深层网络为什么会有梯度消失和退化问题;
- 能看懂残差公式
y = x + F(x); - 能从求导角度理解残差为什么有梯度直通路径;
- 能写出一个 PyTorch 残差块;
- 能理解 Transformer Block 里的残差连接在哪里;
- 能知道残差不是万能药,还要配合归一化、初始化和学习率。
带着这 3 个问题读:
- 为什么深度增加后,模型不一定更容易训练?
x + F(x)为什么比直接学习H(x)更容易?- Transformer 为什么几乎每个子层外面都要包残差?
一、深层网络为什么难训练
从表达能力看,网络越深,理论上能表示越复杂的函数。但训练时不是"层数越多越好"。
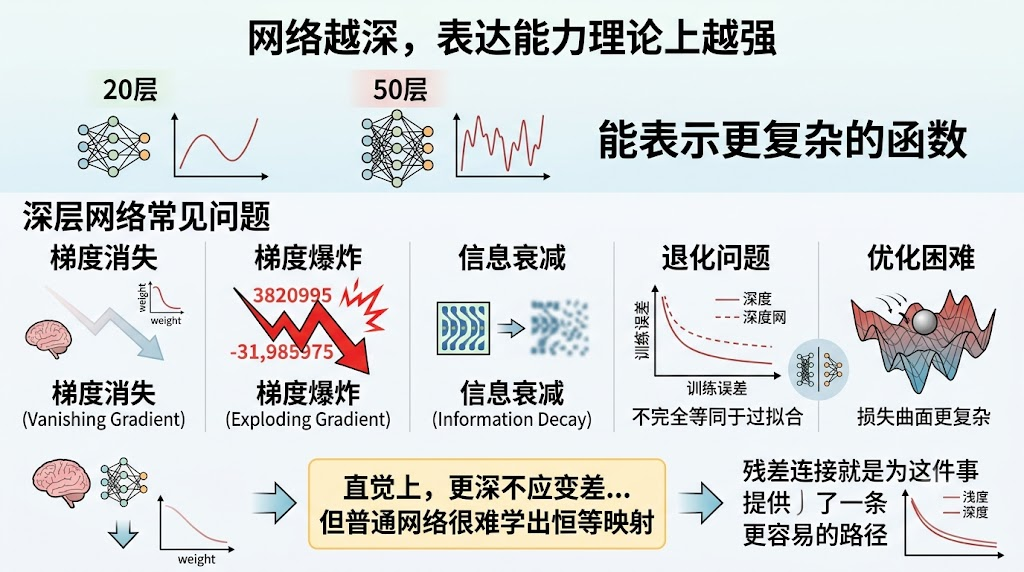
深层网络常见问题包括:
- 梯度消失:反向传播到浅层时梯度非常小,参数几乎不更新;
- 梯度爆炸:梯度非常大,训练不稳定;
- 信息衰减:输入经过很多层变换后,原始信息被破坏;
- 退化问题:更深模型训练误差反而更高;
- 优化困难:损失曲面更复杂,对初始化和学习率更敏感。
注意,退化问题不完全等同于过拟合。过拟合通常表现为训练集很好、验证集变差;退化问题可能是训练集本身都变差。
直觉上,如果一个 20 层网络能达到某个效果,那么 50 层网络至少可以让后 30 层什么都不做,应该不比 20 层差。但普通网络很难自动学出"什么都不做"的恒等映射。
残差连接就是为这件事提供了一条更容易的路径。
二、残差连接的核心公式
残差连接写成:
y = x + F ( x ) y = x + F(x) y=x+F(x)
如果目标映射是 H ( x ) H(x) H(x),那么残差模块学习的是:
F ( x ) = H ( x ) − x F(x) = H(x) - x F(x)=H(x)−x
也就是说,模型不直接学习完整目标 H ( x ) H(x) H(x),而是学习目标相对输入的变化量。
这有什么好处?
如果最优映射接近恒等映射,普通网络要学:
H ( x ) ≈ x H(x) \approx x H(x)≈x
残差网络只要学:
F ( x ) ≈ 0 F(x) \approx 0 F(x)≈0
很多时候,让一个模块输出接近 0,比让它精确复制输入更容易。
用代码看一个最小残差块:
python
import torch
import torch.nn as nn

class ResidualBlock(nn.Module):
    def __init__(self, dim):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(dim, dim),
            nn.ReLU(),
            nn.Linear(dim, dim),
        )

    def forward(self, x):
        return x + self.net(x)

x = torch.randn(4, 16)
block = ResidualBlock(dim=16)
y = block(x)
print(y.shape)
输入和输出形状一样,才能直接相加。这点后面会很重要。
三、梯度直通:残差真正关键的地方
残差连接最重要的作用之一,是给梯度提供直通路径。
对公式求导:
y = x + F ( x ) y = x + F(x) y=x+F(x)
∂ y ∂ x = 1 + ∂ F ( x ) ∂ x \frac{\partial y}{\partial x} = 1 + \frac{\partial F(x)}{\partial x} ∂x∂y=1+∂x∂F(x)
普通层只有:
∂ H ( x ) ∂ x \frac{\partial H(x)}{\partial x} ∂x∂H(x)
如果很多层的导数都小于 1,连续相乘后梯度容易快速变小。残差连接里多了一项 1,这是关键:identity 路径的梯度系数恒为 1,不随层数增加而衰减或放大 。也就是说,无论堆多少层残差块, x x x 到 loss 至少存在一条"梯度系数始终是 1"的直通路径;即便残差分支的梯度趋近 0( ∂ F / ∂ x ≈ 0 \partial F/\partial x \approx 0 ∂F/∂x≈0),总梯度 ∂ y / ∂ x \partial y/\partial x ∂y/∂x 仍约为 1,不会像普通深层网络那样随层数连乘而衰减。这才是残差在深层网络里能缓解梯度消失的根本原因。
更直观地说,残差连接让信息有两条路:
text
主路:x -> F(x) -> + -> y
旁路:x ---------> + -> y
旁路不经过复杂非线性变换,梯度传播更顺畅。
这不是说残差完全消除了梯度问题,而是它显著降低了深层网络训练难度。
四、用一个小实验观察梯度
下面做一个教学实验:比较普通深层 MLP 和带残差的 MLP 在反向传播后,第一层梯度大小的差异。
这不是严格论文实验,只是帮助你形成直觉。
python
import torch
import torch.nn as nn

class PlainMLP(nn.Module):
    def __init__(self, dim, depth):
        super().__init__()
        layers = []
        for _ in range(depth):
            layers.append(nn.Linear(dim, dim))
            layers.append(nn.Tanh())
        self.net = nn.Sequential(*layers)

    def forward(self, x):
        return self.net(x)

class ResidualMLP(nn.Module):
    def __init__(self, dim, depth):
        super().__init__()
        self.layers = nn.ModuleList([
            nn.Sequential(nn.Linear(dim, dim), nn.Tanh(), nn.Linear(dim, dim))
            for _ in range(depth)
        ])

    def forward(self, x):
        for layer in self.layers:
            x = x + 0.1 * layer(x)
        return x


def first_layer_grad_norm(model):
    for p in model.parameters():
        if p.grad is not None:
            return p.grad.norm().item()
    return 0.0

x = torch.randn(32, 64)
target = torch.randn(32, 64)

for Model in [PlainMLP, ResidualMLP]:
    model = Model(dim=64, depth=20)
    out = model(x)
    loss = ((out - target) ** 2).mean()
    loss.backward()
    print(Model.__name__, first_layer_grad_norm(model))
不同随机种子下数值会变化,但你通常能观察到:残差结构更容易让浅层拿到有效梯度。
代码里的 0.1 * layer(x) 是残差缩放,目的是避免一开始每层改动过大。很多大模型训练里也会出现类似的残差缩放或初始化策略。
五、残差和维度匹配
残差相加要求两个张量形状一致。
text
x.shape == F(x).shape如果维度不同,就不能直接相加。
例如:
python
x = torch.randn(4, 16)
f = torch.randn(4, 32)
# x + f 会报错
解决方法通常有两种。
第一,让模块输入输出维度一致。这在 Transformer 里最常见:attention 子层和 FFN 子层最终都会输出 d_model 维。
第二,用投影把 shortcut 调整到目标维度。ResNet 里经常使用 1x1 卷积,MLP 里可以用线性层。
python
class ProjectedResidualBlock(nn.Module):
    def __init__(self, in_dim, out_dim):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(in_dim, out_dim),
            nn.ReLU(),
            nn.Linear(out_dim, out_dim),
        )
        self.shortcut = nn.Linear(in_dim, out_dim)

    def forward(self, x):
        return self.shortcut(x) + self.net(x)
但投影 shortcut 不是完全免费的。它增加参数和计算,也改变了 identity path 的纯粹性。能保持维度一致时,直接相加通常更简单。
六、残差连接和 LayerNorm 的关系
残差解决信息和梯度路径问题,LayerNorm 解决数值分布稳定问题。现代 Transformer 往往把两者一起使用。
常见结构有两种。
Post-Norm
原始 Transformer 更接近:
python
x = norm(x + attention(x))
x = norm(x + ffn(x))
Pre-Norm
现代大模型常用:
python
x = x + attention(norm(x))
x = x + ffn(norm(x))
Pre-Norm 的好处是梯度更容易沿着残差路径传播,深层模型训练更稳定。
一个极简 Pre-Norm block:
python
class PreNormBlock(nn.Module):
    def __init__(self, dim):
        super().__init__()
        self.norm = nn.LayerNorm(dim)
        self.net = nn.Sequential(
            nn.Linear(dim, 4 * dim),
            nn.GELU(),
            nn.Linear(4 * dim, dim),
        )

    def forward(self, x):
        return x + self.net(self.norm(x))
可以看到,残差路径里的 x 没有经过 norm 和 net,它直接传到输出。这条路径对训练很重要。
七、Transformer 里的残差连接
Decoder-Only Transformer Block 可以简化成:
python
x = x + self_attention(norm1(x))
x = x + feed_forward(norm2(x))
第一条残差包住 self-attention,第二条残差包住 FFN。
为什么每个子层都要包残差?
因为每个子层都只是对表示做一次增量更新。
Self-attention 做的是:
text
在当前 token 表示基础上,加入从上下文读取的信息FFN 做的是:
text
在当前 token 表示基础上,加入非线性加工后的特征如果没有残差,每一层都必须完整重写表示,深层训练会困难得多。有了残差,每层只需要学习"这一层要补充什么"。
这非常符合大模型的层级加工方式:底层、中层、高层不断在已有表示上叠加信息。
八、残差连接不是简单保留原输入
有些初学者会误以为残差连接就是"把输入复制到后面",模型就不学习了。实际不是。
输出是:
text
y = x + F(x)如果 F(x) 学到有用变化,输出就会明显不同于输入。如果某层暂时不需要改变太多,F(x) 可以接近 0,让信息通过。
这给模型提供了灵活性:
- 需要修改时,学变化;
- 不需要修改时,近似跳过;
- 训练初期,避免信息被随机层破坏;
- 训练后期,多层逐步叠加复杂变换。
所以残差不是偷懒,而是让深层网络更容易学到合适的增量。
九、残差连接的常见变体
不同模型里,残差连接会有一些变体。
残差缩放
python
y = x + alpha * F(x)alpha 可以是固定小数,也可以随层数设置。它能避免深层网络一开始残差分支输出过大。
门控残差
python
y = x + gate * F(x)gate 控制残差分支贡献大小。某些架构会使用门控机制动态调节信息流。
投影残差
python
y = W_s x + F(x)当输入输出维度不一致时,用投影调整 shortcut。
DropPath / Stochastic Depth
训练时随机丢弃某些残差分支,让深层网络更鲁棒。这在视觉模型和一些大模型训练中也会出现。
这些变体都围绕同一个核心:保留一条稳定的信息通道,同时允许模块学习增量变化。
十、残差不是万能的
残差连接很重要,但它不能单独解决所有训练问题。
深层模型还需要:
- 合理初始化;
- 合适学习率和 warmup;
- LayerNorm/RMSNorm;
- 梯度裁剪;
- 混合精度稳定策略;
- 合理 batch size;
- 数据质量和损失函数设计;
- 分布式训练稳定性。
如果学习率过大,残差网络也会发散。
如果归一化位置不合理,深层 Transformer 也可能不稳定。
如果残差分支输出尺度过大,很多层叠加后数值也会失控。
所以残差是深层网络的基础设施之一,不是单独的万能药。
十一、工程中怎么检查残差相关问题
如果你在实现模型时遇到训练不稳定,可以检查这些点:
- 残差相加的两个张量 shape 是否完全一致;
- attention 和 FFN 输出是否回到
d_model; - mask 或 padding 是否导致输出出现 NaN;
- LayerNorm/RMSNorm 是 Pre-Norm 还是 Post-Norm;
- 残差分支初始化是否过大;
- 混合精度下是否出现 inf/nan;
- 学习率 warmup 是否足够;
- 梯度范数是否异常。
一个简单的 NaN 检查:
python
with torch.no_grad():
    y = block(x)
    print(torch.isnan(y).any().item(), torch.isinf(y).any().item())
如果残差相加前某个分支已经 NaN,残差会把 NaN 继续传播下去。不要只看最终 loss,要逐层定位。
十二、常见误区
误区 1:残差连接只为了解决梯度消失。
梯度直通很重要,但残差还改善信息保留、恒等映射学习和深层优化难度。
误区 2:有了残差,网络就可以无限加深。
不行。深度还受归一化、初始化、学习率、数据、显存和计算成本限制。
误区 3:残差就是把输入复制一份,模型没学东西。
残差让模型学习增量 F(x)。如果增量有用,输出会改变;如果没必要,模型可以近似跳过。
误区 4:残差相加不需要考虑维度。
必须 shape 一致,或者用投影 shortcut。
误区 5:Pre-Norm 和 Post-Norm 差别不大。
对浅层模型可能差别不明显,但深层 Transformer 中归一化位置会显著影响训练稳定性。
十三、你应该记住的最小心智模型
残差连接可以这样记:
text
普通层:直接学 H(x)
残差层:学 H(x) - x,再加回 x
核心公式:
y = x + F ( x ) y = x + F(x) y=x+F(x)
核心好处:
text
信息可以直通
梯度可以直通
层可以学习增量
恒等映射更容易
深层网络更稳定
在 Transformer 里,它通常长这样:
python
x = x + attention(norm(x))
x = x + ffn(norm(x))
看到这两行,你就看到了现代大模型深层堆叠的关键骨架。
总结
残差连接用 y = x + F(x) 这样简单的结构,解决了深层网络训练中的一类核心问题:信息和梯度不必完全穿过复杂变换,可以沿着 shortcut 直接传播。它让网络更容易学习恒等映射和增量变化,从而缓解梯度消失、退化和深层优化困难。
在 Transformer 中,残差连接包裹 self-attention 和 FFN 子层,是 GPT、BERT、LLaMA、Qwen 等模型能够稳定堆叠很多层的重要原因。它通常需要和 LayerNorm/RMSNorm、合理初始化、学习率 warmup、梯度裁剪等技术配合使用。
第一遍记住一句话:残差连接让每一层不必重写全部表示,只需在原表示上学习有用的增量。
大模型视角
后面你看 Transformer Block 时,会反复看到残差路径。Attention 负责从上下文拿信息,FFN 负责加工信息,而残差负责让这些加工以"增量更新"的方式叠加。没有残差,现代深层大模型很难稳定训练。
下一篇
Dropout、权重衰减、学习率调度实战 ------ 残差解决深层结构的训练路径问题,下一篇进入训练配置:如何用正则化和学习率策略让模型更稳地收敛。