本篇介绍context 上下文工程的相关概念
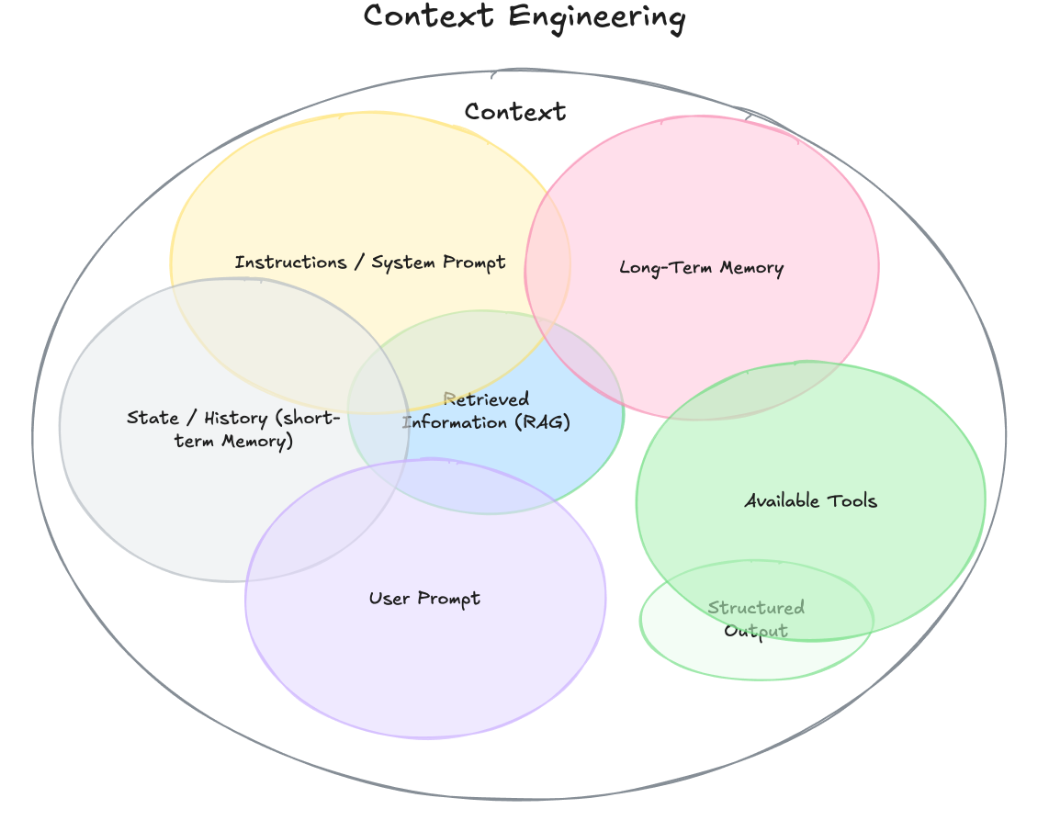
1. 什么是上下文工程
过长的上下文,会带来幻觉、token爆炸、超出上下文窗口限制、不稳定、效果差、性能差等问题。这些问题,通过传统的提示词工程已经无法解决了。因为上下文不仅仅包括提示词。
于是,针对整个上下文做优化的上下文工程就应运而生了。提示词工程是关注和大模型说什么,上下文工程是关注让大模型看到什么。
上下文工程其实也是在不断地优化上下文,让智能体(LLM)只看到恰到好处的上下文信息
2. 上下文包含哪些信息
Context 指的是模型在生成当前回复时所能"看到"的全部信息,通常包括:
- 用户当前的 Prompt(System Prompt+User Prompt);
- 之前的对话历史(包括模型输出,工具执行结果);
- 工具清单(MCP&Function Calling)
- ReAct Agent的Thought/Action/Observation等内容
- 外部知识注入(如 RAG 检索结果)。
Context 是由多个 Tokens 组成的完整输入序列,是模型理解当前任务的依据。受模型最大上下文长度(max context length)限制。
通常会把上下文归个类,分为指令(Instructions)、知识(Knowledge)和工具(Tools)和状态(State)。
- 指令:提示词(用户+系统)
- 知识:记忆(长期+短期)、外部知识
- 工具:工具定义描述、工具调用结果
3. 上下文太长会带来什么问题
Lost in the Middle: 当前的语言模型在长上下文中对信息的位置非常敏感,往往更关注开头和结尾的内容,而忽略中间部分的信息
3.1 Context Poisoning(上下文中毒)
上下文中毒是指,当一个"幻觉"被当作真实内容放进上下文中,后续的回答就会基于这个错误前提继续推理,导致错误放大。
举个🌰:
你问模型:"爱因斯坦发明了电话,对吗?"
模型本来知道这是错的(电话是贝尔发明的),但如果你在上下文里写了一段话:
"众所周知,爱因斯坦不仅提出了相对论,还在1876年发明了电话。"
然后你再问:"谁发明了电话?"
模型可能会回答:"爱因斯坦。"------因为它把上下文里的错误当成了事实。
所以,错误信息一旦进入上下文,模型会"信以为真",就像喝了毒水还觉得是果汁。
Context Distraction(上下文分散)
上下文分散是指,上下文信息太多、太杂,反而让模型忽略了真正重要的指令或问题,导致答非所问。
研究显示,当上下文达到32ktoken后,性能开始下降,超过100k tokens后,这种现象开始显著出现。Agent不再推理当前情况,而是寻找类似的历史模式并重复它们。(Gemini 2.5 技术报告)
你想让模型总结一篇短文,但你在提示词里塞进了大量无关内容:
"请总结以下文章:正文......(500字)。顺便,我昨天吃了披萨,我家猫叫咪咪,最近股市涨了,NASA刚发射火箭,还有记得用中文回答哦!"
结果模型可能开始聊"NASA的火箭"或者"你的猫",而不是总结文章。
信息过载会让模型"分心",就像考试时旁边同学一直在讲八卦,你没法集中注意力。
Context Confusion(上下文混乱)
上下文混乱是指,当上下文中包含大量无关、冗余或非必要的信息(尤其是过多可用工具或选项)时,模型被迫处理所有内容,导致注意力分散、决策偏差,甚至错误调用不相关功能,从而显著降低响应质量与任务成功率。
尤其是在很多agent中,提供了很多工具场景(如 MCP 工具集)中,即使大多数工具与当前任务无关,它们的存在仍会干扰模型对正确工具的选择。
就像让一个厨师在 100 把刀中选一把切菜------即使他知道哪把最合适,但面对一堆锯子、水果刀、手术刀、砍骨刀......他可能会犹豫、选错,甚至用错工具。
而如果只给他 3 把常用刀,效率和准确率立刻提高。
研究表明:将可用工具从 46 个减少到 19 个,任务成功率显著提升。
Context Clash(上下文冲突)
上下文冲突是指,在同一个对话或任务上下文中,同时存在相互矛盾或不一致的信息(如早期错误假设、过时状态、冲突的工具说明等),导致模型无法正确推理,最终生成混乱、自相矛盾或错误的输出。
就像你在导航时,一开始误判了方向,系统记录下"正在向东行驶"。即使你后来掉头向西,导航仍基于"你还在向东"的错误前提规划路线,越走越偏------因为它把自己的错误当成了事实。
4. 上下文工程如何优化
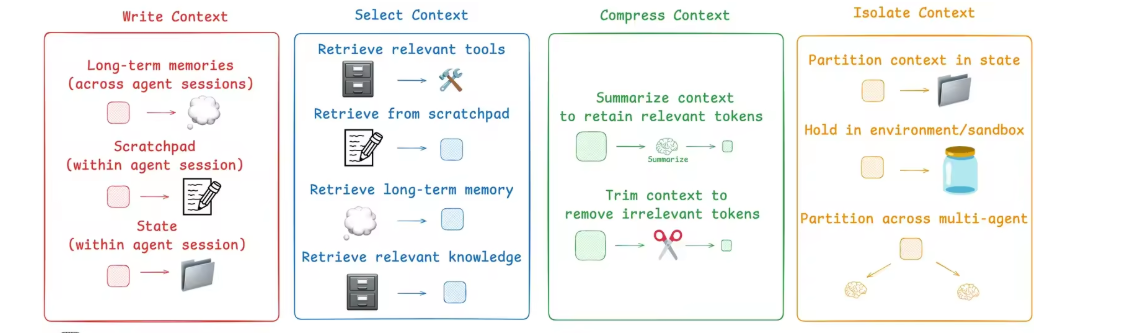
LangChain在2025年7月发布了一篇文章《Context Engineering for Agents》,从Agent开发的角度来看,为了让Agent的上下文恰到好处,文章将上下文工程方法归纳为四个过程:Write(写入)、Select(选择)、Compress(压缩)、Isolate(隔离)
写入
目的:把重要信息保存到上下文窗口之外,供后续使用。实现上下文写入的方案通常有两种,一种叫Scratchpad(草稿板/短期记忆),另外一种是Long Term Memory(长期记忆)。
Scratchpad
所谓草稿版,就是他不是最终输出,而是工作过程中的临时笔记,比如我们的实现短期记忆的memory,保存了本次会话的所有历史消息
Long Term Memory(长期记忆)
所谓的长期记忆就是我们跨会话记录的一些信息,和短期记忆是有区别的,一般记录的是用户画像等信息
具体的实现方法:
- 使用模型提取用户画像信息,向量化之后存入向量库,或者图数据库
选择
有了前面的上下文写入之后,还需要有一个能提取这些上下文的方式,所以Select就是从外部存储中精准检索最相关的信息,注入当前上下文。
- 从长期记忆中召回语义相关的事实
- 动态选择最匹配的工具(而非暴露全部工具)
- 加载特定规则文件(如 CLAUDE.md、.cursor/rules)
压缩
除了做保存和提取外,还有一个最直接有效的方案,那就是针对上下文做压缩,减少上下文中的 token 数量,只保留必要信息。
主要方法:
- Summarization(摘要):例:Claude Code 在上下文达 92% 时自动运行 "auto-compact",将整段对话轨迹压缩成简明摘要。
- Trimming(裁剪):按规则删除旧消息(如"只保留最近 10 轮")
- 智能修剪(Pruning):使用专用模型识别并移除对当前任务无用的内容
隔离
拆分并隔离,主要方案是针对大的上下文做拆分,避免信息混杂或冲突。
典型做法:
- 多智能体架构(Multi-agent):每个子智能体拥有独立上下文窗口,专注子任务。Anthropic 发现:多智能体系统在复杂任务上优于单智能体,因为上下文更聚焦。
- 沙盒环境(Sandbox):让代码在隔离环境中执行,仅将关键结果返回给 LLM,避免 token-heavy 对象(如图像、音频)污染上下文。
- 结构化状态(State Schema):在 LangGraph 中,通过定义 state 字段(如 messages, plan, search_results),控制哪些字段暴露给 LLM,哪些仅内部使用。
渐进式披露
就是我们经常使用的的skills,渐进式披露通常分为三个阶段(以 Skills 系统为例):
- 发现阶段(Discovery): 启动时,只加载技能的元数据(名称、描述)。这就像书的目录,Token 消耗极低(约 50-100 tokens),让模型知道"有什么能力可用"。
- 激活阶段(Activation): 当模型判断某个技能与当前任务相关时,才加载完整的指令文件(如 SKILL.md)。这时模型才读取具体的工作流和操作规范。
- 执行阶段(Execution): 在执行过程中,如果遇到复杂计算或需要查阅深层文档,模型会按需调用工具去读取参考资料或执行脚本。