课程:B站大学
记录学习极客时间团队MySQL45讲,进阶数据分析和数据处理
MySQL主库和备库
- [insert 语句的锁为什么这么多?](#insert 语句的锁为什么这么多?)
-
- 一、insert...select:为什么锁源表的所有行和间隙?
- [二、insert 循环写入:同表 insert + select 导致全表扫描](#二、insert 循环写入:同表 insert + select 导致全表扫描)
-
- [2.1 目标表不同时(正常)](#2.1 目标表不同时(正常))
- [2.2 目标表相同时(问题)](#2.2 目标表相同时(问题))
- [优化方案:拆成两步 + 内存临时表](#优化方案:拆成两步 + 内存临时表)
- [三、insert 唯一键冲突:为什么死锁频发?](#三、insert 唯一键冲突:为什么死锁频发?)
-
- [3.1 加锁行为](#3.1 加锁行为)
- [3.2 经典死锁场景](#3.2 经典死锁场景)
- 避免建议
- [四、insert...on duplicate key update](#四、insert...on duplicate key update)
- 怎么最快地复制一张表?
- 实践是检验真理的唯一标准
insert 语句的锁为什么这么多?
普通 insert 是轻量操作(自增 id 申请后即可释放自增锁),但以下 4 种特殊场景需要额外加锁或无法及时释放锁。
一、insert...select:为什么锁源表的所有行和间隙?
场景 :可重复读(RR)隔离级别 + binlog_format=statement
sql
insert into t2(c,d) select c,d from t;原因:保证主备一致
不加锁时,可能出现这样的并发时序:
| session A | session B |
|---|---|
insert into t2 select ... from t(先执行) |
|
insert into t values(-1,-1,-1)(后写入 binlog) |
由于 binlog 按提交顺序记录,备库重放时会把 id=-1 也复制到 t2,导致主备不一致。
加锁行为:
- 对源表 t 的所有扫描到的记录 + 间隙 加 next-key lock(共享/读锁)
- 语句执行完才释放,期间阻塞其他事务对 t 的插入
二、insert 循环写入:同表 insert + select 导致全表扫描
2.1 目标表不同时(正常)
sql
insert into t2(c,d)
(select c+1, d from t force index(c) order by c desc limit 1);- 走索引 c 倒序,只扫描 1 行
Rows_examined = 1- 加锁范围:索引 c 上的
(3,4]、(4,supremum]两个 next-key lock + 主键 id=4 这一行
2.2 目标表相同时(问题)
sql
insert into t(c,d)
(select c+1, d from t force index(c) order by c desc limit 1);
Rows_examined = 5(不是预期的 1 或 2)Using temporary:需要临时表保存全量数据
完整执行流程:
- 创建临时表(c, d 两字段)
- 按索引 c 扫描表 t,取 c=4,3,2,1 回表写入临时表 → 4 行
- 因
limit 1只取临时表第一行插入 t → +1 行 - 总计 5 行
为什么需要临时表?
一边遍历一边写回原表时,会读到自己刚插入的新记录,导致参与计算逻辑、语义错误。临时表就是为了打破这个循环。
加锁代价 :对表 t 全表扫描 + 索引 c 上所有间隙加共享 next-key lock ,期间其他事务无法插入。
优化方案:拆成两步 + 内存临时表
sql
create temporary table temp_t(c int,d int) engine=memory;
insert into temp_t (select c+1, d from t force index(c) order by c desc limit 1);
insert into t select * from temp_t;
drop table temp_t;
优化点 :先 insert 到临时表只扫描 1 行,再从临时表写回 t,避免全表扫描。
三、insert 唯一键冲突:为什么死锁频发?
3.1 加锁行为
关键规则 :insert 遇到唯一键冲突时,不只是报错,还会在冲突的唯一索引上加锁。
| 场景 | 加锁类型 |
|---|---|
| 普通唯一键冲突 | 冲突索引上加 共享 next-key lock(S 锁) |
on duplicate key update |
冲突索引上加 排他 next-key lock(X 锁) |
⚠️ 官方文档错误纠正 :无论冲突的是主键 还是唯一索引 ,加的都是 next-key lock(不是"主键加记录锁、唯一索引加 next-key lock")。此 bug 已提交官方并被 verified。
为什么加读锁? 防止这条记录被别的事务删除(虽理由不算绝对充分,但目前实现如此)。
3.2 经典死锁场景
| 时刻 | session A | session B | session C |
|---|---|---|---|
| T1 | begin; insert (null,5,5); |
||
| T2 | insert (null,5,5);(冲突,等 S 锁) |
insert (null,5,5);(冲突,等 S 锁) |
|
| T3 | rollback; |
获得 S 锁,要加 X 锁插入 | 获得 S 锁,要加 X 锁插入 → 死锁 |
死锁产生逻辑:
- T1:session A 在 c=5 上加记录锁(唯一索引退化为记录锁)
- T2:B、C 发现唯一键冲突,各自加读锁(S),等待 A 释放
- T3:A rollback → B、C 同时获得 S 锁,都要升级为写锁(X)
- S 锁互相持有、X 锁互相等待 → 死锁
避免建议
- 遇到唯一键冲突报错后,尽快 commit / rollback,缩短锁持有时间
- 降低高并发下的重复值插入
- 去掉不必要的唯一值检测(业务允许时)
四、insert...on duplicate key update
sql
insert into t values(11,10,10) on duplicate key update d=100;语义:插入一行,若违反唯一键约束,则执行后面的 update。
加锁 :冲突索引上加 排他 next-key lock(X 锁/写锁)。
两个坑:
- 多个唯一键冲突时 :按索引顺序,只修改与第一个索引冲突的行
affected_rows返回 2:实际只更新 1 行。因代码实现上 insert 和 update 各计数 +1
怎么最快地复制一张表?
把 db1.t 中 a>900 的数据拷贝到 db2.t,有三种方法。
一、mysqldump 导出 INSERT 语句
bash
mysqldump -h$host -P$port -u$user \
  --add-locks=0 \
  --no-create-info \
  --single-transaction \
  --set-gtid-purged=OFF \
  --result-file=/client_tmp/t.sql \
  db1 t --where="a>900"
参数说明:
--single-transaction:用一致性快照读,不加表锁--add-locks=0:输出文件里不加LOCK TABLES t WRITE--no-create-info:不导表结构--set-gtid-purged=off:不输出 GTID 信息--result-file:指定输出路径,文件在客户端机器上
默认一条 INSERT 包含多行 value,写入更快:

想要一行一个 INSERT,加 --skip-extended-insert。
导入目标库:
bash
mysql -h127.0.0.1 -P13000 -uroot db2 -e "source /client_tmp/t.sql"source 是客户端命令,不是 SQL。服务端 binlog 和慢日志里记的是那些真正的 INSERT 语句。
二、select...into outfile + load data
导出到服务端本地:
sql
select * from db1.t where a>900 into outfile '/server_tmp/t.csv';注意:
- 文件在服务端,不在你执行命令的客户端机器上
- 路径受
secure_file_priv限制(设为 NULL 则禁止导出) - 不能覆盖已有文件,有同名先删
- 字段里含换行符会加
\转义
导入:
sql
load data infile '/server_tmp/t.csv' into table db2.t;主备同步怎么搞
不能直接把 load data infile '/server_tmp/t.csv' 记进 binlog------备库上没有这个文件。实际流程:
- 主库把 csv 内容直接写进 binlog
- binlog 里记的是:
load data local infile '/tmp/SQL_LOAD_MB-1-0' into table db2.t - 备库 apply 线程从 binlog 读出内容,写到本地
/tmp/SQL_LOAD_MB-1-0 - 再执行 load data 把这个本地临时文件读进去
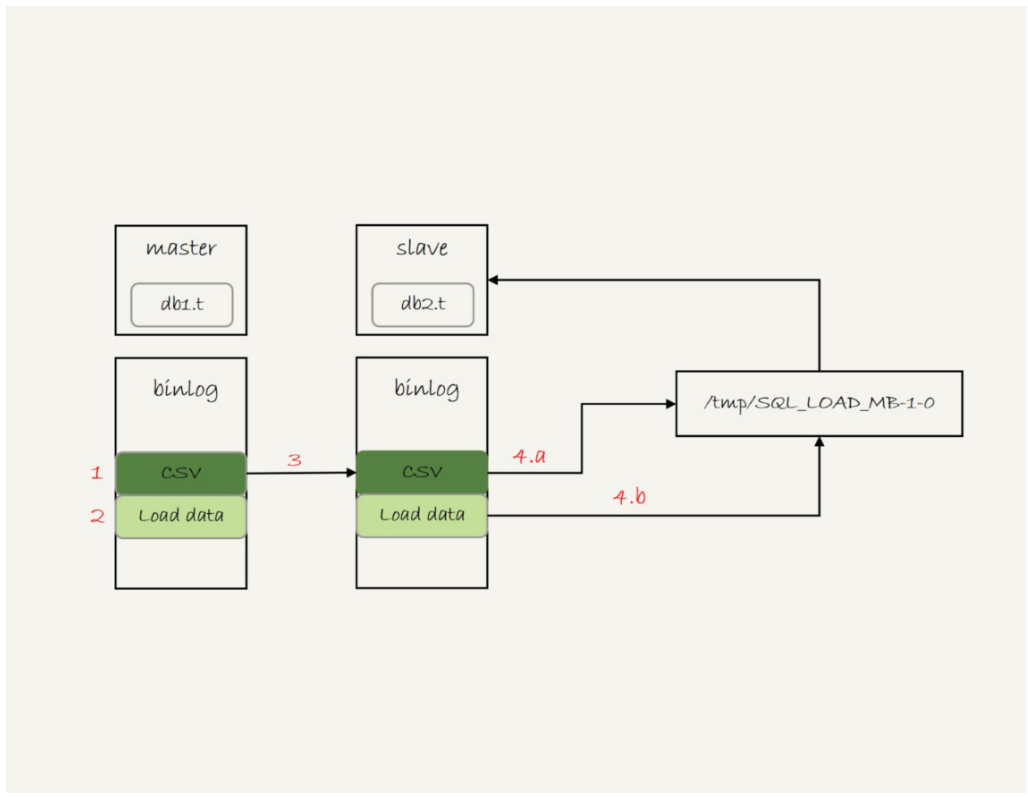
为什么要加 local:
- 不加 local:读服务端文件,必须在
secure_file_priv允许的目录里 - 加 local:读客户端(对备库来说就是同步线程自己)本地文件,不受
secure_file_priv限制
只导数据不导结构,要结构的话用 --tab:
bash
mysqldump --single-transaction --set-gtid-purged=OFF db1 t --tab=$secure_file_priv会生成 .sql(建表)和 .txt(数据)两个文件。
三、物理拷贝(可传输表空间,MySQL 5.6+)
直接 cp .ibd 不行,数据字典没注册。正确步骤:
sql
-- 1. 建空表
create table db1.r like db1.t;

-- 2. 丢弃新表的表空间(r.ibd 被删)
alter table db1.r discard tablespace;

-- 3. 冻结源表,生成 t.cfg(此时 t 只读)
flush table db1.t for export;

-- 4. 拷贝文件(在服务器上操作)
cp t.cfg r.cfg;
cp t.ibd r.ibd;
chown mysql:mysql r.cfg r.ibd;   -- 不改权限会报 Tablespace is missing

-- 5. 解锁源表(t.cfg 自动删除)
unlock tables;

-- 6. 导入
alter table db1.r import tablespace;
要点:
flush table ... for export之后源表只读,操作完赶紧 unlock- import 时每个数据页都要改表空间 id,大文件要一些时间,但比逻辑导入快得多
- cfg 文件 import 完不会自动删,手动清一下
对比
| 速度 | 能过滤数据 | 跨引擎 | 局限 | |
|---|---|---|---|---|
| 物理拷贝 | 最快 | 只能全表 | 仅 InnoDB | 要登服务器、要文件权限 |
| mysqldump | 中 | 支持 where | 可以 | 不能用 join 等复杂条件 |
| outfile | 较快 | 支持任意 SQL | 可以 | 每次一张表,结构单独备 |
物理拷贝大表最快。逻辑拷贝灵活,能跨引擎。
思考题
binlog 里记录的 load data 带了 local,备库执行时读的是自己本地的 /tmp/SQL_LOAD_MB-1-0。为什么不能不带 local?
因为不带 local 读的是服务端文件,必须在 secure_file_priv 指定的目录里。备库临时文件在 /tmp 下,不一定在允许路径内,执行就会失败。加了 local 走客户端文件读取,绕开这个限制,主备才不会断。